Twitter AI - 2026-05-10
1. 人们在讨论什么
1.1 智能体工程正从提示词打磨转向 harness、评测与失败分析 🡕
5 月 10 日最明显的变化是,人们谈论前沿模型“魔法”的少了,转而更多讨论智能体外围的支撑体系。高信息量帖子集中在 harness、隐藏测试评测、审查智能体、长程记忆以及安全失效模式;即便是宣传智能体的帖子,也很快会转向工具对比和可靠性质疑。
@AlexFinn 将 Hermes Agent 称为“地球上最可靠的 AI Agent”和“24/7/365 员工”;回复立刻开始追问 Hermes 与 OpenClaw 的对比,说明讨论会非常快地从炒作转向运营层面的选型(帖子)。
@rohit4verse 认为,“愚蠢的 AI 循环”仍然是护城河,并称 88% 的智能体试点会死在生产环境中;他列举了 Stripe 的 customer_id bug、状态污染、Claude Code harness 回归,以及类级可变对象在用户之间泄漏等问题(帖子)。
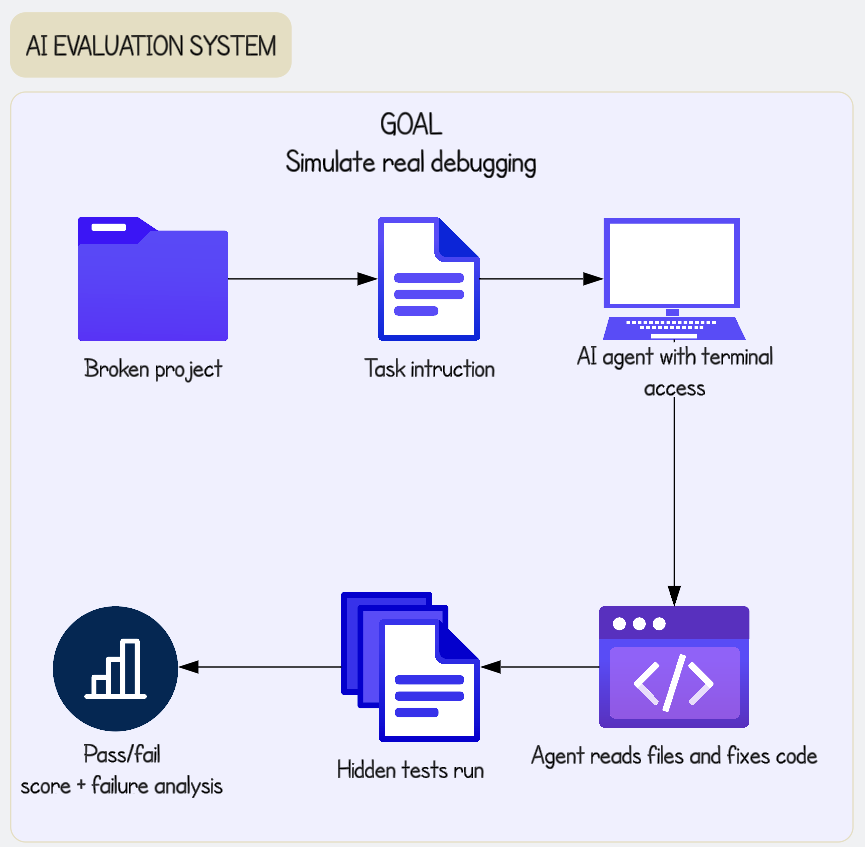
@arshad83 将这一转向概括为“Harness Engineering”;@cloclodma 展示了一套评测流程:从一个损坏的项目开始,最后进入隐藏测试和失败分析;@terakytehq 则发布了 AgentSystems101,作为一本公开手册,覆盖工具、记忆、检索、编排、评测和生产运维(arshad83 帖子、cloclodma 帖子、AgentSystems101)。

讨论洞察: @asmah2107 明确预测,未来会更关注长程记忆、自我评估、错误恢复、上下文工程以及无界面工具集成(帖子)。@dadhalfdev 还补充了一个务实警告:许多宣称“针对智能体工作流优化”的模型,在 OpenClaw 和 Hermes 上依然过不了简单任务,并点名 Gemini 3.1 Flash Lite 不适合做智能体(帖子)。@RoyAmal 指出,ASB 衡量的是长时间运行的智能体行为,而不是单提示问答;VentureBeat 关于工具投毒的文章则称,工具描述和元数据本身也可能成为攻击面(RoyAmal 帖子、VentureBeat)。
与前一天相比: 5 月 9 日的重点是 AI 工程路线图和可观测性;到 5 月 10 日,讨论进一步深入到了 harness 设计、隐藏测试和运行时安全。
1.2 围绕算力和数据中心经济性的争论,开始逐项算账而不是喊口号 🡕
第二条强势主线是基础设施算账。5 月 10 日关于 AI 建设的讨论,少了单纯炫耀资本开支,更多是在追问:利用率、定价、存储和折旧,是否真能把账算通。
@ShanuMathew93 反驳了 David Sacks 对 1 GW AI 数据中心“两年回本”的说法:他列出约 70 亿、170 亿和 320 亿美元的低、中、高收入情景,与约 500 亿美元的资本开支对照;再计入电力、设施、维护、人力和折旧后,得出结论称低情景很可能不具经济性,中等情景的 EBIT 回本期更接近 8 到 10 年(帖子)。
@MartiniGuyYT 转发了 Jensen Huang 的说法,称 agentic AI 所需算力是生成式 AI 的 1000 倍;回复立刻指出,从一家已主导 AI 芯片市场的公司那里听到这个判断,本身就存在明显的利益激励问题(帖子)。
@russianblue2009 将 Kioxia 预期利润大增与运行大语言模型的数据中心对 NAND 闪存的需求联系起来,把 AI 描述为日本产业经济内部的一次结构性变化,而不只是软件趋势(帖子)。
讨论洞察: 现在的分歧已不在于 AI 是否需要基础设施,而在于把完整成本栈都算进去后,租赁价格、GPU 利用率、更新周期和存储需求,是否足以支撑这轮扩张。
与前一天相比: 5 月 9 日已经把 AI 描绘成一场资本开支竞赛;到 5 月 10 日,讨论明显更细,开始逐项拆解 GPU 小时定价、折旧年限和内存瓶颈。
1.3 具体工作流证据正从消费级聊天扩散,但方法论之争仍在继续 🡕
当天最有力的采用证据,来自具体工作流,而不是泛泛的“采用正在发生”口号。医疗和会计给出了最清晰的例子。
@ScienceMagazine 报道称,一款大语言模型在急诊早期病例中约 67% 的情况下给出了正确或非常接近的诊断,而医生的比例约为 50%—55%;该帖将这一结果解读为证据,认为 AI 能在信息稀缺的时刻胜过临床医生(帖子)。
@LocasaleLab 反驳说,更大的问题在于围绕科学结果的炒作和失真传播;该帖下的一条回复则指出,LLM 与医生的对比研究往往依赖回顾性的结构化病例,而不是急诊室里混乱的实时数据(帖子)。
@emollick 认为,AI 的使用已不再集中在旧金山;他还在回复中补充说,一屋子资深会计师里大约有 10% 安装了 OpenClaw(帖子)。
讨论洞察: 争论的重点已不再是“AI 能不能帮上忙”,而是“到底测了什么、是在什么工作流里测的,以及工具一旦可用,非技术用户会以多快速度采用”。
与前一天相比: 5 月 9 日同样强调医疗和科研 AI;到 5 月 10 日,则增加了更多关于谁已经在工作中使用智能体工具的直接证据。
1.4 物理 AI 和企业部署正被框定为基础设施问题 🡕
一个规模较小但辨识度很高的讨论群体,把机器人和企业智能体都视为基础设施问题:数据管线、基准测试和防篡改审计层。
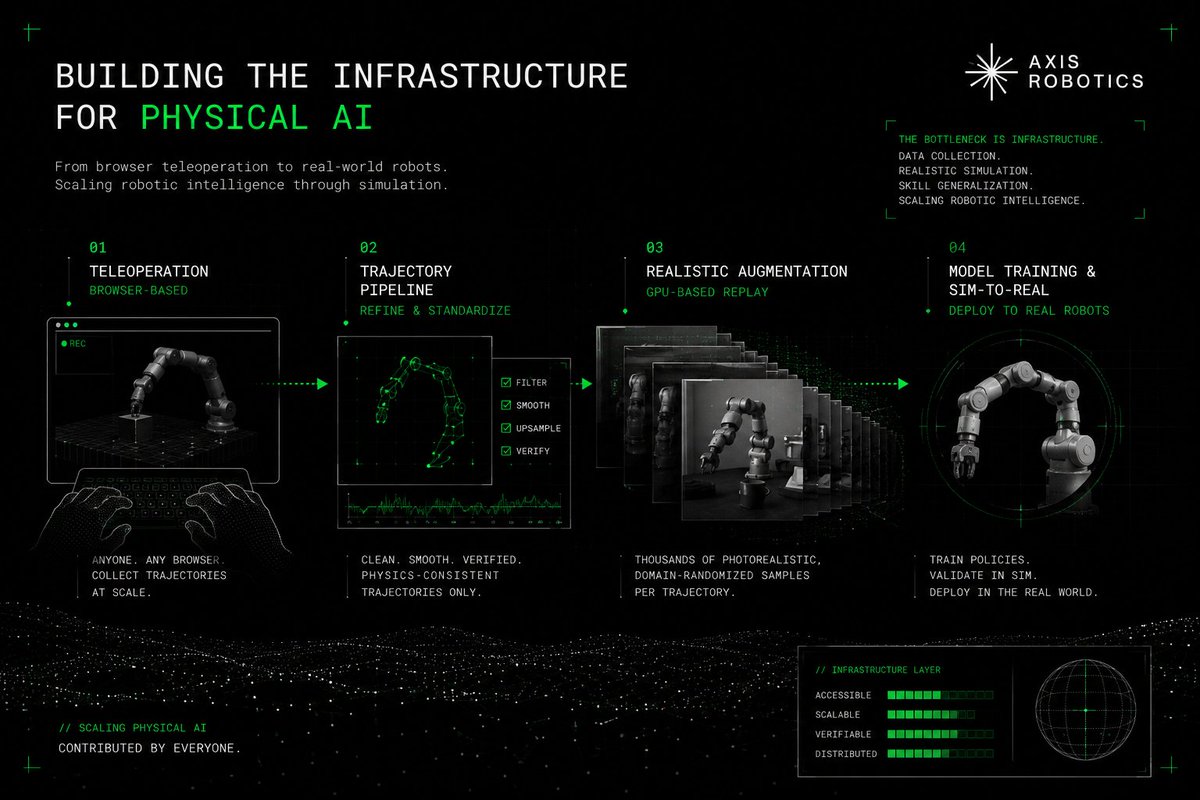
@fijimlk 认为,物理 AI 缺少让 LLM 得以出现的互联网规模数据层,并用一张 Axis Robotics 图示展示了一条从浏览器远程操控,到轨迹清洗、基于 GPU 的数据增强,再到 sim-to-real 部署的管线(帖子)。
@jonas70927106 放大传播了 AI & Partners 的 MAESTRO 提案;链接中的公开帖子称,该联盟希望构建开放、符合欧盟 AI 法案的自主智能体审计基础设施,采用由区块链锚定的 PIAL 治理层,并以 SWE-Bench Verified 和 AgentBench 上 38%+ 的提升、以及相对单智能体基线 30%—50% 的提升为目标(帖子、LinkedIn 帖子)。
讨论洞察: 无论是机器人还是企业智能体,当前被反复指出的缺失层越来越像基础设施:数据管线、审计轨迹和编排,而不只是再发一个新模型。
与前一天相比: 5 月 9 日更关注部署打法;到 5 月 10 日,则为物理 AI 和可审计智能体系统都补上了更明确的基础设施图景。
1.5 文化层面正在同时反击拟人化和 AI 生成垃圾 🡕
当天互动量最高的两条帖子都不是新模型发布,而是有人坚持认为模型是工具、不是人,也有人强调某些创意工作应明确保留为人类创作。
@edzitron 回复 Sam Altman 时直截了当地说:“不,它就是一个大语言模型。”@DeepDishEnjoyer 则认为 Claude 不具备感受或情绪,不应出于认知安全原因被拟人化(edzitron 帖子、DeepDishEnjoyer 帖子)。
@soflysojoe 强调了 Take-Two CEO Strauss Zelnick 的表态:生成式 AI 在 GTA 6 的创作中“完全没有参与”,Rockstar 的世界依然是手工打造,而非 AI 生成(帖子)。

讨论洞察: Claude 相关讨论下有一条回复认为,拟人化仍可作为一种有用的审计隐喻;但整体基调是划清边界,而不是浪漫化“有意识的助手”。
与前一天相比: 5 月 9 日主要由运营纪律和经济性主导;到 5 月 10 日,文化层面对 AI 不该假装成什么、也不该取代什么,划出了更鲜明的界线。
2. 什么让人感到沮丧
智能体试点仍然败在那些乏味的系统问题上
@rohit4verse、@asmah2107、@arshad83 和 @cloclodma 都指向同一种挫败感:智能体通常不是因为模型太笨才失败,而是因为记忆改坏了状态、编排出现泄漏、测试不贴近现实,或者根本没人围绕模型搭建 harness。@dadhalfdev 进一步加重了这种挫败感:那些被宣传为适合智能体工作流的模型,依旧做不好 OpenClaw 和 Hermes 上的简单任务。严重程度:高。当前的应对方式包括收窄任务范围、使用隐藏测试、引入审查智能体,以及改进上下文工程。值得投入建设:是。
工具、记忆和注册表安全仍然缺乏明确规范
安全痛点已经不再只是泛泛的提示注入警告。@RoyAmal 特意提到 ASB,因为它测试的是自主智能体行为;VentureBeat 的工具投毒文章则称,即便常规来源校验看起来没问题,恶意工具描述或元数据依然可能把智能体引向错误方向(VentureBeat)。MAESTRO 提案则从治理角度让同样的缺口变得更清晰:欧洲仍缺少可供部署型自主系统共享使用的审计底座(LinkedIn 帖子)。严重程度:高。当前的缓解手段是防御分层、日志记录和人工复核,但公开证据仍表明这些方案并不完整。值得投入建设:是。
AI 基础设施回报依赖的假设,可能很快失效
@ShanuMathew93 展示了 1 GW AI 建设项目如何在乐观情景下看似能回本,又如何在计入折旧和服务负担后,滑向几乎站不住脚的低情景经济性。@MartiniGuyYT 扩散了 Jensen Huang 关于 1000 倍算力需求的说法,但回复立刻质疑:声音最大的基础设施叙事,是否恰恰也是最符合其自身利益的叙事。严重程度:高。当前的应对方式,是对利用率、定价和硬件更新周期做不间断的敏感性分析,而不是照单全收自上而下的回本口号。值得投入建设:是。
信任与沟通鸿沟仍在拖慢采用
医疗讨论把信任问题表现得很清楚。@ScienceMagazine 报道了一个亮眼的诊断结果,而 @LocasaleLab 及其回复则认为,传播方式和基准设计仍可能误导读者,无法准确理解到底测了什么。文化层面上,@edzitron、@DeepDishEnjoyer 和 @soflysojoe 都体现出一种不耐烦:人们厌倦了 AI 被人格化,或在未经同意的情况下被塞进旗舰级创意作品。严重程度:中。当前的应对方式是收窄论断、坚持人类在环,并明确划出“禁用 AI”的边界。值得投入建设:或许。
3. 人们希望有什么
真实的调试基准和审查智能体栈
cloclodma 的图示、harness engineering 信息图和 ASB 讨论,都指向同一个实际需求:评测系统应当在损坏、长时间运行的环境里测试智能体的真实表现,并提供审查层,在用户发现问题前就拦住低质量输出(cloclodma 帖子、arshad83 帖子、RoyAmal 帖子)。这是一个实际且紧迫的需求,因为今天公开的抱怨聚焦于生产故障,而不是缺少演示。个人 harness、公开手册和研究基准已提供部分解法。机会:直接。
可审计的智能体治理与安全工具注册表
VentureBeat 的工具投毒报道和 MAESTRO 提案,都指向模型输出与企业部署之间缺失的一层:防篡改的审计轨迹、安全的工具元数据,以及解释智能体看到了什么、为什么这样行动的能力(VentureBeat、LinkedIn 帖子)。这是一个实际且紧迫的需求。现有安全控制和合规框架只能部分覆盖这一问题。机会:直接。
面向仿真的物理 AI 数据基础设施
@fijimlk 明确指出,机器人领域仍缺少一个能类比“互联网规模数据层”的基础设施,而正是这种数据层帮助了 LLM 的兴起;附带的 Axis Robotics 架构则把这种缺失具象化了。这是一个实际需求,而非情绪性需求;对真正造机器人而不是做演示的人来说,它看起来相当紧迫。浏览器远程操控、回放系统和 sim-to-real 管线等局部方案已经开始出现。机会:直接。
面向智能体模型的诚实工作负载路由
当天最明显的问题之一,是营销与实际使用之间的错位。Hermes 被包装成永不下线的员工,但最有价值的回复流量却集中在它和 OpenClaw 的对比上;@dadhalfdev 还指出,大多数号称“智能体就绪”的模型依然做不好简单任务。对需要模型选型、回退规则和按任务路由的运营者来说,这是一个实际需求,而不是再听更多口号。用户自行试验和厂商定位提供了一些局部方案,但并不可靠。机会:竞争型。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Hermes Agent / OpenClaw | 智能体运行时 | (+/-) | 有很强的实操兴趣,存在明确的运行时对比,也有证据显示 OpenClaw 已开始进入非技术岗位 | 营销领先于证据,任务成功率仍会随模型和配置大幅波动 |
| Gemini 3.1 Flash-Lite | 基础模型 | (-) | 速度快、成本低,对高吞吐任务有吸引力 | 有实践者明确表示,尽管速度宣传亮眼,它做 AI 智能体工作非常差 |
| 隐藏测试编码评测 | 评测方法 | (+) | 用损坏项目、终端访问、隐藏测试和失败分析来模拟真实调试 | 仍是早期个人系统,尚无公开基准语料 |
| Harness engineering / 审查智能体 | 开发方法 | (+) | 为上下文控制、护栏、文档和自动化审查提供了具体框架 | 仍受制于人工判断、GPU 预算和文档质量 |
| ASB | 安全基准 | (+) | 可评估自主智能体在直接提示注入、观察提示注入、记忆投毒和后门等情形下的表现 | 仍处研究阶段,几乎没有主流产品采用的公开证据 |
| AgentSystems101 | 工程手册 | (+) | 实用覆盖工具、记忆、检索、编排、评测和生产运维 | 只提供指导,团队仍需自己搭建和验证系统 |
| PIAL / MAESTRO | 治理与审计基础设施 | (+/-) | 审计优先的设计、欧盟 AI 法案定位,以及明确的证据链主张 | 仍在提案阶段,更多依赖自报目标,而非已部署系统的遥测数据 |
| 浏览器远程操控 + 仿真回放 | 机器人数据基础设施 | (+) | 能规模化采集轨迹,并将其转化为用于 sim-to-real 训练的照片级逼真数据 | 仍属早期架构,帖子里没有公开部署指标 |
| LLM 急诊诊断分诊 | 临床决策支持方法 | (+/-) | 据称在急诊早期病例中,正确或接近正确诊断率达到 67%,医生约为 50%—55% | 方法论仍有争议,工作流仍需人工监督 |
总结: 当方法足够明确时,满意度最高:隐藏测试、审查智能体、安全基准、审计轨迹和仿真管线都属于这一类。相反,当模型在缺乏证据的情况下被宣传为“智能体就绪”时,情绪就会转负。迁移路径已经很清楚:从手工编码走向 harness 设计,从泛化基准走向运营安全与隐藏测试,从提示安全走向工具、记忆和运行时安全。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| AgentSystems101 | @terakytehq | 一本关于如何正确构建智能体系统的开源手册 | 团队需要关于工具、记忆、编排、评测和生产运维的实用指导 | Markdown 文档、Python 示例、GitHub 仓库 | 已发布 | GitHub、帖子 |
| AI 编码评测 harness | @cloclodma | 测试智能体能否在看不到隐藏测试的情况下修复一个损坏项目 | 现有编码评测无法覆盖真实调试行为 | 损坏项目样例、任务说明、终端访问、隐藏测试、失败分析 | Alpha | 帖子 |
| MAESTRO | AI & Partners 联盟 | 面向开放、可审计自主智能体基础设施的 Horizon Europe 提案 | 欧洲缺少共享基准、治理框架和可审计部署底座 | PIAL 治理层、区块链锚定证据链、多智能体协同 | RFC | LinkedIn 帖子、帖子 |
| Axis Robotics 管线 | @fijimlk | 一套从浏览器远程操控到 sim-to-real 部署的仿真原生物理 AI 栈 | 机器人数据采集和迁移仍然碎片化且成本高 | 浏览器远程操控、轨迹管线、GPU 回放、仿真、真实机器人部署 | Alpha | 帖子 |
| 招标分析智能体平台 | @sayandedotcom | 在欧洲范围内匹配并预评估公共招标 | 企业被无关 RFP 淹没,需要先做投标分诊 | AI/ML 智能体、后端文档匹配、对数百万份招标进行评分 | Beta | 帖子 |
这些项目的构建模式明显偏基础设施。AgentSystems101 和 cloclodma 的评测 harness 并不是想用一个完美模型取代人工操作,而是在模型使用外围搭建支撑结构。MAESTRO 和 Axis Robotics 也在各自领域做了同样的事:把可审计性和数据管线本身做成产品表面。
@sayandedotcom 的招标分析平台,是这组项目里最清晰的垂直产品信号:3 人团队、一个 MVP、25+ 家公司进入早期访问,并正在招聘 AI/ML 和后端人才(帖子)。这比泛泛的“AI 赋能一切”叙事更聚焦,也更可信。
6. 新动态与值得关注的事
OpenClaw 正出现在并非传统早期采用者圈层的地方
@emollick 表示,AI 用户如今已遍布各个行业;而他随后补充说,一屋子资深会计师中大约有 10% 安装了 OpenClaw,这是当天最具体的“AI 已经走出泡沫圈层”数据点。它之所以值得注意,是因为它指向的是保守职业中的真实智能体工具使用,而不是又一个软件工程师轶事。
早期构建者仍在靠 API 额度把产品拼起来
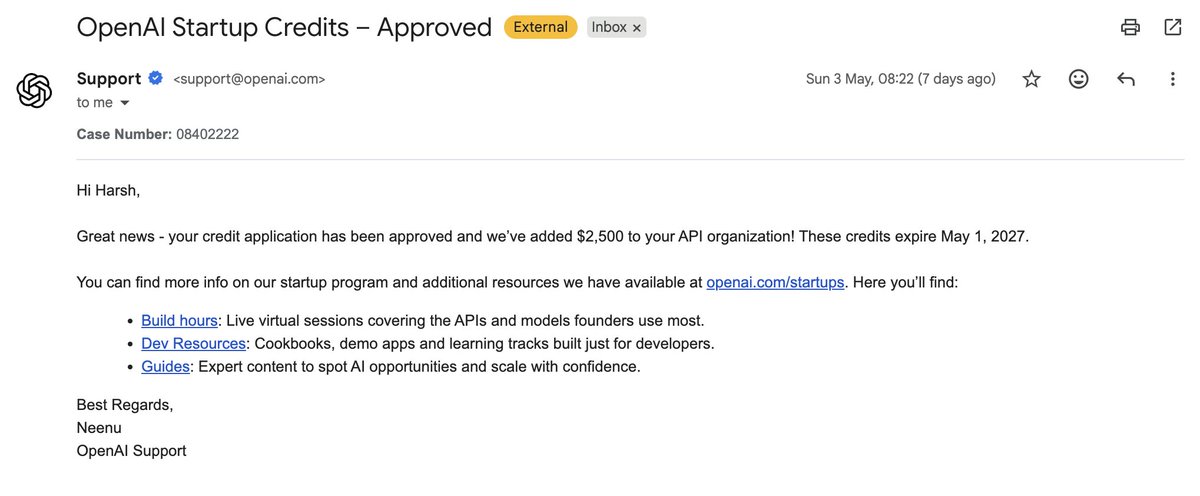
@itsharshag 晒出了一封批准邮件,显示 OpenAI 向一个 API organization 发放了 2,500 美元创业公司额度,有效期至 2027 年 5 月 1 日(帖子)。这值得注意,因为它说明构建者栈里仍包含非常具体的补贴机制,而不只是模型选型。
可审计性正被定位为产品基础设施,而不是合规负担
MAESTRO 提案声称,欧洲需要共享基准、防篡改证据链,以及符合欧盟 AI 法案的智能体基础设施;这一点之所以值得注意,是因为它把治理从法律层面的事后补丁,变成了正在被构建和销售的产品本身(LinkedIn 帖子)。
7. 机会在哪里
[+++] 智能体可靠性基础设施 — 当天最有力的证据来自隐藏测试评测、harness engineering 图示、生产故障复盘和智能体安全基准。构建者想要的是审查智能体、更好的上下文控制,以及在用户发现之前捕捉记忆、编排和运行时故障的方法。
[++] 安全工具注册表与审计轨迹 — VentureBeat 对工具投毒的报道、ASB 的攻击分类,以及 MAESTRO 审计优先的提案,都指向同一个缺失层:可信的工具元数据、防篡改操作日志,以及面向自主系统的可解释执行历史。
[++] 物理 AI 数据基础设施 — Axis Robotics 从远程操控到仿真再到现实的管线,让这一机会变得具体。如果机器人领域仍缺少帮助 LLM 扩张的数据底座,那么数据采集、清洗、增强和迁移本身就都是产品界面。
[+] 面向特定工作负载的智能体路由与运营支持 — Hermes 与 OpenClaw 的对比讨论、对 Gemini 3.1 Flash Lite 的实际抱怨,以及会计师安装 OpenClaw 的迹象,都说明市场需要的是能为具体工作选对模型和护栏的系统,而不是把“agentic”当成万能标签。
8. 要点
- 重心已从模型神秘感转向 harness 质量。 当天最有价值的帖子谈的是隐藏测试、审查智能体、上下文工程和失败分析,而不是前沿模型的“智商秀”。(rohit4verse 帖子、arshad83 帖子、cloclodma 帖子)
- AI 基础设施讨论正在接受真实假设的压力测试。 GPU 小时定价、利用率、折旧和存储需求,比笼统的资本开支口号更受关注。(ShanuMathew93 帖子、MartiniGuyYT 帖子、russianblue2009 帖子)
- 具体的职场采用已经出现,但可信度取决于评测质量。 医疗诊断结果和会计师安装 OpenClaw 的轶事都表明真实使用正在发生,而最强烈的反对意见集中在方法论、传播方式和工作流适配上。(ScienceMagazine 帖子、LocasaleLab 帖子、emollick 帖子)
- 人们希望 AI 的边界更清晰。 互动量最高的文化类帖子反对把模型拟人化,也称赞一家大型游戏工作室坚持让旗舰创意作品由人类完成。(edzitron 帖子、DeepDishEnjoyer 帖子、soflysojoe 帖子)