Twitter AI - 2026-05-14
1. 人们在讨论什么
1.1 可靠性正逐渐成为 AI 工程的定义 🡕
5 月 14 日最强烈的信号是:Twitter 上的 AI 讨论,正在奖励那些能够被衡量、审计,并在循环中持续改进的系统,而不只是能做演示的系统。至少有六条入选内容支撑这一判断:一条高互动的语音基准测试推文串、一条围绕评估标准展开的 CEO 级采购判断、一篇界定 AI 工程师角色的文章、一项 CAD 专项基准测试、一个基于轨迹的 LLM 分类路由器,以及一个面向编程代理的持久化记忆层。它们共同传达的理念是:“真正能用的 AI”,越来越意味着有基准、有凭据、也有生产反馈的 AI。
@XFreeze 声称(1,797 个赞、388 条回复、644,502 次浏览、80 次收藏)称,Grok Voice Think Fast 1.0 现已成为 τ-Voice 基准测试中的头名模型。附图才是重点:图中显示 Grok 在总分和大多数领域分项中都处于领先,因此这条帖子被当作运营层面的证据,而不只是泛泛炒作。

@tbpn 分享了(46 个赞、9,534 次浏览、28 次收藏)提到了 Max Levchin 采购 AI 工具的规则:如果供应商能解释评估标准,产品就值得试点;如果不能,“那就是垃圾,你买到的只是一个故事。” @FrontendMasters 链接到(6 个赞、602 次浏览)则是一篇文章,主张 AI 工程是一个独立的应用层岗位,围绕“构建—评估—改进”的循环展开,而不只是“会用 LLM 的开发者”(文章)。
@gNucleusAI 介绍了(45 次浏览)介绍了 Parametric CAD Bench,这是一项面向代理式 CAD 工作的领域专项基准测试。网站称,它会评估几何、约束、参数化正确性、拓扑、工作流成功率和效率;其初始排行榜显示,GPT-5.5 加 Codex 以 83.2 分位居第一,同时也明确展示了每次运行 $170 的成本(基准测试)。@LeopolisDream 指向了(47 次浏览)介绍了 TRACER。其代码仓库和网站称,该工具会将可预测的 90% 分类流量路由到轻量级 ML 替代模型,同时通过与教师 LLM 做一致性门控来保证质量(GitHub、网站)。@Dinosn 重点介绍了(14 个赞、1,311 次浏览、12 次收藏)介绍了 agentmemory,这是一个面向编程代理的持久化记忆层。其称,在 LongMemEval-S 上可达到 95.2% 的检索 R@5,并支持多个兼容 MCP 的客户端(GitHub、网站)。

讨论洞察: Grok 基准测试推文串下的回复并没有否定基准测试本身,而是在争论这个基准是否捕捉到了真实体验。一条回复称语音质量变差了,另一条则表示可用时长被缩短了。争论已经从“要不要衡量这件事”转向“你衡量的是不是用户真正感受到的东西”。
与前一天比较: 5 月 13 日已经开始偏向轨迹和可审计性。5 月 14 日则把同一理念进一步推进到了岗位定义、采购判断、领域专项基准测试和成本感知型路由。
1.2 物理基础设施约束正进入 AI 讨论 🡕
第二个主题是,人们开始把 AI 视为一个物理系统问题。光纤密度、散热、组件短缺和电力供应都已成为一等约束。讨论不再只是关于更好的模型,也关乎机架、线缆和供电系统能否支撑下一轮部署浪潮。
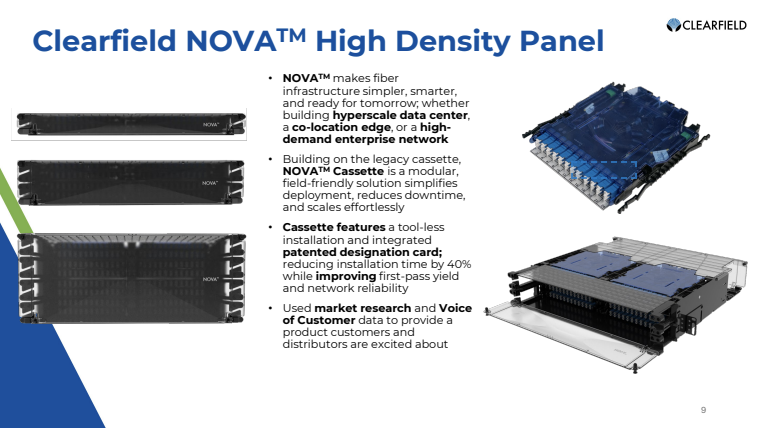
@BryzonX 认为(42 个赞、4 条回复、2,137 次浏览、25 次收藏)称,光纤管理硬件正在成为战略性的 AI 基础设施。附带的产品图和 Clearfield 自己的页面都指向同一个运营细节:NOVA HD panel 在 4RU 空间内最多支持 384 个 LC 端口,面向高密度数据中心互连(产品页面)。
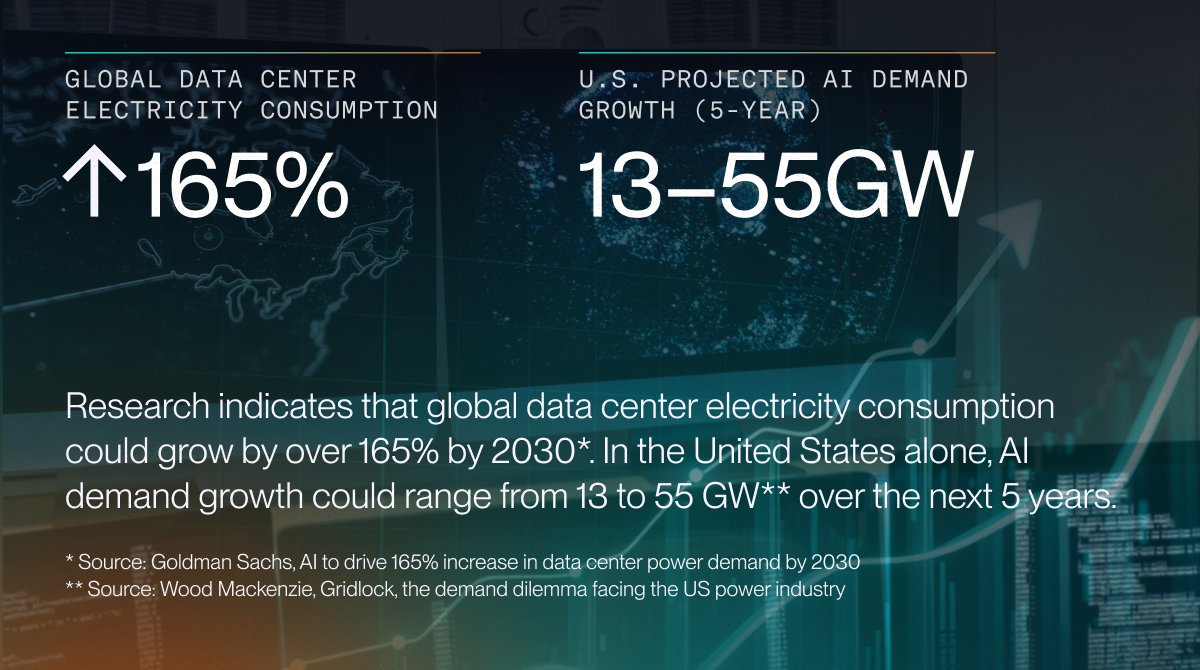
@jun_song 警告(25 个赞、3 条回复、1,347 次浏览)称,由于 DRAM、NAND、涡轮机、散热和电力都受到约束,云端 AI 短期内不太可能降价,他预计到 2028 年前都不会稳定。@xenergynuclear 将其描述为(7 个赞、207 次浏览)则从供给侧描述了同一个问题:其演示文稿称,AI 查询消耗的能量约为传统搜索的 10 倍,预计未来五年美国 AI 需求将增长 13-55 GW,并提出由四台 Xe-100 组成、总计 320MW 的电厂,作为应对这部分需求的方案。
讨论洞察: 这些帖子引发的争论少于基准测试推文串,但它们呈现出的趋同值得注意:不同账号都落在了同样的瓶颈上——光纤密度、散热和全天候电力。
与前一天比较: 5 月 13 日聚焦于代理周围的运行时层。5 月 14 日则进一步下探到了机架、线缆和电力。
1.3 安全与治理正从应用加固扩展到国际协调 🡕
第三个主要主题是,AI 安全正在同时从两个层面展开:具体的部署加固,以及高层治理。一组帖子聚焦于暴露在外的 MCP 服务器、越狱和配置错误;另一组则讨论,美国和中国可能需要直接围绕 AI 护栏机制展开协调。
@Dinosn 分享了(62 个赞、2,348 次浏览、44 次收藏)介绍了 Tencent Zhuque Lab 的 AI-Infra-Guard。其 README 将其描述为一个统一平台,可进行 OpenClaw 扫描、代理扫描、MCP 和 skills 扫描、AI 基础设施漏洞扫描以及越狱评估。当前发行说明称,5 月 14 日发布的 v4.1.8 已将覆盖范围扩大到 64 个 AI 组件;而自托管指南则明确警告,该应用缺少身份验证,不应暴露在公共网络上(GitHub)。
@MsftSecIntel 警告(6 个赞、636 次浏览、7 次收藏)称,AI 和代理式应用中的可利用配置错误,可能导致远程代码执行、凭据窃取,以及访问敏感的内部工具和数据。Microsoft 的相关博客把这一警告具体化:其称,超过一半的云原生工作负载利用事件源于配置错误,15% 的远程 MCP 服务器存在严重安全问题,允许未经身份验证的访问者接触敏感数据和运营能力(博客)。
@FirstSquawk 报道称(42 个赞、10 条回复、12,206 次浏览)称,OpenAI 提议成立一个由美国主导、包括中国在内的全球 AI 治理机构,模式类似 IAEA。回复分成两派:一方支持建立共同的安全机构,另一方则怀疑监管会被用来冻结竞争对手。
讨论洞察: 技术安全类帖子始终很具体:MCP 身份验证、暴露的服务,以及红队测试覆盖范围。治理相关回复则远未形成共识,在合作与对监管俘获的担忧之间来回摇摆。
与前一天比较: 5 月 13 日强调的是私有运行时和受控执行。5 月 14 日则加入了关于暴露 MCP 基础设施的硬数据,以及更明确的中美治理框架。
2. 什么让人沮丧
没有证据支撑的 AI 说法,依旧经不起用户检验
@tbpn 分享了(46 个赞、9,534 次浏览、28 次收藏)给出了最直白的抱怨:如果供应商无法解释评估标准,产品就是“垃圾”。同样的挫败感也出现在 @XFreeze 的 基准测试讨论串(1,797 个赞、388 条回复、644,502 次浏览、80 次收藏)下面:基准测试获胜后,回复立刻转向语音质量下降和使用时长缩短,而不只是庆祝。FrontendMasters 文章 也用岗位语言表达了同一个观点:演示很容易,可靠性才是真正的工作。人们的应对方式,是构建更紧的评估循环、领域专项测试框架,以及像 TRACER 这样更便宜的路由层,而不是盲目相信前沿模型的原始输出。严重程度:高。值得投入构建:是。
AI 基础设施正撞上光纤、散热和电力天花板
@BryzonX 认为(42 个赞、4 条回复、2,137 次浏览、25 次收藏)称,高密度 AI 机架正把光纤管理变成战略瓶颈;Clearfield 自家的产品页面也为这一说法提供了具体支撑:其 4RU 面板支持 384 个端口,专为数据中心互连设计(产品页面)。@jun_song 补充说(25 个赞、3 条回复、1,347 次浏览)称,DRAM、NAND、涡轮机、散热和电力都已紧张到足以推高云端 AI 价格。@xenergynuclear 进行了(7 个赞、207 次浏览)则用演示文稿让同一个问题变得清晰:未来五年美国 AI 需求将增长 13-55 GW。当前的共同应对方式还算不上真正的解决方案,主要仍是前置规划、组件替代,以及销售新的机架层或电力层硬件。严重程度:高。值得投入构建:是。
代理部署仍在带着危险默认值上线
@MsftSecIntel 警告(6 个赞、636 次浏览、7 次收藏)称,配置错误的 AI 和代理式应用,已经让组织暴露在远程代码执行、凭据窃取以及内部工具访问风险之下。Microsoft 自家的博客称,超过一半的云原生工作负载利用事件源于配置错误,15% 的远程 MCP 服务器存在严重安全问题,且允许未认证访问(博客)。@Dinosn 分享了(62 个赞、2,348 次浏览、44 次收藏)之所以推出 AI-Infra-Guard,正是因为团队需要一个统一平台,对代理、MCP 服务器、基础设施和越狱进行红队测试。当前的应对方式是:更多扫描、更强加固,以及更多私有或内部部署。严重程度:高。值得投入构建:是。
3. 人们希望存在什么
默认可验证的 AI 输出
最明确的未满足需求,是能够证明 AI 做了什么、为什么这么做,以及结果是否值得信任的系统。@tbpn 的 讨论串(46 个赞、9,534 次浏览、28 次收藏)、FrontendMasters 的文章 中对“可靠性”的界定、Parametric CAD Bench 中面向 CAD 的专项评分,以及 TRACER 中通过一致性门控进行路由的思路,都指向同一个方向。这是一个现实且紧迫的需求,而且已经有一些部分答案开始上线。机会:直接。
更简单的 AI 技术栈:不必每一步都新增数据库或支付一次全价 LLM 调用
@mjovanovictech 认为(24 个赞、3 条回复、802 次浏览、21 次收藏)称,许多 AI 功能可以借助 pgvector 直接留在 PostgreSQL 中,而不必再引入 Pinecone、Qdrant 或 Weaviate。TRACER 在推理成本上采取了同样的简化思路,把简单的分类调用路由到传统 ML;agentmemory 则在开发者工作流层面,通过跨编程代理会话持久化上下文来做简化(GitHub、网站)。人们想要的是能嵌入自己现有系统的 AI 基础设施,而不是再多一套并行技术栈。机会:直接。
安全且可审计的代理部署标准
Microsoft 的安全帖子和 AI-Infra-Guard 构建者信号都指向同一个缺口:团队需要一套默认配置,让代理在接触内部系统之前就先具备安全性。OpenAI 治理机构的讨论,则把这种愿望从应用安全延伸到了国际标准。这是一个现实需求,已有一些早期工具,但治理层面的争论仍有很多悬而未决之处。机会:竞争型。
面向 AI 电力与互连需求的规划工具
Clearfield 和 X-energy 的帖子揭示了一个更安静的未满足需求:团队希望在 AI 需求演变成基础设施故障之前,更好地推演光纤密度、散热和电力采购。当前相关讨论仍分散在硬件营销、电力预测和运营者评论之间。机会:愿景型。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| τ-Voice Bench / Artificial Analysis 语音基准测试 | 基准测试方法 | (+/-) | 为生产环境风格的语音代理性能提供具体的领域级记分板 | 回复显示,用户仍在质疑基准测试获胜是否真能对应到真实产品质量和使用限制 |
| pgvector | 数据库 / 向量搜索 | (+) | 将嵌入保存在关系数据旁边,同时保留连接、筛选、事务和分页能力 | 并非所有工作负载都适合单一的 Postgres 式部署,尤其是在更大规模下 |
| AI-Infra-Guard | AI 安全 / 红队测试 | (+) | 覆盖 OpenClaw 扫描、代理扫描、MCP 和 skills 扫描、基础设施漏洞扫描以及越狱评估 | 自托管部署定位于内部使用,并明确缺少可公开暴露所需的身份验证 |
| agentmemory | 编程代理记忆层 | (+) | 支持跨代理记忆、本地检索、MCP 工具,以及围绕召回率和 token 节省的明确基准声明 | 仍处于早期阶段,且数据由项目方自行报告;买方需要在自己的工作流中验证这些说法 |
| Parametric CAD Bench | 领域专项评估框架 | (+) | 将代理评估扩展到 CAD,涵盖几何、约束、参数化、拓扑、工作流和效率评分 | 仍属早期基准测试,首批排行榜规模较小,且成本与质量之间的权衡清晰可见 |
| TRACER | 路由 / 成本优化 | (+) | 利用教师模型轨迹,将简单的分类流量路由到低成本 ML 替代模型,同时通过一致性门控保证质量 | 最适合重复性的分类式决策,并不适用于所有代理工作流 |

总结: 今天获得正面关注的工具,都在让 AI 变得不那么含混。两个简化模式尤其突出:其一,尽可能把 AI 功能留在现有系统内,例如 pgvector;其二,对可预测的工作,不再支付前沿模型的价格,例如 TRACER。安全技术栈也正变得更加明确:AI-Infra-Guard 和 Microsoft 的指导都把 MCP 服务器、代理工作流以及云原生部署模式视为不同的运营面,需要各自的控制措施。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| AI-Infra-Guard | Tencent Zhuque Lab | 面向 OpenClaw、代理、MCP/skills、基础设施和越狱评估的红队测试平台 | 团队需要一个统一入口,扫描 AI 技术栈中的多种风险面 | Docker、OpenClaw 扫描、Agent Scan、漏洞数据库、Web UI | 已上线 | GitHub |
| agentmemory | rohitg00 / iii engine | 面向兼容 MCP 工具的编程代理持久化记忆运行时 | 编程代理会在会话之间以及不同客户端之间丢失上下文 | Node.js、hooks、MCP、BM25 + 向量 + 图检索 | 已上线 | 网站、GitHub |
| Parametric CAD Bench | gNucleus AI | 面向代理式参数化 CAD 设计和多步骤 CAD 工作流的基准测试套件 | 通用评估无法捕捉 CAD 工作中的几何、约束和参数化正确性 | 沙箱化 CAD 评估器、几何/规格评分、排行榜 | Beta | 网站 |
| TRACER | adrida / DeepRecall | 将简单的分类调用发送给 ML 替代模型,将困难案例交回教师 LLM 处理的路由层 | 重复性的 LLM 分类工作成本过高、速度过慢,无法每次都按全价运行 | Python SDK、轨迹拟合、校准接受器、托管端点 | Beta | 网站、GitHub |
| NOVA HD Panel | Clearfield | 面向企业和数据中心互连的高密度光纤面板 | AI 机架需要更高密度、管理更好的光纤互连,同时不能增加占地 | 1RU/2RU/4RU 面板规格、NOVA 卡匣、光学模块 | 已上线 | 产品页面 |
@Dinosn 分享了(62 个赞、2,348 次浏览、44 次收藏)把 AI-Infra-Guard 展示成一个真实的产品界面,而不是概念。其 README 的细节已经足以构成构建者证据:支持 Docker 部署、本地 Web UI、OpenClaw 集成,并且有持续发布节奏,5 月 14 日已将覆盖范围扩展到 64 个 AI 组件。
@Dinosn 还指出了(14 个赞、1,311 次浏览、12 次收藏)介绍了 agentmemory。其网站将记忆描述为编程代理的基础设施,而不是某个 IDE 内的功能。其独特之处在于跨代理连续性:一个记忆运行时,服务多个兼容 MCP 的客户端,并提供本地检索以及围绕召回率和 token 节省的明确基准声明。
反复出现的构建模式,是围绕 AI 工作搭建应用层脚手架。Parametric CAD Bench 和 TRACER 都把缺失的那一层视为运营控制层:前者在特定领域内为代理工作打分,后者则在保留可测质量门槛的同时,从可预测的分类循环中剥离成本。Clearfield 的 NOVA 面板是另一种构建者信号,但它回应的是同一种底层压力:当 AI 系统从演示走向规模化部署后,瓶颈往往出现在外围系统,而不是模型本身。
6. 新的和值得注意的内容
Microsoft 量化了 MCP 暴露问题
当天最具体的新数字,来自 Microsoft 5 月 14 日发布的安全文章:其称,超过一半的云原生工作负载利用事件源于配置错误,15% 的远程 MCP 服务器存在严重安全问题,并允许未经身份验证的访问者接触敏感内部数据和运营能力(博客)。这让“代理安全风险”从一种模糊担忧,变成了可衡量的部署问题。
agentmemory 正试图把编程代理记忆变成基础设施
@Dinosn 披露了(14 个赞、1,311 次浏览、12 次收藏)介绍了 agentmemory:它面向 Claude Code、Cursor、Codex CLI、Gemini CLI 及其他兼容 MCP 的客户端,提供持久化上下文。真正有意思的地方不在于抽象的“记忆”概念,而在于它声称,一个共享运行时可以位于多个代理界面之下,并让上下文层保持本地化且可被基准测试衡量(网站)。
Parametric CAD Bench 把评估文化推进到机械设计
@gNucleusAI 宣布(45 次浏览)介绍了一项基准测试:它评估 AI 代理执行参数化 CAD 工作的能力,而不是只评估文本任务。这很重要,因为它把当天“拿出凭据来”的氛围延伸到了一个视觉相似度并不足够的领域;产物必须保持可编辑、满足约束且规格正确(基准测试)。
7. 机会在哪里
[+++] 可验证性与评估基础设施 — 跨多个章节最强的信号是,人们希望 AI 系统能够被评分、路由、证明和调试。证据横跨 Grok 的基准测试推文串、Max Levchin 访谈里“先看评估”的采购准则、FrontendMasters 对“AI 工程师”的界定、Parametric CAD Bench、TRACER,以及围绕 agentmemory 的构建者兴趣。
[+++] AI 部署瓶颈工具 — Clearfield 的高密度光纤设备、Jun Song 对供应链的警告,以及 X-energy 关于电力需求的演示文稿,都指向同一个缺口:AI 部署正与物理约束相撞。能帮助团队规划、管理或缓解这些瓶颈的产品,看起来很有潜力。
[++] 默认安全的代理部署 — Microsoft 关于不安全 MCP 服务器的硬数据,以及 AI-Infra-Guard 广泛的扫描面,都显示出一个真实需求:需要专为代理、MCP 端点和云原生 AI 应用设计的安全控制措施。
[+] 更简单的应用层 AI 架构 — pgvector、TRACER 和 agentmemory 的共同优势,都是去复杂化,而不是增加复杂度。正在浮现的机会,不是再做一个框架,而是提供工具,让团队能把 AI 留在熟悉的数据库、工作流和本地运行时中。
8. 结论
- Twitter 上的 AI 讨论,已把评估视为基本门槛,而不是可有可无的润色。 Grok 的基准测试领先、Levchin“先看评估”的采购规则,以及 FrontendMasters 提出的“构建—评估—改进”论点,都指向同一个方向。(来源)
- 领域专项基准测试正在从编程和聊天扩展到更广泛的领域。 Parametric CAD Bench 会针对代理式 CAD 任务评估几何、约束、参数化正确性和工作流成功率。(来源)
- 开发者想要的是更简单的 AI 技术栈,而不是更多活动部件。 pgvector 相关讨论认为,许多团队应把向量留在 Postgres 中;TRACER 则把可预测的工作从高成本 LLM 路径中分流出去。(来源)
- 跨代理记忆正在成为独立的产品层。 agentmemory 被定位为一种共享运行时,为多个兼容 MCP 的客户端提供编程代理上下文。(来源)
- AI 规模化正表现为光纤与电力问题,而不只是模型问题。 Clearfield 关于 384 端口面板的产品主张、Jun Song 对组件瓶颈的警告,以及 X-energy 关于电力需求的演示文稿,都让这一物理约束变得清晰可见。(来源)
- 代理安全风险已不再抽象。 Microsoft 5 月 14 日的文章称,超过一半的云原生工作负载利用事件源于配置错误,15% 的远程 MCP 服务器存在严重安全问题。(来源)
- 红队测试正在成为完整的 AI 产品类别。 AI-Infra-Guard 将代理、MCP、基础设施和越狱扫描整合到一个平台中,并保持活跃的发布节奏。(来源)
- AI 治理讨论正从企业政策扩展到中美协调。 OpenAI 治理机构相关推文串表明,即便是高层次的安全协调,如今也会在公开的 AI 时间线上展开争论。(来源)