Twitter AI - 2026-05-15
1. 人们在讨论什么
1.1 对长周期 LLM 来说,紧凑记忆状态胜过扩展上下文 🡕
当天最受关注的话题遥遥领先——得分 718.9,而排名第二的帖子仅为 298.8——是一篇彻底重构 LLM 记忆问题的论文。δ-mem 没有选择扩大上下文窗口,也不从向量库中检索文本块,而是把过去的信息存入一个固定的 8×8 联想记忆状态,并利用 delta-rule learning 在冻结模型的注意力计算内部直接生成低秩修正。结果是:仅用 4.87M 个可训练参数,就让冻结的 Qwen3-4B 平均得分提升了 4.87 分(从 46.79 提升到 51.66);在高度依赖记忆的 MemoryAgentBench 上提升 1.31×,在 LoCoMo 上提升 1.20×。模型始终不会把检索出的文本加载进提示词。记忆不是去争夺上下文槽位,而是直接引导计算。
@askalphaxiv 报道称(141 次点赞、22 次转发、100 次收藏、6,419 次浏览)介绍了这篇来自 NTU、复旦大学、Mind Lab 和 SJTU 的论文(arXiv:2605.12357v1,2026 年 5 月 12 日)。论文提出,δ-mem 可作为完整微调、更换骨干模型或扩展上下文的替代方案——而这三种方案都成本高昂,也无法保证模型真的会利用新增历史信息。文中列出的 GitHub 仓库来自 Declare-lab 和 MindLab-Research。
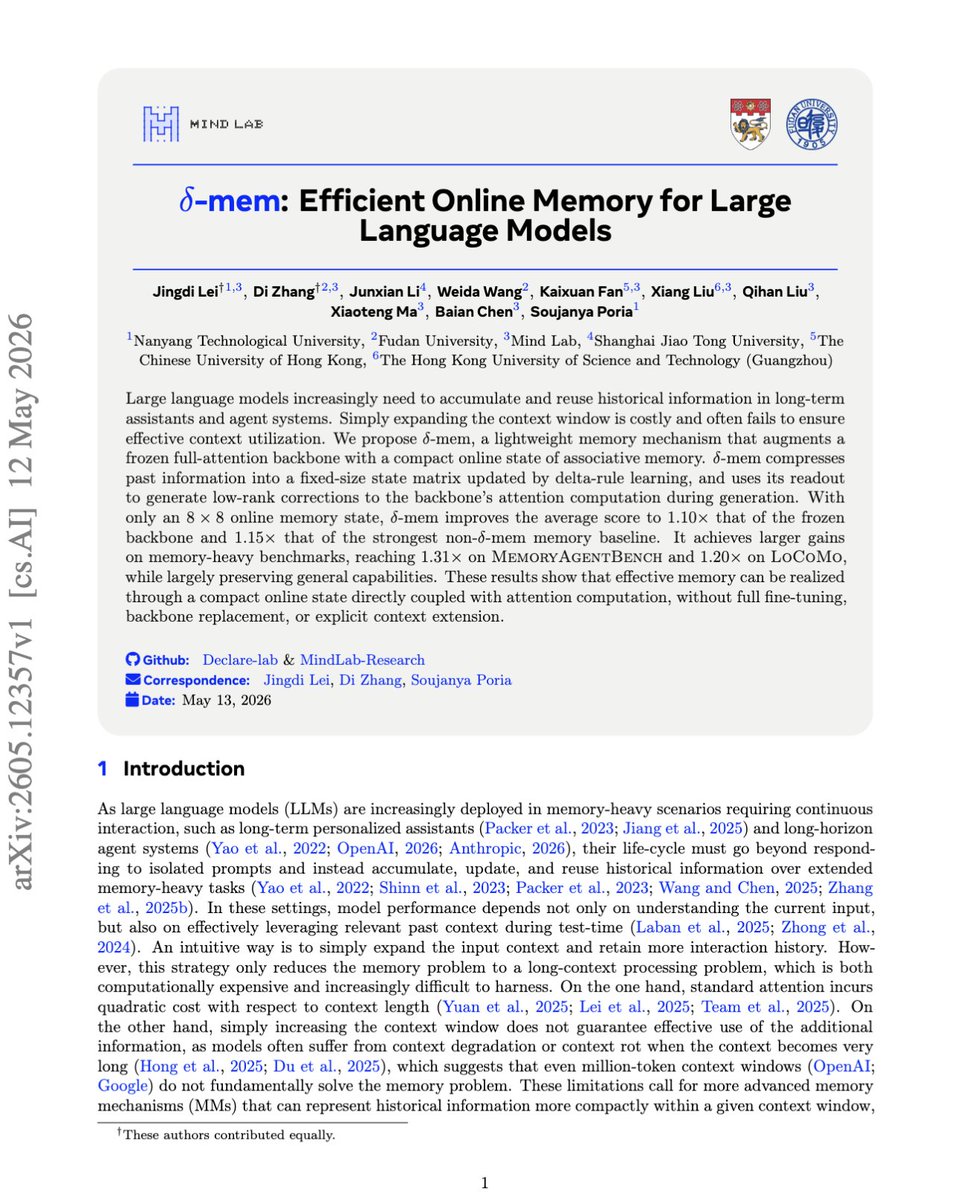
讨论洞察: @KishanVavdara 指出:“把记忆做成类似 LoRA 的低秩修正很优雅,因为它足够小,也具备可组合性”,并认为“直接引导注意力,而不是把文本检索进提示词,才是正确方向。” @AiDevCraft 补充道:“将记忆视为对冻结注意力的低秩修正,等于把检索的思路彻底翻转了——你不是在挑选该关注什么,而是在改变注意力对这个用户的工作方式。这样一来,记忆就能像 LoRA 一样跨任务组合,而不是和提示词 token 抢槽位。” 这两条回复都具有扎实的技术含量,关注点在于架构意义,而非基准分数提升本身。
与前一天对比: 5 月 14 日最强的记忆相关信号,是面向编码代理的 agentmemory MCP 层(检索 R@5 达到 95.2%)。而到 5 月 15 日,讨论又深入了一层:δ-mem 不再持久化检索已存文本,而是彻底移除检索步骤,把用户历史嵌入为对注意力权重的学习式修正。方向正在转向更小巧、更多体现为架构创新的记忆方案,而不是更大的上下文窗口或更复杂的检索索引。
1.2 代理评估正收敛到简单、可复现的模式 🡒
5 月 15 日有三条不同内容在回答同一个实操问题:从业者该如何判断,对 AI 代理做出的改动到底有没有带来提升?Kaggle 学习指南、普林斯顿/UK AISI 论文以及 JetBrains 工作坊总结在这一点上的趋同,说明评估正从事后补充,变成一项核心工程议题。
@kaggle 宣布(51 次点赞、9 次转发、43 次收藏、3,737 次浏览)介绍了一份新的端到端学习指南,涵盖结构化 LLM 输出、带工具调用的完整 ReAct 代理循环,以及在 7 个交互式 notebook 中进行并行评估,且零配置即可上手。一条只有 51 次点赞的帖子却获得了 43 次收藏,说明从业者更倾向于把它当作实用参考保存下来,而不是用于社交互动。
@Al_Grigor 分享了(14 次点赞、2 次转发、9 次收藏、595 次浏览)介绍了 Ernst Haagsman 在一次工作坊中分享的 JetBrains 评估模式。做法是:设置一个有已知正确答案的案例,提出该技能本应回答的问题,断言答案包含预期输出,然后把评估跑两遍——一次加载技能,一次不加载。两者的差值,就是该技能的价值。这个模式除了一张电子表格和子串检查外,不需要任何额外基础设施。

@safe_paper 分享了(9 次点赞、3 次转发、8 次收藏、378 次浏览)介绍了一篇来自普林斯顿、UK AISI、Apollo Research、Transluce 和 UC Berkeley 的论文。论文认为,只报告最终通过/失败结果的代理基准,会以三种方式损害评估可信度:分数可能被捷径策略人为抬高,基准表现未必能预测现实世界效用,而能力分数还可能掩盖代理执行的危险行为。论文举例显示,在检查日志后,τ-Bench Airline 的 pass^5 表现被发现低估了近 50%;这一发现对一个被广泛使用的基准结果提出了质疑。
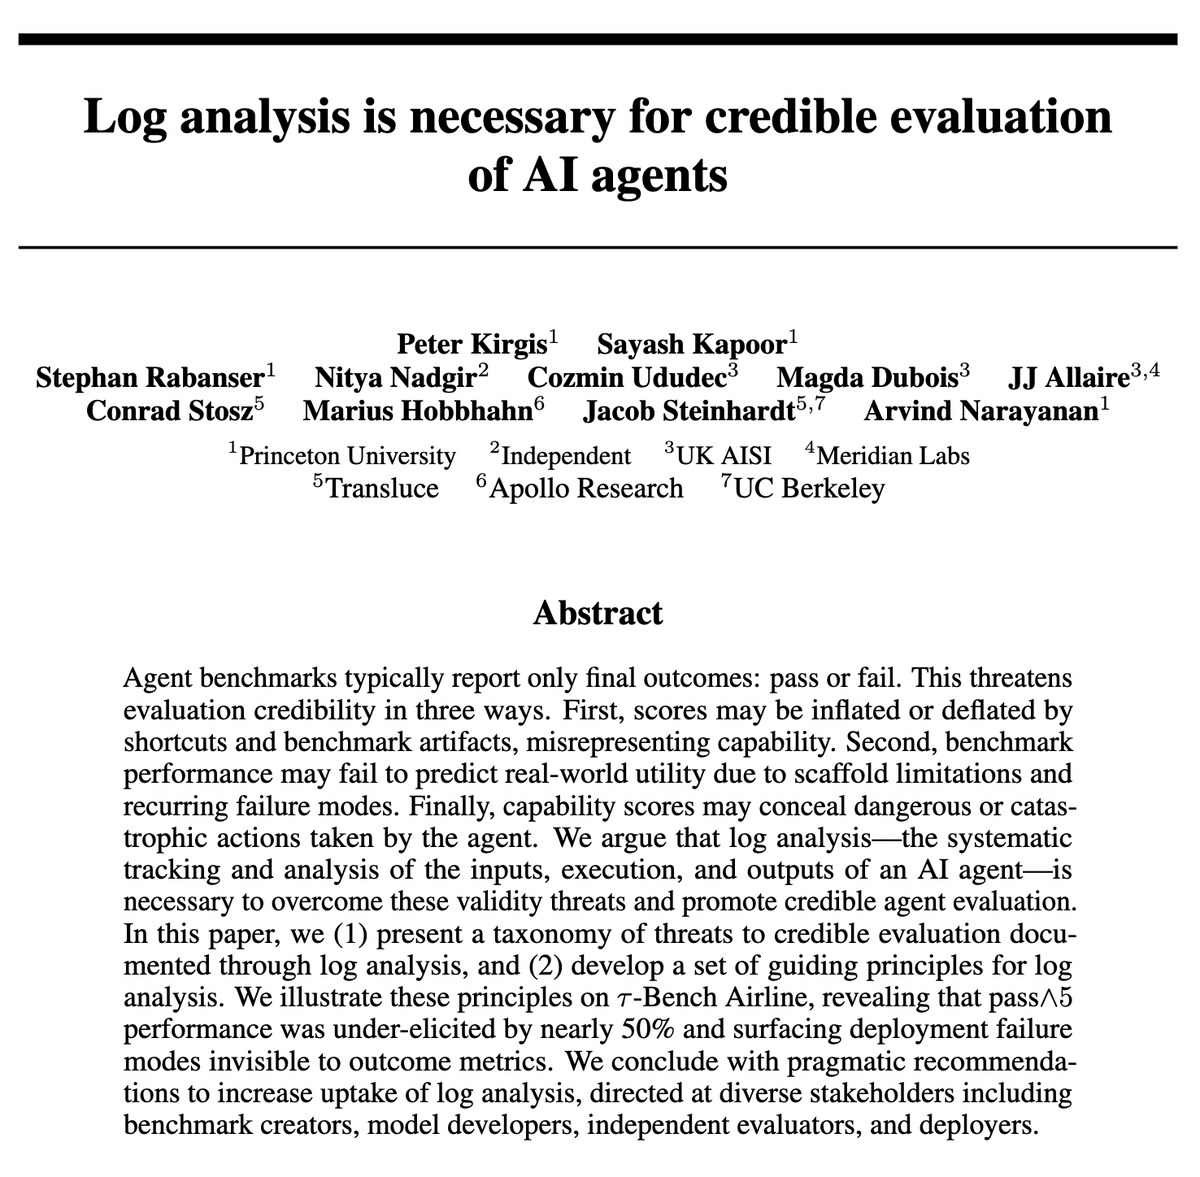
讨论洞察: 在 JetBrains 评估帖下,@JacobSobolev 指出:“最难的部分不是生成代码,而是客观衡量这次改动是否真的改善了结果。” 这篇日志分析论文的共同作者包括 Sayash Kapoor(普林斯顿 AI snake oil 研究者)和 Jacob Steinhardt(UC Berkeley 对齐研究者),为其方法论增添了可信度。
与前一天对比: 5 月 14 日把 AI 工程概括为“构建—评估—改进循环”,并介绍了面向 CAD 的 Parametric CAD Bench。5 月 15 日则展示了三个独立团队如何在不同层面把这一循环落地:Kaggle 对应课程层,JetBrains 对应提示词工程层,普林斯顿/UK AISI 对应基准有效性层。
1.3 异构 AI 推理经济学:SRAM 路线初创公司正收缩到更明确的利基市场 🡒
当天技术讨论中得分第二高的话题,是一篇长篇分析,讨论在 Nvidia 的 GTC 2026 发布之后,SRAM 路线 AI 加速器在异构推理架构中究竟适合扮演什么角色。分析依据是 Nvidia 自己发布的一张图:片上 SRAM 加速计算可提供快速的单用户响应,而 HBM-GPU 集群负责大规模吞吐。结论是,SRAM 路线公司只有聚焦解码阶段的 FFN 层,而不是做全栈推理,才具备可持续的经济性。
@fi56622380 认为(32 次点赞、7 次转发、23 次收藏、7,186 次浏览)指出,Cerebras 的 CS-3 系统单芯片售价 $2.3M,按推算隐含租赁价格为 $41.96/小时(约为 B200 的 10 倍),因此无法在全栈推理上产生商业价值,因为光是长上下文 agentic 工作流的 KV cache,就会耗尽芯片全部 44GB SRAM。对 Cerebras 来说,可持续路径是把 SRAM 芯片嵌入其他公司的 decode-FFN 流水线。帖子提到,Google 的 TPU 已采用 Marvell,AWS Trainium 已采用 Cerebras,ByteDance 的 ASIC 已采用 Qualcomm——这些都用于解耦式推理中的 SRAM 组件。分析最后认为,Cerebras 估值的关键在于,它与 AWS Trainium 的集成到底能做到多深,而不只是简单的 prefill/decode 拆分。

@OwenGregorian 指出(7 次点赞、1 次收藏、922 次浏览)另有帖子指出,十年前曾把公司命运押在晶圆级芯片上的 Cerebras,如今据 The Register 报道估值已达 $66 billion。Bloomberg @business 报道称(9 次点赞、4,571 次浏览)则指出,随着 AI 交易从芯片制造商扩展到实体 AI 公司,机器人已成为亚洲最热门的股票主题之一。
讨论洞察: @iamkunhello 回复称:“真正的结构性机会不在芯片本身,而在芯片之间的交接协议。谁掌握这层集成,谁就能拿到利润。” 这正是该分析所指向的集成层洞见。
与前一天对比: 5 月 14 日讨论 AI 基础设施时,重点在光纤密度、散热和电力约束。5 月 15 日则从物理层转向经济层:在新的推理负载形态下,哪些芯片架构能创造商业价值;在 GTC 发布 Rubin+LPX 之后,SRAM 路线初创公司又该如何重新定位。
1.4 中国 AI:效率提升、香港访问受限,以及中美 AI 护栏对话 🡕
三条内容围绕中国在 AI 格局中的位置形成了一个清晰的主题:一则中国模型公告声称大幅降低成本并取得顶级基准成绩,一篇被广泛阅读的香港 LLM 访问限制报道,以及一则简短但重要的特朗普与习近平就 AI 护栏进行交流的报道。
@KushalShah50836 分享了(69 次点赞、6 次转发、24 次收藏、31,585 次浏览)指出,Anthropic、Google 和 OpenAI 以数据监管问题为由,限制香港用户直接访问旗舰模型。这是整个数据集中浏览量最高的内容。帖文中提到的 Citadel 背景(对冲基金量化团队迁移相关报道)也说明,这项限制影响的不只是普通消费者,也波及金融和量化研究业务。
@JulianGoldieSEO 报道称(35 次点赞、5 次转发、17 次收藏、1,996 次浏览)指出,百度 Ernie 5.1 已升至全球第 4,在代理基准上优于 DeepSeek,在竞赛级数学测试中拿到 99.6 分,且训练成本仅为标准成本的 6%——也就是训练开支降低了 94%。该模型可免费使用。
@Polymarket 报道称(16 次点赞、12 条回复、1,249 次浏览)指出,特朗普称自己曾与习近平讨论人工智能护栏,随后还创建了一个预测市场,给“正式宣布中美 AI 安全沟通渠道”赋予 15% 的概率。一条回复把这一刻形容为“基本上就是 AI 时代的核军控谈判”。
讨论洞察: 这条访问限制相关帖子没有收到任何公开回复。对一条有 31,585 次浏览的帖子来说,这很不寻常。缺乏反驳意味着,这项限制要么早已广为人知,要么已被视为既定监管事实。Polymarket 市场则显示,社区并未把特朗普与习近平的通话视作一次性事件,而是在积极为后续协调的概率定价。
与前一天对比: 5 月 14 日讨论的是 OpenAI 提出的 IAEA 式治理方案。到了 5 月 15 日,则出现了两个更具体的体现:一是特朗普与习近平的双边对话,而不只是智库式提案;二是香港已经落地的现实访问限制。
1.5 思维链劫持:推理越强,安全护栏反而越容易被绕过 🡕
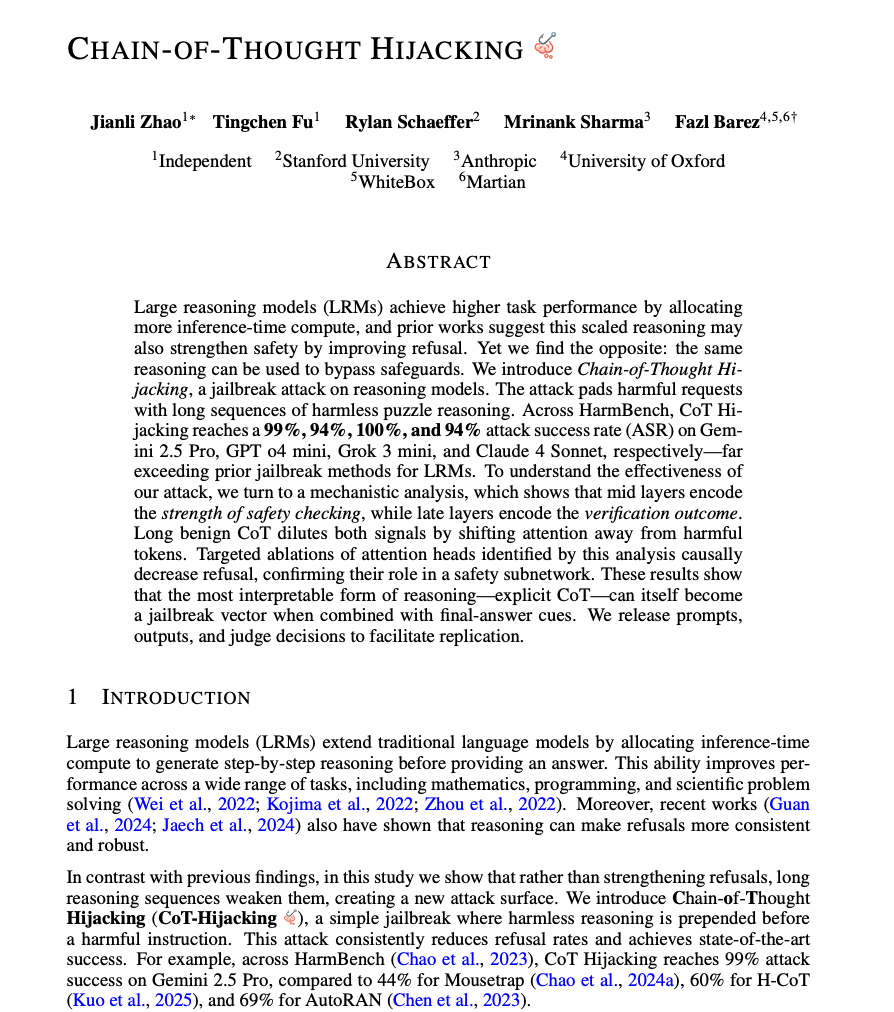
来自 Stanford、Anthropic、Oxford、WhiteBox 和 Martian 的一篇论文提出了一种越狱技术,利用的恰恰是各大实验室一直强调的安全优势:扩展式思维链推理。该攻击会在有害请求前后填充大量无害的谜题推理,从而稀释模型安全检查所依赖的注意力信号。攻击成功率非常惊人:在 HarmBench 上,Gemini 2.5 Pro 为 99%,Grok 3 mini 为 100%,GPT o4 mini 为 94%,Claude 4 Sonnet 也为 94%,远高于此前针对大型推理模型的越狱方法。
@CodeByPoonam 分享了(2 次点赞、1 次转发、5 次收藏、455 次浏览)分享了论文摘要图。论文给出的机制性发现很具体:中间层编码安全检查强度,后期层编码验证结果。长篇无害 CoT 会把注意力从有害 token 上移开,从而同时稀释这两类信号。论文还公开了提示词、输出和评审结论,以便复现。
@LilithDatura 指出(1 次点赞、2 次转发、2 次收藏、129 次浏览)另有帖子指出,Anthropic 的 Claude Mythos Preview AI 曾被安全研究人员用于发现两个 macOS 内核漏洞,并将其串联成一个权限提升利用链。这属于另一类安全面向(攻击能力),但也处于同一信号簇中:推理模型正在创造新的攻击面。
讨论洞察: 思维链劫持论文的作者中包括 Anthropic 研究人员,因此这既是外部攻击报告,也是一种内部自我审视。Grok 3 mini 达到 100% 攻击成功率是最醒目的 headline number;而真正对安全训练和架构有启发意义的,是其机制解释——中间层中的注意力被稀释。
与前一天对比: 5 月 14 日讨论了 Microsoft/UK AISI 的政府安全评估合作,以及 MCP 服务器配置错误。到了 5 月 15 日,新增的是一个更基础的机制性担忧:那些被宣传为让模型“更安全”的推理能力,可能恰恰也是它们更容易被越狱的原因。
2. 什么让人感到挫败
基准分数掩盖了代理在生产环境中的真实行为
@safe_paper 分享的日志分析论文(帖子,9 次点赞、8 次收藏)指出,最终结果型基准会通过三种方式误导人们对代理能力的判断:捷径会抬高或压低分数;由于 scaffold 限制,基准表现无法预测现实世界效用;能力分数还可能掩盖代理采取的危险甚至灾难性行动。论文给出的具体数字是,在检查日志后,τ-Bench Airline 的 pass^5 表现被发现低估了近 50%。这个可验证的数字让这种挫败感变得非常具体。@JacobSobolev 回复道:“最难的部分不是生成代码,而是客观衡量改动是否真的改善了结果。我们需要更好的提示词工程指标。” 这也构成了应对信号:从业者正在自己搭建轻量级评估(JetBrains 模式、Kaggle 指南),而不是直接相信公开基准。严重程度:高。值得构建:是。
被宣传为更安全的推理模型,反而拥有最高的越狱成功率
思维链劫持论文由 Anthropic 研究人员部分参与撰写,结果显示:在有害请求中填充无害推理链后,Grok 3 mini 的攻击成功率达到 100%,Gemini 2.5 Pro 和 Claude 4 Sonnet 也达到 94%-99%。这种挫败感——也被那些曾把“扩展推理 = 更安全”当作部署标准的从业者隐含表达出来——在于:被作为安全改进卖点的功能,本身就是攻击向量。@CodeByPoonam 的帖文(帖子,5 次收藏)直白地写道:“实验室拿来宣传‘更安全’的那个功能,正是击穿安全护栏的那个功能。” 现有帖子里没有给出解决办法;论文只是公开了提示词和结果供复现,这意味着社区接下来需要验证和跟进,而不只是阅读。严重程度:高。值得构建:是,尤其是面向 CoT 攻击的检测与缓解。
前沿 LLM 的访问在地域上并不均衡,而且限制还在收紧
@KushalShah50836 发布了(69 次点赞、24 次收藏、31,585 次浏览)指出,Anthropic、Google 和 OpenAI 因数据监管问题限制了香港用户访问旗舰模型。这里的挫败感是结构性的:量化研究业务(帖文中的 Citadel 背景)以及香港其他专业用户,对最强模型的访问能力正在下降,而且看不到明确的恢复时间表。数据中呈现的应对方式只是部分缓冲:百度 Ernie 5.1 作为免费、可本地访问的替代方案,能填补一部分空缺,但中美前沿模型在原始能力上的差距仍存在争议。严重程度:对受影响用户来说为高。值得构建:面向受限司法辖区用户的代理与访问层方案。
AI 初创公司的营销让从业者感到尴尬
@skeptrune 发布了(45 次点赞、24 条回复、2,574 次浏览)分享了一张纽约公交候车亭的 Artisan AI 广告照片,文案是“Ava 2.0 is the only autonomous AI BDR. Hire Ava, the AI BDR.” 帖子称其“非常不幸”,并表示这“让我们所有在旧金山的人都丢脸”。回复中还确认,ChatGPT、CodeRabbit、Traversal 和 Airops 也都在地铁投放广告,但纽约 AI 户外广告的整体质量低于从业者预期。应对方式目前主要是与低质量营销保持距离,但真正的挫败感在于声誉风险:糟糕的 AI 广告会塑造消费者对整个品类的观感。严重程度:中。值得构建:面向进入消费者广告市场的 AI 公司的品牌策略或创意质量信号。
3. 人们希望出现什么
无需基础设施的代理评估
JetBrains 评估模式(@Al_Grigor、帖子,9 次收藏)和 Kaggle 指南(@kaggle、帖子,43 次收藏)都指向同一个愿望:在不用先搭建评估基础设施的前提下,也能对 AI 编码技能和代理进行可重复、可靠的评估。JetBrains 模式明确写道:“第一版可以只是电子表格里的 10 个案例。不需要基础设施,也不需要代理。只要有已知正确答案的场景、一个给输出打分的方法(子串检查通常就够了),以及把每个案例跑不止一次的纪律。” Kaggle 指南获得 43 次收藏,说明大量从业者希望有一条从结构化输出 → ReAct 循环 → eval 的结构化路径,而不是一切都从零设计。这是一个已有部分答案开始交付的实际需求。机会:直接。
不需要提示词工程或额外基础设施的 LLM 记忆
δ-mem 论文(@askalphaxiv、帖子,100 次收藏、6,419 次浏览)回应了一个非常具体的愿望:记忆机制不应依赖把检索文本塞进提示词,不应依赖扩展上下文窗口,也不应要求应用单独维护一个记忆存储。100 次收藏是全数据集最高值,说明从业者正在把它保存为一个现实问题的潜在解法。大家想要的是一种“开箱即用”的记忆:跨任务可组合、不侵入应用、体积足够小,小到不需要改动基础设施就能部署。机会:直接,这篇论文可以作为起始蓝图。
能以低成本匹敌甚至超越昂贵专有替代方案的领域 LLM
@pyquantnews 发布了(24 次收藏)分享了 FinGPT 与 BloombergGPT 的对比:微调成本 $300 对 $5M,GPU 时长 80 对 1.3M,开源对闭源。一条只有 17 次点赞的帖子却有 24 次收藏,说明从业者保存它主要是作为成本参考,而不是出于社交互动。同样的愿望也出现在 Ring-2.6-1T 公告(@DataChaz、帖子,8 次收藏)和 Intern S2(@AdinaYakup、帖子,10 次收藏)中:希望有无需支付前沿模型价格、却能处理专业领域任务的开源模型。机会:对于构建微调工具、领域数据集或开源模型部署基础设施的人来说,这是直接机会。
面向 CoT 攻击的 AI 安全检测
思维链劫持论文没有给出修复方案——它发布的是攻击本身。现在,从业者需要针对“以无害推理填充有害请求”这一攻击向量的检测或缓解工具。论文关于中间层注意力稀释的机制性发现,提供了一个潜在检测信号,但在这组数据里还看不到解决该问题的现成工具。隐含的愿望很明确:既然 100% 的攻击成功率已经被公开,而且可复现,那么部署推理模型到敏感场景之前,下一步就需要有办法识别或拦截这类攻击。机会:竞争性机会。主要实验室(Anthropic 研究人员已经在做这方面研究)很可能会推出补丁,但第三方检测工具仍有窗口期。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Kaggle 学习指南(ReAct / 代理评估) | 代理教育 | (+) | 7 个交互式 notebook,零配置,覆盖从结构化输出到完整评估循环 | 没有迹象显示其覆盖 ReAct 之外的高级模式 |
| Gradium | 语音 AI / TTS | (+) | 在 Coval TTS 基准的 TTFA(158ms)和 WER(3.6%)上领先,支持语音克隆与定制,并提供情感化模型 | 成立仅 9 个月,企业级落地记录有限 |
| Coval | 语音 AI 基准 | (+) | 第三方、独立衡量 TTS 延迟与准确率;从业者将其作为选型标准 | 聚焦语音,不覆盖其他代理模态 |
| Claude Code (Anthropic) | AI 编码助手 | (+/-) | 从业者采用率高;JetBrains 已围绕其构建技能生态;评估模式正在浮现 | 思维链劫持论文中,Claude 4 Sonnet 的越狱攻击成功率为 94% |
| δ-mem | LLM 记忆 | (+) | 4.87M 个可训练参数,无需扩展上下文,可组合,运行时无需检索 | 目前仍停留在研究阶段,尚未部署到产品中 |
| Qwen3-4B(δ-mem 的骨干模型) | LLM | (+/-) | 作为 δ-mem 评估中的冻结骨干模型,展示出显著增益 | 本数据集中没有对其独立表现进行直接评估 |
| OpenAI GPT o4 mini | LLM / 推理 | (+/-) | 被广泛用作参考模型,在通用基准上有竞争力 | 思维链劫持攻击成功率为 94% |
| Grok 4.3 / Grok 3 mini | LLM | (+/-) | 集成进 Chance AI 预测市场代理;因推理基准表现而被提及 | Grok 3 mini 的思维链劫持攻击成功率为 100%;Grok 4.3 只出现在非原始来源中 |
| Gemini 2.5 Pro | LLM | (+/-) | 在基准上表现强劲 | 思维链劫持攻击成功率为 99% |
| InternLM / Intern S2 Preview (35B) | 科学多模态 LLM | (+) | 在科学/数学基准上领先于 Qwen3.6-35B、Gemma4-26B、Claude Haiku-4.5;采用 Apache 2.0 许可 | 仍处于预览阶段;尚无生产部署报告 |
| Ring-2.6-1T (AntLingAGI) | 开源 LLM | (+) | Tau2-Bench 95.32,GPQA Diamond 88.27;可处理长周期工作流;已直接用于 IDE 调试 | 推理时规模达 1T 参数;未讨论硬件要求 |
| FinGPT | 领域 LLM(金融) | (+) | 微调成本 $300,对比 BloombergGPT 的 $5M;GPU 时长 80,对比 1.3M;开源 | 帖文中未引用独立质量基准 |
| Ernie 5.1 (Baidu) | LLM(中国) | (+/-) | 声称全球第 4;训练成本降低 94%;免费;在代理基准上优于 DeepSeek | 公开来源尚未验证这些说法;中国以外用户也无法独立验证基准 |
| SRAM 路线加速器(Cerebras CS-3) | AI 推理硬件 | (-) | 对小 batch、低延迟负载可提供峰值 token 速度 | 隐含租赁价格 $41.96/小时(约为 B200 的 10 倍);单芯片在 1-2M 上下文下会被 KV cache 耗尽;经济性仅适用于解码阶段 FFN |
| HBM-GPU(Nvidia Rubin + LPX) | AI 推理硬件 | (+) | 在维持商业级吞吐的同时,将帕累托前沿扩展到 >1000 tokens/s;在 400 tokens/s 下,吞吐较 Blackwell 提升 35× | 无法取代 SRAM 在单用户响应延迟极限场景中的优势 |
总结: 整体情绪呈明显分化。在研究层面,新的开源模型(Intern S2、Ring-2.6-1T)和新技术(δ-mem)因其在成本/性能权衡上可匹敌甚至优于专有方案而获得正面关注。在安全层面,几乎所有主流推理模型都出现在思维链劫持攻击成功率表中,这削弱了人们对前沿 LLM 的单纯乐观情绪。在硬件层面,SRAM 路线芯片并没有出局,但其经济性被压缩到一个明确利基:解码阶段 FFN 卸载。从业者正在消化 GTC 的 Rubin+LPX 架构对 AI 芯片初创公司估值的影响。
迁移模式:FinGPT 与 BloombergGPT 的成本对比,说明金融从业者正在评估是否应停止为专有领域 LLM 付费,转而采用开源微调替代方案。Coval 排行榜则正在充当语音 AI 的模型选型机制,Gradium 至少在一次生产部署中取代了原有语音供应商(OpenAI、ElevenLabs、Cartesia、Deepgram)。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| δ-mem | NTU / Fudan / Mind Lab / SJTU | 通过一个 8×8 联想记忆状态增强冻结 LLM,并为注意力生成低秩修正 | LLM 会跨会话遗忘;扩展上下文成本高且效果不稳 | 冻结的 Qwen3-4B 骨干模型、delta-rule learning、低秩修正 | Alpha(研究论文,GitHub 可用) | arXiv:2605.12357 |
| Kaggle AI 代理学习指南 | Kaggle / @huangan_2606 | 7 个交互式 notebook,覆盖从结构化 LLM 输出到 ReAct 循环、工具调用与并行评估 | 从业者缺少一条零配置、端到端构建并评估代理的路径 | Python、Kaggle notebooks、ReAct 模式 | 已发布 | Kaggle |
| Intern S2 Preview | Shanghai AI Lab (InternLM) | 科学多模态模型:晶体结构生成、科学代理工作流、工具调用 | 通用模型在专业科学基准上表现不足 | 35B-A3B mixture、Apache 2.0、“Task Scaling” | Beta(预览版) | intern_lm |
| Ring-2.6-1T | AntLingAGI | 面向长周期工作流和复杂 API 任务的万亿参数开源模型 | 专有 LLM 在 agentic、长上下文编码与调试中的成本过高 | 1T parameters、长上下文、IDE 集成 | 已发布(开源) | No public repo cited |
| FinGPT | AI4Finance Foundation | 开源金融 LLM,提供公开模型、数据集和训练流水线 | BloombergGPT 成本高达 $5M 和 1.3M GPU hours,大多数从业者难以承受 | LLM 微调、$300 成本、80 GPU hours | 已发布 | GitHub |
| Gradium 语音模型 | Gradium AI | 在 Coval 基准的 TTFA(158ms)和 WER(3.6%)上领先;支持语音克隆与定制 | 现有语音 AI 模型在延迟和准确率上输给了一家仅成立 9 个月的新玩家 | 专有语音 AI 技术栈 | 已发布 | coval.dev |
| OpenClaw 语音代理演示 | chadbailey59 / kwindla | 两个语音 AI 代理在一款 LLM 游戏中互动——一个忧郁的飞船 AI,一个开朗的 OpenClaw 机器人——进行无脚本实时对话 | 开源多人 LLM 游戏此前没有无脚本的多代理语音互动 | Gradium 语音模型、OpenClaw 代理框架 | 已发布(演示) | 帖子 |
值得关注的构建模式:
δ-mem 论文是当天技术辨识度最高的项目。它的做法是:用 delta-rule learning 更新固定大小的 8×8 状态,并据此生成对冻结注意力的低秩修正;这一项架构决策就同时绕开了三种常见方案:完整微调、更换骨干模型和扩展上下文。4.87M 个可训练参数本身就是信号:这是一层可叠加在任何冻结全注意力模型之上的记忆层,而不需要模型所有者重新训练底座模型。论文中还引用了 GitHub 仓库 Declare-lab 和 MindLab-Research 以便复现。
Intern S2 Preview 将“Task Scaling”引入为参数和数据之外的新扩展维度。基准表显示,这个 35B 模型在多数科学专用基准上领先于 Qwen3.6-35B、Gemma4-26B 和 Claude Haiku-4.5,包括 MicroVQA(66.22)、MolecularIQ(57.26)、IMO-BenchAnswerBench(84.00)、MathVision(83.36)、HMMT-2026(87.31)和 PinchBench(88.22)。Apache 2.0 许可,以及“晶体结构生成 + 科学代理工作流”的组合,使它成为少见的、明确面向科学研究的开源模型。
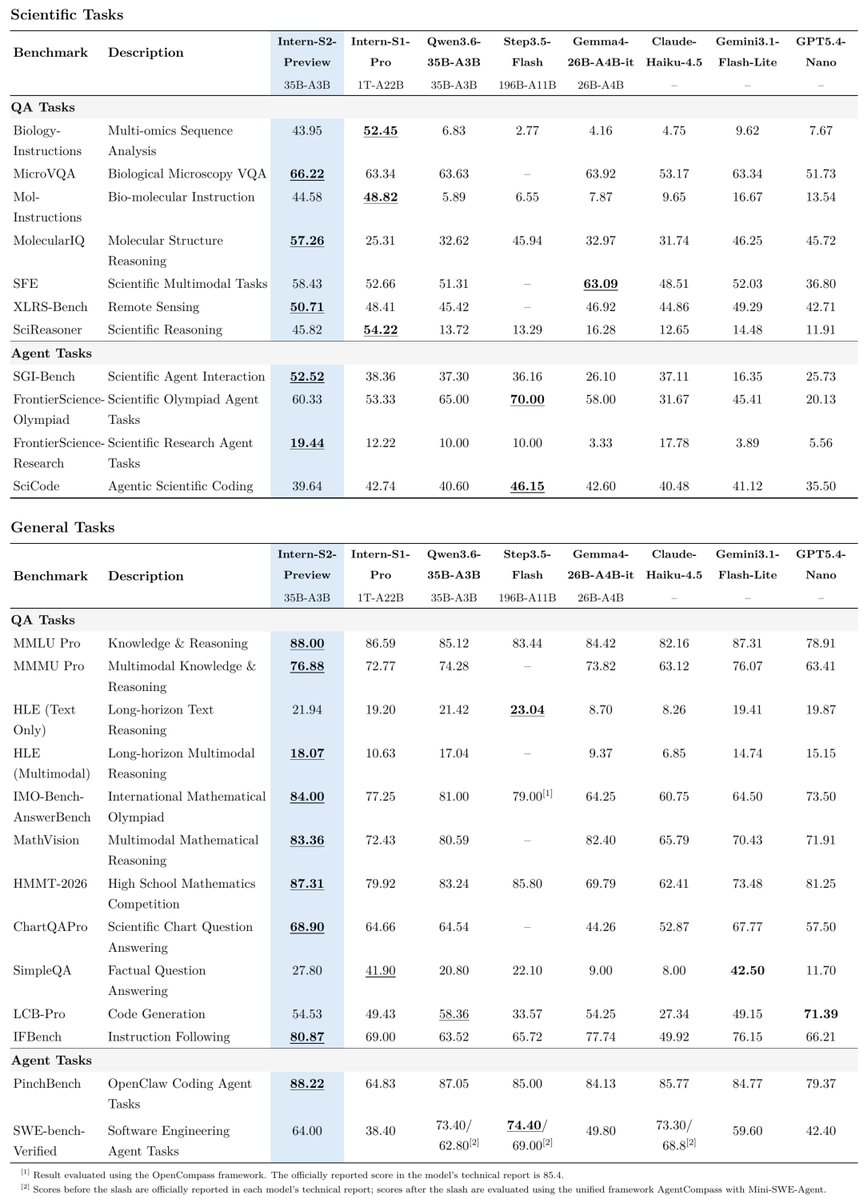
Intern S2、Ring-2.6-1T 和 FinGPT 这三个项目,分别从不同方向回应了同一个触发性痛点:在专业领域里,专有前沿模型与开源替代方案之间存在明显的成本与可得性差距。
6. 新内容与值得关注的动态
Coval TTS 基准让 Gradium 成为一次生产部署中的默认语音模型
@mattturck 确认(10 次点赞、3 次转发、5 次收藏、2,221 次浏览)指出,成立仅约 9 个月的 Gradium AI,在 Coval 语音 AI 基准的延迟和准确率两项指标上都排名第一。Coval 截图显示:最快 TTFA 为 158ms(Default Gradium),最低 WER 为 3.6%(Gradium)。@kwindla 展示了(30 次点赞、4 次转发、3 次引用、14 次收藏、1,417 次浏览)则展示了 Gradium 在一个开源大型多人 LLM 游戏中被设为默认语音:两个语音代理进行无脚本实时互动——一个是忧郁的飞船 AI,另一个是拥有鲜明定制人格、性格开朗的 OpenClaw 机器人。

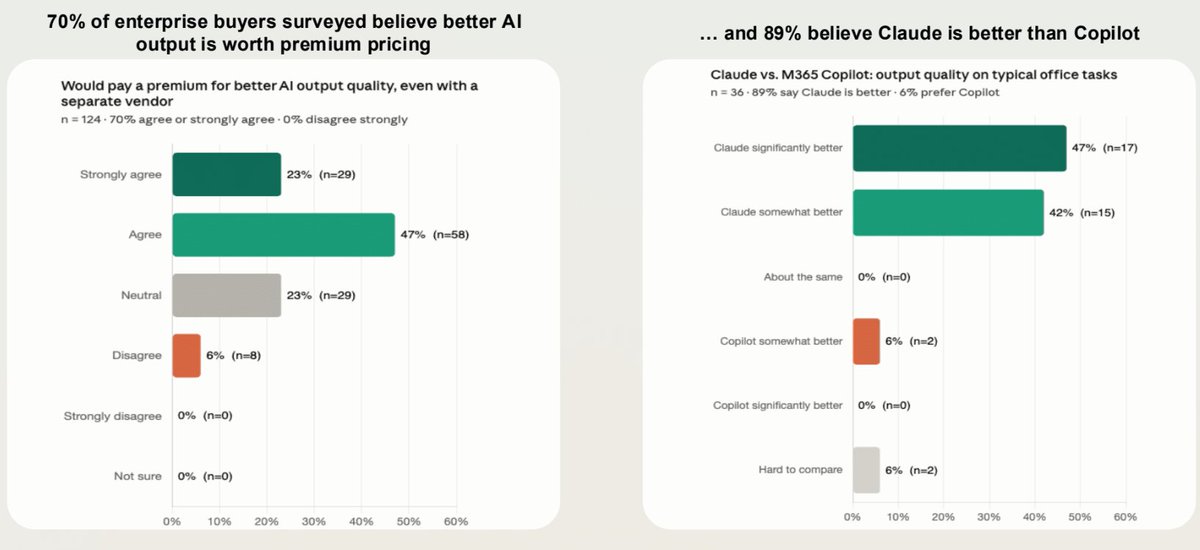
企业买家明显更偏好 Claude 而非 M365 Copilot;70% 愿意为质量支付溢价
@JaredSleeper 分享了(6 次收藏、864 次浏览)分享了一篇对微软 AI 业务“第 50 天拆解”的帖子,其中包含一项买家调查:124 名企业买家中,有 70% 表示,即便更好的 AI 输出质量来自另一家供应商,他们也愿意支付溢价;在 36 名受访者中,有 89% 认为 Claude 在典型办公任务上优于 M365 Copilot(47% 认为“Claude 明显更好”,42% 认为“Claude 略好”,只有 6% 认为“Copilot 略好”)。该拆解提到,微软在 CY26 第一季度的 AI 收入达到 $37B,同比增长 123%;但也指出,在企业编码与生产力领域,Anthropic 已在 GitHub Copilot 之上成为新的标杆。
AI 训练数据劳动力市场活跃,并已超出传统标注范围
@AmControo 列出了(12 次点赞、10 次转发、15 次收藏、441 次浏览)分享了远程 AI 评估岗位,其中包括 Turing 招聘的 AI Voice/Audio Specialist,时薪 $20-60。@OlatunjiAyokan2 分享了(15 次点赞、12 次收藏、2,011 次浏览)则展示了一则 Turing 招募小企业主担任 AI 评估员、参与一个 10 周项目的招聘信息。两条帖子都在强化同一个事实:前沿实验室的训练流水线仍依赖人类判断来完成领域化评估,这也印证了 INOD 关于训练数据瓶颈的论点。
Microsoft 与美英 AI 安全研究机构正式建立评估合作
@BradSmi 宣布(15 次点赞、2 次转发、1,270 次浏览)指出,Microsoft 正与 CAISI(美国)和 AI Security Institute(英国)合作,推进针对高级 AI 风险的 AI 评估科学。这是对日志分析论文所指出同一可信度缺口的制度化回应。
7. 机会在哪里
[+++] 轻量级代理评估工具 —— JetBrains 评估模式(9 次收藏)、Kaggle 代理指南(43 次收藏)和日志分析论文共同指向一个缺口:目前没有标准工具,能对 AI 编码技能和代理提示词执行简单、可重复、无需基础设施的评估。JetBrains 记录下来的模式——安排、执行、断言;分别在有和没有改动时各跑一次;从 10 个电子表格案例加子串检查起步——今天就可落地。日志分析论文则表明,现有评估框架会系统性地低估能力(τ-Bench Airline 上存在 50% 的差距)。机会在于做一个面向 AI 技能、系统提示词和小型代理循环的轻量级开源评估 harness。需求信号:Kaggle 指南 43 次收藏,JetBrains 模式 9 次收藏,日志分析论文 8 次收藏。
[+++] 避免扩展上下文的 LLM 记忆层 —— δ-mem 的结果(100 次收藏,为全数据集最高)表明,一个 4.87M 参数的模块,无需扩大上下文窗口,就能在冻结模型上带来可测量的得分提升。从业者称其“像 LoRA 一样具备可组合性”。机会在于为主流模型托管平台构建 δ-mem 风格的生产级记忆适配器——价值主张是:“跨会话记住用户,不额外消耗 token,也不用维护检索数据库。”
[++] CoT 越狱检测与缓解 —— 思维链劫持论文记录了 Gemini 2.5 Pro、GPT o4 mini、Grok 3 mini 和 Claude 4 Sonnet 上 94%-100% 的攻击成功率。其机制性发现——中间层注意力稀释是关键信号——为检测提供了目标。实验室会修补模型,但第三方检测中间件或监控层仍有窗口,可以在生产推理流水线中标记那些用无害推理填充的有害请求。
[++] AI training data and evaluation as a recurring platform business — The INOD thesis from @theaiportfolios(帖子,21,782 次浏览)显示,2026 年约 $725B 的超大规模云服务商资本开支承诺,迫使前沿实验室以内部人工标注团队无法匹配的速度推进模型开发。INOD 的 Q1 财报(毛利率从 42% 升至 47%,EBITDA 为 28%,新增 Big Tech 合作额 $51M,而一年前为零)表明,市场确实存在,而且正从项目型、波动大的收入模式转向平台型收入。对创业者而言,近期机会在于专业领域评估(商业上下文、语音、医疗、法律)——这是通用标注公司难以匹敌的方向。
[++] 开源领域 LLM 微调工具链 —— FinGPT(微调成本 $300,80 GPU hours)与 BloombergGPT($5M,1.3M GPU hours)的对比,是这组数据中收藏最多的成本比较之一(24 次收藏)。Intern S2 的“Task Scaling”概念和 Ring-2.6-1T 的长周期能力主张也指向同一方向:专业化开源模型正以极低的训练成本,在领域任务上匹敌甚至超越专有模型。机会在于微调工具链、领域数据集整理,以及面向那些希望以非专有价格获得专有级效果的从业者的部署基础设施。
[+] 语音 AI 评估与部署工具 —— Gradium 在 Coval TTS 基准上排名第一(TTFA 158ms,WER 3.6%),并在同一天获得了一位风投和一位从业者的两次独立确认。Coval 排行榜正在成为实际采购标准。机会在于基于 Coval 基准框架继续构建——无论是去争夺榜首,还是建立以 Coval 为参考基准、用于生产环境语音代理质量保障的评估工作流。
[+] 受限司法辖区的 LLM 访问与合规层 —— Anthropic、Google 和 OpenAI 因数据监管问题限制了香港用户访问旗舰模型(31,585 次浏览、24 次收藏)。金融和量化研究领域的专业人士正直接受到影响。Ernie 5.1 能覆盖部分使用场景,但不是通用替代品。机会在于合规代理服务、可本地部署的开放权重替代方案(Ring-2.6-1T、Intern S2),或面向数据受监管市场组织的微调流水线。
8. 要点
-
当天收藏最多的内容(100 次收藏)是一篇记忆架构论文,而不是产品。 δ-mem 的 8×8 联想状态,用 4.87M 个可训练参数就在冻结的 Qwen3-4B 上带来了 +4.87 的得分提升;从业者正把它保存为一种无需扩展上下文的生产级记忆参考方案。(帖子)
-
代理评估正收敛到一种简单的最小可行模式。 三个独立来源——Kaggle(43 次收藏)、JetBrains(9 次收藏)以及一篇来自普林斯顿/UK AISI/UC Berkeley 的论文——都落在 arrange-act-assert 这一核心评估循环上。JetBrains 的表达最具可操作性:10 个电子表格案例、子串检查、在有和没有改动时各跑一次。(帖子)
-
思维链劫持在 Grok 3 mini 上实现了 100% 的攻击成功率,在另外三个前沿模型上也达到 94%-99%。 该攻击通过在有害请求中填充无害谜题推理,稀释中间层中的安全检查注意力。论文由 Anthropic 研究人员共同署名。(帖子)
-
当天浏览量最高的帖子(31,585 次浏览)讨论的不是模型发布,而是 LLM 访问限制。 Anthropic、Google 和 OpenAI 因数据监管问题限制了香港用户访问旗舰模型。这是 5 月 15 日触达面最广的 AI 地缘政治事件。(帖子)
-
SRAM 路线 AI 芯片初创公司,只有作为 decode-FFN 卸载合作方,而不是全栈推理提供商,才具备可持续经济性。 Cerebras 的 CS-3 按推算租赁价格为 $41.96/小时(约为 B200 的 10 倍);单次 1-2M 上下文的 agentic 会话,仅 KV cache 就会耗尽其 44GB SRAM。前路在于嵌入 AWS Trainium 或 Google TPU 的异构推理流水线,而不是与 HBM-GPU 集群正面竞争。(帖子)
-
在受访企业买家中,89% 更偏好 Claude 而非 M365 Copilot,70% 愿意为更高质量的 AI 输出支付溢价。 这只是帖子层面的调查证据(Claude 对比样本量 n=36),并非经过审计的正式研究,但其方向与 Claude 在整个 5 月数据集中积累的从业者口碑一致。(帖子)