Twitter AI - 2026-05-16
1. 人们在讨论什么
1.1 信任与评估正从抽象原则走向具体的 AI 运营 🡕
5 月 16 日,AI 领域最强烈的讨论围绕“信任正在变得可操作”展开。不同于又一轮泛泛而谈的“AI 需要护栏”,最有实质内容的帖子聚焦于具体的测试套件、基准平台,以及公私合作的评估机制——让模型行为变得可衡量,而不只是停留在口头表态上。共有三条内容支撑了这一主题。
@AIHighlight 总结称(99 个赞、14 条回复、6,047 次浏览、54 次收藏)提到了 Garry Tan 的“Agent Complexity Ratchet”观点,并称一个名为 iFixAi 的开源工具如今可对已部署的 AI 系统执行 32 项检查,其中包括两项自动判定失败的条件。这条帖子的意义,与其说在于 YC 的框架,不如说在于它提出了一个运营层面的判断:AI 测试被描述为构建流程中的一环,而不是政策备忘录里的内容。
@BradSmi 表示(24 个赞、5 条回复、1,809 次浏览)称,Microsoft 正将其一线经验与美国 CAISI 及英国 AI Security Institute 的工作结合起来,以提升对先进 AI 风险的理解和防护能力。这为同一主题增加了第二条路径:评估体系不仅通过工具开发者扩展,也在通过机构扩展。
@sahar_abdelnabi 宣布(22 个赞、2,748 次浏览、16 次收藏)提到了 AISec 2026 论文征集;该研讨会页面如今已明确纳入 AI 安全、危险能力评估、多智能体协同风险、基准论文以及工件共享要求。配图信息量很大,因为它表明 AI 安全与基准测试正被作为 ACM 的正式研讨会方向呈现,而不再只是小众的边缘议题。

讨论洞察: iFixAi 主题下最值得注意的两条回复都不是炒作。一条说:“所有人都在竞相让 AI 变得更聪明,却没人检查它是否诚实。”另一条说:“大多数失败都会来自未经测试的行为。”它们传达的是同一个意思:AI 信任不再只是价值观问题,也被视为测试缺口。
与前一天比较: 5 月 15 日已经通过 JetBrains 模式、Kaggle 指南以及对基准可信度的质疑,将智能体评估推上台面。5 月 16 日则更进一步转向部署层面:公共测试套件、正式研讨会征稿,以及与国家相关的评估基础设施。
1.2 安全能力的扩张速度快于其周围护栏的完善 🡕
第二个主题是,人们描述更强大的 AI 系统时,关注点不再是它们作为助手是否更安全,而是它们是否会成为更快发现失败点的引擎。最受关注的例子来自安全利用相关主张,以及围绕 AI 与安全研究持续扩张的机构建设。
@EvanLuthra 声称(155 个赞、18 条回复、30,133 次浏览、15 次收藏)称,Anthropic 尚未发布的 Claude Mythos Preview 帮助安全研究人员在五天内绕过 Apple M5 芯片上的 Memory Integrity Enforcement。虽然这条帖子带有很强的宣传色彩,但它仍是数据集中的一个真实信号,因为它把前沿模型能力与漏洞发现、补丁时间线,以及通过更高层逻辑绕过硬件防护的可能性联系到了一起。
@ai_for_success 放大传播(41 个赞、5 条回复、6,550 次浏览、12 次收藏)是一条对 @IntCyberDigest 的引用转推,对同一说法作了更具体的表述:Mythos Preview 被用于发现 Apple M5 芯片上首个公开的 macOS 内核内存破坏漏洞利用;Calif 在五天内构建出可运行的漏洞利用后,将报告提交给了 Apple。回复随即把这件事上升为更广泛的担忧:AI 辅助的漏洞发现正在跑赢传统防御。
@sahar_abdelnabi 分享 提到了当天发布的 AISec 征稿,这与本主题相关,因为该研讨会如今明确征集有关 AI 滥用、自动化黑客攻击、真实性、危险能力评估以及自主智能体遏制机制的研究。安全讨论不再与主流 AI 话语割裂,而正成为讨论能力问题的核心场域之一。
讨论洞察: Mythos 帖子下最有价值的回复来自 @ECLresearch。该回复称,这一漏洞故事表明,AI 辅助的漏洞发现甚至正在超越资金充足的传统防御层。与标题本身相比,这条回复更扎实,因为它把轰动性的叙事转化成了一个可操作的结论。
与前一天比较: 5 月 15 日的重点是思维链劫持,以及推理功能可能削弱安全性的说法。5 月 16 日则从越狱和评估转向针对真实平台的漏洞发现,以及围绕这一风险形成的机构体系。
1.3 AI 基础设施正分化为更便宜的专业模型、边缘推理和劳动密集型数据流水线 🡕
第三个主题并非围绕某一个前沿模型,而是其底层技术栈:专业化开源模型、小型边缘多模态系统,以及支撑许多系统持续改进的人力数据工作层。
@pyquantnews 对比指出(32 个赞、1 条回复、3,029 次浏览、35 次收藏)将 BloombergGPT 与 FinGPT 进行对比,并称这一开源金融模型只需约 $300 和 80 个 GPU 小时即可完成微调,而 BloombergGPT 需要 $5 million 和 1.3 million 个 GPU 小时。尽管数据集中没有直接的仓库链接,但这条帖子显然引发共鸣的原因,在于它讲述的是成本与专业化,而不是模型品牌。
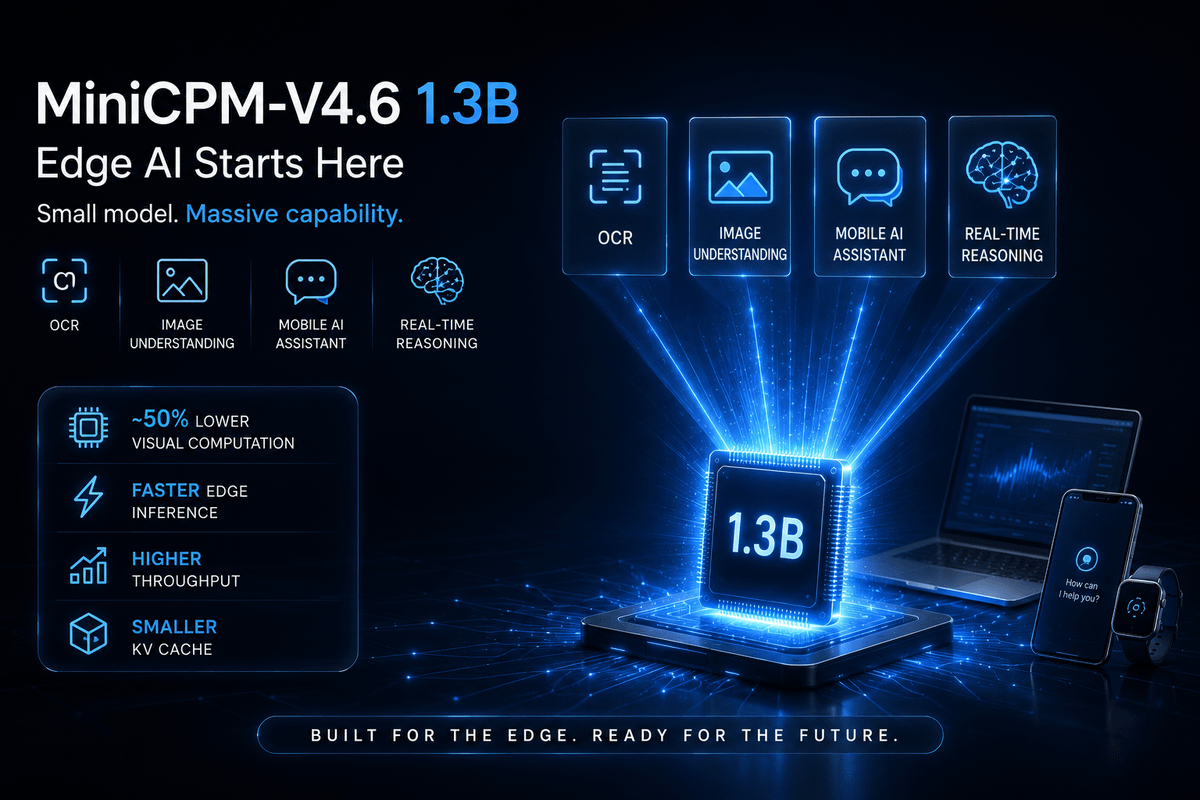
@nrqa__ 发布(29 个赞、7 条回复、10,679 次浏览、13 次收藏)称,MiniCPM-V4.6 1.3B 可以运行在边缘设备上,在关键多模态基准测试中超过 Qwen3.5-0.8B,并将视觉计算成本削减约 50%。配图直接写出了它的卖点:OCR、图像理解、移动助手能力、实时推理、更小的 KV cache、更快的边缘推理,以及 1.3B 模型带来的更高吞吐量。
在人力侧,@AmControo 指出(30 个赞、4 条回复、1,075 次浏览、30 次收藏)提到了 TransPerfect 的 DataForce 平台,用于标注、语言标注、转录和内容评估;@justprotocol 描述(6 个赞、4 条回复、1,332 次浏览、7 次收藏)则介绍了 Handshake AI,将其描述为一个数据标注、聊天机器人评估和提示工程平台,按周支付报酬,高级任务时薪最高可达 $75。这些帖子让人们清楚看到人力维护层的存在:即使小型和开源模型不断进步,数据与评估工作仍然垫在底层。
讨论洞察: 这些数据工作帖子并没有把相关岗位包装成光鲜亮丽的 AI 工作,而是将其描述为持续存在的任务市场:标注、转录、内容评估和提示词工作。与开源模型帖子相比,这形成了有益的对照,说明更便宜的模型能力并不会消除对劳动密集型整理和评分工作的需求。
与前一天比较: 5 月 15 日的基础设施讨论更侧重推理经济学和芯片定位。5 月 16 日的范围更广,也更加碎片化:开源专业模型、边缘多模态模型和付费数据工作平台同时出现在同一信息流中。
1.4 AI 的物理足迹正从基础设施路线图变成治理之争 🡕
第四个主题是,AI 算力不再只是“更多 GPU”或“更高资本开支”的问题。它越来越被视为公共治理议题,涉及数据中心、制造业政策,以及谁掌控这套物理底层。
@democracynow 发布(11 个赞、899 次浏览、3 次收藏)是一段来自 Astra Taylor 的采访 的视频片段。她认为,反对新建 AI 数据中心并不只是“邻避”心态,而是在推动“对 AI 实施民主治理”。文章还给出了具体数字:Gallup 的一项新民调显示,十分之七的美国人反对数据中心建在自己附近;Utah 居民则在反对一座拟建园区,因为该园区的能耗可能超过整个州。
@Sanjay_Sriv 认为(26 个赞、1 条回复、663 次浏览、5 次收藏)称,印度的 IT Hardware PLI 2.0 计划可以通过明确支持 AI 服务器和本地供应链,为 AI 建立国内制造业支柱。@chandrarsrikant 则单独提到了 报道称,内容涉及印度初创公司试图通过“太空数据中心”项目,将算力迁移到轨道上。
讨论洞察: 这些帖子并不认同同一种算力未来,但共享一个结构性观点:算力如今被视为公共利益问题。无论答案是放缓新数据中心建设、打造本土 AI 服务器产能,还是试图彻底摆脱地面环境的限制,都是如此。
与前一天比较: 5 月 15 日主要通过中美护栏和访问限制讨论治理问题。5 月 16 日则把争论拉回到土地、能源、工厂和地方控制权。
2. 什么让人感到沮丧
已部署的 AI 仍然缺乏可持续执行的简单信任检查
iFixAi 和 AISec 的帖子共同指向同一种挫败感:许多团队知道自己的 AI 可能失败、产生幻觉或表现不一致,但仍缺少能够融入正常工程流程的例行检查。@AIHighlight 将 iFixAi 描述为包含 32 项测试并支持自动判定失败的测试套件;AISec 征稿启事 如今也将基准工件视为严肃的研究成果,而不是可有可无的附加项。问题不在于缺少安全原则,而在于缺少简单、可重复的测试。严重程度:高。值得投入建设:是。
前沿能力正在超越防御体系的安全感
Mythos/Apple 相关帖子最清楚地体现了这一点。@EvanLuthra 和 @ai_for_success 描述了研究人员如何利用前沿模型帮助寻找绕过旗舰硬件安全功能的漏洞路径;回复也立即将其解读为防御缺口问题,而不是模型演示问题。即使这些公开说法带有宣传成分,它们所反映的挫败感仍然真实存在:AI 能力越强,防御者就越难确信今天的防护措施还能守住。严重程度:高。值得投入建设:是。
AI 数据层仍然高度零工化,运营上也很混乱
标注、内容评估和提示词工作反复以付费任务平台的形式出现,而不是稳定的产品基础能力。@AmControo 介绍了 TransPerfect/DataForce 的标注和标签工作;@justprotocol 推广了用于标注和聊天机器人评估的 Handshake AI;@OlatunjiAyokan2 则推广 Sigma AI 招募尼日利亚富拉语(Fulfulde)使用者,参与语音、转录和对话任务。问题不只是缺乏光环,而是更好的模型仍然依赖底层一个分散的劳动力市场。严重程度:中高。值得投入建设:是。
AI 算力扩张引发反弹,却没有明显的本地收益
Democracy Now 采访 给出了最明确的表述:社区被要求承受噪音、能源需求、土地占用和排放,却只能获得很少的就业回报。这种挫败感不同于模型安全问题,但如今已经成为 AI 讨论的一部分。严重程度:对受影响社区而言为高。值得投入建设:是,尤其是在算力透明度和治理方面。
3. 人们希望有什么
像普通工程检查一样运行的持续 AI 审计
iFixAi 的故事实际上释放了这一类别的需求信号。人们希望已部署的 AI 能够针对诚实性、抗操纵能力、一致性和不确定性处理进行通过/失败检查,而不必每次都聘请专业审计团队。这个需求非常实际;围绕 iFixAi 的互动表明,人们愿意使用能够将 AI 信任工作压缩进类似 CI 的常规流程中的工具。机会:直接。
帮助可信团队率先发现问题的防御型 AI 工具
Mythos 的漏洞帖子暗示了一个具体愿望:如果先进模型能够加速漏洞发现,防御者就希望在攻击者之前获得同等或受约束的能力。关于 AI 辅助漏洞发现正在跑赢传统防御层的评论表明,这是一项直接的安全需求,而不是对未来的推测。机会:直接。
面向真实领域和真实设备的低成本专业模型
FinGPT 和 MiniCPM-V4.6 的帖子都显示出对更窄领域、更低成本能力的需求。人们希望使用价格不及 Bloomberg 的金融专用模型,也希望多模态系统足够小,能够在靠近边缘的位置运行,而不是依赖大型托管技术栈。机会:直接且竞争激烈。
更完善的物理 AI 技术栈治理
围绕数据中心的反弹,以及关于主权制造的帖子,指向了一项当前产品工具几乎无法满足的需求:社区、运营商和政策制定者希望有更清晰的方式,来分析 AI 基础设施的能源、土地和供应链成本由谁承担。机会:正在形成。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| iFixAi | AI 测试 / 审计工具 | (+) | 将 AI 信任定义为可重复的检查,可针对已部署系统运行 | 数据集中的公开证据仍主要来自推文,而不是深入的产品文档 |
| FinGPT | 领域模型 | (+) | 展示了一个金融专用的开源替代方案,微调成本远低于 BloombergGPT | 抓取的推文数据中没有出现直接的仓库或论文链接 |
| MiniCPM-V4.6 1.3B | 边缘多模态模型 | (+) | 足够小,适合边缘式部署,同时宣称具备 OCR、图像理解和实时推理能力 | 当前证据主要是发布式宣传和基准测试主张,而非实地反馈 |
| TransPerfect DataForce | 数据工作平台 | (+/-) | 可大规模提供标注、标签、转录和评估劳务 | 揭示了 AI 进步在多大程度上仍依赖外包任务市场 |
| Handshake AI | 数据标注 / 评估市场 | (+/-) | 将标注、聊天机器人评估和提示工程工作与按周支付结合起来 | 公开注册页面信息有限;目前最有力的证据仍来自社交媒体帖子,而非产品细节 |
| AISec | 研究 / 基准测试平台 | (+) | 将 AI 安全、AI 安保和基准工件视为一等研究成果 | 属于学术平台,而非运营产品 |
| Generative AI for Beginners | 教程 | (+) | 提供免费的、大规模、多语言 AI 应用开发和智能体基础课程覆盖面 | 属于教育资源,而不是运行时环境或工具 |
| IDLE Inference Network | 分布式推理网络 | (+/-) | 倡导在本地运行开源模型,并按完成的任务获得报酬 | 当前公开证据主要围绕发布,且带有代币色彩,实际使用信息有限 |
总体满意度因层而异。专业模型和边缘系统带来了乐观情绪,因为它们承诺更低的成本和更强的控制力;数据工作平台和安全相关帖子则清楚表明,“AI 魔法”底层仍然依赖大量不可见的人力和评估。最明显的迁移趋势,是从“前沿模型可以解决一切”的单体式思维,转向更窄的技术栈:领域模型、边缘推理、正式基准测试和人工评估闭环。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| IDLE Inference Network | @IdleProtocol | 用于在本地运行开源 AI 模型,并按完成的任务赚取 USDC 的分布式网络 | 降低对集中式云推理的依赖 | 本地开源模型、用户硬件、USDC 结算 | Alpha | 帖子 |
| Handshake AI | Handshake AI(由 @justprotocol 分享) | 提供数据标注、聊天机器人评估和提示工程任务的平台 | 帮助团队快速获得人工评估和数据工作 | Web 任务平台、人工标注/评估工作流 | Beta | 帖子, 网站 |
| MiniCPM-V4.6 1.3B | MiniCPM 团队(由 @nrqa__ 分享) | 面向边缘设备的小型多模态模型,支持 OCR 和图像理解 | 让多模态 AI 能以更低成本部署在靠近设备的位置 | 1.3B 多模态模型、更低视觉计算成本的路径 | Shipped | 帖子 |
最强的构建者趋势,是为基础设施附加一个明确的约束条件。IDLE Inference Network 关注本地执行,而非依赖云端;Handshake AI 关注将标注和评估工作重新接入系统,而不是假装人力层已经消失;MiniCPM-V4.6 则关注将模型缩小到足以运行在边缘硬件上。相比充斥前沿模型发布炒作的信息流,这种构建者组合更加务实。
6. 新动态与值得关注的事
反对 AI 数据中心正成为主流政治信号
Astra Taylor 采访 值得关注,因为它将 AI 数据中心视为民主与公共危害问题,而不只是基础设施投资叙事。文章援引“十分之七的美国人反对附近建设数据中心”的数据,并围绕能源、水资源、土地和地方治理展开论述,而不是讨论基准测试表现。
7. 机会在哪里
[+++] 持续信任与审计工具 — 最明显的未满足需求,是面向已部署 AI、可重复且适合构建流程的评估工具。iFixAi 获得的互动,以及 AISec 对基准测试的强调,都指向同一方向。
[++] 防御型 AI 安全工作流 — 漏洞发现相关帖子显示,市场需要受约束的访问权限、可信团队扫描,以及更快的防御反馈闭环,以便在攻击者或普通用户获得类似能力之前采取行动。
[+] 专业化与边缘 AI 技术栈 — FinGPT、MiniCPM-V4.6 和本地推理理念都表明,人们正在寻求更窄、更便宜、更可控的 AI 系统,而不是一套适用于所有场景的前沿 API。