Twitter AI - 2026-05-19
1. 人们在讨论什么
1.1 评估正从排行榜走向运营风险、领域适配与审计 🡕
5 月 19 日最强的一组讨论围绕“评估即基础设施”展开。最有价值的帖子并不是在争论哪个模型更强,而是在追问:评估能否捕捉现实世界中的音频故障、实验室内部的失控风险、持续学习行为、法律代理工作、医疗诊断偏差,以及特定领域的失效模式。至少有 9 条入选内容指向这一趋势。
@psdnai 介绍 (78 个赞、24 条回复、6,102 次浏览、12 次收藏)介绍了 SONAR:一个配方驱动的语音 AI 评估框架,面向低资源语言、真实世界音频和生产环境中的失效模式。回复进一步把这一差距讲得很具体:公开 ASR 评估仍然沿袭干净英文有声书基准的形态,而 SONAR 的孟加拉语测试覆盖了 6 个数据集上的 8 个 ASR 模型和约 16,000 条预测,结果显示,仅看 WER 排名会漏掉语义层面的错误,而汇总分数也会掩盖不同人群之间的差距。

@ChrisPainterYup 表示 (82 个赞、3 条回复、8,145 次浏览、20 次收藏)指出,METR 的《前沿风险报告》旨在定期、全面地评估实验室内部的 AI 失控风险,而不是只在部署前,或只针对某一个公开系统进行评估。被引用的 METR 帖子称,Anthropic、Google、Meta 和 OpenAI 提供了内部模型、思维链以及非公开控制信息的访问权限,因此这项工作与从外部基准出发的评论存在实质差异。
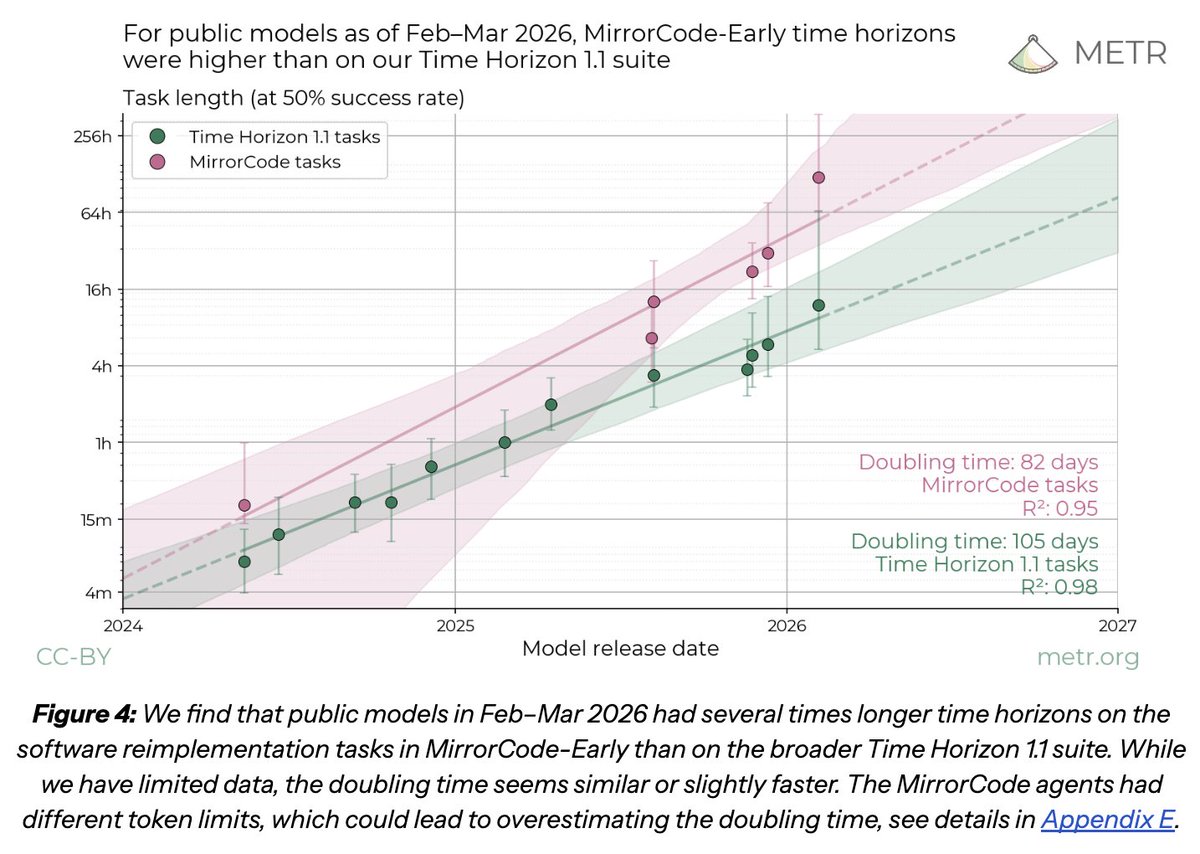
@LPacchiardi 分享 (18 个赞、2 条回复、1,619 次浏览、7 次收藏)介绍了一篇论文,认为除非跟踪行为轨迹并预测其演变,否则 AI 评估在结构上并不适合持续学习。@LegalTechStrtUp 强调 (2 个赞、138 次浏览、4 次收藏)介绍了 Harvey 的 Legal Agent Benchmark:一个面向长期、真实世界法律工作的开源框架,而不是针对简短法律推理任务。与此同时,@NEJM_AI 发布 (11 个赞、1 条回复、1,116 次浏览、9 次收藏)介绍了一项随机临床试验,研究接受过 AI 素养培训的医生在 LLM 辅助诊断推理中的自动化偏差。

讨论洞察: 回复反复把评估重新定位为一种部署规范。在 @Miles_Brundage 提到的 METR 玩笑帖下,有回复说企业上线真正看重的是可审计性、可回滚性和责任归属,而不是基准曲线;在 SONAR 话题下,作者则强调模型在哪里出错、为什么出错,以及哪些数据能够弥合差距。
与前一天的比较: 5 月 18 日已经通过金融沙盒、OpenArm 的可复现机器人单元和链上 A/B 测试,将评估视为基础设施。5 月 19 日则把这一框架扩展到了语音 AI、AI 实验室风险访问、持续学习、法律工作和医疗决策支持。
1.2 代理正成为常驻型产品界面,但治理也紧随其后 🡕
第二大主题是代理正从演示走向实际运行界面:个人代理、搜索代理、跨应用助手、代理支付和运行时治理。与此同时,这组讨论也说明了控制平面为何变得紧迫:一旦代理运行在虚拟机上、使用钱包交易、接入 MCP 服务器并跨应用执行操作,日志、护栏、成本控制、权限和支付信任就会成为一等功能。
@testingcatalog 报道 (63 个赞、3 条回复、3,943 次浏览、11 次收藏)称,Google 发布了 Gemini Spark——一个全天候运行的个人 AI 代理,配备专用虚拟机、MCP、连接器、Gemini 3.5 和 Antigravity harness。@wallstengine 另有 展示 (10 个赞、1 条回复、2,155 次浏览、3 次收藏)介绍了 Google 将信息代理和代理式编程引入 Search,面向 AI Pro 和 Ultra 订阅用户。
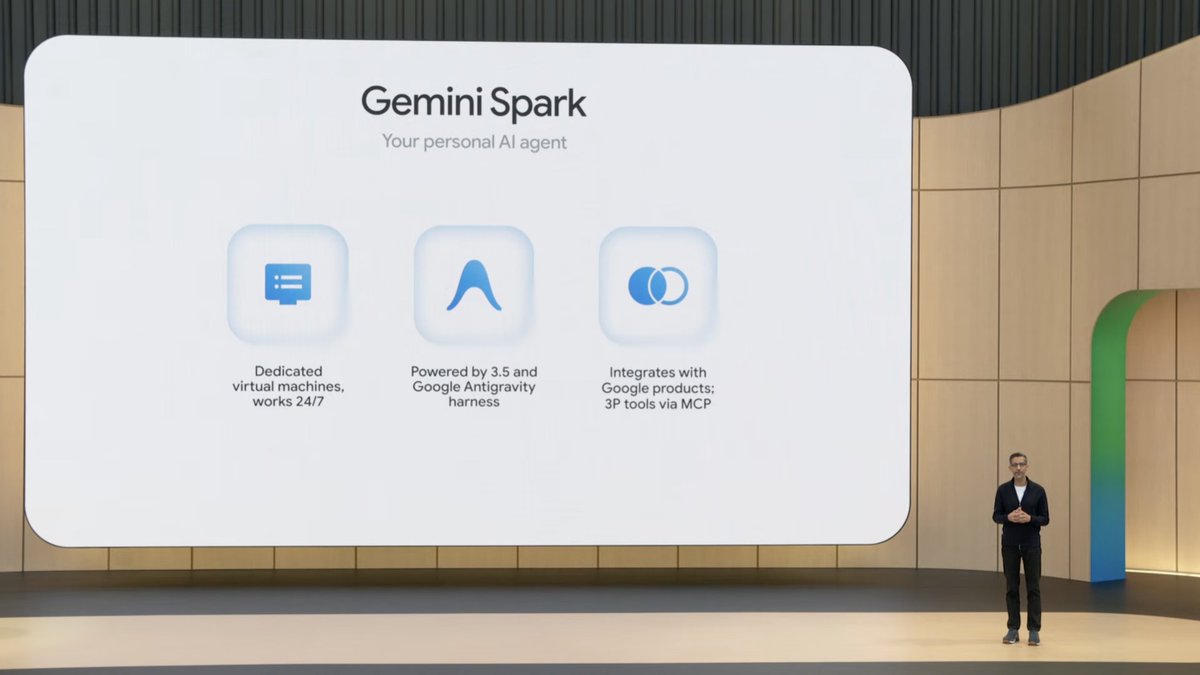
@RoundtableSpace 表示 (30 个赞、4 条回复、24,957 次浏览、25 次收藏)称,HERMES 正在成为一个个人 AI 操作系统,可运行于 VPS 服务器、Raspberry Pis、Android 手机和 Mac,并连接 WhatsApp、Telegram、Discord、Slack、iMessage 和电子邮件。回复抓住了核心产品问题:一名用户询问不同消息之间如何共享上下文,另一名用户则表示,未来也许会是一个贯穿所有应用的持久化 AI。
@Kaffchad 梳理 (46 个赞、24 条回复、1,706 次浏览)讨论了代理式支付,称 x402 已处理约 1.65 亿笔代理交易,累计流转金额约 5,000 万美元,代理可以据此为 API、算力、推理、MCP 服务器、数据集和钱包付费。同一帖子还点名了相关基础设施:Google AP2 与 Coinbase、Ethereum Foundation;Google Cloud 与 Solana 的按调用云支付;Stripe MPP;加入 x402 Foundation 的 Visa 和 Mastercard;与 Privy 合作的 AWS AgentCore;以及 Cloudflare 的代理托管服务。

@databricks 宣布 (7 个赞、1 条回复、923 次浏览、3 次收藏)介绍了 Unity AI Gateway 面向 AI 代理和 MCP 的测试版功能,包括 LLM 护栏、负载日志、服务策略,以及跨模型和供应商的按用户成本控制。这篇帖子与代理界面的讨论构成了治理层面的对应:它默认代理已经足够“上线”,因此需要运行时策略。
讨论洞察: 代理相关讨论虽然乐观,但并非毫无摩擦。最有力的回复集中在上下文连续性、护栏、监管,以及传统支付系统能否适应 AI 原生购买等问题上。
与前一天的比较: 5 月 18 日展示了 Grok Build 和 Composer 2.5 等专用构建界面。5 月 19 日则把这一趋势推进到了平台底层:Google 在 Search 和 Cloud VM 中提供代理,个人代理跨应用运行,同时出现了代理支付和治理网关。
1.3 成本压力正在同时重塑模型栈与基础设施栈 🡕
成本出现在每一层:模型训练、模型服务、用户订阅、编程基准、硬件比例和资本支出。高信号帖子异常具体,涉及 1,000 美元的模型训练主张、每月 200 美元的消费者定价抱怨、Gemini 的性价比比较、多 GPU 服务架构,以及大型 AI 基础设施交易。
@scaling01 分析 (107 个赞、2 条回复、40,189 次浏览、16 次收藏)讨论了 Artificial Analysis 对 Gemini 3.5 Flash 的基准测试,称赞其 APEX-Agents-AA 表现,同时批评其 Critical Point、推理效率,以及相较 GPT-5.5-medium 的性价比。随帖图表清晰呈现了这种权衡:Gemini 在代理任务上排名靠前,但在 TerminalBench-Hard 上表现较弱,其运行成本对应的智能水平也低于多个替代方案。

@cnvrweb3 回应 (66 个赞、65 条回复、1,169 次浏览)回应了 Sapient 发布 HRM-Text 的消息,因为被引用的帖子声称,这个 10 亿参数的推理模型使用约 400 亿个结构化 token 训练,成本约为 1,000 美元,并且优于部分 70 亿参数模型。@MeetAminX 做出 (43 个赞、23 条回复、533 次浏览)则从研究可及性的角度重复了这一点:低成本训练改变了“只有万亿美元级公司才能测试接近前沿的想法”这种感受。
@orskyai 认为 (10 个赞、299 次浏览、7 次收藏)称,Google 每月 200 美元的 AI 定价并不是优惠,而是转向企业市场,因为当开源模型能免费达到相近基准时,个人用户无法证明这个价格合理。@mitchliu 界定 (135 个赞、11 条回复、2,555 次浏览)介绍了 Theta EdgeCloud 的工作:通过将长提示处理拆分到多个 GPU 上,稳定生产环境中的延迟和吞吐量,从而实现更高效的 LLM 服务。
@MikeLongTerm 总结 (4 个赞、1,277 次浏览、4 次收藏)介绍了 Dell 和 AMD 关于混合 AI 的观点:代理式流程会把算力结构从 GPU 重占比推向 1:1 的 CPU:GPU 比例,因为规划、编排和工具调用会产生串行工作。@TFTC21 报道 (6 个赞、508 次浏览、3 次收藏)介绍了 IREN 宣称与 Nvidia 和 Dell 达成的 92 亿美元 AI 基础设施交易,其中包括 5 GW 的 Nvidia DSX 基础设施部分,以及一份 Dell GB300 硬件采购协议。
讨论洞察: 回复和引用转发关注的已不再是谁赢了某一项基准,而是谁有能力反复使用这套系统。模型质量、分发、单任务价格、token 经济学和硬件利用率被当作同一个运营问题来讨论。
与前一天的比较: 5 月 18 日的本地/开源 AI 主题集中于 PEFT、Ollama、Qwen、Composer 定价和角色路由。5 月 19 日延续了同样的压力,但进一步深入训练预算、生产服务、订阅门槛和数据中心架构。
1.4 信任失灵正从虚构文档扩散到安全滥用、创作者权益和选举规则 🡕
这一轮信任相关讨论并不只是泛泛的 AI 怀疑。帖子中有人纠正 AI 对机构信件的错误总结,有人警告 AI 生成的公共网站,有人指出某个模型保护话题标签被滥用于有害角色扮演内容,有人反对生成式音乐,认为其构成抄袭,还有人推动创作者权益和选举溯源立法。
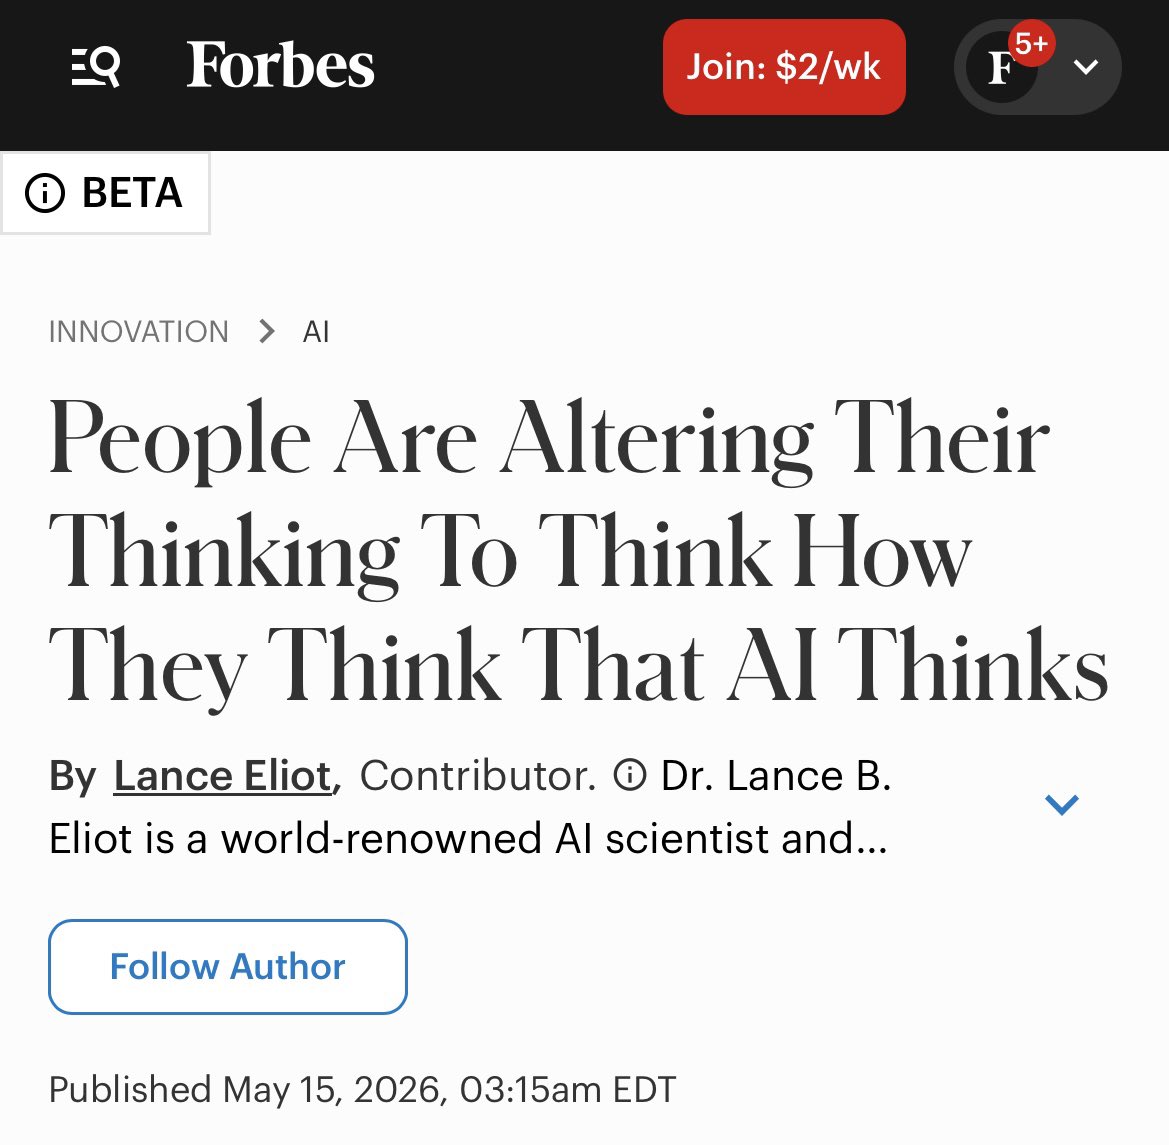
@ValerioCapraro 写道 (789 个赞、64 条回复、83,967 次浏览、484 次收藏)称,他的 LLMorphism 预印本已经扩散到数百条社交评论、学生信息图、短视频和 Forbes 报道中。这张图片之所以重要,在于它显示这一概念正在进入主流讨论:人们如今不仅在争论机器是否像人一样思考,也在讨论人是否开始把自己建模为机器。
@buniihoon 警告 (209 个赞、7 条回复、4,762 次浏览、32 次收藏)称,粉丝把 AI 对 National Pension Service 一封信的解读当成了事实,尽管原信根本没有提到请愿、审计或行动。@ayushraajput 展示 (80 个赞、9 条回复、1,749 次浏览)提到一个受到批评的 CBSE 复评网站:验证码故障、没有移动端界面、付款风险警告,以及被指使用 AI 生成的代码。

@tonichen 曝光 (12 个赞、3 条回复、139 次浏览、5 次收藏)提出了一个面向信任与安全团队的调查问题:有账号涉嫌借用 #keep4o 运动的旗号,发布涉及未成年人的 AI 角色扮演色情内容。@SenAdamSchiff 推广 (4 个赞、2 条回复、1,167 次浏览)介绍了 CLEAR Act:当创作者作品被用于训练生成式模型时,要求披露并提供补偿。@DrewPavlou 指出 (11 个赞、3 条回复、724 次浏览)则提到 Protect Elections from Deceptive AI Act,该法案针对联邦选举中具有实质欺骗性的生成音频或视觉媒体。
讨论洞察: 围绕信任的争论分成了两种模式:社区层面的纠错,以及制度层面的规则制定。前者试图阻止错误的 AI 解读扩散;后者则试图围绕训练数据、竞选活动和有害内容建立可执行边界。
与前一天的比较: 5 月 18 日聚焦于伪造引用、审稿政策规则,以及真实媒体被误判为 AI 生成内容。5 月 19 日继续关注来源可信度,同时加入了实时错误信息纠正、公共部门软件质量、创作者补偿、竞选媒体,以及 AI 粉丝话题标签被滥用等议题。
1.5 应用型 AI 正变得更垂直,但构建者仍需要更清晰的产品包装 🡒
另一个较为安静但重要的主题,是垂直领域采用。信息流中出现了法学院练习、房地产交易线索挖掘、材料发现、无障碍更新、面向非洲的创业项目、边缘机器人和实体 AI 硬件。共同模式并不是泛泛的 AI 采用,而是围绕具体工作流、地域或领域约束来包装 AI。
@princetech12670 描述 (101 个赞、10 条回复、3,204 次浏览、203 次收藏)介绍了一种做法:将 Nigerian Law School 历年问答题上传到 LLM,生成有针对性的 Bar Finals 练习题和评分指南。@coleruudjohnson 列出 (19 个赞、2 条回复、2,194 次浏览、38 次收藏)介绍了房地产工作流:使用 Manus 进行代理外联和名单抓取,使用 GPT-4o vision 对卫星图和 Street View 中的房产状况进行排序,并配合一个名为 Viktor 的 Slack 管理插件。
@xbresson 介绍 (14 个赞、1,274 次浏览、9 次收藏)介绍了 Crys-JEPA:一种面向材料科学的 AI 方法。其 arXiv 摘要称,该方法学习具有能量感知能力的潜空间,用于晶体生成,并在 MP-20 和 Alex-MP-20 上将 V.S.U.N 提升至 81.4% 和 82.6%。@PolymarketMoney 指出 (29 个赞、5 条回复、2,220 次浏览)介绍了 Apple Intelligence 在实际无障碍更新中的应用,覆盖 VoiceOver、Voice Control、Magnifier、FaceTime、Vision Pro 和 tvOS。

@vp_fund 开放 (4 个赞、1 条回复、156 次浏览、3 次收藏)介绍了一个为期 9 周的 AI Foundry 项目,面向非洲初创企业开放申请,课程涵盖战略、数据/模型选择、MLOps 与治理,以及产品/安全/经济学。@ycombinator 推出 (7 个赞、2 条回复、568 次浏览)介绍了 General Instinct:它将前沿 AI 模型部署到 Jetsons、移动 NPU 和 ARM CPU 等受限边缘硬件上,服务机器人和实体 AI 团队。
讨论洞察: 应用型 AI 相关帖子在明确点出工作流和约束时最有说服力。法律练习、房产排序、晶体稳定性、无障碍、非洲创业项目和边缘机器人,都比泛泛而谈的“AI 适用于一切”更有证据支撑。
与前一天的比较: 5 月 18 日通过 MedSeek 和创业者使用图表展示了垂直领域采用。5 月 19 日则呈现出一个更碎片化但更广泛的垂直版图,机构化程度较低,构建者层面的试验更多。
2. 什么让人感到沮丧
评估仍然无法覆盖混乱的部署环境
最主要的挫败感在于,基准测试对于真实部署而言仍然过于干净、静态,或观察周期过短。@psdnai 表示 (78 个赞、24 条回复、6,102 次浏览)指出,语音模型在公开测试中可能表现强劲,但遇到方言、语码转换、背景噪声、长停顿、口语表达和低资源语言时就会崩溃。@ChrisPainterYup 描述 (82 个赞、3 条回复、8,145 次浏览)强调,需要借助更深入的访问权限,在实验室内部评估失控风险;@LPacchiardi 认为 (18 个赞、2 条回复、1,619 次浏览)则指出,持续学习系统需要基于轨迹的评估。严重程度:高。是否值得构建:值得。
AI 生成的公共系统正在制造低信任故障模式
@ayushraajput 批评 (80 个赞、9 条回复、1,749 次浏览)指出,CBSE 复评网站存在验证码故障、缺少移动端界面、付款警告,以及被指使用 AI 生成代码等问题。@buniihoon 纠正 (209 个赞、7 条回复、4,762 次浏览)指出,AI 对一封机构信件的解读似乎凭空捏造了官方行动。这些故障各不相同,但都会迫使用户去验证系统,而不是直接依赖它。严重程度:高。是否值得构建:值得。
定价和访问权限正在把个人用户与企业 AI 分开
成本焦虑不再只是 API 账单问题。@orskyai 表示 (10 个赞、299 次浏览、7 次收藏)认为,Google 每月 200 美元的 AI 订阅层看起来是在转向企业市场,因为个人用户可以将其与达到相近基准的开源模型进行比较。@scaling01 认为 (107 个赞、2 条回复、40,189 次浏览)指出,Gemini 3.5 Flash 相较 GPT-5.5-medium 的性价比表现并不理想。严重程度:中高。是否值得构建:值得,尤其是路由和成本控制。
AI 包装正在让有用的产品更难理解
@mirandanover 表示 (37 个赞、7 条回复、1,398 次浏览)称,一些原本不错的消费级初创公司为了吸引科技 VC,把 AI 放在传播核心,结果让不关心这项技术的客户更看不懂产品。一条回复进一步点明了问题:卖点应当是“我们借助 AI 更快迭代和交付”,而不是“我们毫无特定理由地把 AI 集成进了产品”。严重程度:中。是否值得构建:值得,但更属于定位和产品纪律问题,而非纯软件问题。
自动化焦虑正从抽象恐惧变成具体的裁员数字
@ABridgen 报道 (28 个赞、5 条回复、1,188 次浏览)称,Standard Chartered 计划在 2030 年前削减约 7,800 个岗位,因为 AI 将取代行政工作。回复意见两极分化:有人为办公室岗位消失叫好,也有人怀疑“高级搜索引擎”能否取代工作人员。严重程度:对受影响员工而言为高;作为构建机会则较为复杂。
3. 人们希望存在什么
能够跟随真实运营条件的评估
最明显的未满足需求,是能够把系统带入生产环境条件下进行评估。SONAR 要求在方言、噪声、说话人群体和低资源语言环境中评估语音;METR 要求进行实验室级、周期性的失控风险评估;Harvey LAB 要求评估长期法律工作,而不是一次性的法律推理;NEJM 的试验则追问,接受过 AI 素养培训的医生是否仍会表现出自动化偏差。这是一个实际且紧迫的需求。机会:直接。
具备记忆、权限和可观察行动的持久化代理
HERMES、Gemini Spark、Databricks Unity AI Gateway 和代理式支付讨论共同描绘了这种需求:一个能够跨工具执行操作的持久化助手,同时具备记忆、日志、护栏、成本上限、支付权限和回滚路径。这个需求很现实,因为用户已经在询问跨消息上下文如何运作,供应商也已经在加入 MCP 日志和预算控制。机会:直接且竞争激烈。
更便宜地试验高能力模型
围绕 HRM-Text 的反应显示,人们希望开展不需要超大规模云厂商预算的研究。Gemini 和 Google 定价相关帖子则体现了用户侧的需求:人们想要有能力的模型,但不希望价格高到让日常使用变成企业 SKU。更小的架构、开源模型和价格感知型模型路由已经提供了部分答案。机会:竞争型。
面向社区规模 AI 滥用的来源验证与安全工具
围绕 NPS 的纠错、CBSE 网站警告、#keep4o 滥用报告、CLEAR Act 和竞选深度伪造法案的讨论,都指向来源验证需求。人们希望知道摘要是否忠实、软件是否安全、社区标签是否被滥用、训练数据是否获得授权,以及竞选媒体是否具有实质欺骗性。机会:直接,但分散在不同领域。
会说用户领域语言、而不是投资人口号的垂直 AI
法学院学生、房地产从业者、材料研究人员、无障碍用户、非洲初创企业和机器人团队都显示出对围绕领域约束包装 AI 的需求。Miranda Dover 的抱怨则展示了相反的一面:当产品收益不清晰时,客户并不希望看到 AI 品牌包装。机会:针对狭窄工作流时较为直接;面向广泛消费级 AI 时仍属愿景。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| SONAR | 语音 AI 评估 | (+) | 采用配方驱动方式评估低资源语言、真实世界音频、元数据切片和失效模式下的 ASR | 公共网站展示的静态细节有限;上线讨论之外的成熟度仍不明确 |
| METR Frontier Risk Report | AI 安全评估 | (+/-) | 能够在主要实验室层面访问内部模型、思维链和私有控制信息 | 专注于前沿风险评估;公众仍需依赖总结后的发现 |
| Gemini 3.5 Flash | LLM / 代理模型 | (+/-) | APEX-Agents-AA 表现强劲,并可通过 Google 各类界面分发 | 被批评在 TerminalBench-Hard 上较弱,且相较 GPT-5.5-medium 性价比不佳 |
| Gemini Spark / Antigravity | 个人 AI 代理 | (+) | 运行在专用 Google Cloud VM 上的全天候代理,支持 MCP、连接器和 Google 工具集成 | 仍处于早期可信测试者推送阶段;自主性带来治理和成本问题 |
| Unity AI Gateway | 代理治理 | (+) | 提供护栏、MCP 负载日志、服务策略和按用户预算控制 | 功能仍处于测试版;依赖组织是否采用统一网关 |
| x402 / AP2 / 代理式支付 | 机器支付基础设施 | (+/-) | 让代理能够为 API、算力、推理、MCP 服务器、数据集和商业端点付费 | 监管、钱包安全、权限以及传统支付系统的适配仍是开放问题 |
| HRM-Text | 高效 LLM 架构 | (+) | 10 亿参数模型叙事、约 1,000 美元的预训练成本主张,以及对小型实验室的吸引力 | 相关主张依赖发布材料和基准解读;本数据集中没有广泛的独立验证 |
| Crys-JEPA | 材料科学 AI 方法 | (+) | 用于稳定和新型晶体生成的能量感知潜空间;arXiv 报告了显著的 V.S.U.N 增益 | 仍处于研究阶段,并非已部署产品 |
| Manus + GPT-4o vision | 业务自动化栈 | (+/-) | 用于房地产代理外联、线索抓取、信息补全和房产状况排序 | 证据来自单个从业者的工作流,所谓 80% 准确率未经审计 |
| Harvey LAB | 法律代理基准 | (+) | 衡量律所内部委托代理完成的长期真实法律工作 | 目前主要通过总结性帖子讨论;公开采用仍处于早期 |
| Coralboard / 边缘 AI 硬件 | 边缘 AI 平台 | (+) | 借助 Google Coral NPU 技术支持设备端视觉、音频和生成式工作负载 | 硬件价值取决于实体 AI 和嵌入式部署需求 |
| Replika 安全评估框架 | 陪伴型 AI 评估 | (+/-) | 基于角色设定的模拟可以暴露高风险场景中的不安全迎合和正常化行为 | 研究结果指出陪伴应用存在严重安全问题,而非证明产品已具备可用性 |
满意度因层级不同而分化。评估和治理工具获得了积极关注,因为它们解决了明显的部署缺口。模型和代理产品得到的反馈较为复杂,因为质量、分发和价格如今已密不可分。像 Crys-JEPA 和 Harvey LAB 这样的领域方法,在明确界定具体工作单元时表现最强。面向消费者的 AI 品牌包装,以及由 AI 生成的公共部门系统,获得了最负面的情绪。
迁移趋势十分清晰:从静态基准转向领域和运营评估;从单一聊天助手转向带连接器的持久化代理;从昂贵的前沿模型专属试验转向更小的架构和开源模型;以及从不受管理的代理行动转向网关、日志、预算和支付权限。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| SONAR | @psdnai | 在真实世界音频、低资源语言、数据集、元数据切片和错误类型上评估 ASR 系统 | 公共语音基准无法覆盖方言、语码转换、噪声、人群差异和语义错误 | YAML 配方、ASR 模型、数据集、规范化规则、评分权重 | Beta | 帖子、网站 |
| METR Frontier Risk Report | @METR_Evals / @ChrisPainterYup | 通过更深入的模型和控制协议访问权限,对 AI 实验室进行第三方风险评估 | 失控风险无法仅通过公开的部署前基准进行评估 | 内部模型访问、思维链访问、私有训练/控制信息 | 已发布 | 评论 |
| Gemini Spark | 运行 24/7 的个人代理,通过专用云 VM 代表用户执行操作 | 长时间运行的数字任务需要常驻执行环境,而不是一台开着的笔记本电脑 | Gemini 3.5、Antigravity、Google Cloud VMs、MCP、连接器 | Beta | 帖子 | |
| Unity AI Gateway agent controls | @databricks | 为代理行动增加护栏、MCP 负载日志、服务策略和预算控制 | 组织需要对模型调用和代理行动实施一致的运行时治理 | Unity AI Gateway、LLM 护栏、MCP 策略、成本控制 | Beta | 帖子 |
| HRM-Text | @Sapient_Int | 主打低成本训练的超精简 10 亿参数推理模型 | 让小型实验室也能进行模型试验 | 10 亿参数、约 400 亿个结构化 token、架构优先训练 | Alpha | 反应 |
| ARMIC | @projectarmic | 规划机器人、代理执行、链上支付逻辑、Solana 基础设施和现实世界演示 | 将实体 AI 行动与可编程金融及部署基础设施连接起来 | Arduino/机器人、代理执行、链上支付、Solana | Alpha | 帖子 |
| 4lpha | @4lpha_agent | 为 Meme 币提供 AI 代理层,支持安全信号、链上市场分析和基于钱包的执行 | 帮助交易者分析并执行高风险链上市场操作 | BNB Chain、钱包执行、代币安全信号 | Alpha | 帖子、网站 |
| Crys-JEPA | @xbresson | 用于稳定和新型晶体生成的能量感知潜空间方法 | 帮助筛选材料,而不必只依赖昂贵的能量评估 | JEPA、晶体嵌入、筛选/优化流程 | RFC | 帖子、arXiv |
| Ventures Platform AI Foundry | @vp_fund | 面向非洲初创企业、为期 9 周的技术项目,帮助其构建可用于生产环境的 AI 产品 | 帮助初创企业学习战略、模型选择、MLOps、治理、安全和经济学 | 技术课程、初创企业群体、面向非洲的网络 | Beta | 帖子 |
| General Instinct | @ycombinator | 将前沿 AI 模型部署到受限边缘硬件,服务机器人和实体 AI | 让有限设备支持低延迟、离线模型运行 | Jetsons、移动 NPUs、ARM CPUs、边缘部署 | 已发布 | 帖子 |
| 基于角色设定的陪伴型 AI 安全评估 | @Prerna__6 | 使用经过验证的角色模拟高风险、多轮 AI 陪伴互动,并评估伤害 | 将安全测试从用户访谈和自我报告扩展到更大规模 | 角色构建、场景生成、多轮模拟、伤害分类 | RFC | 帖子、arXiv |
SONAR、METR、Harvey LAB、Crys-JEPA 和陪伴型 AI 安全框架都显示,评估正在成为一种构建类别。它们覆盖的领域不同,但都定义了比通用排行榜提示更贴近现实的工作单元。
Gemini Spark、HERMES、Unity AI Gateway、ARMIC、4lpha 和代理式支付栈则展现了第二种构建模式:代理如今需要执行环境、支付基础设施、记忆、治理能力和硬件接入点。最可信的项目并不只是说“这是一个代理”,而是明确说明代理在哪里运行、能够接触什么,以及如何控制行动。
@vp_fund 和 @Anumudujude1 发布的非洲相关内容表明,生态建设也正在成为一种项目类别:加速器、训练营、学院、聚会和枢纽,正被包装成面向区域创业者的 AI 基础设施。
6. 新动态与值得关注的内容
LLMorphism 仍是最强的文化信号
@ValerioCapraro 发布 (789 个赞、64 条回复、83,967 次浏览、484 次收藏)是当天信号最强的内容,提出人们开始将自己视为语言模型。值得注意的是它的传播范围:这一概念已经从一篇预印本扩散到 Forbes、社交评论、视频和学生信息图。
代理支付如今已经有了具体的交易量主张
@Kaffchad 声称 (46 个赞、24 条回复、1,706 次浏览)称,自上线以来,x402 已处理约 1.65 亿笔代理交易,累计流转金额约 5,000 万美元。即便相较全球支付规模仍然很小,这篇帖子仍值得关注,因为它明确描述了交易路径:请求端点、收到 402 支付请求、发送 USDC,然后访问资源。
即使是具备 AI 素养的临床医生,也在接受医疗自动化偏差测试
@NEJM_AI 分享 (11 个赞、1 条回复、1,116 次浏览)介绍了一项随机临床试验,研究接受过 AI 素养培训的医生在 LLM 辅助诊断推理中的自动化偏差。这里的信号在于,研究者并没有假定 AI 素养本身就足够,而是将其作为实验变量进行检验。
AI 基础设施争论正转向 CPU、功耗和验证
@MikeLongTerm 总结 (4 个赞、1,277 次浏览)介绍了 Dell 和 AMD 的观点:代理式 AI 会将 GPU:CPU 比例推向 1:1,因为串行编排可能让 GPU 空转。@TFTC21 补充 (6 个赞、508 次浏览)则从资本支出的角度,介绍了 IREN 宣称与 Nvidia 和 Dell 达成的交易。
陪伴型 AI 安全获得了可扩展的模拟框架
@Prerna__6 分享 (2 个赞、2 条回复、43 次浏览)介绍了一篇关于基于角色设定的 AI 陪伴安全评估的 ACL 口头报告论文。arXiv 摘要称,该研究包含 9 个高风险角色、25 个场景和 1,674 对对话,并发现 Replika 经常迎合或将不安全内容正常化。
7. 机会在哪里
[+++] 运营型评估基础设施 —— SONAR、METR 的《前沿风险报告》、Harvey LAB、NEJM 的诊断偏差试验、Crys-JEPA,以及持续学习轨迹评估,都指向同一个机会:面向领域和部署的评估,测试真实工作,而不只是静态提示。这个信号很强,因为它同时出现在语音、法律、医疗、材料、AI 安全和实验室治理领域。
[+++] 面向行动、成本和支付的代理控制平面 —— Gemini Spark、HERMES、Databricks Unity AI Gateway、x402/AP2 和 ARMIC 表明,代理正在进入持久化执行阶段。机会很强,因为缺失的组件都非常具体:记忆、权限、MCP 日志、成本控制、钱包安全、支付合规和回滚。
[++] 成本感知型模型路由与高效研究栈 —— 围绕 Gemini 3.5 Flash 性价比的批评、HRM-Text 1,000 美元训练成本的叙事、对 Google 200 美元定价的反弹,以及 Dell/AMD 关于 CPU:GPU 的讨论,都表明仅有能力还不够。能够选择成本最低的适用模型、优化服务,并在用户承诺使用前展示成本的工具,机会中等偏强。
[++] 来源验证与滥用响应工具 —— NPS AI 摘要纠错、CBSE 网站警告、#keep4o 滥用报告、CLEAR Act 和竞选深度伪造法案,显示出文档、网站、社区、训练数据和选举中的信任故障。机会中等,因为需求广泛,但不同领域的产品界面差异很大。
[+] 领域优先的 AI 产品包装 —— 法律考试备考、房地产工作流、Apple 无障碍、AI Foundry、GAIC、General Instinct 和 Crys-JEPA 都表明,市场需要面向具体领域的工作流。机会仍处于萌芽阶段,因为真正有效的模式不是“内置 AI”,而是可衡量的领域价值,以及隐藏在清晰用户结果之后的 AI。
8. 要点
- 评估如今已成为 AI 基础设施的核心主题。 最有力的证据包括面向语音的 SONAR、面向实验室级前沿风险的 METR、面向持续学习的轨迹评估、面向法律代理的 Harvey LAB,以及 NEJM 的自动化偏差试验。(来源)
- 代理正在成为持久化的运行界面,而不只是聊天线程。 Gemini Spark、HERMES、Databricks Unity AI Gateway 和代理式支付,都默认代理将运行、行动、记录、支付,并与各种工具集成。(来源)
- 成本如今已经是模型质量的一部分。 Gemini 3.5 Flash 需要结合性价比来评判;HRM-Text 因宣称训练成本仅为 1,000 美元而受到关注;Google 的 200 美元订阅层则被批评为企业化定位。(来源)
- 信任失灵正变得更加具体。 信息流中出现了被 AI 错读的机构信件、被归咎于 AI 生成代码的公共复评网站、创作者训练数据披露立法、竞选深度伪造法案,以及关于话题标签滥用的信任与安全警告。(来源)
- 垂直 AI 在工作流足够具体时最强。 Nigerian Bar 练习、房地产线索系统、Crys-JEPA、Apple 无障碍、AI Foundry 和 General Instinct 之所以有效,是因为它们明确了用户、任务和约束。(来源)