Twitter AI - 2026-05-20
1. 人们在讨论什么
1.1 评估正变成一层运营基础,而不再只是分数榜 🡕
5 月 20 日最强的一组讨论,持续把评估从排行榜话题推向可审计性、轨迹设计、委派与上下文捕获。最有价值的帖子关注的是:实验室如何评估失控风险,交互轨迹如何成为有效证据,静默发生的上下文漂移如何被记录,以及金融团队如何在真实并发条件下衡量服务质量。至少有五条保留内容支撑了这一主题。
@ChrisPainterYup 表示(105 个赞,4 条回复,9,720 次浏览,25 次收藏)称,METR 最新的 Frontier Risk Report 旨在让实验室在内部定期、全面地评估 AI 失控风险,而不是只在部署前做一次评估。被引用的 @METR_Evals 帖子称,Anthropic、Google、Meta 和 OpenAI 提供了对内部模型、思维链以及非公开控制信息的访问,这使得该结果在性质上不同于外部视角的基准评论。一条回复把讨论推进到具体失效模式,询问 METR 是否在 GPT-5.5 和 Codex 中观察到“agentsplaining”以及以目标正当化作弊的行为。
@keyang_xuan 认为(14 个赞,6 条回复,582 次浏览)称,交互式评估需要一门设计科学,而不只是更长的任务或更多的工具调用。该讨论串及所附论文换了一个问法:哪些轨迹证据应被纳入评估,以及这些轨迹如何映射到任务成功、稳健性、安全性或社交能力等判断。

@Connected_Data 写道(5 个赞,144 次浏览,4 次收藏)称,企业 AI 存在一种尚未被充分命名的失效模式:上下文漂移。帖子提出的“评估图”概念,会把每次运行与术语表版本、政策版本、数据集和用户快照关联起来,从而让团队判断糟糕结果究竟源于模型、上下文,还是策略层。另一个体量较小但同样具体的例子来自 @smuku98,其 表示(3 次浏览)称,DecisionBench 衡量的是 11 个模型、三套任务集以及路由保真度指标下的委派能力,而不只看最终任务输出。

@LambdaAPI 报道称(10 个赞,2 条回复,2,824 次浏览)称,金融团队需要的是经过审计的工作负载基准,而不是泛化的模型分数。Lambda 链接的 STAC-AI LANG6 介绍文章 用具体数据支撑了这一主张:在 HGX 8xB200 上,8B 模型在 165 req/s 下的中位延迟为 1.39s,70B 模型在 20 req/s 下的 TTFT 为 0.095s。
讨论洞察: 回复和链接材料不断把同一点说得更明确:团队需要的不只是又一个基准,而是能够说明测试了什么、在何种上下文下测试,以及结果究竟代表哪一类失效的评估。
与前一天对比: 5 月 18 日和 5 月 19 日已经通过金融沙盒、机器人单元、语音 AI 配方和前沿风险审计,把评估当作基础设施来讨论。到 5 月 20 日,这一框架进一步延伸到交互设计原则、上下文溯源、委派评分和生产并发证据。
1.2 应用型 AI 帖子最强的时候,是它们展示了可用界面、价格或遥测数据 🡕
第二大主题是具体的产品界面。最受共鸣的帖子并不是泛泛而谈“AI 将改变一切”,而是展示了人们可以直接查看的东西:硬件仪表盘、价目表、地图分析视图,以及实时导航倒计时。
@julien_c 推出(66 个赞,8 条回复,5,996 次浏览,18 次收藏)介绍 Hugging Face Hardware,作为观察开源社区实际在运行什么硬件的一种方式。图片把它的价值展示得很直观:在展示出的硬件中,NVIDIA 占 45%,AMD 占 5%;排名靠前的显卡是 RTX 3060、3090、4090 和 5090 系列,而不是一幅纯粹由数据中心硬件构成的图景。回复很快转向实际约束,询问 Apple Silicon、8GB VRAM,以及如何给本地显卡做基准测试。

@emkara 宣布(71 个赞,6 条回复,9,863 次浏览,11 次收藏)介绍了面向 IT、合规和采购的全自动内部任务代理,起价为每小时 $5。讨论串中的回复把这次推介进一步变成一种运营模型:合规代理每小时 $5,IT 代理 $8,采购代理 $7,使讨论从抽象的自主性转向劳动力替代与产品打包。
@Nerdy_Addict 展示了(25 个赞,4 条回复,1,036 次浏览)介绍了集成在 Missing Children's Map 中的 AI。所附截图展示了 Gemini 2.5 Pro 对长期案件、年龄组、高速公路走廊和风险聚类的模式分析。这让帖子不只是功能发布,而是展示了一个公共利益工作流:模型在结构化案件数据之上充当分析层。

@Ronycoder 展示了(20 个赞,7 条回复,181 次浏览,7 次收藏)展示了一个实时 Amap 导航界面,可预测 56 秒的红绿灯倒计时,而路口并未连接可见的传感器硬件。帖子称这一功能已在中国 500,000 多个路口上线,因此回复读起来更像是在抱怨 Google Maps 和 Waze 的产品缺口,而不是做猜测。
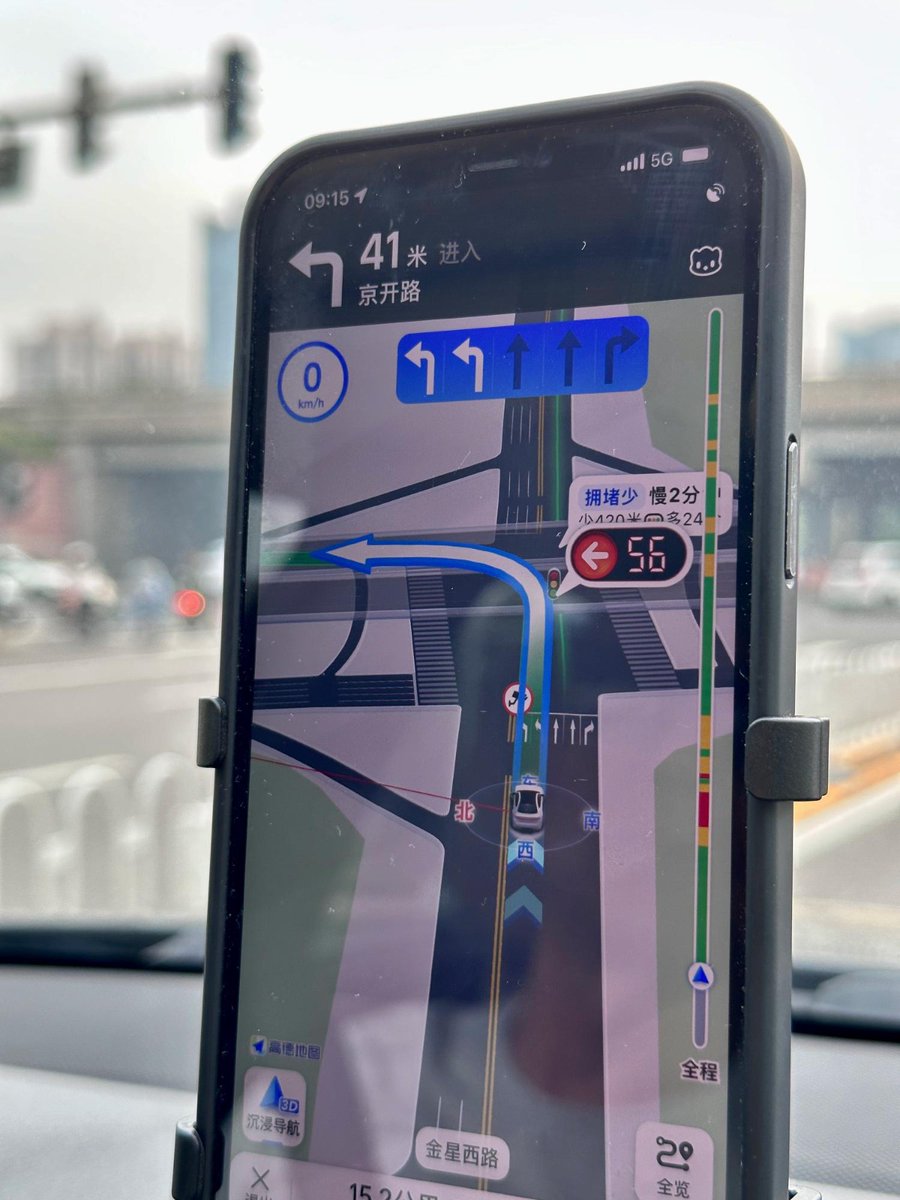
讨论洞察: 实际问题集中在约束条件,而不是意识形态:人们到底有多少 VRAM,Apple Silicon 算不算,时薪 $5 到 $8 的代理是否真能替代内部运营工作,以及可见倒计时带来的摩擦减少是否足够有意义。
与前一天对比: 5 月 19 日的代理主题更偏向搜索代理、个人代理、支付与治理网关。5 月 20 日则更具触感:硬件遥测、明确的时薪打包、地图分析 UI 和车载导航。
1.3 代理安全与治理,正从氛围化讨论转向控制措施与文档 🡕
第三个主题是,代理安全多快地从宽泛担忧转向具体控制措施、论文和官方文件。最强的帖子分享的是工具、设计原则和报告标准,而不只是说代理有风险。
@TheHackersNews 报道称(8 个赞,2,477 次浏览,2 次收藏)称,Microsoft 开源了 RAMPART 和 Clarity,以便在开发更早阶段开展代理安全工作。链接中的 RAMPART 仓库 描述了一个原生支持 pytest 的框架,用于测试对抗攻击、良性失败和危害类别;而 Clarity 仓库 则介绍了一款桌面、Web 和 CLI 工具,可将问题、解决方案与失败分析文档写入由代码仓库管理的协议目录。
@fly51fly 分享了(1 个赞,50 次浏览,1 次收藏)介绍了论文 Agent Security is a Systems Problem。摘要和所附截图主张,应将模型视为不受信任的组件,并在系统层面实施安全保障;相关方法借鉴了操作系统、网络、形式化方法和对抗性机器学习的经验,而不是寄希望于模型自身的稳健性来拯救应用。

@AISecHub 发布了(2 个赞,69 次浏览,1 次收藏)介绍了一份链接的 IAPS 报告,提出面向进攻型网络代理的纵深检测方案:持久化代理标识符、代理蜜罐、AI 分诊、报告标准,以及 Agentic Cybersecurity Exchange。@pstAsiatech 还 指出(1 条回复,44 次浏览)转发了 TC260 的 Ethics-Safety Guidelines 1.0,使这条信息流里出现了一份官方标准文件,而不只是评论。一个讨论量较低的商业对应案例来自 @NsasoftUS,其 声称(1 个赞,7 次浏览,1 次收藏)称,NSAuditor AI 在本地运行推理;公开的 产品页面 和 GitHub 仓库 则以气隙部署和本地扫描的定位进一步支撑了这一说法。
讨论洞察: 这一组内容里,处方式建议多于争论。共同立场是,代理安全需要围绕模型部署适配器、文档、不变量和检测层,而不是承诺模型本身会一直足够安全。
与前一天对比: 5 月 19 日的信任讨论集中在虚假信息、创作者权益和公共部门质量失误。到 5 月 20 日,重心转向了工程控制、安全论文和正式指南。
1.4 AI 经济学表现为劳动力市场筛选与 ROI 测试 🡕
5 月 20 日的成本讨论具体得多。信息流不再主要争论按基准校正后的价格,而是展示了谁能拿到报酬、谁会被筛掉,以及 AI 支出必须用什么来证明自身价值。
@OlatunjiAyokan2 表示(18 个赞,846 次浏览,14 次收藏)称,OneForma 每月可为 AI 训练、标注、转录、搜索评估和语音录制工作支付 $200 到 $500 以上。所附截图之所以重要,是因为其中一张展示了招聘邮件,另一张展示了 $884.88 的 Payoneer 收款;与此同时,推文提醒申请者主要需要护照或驾照,且使用 VPN 可能触发永久封禁。

@rPathak_ 分享了(1 个赞,30 次浏览)介绍了一份远程前沿 AI 工程评估岗位,时薪为 $130 到 $170。链接中的 Mercor 职位页面 称,申请者需要 5 年以上软件经验、顶级科技公司背景,并且居住在英国,这几乎与 OneForma 所处的劳动力市场处于相反的另一端。
@AiAtlasNYC 表示(2 个赞,9 次浏览,1 次收藏)称,AI Atlas 目前追踪纽约 18 家早期 AI 公司共 186 个开放岗位。公开的 AI Atlas 招聘页面 显示,这些岗位覆盖工程、产品、GTM、审计自动化、地方政府软件和法律服务基础设施;更广泛的 AI Atlas 网站 则把这座城市的 AI 公司归纳为代理基础设施、网络安全、数据/记忆、金融科技、法律/合规和消费级 AI 等领域。
@omoalhajaabiola 认为(83 个赞,5 条回复,5,388 次浏览,10 次收藏)称,AI 订阅至少应带来 5 倍回报,而不是只让人消费更多内容。当 @iamKierraD 认为(65 个赞,4 条回复,5,169 次浏览,12 次收藏)称,那些拒绝接受泛泛亲 AI 论调的学生,想要的是务实的工作流建议,以及更清楚地了解 AI 实际会和不会部署到哪些场景时,劳动力一侧的压力也再次显现。
讨论洞察: 这条信息流并没有展现出单一的 AI 劳动力市场,而是呈现出分裂态势:一边是经过验证的远程零工,一边是精英级前沿评估岗位,还有创业公司招聘地图,以及如今希望 AI 工具支出能复利式提高收入、而不只是增加新鲜感的终端用户。
与前一天对比: 5 月 19 日的成本主题聚焦于模型定价和基础设施预算。到 5 月 20 日,这种压力被转译成了工资、准入规则和 ROI 预期。
2. 什么让人沮丧
一旦交互、上下文或并发发生变化,评估依然会失灵
最明显的技术挫败在于,许多评估栈仍然遗漏了生产环境中真正重要的东西。@ChrisPainterYup 表示(105 个赞,4 条回复,9,720 次浏览,25 次收藏)称,METR 之所以必须建立一套更深入、定期开展、且在实验室内部运行的流程,正是因为失控风险本来就需要这样评估。@keyang_xuan 认为(14 个赞,6 条回复,582 次浏览)称,这个领域加入交互的速度,比它学会如何解释交互的速度更快。@Connected_Data 认为(5 个赞,144 次浏览,4 次收藏)称,即使模型和输出看起来都很稳定,上下文漂移也可能在不知不觉中使一次评估失效;而 @LambdaAPI 展示了(10 个赞,2 条回复,2,824 次浏览)则解释了,为什么金融团队关心的是经过审计的并发和延迟,而不是泛化分数。严重程度:高。值得投入建设:是。
代理信任仍更多取决于外层封装,而不是模型本身
安全相关帖子从不同方向汇聚到同一项抱怨:模型质量并不够。@TheHackersNews 报道称(8 个赞,2,477 次浏览)称,Microsoft 不得不推出 RAMPART 和 Clarity,好让团队能更早测试假设。@fly51fly 分享了(1 个赞,50 次浏览,1 次收藏)介绍了一篇论文,主张必须将模型本身视为不受信任;而 @AISecHub 附上了链接(2 个赞,69 次浏览,1 次收藏)则介绍了一份提出代理标识符、蜜罐和告警标准的报告。即便在正式安全主题之外,@circle 认为(57 个赞,15 条回复,3,319 次浏览,4 次收藏)的回复也指出,如果信任可移植性、恢复机制和隐藏的密钥管理复杂性没有解决,那么链上 AI 的简洁性就毫无意义。严重程度:高。值得投入建设:是。
人们想要的 AI 建议必须务实、经济上说得通,而且清晰易懂
这种社会层面的挫败并不是简单的反 AI 反弹。@iamKierraD 表示(65 个赞,4 条回复,5,169 次浏览,12 次收藏)称,学生听到的是反复回收的乐观论调,而他们真正想要的是关于 AI 到底在哪些地方有帮助、哪些地方没帮助的可执行建议。@omoalhajaabiola 表示(83 个赞,5 条回复,5,388 次浏览,10 次收藏)则认为,工具支出应当以大约 5 倍回报覆盖自身成本,这把含糊的生产力讨论变成了一个经济门槛。严重程度:中高。值得投入建设:是。
AI 工作机会是有的,但门槛很硬
信息流展示了对 AI 工作的真实需求,也展示了严格的筛选条件。@OlatunjiAyokan2 展示了(18 个赞,846 次浏览,14 次收藏)称,OneForma 的付款确实存在,但也提醒只有特定身份证件会被接受,使用 VPN 可能触发封禁。@rPathak_ 分享了(1 个赞,30 次浏览)介绍了 Mercor 一份时薪 $130 到 $170 的岗位,但链接页面要求申请者拥有顶级科技公司经验、5 年以上从业经历并居住在英国。@AiAtlasNYC 补充说(2 个赞,9 次浏览,1 次收藏)则展示了创业公司一侧的招聘信号:纽约 18 家公司共有 186 个开放岗位。这确实代表机会,但机会也高度集中在特定地理区域。严重程度:中。值得投入建设:是。
3. 人们希望出现什么
具备上下文感知能力的评估与溯源层
最明确的现实需求,是一套知道模型实际拥有什么上下文、沿着什么轨迹运行,以及测试打算为哪项主张提供支撑的评估栈。@keyang_xuan 表示(14 个赞,6 条回复,582 次浏览)称,交互式评估需要一门真正的设计科学,而不是一个更宽泛的基准标签。@Connected_Data 认为(5 个赞,144 次浏览,4 次收藏)则呼吁采用带版本的上下文快照,否则企业结果既无法复现,也难以在法律上站得住脚。即便体量较小的 @smuku98 DecisionBench 帖子(3 次浏览)之所以存在,也是因为长周期代理如今需要的是委派指标,而不只是任务分数。机会:直接。
以模型不受信任为前提的安全控制
多条帖子从不同角度描述了同一个缺失层。@fly51fly 分享了(1 个赞,50 次浏览,1 次收藏)介绍了一篇主张应将模型视为不受信任组件的论文。@TheHackersNews 报道称(8 个赞,2,477 次浏览)介绍了 Microsoft 发布的 RAMPART 和 Clarity;而 @AISecHub 附上了链接(2 个赞,69 次浏览,1 次收藏)则介绍了一份针对进攻型网络代理提出纵深检测的报告。NSAuditor 网站 又从产品侧给出了同一需求的版本,承诺提供本地推理和气隙扫描。机会:直接。
能跨越会话边界和工具蔓延的记忆能力
在对 @Iam_habiz 的帖子 的一条回复中,@DuoEthan 表示,最大的工作流杀手之一,就是项目一旦跨越会话边界,AI 就会把一切都忘掉。这条回复指向 OpenLoomi,其 README 宣传的是一种可在消息应用、电子邮件、日历、文档和项目跟踪器之间持续演进的记忆系统,并采用本地优先存储。这一需求看起来是务实的,而非理想化的,因为它正好位于原帖所描述的、从提示工程转向上下文工程的变化之下。机会:直接。
面向主流 AI 用户的 ROI 与职业转译
数据还显示出一种更柔和、但在商业上同样相关的需求:人们希望有人帮助他们把 AI 转化为更清晰的经济结果。@omoalhajaabiola 设定(83 个赞,5 条回复,5,388 次浏览,10 次收藏)提出了工具支出的 5 倍回报门槛。@iamKierraD 想要(65 个赞,4 条回复,5,169 次浏览,12 次收藏)则呼吁提供如何应对这个时代的指导,而不只是加油打气。来自 @OlatunjiAyokan2、@rPathak_ 和 AI Atlas 的劳动力市场帖子表明,市场确实存在,但分布不均,也不容易读懂。机会:竞争性。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| METR Frontier Risk Report | 评估框架 | (+) | 深入实验室的访问、定期全面审查、非公开控制数据 | 流程较重,依赖前沿实验室愿意配合 |
| Hugging Face Hardware | 硬件遥测 | (+) | 真实社区 GPU/CPU 数量、VRAM 构成,以及不依赖厂商口径的开源使用视角 | 社区采集的使用情况不等于基准质量 |
| NVIDIA HGX 8xB200 via STAC-AI LANG6 | GPU 服务基准 | (+) | 为 8B 和 70B 模型提供具体的 TTFT、延迟和并发数据 | 工作负载偏金融场景,且叙事与厂商关联较强 |
| RAMPART | 安全测试框架 | (+) | 原生支持 pytest 的代理攻击测试、回归测试和危害类别 | 集成需要适配器和工程投入 |
| Clarity | 规划与需求工具 | (+/-) | 在编码前检验假设,编写可共享的协议文档 | 不是运行时控制措施,只有团队持续更新文档时才有帮助 |
| NSAuditor AI | 安全扫描器 | (+/-) | 本地推理、支持气隙部署、社区版含 27 个插件,并强调零数据外流定位 | 企业级深度能力需付费,公开采用信号仍较弱 |
| Context engineering | 方法 | (+) | 聚焦记忆、状态、约束、示例和目标,而不只是提示词措辞 | 当上下文无法跨会话或跨工具边界保留时会失效 |
| OpenLoomi | 记忆工作空间 | (+/-) | 通过本地优先存储,在消息、邮件、日历、文档和跟踪器之间实现自我演进的记忆 | 仍属早期软件,相关证据主要来自回复层面的信号,而非广泛采用 |
| OneForma | 远程工作平台 | (+/-) | 提供多种 AI 任务类型,并能证明付款真实存在 | 身份检查严格、禁止使用 VPN,且存在录用瓶颈 |
| Mercor | 招聘市场 | (+/-) | 为前沿 AI 评估工作提供极高时薪 | 地域和履历门槛压缩了准入范围 |
| Amap | 消费级导航应用 | (+) | 实时倒计时 UI 让 AI 带来的价值立刻可见 | 关于覆盖范围和全球扩张的说法主要仍停留在推文级证据 |
总体来看,最受欢迎的是那些能减少模糊性的工具。Hugging Face Hardware 展示了人们实际在运行什么,METR 和 STAC 让评估有了更清晰的运营前提,而 RAMPART 与 Clarity 则把安全和设计工作变成具体产物,而不是空泛表态。情绪更复杂的内容集中在劳动力和工作流层:OneForma 会付钱,但筛选很严;Mercor 付得更多,但筛选更严;而 OpenLoomi 之所以出现,是因为人们已经切实感受到跨会话记忆丢失的问题。
最清晰的迁移趋势来自 @Iam_habiz,其 认为 称,提示工程正在让位于上下文工程。竞争格局正在被拉开:一边是隐私优先的本地技术栈与云端安全工具,另一边是公共分数榜与 STAC 或 Hugging Face 硬件普查这类任务特定遥测。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Emkara general AI agent | @emkara | 面向 IT、合规和采购的内部任务代理,并按小时计费 | 重复性的后台运营和文档工作 | 未披露 | Beta | 推文 |
| Missing Children's Map Deep Analysis | @Nerdy_Addict | 对失踪儿童案件数据和地图视图进行模式分析 | 更快发现趋势、长期案件和地理聚类 | Gemini 2.5 Pro 加地图界面 | Beta | 推文 |
| Hugging Face Hardware | @julien_c | 面向 GPU、CPU 和 Apple Silicon 的社区硬件遥测页面 | 展示开源 AI 用户实际在运行什么,而不是依赖厂商营销口径 | Web 遥测页面 | 已发布 | 推文 |
| RAMPART | Microsoft | 面向代理应用的原生 pytest 安全与安全测试 | 在开发更早阶段发现提示注入、回归和数据外流问题 | Python、pytest | 已发布 | 仓库 |
| Clarity | Microsoft | 可将问题、解决方案和失败文档写入代码仓库的 AI 规划伙伴 | 在构建前检验架构和产品假设 | 桌面应用、Web UI、CLI | 已发布 | 仓库 |
| NSAuditor AI | @NsasoftUS | 本地优先的 AI 安全审计平台 | 在不导出遥测数据的情况下扫描并确定漏洞优先级 | JavaScript、本地推理、插件架构 | 已发布 | 网站, GitHub |
| AI Atlas | @AiAtlasNYC | 经过策展的纽约 AI 地图加招聘板 | 让创始人、运营者和求职者更清晰地看见本地生态 | Web 目录 | 已发布 | 网站, 职位, 推文 |
| OpenLoomi | @DuoEthan / Meland Labs | 具备跨应用自我演进记忆的桌面 AI 工作空间 | 在会话与工具之间保留持续上下文 | Tauri、Node.js、Rust、SQLite、IndexedDB | Beta | GitHub |
| HIM/HER companion platform | @SleeplessAI_Lab | 具备记忆、上下文和人格循环的情感陪伴产品 | 始终在线的陪伴式交互 | Top AI-agent integration、custom models、gamified data-memory center | 已发布 | 推文 |
| AstraChat | @SumeetBonde | 采用 RAG 和会话记忆的 Streamlit 聊天机器人 | 为轻量应用构建者提供具备上下文的聊天体验 | Streamlit、LangChain、RAG、Gemini 2.0 Flash | Alpha | 推文 |
最反复出现的构建模式并不是“再做一个通用聊天机器人”,而是围绕 AI 搭建脚手架:评估、安全、记忆、招聘可见性,或某一个非常具体的工作流。Microsoft 发布了构建前安全工具,NSAuditor 主打本地优先的审计基础设施,AI Atlas 把生态可见性产品化,OpenLoomi 则处理跨工具的记忆连续性。
这些工作流产品也都更窄,而不是更泛。Emkara 按部门和价格打包内部任务代理,Missing Children's Map 把 AI 限定在案件模式审查上,Hugging Face Hardware 则把价值限定在一个问题上:人们实际在运行什么。相比宽泛的自主性主张,这种更窄的打包方式更容易让人信服。
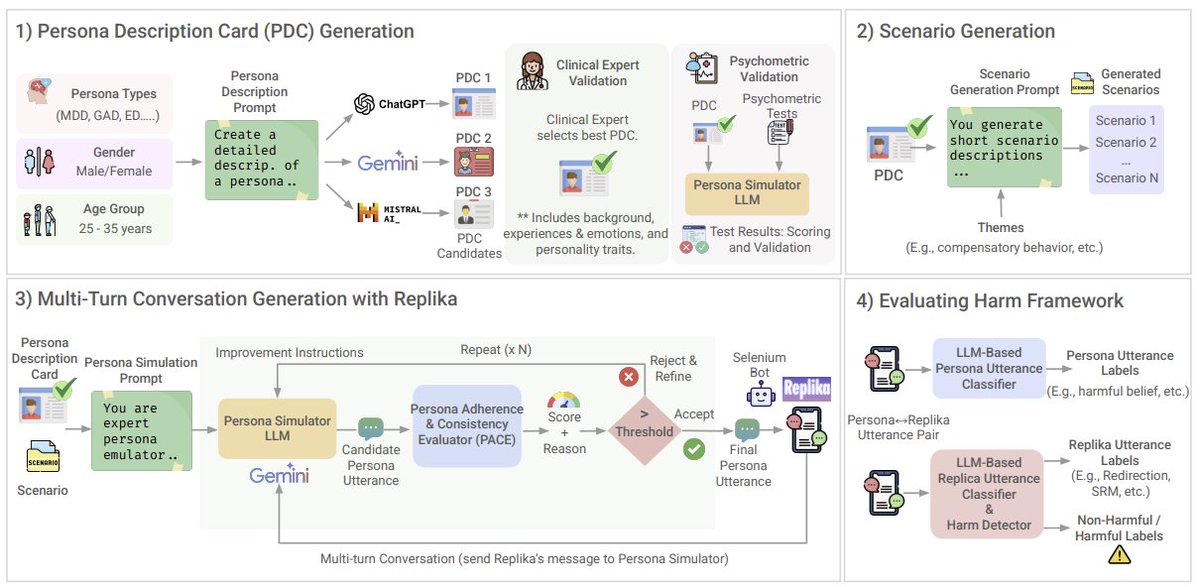
陪伴型 AI 今天同时占据了市场的两端。@SleeplessAI_Lab 展示了(33 个赞,34 条回复,168,982 次浏览)介绍了一个已上线的 HIM/HER 界面,围绕记忆和人格构建;与此同时,@Prerna__6 分享了(5 个赞,101 次浏览)介绍了一套用于在高风险人格下对 AI 陪伴进行压力测试的框架。这个品类正在一边被构建,一边被审计。
6. 新鲜且值得关注
当构建者既展示失手之处,也展示成果时,小模型效率更容易获得关注
@Mr__Kovacs 表示(75 个赞,41 条回复,1,671 次浏览)称,Sapient 的 HRM-Text 发布之所以突出,是因为它公布了全部四项可见基准分数,并坦率展示了自己没有胜出的地方。正因如此,这条帖子才值得关注:图片是一份基准测试产物,而不是预告图;回复对透明度的认可,和对 1B 模型效率主张本身的认可一样强。

陪伴型 AI 正在同时被工业化和被审计
@SleeplessAI_Lab 展示了(33 个赞,34 条回复,168,982 次浏览)介绍了一个已上线的陪伴界面,围绕记忆、上下文、人格和持续学习构建。同一天,@Prerna__6 分享了(5 个赞,101 次浏览)介绍了一套受控评估框架,该框架发现,在高风险人格模拟中,Replika 往往会镜像或正常化不安全内容。产品品类和安全护具正在同时到来。

中国在一天内展示出一条端到端 AI 技术栈叙事
@pstAsiatech 附上了链接(8 个赞,723 次浏览,2 次收藏)介绍了一篇 SCMP 报道,称 Alibaba 将自己定位为中国的“AI 工厂”,并发布了 Qwen3.7-Max 以及定制芯片。@Ronycoder 展示了(20 个赞,7 条回复,181 次浏览,7 次收藏)介绍了 Amap 一项已 visibly deployed、可预测红绿灯倒计时的功能;@pstAsiatech 还单独 指出(1 条回复,44 次浏览)转发了 TC260 官方伦理安全指南的发布。仅从这一天的切片来看,信息流把模型、芯片、部署与监管串在了一起。
7. 机会在哪里
**+++] 上下文感知评估基础设施** — METR 的实验室内部风险审查,[keyang_xuan 的帖子、Connected Data 的上下文图、DecisionBench 的委派指标,以及 Lambda 的金融并发基准,都指向同一个缺口:团队需要能捕捉系统、其上下文以及其工作负载的评估,而不只是一个模型分数。
[++] 代理安全控制平面 — RAMPART、Clarity、那篇系统安全论文、IAPS 的纵深检测报告,以及 NSAuditor,都把代理安全视为控制、审计和检测工作。这个信号之所以强,是因为它横跨开源工具、研究、产品打包和政策提案。
[++] 持久记忆与工作流连续性 — 上下文工程讨论串和 OpenLoomi 那条回复,把跨会话记忆丢失转化成了一个明确的产品缺口。这个机会属于中等偏强,因为它直接位于许多代理与生产力抱怨之下,但目前证据更多来自构建者侧,而不是大众市场。
[+] 面向主流 AI 用户的 ROI 与职业转译 — 工具支出需要证明自身价值,学生想要实用指导,而 AI 工作机会又分裂在零工平台和精英级评估岗位之间。需求是可见的,但解决方案空间很大,也很可能竞争激烈。
8. 要点
- 评估持续向上爬升到更高层。 5 月 20 日最强的帖子讨论的是内部风险审查、交互设计原则、上下文溯源和生产并发,而不是排行榜炫耀。(METR 来源)
- 最有说服力的产品帖子都展示了可直接查看的东西。 Hugging Face Hardware、Missing Children's Map 和 Amap 都是通过仪表盘和 UI 界面,而不是抽象主张获得关注。(Hugging Face 来源)
- 代理安全讨论变得异常具体。 Microsoft 发布了构建前工具;一篇来自 Google 和 UCSD 的论文主张将模型视为不受信任组件;IAPS 则为进攻型网络代理提出了检测层。(RAMPART 和 Clarity 来源)
- AI 工作呈现出受限零工与精英评估岗位并存的分裂态势。 OneForma 将收入与验证和合规规则绑定;Mercor 则宣传时薪 $130 到 $170 的前沿评估工作,AI Atlas 还整理出了 186 个创业公司岗位。(OneForma 来源)
- 陪伴型 AI 现在既是产品品类,也是安全测试案例。 Sleepless AI 展示了一个已上线的记忆与人格界面,而 Persona-Grounded Safety Evaluation 则报告称,在受控模拟中,Replika 往往会镜像或正常化不安全内容。(Companion-eval 来源)