Twitter AI - 2026-05-21
1. 人们在讨论什么
1.1 除非基准测试能映射到真实工作流或可用产品,否则其权威性正在减弱 🡕
最强的一组观点认为,基准测试讨论并非决定性结论,而是不完整的讨论。保留下来的帖子认为:交互式评估需要明确的设计原则;科学智能体评估应基于真实工作流并进行程序化验证;推理时间可变使单一分数评分卡失去意义;相比 AI 是否又拿下一个排行榜,用户更在意它能否修好邮箱或应用。至少有四条高信号内容支撑这一主题。
@keyang_xuan 指出(27 个赞、9 条回复、2,282 次浏览、15 次收藏)认为,交互式评估需要的是一门设计科学,而不只是更长的轨迹或更多工具使用。该线程称,评估问题必须明确:哪些轨迹证据算数,以及这些轨迹如何映射到稳健性、可恢复性、安全性或社交能力等判断。随附的论文页面将这一点具体化:交互式评估应被视为一种有原则的范式,并配套报告标准,而不是一个宽泛松散的基准测试标签。

@sanmikoyejo 表示(8 个赞、405 次浏览、3 次收藏)认为,“面向科学的 AI”基准测试目前大多仍在考教科书式记忆,并指向 Terminal-Bench Science。该项目正在容器化环境中收集真实科学工作流,并使用基于 pytest 的验证。这很重要,因为它把基准构建变成了实践科学家可参与的贡献过程,而不再是一组封闭的玩具任务。
@haider1 报道(53 个赞、8 条回复、3,433 次浏览、10 次收藏)称,Noam Brown 表示,对于推理模型而言,单一数字基准测试已不再有意义,因为模型表现如今取决于系统获得了多少推理时间。一条回复进一步点明了这种质疑:当同一家实验室恰好在最难衡量的模型上领先时,批评基准测试听起来就显得很方便。
@boneGPT 指出(76 个赞、16 条回复、3,639 次浏览、9 次收藏)认为,团队应停止“benchmaxxing”,转而开始“productmaxxing”,并以 Gmail 为例:用户想要的是记忆、规则和可靠的回复模板,而不是基准分数再涨零点几。回复很快从理论转向执行缺口,抱怨手机和应用助手至今仍无法完成简单的跨应用操作。
讨论洞察: 回复并不是反对评估,而是反对那种无法解释工作流质量、产品实用性,或模型在何种条件下获得额外推理时间的评估。
与前一日比较: 5 月 20 日已经通过 METR、STAC 和上下文溯源相关帖子,把评估视为基础设施。5 月 21 日则更明确地反对排行榜式抽象,转向以工作流为基础的任务、可变算力评估和产品实用性。
1.2 算力获取与本地执行,正成为聊天机器人与智能体之间真正的分界线 🡕
第二个主题是把算力视为一种访问控制。相关证据涵盖:无法统筹预算的学术机构、希望使用本地机器而不是云端调用的开发者,以及展示小型 GPU 实际承载能力的基准截图。至少有五条保留内容支撑这一主题。
@emollick 写道(96 个赞、19 条回复、5,902 次浏览、12 次收藏)认为,即使单轮聊天机器人越来越便宜,算力稀缺仍会让复杂的智能体工作流变得昂贵。他在后续回复中表示,也许每个人都能获得强大的免费聊天机器人,但最好的智能体将只留给那些负担得起多出数千倍 token 消耗的工作负载;这将分化框定为一个普惠问题,而不只是定价问题。
@MilkRoadAI 表示(36 个赞、6 条回复、4,427 次浏览、12 次收藏)称,Jensen Huang 给大学 AI 获取能力开的药方是集中采购,而不是继续抱怨短缺。该线程认为,像 Stanford 这样的机构需要集中式共享算力,因为单个院系不可能靠一笔笔拨款逐步买出价值数十亿美元的基础设施。
@ClementDelangue 表示(43 个赞、5 条回复、1,964 次浏览、3 次收藏)认为,AI 开发者需要更多本地硬件,并在 AMD 发布 Ryzen AI Halo 后提出了 Hugging Face 盒子的设想。回复立刻追问预装模型和更清晰的硬件打包方式,说明这种需求并不只是意识形态上的“本地优先”,而是明确的产品需求。
@TheAhmadOsman 展示了(92 个赞、10 条回复、8,492 次浏览、148 次收藏)称,在 RTX 3070 8 GB 显卡上运行本地 Qwen3.5-9B,可在 180,224 上下文长度下达到稳定的 q8_0 配置,并实现每秒 54.45 个 token。该截图把“本地 AI 很容易”这种模糊说法,变成了围绕 KV cache、batch size,以及显存临界点故障点的具体权衡。

@latentspacepod 强调(16 个赞、1 条回复、2,711 次浏览、4 次收藏)转发了一篇 Daytona 访谈,主张智能体需要的是有状态的计算机,而不是用完即弃的代码执行盒子。相关文章声称,沙盒启动时间约为 60 毫秒,可在约 75 秒内启动 50,000 个沙盒,且有客户每天运行约 850,000 个沙盒。这让面向智能体的算力看起来更像一种新的基础设施类别,而不是又一层开发者工具封装。
讨论洞察: 回复主要聚焦于封装与获取:谁能得到共享算力、什么样的本地盒子才够用、哪些内容应当预装,以及哪些工作负载会打破纯云端假设。
与前一日比较: 5 月 20 日的算力讨论聚焦于遥测和基准化服务。5 月 21 日则把它转化为稀缺性、集中采购、本地盒子和面向智能体的计算机。
1.3 安全与治理讨论继续转向控制措施、协议和公众审查 🡕
第三个主题是落地执行:具体的安全工具、由代码仓库管理的决策记录、国家级评估能力,以及发布前的政府审查。最强的例子在数量上不如算力讨论多,但对于控制层应当做什么却异常具体。
@TheTuringPost 表示(5 个赞、2 条回复、399 次浏览、3 次收藏)称,Microsoft 新发布的 RAMPART 和 Clarity,面向的是 CI 中可重复的攻击场景,以及代码发布前的结构化系统设计。那张架构图之所以重要,是因为它展示了完整技术栈:工具、外部数据源、LLM 引擎、智能体适配器、pytest 测试套件、攻击与探测层、评估器、报告系统,以及底层的 PyRIT。

@CSOonline 报道(3 个赞、48 次浏览、1 次收藏)认为,Microsoft 这波动作的重点,是把安全变成一项持续性的工程学科。相关 文章 称,RAMPART 会把红队发现转化为 CI/CD 测试,而 Clarity 会把结构化假设和失效分析写入 .clarity-protocol/ 目录,使其能够像代码一样被审查。
@washingtonpost 报道(18 个赞、14 条回复、7,910 次浏览)称,外界预计美国政府将建立一套机制,在强大的新 AI 模型公开发布前对其进行审查。@Rudra_81 指出(14 个赞、2 条回复、5,129 次浏览、7 次收藏)则认为,印度需要建立自己的 AI 监管、安全研究机构和评估能力,而不是被动回应其他国家的治理动作。
讨论洞察: 最大的分歧不在于是否需要控制措施,而在于应由谁来掌管:供应商、开源工具链、国家政府,还是新的公共评估机构。
与前一日比较: 5 月 20 日把智能体安全进一步拉近到工程控制。5 月 21 日则把它扩展为经 CI 测试的安全栈、仓库级决策协议和政府审查机制。
1.4 AI 经济学看起来不再只是定价问题,而更像资本配置与劳动力适应 🡕
第四组主题混合了资本密集度、劳动力解读和企业适应。相关帖子并未就 AI 是否属于泡沫达成一致,但都收敛到一点:仅靠模型定价,已经看不清当下的 AI 经济学。
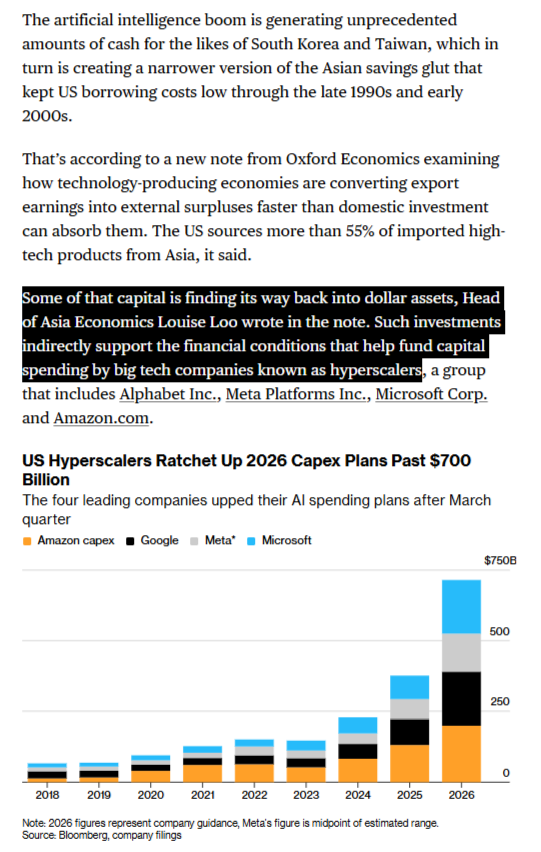
@scottlincicome 分享(9 个赞、2 条回复、3,967 次浏览)转发了一则 Bloomberg 观点,认为亚洲 AI 硬件出口顺差正在回流,推动美国 AI 资本支出。随附图表称,四家领先的超大规模云服务商已将 2026 年 AI 资本支出计划推高到 7,000 亿美元以上,使资本周期本身也成为当天 AI 讨论的一部分。
@1CoastalJournal 警告(8 个赞、3 次引用、1,958 次浏览)讨论了“AI LLM ROI 问题”,并附上一张幻灯片,称某 AI 业务板块 2025 年收入为 32.01 亿美元,而 AI 资本支出为 127.27 亿美元,相当于每 1 美元 AI 销售额对应约 4 美元资本支出。@cremieuxrecueil 补充说(43 个赞、3 条回复、5,344 次浏览)则从劳动力市场角度提出修正,认为初级岗位招聘下滑可能被错误归因于 GenAI,实际上也混入了居家办公趋势的影响。
@binance 表示(209 个赞、93 条回复、37,801 次浏览)称,其应对 AI 驱动就业市场变化的方式包括培训员工、分享内部用例,并继续招聘 380 多个岗位。回复分成两派:一派认为“AI 是提升效率的工具”,另一派则讽刺说,员工被培训只是为了跟上那些正在取代他们的系统。
讨论洞察: 当天并没有出现一条清晰统一的 AI 就业叙事。人们看到的是:企业在培训和招聘,批评者警告资本支出消耗过快,也有人认为 AI 正被拿来替其他原因造成的就业变化背锅。
与前一日比较: 5 月 20 日聚焦于工资、订阅 ROI 和劳动力市场筛选。5 月 21 日则把视角拉远,转向超大规模云服务商的资本支出循环、对 ROI 的怀疑,以及雇主如何围绕 AI 采用重组组织。
2. 什么让人沮丧
基准测试的胜利依然解释不了产品到底好不好
人们显然已经厌倦了那种无法预测助手能否处理真实工作流的抽象基准测试讨论。@boneGPT 指出(76 个赞、16 条回复、3,639 次浏览、9 次收藏)指出,尽管基准测试讨论没完没了,Gmail 仍然没有记忆、规则和稳定的回复模板;@haider1 报道(53 个赞、8 条回复、3,433 次浏览、10 次收藏)指出,推理模型会随着分配到的算力而变化;@keyang_xuan 指出(27 个赞、9 条回复、2,282 次浏览、15 次收藏)则认为,如果缺少从轨迹到结论的原则性映射,交互式评估就会变得松散且难以解读。严重程度:高。当前的应对方式是构建类似 Terminal-Bench Science 的领域专用任务集,或者干脆忽略排行榜上的细微分差。
先进智能体看起来受预算门槛限制
最常被重复提及的经济层面挫败感是:真正强大的智能体可能只对负担得起长时间算力的人开放。@emollick 提出(96 个赞、19 条回复、5,902 次浏览、12 次收藏)把这种分化说得很明确;@MilkRoadAI 将其定义为(36 个赞、6 条回复、4,427 次浏览、12 次收藏)把大学算力获取问题定义为共享预算问题;而对 @ClementDelangue 的 帖子 以及对 @TheAhmadOsman 的 本地基准测试帖子 的回复,则把讨论转向显存上限、预装模型,以及什么样的硬件才算够用。严重程度:高。人们目前的应对方式包括更小的本地模型、手动调优推理设置,或转向像 Daytona 这样的新型智能体算力提供商。
智能体周围的控制层仍然单薄
RAMPART/Clarity 帖子、《华盛顿邮报》的审查报道,以及 @Rudra_81 主张(14 个赞、2 条回复、5,129 次浏览、7 次收藏)对印度安全研究机构的呼吁,都在抱怨同一个缺口:许多组织仍缺乏可重复的流程,用来测试工具使用、记录假设,并在强大系统发布前对其进行审查。@CSOonline 报道(3 个赞、48 次浏览、1 次收藏)认为,提示注入、不安全的工具使用、权限提升和非预期自主行为,都无法顺畅纳入传统应用安全工作流。严重程度:高。当前的应对方式仍较为临时:CI 安全测试、Markdown 协议文件,或呼吁开展公共审查。
AI 经济正在发出相互矛盾的信号
同一天,人们既看到了 @binance 培训与招聘(209 个赞、93 条回复、37,801 次浏览),也看到了 @scottlincicome 分享(9 个赞、2 条回复、3,967 次浏览)那张超大规模云服务商资本支出激增图表、@1CoastalJournal 警告(8 个赞、3 次引用、1,958 次浏览)关于 AI 资本支出增速超过 AI 收入的说法,以及 @cremieuxrecueil 主张(43 个赞、3 条回复、5,344 次浏览)关于初级岗位招聘下滑可能被错误归因于 GenAI 的观点。严重程度:中高。令人沮丧的不只是对 AI 的恐惧,而是买方、劳动者和运营者都很难判断,眼前究竟是可持续的生产力提升,还是一个成本高昂的过渡期。
3. 人们希望出现什么
产品级工作流 AI,而不是基准测试表演
人们想要的不是又一个基准测试冠军,而是一个能在真实工作流中表现可预测的助手。@boneGPT 想要(76 个赞、16 条回复、3,639 次浏览、9 次收藏)希望 Gmail 拥有记忆、规则和回复模板;@haider1 放大传播(53 个赞、8 条回复、3,433 次浏览、10 次收藏)则指出,推理模型本来也不存在单一稳定分数。这是一个现实且紧迫的需求。Flash 模型和更窄领域的助手如今只能部分解决这一问题,但信息流仍把那个“显而易见”的邮件与应用控制层视为未解难题。机会:直接。
共享算力池与打包好的本地 AI 盒子
这些算力帖子描述了一层尚未真正存在的中间形态:比 DIY 调优更简单,但又比长期依赖云更便宜、更私密。@MilkRoadAI 指出(36 个赞、6 条回复、4,427 次浏览、12 次收藏)呼吁机构共享算力;@ClementDelangue 询问(43 个赞、5 条回复、1,964 次浏览、3 次收藏)讨论开发者是否想要打包好的本地硬件;@TheAhmadOsman 展示了(92 个赞、10 条回复、8,492 次浏览、148 次收藏)则表明,消费级 GPU 本地推理虽然可行,但仍然麻烦。这一需求现实、紧迫,而本地推理指南、AI PC 和新型云服务目前只能部分覆盖。机会:直接。
能像代码一样被审查的安全与评估工作流
Microsoft 的工具帖子、联邦审查报道,以及 @Rudra_81 呼吁(14 个赞、2 条回复、5,129 次浏览、7 次收藏)对本土评估能力的呼吁,都指向同一种需求:安全工作应当可测试、可审计,并且在制度上说得清。@CSOonline 报道(3 个赞、48 次浏览、1 次收藏)指出,Clarity 已经会写入由仓库管理的协议;@TheTuringPost 展示了(5 个赞、2 条回复、399 次浏览、3 次收藏)则展示了围绕 RAMPART 的安全测试栈。对实验室、企业和政府来说,这一需求既现实又紧迫,但今天的部分解决方案仍分散在开源工具和政策草案之间。机会:直接。
面向敏感个人数据的本地优先副驾驶
@SimonAubury 展示了(3 个赞、3 条回复、100 次浏览、1 次收藏)介绍了一套完全本地的支出分析栈,由 Moneydance、DuckDB、MCP、Claude Desktop 和 Ollama 组成。这是一个带有情绪色彩的现实需求:人们想得到有用的 AI 帮助,但不想把私人财务数据交给不受信任的托管模型。本地模型和 MCP 连接虽已提供部分答案,但目前的答案仍是一张 DIY 架构图,而不是主流产品。机会:竞争性。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Terminal-Bench Science | 基准测试 | (+) | 真实科学工作流、容器化任务、pytest 验证 | 仍在组装中;只有确定性、可评分的任务适用 |
| 交互式评估设计科学 | 评估方法 | (+) | 将轨迹与稳健性、安全性和可恢复性等判断联系起来 | 还是框架论文,不是开箱即用产品 |
| RAMPART | 安全测试框架 | (+) | 在 CI 中实现可重复的攻击与安全场景,基于 PyRIT | 需要适配器,并持续维护测试 |
| Clarity | 治理/设计工具 | (+/-) | 结构化假设审查和仓库管理的协议文档 | 有助于构建前审查,但不能做运行时强制执行 |
| Daytona | 智能体算力基础设施 | (+) | 为智能体和评估提供有状态沙盒、突发扩展能力和快速启动 | 面向高级工作负载的专用基础设施 |
| llama.cpp 加本地 Qwen 调优 | 本地推理栈 | (+/-) | 避免依赖 API,可在消费级 GPU 上运行 | 配置复杂,显存上限严格 |
| DuckDB + MCP + Claude/Ollama | 本地分析工作流 | (+) | 让私有数据留在本地,并提供只读查询路径 | DIY 架构,主流打包有限 |
| ERA | 科学软件生成 | (+) | 探索数千种代码变体,并超越较早基线 | 需要可评分任务和人工问题设定 |
| Cognitive Broadband | 网络运营 AI | (+/-) | 在问题检测和客户服务方面提出具体运营 ROI 主张 | 证据由供应商提供,范围局限于电信行业 |
总体满意度最高的,是那些消除了具体歧义的工具。@sanmikoyejo 指出(8 个赞、405 次浏览、3 次收藏)认可 Terminal-Bench Science,因为它把“面向科学的 AI”变成了带程序化验证的真实工作流;@TheTuringPost 展示了(5 个赞、2 条回复、399 次浏览、3 次收藏)和 @CSOonline 报道(3 个赞、48 次浏览、1 次收藏)认为,RAMPART 和 Clarity 把安全工作变成了 CI 测试和仓库管理的协议工作;@latentspacepod 强调(16 个赞、1 条回复、2,711 次浏览、4 次收藏)认可 Daytona 的有状态沙盒模式;@SimonAubury 展示了(3 个赞、3 条回复、100 次浏览、1 次收藏)则展示了 DuckDB、MCP、Claude Desktop 和 Ollama 如何组合成本地私有数据副驾驶。
评价较为复杂的,主要是那些仍需大量解读或调优的工具。@TheAhmadOsman 展示了(92 个赞、10 条回复、8,492 次浏览、148 次收藏)指出,本地推理可以在 8 GB 显卡上良好运行,但同一张图也显示了接近上限时配置会变得不稳定。@nokianetworks 链接到(2 个赞、106 次浏览、1 次收藏)转发了一篇 Cognitive Broadband 页面,声称首次接触解决率超过 50%、事件定性时间低于 5 分钟,并能主动发现 40% 的问题,但证据仍然是供应商视角。主要迁移趋势是:从单一分数排行榜和“localhost 假设”,转向工作流专用基准测试、有状态智能体计算机、CI 安全测试,以及本地/本地部署的数据路径。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Terminal-Bench Science | @sanmikoyejo / Harbor | 由研究人员贡献真实科学工作流的基准测试 | 弥合教科书式记忆与真实实验室任务之间的差距 | Harbor Task Format、容器、pytest 验证 | Beta | 网站、GitHub、推文 |
| Daytona | @daytonaio via @latentspacepod | 面向 AI 智能体的原生计算机和有状态沙盒 | 为智能体提供持久、可扩展的机器,而不是一次性的代码运行器 | 裸机、有状态快照、自定义调度器、CLI/API | 已发布 | 网站、文章、推文 |
| RAMPART | Microsoft | 面向智能体 AI 的持续安全测试 | 将提示注入和不安全工具调用发现转化为可重复测试 | Python、pytest、PyRIT | 已发布 | 仓库、推文 |
| Clarity | Microsoft | 面向智能体系统的结构化设计与失效分析协议 | 让假设和决策权衡像代码一样可供审查 | 桌面应用、Web UI、编码智能体集成、Markdown 协议 | 已发布 | 仓库、文章 |
| 本地个人财务 AI 技术栈 | @SimonAubury | 通过 DuckDB 和 MCP 对 Moneydance 数据进行本地支出分析 | 无需把原始数据发给不受信任的托管模型,也能回答私人财务问题 | CPython 3.14 + uv、DuckDB、MCP、Claude Desktop、Ollama qwen3.5 | Alpha | 推文 |
| ERA | Google Research / Harvard SEAS | 编写专家级实证软件的 AI 系统 | 将科学任务中原本数月的代码搜索与调优压缩掉 | Gemini、树搜索 | Alpha | 文章、推文 |
反复出现的构建模式,是围绕 AI 的基础设施,而不是再做一个通用助手。Terminal-Bench Science 定义更难的工作流任务,Daytona 提供智能体所需的计算底座,Microsoft 在 RAMPART 和 Clarity 中发布安全脚手架,而 @SimonAubury 展示了(3 个赞、3 条回复、100 次浏览、1 次收藏)展示了单用户本地优先栈在实践中的样子。

“面向科学的 AI”这一组尤其值得注意,因为构建者正在同时推动这个闭环的两端。Terminal-Bench Science 邀请科学家贡献能暴露当前智能体失败点的确定性工作流,而 ERA 则使用 Gemini 和树搜索,在数千种代码变体中搜索,并击败了疫情时期住院模型的顶级基线。两者合在一起,使科学成为评估、基础设施和自动化编程汇流最明显的领域之一。
6. 新的和值得关注的内容
“面向科学的 AI”在同一天同时补上了基准测试层和求解器层
@sanmikoyejo 表示(8 个赞、405 次浏览、3 次收藏)称,Terminal-Bench Science 正在寻找真实科学工作流,而不是教科书式记忆任务;项目页面称其目标是构建 100 多个带确定性验证的自然科学任务。同一天,@TechXplore_com 报道(7 个赞、2 条回复、1,692 次浏览、4 次收藏)称,Google 的 ERA 系统搜索了数千种代码变体,并生成了 14 个击败疫情时期顶级基线的 COVID-19 住院模型。一个项目在定义更难的任务,另一个则已经在自动化寻找更优解。
治理能力正在成为人们去绘制和梳理的对象,而不只是喊出来的口号
@CecilYongo 分享(10 个赞、2 条回复、410 次浏览)介绍了一张矩阵,涵盖全球南方 22 项政策工具,涉及人权影响评估、AI 安全评估与测试,以及第三方评估生态。再结合 @washingtonpost 报道 和 @Rudra_81 主张,一个值得注意的信号是:评估能力本身正在成为公共政策对象,而不再只是实验室内部事务。

本地优先 AI 不再像业余爱好者的怀旧情结
@TheAhmadOsman 发布(92 个赞、10 条回复、8,492 次浏览、148 次收藏)展示了具体的消费级 GPU 基准表,@SimonAubury 绘制了图示(3 个赞、3 条回复、100 次浏览、1 次收藏)展示了完整的本地私有数据副驾驶栈,而 @ClementDelangue 询问(43 个赞、5 条回复、1,964 次浏览、3 次收藏)则呼吁为开发者提供打包好的本地硬件。这种组合让本地优先 AI 看起来更像是封装和产品问题,而不是意识形态问题。
7. 机会在哪里
[+++] Workflow-grounded evaluation and provenance layers — Evidence from @keyang_xuan 的 帖子串、@sanmikoyejo 的 Terminal-Bench Science 帖子、@haider1 的 Noam Brown 片段,以及 @boneGPT 的 productmaxxing 帖子,都指向同一个缺口:团队需要的是能把轨迹、推理预算和产品结果联系起来的评估,而不是依赖单一最终分数。
[+++] Compute-access products for serious agents — Evidence from @emollick 的 compute-scarcity 帖子、@MilkRoadAI 的 Jensen 帖子串、@ClementDelangue 的 本地硬件帖子、@TheAhmadOsman 的 基准测试截图,以及 Daytona 讨论,都显示出共享算力、本地 AI 设备和面向智能体的计算机存在强劲市场。
[++] Agent safety control planes and public evaluation capacity — @TheTuringPost 的 RAMPART 解析、@CSOonline 的 文章帖子、@washingtonpost 的 审查报告、@Rudra_81 的 India 帖子串,以及 @CecilYongo 的 政策矩阵,表明市场对可重复测试、决策日志,以及第三方或国家级审查基础设施有明确需求。
[++] Local-first private AI workflows — @SimonAubury 的 本地金融技术栈、@TheAhmadOsman 的 消费级 GPU 基准测试,以及 @ClementDelangue 的 本地构建者硬件帖子,都指向一个直接市场:既能保持易用,又能把敏感数据、日志和媒体保留在本地或本地部署系统中的助手。
8. 要点
- 只要不能连接到工作流,基准测试讨论就在持续失去公信力。 当天最有力的评估帖子,讨论的是轨迹设计、对推理预算的依赖,以及邮箱记忆这类显而易见的产品缺口,而不是抽象的基准胜利。(来源)
- 算力稀缺正成为大众聊天机器人与高端智能体之间的分界线。 最明确的表述来自 @emollick:即使强大的聊天机器人变得便宜,重算力智能体也可能仍只服务于资金最充足的使用场景。(来源)
- 应对算力稀缺的路径,正分裂为共享基础设施和本地硬件两条线。 Jensen 式共享算力、Hugging Face 式本地盒子,以及消费级 GPU 基准表,本质上都在回应同一个获取问题。(来源)
- 安全工作正在程序化。 Microsoft 发布的 RAMPART 和 Clarity,再加上联邦和国家级评估提案,都表明行业正转向可重复测试、协议文件和公共审查,而不是非正式评审。(来源)
- “面向科学的 AI”正在同时推进基准测试侧和求解器侧。 Terminal-Bench Science 正在定义更难的真实工作流,而 ERA 已经能够以足够快的速度搜索科学代码,并击败较早基线。(来源)
- 资本密集度已成为主流 AI 讨论的一部分。 Bloomberg 的超大规模云服务商图表和“AI Capex Furnace”警告,都把 AI 经济学从模型定价推向了资本支出可持续性。(来源)