Twitter AI - 2026-05-22
1. 人们在讨论什么
1.1 代理式 AI 将经济分成两个层级——富人用代理,其他人用聊天机器人 🡕
5 月 22 日最突出的信号,是算力稀缺正在成为一种结构性分界。人们担心的并不是 AI 会不可用,而是最强大的 AI——能够自主执行多步骤工作的代理——会因为价格过高而超出大多数用户和组织的承受范围;与此同时,简单聊天机器人则会越来越便宜,最终甚至免费。
@emollick 指出(273 个赞、17 次转发、43 条回复、14,456 次浏览、34 个书签)表示,即便单轮聊天机器人的价格持续下降,复杂的代理式工作流仍将维持高成本,并将其归结为一个 AI 普及公平问题:“地球上的每个人都将免费获得非常好的聊天机器人,这对 AI 的民主化是好事;但真正优秀、能完成复杂工作的代理,会消耗多出数千倍的 token,因此只会留给那些付得起钱的地方。”一条来自从业者 @gotnerfedhq 的回复则反驳了“这是未来风险”的说法:“这种分层已经体现在厂商定价里了。过去 60 天里,每一次悄无声息的涨价都落在代理式套餐,而聊天机器人套餐要么持平,要么更便宜。”
@IntuitMachine 总结(527 次浏览、7 个书签)分享了一项精确量化代理式工作成本的学术研究,并直接贴出了论文摘要:

这篇论文——《AI 代理如何花掉你的钱?分析并预测代理式编码任务中的 Token 消耗》(Longju Bai 等,密歇根大学 / Stanford / Google DeepMind / MIT / Microsoft AI)——分析了 SWE-bench Verified 上 8 个前沿模型的 16,000 次生产运行。主要发现包括:代理式任务消耗的 token 数量是代码聊天的 1,000 倍;同一任务的运行最多可相差 30 倍;成本主要由输入 token 而非输出 token 驱动;更高的 token 消耗并不会提升准确率——准确率在中等成本时达到峰值,在更高支出下趋于饱和。Kimi-K2 和 Claude-Sonnet-4.5 每个任务平均比 GPT-5 多消耗超过 150 万个 token。前沿模型也无法准确预测自身的 token 成本(r = 0.39),而且会持续低估。
@cerebras 发布(46 个赞、7 次转发、4,595 次浏览、11 个书签)表示,在团队开始把 AI 融入日常工作后,速度“从根本上变得重要起来”,并引用 CEO Andrew Feldman 的话说:“Cerebras 的推理只是在特定用例里更快吗?不是,它是全面更快。大模型、小模型、美国模型、中国模型、万亿参数模型、十亿参数模型——全面都更快。”
讨论洞察: 对 Mollick 的回复并未否认这种“两层结构”,而是进一步把它说得更具体。争议点不在于会不会分层,而在于这种分化是即将到来,还是其实已经发生——从业者认为,它已经被写进当前的定价页面里了。
与前一天的比较: 5 月 21 日关注的是算力稀缺带来的机构准入问题(大学联合采购、本地设备)。到 5 月 22 日,讨论进一步上移到了结构性经济层面:学术界量化了代理成本,DeepSeek 与美国模型之间出现了持续性的价格不对称,而让代理昂贵的具体机制也被点明——不是输出生成,而是输入 token 的累积。
1.2 AI 安全与治理:在科技行业施压下,行政令被搁置;民调显示 82% 的公众支持测试 🡖
多条信息汇聚到同一个政策事件及其结构性解释上。5 月 22 日,在科技行业领袖最后一刻打电话游说后,白宫没有签署外界原本预期会发布的 AI 行政令。也就在同一天,民调数据显示,82% 的美国人——无论是 Trump 还是 Harris 的选民——都支持在 AI 发布前强制进行安全测试。
@washingtonpost 报道(8 个赞、7 次转发、4,313 次浏览)报道了这条突发消息:“与科技行业领袖最后一刻的电话沟通,帮助说服 Trump 总统不要签署”这份原定推出的 AI 行政令。社区反应出现分化:@draken1721 称其为“罕见的华盛顿危机公关胜利”;@burcham_don 则称之为“彻底出卖”。
@S_OhEigeartaigh 发布(9 个赞、2 次转发、368 次浏览、2 个书签)分享了一篇被 Cambridge Forum on Technology and Global Affairs 接收的预印本论文——《芯片告急:技术行为者如何成为美中“AI 竞赛”中的权力掮客》。论文梳理了 2017 至 2025 年间,“AI 竞赛”叙事如何被美国科技行业行为者“在很大程度上、且往往以相当协调的方式”持续推动。论文记录指出,这一叙事反复被用来针对安全与监督;儿童安全保护、反垄断规则、版权法和环境限制,都被列为在“竞赛”框架下被削弱的具体政策领域。作者写道:“尽管这一竞赛叙事在学术专家或美国公众中几乎没有市场,但它仍被极其高效地武器化了。”
@gc22gc 分享(3 个赞、1 次转发、1,344 次浏览)分享了民调数据:82% 的美国人支持在 AI 发布前进行安全测试;88% 支持针对国家安全风险进行测试;87% 支持针对儿童和家庭风险进行测试。在所有风险类别中,Trump 和 Harris 的选民对强制测试的支持率都超过 80%。
@ChrisRMcGuire 总结(12 个赞、262 次浏览)指出了他所说的美国 AI 政策中明摆着的矛盾:“1. 因为不能输给中国,所以不搞国内 AI 安全监管。2. 因为我们对中国领先得够多,所以把 AI 芯片出口给中国。3. 再去和中国谈 AI 安全,好让中国自己搞国内监管。说得通吗?”
讨论洞察: 最有力的回复并没有争论这份行政令本身是好是坏,而是聚焦于其运作机制:行业游说借“竞赛”之名搁置监管,而两党选民中的绝大多数都支持测试。当天的证据描述的并不是竞争力与安全之间的取舍,而是一个代表性缺口。
与前一天的比较: 5 月 21 日讨论 AI 安全时,重点还是工程控制手段(RAMPART、Clarity 协议、国家评估能力)。到了 5 月 22 日,焦点转向治理:行政令事件、学术界对“竞赛叙事”武器化的记录,以及民调结果与政策结果之间的尖锐反差。
1.3 中国 AI 加速:Qwen 3.7 和 DeepSeek 的永久降价重塑成本基线 🡕
5 月 22 日的三条信息共同指出,中国 AI 模型已经从“基准测试里的威胁”转变为“重置行业价格结构的力量”。
@GestaltU 指出(13 个赞、1,648 次浏览、7 个书签)称,Alibaba Qwen 3.7 Max 的发布“比 DeepSeek 时刻重要得多”,并声称它在大多数关键基准上超越了 Claude Opus Max 和 GPT-5.5,成本却明显更低;其推理架构还“动摇了支撑美国 AI 泡沫的整套论点”。
@deliprao 指出(6 个赞、2 次转发、801 次浏览)称,DeepSeek 已将此前的折扣永久化,并分享了一张价格对比表:

表格显示,DeepSeek-V4-Pro 的价格为每百万 token $0.435/$0.003625/$0.87(输入/缓存命中/输出);相比之下,Google Gemini 3.5 Flash 的输出价格约为其 10.3 倍,OpenAI GPT-5.4 为 17.2 倍,Claude 4.6 Sonnet 为 17.2 倍,Claude 4.7 Opus 为 28.7 倍。@deliprao 指出,这个模型“已经足以覆盖大多数‘正常’用例”。
@Techmeme 报道(3 个赞、1 次转发、925 次浏览)称,中国 AI 初创公司在 2026 年第一季度融资 162 亿美元,同比增长 185%,其中 Moonshot、Z.ai 和 MiniMax 领跑。
@nicrypto 指出(9 个赞、4 次转发、191 次浏览)称,DeepSeek 创始人表示目标是 AGI,而不是利润:“没有 IPO 计划,没有营收目标,也没有商业化路线图。”
讨论洞察: 回复并未质疑这些基准测试说法,而是聚焦其下游影响——现在谁还负担得起构建成本,以及那些建立在高溢价定价假设之上的美国实验室估值会发生什么变化。
与前一天的比较: 5 月 21 日几乎没有多少中国相关内容。到了 5 月 22 日,三个相互强化的信号同时出现:具体模型表现(Qwen 3.7)、永久价格动作(DeepSeek)和融资数据(162 亿美元),共同指向同一个结论——中国 AI 已不再只是基准测试中的新奇样本,而是成本结构上的真正扰动者。
1.4 代理安全正在成为一个产品类别 🡕
5 月 22 日,一组面向开发者和构建者的信息把代理安全视为一个工程问题,而不是政策讨论:具体的解决方案已经在落地。
@infisical 发布(8 个赞、2 次转发、123 次浏览、3 个书签)表示,凭据经纪是应对“提示注入导致凭据窃取”的正确架构方案:他们的开源 Agent Vault “位于代理与其所需 API 之间,持有真实凭据,并在网络层把凭据替换进去。代理看到的始终只是占位符。”
@trishoolai 介绍(13 个赞、10 次转发、282 次浏览)介绍了一个基于 Bittensor、用于训练其 Halo 防护模型的对抗训练闭环:

这个飞轮运行在 Bittensor Subnet 23 上:部署 Halo 模型后,矿工竞争性地用新型越狱攻击去攻破它,验证者为每次攻击打分(0/1/2),最佳提交获得 emissions,形成的对抗数据集再用于训练下一版 checkpoint。新颖性过滤器会剔除复制来的提示词。每天向矿工分发 $1,500;默认情况下,当防护模型守住攻击时,50% 的 emissions 会被销毁。使用 OpenClaw、Claude Code、Codex、Cursor 或 LangChain 的团队,都可以把 Halo 作为一层安全防护。
@EveryDevAi 分享(2 次转发)介绍了 AutoHarness 这一开源工具——只需两行代码就能封装任意兼容 OpenAI 的客户端,并加入完整管线:风险分类、机密扫描、成本归因和审计日志。该 GitHub 仓库已有 283 个 star,标签涵盖 audit、multi-agent、safety、governance、prompt-injection 和 context-management。
讨论洞察: 这三个工具分别代表三种不同路径:网络层凭据隔离(Agent Vault)、基于对抗训练的防护模型(Trishool Halo),以及 API 层治理埋点(AutoHarness)。从不同方向同时收敛到同一个问题,说明代理安全层正在固化为一个独立产品类别。
与前一天的比较: 5 月 21 日讨论代理安全时,重点还是 Microsoft 的 RAMPART 和基于 CI 的安全流水线。到了 5 月 22 日,重心从企业工具转向开源、区块链激励,以及开发者可自助使用的解决方案。
1.5 语音 AI 致电数千家面包店;代理正在进行结构化现实世界数据采集 🡒
@Carles_Reina 分享(98 个赞、11 次转发、5 条回复、7,951 次浏览、44 个书签)展示了 ElevenLabs Agents 平台的一个用例:一位名叫 Charles Lorin 的构建者使用 AI 代理致电数千家法国面包店,调查法棍价格。配图显示,调查已完成,并生成了真实价格分布的柱状图。回复中也注意到了这个用例的新颖性:@ktoya_me(4 个赞)说:“我觉得你用 guinndex 发明了一个全新的类别!”
这是一个很具体的示范:AI 代理可以通过语音通话,大规模完成结构化数据采集。过去,这种能力通常需要人工呼叫员或专门的调查基础设施。
与前一天的比较: 5 月 21 日关于代理式用例的证据更偏基础设施(沙盒计算机、遥测)。而 5 月 22 日则出现了一个已经完成、面向消费者且产出了真实数据的任务。
2. 什么让人感到沮丧
代理成本不可预测、因模型而异,而且在结构上与任务难度脱节
最具体的挫败感来自 AI 代理的成本波动。1.1 节引用的论文把这个问题说得很清楚:同一任务、同一模型,不同运行之间的 token 消耗最多可相差 30 倍;人工评定的任务难度与实际 token 成本相关性很弱(r = 0.32);而前沿模型在执行前也无法预测自己的成本(r = 0.39,而且是系统性低估)。实际含义是:在生产环境中运行代理的工程团队无法可靠地做预算——同一个任务,这次可能只花 $0.20,下次却可能花 $6.00,而且执行前没有可信信号。严重程度:高。@IntuitMachine 帖子串 提到的应对办法,是追踪重复文件读取操作,并把任务路由给 token 效率更高的模型(对代理工作负载使用 GPT-5,而不是 Claude 或 Kimi 系列)。
AI 推理没有可验证回执——团队正在为不可审计的公用能力付费
@ambient_xyz 写道(10 个赞、1 次转发、225 次浏览)指出,AI 推理缺乏其他公用服务都有的可验证性:“用的是不是正确的模型?路由是否变了?安全策略是不是截断了你的响应?延迟飙升是不是因为你被降级塞进了拥挤队列?没有证据,只有账单。”其他公用服务——电力、物流、支付——都有可计量、可核验的凭证。AI 却成了“那个奇怪的例外”,导致团队“花几周时间和供应商争论,财务和工程互相扯皮,SRE 还得因为‘昨天明明还好好的’被叫醒”。严重程度:中高。现有应对方法是自行构建内部日志,但供应商侧的验证仍然缺失。
AI 实验室的不透明让研究者和从业者感到沮丧
@GaryMarcus 发布(20 个赞、619 次浏览)直接批评 OpenAI 在 Erdos 问题结果上的披露不足:没有说明一共尝试了多少道题,训练集是否包含那个新发现的反例,也没有说明用了多少算力。回复 @rugbist_(2 个赞)说:“erdos 问题这个例子比大多数人意识到的更有冲击力,那种透明度正是我们已经失去、而且不会再回来的东西。”严重程度:中等。应对办法是独立复现,但那需要获取实验室私下掌握的基准数据。
AI 初创公司的 ARR 数据被系统性夸大
@TechCrunch 报道(10 个赞、5,754 次浏览)分享了一项 TechCrunch 调查,确认“合同 ARR”(CARR)经常被直接当作 ARR 对外宣布,而投资人对此心知肚明:“当一个赛道里有一家这么做,其他人很难不跟着做,只为了不掉队。”这种失真让竞品分析和融资决策都变得不可靠。严重程度:中等。应对方式是明确问创始人,这些数字究竟代表 CARR,还是已经到账的现金收入;但前提是你得知道要这么问。
用户对 Sonnet 4.5 形成情感依赖,担心它被弃用
@MOCHANG_Y 发布(20 个赞、5 次转发、225 次浏览)带有 #keepSonnet45 标签:

这条推文认为,人们看重 Sonnet 4.5,并不是因为它的代码能力,而是因为它的情感共鸣:“不是每个用户都写代码。我们当中有些人只是需要被倾听。”#keepSonnet45 标签则暗示,这是一种有组织的社区回应。严重程度:低(模型弃用本来就常见),但这个情感诉求本身很具体——用户看重的是模型的语气,而不是基准成绩——这一点值得注意。
3. 人们希望存在什么
一个持久、理解上下文、无需反复解释就知道你在做什么的 AI
@TakoTreba 介绍(21 个赞、512 次浏览、6 个书签)提出了数据中最具体的未满足需求:“我想要一只鸟,它知道我做的所有事,而且一直都在。我可以跟它说话,也可以给它写字,不用解释我在做什么,或者我需要什么。它就是知道。”这里的语境是营销工作,横跨邮件、研究、内容创作、新闻简报、活动和数据分析——这些环节现在都能借助 AI,但每次会话都得重新建立上下文。“我不要 integrations。我想要的是对我全部工作的鸟瞰视角。”来自 @TechWithMatteo 的回复提到,他们的 newsletter AI 能把原本 6 小时的研究和初稿工作压缩到 30 分钟,可算部分解决方案。@chasing_next 则把“个人操作系统”(文件 + AI)描述为当前替代方案。但二者都没有解决“跨所有任务保持持久上下文”这个需求。机会类型:直接机会。目前似乎还没有产品能完整解决它。
一个真正可用的代理式工作流执行前成本估算器
1.1 节总结的论文已经直接暗示了这个需求:如果前沿模型对自身 token 成本的预测相关性只有 r = 0.39,而且还是系统性低估,那么市场上就存在一个空白——在执行前仅根据任务描述估算代理运行成本的工具。虽然没有哪条推文明说“我希望有这个”,但这正是整组代理成本挫败感在实践中的直接推论。机会类型:竞争型——面向代理的成本预测工具,与现有模型路由产品相邻。
可验证的推理回执——证明在什么策略下跑了什么模型
@ambient_xyz 阐述 直接提出了这一点:“每次调用都附带一份可验证回执:跑了什么、在什么策略下、走了什么路由、最终交付了什么。”目前还没有主流 AI API 提供商提供这项能力。机会类型:直接机会。它与支付领域的 Stripe、物流领域的 FedEx tracking 之间的类比,让这个产品直觉非常清晰。
真正适用于 AI 代理的文档解析
@llama_index 发布(6 个赞、755 次浏览、5 个书签)提到 ParseBench,称其为“首个面向 AI 代理的文档 OCR 基准”,并指出“现有基准没有覆盖 AI 代理真正需要的东西”。回复 @Hershal0_0 说:“文档解析是 AI 的最终 Boss。希望以后少受点表格带来的创伤。”这种具体表述——去测试代理真正需要的能力——说明面向生产环境的代理文档解析仍然没有被解决。机会类型:竞争型。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| DeepSeek-V4-Pro | LLM | (+/-) | 输出 token 比竞争对手便宜 10–29 倍;“足以满足大多数正常用例” | 有中国国家背景;没有商业化路线图;公开表述的使命仅为 AGI |
| Qwen 3.7 Max | LLM | (+) | 据称以更低成本在关键基准上超越 Claude Opus Max 和 GPT-5.5;能执行实际工作流(收件箱、研究、内容) | 数据中独立验证有限;主要由分析类账号称赞 |
| Claude Sonnet 4.5 | LLM | (+) | 社区有明显情感依赖;人们看重其语气和共情能力,而不只是代码能力 | 预计会被弃用;社区正通过 #keepSonnet45 组织回应 |
| GPT-5(系列) | LLM | (+/-) | 在 SWE-bench 代理式研究中 token 效率最高(每任务约 50 万个 token,而 Claude 约 200 万个) | 输出成本仍比 DeepSeek 高 17 倍;更多 token 并不会带来更高准确率 |
| Claude 4.5/4.7 | LLM | (+/-) | 广泛用于代理式编码;Sonnet 4.5 的对话质量受到重视 | 按研究,Claude Sonnet 4.5 在每个代理式任务上比 GPT-5 多消耗 150 万以上 token |
| Gemini 3.5 Flash | LLM | (+) | Gemini 4 正在升温;擅长文档提取与理解;视觉任务速度约为 3.1 Pro 的 6 倍 | 输出价格比 DeepSeek 高 10 倍 |
| Cerebras | 推理 | (+) | 据称对所有模型规模和类型都更快:无论大小、美国还是中国模型 | 仅为单家公司说法;未展示独立基准 |
| ElevenLabs Agents | 语音 AI / 代理平台 | (+) | 已成功用于致电数千家面包店,实现大规模结构化数据采集;还在增加本地企业部署能力(本地 GPU、边缘推理、气隙环境) | 面向消费者的用例仍在探索期 |
| LangChain / Cursor / Claude Code / OpenClaw | 代理框架 | (+/-) | 部署广泛;Trishool 明确将其视为需要 Halo 安全层保护的代理表面 | 凭据处理仍是未解决缺口(Agent Vault 正在补位) |
| Bittensor(Subnet 23) | AI 基础设施 / 区块链 | (+/-) | 用于经济激励式对抗训练;Trishool Flywheel 运行于其上 | 相对小众;代币经济学增加复杂性;仍处早期 |
| AutoHarness | 代理治理 | (+) | GitHub 已有 283 个 star;两行代码即可封装任意兼容 OpenAI 的客户端;加入风险分类、机密扫描、成本归因和审计日志 | 仅 v0.1.0;使用数据有限 |
| Agent Vault(Infisical) | 代理安全 | (+) | 开源;网络层凭据隔离;代理永远看不到真实凭据 | 只有视频演示;采用情况未知 |
| Modal | 计算 / AI 基础设施 | (+) | 为 Stanford AI Measurement Science 的 GPU 评分基础设施提供算力;可扩展,适合教育场景 | 数据中没有负面信号 |
总体满意度范围: 当天的证据主要被成本与透明度挫败感主导。DeepSeek 创造了新的成本底线,让西方模型的定价显得存在结构性溢价;而量化代理成本波动的学术研究也表明,即便换用更便宜的模型,代理运行本身的不可预测性依然是现实障碍。当天提到的主要成本管理办法,是针对不同任务做模型路由(用 GPT-5 提高效率,用 Gemini 处理文档类任务)。
迁移模式: 数据中没有出现明确迁移模式,但 DeepSeek 将折扣永久化、Qwen 3.7 又给出强势基准表现,这些都为成本敏感型代理工作负载从 Claude/GPT 迁移到中国模型创造了条件。
竞争动态: 最清晰的竞争信号,是 DeepSeek 通过永久折扣锁定了结构性价格优势;与此同时,论文又发现不同模型在代理效率上每任务可相差 150 万以上 token——这意味着模型选择不只是质量决策,也是成本决策。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| 法棍价格调查代理 | Charles Lorin(通过 ElevenLabs) | AI 语音代理致电数千家面包店,记录结构化价格数据 | 无需人工呼叫员即可大规模采集现实世界结构化数据 | ElevenLabs Agents 平台 | 已发布(调查已完成) | 帖子 |
| Agent Vault | Infisical | 位于 AI 代理与 API 之间的凭据经纪;代理只能看到占位符 | 提示注入 → 凭据外泄攻击路径 | 开源、网络层代理 | 已发布(开源) | 帖子 |
| Trishool Halo | Trishool AI | 通过 Bittensor Subnet 23 上的对抗矿工持续训练的 AI 防护模型 | 处理真实资金或敏感操作的 AI 代理遭到越狱攻击 | Bittensor 代币经济学、对抗训练闭环 | Beta(已在 Subnet 23 上线,每天分发 $1.5K) | 帖子 |
| AutoHarness | aiming-lab | 两行代码封装任意兼容 OpenAI 的客户端;加入风险分类、机密扫描、成本归因和审计日志 | 代理在缺乏治理和审计轨迹的情况下直接上线生产 | Python、MIT 许可证 | 已发布(v0.1.0,283 个 star) | GitHub |
| ParseBench | LlamaIndex | 首个按 AI 代理真实需求设计的文档 OCR 基准 | 现有基准无法衡量面向代理场景的文档解析质量 | LlamaIndex 基础设施 | Alpha/RFC(通过 webinar 宣布) | 落地页 |
| BitCPM-CANN | OpenBMB × Tsinghua × ModelBest | 1.58-bit LLM 系列(0.5B–8B),在 Huawei Ascend 910B 上训练;相比 BF16 内存降低 6 倍;保留 95–97% 的基准表现 | 无需新芯片,即可在边缘设备(手机、PC、汽车)上运行有能力的 LLM | Huawei Ascend 910B、1.58-bit 量化、MiniCPM4 架构 | 已发布(在 HuggingFace + ModelScope 上开源) | 帖子 |
| Kethic 编程语言 | @micheal_node(16 岁,尼日利亚 Ibadan) | 专为 AI 编写代码而设计的编程语言;输出 token 比 TypeScript 少 96% | AI 编码代理生成冗长 TypeScript;Kethic 追求 token 效率 | 自定义编译器 | Alpha(编译器可用,黑客松获奖) | 帖子 |
值得关注的项目细节:
Agent Vault(Infisical)解决了数据中最具体、最明确的代理安全缺口:提示注入导致的凭据窃取。它的架构简单且易于组合——经纪层持有凭据,并在网络层完成替换,这意味着即便代理被攻破,其遵循指令的过程也无法暴露机密。它兼容任何基于 API 的代理技术栈。
Trishool Halo 的飞轮设计很不寻常:它不是一次性构建对抗数据集,而是持续付费给矿工,每周寻找新的攻击方式,从而不断刷新数据集。新颖性过滤器会在评分前剔除复制提示词,因此数据集不容易被刷;而经济激励则意味着矿工会持续寻找新的攻击面。这个项目正被定位为 LangChain、Claude Code、Cursor 等代理框架的插件式安全层。
Kethic 是一个值得注意的信号:一位来自尼日利亚、16 岁的自学构建者,专门创造了一种编程语言,把 AI 编码代理的 token 消耗相较 TypeScript 降低了 96%。黑客松获奖和可运行编译器说明这并非玩具项目。如果代理成本真如 SWE-bench 研究所说主要由输入 token 驱动,那么面向 token 效率设计目标语言,确实能直接缓解成本问题。
反复出现的构建模式: 三个彼此独立的团队(Infisical、Trishool、aiming-lab/AutoHarness)都在没有明显协调的情况下,收敛到“代理安全/治理”这个产品类别。它们面对的是同一个问题——AI 代理已经在生产环境中运行,但监管和控制不足——只是路径不同:网络层隔离、对抗训练、API 层埋点。
6. 新动态与值得关注的事项
边缘 AI 的规模可能超过数据中心市场
@wolfejosh 分享(11 个赞、1,677 次浏览、5 个书签)分享了 Lux Capital 投资人信的标注页,提出一个结构性判断:边缘 AI 将远超数据中心 AI:
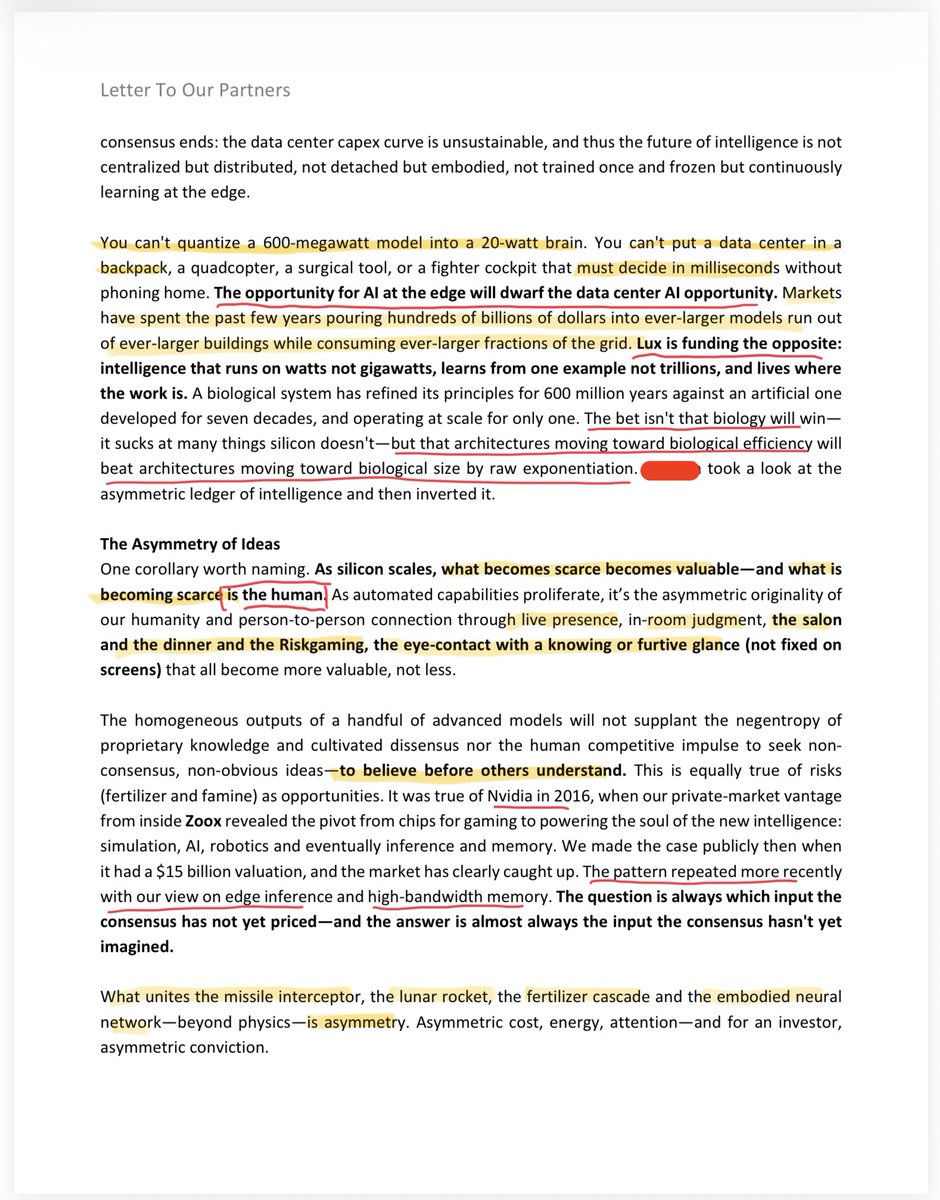
这封信认为,长期赢家将是那些走向“生物式效率”而不是单纯追求规模扩张的架构。关键约束不是模型能力,而是能否在物理世界中部署:战斗机驾驶舱中的毫秒级决策、手术工具、四旋翼无人机、移动设备。BitCPM-CANN(见第 5 节)就是这一方向的具体例子:1.58-bit 量化在 Huawei Ascend 硬件上实现 6 倍内存压缩,同时保留 95–97% 的基准表现。Lux 的信件与 OpenBMB 的发布出现在同一天,彼此之间看不出协调迹象。
即使是最支持 AI 的群体,美国人对 AI 的信心也很低
@AFpost 分享(35 个赞、2,589 次浏览)分享了 Spiritual Migration Survey 2025 的调查数据:

即便是对 AI 最有信心的群体(每周或更频繁参加宗教活动的人),比例也只有 19%。这种模式——宗教参与度越高,信心越强——有些反直觉,回复中也没有给出因果解释。更广泛的含义是:无论哪个群体,美国整体人口对 AI 的信心都偏低。
DeepSeek 由使命而非指标驱动——与美国初创生态形成结构性反差
就在 TechCrunch 发布调查、确认美国 AI 初创公司普遍夸大 ARR 的同一天,@nicrypto 指出 表示,DeepSeek 创始人称目标是 AGI,而不是利润——没有 IPO 计划,也没有营收目标。中国 AI 初创公司在 2026 年第一季度融资达到 162 亿美元(据 @Techmeme,同比增长 185%)。这种结构性反差在于:美国 AI 初创公司的估值由那些已被证实经常被夸大的指标驱动;而中国 AI 实验室则明确拒绝商业指标,并由国家资本支持。
据称 OpenAI 正通过 360 度摄像头记录家庭活动,用于智能家居 AI 研究
@LLMJunky 分享(15 个赞、2 次转发、2,237 次浏览、7 个书签)分享了 @loffredojeremy 的一则报道,称 OpenAI 正向纽约市数百个家庭付费,让他们在家中安装 360 度摄像头,记录日常活动(吸尘、做饭、洗碗等),并定期回收存储卡。据称目的在于开发一款智能家居设备。一个值得注意的细节是:据说该项目的主管是行为心理学家,而不是 ML 工程师。
这是一则未经证实的二手说法(某个人转述承包商的描述)。回复普遍把它当作关于 OpenAI 硬件野心的可信猜测,而不是 OpenAI 已确认的正式公告。
Google I/O 2026:AI 已成为 Google Search 的默认模式
@semrush 总结(4 个赞、2 次转发、190 次浏览)总结了 Google I/O 2026 的公告:Gemini 3.5 Flash 已向所有用户开放;搜索栏现在接受文本、图片、视频和文件(“智能搜索框”);Universal Cart 允许由 Gemini 驱动的多零售商结账;Agentic Search 现在可直接处理复杂预订任务。总结的结论是:“AI 不再是 Google Search 的附加功能。AI 就是 Google Search。”
7. 机会在哪里
[+++] 代理成本监测与执行前估算 —— 关于代理 token 消耗的学术研究(第 1.1 节)量化了一个真实的生产问题:同一任务,成本可相差 30 倍,而执行前没有可靠信号。论文明确指出,执行前成本预测尚未解决(相关性 r = 0.39)。相关工具领域——成本归因、路由、预算预警——仍很早期。AutoHarness 把成本归因列为四项功能之一;但目前还没有产品专注于代理工作负载的执行前成本估算。证据来自:Mollick 的两层结构判断、SWE-bench 研究、代理式定价层级的观察,以及 IntuitMachine 对 16,000 次运行的分析。
[+++] 代理安全层:凭据隔离、治理与对抗加固 —— 一天之内出现了三个彼此独立的工具(Agent Vault、Trishool Halo、AutoHarness),全都在解决同一个问题:代理已经在生产环境中运行,却缺乏足够的安全控制。提示注入 → 凭据窃取,是最具体的攻击路径;治理和审计日志,则是企业眼下就有需求的合规能力。证据来自:Infisical、Trishool、aiming-lab/AutoHarness,以及 Aptos Move Prover 的工作——它也在区块链场景中显示出同样模式。
[++] Verifiable inference receipts / AI utility metering — The gap @ambient_xyz 所描述的问题(无法证明实际运行的是什么模型、采用了什么策略、经历了什么延迟)是一个企业采购和 SRE 问题,而当前没有现成解法。其他所有公用服务都有这种能力。这个类比很强,市场也真实存在:那些已经因为和供应商扯皮而耗掉数周的团队,会愿意付费更快地解决争议。证据来自:ambient_xyz 的帖子,以及更广泛的推理成本挫败感信息。
[++] 边缘 AI 部署工具与量化 —— Lux Capital 的信和 BitCPM-CANN 指向的是同一个缺口:模型需要能跑在“以瓦特计、而不是以吉瓦特计”的硬件上,同时保留生产级质量。BitCPM-CANN 证明,今天已经能做到在保留 95–97% 表现的同时,把内存需求降低 6 倍。瓶颈在工具、部署和硬件兼容性,而不是能力本身。证据来自:wolfejosh/Lux 帖子、BitCPM-CANN,以及 wolfejosh 关于“边缘将超过数据中心”的判断。
[++] 面向知识工作者的跨会话持久上下文 —— @TakoTreba 的“鸟”帖子异常具体:一个能跨全部工作持续保留上下文、不需要每次重新解释、并且理解营销工作中各环节相互关联的系统。当前工具要么要求用户每次重建上下文,要么要求自己维护外部知识库。未满足需求是:一种无需显式管理、就能积累并应用持久工作上下文的个人 AI。证据来自:TakoTreba 的帖子、chasing_next 的个人 OS 变通方案,以及 Sonnet 4.5 社区对关系连续性的强调。
[+] AI 初创公司指标透明度 / CARR 与 ARR 信号服务 —— TechCrunch 的报道证实,投资人和记者所依据的,往往是被系统性夸大的营收数据。无论是一项标准化并审计 AI 初创公司营收口径的服务,还是仅仅为主要 AI 公司同步公布 CARR 与 ARR,都会对分析师、竞品创始人和 LP 有价值。证据来自:TechCrunch 的 ARR 调查。
[+] 面向 AI 代理的 token 高效编程语言 —— Kethic 项目(比 TypeScript 少 96% token)以及 SWE-bench 关于“驱动代理成本的是输入 token 累积而非输出”的发现,都表明语言层面的 token 效率是一个真实优化目标。一种专门面向 AI-to-AI 代码生成设计的语言或转译器——也就是代码读者是模型,而不是人——有可能实质性降低代理式编码成本。证据来自:Kethic 帖子、SWE-bench token 消耗研究。
8. 要点
-
聊天机器人与代理之间的成本分层,已经写进定价页面,而不是尚未发生。 @emollick 把它描述为未来的民主化风险;而来自 @gotnerfedhq 的从业者回复则纠正了时间线:过去 60 天里,每一次悄无声息的涨价都落在代理式定价层。 (来源)
-
代理式成本是代码聊天的 1,000 倍,单次运行波动可达 30 倍——而模型连自己的成本都预测不准。 一篇来自密歇根大学/Stanford/Google DeepMind 团队、分析 16,000 次生产运行的论文发现,驱动代理成本的是输入 token 的累积,而不是推理或输出;同一任务的运行成本最多可相差 30 倍,这使得在现有工具条件下,代理预算从结构上就不可靠。 (来源)
-
** AI 行政令在科技行业游说电话后被搁置,而同一天的民调显示,82% 的公众支持安全测试。** 治理缺口不在于公众反对监督,而在于行业借助“竞赛叙事”进行游说的有效性;而当天另一篇学术论文恰好记录了,这套叙事是如何被有意构建出来的。 (WaPo 来源; 学术来源)
-
DeepSeek 的永久降价创造了一个成本底线,让西方模型的定价显得存在结构性溢价。 价格表显示,DeepSeek-V4-Pro 的输出成本比竞争对手低 10–29 倍。再结合 SWE-bench 关于代理工作负载中模型选择首先是成本决策的发现,这构成了真实的迁移压力。 (来源)
-
代理安全正在固化为一个产品类别:一天之内出现了三个独立工具。 Agent Vault(凭据经纪)、Trishool Halo(通过代币经济学持续训练的对抗式防护模型)和 AutoHarness(API 层治理)都在没有明显协调的情况下,瞄准了生产环境中的代理安全。 (Infisical; Trishool; AutoHarness)
-
中国 AI 初创公司在 2026 年第一季度融资 162 亿美元(同比增长 185%),而 DeepSeek 创始人明确拒绝商业指标。 这与美国 AI 初创公司形成了结构性反差——TechCrunch 已确认,美国初创公司经常把合同 ARR 直接宣布为 ARR——这说明两个 AI 生态系统运行在根本不同的激励结构之下。 (中国资金来源; ARR 来源)
-
边缘 AI 代表的机会可能大于数据中心 AI——而量化已经能在内存降低 6 倍的同时维持生产级质量。 Lux Capital 的投资人信认为,走向生物式效率的架构将占据主导;BitCPM-CANN 则证明,1.58-bit 量化无需新芯片,就能在手机、PC 和汽车硬件上保留 95–97% 的基准表现。 (wolfejosh 来源; BitCPM-CANN)