Twitter AI - 2026-05-24
1. 大家在讨论什么
1.1 Agent 的采用,开始围绕路由、信任与本地性能来衡量 🡕
5 月 24 日最突出的现实主题,不是 agent 突然变得更聪明了,而是人们开始像讨论操作系统一样讨论它们:谁信任它们、团队如何应对成本,以及现实硬件究竟能把它们撑到什么程度。至少有五条保留内容都指向了同一个转变。
@AlexFinn 认为(646 次点赞,53 条回复,32,868 次浏览,880 次收藏)称 Hermes Agent 是“现在最强大的 AI 工具”,但回复区传递出的真正信号,比视频宣传本身更清楚。一位用户说,加上 Mempalace 后,它就成了一个持久记忆系统;另一位说,信任取决于它能否“在不擅自改动架构的情况下”完成可重复的工作;第三位则表示,Hermes 只有在获得干净的上下文、明确的边界和审查闸门时才能正常工作。
@sdianahu 概述了(210 次点赞,20 条回复,26,056 次浏览,90 次收藏)给出了一套更明确的 AI-native 创业公司运营打法。该帖称,创始人应先用最强模型寻找 model/product fit,然后把更简单的查询定制路由到更小的模型,这样就能让 60-80% 的生产流量便宜 10-100 倍,同时再用 speculative decoding、KV-cache 优化,以及后续的 trace distillation 来守住利润率。
@tmophoto 报道了(46 次点赞,9 条回复,5,933 次浏览,26 次收藏)称,llama.cpp 在双 RTX 3090 配置上运行 35B 模型时达到 99.45 tok/s,而 LM Studio 只有 47.43 tok/s,并且 MTP draft max 2 的表现优于 draft max 4。回复区随即把这变成了一场工具对比:有人说 vLLM 还能更高,但原作者反驳称,GGUF 不兼容以及体积庞大的模型下载,仍然是人们留在更简单本地栈上的现实原因。
@ClementDelangue 分享了(41 次点赞,12 条回复,3,439 次浏览,8 次收藏)分享了一个基于 300,000 份构建者自报资料整理出的 Hugging Face 硬件概览。页面显示,已列出的设备中,45% 使用 NVIDIA 硬件,32% 使用 CPU,17% 使用 Apple Silicon,5% 使用 AMD;在披露的 NVIDIA 配置中,RTX 30xx、40xx 和 50xx 显卡占据主导。

这张图之所以重要,是因为它把“本地 AI 正在爆发”从一种模糊印象,变成了真实装机基数的快照。
@iam_chonchol 认为(16 次点赞,8 条回复,3,143 次浏览,4 次收藏)称,真正的瓶颈不是智能,而是内存。后续线程声称,BitCPM-CANN 的 1.58-bit ternary 训练方法,相比 BF16 可节省约 6 倍内存,在 1B-8B 模型上保留了 93-99% 的基准性能,并且是在 Huawei Ascend 910B/910C 硬件上原生训练完成的。
讨论洞察: 最有力的回复并没有要求更好的 prompt,而是在要持久记忆、审查闸门、架构约束、更便宜的路由,以及面向硬件的部署选择。
与前一天对比: 前一周的数据主要被算力稀缺和 agent 成本主导。到了 5 月 24 日,讨论又向运营层推进了一层:路由策略、推理引擎,以及人们实际试图运行 AI 的机器。
1.2 验证成了 AI 的一等问题,横跨错误信息、评测与安全 🡕
第二个主要聚类把验证视为真正的瓶颈。共同的问题不再是“模型能不能做到”,而是“在真实环境里,在损害或漂移出现之前,你如何证明到底发生了什么?”至少有六条保留内容支持这一模式。
@georgeviews 认为(500 次点赞,8 条回复,15,147 次浏览,31 次收藏)称,一段带有强烈政治色彩的儿童安全视频被 AI 编辑过。对这份日报来说,这条帖子的价值不在政治争论本身,而在于其附带的对比画面把它变成了一场公开验证实践,回复区要求对错误信息传播者采取行动,而不是抽象地争论模型能力。
@soyouIJ 总结了(9 次点赞,3 条回复,92 次浏览)WildClawBench,这是一个在真实 Docker 环境中运行、包含 60 个由人类撰写的双语多模态任务的 benchmark。论文称,任务平均耗时约 8 分钟、需要 20+ 次工具调用,最佳系统也只达到 62.2%,而仅仅更换 harness,就可能让同一个模型的分数波动高达 18 个点。

这张图之所以重要,是因为它把人们对 benchmark 的怀疑具体化了:一旦评测进入带副作用的真实运行时,当前前沿 agent 依然举步维艰。
@inferencemedia 认为(1 次点赞,1 条回复,90 次浏览)称,49% 的失败企业 AI 试点都提到了评估缺口,随附图片还列出了 14 个评估平台和 8 项选型标准。@IFPRI 分享了(3 次点赞,1 条回复,303 次浏览)分享了一个面向农业 AI 系统的 评估框架,明确把评估拆分为模型、系统和流程三层,并指出,即便模型在纸面上表现不错,可用性、信任和公平性方面的失败依然会拖垮部署。
@TechCrunch 报道了(8 次点赞,3 条回复,4,060 次浏览,2 次收藏)称,AI 安全团队现在面对的事件窗口,已经比传统软件团队习惯的时间尺度短得多。链接文章称,攻击交接时间可能从 8 小时压缩到 22 秒,agent 能够发现被遗忘的内部仓库,而且一些被删除的 Google API keys 在最长 23 分钟内仍被观察到可以继续使用。
@Pirat_Nation 分享了(88 次点赞,13 条回复,5,334 次浏览,16 次收藏)引用了 Anthropic 的 Project Glasswing 数据,称一个漏洞发现模型在 1,000 个开源项目中找出了 23,019 个问题,其中 6,202 个被评为高危或严重,约 90.6% 被确认是真实问题。
讨论洞察: 在这些帖子中,人们想要的修复方式并不是“更好的 AI”,而是源头对比、运行时验证、环境感知型 benchmark,以及持续的安全监控。
与前一天对比: 本周更早的时候,讨论还主要停留在 benchmark 合法性和政策层面的 AI 安全质疑。到了 5 月 24 日,同样的担忧已经被操作化,具体落到了 deepfake、评测采购、漏洞扫描和实时安全响应上。
1.3 构建者持续在交付面向具体工作流的 AI 系统,而不是通用聊天机器人 🡕
5 月 24 日的构建信号关乎“封装方式”。最强的产物不是通用助手,也不是基础模型发布,而是那些围绕狭窄工作流,把数据、评估和部署一起包起来的系统。至少有五条内容支撑这一主题。
@DanKornas 分享了(10 次点赞,2 条回复,1,053 次浏览,6 次收藏)FluxVLA Engine,一个开源 robotics/VLA 平台,把训练、评估、推理、部署和模型配置放在同一个地方。GitHub 仓库显示,它支持 OpenVLA、LlavaVLA、GR00T、Pi0/Pi0.5、基于 ZMQ 的远程推理,以及 LIBERO 评估,而不是让 embodied-AI 团队再用分散脚本把整套栈拼起来。
@HuggingPapers 强调了(13 次点赞,816 次浏览,3 次收藏)AllenAI 的 OpenVLA 钉板数据集,通过 URL 检查可知,其中包含 50 个 episode、76,921 帧三视角画面,以及 LeRobot 格式的 14-D action/state control。同一波发布还包含一个配套的 MolmoAct pegboard 数据集,包含 52 个 episode 和 45,221 帧。
@mrasero_ 指出(2 次点赞,1 条回复,663 次浏览)指向 Runflow,其介绍称可在 736 个模型上运行生产级 AI 图像工作流,用 Sentinel 进行评分,并可自动重生成失败输出。这和普通的 text-to-image endpoint 是完全不同的产品形态:它是基础设施 + 评估 + 重试逻辑。
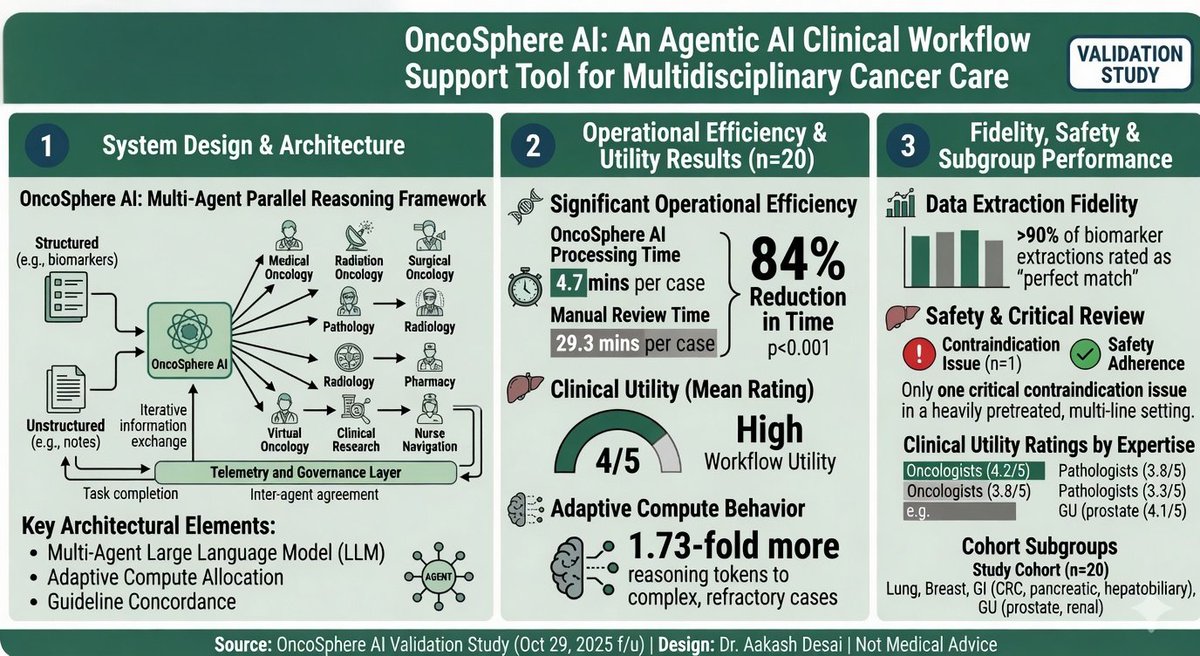
@ADesaiMD 介绍了(2 次点赞,1 条回复,48 次浏览,1 次收藏)把 OncoSphere AI 描述为一个 agentic 肿瘤学工作流,能够像肿瘤委员会那样跨指南、试验数据、影像和病理进行推理。附带的验证幻灯片称,准备时间下降了 84%,这让该项目更像工作流自动化,而不是聊天机器人式摘要。
@richardokunolar 展示了(3 次点赞,1 条回复,108 次浏览)NaijaTax IQ,来自一次 mentorship capstone session,带有可运行的会计/税务 UI,而不是概念帖。即便规模不大,它依然是另一个例子,说明 agentic AI 正被封装进狭窄而具体的运营任务中。
讨论洞察: 这些项目共享的模式是栈压缩:单配置机器人平台、可复用评估数据集、带评分的图像流水线、肿瘤学工作流 agent,以及税务/会计助手。当天的构建者在封装完整闭环,而不只是推出模型外壳。
与前一天对比: 本周更早时,AI Twitter 更多把 agent 成本和安全视为约束。5 月 24 日则展示了人们在接受这些约束之后在构建什么:原生面向工作流、且内建评估与部署的系统。
1.4 AI 获取方式正通过官方课程和主流封装变得更具机构化 🡕
最后一个值得注意的主题是分发。5 月 24 日的信息流中,明显混合了厂商主导的课程目录、开源构建者课程体系,以及面向大众市场的 AI 产品封装。至少有四条保留内容支持这一点。
@HowToAI_ 指出(5 次点赞,1 条回复,179 次浏览,9 次收藏)称 Anthropic 现在已有 18 门官方 AI 课程。检查 Skilljar 页面可确认,这一目录覆盖 Claude、Claude Code、API 开发、MCP、subagents,以及 Bedrock/Vertex 部署路径,而不只是单一的新手入门课。
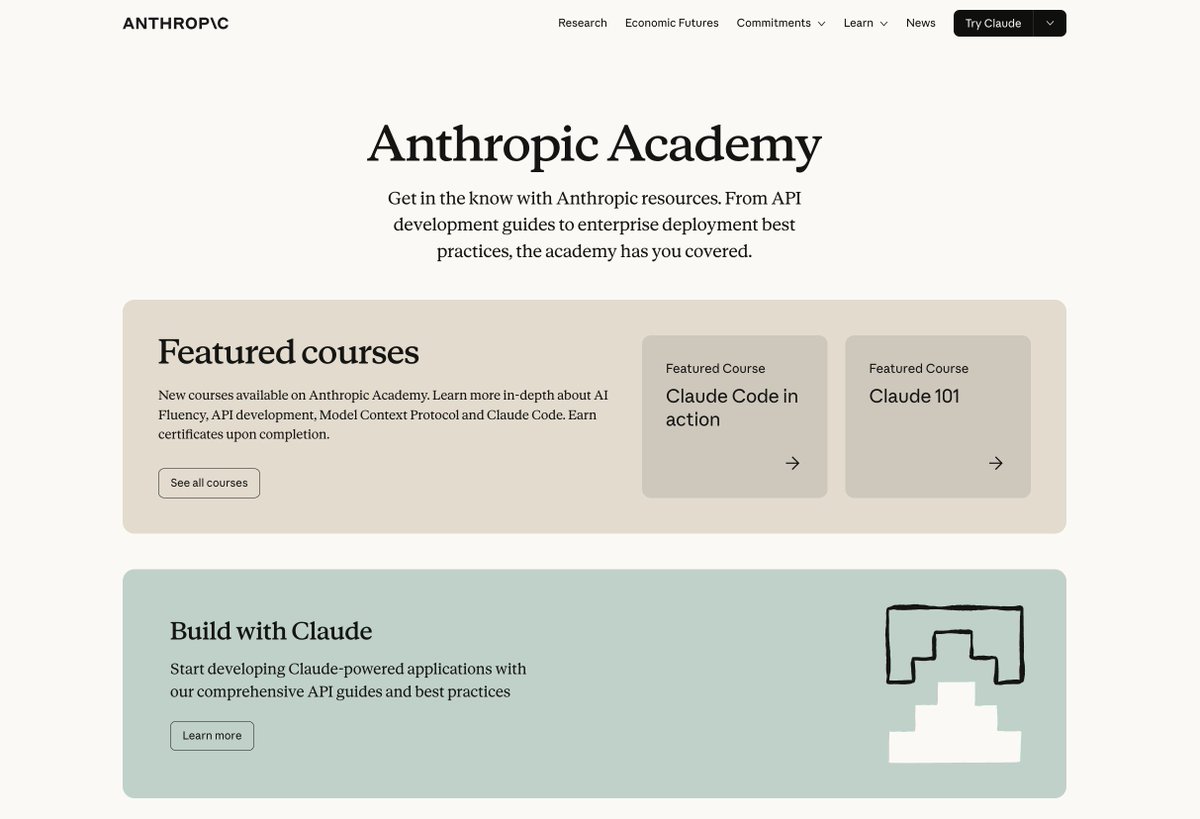
这张截图之所以重要,是因为它把一条互动不高的推文,变成了清晰证据:一个由厂商运营的 Claude/Claude Code 学习中心确实存在。
@akjsal 分享了(4 次点赞,1 条回复,175 次浏览,3 次收藏)LLM Zoomcamp 2026,一门为期 10 周的免费构建者课程,涵盖 RAG、vector search、agents、orchestration、evaluation 和 monitoring,并称不需要 GPU,API 成本可控制在约 $1-5。@cyrilXBT 推广了(40 次点赞,5 条回复,1,030 次浏览,29 次收藏)一个在 YouTube 上免费的 Harvard AI 课程体系,内容涵盖 prompting、GitHub Copilot、决策算法、深度学习和 hallucinations。
@ABC 报道了(14 次点赞,16 条回复,18,842 次浏览,4 次收藏)Google 的下一波 AI 工具,而链接的 AP 文章补充了更关键的细节:Gemini Spark 是一个会在云端持续工作的后台 agent,Gemini Omni 用于可编辑视频生成,SynthID/content credentials 则面向生成媒体。
讨论洞察: 共同动作是结构化 onboarding:官方课程目录、可复用教学大纲,以及围绕 agent 行为做出的消费者友好型封装。
与前一天对比: 前一周已经零散出现了一些劳动力培训相关帖子。到了 5 月 24 日,这种趋势变得更正式了:厂商主导的 Claude 教育、免费开放课程,以及来自 Google 的主流产品封装被放在了一起。
2. 什么让人沮丧
不透明的定价和算力经济学依然在破坏信任
最尖锐、最直接的抱怨来自定价诚实度。@GergelyOrosz 写道(63 次点赞,15 条回复,7,918 次浏览,16 次收藏)称,OpenArt 在注册前对一个 3 分钟视频展示的是一种 credits 需求,付款后却变成了 10 倍 credits,让他在花了 $29 却只得到很差结果后感到“被骗了”。这一抱怨与 @sdianahu 概述(210 次点赞,20 条回复,26,056 次浏览,90 次收藏)提出的更战略版本形成呼应:AI-native 创业公司如今之所以需要自定义路由,正是为了在 frontier models 的经济账下活下去。当天可见的应对方式也印证了这一点:把简单查询路由到更小模型、使用 speculative decoding 和 KV-cache 技巧,或者在可能时转向本地推理。严重程度:高。值得为此构建:是——透明定价、质量披露和面向利润率的路由,仍是许多 AI 产品缺失的部分。
验证缺口仍在阻碍部署和公众信任
最广泛的不满在于,AI 系统在造成问题之前依然很难被验证。@georgeviews 认为(500 次点赞,8 条回复,15,147 次浏览,31 次收藏)称,一段被 quote tweet 的政治视频经过了 AI 编辑,而人们关注的证据是并排对比图像,而不是围绕它的修辞。@inferencemedia 表示(1 次点赞,1 条回复,90 次浏览)称,49% 的失败企业 AI 试点提到了评估缺口;@IFPRI 分享了(3 次点赞,1 条回复,303 次浏览)给出了一个面向现场 AI 部署的模型/系统/流程评估框架;@soyouIJ 总结了(9 次点赞,3 条回复,92 次浏览)WildClawBench 中,即便最佳系统在长时程 Docker 任务上也只达到 62.2%。@TechCrunch 报道了(8 次点赞,3 条回复,4,060 次浏览,2 次收藏)称,AI 安全事件已经从以小时计压缩到以秒计;@WSJ 分享了(2 次点赞,3 条回复,733 次浏览)则分享了一张图,称美国人对 AI 的负面感受上升速度快于行业本身的发展速度。
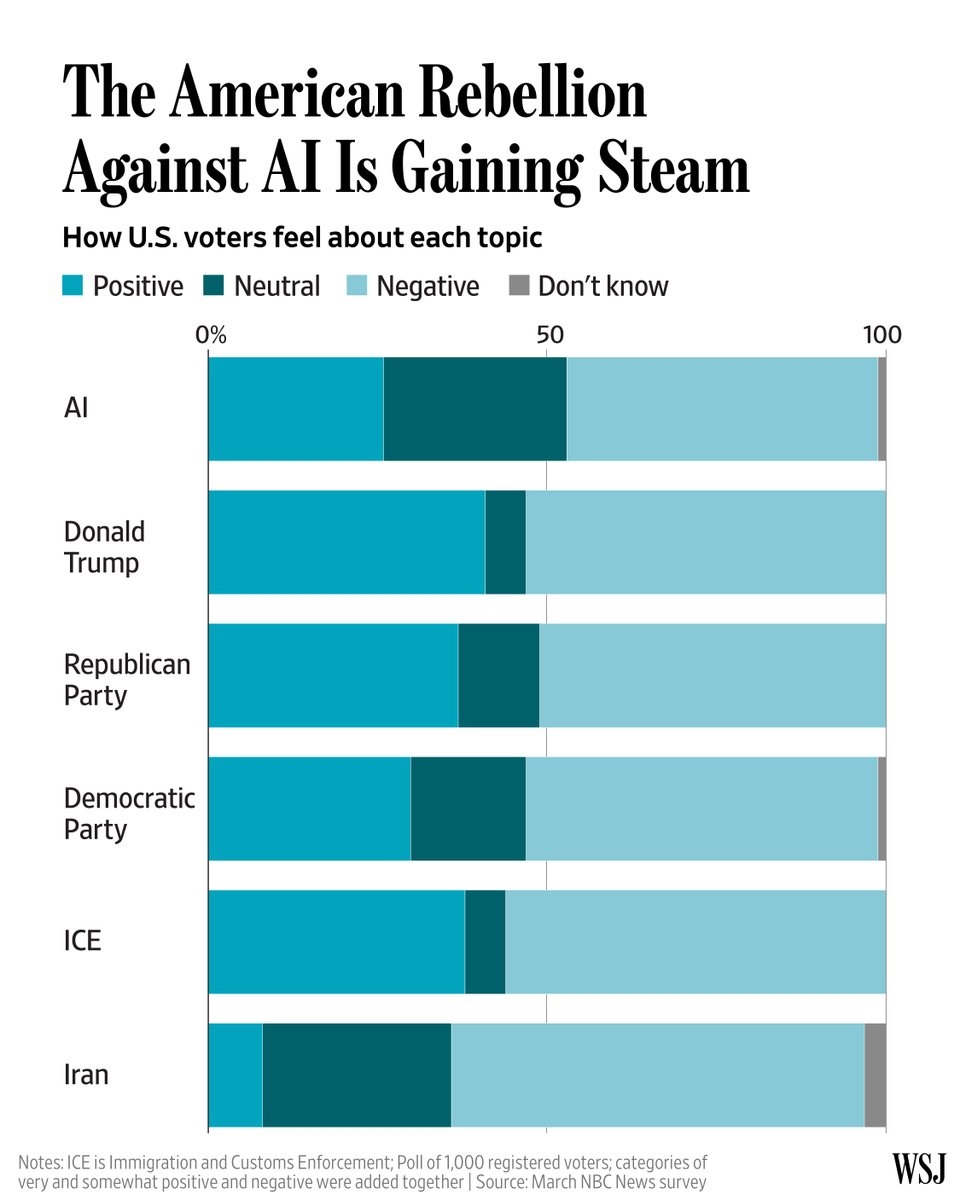
信息流中可见的应对策略,几乎全都是额外验证的不同形式:对比源视频、使用真实运行时 benchmark、采购专门的评估工具,以及进行更严格的安全监控。严重程度:高。值得为此构建:是——这是当天数据中最清晰、尚未满足的基础设施层之一。
本地 AI 已成现实,但仍受制于内存和配置工作
关于本地 AI 的讨论虽然热烈,但摩擦也很多。@ClementDelangue 分享了(41 次点赞,12 条回复,3,439 次浏览,8 次收藏)给出了硬数字,显示构建者正在大量使用 NVIDIA、CPU、Apple Silicon 和 AMD,这意味着硬件基础高度碎片化,而非只有一个标准目标。@tmophoto 报道了(46 次点赞,9 条回复,5,933 次浏览,26 次收藏)称,本地吞吐会随着推理引擎和 MTP 设置发生巨大波动,而一条推荐 vLLM 的回复则遭遇了熟悉的反对意见:GGUF 不兼容以及巨大的下载体积。@iam_chonchol 认为(16 次点赞,8 条回复,3,143 次浏览,4 次收藏)称,真正的瓶颈是内存,并把 BitCPM-CANN 指作一个可能答案。
严重程度:中高。当前可见的变通方式是手工调参:按场景逐一选择引擎、测试多种 MTP 设置,并寻找更轻量的低比特模型。值得为此构建:是——面向硬件的推理配置和高内存效率的本地栈,仍然太依赖操作者手工介入。
3. 大家希望存在什么
一个可审查的 agent 行为控制平面
最明显缺失的一层,是一个能让 agent 行为在执行前、执行中和执行后都可检查的系统。@AlexFinn 认为(646 次点赞,53 条回复,32,868 次浏览,880 次收藏)称 Hermes 很强大,但回复很快把价值重心重新放回到记忆、审查闸门和清晰边界上。@inferencemedia 表示(1 次点赞,1 条回复,90 次浏览)称,49% 的失败企业 AI 试点提到了评估缺口;@soyouIJ 总结了(9 次点赞,3 条回复,92 次浏览)给出一个最佳配置也只达到 62.2% 的 benchmark;@TechCrunch 报道了(8 次点赞,3 条回复,4,060 次浏览,2 次收藏)则称,实时 AI 安全窗口已经从数小时压缩到数秒。这是一个紧迫度很高的现实需求。benchmark 套件、评估图谱和安全工具都提供了局部答案,但数据仍显示这是一个碎片化栈,而不是一个统一、可审查的控制平面。机会:直接。
诚实的定价与面向硬件的部署指导
人们也希望,在购买或部署 AI 系统之前,就能理解其运行成本和硬件适配情况。@GergelyOrosz 描述了(63 次点赞,15 条回复,7,918 次浏览,16 次收藏)展示了一次视频 AI credits 的“先诱导后加价”体验;@sdianahu 解释了(210 次点赞,20 条回复,26,056 次浏览,90 次收藏)则称,严肃的 AI 创业公司如今必须依靠明确的 query routers 才能让利润率成立。@tmophoto 展示了(46 次点赞,9 条回复,5,933 次浏览,26 次收藏)展示了本地性能在不同推理引擎之间会有多大差异;@ClementDelangue 分享了(41 次点赞,12 条回复,3,439 次浏览,8 次收藏)则证明,本地 AI 并不存在一个默认通用的机器配置。这同样是一个紧迫度很高的现实需求。路由打法、硬件仪表盘和 BitCPM-CANN 这类低比特工作已提供部分答案,但信息流仍显示太多手工猜测。机会:直接。
在数据、基础设施和法律上都具备主权的本地语言 AI
最强的地域性需求,并不是抽象意义上的“本地模型”,而是一个能反映本地语言和治理环境的全栈。@OmarKamali 写道(18 次点赞,3 条回复,1,135 次浏览,2 次收藏)称,如果 AI 要重塑摩洛哥的工作,它就必须理解摩洛哥,并建立在本地数据、语音、NLP、embeddings、评估、基础设施和法律一致性之上。@DivaJain2 认为(79 次点赞,3 条回复,2,060 次浏览,20 次收藏)称,中国已经不再满足于强模型,而是在推进 AI-native 的消费级用例;截图和回复则把 Doubao 视为可触达 AI 封装的一个证明点。这种需求既现实,也具有战略意义。本地生态努力和 sovereign-AI 话语已提供部分回应,但在代表性不足的语言中,支撑栈仍不完整。机会:竞争型。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Hermes Agent | Agent 平台 | (+/-) | 灵活的多步骤工作流;记忆与文档召回类用例很有共鸣 | 信任取决于边界、审查闸门和可见控制 |
| Query routing + speculative decoding | 推理编排 | (+) | 可将 60-80% 的流量转移到便宜得多的模型上;保护利润率 | 需要自定义路由逻辑,以及对查询难度有很强的理解 |
| llama.cpp | 本地推理引擎 | (+) | 在一次双 3090 测试中,35B 模型跑到 99.45 tok/s;很适合 GGUF 风格的本地工作 | 对调优高度敏感;MTP 设置会显著改变结果 |
| LM Studio | 本地推理应用 | (+/-) | 本地工作流简单,且便于并排 benchmark | 在引用测试中,吞吐大约只有 llama.cpp 的一半 |
| vLLM | 推理引擎 | (+/-) | 回复中的证据表明,同一硬件上可能实现更高吞吐 | GGUF 摩擦和大模型下载让一些用户望而却步 |
| Hugging Face Hardware | 硬件可观测性 | (+) | 展示了 300,000 份构建者资料中真实的社区硬件构成 | 自报拥有数据并不能保证工作负载适配 |
| BitCPM-CANN | 低比特建模 | (+) | 声称相比 BF16 节省 6 倍内存,并为更轻的本地/边缘模型提供路径 | 仍偏早期且主要来自帖子表述;绑定 Ascend/CANN 专用工具链 |
| WildClawBench | Agent 评测 benchmark | (+) | 真实 Docker 任务、混合评分和对 harness 的敏感性,让它比合成榜单更贴近现实 | 即便最佳配置也只有 62.2%,说明问题仍未解决 |
| Glasswing / Claude Mythos Preview | AI 安全扫描 | (+) | 声称可大规模发现漏洞,且确认率很高 | 证据主要停留在推文层面和早期访问阶段;公开技术细节有限 |
| Runflow + Sentinel | AI 图像工作流/评估 | (+) | 能给输出评分、识别坏输入,并在多个模型间自动重生成失败结果 | 聚焦图像流水线,仍受上游模型经济性影响 |
| FluxVLA Engine | Robotics/VLA 平台 | (+) | 从数据到训练、评估、推理和部署的一站式单配置路径 | 需要机器人专用基础设施,且配置高度依赖 CUDA |
| X2SAM | 多模态分割模型 | (+) | 在同一界面中统一图像和视频分割,并支持文本与视觉提示 | 仍是研究阶段系统,尚非经过验证的生产工具 |
在这张表下面,总体模式已经很清楚:人们不再把“AI tooling”当作一个单一类别来讨论。他们讨论的是具体分层——agent 外壳、路由器、推理引擎、评测 benchmark、漏洞扫描器,以及面向特定工作流的平台。满意度曲线也是分裂的:当工具能缩小问题范围并暴露运营细节时,人们最积极;而当定价、评估或硬件适配仍不透明时,负面情绪最强。
迁移模式也很明显。成本控制的打法,是在理解工作负载之后,把流量从 frontier models 路由到更小模型。本地推理的打法,则是不预设某个默认栈,而是直接比较不同引擎;被引用的 tmophoto 线程及其回复,实际上把 llama.cpp、LM Studio 和 vLLM 框定为速度、模型格式支持与配置负担之间的权衡。在评估侧,趋势则是从整洁沙箱转向原生运行时 benchmark、工具选型评分卡,以及盯住实时系统的安全层。
@sijlalhussain 认为(10 次点赞,1 条回复,126 次浏览,2 次收藏)称,generative AI 应被视为更大企业 AI 系统中的一层,并引用了 Gartner。

这张图之所以重要,是因为它捕捉到了当天更广泛的技术结论:GenAI 并没有取代栈的其他部分,而是被嵌入到了一个更宽的运营系统之中。
培训内容也开始围绕这种分层视角标准化。Anthropic 的课程目录、LLM Zoomcamp 的教学大纲,以及 Harvard 的课程体系,都把 AI 实践组织在 RAG、agents、orchestration、evaluation、monitoring、MCP 和 Claude Code 这样的具体工作流周围,而不是围绕模糊的“prompting 技巧”。
5. 大家在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| FluxVLA Engine | FluxVLA / limxdynamics | 用于训练、评估和部署 VLA 系统的全栈工程平台 | 取代分散在多个脚本和工具中的碎片化 embodied-AI 工作流 | Python、PyTorch、OpenVLA、LlavaVLA、GR00T、Pi0/Pi0.5、LIBERO、ZMQ 远程推理 | Beta | GitHub · 推文 |
| Runflow | Runflow 团队 | 带评分和重生成功能的 AI 图像工作流与评估 API | 帮助团队让图像生成功能在生产中保持可靠且可盈利 | 736 个模型、Sentinel 评分、自动重生成、包含 Qwen Edit 和 Flux 在内的自定义开源模型工作流 | Shipped | 网站 · 推文 |
| OncoSphere AI | @ADesaiMD | 跨指南、试验、影像和病理进行推理的 agentic 肿瘤学工作流 | 降低肿瘤委员会式决策支持中的手工准备和工作流协调成本 | Agentic AI、临床指南、试验数据、影像、病理 | Alpha | 推文 |
| NaijaTax IQ | @richardokunolar and MC7.0 mentees | 带可运行 UI 的会计与税务助手 | 将狭窄金融工作流封装为比通用聊天更具体的 agent 界面 | Agentic AI workflow、税务/会计界面 | Alpha | 推文 |
| AllenAI pegboard VLA datasets | AllenAI / LeRobot | 公开的 OpenVLA 和 MolmoAct pegboard 评估数据集 | 为 embodied-AI 团队提供可复现的多模态 benchmark 数据 | Hugging Face datasets、LeRobot、3 个摄像头、14-D control/state 数据 | Shipped | OpenVLA 数据集 · MolmoAct 数据集 · 推文 |
| X2SAM | Sun Yat-sen University / Peng Cheng Laboratory / Meituan | 通过对话式和视觉提示统一处理图像与视频分割的模型 | 避免图像工作流和视频工作流分别维护不同分割系统 | MLLM、Mask Memory、V-VGD benchmark | Alpha | 论文 · 项目 · 推文 |
最重要的模式是,这些项目交付的是完整闭环,而不是孤立模型。@DanKornas 分享了(10 次点赞,2 条回复,1,053 次浏览,6 次收藏)把 FluxVLA 描述为单配置机器人栈,而仓库内容也印证了这一点:它给出的是部署文档、远程推理支持和 benchmark 表格,而不是只有概念性陈述。

Runflow 在另一个市场里也体现了同样的封装冲动。Runflow 网站 表明,这个产品不只是一个生成 API;它把评分、护栏、重试逻辑和基础设施组合在一起,使图像功能能扛住生产流量和利润率压力。
@ADesaiMD 介绍了(2 次点赞,1 条回复,48 次浏览,1 次收藏)把 OncoSphere AI 描述为一个肿瘤委员会工作流 agent,而不是临床聊天机器人;附带幻灯片是最有力的证据,因为它展示了工作流本身以及声称 84% 的时间缩减。
@richardokunolar 展示了(3 次点赞,1 条回复,108 次浏览)展示了在一次 agentic-AI mentorship capstone 中可运行的 NaijaTax IQ 界面,这之所以重要,是因为它明显绑定在会计和税务运营上,而不是泛泛宣称自己是助手。

另一个反复出现的构建模式,是“评估优先”的基础设施。AllenAI 成对发布的 pegboard 数据集,以及 X2SAM 高度依赖 benchmark 的发布方式,都表明团队在同时交付数据、方法和产物;而 FluxVLA 和 Runflow 则把评估直接封进产品内部。驱动这些构建的触发性痛点,与本报告其他部分看到的是同一个:通用 AI 界面只有在被收窄为带明确检查点的工作流之后,才会获得信任。
6. 新内容与值得关注的内容
WildClawBench 让“真实 agent 评测”变得具体起来
@soyouIJ 总结了(9 次点赞,3 条回复,92 次浏览)WildClawBench,这篇论文之所以值得注意,是因为它用 60 个由人类撰写的双语多模态 Docker 任务,替代了关于合成评测的抽象讨论;这些任务平均耗时约 8 分钟,需要 20+ 次工具调用。最佳配置也只有 62.2%,而仅仅是 harness 的选择就可能让性能波动高达 18 个点。这使它成为本数据集中最清楚的公开证据之一,说明前沿 agent 评估在多大程度上仍取决于运行时外壳,而不只是基础模型本身。
Anthropic 将 Claude 学习栈正式化
@HowToAI_ 强调了(5 次点赞,1 条回复,179 次浏览,9 次收藏)Anthropic 的课程目录,通过 URL 检查可确认其中包含 Claude、Claude Code、MCP、subagents、API 开发和云部署的官方路径。这很重要,因为它把此前分散、口口相传的经验,变成了厂商支持的课程体系。虽然只是一条小推文,但对 Claude 生态走向来说是个有意义的信号。
Google 持续把主动式 agent 推向主流产品封装
@ABC 报道了(14 次点赞,16 条回复,18,842 次浏览,4 次收藏)Google 的下一波 AI 发布,而经过检查的 AP 文章才是它值得关注的原因:Gemini Spark 被定义为一个会在云端持续工作的后台 agent,Gemini Omni 则推进可编辑视频生成,SynthID 则把内容凭证进一步扩展。这个故事与其说是一次模型升级,不如说是对主动式 AI 系统进行消费级封装。
研究发布持续拓宽可用的多模态栈
@jiqizhixin 分享了(9 次点赞,1 条回复,897 次浏览,4 次收藏)X2SAM,其 论文 和 项目页面 描述了一个统一的图像-视频分割模型,支持对话式与视觉提示、Mask Memory 模块,以及新的 V-VGD benchmark。@SciFi 发布了(2 次点赞,1 条回复,117 次浏览,1 次收藏)LLM-Metrics paper,测试 LLM 对研究论文的记忆是否与研究影响力相关。两者合在一起表明,当天的研究信号正在从文本聊天扩展到分割、benchmark,以及对“测量”本身的研究。
7. 机会在哪里
[+++] Reviewable agent operations — Multiple sections point here at once: @AlexFinn 挖掘出(646 次点赞,53 条回复,32,868 次浏览,880 次收藏)这个信任问题,@inferencemedia 点名指出(1 次点赞,1 条回复,90 次浏览)评估缺口,WildClawBench 展示了偏低的真实运行时成功上限,而 @TechCrunch 报道了(8 次点赞,3 条回复,4,060 次浏览,2 次收藏)则指向实时 AI 安全事件的压缩。这个机会很强,因为同一种需求同时出现在 agent 体验、benchmark、安全和企业部署中。
**++] 本地 AI 部署与优化工具** — [Hugging Face 硬件页面,@tmophoto 基准测试讨论串(46 次点赞,9 条回复,5,933 次浏览,26 次收藏),BitCPM-CANN 的内存声明,以及 @sdianahu 路由实战指南(210 次点赞,20 条回复,26,056 次浏览,90 次收藏)都指向同一个缺口:构建者需要有人帮助他们把工作负载匹配到合适的硬件、引擎和模型尺寸上,而不是凡事都靠手工调参。
[++] Workflow-native vertical agents — @ADesaiMD 介绍了(2 次点赞,1 条回复,48 次浏览,1 次收藏)一个肿瘤学工作流 agent,@richardokunolar 展示了(3 次点赞,1 条回复,108 次浏览)一个税务/会计 UI,Runflow 封装了生产级图像评估,而 FluxVLA 则封装了 embodied-AI 部署。中等强度的信号在于,胜出的模式不是通用聊天,而是内建评估和工作流逻辑的狭窄系统。
[+] Local-language sovereign AI stacks — @OmarKamali 详细说明了(18 次点赞,3 条回复,1,135 次浏览,2 次收藏)摩洛哥所缺失的那些层,@DivaJain2 指出了(79 次点赞,3 条回复,2,060 次浏览,20 次收藏)则是中国的 AI-native 消费级封装。这个信号仍在浮现,还不是主流,但它是数据集中少数几个把语言、基础设施、法律和产品分发作为同一栈来讨论的地方。
8. 要点
- 人们对 agent 的热情仍在,但前提是工作流必须被约束住。 @AlexFinn 展示了(646 次点赞,53 条回复,32,868 次浏览,880 次收藏)显示,互动最高的 agent 线程很快就变成了关于持久记忆、干净上下文和审查闸门的讨论,而 @sdianahu 概述了(210 次点赞,20 条回复,26,056 次浏览,90 次收藏)则讨论在找到 PMF 之后做路由和蒸馏。
- 验证仍是最难补上的基础设施缺口。 @georgeviews 提示了(500 次点赞,8 条回复,15,147 次浏览,31 次收藏)一段据称经过 AI 编辑的错误信息视频,WildClawBench 展示了偏低的真实运行时成功上限,而 @TechCrunch 报道了(8 次点赞,3 条回复,4,060 次浏览,2 次收藏)则涉及实时安全故障,它们都指向同一个“证明问题”。
- 本地 AI 已不再小众,但仍然过于依赖操作者。 这个 Hugging Face 硬件页面 显示了多种硬件类型上的广泛采用,而 @tmophoto 测量了(46 次点赞,9 条回复,5,933 次浏览,26 次收藏)展示了引擎之间巨大的吞吐差异,@iam_chonchol 认为(16 次点赞,8 条回复,3,143 次浏览,4 次收藏)则说明内存仍是核心瓶颈。
- 最强的构建模式是工作流封装,而不是再做一个聊天机器人。 @DanKornas 分享了(10 次点赞,2 条回复,1,053 次浏览,6 次收藏)FluxVLA、@ADesaiMD 介绍了(2 次点赞,1 条回复,48 次浏览,1 次收藏)OncoSphere AI,以及 Runflow 都把评估和部署封装进了具体待完成的工作中。
- AI onboarding 正在官方化、机构化,同时消费级封装也在扩张。 @HowToAI_ 强调了(5 次点赞,1 条回复,179 次浏览,9 次收藏)Anthropic 的课程目录,LLM Zoomcamp 提供了一份免费的构建者教学大纲,而 @ABC 报道了(14 次点赞,16 条回复,18,842 次浏览,4 次收藏)则是 Google 的 Gemini Spark/Omni 发布。