Twitter AI - 2026-05-25
1. 人们在讨论什么
1.1 制度治理与权利成为焦点 🡕
5 月 25 日最清晰的新讨论集群,是把 AI 视为制度治理问题,而不只是实验室问题。相关证据来自一份教宗通谕、一项大型高等教育研究,以及一场围绕合成语音使用展开的在审诉讼。
@cnnbrk 报道称(15 个赞、10 条回复、1,636 次浏览)称,教宗良十四世表示,人工智能的控制权不能继续掌握在“少数人”手中;所链接的 Magnifica Humanitas 大纲显示,文件专门设有 AI 治理、工作、自由与武器等章节。@metlifepaul 串文(1 条回复、115 次浏览、2 个书签)则摘录了同一文件中的具体内容,包括警告称,AI 介入就业、信贷、公共服务和声誉相关决策,可能造成排斥,而操纵、隐私侵犯和设计者偏见仍是现实风险。

这张图片之所以重要,是因为它把头条层面的治理议题,落实成了具体的政策语言。
@ScienceMagazine 认为(31 个赞、4 条回复、6,692 次浏览、13 个书签)称,高等教育必须重新思考考核方式,以应对生成式 AI。所链接的 Berkeley/Science 摘要 表示,这一结论来自对 20 所大型公立研究型大学 95,513 名学生的调查数据,并支持按学科改革考核,而不是一刀切禁令或通用检测器。

这张图表之所以重要,是因为它显示,AI 的滥用在不同学科之间存在显著差异,而不是在整个校园里均匀上升。
@NHKWORLD_News 报道称(42 个赞、2,105 次浏览)称,配音演员津田健次郎已就至少 188 条据称未经许可模仿其声音的 TikTok 视频提起诉讼;NHK 还补充称,日本法务省已于 4 月成立专家小组,研究 AI 生成语音与民事责任问题。
讨论洞察: 这些讨论串中最强烈的反应,与其说是关注模型的原始能力,不如说更关心权力集中、媒体完整性,以及当 AI 介入的决策出错时,制度是否仍能提供申诉渠道。
与前一日比较: 前一日的证据主要围绕评测、安全和硬件展开。5 月 25 日则把视角扩展到教会教义、大学政策,以及一场围绕合成身份的现实法庭争端。
1.2 评测继续从基准测试讨论走向真实环境 🡕
最强的工程主题,是在真实条件下进行评测。在医疗、编码代理、企业工具、金融和视频生成等领域,这一天的讨论都更看重环境、测试和流程控制,而不是醒目的基准分数。
@ycombinator 分享了(70 个赞、9 条回复、109,377 次浏览、42 个书签)介绍了 BioStack,称其为一种仿真环境,让医疗 AI 模型通过“数据、评测、奖励和基准测试”的后训练闭环,在混乱的临床数据上演练。BioStack 的 网站 补充称,该公司正在构建用于后训练的强化学习环境、适用于机器学习的医疗数据集,以及多智能体推理基础设施;其中一条回复则认为,真正的突破在于针对延迟结果进行训练,而不是针对适合演示的任务训练。
@pben4ai 指出(31 个赞、4 条回复、10,696 次浏览、30 个书签)讨论了“约束衰减”论文,该论文研究随着结构化要求不断叠加,编码代理的性能如何下降。在该讨论串中,@unclebobmartin 回复了(226 个赞、17 条回复、6,570 次浏览、105 个书签)称,自然语言规则文件是“徒劳之举”,而验收测试、单元测试、变异测试和属性测试作为硬性约束效果更好,因为代理无法推翻它们。
@AlphaBalzer 重点介绍了(1 个赞、2 条回复、23 次浏览)介绍了 Microsoft 的 Copilot Studio Agent Evaluation 预览版,该工具现在支持导入和 AI 生成的测试集、多种评分方式、自定义阈值,以及在构建器工作流中明确显示通过/失败摘要。

这张图片之所以重要,是因为它显示,评测正在成为产品的核心界面,而不再只是平台外的 QA 仪式。
@PreyWebthree 认为(38 个赞、7 条回复、657 次浏览)称,Sentient 的 Grounded Reasoning Challenge 之所以重要,是因为它使用 Databricks 的 OfficeQA 基准、1939 年至 2025 年的 Treasury Bulletins,以及在有据可依的检索基础上进行数值推理,而不是轻量级提示测试。@metatronics_ 写道(7 个赞、10 条回复、1,615 次浏览)称,前沿模型在一次真实交易测试中因过度交易、仓位控制不当以及事后设置止损而亏损;@jiqizhixin 介绍了(8 个赞、1 条回复、448 次浏览、4 个书签)则介绍了 EvalVerse,这是一套视频评测框架,评分维度包括电影感、表演、美学、镜头编排和视听融合,而不只是提示遵循度。
讨论洞察: 当天最有价值的回复并没有要求更好的提示词,而是要求能够真正执行的测试、贴近真实任务的环境,以及能够因流程糟糕而判定系统失败的评分机制,而不是只奖励漂亮的语言。
与前一日比较: 5 月 24 日已经开始质疑基准测试的正当性。5 月 25 日则进一步推进到内置评测产品、领域模拟器,以及对流程层失败的明确分析。
1.3 AI 工作正围绕职位、Fellowship 和开发者课程逐渐成形 🡕
一个规模较小但很清晰的讨论集群,关注 AI 工作本身如何被组织起来。这里的信号不是大规模招聘炒作,而是职位设计、治理培训和面向生产的学习路径。
@Yuchenj_UW 认为(212 个赞、27 条回复、25,850 次浏览、48 个书签)称,“Member of Technical Staff” 这一职位正从贝尔实验室的传统体系扩散到 OpenAI、Anthropic、xAI、Thinky 和 Databricks AI。讨论串中的回复称,其吸引力在于,MTS 将激励机制从“最大化职级晋升”转向“最大化产出”。

这张截图之所以重要,是因为它来自一位有影响力的从业者,为这一观点提供了外部验证,而不是让它停留在孤立的组织架构看法上。
@ImadeIyamu 分享了(42 个赞、3,941 次浏览、94 个书签)介绍了 BASE AI Safety & Ethics Fellowship。其 项目页面 描述了一个为期 13 周的远程项目,涵盖 AI Alignment、AI Security 和 AI Governance 三个方向,其中第 1 至第 5 周侧重培训,第 6 至第 13 周开展导师指导下的研究项目。@akjsal 发布了(7 个赞、1 条回复、361 次浏览、5 个书签)则讨论了加入 LLM Zoomcamp 2026。该项目拥有 5,297 个 star 的代码仓库,设计了为期 10 周的课程,涵盖 RAG、智能体、编排、评测、监控和结业项目;无需 GPU,典型 API 成本约为 $1-5。
讨论洞察: 这里对劳动力市场最实际的回应,是围绕影响力、安全性和可部署系统建立结构,而不是继续使用泛泛的“学习 AI”品牌话术。
与前一日比较: 5 月 24 日更明显地体现了厂商课程信号。5 月 25 日则增加了更具结构性的内容:与评测和治理相联系的职位名称、Fellowship 和实践型开发者课程。
1.4 构建者继续交付原生于工作流的系统,而不是通用聊天工具 🡒
构建信号仍集中在这样一类产品上:围绕狭窄工作流,把数据、训练、评测和部署压缩到一起。这也是前一天最稳定的延续主题。
@DanKornas 分享了(27 个赞、2 条回复、1,747 次浏览、18 个书签)介绍了 FluxVLA Engine,这是一套用于训练、评测、推理和真实机器人部署的开源 VLA 平台。检查时,仓库 已有 425 个 star;项目网站 描述了一套模块化 VLA 主干,支持 OpenVLA、LlavaVLA、GR00T、Pi0 和 Pi0.5,并配有 RLDS/Parquet 数据管道、LIBERO 评测和真实机器人推理。

这张图片之所以重要,是因为它以视觉方式展示了技术栈压缩:这不是一个模型演示,而是一整套工程闭环。
@jiqizhixin 重点介绍了(9 个赞、1 条回复、1,093 次浏览)介绍了 X2SAM。其 项目页面 表示,该模型统一了图像和视频分割,支持对话式提示和视觉提示,新增用于时间一致性的 Mask Memory 模块,并推出新的 V-VGD 基准。检查时,所链接的 GitHub 仓库 已有 74 个 star。

这张图之所以重要,是因为它让“一套模型应对多种分割任务”的说法变得具体可见。
@thecableng 报道称(5 个赞、2 条回复、569 次浏览)称,GovGuide Nigeria 是一个基于 Meta Llama 生态构建的多语言政府聊天机器人,支持英语、Hausa、Igbo 和 Yoruba;随附的仪表板图片展示的是可见的产品使用情况,而不是政策备忘录。@anindyadeeps 指出(7 个赞、2 条回复、203 次浏览)则介绍了 fpv_labs 的一个开源 physical-AI 数据可视化工具,其图片同时展示了 RGB、深度、3D 场景、标注和 IMU 图层。
讨论洞察: 共同模式并不是“再推出一个助手”,而是把缺失的工作流整合起来:机器人部署、多模态感知、多语言公共服务访问,或多模态 physical-AI 数据工具。
与前一日比较: 这一主题保持稳定。5 月 24 日已经偏好原生于工作流的系统,5 月 25 日延续了这一形态,没有重新回到泛化的模型炒作。
1.5 本地优先和主权 AI 从硬件讨论转向所有权与语言 🡕
前一天关于本地 AI 的讨论主要集中在吞吐量、内存和硬件组合上。5 月 25 日更有意思的问题是:谁拥有这个助手,以及它究竟承载了多少本地语境。
@iamfakhrealam 认为(10 个赞、4 条回复、2,551 次浏览)称,今天的助手之所以是“租来的”,是因为它们运行在别人的服务器上;该帖引用了 OpenBMB 发布 MiniCPM5-1B 的消息,并将 MiniCPM Desk Pet 描述为一种与 AI 建立根本不同关系的方式。OpenBMB 的 Hugging Face 页面 将 MiniCPM5-1B 描述为一款拥有 1.08B 参数、支持 131,072 上下文的端侧模型,提供 GGUF 和 MLX 版本;它还是一款本地优先的桌面伴侣,完成设置后,普通聊天可在设备本地运行。
@OmarKamali 认为(21 个赞、5 条回复、1,568 次浏览)称,摩洛哥的 AI 主权不只是本地托管,还需要本地数据、语音、自然语言处理、嵌入、评测、基础设施、法律协同和文化语境。他在会议上的幻灯片宣称,先做出 Darija 版 LLM,之后再做 Amazigh 版,使这一讨论比泛泛而谈的主权口号具体得多。
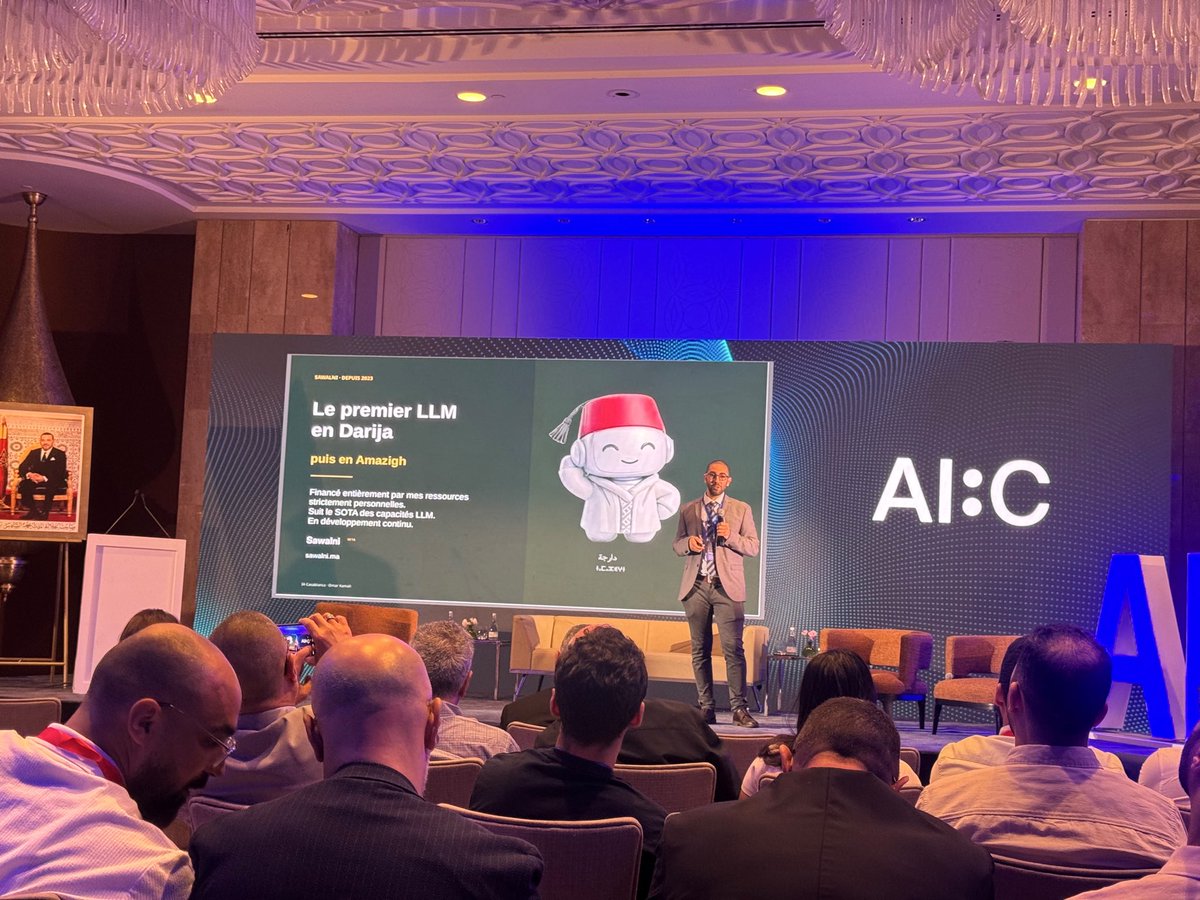
这张图片之所以重要,是因为它把宽泛的主权论述落实到了一个具体的本地语言成果上。
讨论洞察: 共同诉求不只是更快的本地推理,而是持续的访问权、语言适配,以及符合本地法律和公共机构需求的系统。
与前一日比较: 与 5 月 24 日围绕硬件份额和内存瓶颈的帖子相比,今天的本地化信号更多地指向所有权、语言、法律和制度适配。
2. 什么让人感到沮丧
基准测试获胜,但遇到真实流程约束仍会失败
最反复出现的运营层面挫败是:一旦任务要求严格执行,而不只是产出看起来不错的结果,代理仍然会出问题。@pben4ai 指出(31 个赞、4 条回复、10,696 次浏览、30 个书签)讨论了编码代理中的“约束衰减”;@unclebobmartin 回复了(226 个赞、17 条回复、6,570 次浏览、105 个书签)称,自然语言规则文件会失效,而验收测试、单元测试、变异测试和属性测试可以把代理限制在硬边界之内。@metatronics_ 写道(7 个赞、10 条回复、1,615 次浏览)称,前沿模型在真实交易中因过度交易、仓位控制不当和事后设置止损而亏损;@PreyWebthree 认为(38 个赞、7 条回复、657 次浏览)则呼吁采用基于真实 Treasury 文件的 grounded reasoning 基准,而不是轻量级提示测试。信息流中可见的应对方式,是让评测更加明确:使用结构化测试套件、基于真实材料的基准,以及 Copilot Studio 等产品化的代理评测工具。严重程度:高。是否值得构建:值得——数据仍然指向代理所缺失的流程控制层。
机构仍没有完善的作弊、声音克隆或 AI 介入排斥控制机制
第二个挫败集群来自制度和法律层面。@ScienceMagazine 认为(31 个赞、4 条回复、6,692 次浏览、13 个书签)引用一项涉及 95,513 名学生的研究,指出高等教育需要改革考核方式,因为生成式 AI 的使用和滥用情况因学科而异。@NHKWORLD_News 报道称(42 个赞、2,105 次浏览)关注一宗涉及 TikTok 上至少 188 条 AI 生成模仿声音视频的诉讼;NHK 表示,日本法务省已经成立专家小组,研究未经授权的合成声音问题。Magnifica Humanitas 中关于 AI 的章节,由 @cnnbrk 报道(15 个赞、10 条回复、1,636 次浏览)和 @metlifepaul 摘录(1 条回复、115 次浏览、2 个书签)转述出来,也从另一个角度提出了同样的批评:重要决策正逐渐交给自动化系统,而这些系统可能放大偏见、隐私侵犯和排斥。这里的应对方式是制度性的,而非技术性的——重新设计考核、提起诉讼、成立专家小组、撰写治理文本——这本身就说明,产品层面的控制仍然薄弱。严重程度:高。是否值得构建:值得——权利管理、来源证明和申诉工作流仍然十分欠缺。
有用的 AI 仍依赖许多团队并不具备的本地数据和语境
第三个挫败来自基础设施。@ycombinator 分享了(70 个赞、9 条回复、109,377 次浏览、42 个书签)关注 BioStack,因为医疗 AI 仍需要把混乱的真实临床数据、延迟结果、奖励和基准测试整合到一个闭环中。@OmarKamali 认为(21 个赞、5 条回复、1,568 次浏览)称,摩洛哥 AI 仍缺少服务代表性不足语言所需的大量基础设施,包括数据、语音工具、嵌入、评测、基础设施和法律协同。@anindyadeeps 写道(7 个赞、2 条回复、203 次浏览)称,许多 physical-AI 初创公司实际上都是数据供应商,并将这一领域称为“运营与规模化问题”;随后,该帖又展示了一个开源多模态可视化工具,说明仍有大量基础设施需要建设。可见的解决方式,是构建定制化技术栈、发布开放数据或可视化工具,并一次只聚焦一个领域或一种语言。严重程度:中高。是否值得构建:值得——但市场已经十分竞争,因为各团队都在构建内部替代方案。
3. 人们希望有哪些东西存在
可审计的代理评测与控制平面
最明显的缺失层,是一个能在代理造成损害之前,让其行为可供审查的系统。@pben4ai 提出了(31 个赞、4 条回复、10,696 次浏览、30 个书签)讨论了“约束衰减”问题;@unclebobmartin 回答了(226 个赞、17 条回复、6,570 次浏览、105 个书签)强调应使用可执行测试,而不是规则文件;@AlphaBalzer 指出(1 个赞、2 条回复、23 次浏览)介绍了 Microsoft 的内置评测工具;@PreyWebthree 以及 @metatronics_ 展示了 则共同说明,糟糕的流程仍会击败强大的模型。这是一项紧迫性很高的实际需求。基准测试套件、Copilot Studio 和自建测试框架已经提供了一些局部答案,但数据仍显示,目前是一个碎片化的技术栈,而不是一个可靠的统一控制平面。机会:直接。
合成媒体与自动化决策的权利、同意和申诉层
人们还希望 AI 系统明确处理同意、作者归属和补救机制。@NHKWORLD_News 报道称(42 个赞、2,105 次浏览)关注 AI 模仿声音的诉讼;@ScienceMagazine 披露了(31 个赞、4 条回复、6,692 次浏览、13 个书签)关注因学科而异的学术诚信问题;@metlifepaul 摘录了(1 条回复、115 次浏览、2 个书签)则关注一份通谕的警告:AI 介入的决策可能在看似中立的同时,将排斥常态化。这既是实际需求,也是情感需求:当一个人的身份或地位受到影响时,人们希望有证据、有同意机制,也有申诉渠道。目前的局部答案主要是诉讼、政策小组和机构指导,而非产品化的安全保障。机会:直接。
不会因价格或政策变化而消失的本地优先、本地语言 AI
所有权主题在当天格外明确。@iamfakhrealam 写道(10 个赞、4 条回复、2,551 次浏览)称,托管在服务器上的助手是“租来的”;引用的 MiniCPM 发布信息则将本地端侧推理定位为一种与工具建立不同关系的方式。@OmarKamali 认为(21 个赞、5 条回复、1,568 次浏览)称,摩洛哥的主权 AI 不仅要包含托管,还必须覆盖语言、法律、基础设施和文化语境。@thecableng 补充道(5 个赞、2 条回复、569 次浏览)展示了同一诉求在公共部门的版本:GovGuide Nigeria 的多语言聊天机器人。这是一项紧迫性中高的实际需求。MiniCPM、多语言政府机器人和本地语言 LLM 项目已经提供了一些局部答案,但信息流仍显示,现有的是许多组件,而不是完整的技术栈。机会:直接。
面向具体领域的后训练与数据管道
这一天还显示出一种更安静的需求:构建看起来像真实工作的环境和数据集。@ycombinator 分享了(70 个赞、9 条回复、109,377 次浏览、42 个书签)关注 BioStack,因为医疗 AI 需要在一个闭环中整合真实记录、延迟结果、奖励和基准测试。@anindyadeeps 指出(7 个赞、2 条回复、203 次浏览)则关注一个 physical-AI 可视化工具,它让多模态传感器数据可以在网页上被检查。这是一项紧迫性中等的实际需求,目前已经催生出真实公司和开源工具。机会:竞争激烈。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| BioStack | 医疗数据/评测平台 | (+) | 用于后训练的强化学习环境、适用于机器学习的临床数据、多智能体推理基础设施 | 回复中仍未解决隐私和数据治理问题 |
| FluxVLA Engine | 机器人/VLA 平台 | (+) | 从数据到部署的一体化工作流;支持多种 VLA 系列和骨干;支持 LIBERO 及真实机器人 | 早期开源项目,生态仍在形成 |
| X2SAM | 视觉分割模型 | (+) | 通过一个接口处理图像/视频分割;支持对话式和视觉提示;提供新的 V-VGD 基准 | 研究阶段系统,采用情况仍处于早期 |
| Copilot Studio Agent Evaluation | 代理评测工具 | (+/-) | 导入和 AI 生成的测试集、多种评分方式、阈值、通过/失败摘要、来源检查 | 处于公开预览阶段,并与 Microsoft 技术栈紧密绑定 |
| MiniCPM5-1B / Desk Pet | 端侧 LLM | (+) | 设置完成后支持本地优先聊天;上下文较长;部署占用小;提供桌面伴侣体验 | 首次启动设置和硬件限制仍然重要 |
| Sentient Arena / OfficeQA | Grounded reasoning 基准 | (+/-) | 大文档检索结合数值推理,比纯提示测试更接近真实企业任务 | 竞赛式叙事强于独立验证 |
| 可执行测试 | 代理控制方法 | (+) | 验收、单元、变异和属性测试构成代理难以规避的硬约束 | 可能较为僵化,效果取决于测试套件本身 |
| EvalVerse | 视频评测框架 | (+/-) | 评分电影感、表演、美学、镜头编排和视听融合,而不只是提示匹配度 | 仍处于早期研究阶段,尚未成为部署标准 |
总体而言,这一天对集成式技术栈的工具情绪偏正面,而对评测基础设施的看法较为复杂。人们喜欢能够压缩缺失工作流层的工具——BioStack 用于临床闭环,FluxVLA 用于机器人,X2SAM 用于多模态分割,MiniCPM 用于本地所有权——但对当前评测的拼接方式并不满意。可见的应对方式包括:用可执行测试替代规则文件,从通用基准转向任务专用测试框架,以及在访问连续性比前沿能力更重要时,从纯云端助手转向更小的本地模型。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| BioStack | @ycombinator | 基于混乱临床数据,为医疗 AI 后训练提供仿真环境 | 医疗模型需要真实的结果、奖励和评测闭环,而不是演示任务 | 临床数据、评测、奖励、基准测试、强化学习环境 | 已发布 | 推文 · 网站 |
| FluxVLA Engine | @DanKornas | 从数据到真实机器人部署的全栈 VLA 工程平台 | 机器人团队此前需要用不同脚本拼接训练、评测和部署 | Python、OpenVLA/LlavaVLA/GR00T/Pi0、LLaMA/Gemma/Qwen、RLDS/Parquet、LIBERO | Alpha | 推文 · 仓库 |
| X2SAM | @jiqizhixin | 统一的图像/视频分割模型,支持文本和视觉提示 | 图像、视频、指代分割和推理分割此前分散在不同工具中 | LLM、Mask Memory、分割解码器、V-VGD 基准 | Alpha | 推文 · 仓库 |
| MiniCPM Desk Pet | @iamfakhrealam | 基于 MiniCPM5-1B 构建的本地优先桌面伴侣 | 云端助手让人感觉是租来的、可变的,也可能随时停止服务 | MiniCPM5-1B-GGUF、本地运行时、macOS/Windows 桌面应用 | Beta | 推文 · 仓库 · HF |
| GovGuide Nigeria | @thecableng | 多语言政府信息聊天机器人 | 公民需要通过主要本地语言更容易地获取公共信息 | Meta Llama 生态、英语/Hausa/Igbo/Yoruba 聊天机器人 | Beta | 推文 |
BioStack 和 FluxVLA 是当天构建模式最清晰的例子:打包完整闭环,而不是让用户手动拼接缺失的基础设施。BioStack 将混乱的记录、奖励和基准测试封装进医疗后训练流程;FluxVLA 则在一套 VLA 主干中统一数据管道、训练、评测和真实机器人部署。
X2SAM 将同样的压缩逻辑应用于多模态感知,通过一个对话式界面处理图像和视频分割。MiniCPM Desk Pet 把本地推理变成面向用户的产品,而不只是开发者专用的配置;GovGuide Nigeria 则表明,多语言公共部门 AI 正从概念演示走向可见的实际使用——随附的仪表板显示有 1,969 名用户和 5,804 次对话。
反复出现的构建触发点,是工作流缺口:临床数据的混乱性、机器人集成、分割任务碎片化、对云端的依赖,或公共服务的可访问性。即使是 fpv_labs 的可视化工具帖子,也符合这一模式:它让多模态 physical-AI 数据变得可检查,而不只是可收集。
6. 新鲜且值得关注的内容
Magnifica Humanitas 将 AI 变成完整的社会教义议题
@cnnbrk 报道称(15 个赞、10 条回复、1,636 次浏览)称,教宗良十四世的首份重要神学文件警告,不应让 AI 掌握在少数人手中。官方的 Vatican 文本 值得关注,因为它没有把 AI 当作附带议题:文件专门讨论了 AI 治理、工作、自由与武器;@metlifepaul 披露了(1 条回复、115 次浏览、2 个书签)发布的摘录讨论串,则具体提出了对自动化排斥、隐私伤害和设计者偏见的警告。
Copilot Studio 将代理评测纳入构建工作流
@AlphaBalzer 重点介绍了(1 个赞、2 条回复、23 次浏览)介绍了 Microsoft 面向公开预览发布的 Agent Evaluation Copilot Studio 功能。该产品值得关注,因为它把导入和 AI 生成的测试集、灵活的评分方式、阈值,以及可按来源审查结果的能力,整合进构建代理的同一界面。
EvalVerse 将视频评测拓展到提示遵循之外
@jiqizhixin 介绍了(8 个赞、1 条回复、448 次浏览、4 个书签)介绍了 EvalVerse。这是由 HKUST、Tencent 和 Stanford 开发的框架,将视频评测视为不止是提示对齐问题。值得关注的变化在于评测指标本身:电影感、表演、美学、多镜头编排和视听融合。这指向了生成式视频系统更丰富的评测目标。
GovGuide Nigeria 让公共部门多语言 AI 变得可见
@thecableng 报道称(5 个赞、2 条回复、569 次浏览)介绍了 GovGuide Nigeria,这是一个基于 Meta Llama 生态构建的 AI 政府聊天机器人,支持英语、Hausa、Igbo 和 Yoruba。它之所以突出,是因为随附的截图看起来像一项正在运行的服务,而不是概念公告,产品仪表板上还显示了实际使用量。
7. 机会在哪里
[+++] 代理评测与流程控制基础设施 —— 医疗、编码代理、企业工具、金融和视频生成等领域都出现了相关证据。BioStack、“约束衰减”与 Uncle Bob 关于测试优先的回复、Copilot Studio Agent Evaluation、Sentient 的 grounded reasoning challenge,以及 Alpha Arena 的交易失败,都指向同一个缺口:在真正产生影响之前,团队仍缺乏可靠的方法证明代理会在真实环境中正确运行。
[++] 合成媒体与自动化决策的权利、来源证明和申诉机制 —— NHK 报道的声音克隆诉讼、Science 的考核改革研究,以及梵蒂冈关于隐私、偏见和排斥的警告,都显示出同一种制度性痛点。这是一个中等偏强的机会,因为需求十分明确,但当前的应对方式仍主要由法律和政策驱动,而非产品化方案。
[++] 面向服务不足语言和机构的主权及本地优先 AI 技术栈 —— MiniCPM Desk Pet、摩洛哥的 Darija/Amazigh LLM 项目,以及 GovGuide Nigeria,都在推动一种能够持续可用、原生支持本地语言并符合制度需求的 AI。机会程度为中等,因为开源和公共服务项目已经在推进,但集成式技术栈仍然少见。
[+] 原生于工作流的垂直 AI 基础设施 —— FluxVLA、X2SAM、BioStack 和 fpv_labs 的多模态可视化工具,都显示构建者正在把缺失的工作流层压缩成可用系统。这是一个新兴机会,因为模式已经清晰,但大多数成果仍处于早期阶段,标准和最终胜者尚未确定。
8. 要点
- 制度性参与者与构建者同样塑造了当天的 AI 叙事。 教会教义、高等教育政策和合成语音诉讼都成为主要证据,而不只是背景信息。(来源)
- 真正的实践前沿是在现实约束下进行评测,而不是刷新更大的基准测试标题。 BioStack、“约束衰减”、Copilot Studio Agent Evaluation 和 Alpha Arena 都指向同一点:真正困难的问题,是让系统在真实工作流中保持正确。(来源)
- AI 工作正围绕影响力、安全性和生产系统变得更加结构化。 MTS、BASE Fellowship 和 LLM Zoomcamp 都表明,进入 AI 行业的路径正变得比泛泛的“学习 AI”宣传更加明确。(来源)
- 最强的构建者持续交付完整闭环,而不是通用助手。 FluxVLA、X2SAM、BioStack 和 GovGuide Nigeria 都围绕一项具体工作,整合了数据、评测和部署。(来源)
- 本地所有权和本地语言正成为产品要求。 MiniCPM 的本地优先定位和摩洛哥的主权 AI 讨论都认为,可用性、语言适配和合规部署与模型原始能力同样重要。(来源)