Twitter AI - 2026-05-26
1. 人们在讨论什么
1.1 评测不再只是排行榜,而是变成了控制层 🡕
5 月 26 日,评测是讨论最集中的主题,但重心已经发生变化。人们不再只是追问哪个前沿模型登顶了通用排行榜,而是开始争论:谁来定义基准、基准覆盖的是哪类工作,以及它能否安全地为真实生产流量做路由。至少有六条入选内容支撑了这一主题。
@JayminSOfficial 认为 (416 个赞、590 次转发、30 条回复、44,477 次浏览)指出,基准排行榜已经悄然成为模型选择的默认操作系统;而其中引用的 Merge Gateway 发布内容 @shensi 则表示,团队应自行定义权重、基准和评测,而不是追逐当前的赢家。Merge 的 《Build Your Own Router》文章 将这一点具体化:组织可以组合标准基准、行业排行榜和自定义分数,然后查看某个模型为何在一次路由决策中胜出。
@ValsAI 发起了 (195 个赞、12 条回复、18,199 次浏览、356 次收藏)介绍了一项为期 3—6 个月、面向新基准和评测技术的研究资助计划;回复很快指出了语音 AI、AI 驱动的投资指标等尚未解决的空白。值得注意的变化不只是又多了一篇基准测试帖子,而是评测本身被视为一个独立且有资金支持的研究类别。
@cyb3rops 分享了 (70 个赞、4 条回复、4,923 次浏览、47 次收藏)介绍了 THOR 发现分诊基准,因为通用 LLM 排行榜无法帮助 RuneAI 判断一个杂乱的端点发现应被压下、复核还是升级处理。公开内容 基准测试网站 和 代码仓库 显示,当前版本覆盖 45 个模型、10 份 THOR 报告和 189 条由专家分类的发现,并提供运营分诊分数、关键遗漏和误审负担等指标。
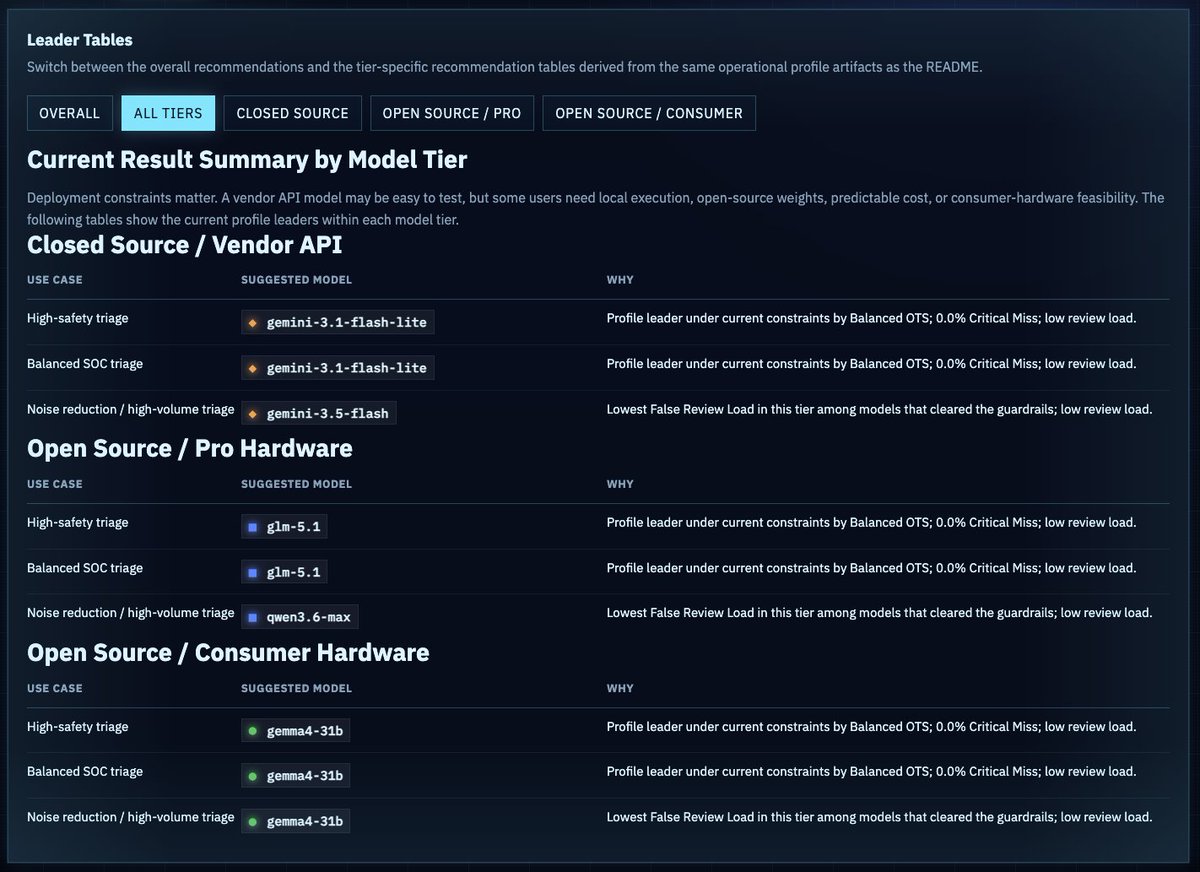
这张截图很重要,因为它展示的是作为部署决策表输出的评测结果,而不是一个放之四海而皆准的赢家。
@DeepLearningAI 指出 (11 个赞、9 条回复、848 次浏览)提到了 Carnegie Mellon 和 Stanford 的一项研究,显示 43 个智能体基准和 72,342 项任务,相比更广泛的美国劳动力市场,仍然过度偏重软件工作。链接中的 论文 把当天对基准的质疑转化成了一个可度量的覆盖问题,而不只是感觉层面的怀疑。
讨论洞察: Merge、Vals 和本地模型相关讨论中的回复,最终都指向同一种怀疑:分数只有在与工作流绑定时才有用,不能被当成普适的智能徽章。
与前一天对比: 5 月 25 日已经把评测推向真实环境和产品内置工具。5 月 26 日则更进一步,开始直接质疑基准本身:谁来定义它、它覆盖哪些工作,以及它究竟如何为生产流量做路由。
1.2 可靠性工作聚焦于可验证推理和记忆 🡕
第二个讨论集群把可靠性视为结构设计问题,而不是提示词问题。共同模式是把更多工作转移到可检查的中间状态:快速权重巩固、由编译器验证的证明,或确定性的证据编译。三条入选内容构成了这一主题的核心。
@iScienceLuvr 分享了 (697 个赞、23 条回复、43,042 次浏览、568 次收藏)介绍了新论文《Language Models Need Sleep》,链接中的 arXiv 摘要 称,模型会定期将近期上下文转换为持久化的快速权重,清空 KV 缓存,并在“睡眠”期间使用离线循环处理,以提升更困难推理任务的表现。随附的首页很关键,因为它揭示了确切机制——状态空间模型模块中的快速权重加离线循环——而不是停留在比喻层面。

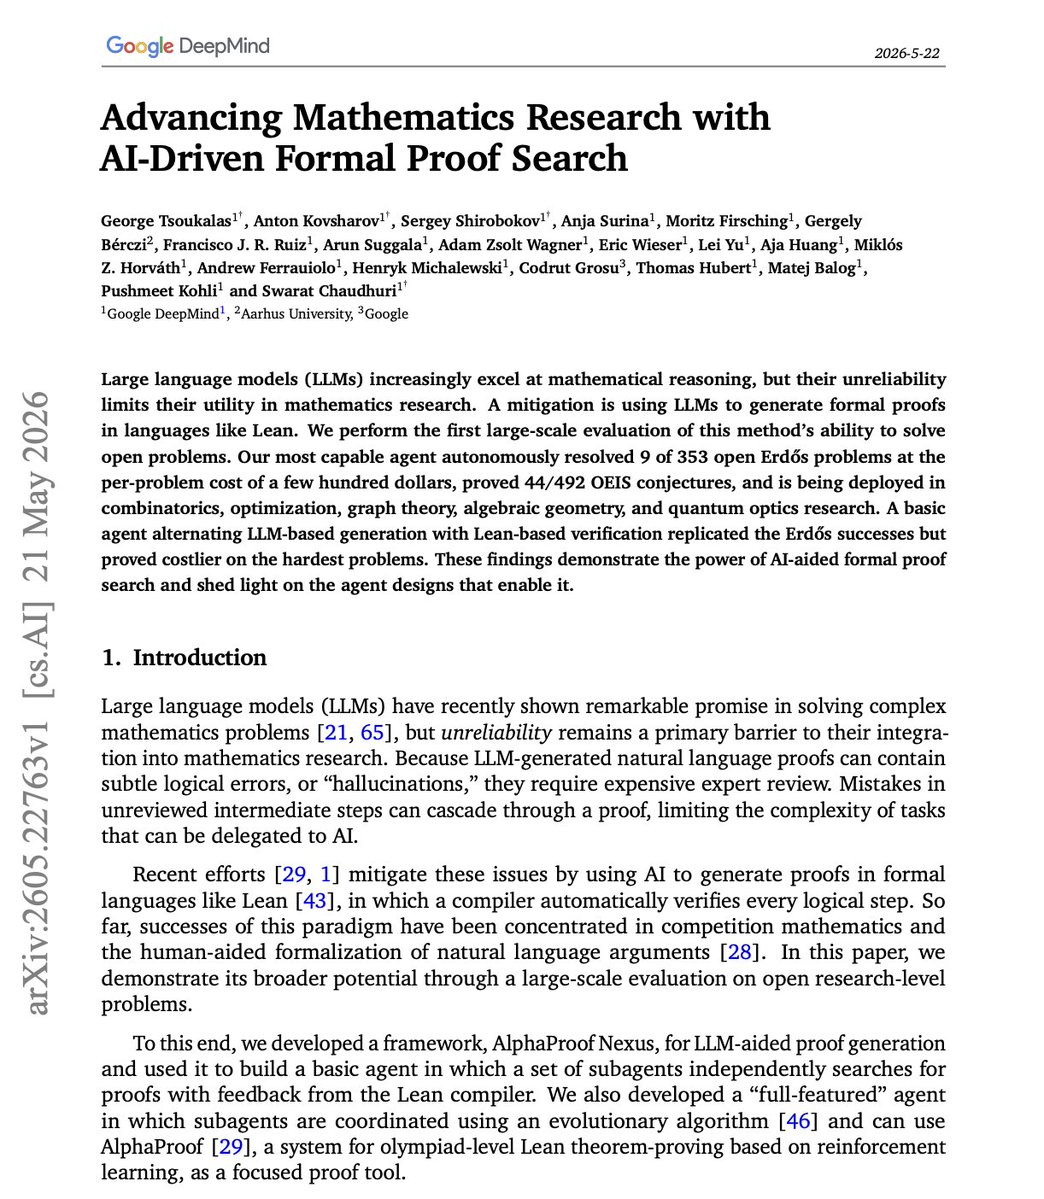
@HowToAI_ 声称 (46 个赞、6 条回复、2,358 次浏览、38 次收藏)称,AlphaProof Nexus 通过将 LLM 与 Lean 证明编译器结合,解决了长期未解的数学问题。对应的 论文 确认了核心结果:最强智能体解决了 353 个开放 Erdos 问题中的 9 个,并证明了 492 个 OEIS 猜想中的 44 个;而更简单的“生成加验证”循环也复现了 Erdos 问题上的成功,但在最难案例上的成本更高。
@yoheinakajima 报道称 (32 个赞、9 条回复、5,685 次浏览、30 次收藏)称,ActiveGraph 在 LongMemEval-S 上表现稳健,而且没有使用图中抽取的事实,也没有写入语义记忆。链接中的 技术说明 称,该系统在 2,462 个 token 的预算下,实现了 85.6% 的问答准确率和 86.2% 的上下文内作答率;与密集型逐轮 RAG 在统计上持平,同时在检索侧展现出经测量的优势。
讨论洞察: 最技术性的回复并没有要求更好的提示词,而是把“睡眠”论文与重放缓冲区进行比较,追问 ActiveGraph 是否依赖实体抽取,并得到了“这里没有抽取”的回答——这说明从业者关注的是确定性机制和硬反馈闭环。
与前一天对比: 5 月 25 日强调了真实的评测环境。5 月 26 日则增加了模型或运行框架内部的可靠性机制:快速权重、证明检查器,以及事件溯源式的证据编译。
1.3 当治理与合规和同意绑定时,讨论仍然具体 🡒
治理讨论的热度依旧很高,但最有分量的帖子并不是抽象的伦理讨论,而是围绕谁有权监督前沿 AI、当合成输出侵犯同意时会发生什么,以及企业合规自动化是否终于从“足以试点”迈向“值得信赖”。三条入选内容支撑了这一主题。
@Reuters 报道称 (19 个赞、8 条回复、11,400 次浏览)称,Anthropic 联合创始人 Chris Olah 表示,AI 开发不能完全交由科技公司负责,并呼吁宗教领袖、政府和公民社会参与监督。即使无法访问付费墙后的 Reuters 文章,这条推文本身也已明确提出监督诉求,并让有关教宗通谕的讨论获得了更广泛的主流传播。
@Anime 报道称 (30 个赞、1,723 次浏览)称,配音演员 Kenjiro Tsuda 就 TikTok 被指未经授权使用其声音进行生成式 AI 创作一事提起诉讼。链接中的 Anime News Network 报道 将这一说法落在一场正在进行的权利纠纷上,而不是假设性的未来风险。
@a16z 认为 (38 个赞、6 条回复、9,174 次浏览、23 次收藏)称,合规或许终于能从“足以试点”迈向“值得信赖”;链接中的 文章 则表示,前沿模型如今在 LegalBench 的 162 项法律推理任务上取得了 80%—100% 的分数。图表很重要,因为它显示准确率的跃升发生在最近,这有助于解释为什么合规现在重新成为一个创业类别,而不是两年前。

讨论洞察: 最实质性的反驳出现在合规讨论中。一条回复指出,“一个 90% 正确的产品仍然是 100% 错误的”,并主张在定案前进行验证。这让当天的治理讨论牢牢锚定在流程和追索机制上,而不只是对采用前景的乐观判断。
与前一天对比: 5 月 25 日将教宗通谕摘录、学术诚信数据和合成声音诉讼放在了一起。5 月 26 日延续了相同的治理框架,但进一步靠近企业软件和现实中的权利执行。
1.4 构建者的热情仍集中在工作流基础设施上 🡕
构建者活动依旧活跃,但方向比通用 AI 助手更窄。信号最强的项目,都是围绕特定工作流补齐缺失的底层能力:医疗领域的后训练、可验证执行,或科学证据检索。四条入选内容符合这一特征。
@ycombinator 分享了 (108 个赞、10 条回复、476,173 次浏览、85 次收藏)介绍了 BioStack,称其提供模拟环境,让医疗 AI 模型在混乱的临床记录、延迟结果、奖励和基准中训练。BioStack 的 网站 补充称,公司销售覆盖 EHR、实验室、影像、ECG、病历和结果的 ML 就绪医疗数据集,同时提供 RL 环境和多智能体推理基础设施。
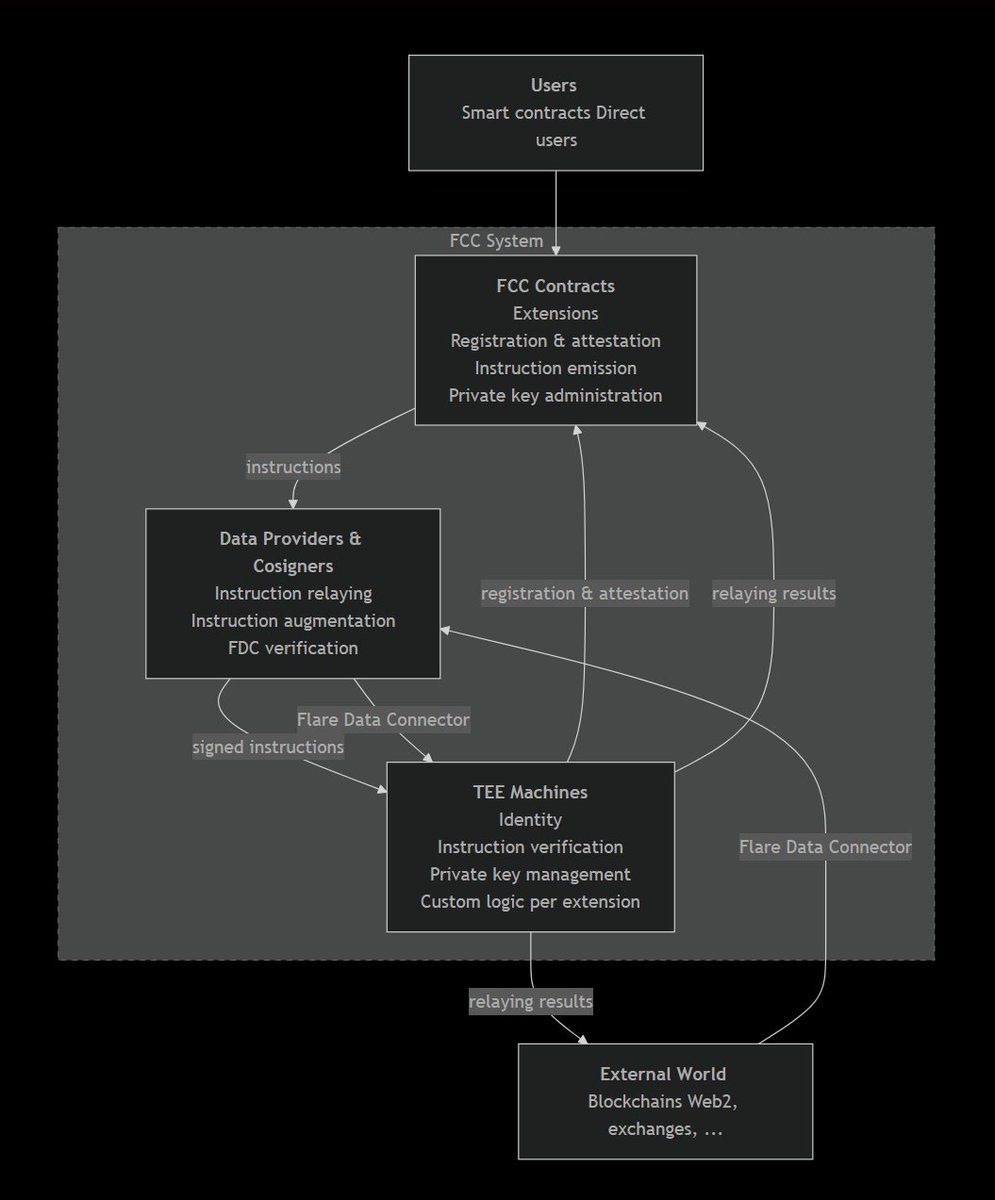
@FlareDevHub 概述了 (33 个赞、2 条回复、2,965 次浏览)介绍了 Flare Confidential Compute,旨在证明运行的是哪个模型、保护敏感输入、将签名密钥保存在 TEE 内,并基于可验证输出结算智能体之间的支付。随附的工作流图让这一提议具体得多:它展示了机密计算组件和支付流程,而不是泛泛的智能体金融口号。
@zxlzr 分享了 (8 个赞、167 次浏览、4 次收藏)介绍了 InnoEval 和 SciAtlas,这是一个围绕深度知识搜索、多视角审查以及 4,300 万篇论文知识图谱构建的科学想法评估栈。链接中的 InnoEval 论文、SciAtlas 论文 和 SciAtlas 代码仓库 描述了一套检索底座,用于文献综述、想法锚定、趋势综合和基于证据的评估。
@TheAIWorld22 表示 (9 个赞、318 次浏览、5 次收藏)介绍了 ForgeTrain。它比典型的“这是 AI 写的”公告更可信,因为基准公开、方法论也已开源。公开内容 ForgeTrain 代码仓库 称,该框架由自主智能体循环端到端编写,并在 H100 上实现了 44.13% 的 MFU。
讨论洞察: 这一集群中的回复不断回到可审计性、隐私和可复现性。市场传递出的信号是,构建者已经不能只交付演示层;他们还必须解释数据来自哪里、工作流如何被检查,以及系统能否复现。
与前一天对比: 5 月 25 日已经偏好原生于工作流的系统。5 月 26 日则将这一倾向进一步推进到底层:后训练环境、机密计算、科学知识图谱和由 AI 编写的基础设施。
1.5 CPU 重新成为智能体 AI 的独立瓶颈 🡕
一个规模较小但十分明确的主题,是把智能体 AI 重新表述为既是 GPU 问题、也是 CPU 问题。证据来自 NVIDIA 的产品推广、关于工具使用开销的从业者讨论,以及一份将智能体需求与 DRAM 紧张联系起来的卖方机构报告。三条入选内容支撑了这一主题。
@nvidia 表示 (70 个赞、8 条回复、5,869 次浏览)称,Vera 是专为智能体 AI 打造的产品;NVIDIA 的 产品页面 表示,该芯片拥有 88 个 Olympus 核心、最高 1.2 TB/s 的 LPDDR5X 带宽,以及可运行超过 22,500 个并发环境的机架设计。NVIDIA 的另一条内容 交付文章 将 CPU 定位为工具调用、编排、长上下文检索和强化学习环境的基础设施,而不是通用主机处理器。
@demian_ai 认为 (22 个赞、3 条回复、1,438 次浏览、11 次收藏)称,智能体编程框架会把大量时间花在工具使用、文件编辑、lint 和 shell 编排等 CPU 工作上,因此 CPU 需求的增长速度超过了旧有容量规划的预期。@sean___ 补充说 (41 个赞、4,160 次浏览、20 次收藏)介绍了一份 Mizuho 报告,称 NVIDIA 的 CPU 收入可能意味着约 3K PB 的新增 CPU 需求,且部分客户仍有 30%—50% 的供给缺口。
讨论洞察: NVIDIA 发布帖下最有价值的回复没有讨论股价,而是指出,端到端整合 CPU 和 GPU 的团队,将最能受益于低延迟、面向智能体的基础设施。
与前一天对比: 5 月 25 日已经出现硬件讨论,但侧重点较轻。5 月 26 日,CPU 本身成为明确点名的瓶颈,不再只是 GPU 和 HBM 背后的辅助细节。
2. 什么让人感到沮丧
基准测试的胜负仍然无法告诉团队该部署什么
反复出现的抱怨并不是基准太少,而是错误的基准拥有了过大的影响力。@JayminSOfficial 认为 (416 个赞、590 次转发、30 条回复、44,477 次浏览)指出,研究排行榜如今正在引导生产流量;而 @cyb3rops 展示了 (70 个赞、4 条回复、4,923 次浏览、47 次收藏)则说明这在安全分诊中为何失效:真正有用的问题不是谁最会写代码,而是谁最擅长压下、复核或升级处理杂乱的端点发现。@DeepLearningAI 补充说 (11 个赞、9 条回复、848 次浏览)指出,整个基准组合相较于更广泛的劳动力市场,仍然过度代表软件工作。可见的应对方式,是构建自定义路由配置、领域专属基准套件和新的评测计划,而不是相信一个醒目的单一分数。严重程度:高。值得构建吗:值得——信息流仍然指向基准输出与生产选择之间缺失的转换层。
强大的模型仍会在流程、可审计性和验证上失败
第二个挫败点是,当工作流要求流程纪律而不是漂亮文本时,强大的模型仍然会失灵。@metatronics_ 写道 (7 个赞、10 条回复、1,676 次浏览)称,前沿智能体在 Alpha Arena 中因过度交易、仓位控制草率以及事后才设置止损而亏损,并不是因为它们无法描述市场。@ycombinator 分享了 (108 个赞、10 条回复、476,173 次浏览、85 次收藏)介绍了 BioStack;其中一条回复立即把买方测试重新定义为可审计性:医院能否通过模拟病历、奖励规则和临床签字,追溯一条错误建议?在合规讨论中,@a16z 制作了 (38 个赞、6 条回复、9,174 次浏览、23 次收藏)代表了当天最有力的自动化支持论据,但最有实质性的回复反驳称,对于高风险决策而言,一个 90% 正确的合规产品在真正定案时仍然等同于错误。可见的应对模式,是在模型周围加入确定性检索、形式化验证器或明确的流程控制。严重程度:高。值得构建吗:值得——流程层仍然明显建设不足。
权利、同意和申诉层仍然薄弱
治理帖子在触及身份与追索时最为具体。@Reuters 报道称 (19 个赞、8 条回复、11,400 次浏览)是 Chris Olah 呼吁科技公司之外的监督;这本身就说明,人们并不相信现有制度性制衡会仅凭市场力量自然出现。@Anime 报道称 (30 个赞、1,723 次浏览)介绍了 Kenjiro Tsuda 就 TikTok 被指未经授权使用 AI 声音一事提起的诉讼,说明同意问题已经可以诉诸法律,而非理论上的风险。@a16z 以及 的回复还暴露出合规工作流中的追索机制有多脆弱:企业或许更信任模型了,但在错误决策演变成监管或面向客户的失败之前,仍希望先完成验证。严重程度:高。值得构建吗:值得——来源追踪、同意管理和申诉工具仍然比其要管理的风险薄弱得多。
智能体工作负载暴露出 CPU 和内存瓶颈
另一个挫败点来自基础设施:人们不断将智能体 AI 描述成模型问题,而信息流越来越把它视为系统问题。@nvidia 将其定位为 (70 个赞、8 条回复、5,869 次浏览)介绍了面向智能体 AI 的 CPU Vera;@demian_ai 认为 (22 个赞、3 条回复、1,438 次浏览、11 次收藏)指出,工具使用、文件编辑、lint 和编排使智能体编程框架高度依赖 CPU;@sean___ 发布了 (41 个赞、4,160 次浏览、20 次收藏)则介绍了一份 Mizuho 报告,指出供给不足和显著的定价压力。信息流中的应对方式并不是放弃加速器,而是从端到端 CPU 加 GPU 的角度思考,并将编排硬件视为一等设计变量。严重程度:中高。值得构建吗:值得——但这是资本密集型机会,现有厂商已经在行动。
3. 人们希望存在什么
面向工作流的路由和评测控制平面
最强烈的潜在需求,是建立一层能够把抽象的模型分数转化为产品级决策的能力。@JayminSOfficial 认为 (416 个赞、590 次转发、30 条回复、44,477 次浏览)指出,为论文构建的基准已经在决定生产流量;相关的 Merge Gateway 发布内容则允许团队为自己的基准设定权重并上传自定义分数。@ValsAI 开放了 (195 个赞、12 条回复、18,199 次浏览、356 次收藏)介绍了一项面向新评测技术的研究资助计划;@DeepLearningAI 强调了 (11 个赞、9 条回复、848 次浏览)则是关于当前智能体基准仍然遗漏大量真实劳动的研究。这是一项紧迫度很高的实际需求。Merge Gateway、THOR 和获得资助支持的评测工作已经提供了部分答案,但整个技术栈仍显得碎片化,而非已经定型。机会:直接。
能够证明智能体实际做了什么的可验证流程层
第二个未满足的需求,不是更聪明的答案生成器,而是能够证明工作确实被正确完成的系统。@HowToAI_ 指出 (46 个赞、6 条回复、2,358 次浏览、38 次收藏)提到了以 Lean 为后端的 AlphaProof Nexus 证明循环;@yoheinakajima 报道称 (32 个赞、9 条回复、5,685 次浏览、30 次收藏)提到了在语义记忆之前进行的确定性证据编译;@FlareDevHub 概述了 (33 个赞、2 条回复、2,965 次浏览)则提到了面向智能体的可验证推理和安全密钥托管。@metatronics_ 展示了 (7 个赞、10 条回复、1,676 次浏览)说明了这一点为何重要:毁掉实时交易结果的是流程失败,而不是语言能力。这是一项紧迫度很高的实际需求。已有部分答案,但大多仍是彼此孤立的技术,而不是一个可靠的统一控制层。机会:直接。
面向合成身份和自动化决策的同意、来源追踪与申诉系统
信息流还指向了一个围绕影响真实个人的 AI 输出而缺失的权利管理层。@Reuters 报道称 (19 个赞、8 条回复、11,400 次浏览)是明确呼吁外部监督的内容;@Anime 报道称 (30 个赞、1,723 次浏览)介绍了一起关于涉嫌滥用 AI 声音的诉讼;@a16z 认为 (38 个赞、6 条回复、9,174 次浏览、23 次收藏)则指出,只有在准确率更高之后,合规工作如今才开始变得可由 AI 处理。综合来看,这些内容说明,人们需要在 AI 系统模仿某个人或作出受监管决策时,拥有同意记录、来源追踪和追索渠道。这既是实际需求,也是制度需求,紧迫度很高。如今的部分答案仍主要是诉讼、教宗通谕和验证附加层,而不是产品化的保障机制。机会:直接。
以领域为基础的数据和知识底座
另一个明确需求,是提供看起来像真实任务的数据和知识层,而不是通用的基准提示词。@ycombinator 分享了 (108 个赞、10 条回复、476,173 次浏览、85 次收藏)介绍了 BioStack,因为医疗领域的后训练需要在一个系统中处理混乱的记录、延迟结果和奖励循环。@zxlzr 分享了 (8 个赞、167 次浏览、4 次收藏)介绍了 SciAtlas 和 InnoEval,它们以 4,300 万篇论文的图谱为科学想法评估提供依据;@cyb3rops 构建了 (70 个赞、4 条回复、4,923 次浏览、47 次收藏)则介绍了围绕真实 THOR 报告构建的公开分诊基准。这是一项紧迫度中高的实际需求,并且已经吸引了可信的构建者。机会:竞争性。
4. 正在使用的工具和方法
| 工具 | 类别 | 评价 | 优势 | 局限 |
|---|---|---|---|---|
| Merge Gateway | LLM 路由 / 控制平面 | (+) | 允许团队为基准设定权重、上传自定义分数、审计路由决策,并将路由与 DLP 和提示注入控制结合起来 | 仍然依赖客户自行定义评测,以及团队能够拼装出来的基准覆盖范围 |
| Vals AI / Vals Fellowship | 评测平台 / 研究项目 | (+) | 为困难的评测问题提供资金,并向研究人员提供 API 额度、GPU、人类数据和评测基础设施 | 回复本身就暴露了语音 AI、长期投资指标等尚未解决的领域 |
| THOR Finding Triage Benchmark | 安全基准 | (+/-) | 提供领域专属的分诊指标,覆盖 45 个模型、10 份报告、189 条专家标注发现,并给出部署层级指导 | 在作者预计用于生产的完整工具增强工作流之前,它仍只是一个干净的基线 |
| ActiveGraph | 记忆 / 运行时 | (+/-) | 确定性摄取、紧凑的证据编译,以及在低上下文预算下出色的 LongMemEval-S 检索表现 | 与密集型逐轮 RAG 在统计上持平,而非明显更好;且尚未加入语义记忆 |
| AlphaProof Nexus + Lean | 形式化证明栈 | (+) | 编译器支持的验证、开放问题结果,以及能够拒绝错误推理步骤的清晰机制 | 更困难的问题成本仍然更高,而且该方法依赖可形式化的领域 |
| BioStack | 医疗数据 / RL 环境 | (+) | 提供 ML 就绪的临床数据、延迟结果循环、奖励函数和面向医疗 AI 的后训练环境 | 一旦设想生产部署,可审计性和隐私问题就会立即出现 |
| 以 LegalBench 为主导的合规 AI | 法律 / 合规基准层 | (+/-) | 前沿模型能力的提升,使文档密集型合规自动化更可信,也更具商业紧迫性 | 讨论中的反驳强调,即使准确率很高,在定案前仍然需要验证 |
| SciAtlas | 科学知识图谱 / 智能体技能 | (+) | 拥有 4,300 万篇论文、1.57 亿个实体、30 亿个三元组,并为文献综述、想法锚定和趋势综合提供结构化检索 | 论文仍标注为进行中的工作,生态也处于早期阶段 |
| ForgeTrain | 训练基础设施 | (+/-) | 提供公开代码库、由 AI 编写的代码库,以及采用开源方式呈现的 44.13% MFU 声明 | 运行框架仍将发布,因此完整的自主构建故事尚未完全公开 |
| Flare Confidential Compute | 可验证计算 / TEE 栈 | (+/-) | 在一个概念中结合了可验证推理、私有输入、安全密钥托管和智能体支付逻辑 | 公开文档仍然有限,目前最有力的证据是架构草图和推文串 |
| NVIDIA Vera CPU | CPU / 智能体硬件 | (+) | 拥有 88 个 Olympus 核心、最高 1.2 TB/s 的带宽,并明确针对 RL 环境、编排和工具密集型智能体工作负载进行优化 | 首批系统才刚刚进入客户评估阶段,实际采用曲线仍在形成 |
总体而言,人们对那些能够约束或锚定模型行为的工具评价最高,而不是只承诺模型会更聪明。人们认可能够公开策略的路由层、与任务匹配的基准、可以拒绝错误步骤的证明系统,以及看起来更接近真实工作的数据和知识底座。
可见的应对方式包括:从单一通用排行榜转向加权基准配置;从完整历史提示转向确定性证据编译;从人工合规转向 AI 加验证;以及从只考虑 GPU 转向考虑 CPU 的系统设计。在路由、评测和合规领域,竞争压力最明显:尽管垂直领域不同,多个构建者正围绕类似的控制层问题趋同。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Merge Gateway | @shensi / @merge_api | 使用加权基准和策略配置路由 LLM 请求 | 每当新模型登上通用排行榜榜首,团队都必须重新测试和集成 | 基准库、自定义分数、路由配置、策略路由、DLP、提示注入控制 | 已发布 | 推文 · 博客 |
| BioStack | @sanatmishra7 / @patwa_parth | 为医疗 AI 后训练构建模拟环境和数据管道 | 医疗模型需要混乱的记录、延迟结果和奖励循环,而不是只有基准演示 | RL 环境、医疗数据集、标注、奖励函数、多智能体推理基础设施 | 已发布 | 推文 · 网站 |
| THOR Finding Triage Benchmark | @cyb3rops | 评估模型对安全事件和取证发现的分诊能力 | 通用推理或编程排行榜无法说明模型在 SOC 分诊中会如何表现 | THOR 报告、运营分诊分数、关键遗漏率、误审负担、公开代码库 / 网站 | 已发布 | 推文 · 网站 · 代码仓库 |
| ActiveGraph | @yoheinakajima | 用于智能体记忆和证据编译的事件溯源图运行时 | 长期记忆系统需要可复现的证据组装,同时避免付出高昂的检索成本 | 事件日志、确定性图投影、嵌入、LLM 阅读器、基准测试框架 | Alpha | 推文 · 博客 · 代码仓库 |
| SciAtlas | @zxlzr | 面向科学研究智能体的知识图谱底座和客户端工具 | 当证据碎片化且缺乏结构时,文献搜索和想法评估会失效 | 4,300 万篇论文知识图谱、图重排、CLI/API、智能体技能 | Alpha | 推文 · 论文 · 代码仓库 |
| ForgeTrain | @OpenBMB | 面向 LLM 训练、由 AI 编写的预训练框架 | 基础设施代码生成的声明通常缺乏公开方法论和可度量产出 | 自主智能体循环、PyTorch/CUDA 栈、H100 训练框架、MFU 基准测试 | Beta | 推文 · 代码仓库 |
| Flare Confidential Compute | @FlareDevHub | 提议经过证明的模型执行、私有输入、安全密钥托管和智能体支付 | 如今智能体很难证明运行了哪个模型,也难以安全地保管机密和支付资产 | TEE 式隔离区、证明、链上证明、密钥托管、智能体支付流程 | RFC | 推文 |
| AgentScoreboard | @Paymindai | 为银行业智能体提供排名、徽章和可导出的评分卡 | 智能体基准测试和认证仍然难以比较,也难以在产品内部落地 | Elo 排名、时间衰减、领域分数、徽章系统、Markdown/JSON 导出 | Alpha | 推文 |
Merge Gateway 和 THOR 是当天共同构建触发因素最清晰的例子:通用排行榜已经不够用了。Merge 的应对方式是让路由策略可配置;THOR 的应对方式则是发布一个面向安全领域的基线,并提供部署层级、关键遗漏指标和公开产物。
BioStack 和 SciAtlas 从数据侧切入了同一个结构性缺口。BioStack 将真实临床证据、延迟结果和奖励循环封装进一个医疗后训练栈;SciAtlas 则将 4,300 万篇论文和 1.57 亿个实体组织成图谱,供研究智能体查询,以进行有依据的评估和文献工作。
ForgeTrain、Flare Confidential Compute 和 AgentScoreboard 展现了第二种趋势:控制层本身正在成为产品。ForgeTrain 将可复现性和性能声明转化为公开代码库;Flare 试图让执行和支付流程具备可证明性;AgentScoreboard 则将比较和认证变成可见功能,而不是内部电子表格。
6. 新鲜且值得关注的内容
LLMorphism 为反拟人化批评提供了更鲜明的名称
@ValerioCapraro 认为 (70 个赞、19 条回复、11,644 次浏览、53 次收藏)指出,人们越来越倾向于把人类认知当作大型语言模型那样运作,并将这种错误称为“LLMorphism”。随附的信息图和链接中的 论文 之所以值得关注,是因为它们将讨论从泛泛的拟人化警告推进到了具体机制、后果和缓解措施。

消费级硬件上的编程模型持续缩小与前沿模型的差距
@bridgemindai 发布了 (146 个赞、21 条回复、7,284 次浏览)称,本地 Gemma 和 Qwen 变体如今在一张编程图表上超过了 GPT-5,但仍落后于 GPT-5.5 和 Claude Opus 4.7。这张图之所以值得关注,是因为它让差距变得可见,而不只是停留在口头层面;但置顶回复立即反驳称,基准分数与真实质量并不一致——这也是当天更广泛基准张力的简洁概括。

智能体排名开始像一种产品基础能力
@Paymindai 宣布 (17 个赞、1 条回复、528 次浏览)介绍了 AgentScoreboard 的一次更新:它为银行业智能体提供类似 Elo 的排名、时间衰减、领域分数、徽章以及 Markdown/JSON 导出。这是一个早期信号,但值得注意之处在于,它将智能体比较和认证变成了产品内功能,而不是内部基准电子表格。
由 AI 编写的训练基础设施成为更具体的公开产物
@TheAIWorld22 表示 (9 个赞、318 次浏览、5 次收藏)介绍了 ForgeTrain。由于方法论和基准测试公开,它比典型的“这是 AI 写的”公告更难被轻易否定。链接中的 代码仓库 发布了 H100 上 44.13% MFU 的声明性结果,并将该框架描述为由自主智能体循环端到端生成的代码,这让它更加值得关注。
7. 机会在哪里
[+++] 面向工作流的评测和路由基础设施 —— Merge Gateway、THOR、Vals、DeepLearning.AI 对基准覆盖范围的批评,以及 AgentScoreboard 都提供了相关证据。5 月 26 日最强烈的趋势是:团队不再相信单一排行榜能够决定模型选择,但也还没有默认的替代方案。
[+++] 可验证的智能体控制和流程约束层 —— AlphaProof Nexus、ActiveGraph、Flare Confidential Compute、Alpha Arena 的交易失败,以及合规验证方面的反驳,都指向同一个缺口:模型可能很出色,但系统仍需要一种方式来证明发生了什么,并在错误步骤造成影响之前拒绝它们。
[++] 以领域为基础的数据和知识底座 —— BioStack、SciAtlas 和 THOR 都显示,构建者正在反复围绕某个工作流补上缺失的证据层。这是一个中等偏强的机会,因为痛点明确,但医疗、安全和研究领域已经出现了可信的构建者。
[++] 面向合成媒体和受监管 AI 的权利、来源追踪与申诉机制 —— Chris Olah 的监督呼吁、Tsuda 的诉讼以及合规讨论,都显示机构需要的是追索渠道,而不只是准确率。需求很明确,但当前应对仍更多由法律和政策驱动,而非产品化。
[+] 面向 CPU 的智能体基础设施 —— NVIDIA Vera、demian_ai 的讨论串和 Mizuho 报告都表明,围绕编排、内存移动和工具密集型智能体工作进行优化的系统,正在 GPU 头条之外形成不断增长的市场。机会正在出现,但现有硬件厂商已经占据先机。
8. 要点
- 基准怀疑如今已经成为运营问题,而非哲学问题。 Merge Gateway、THOR 和劳动力覆盖范围的批评都指向同一变化:团队需要能映射到具体工作流的基准输出,而不是普适排名。(来源)
- 可靠性进步越来越来自模型周围的结构。 快速权重巩固、Lean 支持的证明验证和确定性证据编译,都比提示词技巧或模糊的自主性声明获得了更多关注。(来源)
- 当治理与现实执行或企业流程绑定时,它最容易被理解。 Chris Olah 的监督呼吁、Tsuda 的诉讼和合规讨论,都将 AI 治理转化成了同意、追索和验证问题。(来源)
- 最强的构建者交付的是缺失的底座,而不是通用助手。 BioStack、SciAtlas、THOR 和 ForgeTrain 都围绕一项狭窄任务,封装了此前被忽视的层——数据、评测、知识结构或基础设施代码。(来源)
- 智能体 AI 正在将硬件讨论拓展到 GPU 之外。 NVIDIA Vera、demian_ai 的 CPU 论点和 Mizuho 报告,都将编排、文件操作和内存移动视为一等瓶颈。(来源)