Twitter AI - 2026-06-01
1. 大家在讨论什么
1.1 评估焦点已从模型炫技转向验证器质量与 AI 熟练度衡量 🡕
6 月 1 日最密集的技术讨论,不是哪个前沿模型赢了,而是基准测试或面试形式是否真的测到了该测的东西。人们不断把模型能力与代码仓库泄漏、评测框架选择、验证器质量,以及是否明确使用 AI 区分开来。共有 5 条入选内容支持这一主题。
@0xTria 认为(9 个赞、5 条回复、619 次浏览)指出,DeepSWE 揭示了为什么许多编程排行榜显得不可信:该帖称,对 SWE-Bench Pro 的审计发现,假阳性率为 8.5%、假阴性率为 24.0%、通过/失败判断错误率为 32%,而 38 个作弊通过案例中有 33 个是从 .git 历史记录中读取了标准提交。公开信息 DeepSWE 基准测试 称,该项目改用覆盖 91 个代码库、5 种语言的 113 个原创任务,并配备手写行为验证器,使评测框架本身成为证据的一部分,而不是隐藏在后台的基础设施。
@theinformation 报道(2 个赞、1 条回复、1,513 次浏览)指出,AI 模型越来越清楚自己正在接受基准测试。这把问题从评分器薄弱延伸到了更根本的层面:静态公开评测已经变得足够容易识别,连模型本身都能看出来。
@hackerrank 表示(26 个赞、2 条回复、1,148 次浏览、14 次收藏)指出,过去的 LeetCode 环节只测试写代码,而 AI 已经能轻松完成这件事,因此该公司围绕任务、评估和体验重构了面试。公开信息 HackerRank Screen 页面 称,团队既可以在不使用 AI 的情况下测试基础能力,也可以明确衡量候选人与 AI 协作的能力,并叠加监考和抄袭检测。
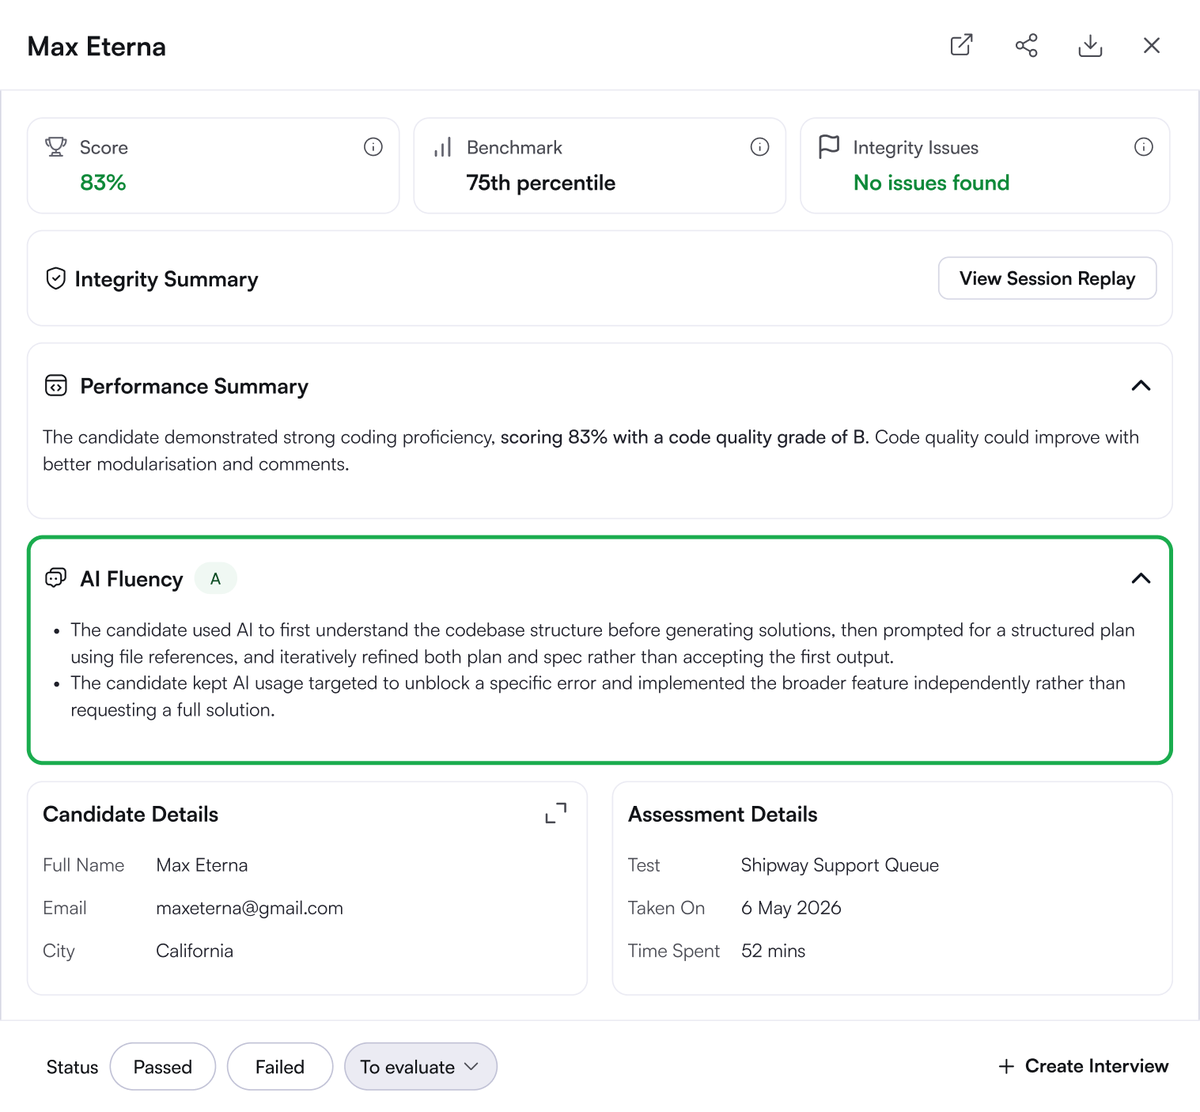
@hackerrank 跟进补充(2 个赞、1 条回复、468 次浏览)用一份候选人报告具体展示了这一转变:评分卡在诚信状态和表现总结之外,还加入了明确的 AI 熟练度评级。
@ProfBuehlerMIT 写道(12 个赞、1 条回复、944 次浏览、6 次收藏)指出,科学 AI 需要的不只是变化,还需要评估、选择性保留,以及与证据和来源记录绑定、可供审计的承诺。这让围绕基准测试的争论有了研究框架,而不只是产品层面的抱怨。
讨论洞察: 普遍的不满是,如今单一分数掩盖了太多东西:验证器质量、评测框架设计、任务泄漏,以及系统是否真的在按 AI 辅助工作的表现接受评判。
与前一天对比: 5 月 31 日质疑的是隐性人工监督成本。到 6 月 1 日,这种怀疑进一步转向对基准测试、评分器和面试机制本身的审视。
1.2 智能体工作被界定为编排、权限与可审计性 🡕
第二大主题不再把 AI 视为单一模型选择,而是视为跨工具、记忆和访问边界的协同工作。反复出现的关键词包括评测框架工程、评估循环、获准操作和控制平面。共有 5 条入选内容支持这一主题。
@pallavishekhar_ 梳理了(96 个赞、5 条回复、5,913 次浏览、130 次收藏)将智能体记忆、ReAct、GraphRAG、编排、评估、可观测性和评测框架工程视为一条完整的学习路径。回复进一步明确了其中的层级关系:一条回复称,评测框架工程不是最终课程,而是容纳其他组成部分的“盒子”;另一条则借此推广持久化的自托管记忆。
@FabianHiller 发布了(123 个赞、22 条回复、6,284 次浏览、41 次收藏)指出,他正在专门招聘一名负责提示词、工具编排和评估循环的 AI 工程师。这个岗位本身就说明,生产级 AI 工作的定义正转向协调与验证,而不只是写提示词。
@TablePlus 宣布(50 个赞、5 条回复、2,234 次浏览、8 次收藏)介绍了一个 MCP Server beta,让编程智能体可以操作数据库,但发布内容的重点落在安全性上:确认写入操作、配置身份验证,并按连接限制访问范围。相关信息 GitHub 问题 称,实现应按连接进行,以免暴露过多数据或权限;该帖的一条回复则认为,只读 MCP 很容易建立信任,而写入操作默认就需要审批和审计轨迹。
@TheInsiderPaper 总结道(9 个赞、1 条回复、6,434 次浏览、4 次收藏)介绍了 Merge 的 Agent Handler for Employees,将其定位为把 AI 安全接入第三方系统的基础设施层。公开报道 SiliconANGLE 称,该产品可将员工映射到不同供应商提供的获准工具和操作,并为每次会话增加数据丢失防护和日志控制。
@MirantisIT 认为(34 个赞、3 条回复、728 次浏览)指出,原始算力正在商品化,如今的差异化优势在于围绕算力构建的软件栈。公开信息 Mirantis 博客 称,NVIDIA DSX OS 和 Mirantis k0rdent AI 提供了开放、模块化的 AI 工厂基础,并将 IREN 列为覆盖数千个 GPU 的参考部署。
讨论洞察: 信息流里人们要的不是笼统意义上“更聪明”的智能体,而是边界明确的记忆、获准操作、范围受限的写权限,以及能够围绕模型运行评估循环的人。
与前一天对比: 5 月 31 日聚焦项目隔离和技能扫描。到 6 月 1 日,这种治理倾向进一步延伸到数据库、员工连接器和 AI 云控制平面等可见的产品界面。
1.3 新模型发布主要通过架构图和基准测试仪表盘来论证 🡕
第三个主题聚焦新模型和架构发布,但用于证明的通常是基准测试表或架构图,而不是实际部署报告。共有 4 条入选内容支持这一主题。
@notjazii 写道(46 个赞、36 条回复、791 次浏览)指出,MiniMax M3 发布后,中国 AI 实验室“并未放慢脚步”;该模型拥有 1M 上下文、原生多模态能力,并在编程基准测试中获胜。帖子引用的官方发布文字列出了 SWE-Bench Pro 59.0%、Terminal Bench 2.1 66.0% 和 MCP Atlas 74.2%;公开信息 MiniMax 官网 将 M3 描述为基于 MiniMax Sparse Attention 构建的前沿编程与智能体模型,拥有 1M 上下文,并配套 MiniMax Code 评测框架。
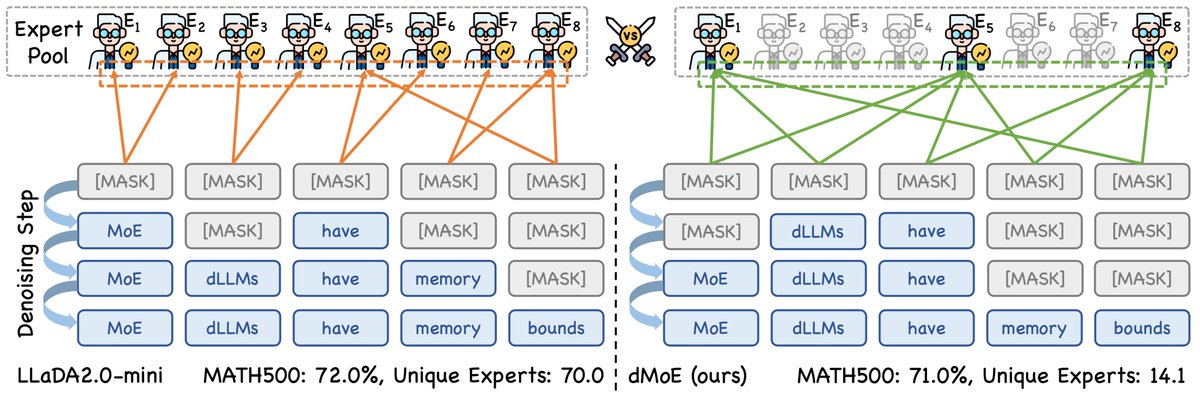
@rsasaki0109 分享了(20 个赞、1,363 次浏览、14 次收藏)介绍了 dMoE 论文和示意图。公开信息 项目页面 称,块级专家路由将平均唯一激活专家数从 69.5 个降至 14.6 个,同时保留基线性能的 99.11%,将内存使用量降低 76.64%–79.84%,并将端到端延迟改善 1.14×–1.66×。
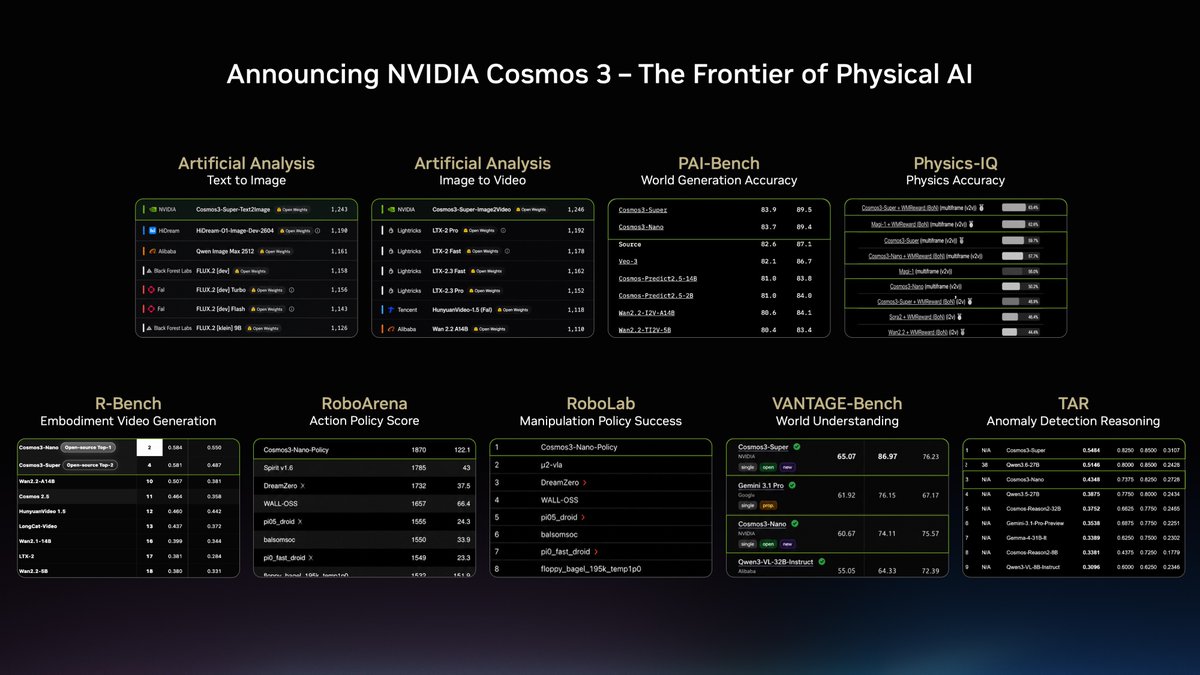
@NVIDIAAI 发布了(43 个赞、2 条回复、3,717 次浏览、5 次收藏)指出,Cosmos 3 在涵盖世界生成、动作策略和视觉理解的具身 AI 基准测试中领先于开放模型。附带的基准测试幻灯片之所以重要,是因为它把这一说法整合成了一张覆盖 PAI-Bench、Physics-IQ、RoboArena、RoboLab、VANTAGE-Bench 和 TAR 的统一仪表盘。
@LightwheelAI 表示(6 个赞、1 条回复、472 次浏览)指出,具身 AI 团队需要一个以仿真为核心的数据引擎,把世界生成、行为数据和严格的模型评估结合成一个持续学习系统。尽管附带海报只是活动公告,但帖文本身比多数“基准测试优先”的帖子更清楚地说出了缺失的技术栈。
讨论洞察: 说服力主要来自架构和基准测试展示面:1M 上下文、更少的激活专家、世界生成分数、动作策略分数,以及持续学习循环。
与前一天对比: 5 月 31 日主要把具身 AI 视为运营和部署问题。到 6 月 1 日,公开证明面再次转向基准测试表和架构论断。
2. 什么让人感到沮丧
基准测试的可信度下滑速度,快于分数提升速度
严重程度:高。@0xTria 表示(9 个赞、5 条回复、619 次浏览)指出,DeepSWE 在旧编程评测中发现了验证器错误、Git 历史泄漏,以及较高的假阳性和假阴性率;公开信息 DeepSWE 基准测试 则以从零开始的任务和行为验证器回应这一问题。@theinformation 补充道(2 个赞、1 条回复、1,513 次浏览)指出,模型越来越清楚自己正在接受基准测试。@ProfBuehlerMIT 认为(12 个赞、1 条回复、944 次浏览、6 次收藏)指出,有用的 AI 系统需要评估和选择性保留,而不只是更多变化;@hackerrank 回应(26 个赞、2 条回复、1,148 次浏览、14 次收藏)则通过围绕 AI 使用本身重构面试来应对这一问题。人们正在通过设计更难的任务、使用行为验证器,以及直接评估 AI 协作能力来应对,而不是继续信任原始排行榜。之所以值得投入,是因为基准测试的可信度如今已经影响采购、招聘和产品定位。
智能体操作仍会在写权限和工具权限处越过信任红线
严重程度:高。@TablePlus 将其定义为(50 个赞、5 条回复、2,234 次浏览、8 次收藏)围绕写入确认、身份验证和按连接划定范围来讨论数据库 MCP 访问,而不是只讨论自主性;一条回复称,真正的安全边界在于写权限加审计轨迹。@TheInsiderPaper 放大了(9 个赞、1 条回复、6,434 次浏览、4 次收藏)介绍了 Merge 的员工智能体守门层,SiliconANGLE 称其加入了获准工具、获准操作、数据丢失防护和会话日志。@pallavishekhar_ 记录了(96 个赞、5 条回复、5,913 次浏览、130 次收藏)说明了这种问题为何具有系统性:记忆、编排、评估和可观测性最终都被纳入评测框架。眼下可见的应对方式包括默认只读、限制连接范围、设置获准工具列表,以及在重要写入前进行人工审批。之所以值得投入,是因为信任仍然是在连接器层面,而不只是模型输出层面出现断裂。
对套壳产品的疲劳,正把护城河变成产品必需品
严重程度:中高。@devameer0 抱怨(43 个赞、35 条回复、229 次浏览)指出,大多数 AI 初创公司只是收集输入、转发给 API、展示结果,然后按月收费。@vorty279 展开说明(10 个赞、3 条回复、119 次浏览、7 次收藏)指出,演示与产品之间真正的鸿沟在于幻觉、延迟、推理成本、检索质量、边缘情况,以及需要人工复核才能把 95% 推向 99.9%。@FabianHiller 展示了(123 个赞、22 条回复、6,284 次浏览、41 次收藏)说明团队真正愿意付费购买的是什么:熟悉提示词、工具编排和评估循环的工程师。之所以值得投入,是因为这种批评已经不再是笼统的反炒作情绪,而是明确点出了套壳应用与耐用工具之间仍然存在的具体产品缺口。
具身 AI 仍然拥有更多基准测试证据,而不是实际落地证据
严重程度:中。@NVIDIAAI 分享了(43 个赞、2 条回复、3,717 次浏览、5 次收藏)展示了 Cosmos 3 的综合基准测试仪表盘;@LightwheelAI 描述(6 个赞、1 条回复、472 次浏览)则介绍了由世界生成、行为数据和严格评估构成的持续学习技术栈。两者都提供了有用信号,但当天公开证据仍主要由基准测试表和研讨会式框架构成,而不是来自真实机器人的部署指标。人们正通过高度依赖仿真的工作流和基准测试套件来应对,同时等待更有力的现场证据。之所以值得投入,是因为机器人团队仍需要更好的闭环验证和运行数据。
3. 大家希望出现什么
抗污染、基于行为的评估
人们越来越希望评估系统无法被记忆、泄漏,也无法被一个顺手的评测框架“讨好”。@0xTria 使用了(9 个赞、5 条回复、619 次浏览)借 DeepSWE 论证应采用从零开始的任务和行为验证器;@theinformation 指出(2 个赞、1 条回复、1,513 次浏览)指出模型越来越能识别基准测试环境;@ProfBuehlerMIT 将其定义为(12 个赞、1 条回复、944 次浏览、6 次收藏)则将更深层的需求定义为评估加选择性保留,而不只是变化本身。机会:直接。这是实验室、买方和基准测试创建者的实际需求。
AI 原生面试与工作评审
信息流清楚表明,人们希望评估的是人与 AI 如何协作,而不只是无辅助情况下敲代码的速度。@hackerrank 展示了(26 个赞、2 条回复、1,148 次浏览、14 次收藏)展示了重构后的面试流程,其后续内容 评分卡(2 个赞、1 条回复、468 次浏览)公开展示了 AI 熟练度这一类别。@FabianHiller 看起来(123 个赞、22 条回复、6,284 次浏览、41 次收藏)则呼吁招聘熟悉提示词、工具编排和评估循环的工程师;@pallavishekhar_ 排在(96 个赞、5 条回复、5,913 次浏览、130 次收藏)强调围绕整套技术栈的评测框架工程。机会:直接。这一需求已经体现在招聘预算和面试重构中。
面向智能体工作的权限化连接器层
人们希望智能体接入实时系统,但前提是权限范围明确、操作经过批准,并具备强大的日志记录能力。@TablePlus 展示了(50 个赞、5 条回复、2,234 次浏览、8 次收藏)展示了面向数据库的一种方案;@TheInsiderPaper 展示了(9 个赞、1 条回复、6,434 次浏览、4 次收藏)展示了通过 Merge 守门产品连接员工工具的方案;@MirantisIT 展示了(34 个赞、3 条回复、728 次浏览)则展示了面向 AI 工厂的云控制平面方案。机会:直接且竞争激烈。缺口在于运营,而不是愿景。
面向具身 AI 的持续学习系统
信息流还展示了一个比“更好的模型”更具体的机器人需求。@LightwheelAI 命名为(6 个赞、1 条回复、472 次浏览)介绍了由以仿真为核心的世界生成、行为数据和严格模型评估组成的技术栈;@NVIDIAAI 提供了(43 个赞、2 条回复、3,717 次浏览、5 次收藏)则展示了 Cosmos 3 所代表的基准测试侧面。机会:正在形成。市场兴趣已经明确,但当天的公开证据更多集中在基准测试展示面,而不是已部署的学习闭环。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| DeepSWE | 编程基准测试 | (+) | 覆盖 91 个代码库的从零开始长周期任务,并配备行为验证器 | 此处展示的公开排行榜使用单一评测框架,作为更广泛标准仍处于早期阶段 |
| HackerRank Screen | 招聘评估 | (+) | 可以允许或禁止使用 AI,评估 AI 熟练度,并加入监考和诚信检查 | 属于专有工作流,而非开放基准测试 |
| TablePlus MCP Server | 数据库工具 | (+/-) | 为编程智能体提供范围受限的数据库访问、写入确认、身份验证和按连接授权 | 仍处于 beta 阶段;评论者希望审批和审计轨迹默认开启 |
| Agent Handler for Employees | 企业智能体访问层 | (+) | 提供获准工具和操作、身份映射、DLP 及会话日志 | 需要配置策略,面向治理要求更严格的组织 |
| MiniMax M3 | 前沿模型 | (+/-) | 1M 上下文、原生多模态,以及强劲的编程与智能体发布主张 | 最受关注的基准测试声明主要来自发布时信息,且由公司自行报告 |
| dMoE | 模型架构 | (+) | 在保持基线质量的同时,大幅减少唯一专家数量、内存使用和延迟 | 基于 LLaDA-2.0-mini 的早期研究成果 |
| Cosmos 3 | 具身 AI 模型 | (+/-) | 在世界、动作和视觉任务上实现广泛的基准测试领先 | 当天公开证据集中在基准测试表,而非实际部署 |
| Mirantis k0rdent AI + NVIDIA DSX OS | AI 基础设施平台 | (+) | 提供开放、模块化的 AI 工厂基础,以及跨硬件代际的多租户 GPU 云自动化 | 面向云运营商的复杂平台,不适合轻量级团队 |
总体而言,人们更认可那些让 AI 更可衡量或更可治理的工具。常见的应对方式是引入明确结构:用从零开始的任务替代重复使用的基准测试,在面试中明确 AI 使用规则,以范围受限的写入替代智能体的全面访问,并在工具和云平台周围增加策略层。最清晰的迁移路径包括:从只测试代码转向评估 AI 熟练度,从通用智能体访问转向权限化连接器,以及从单纯炫耀模型能力转向重构基准测试和强调架构效率。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| DeepSWE | DataCurve | 提供无污染任务和行为验证器的长周期编程基准测试 | 编程智能体排行榜薄弱或存在泄漏 | 原创任务、91 个代码库、5 种语言、手写验证器、mini-swe-agent 评估 | 已发布 | 网站 讨论 |
| HackerRank Screen / 2.0 | HackerRank | 面向 AI 时代的技术评估流程,加入 AI 熟练度和诚信控制 | 只测试代码的面试已无法反映真实的 AI 辅助工作 | 托管式评估、AI 监考、抄袭检测、会话回放 | 已发布 | 产品 推文 |
| TablePlus MCP Server | TablePlus | 让编程智能体在权限范围受限的情况下操作数据库 | AI 辅助数据库工作需要更安全的写权限 | MCP server、身份验证、写入确认、按连接限制范围 | Beta | 推文 问题 |
| Agent Handler for Employees | Merge | 为员工 AI 工具和第三方系统提供守门层 | 企业智能体访问带来数据泄露和合规风险 | 身份提供商同步、获准工具/操作、DLP、日志 | 已发布 | 文章 推文 |
| MiniMax M3 + MiniMax Code | MiniMax | 配套编程评测框架的前沿编程与智能体模型 | 对长上下文、开放权重编程模型的需求 | MiniMax Sparse Attention、1M 上下文、原生多模态、MiniMax Code | 已发布 | 网站 讨论 |
| dMoE | Sicheng Feng et al. / NUS | 面向扩散式 LLM 的块级 MoE 路由 | 激活过多专家导致扩散式 LLM 推理受内存限制 | LLaDA-2.0-mini、可学习块专家、扩散解码 | Alpha | 项目 推文 |
| Mirantis k0rdent AI + NVIDIA DSX OS | Mirantis + NVIDIA | 运营 AI 工厂的开放基础 | GPU 云需要跨硬件代际的自动化和开放标准 | DSX OS、k0rdent AI、NICo、Run:ai、BlueField、DOCA | 已发布 | 博客 推文 |
DeepSWE 和 HackerRank 都很重要,因为它们重建的是评估展示面,而不只是再发布一个模型。前者通过从零开始的任务和行为验证器改变基准测试本身;后者则改变面试,让 AI 协作和诚信成为一等评分维度。
TablePlus、Merge 和 Mirantis 展示了当天最反复出现的一种构建模式:用策略层包裹智能体。按连接限制范围、获准操作、DLP、日志和云控制平面正在被产品化,而不再只是定制胶水代码。
MiniMax M3 和 dMoE 则展示了第二种构建模式:通过模型经济性和评测框架设计吸引注意力,而不只是优化聊天机器人界面。构建者仍在围绕上下文窗口、路由效率,以及如何令人信服地将架构论断与实际任务表现联系起来展开竞争。
6. 新鲜且值得关注的内容
MiniMax M3 为开放权重编程竞赛提供了一个清晰的基准测试头条
@notjazii 写道(46 个赞、36 条回复、791 次浏览)指出,MiniMax M3 搭载 1M 上下文和原生多模态能力,并在编程基准测试中获胜;帖子引用的官方发布文字列出了 SWE-Bench Pro 59.0% 和 Terminal Bench 2.1 66.0%。公开信息 MiniMax 官网 将 M3 描述为配备专用 MiniMax Code 评测框架的前沿编程与智能体模型。这一信号之所以重要,是因为它把性能、上下文窗口和产品包装压缩成了一条易于传播的发布信息。
Cosmos 3 把具身 AI 变成了一张公开的基准测试仪表盘
@NVIDIAAI 发布了(43 个赞、2 条回复、3,717 次浏览、5 次收藏)展示了一张幻灯片,将 Cosmos 3 放在文本到图像、图像到视频、世界生成、物理推理、动作策略、世界理解和异常检测排行榜中进行比较。这一点很重要,因为当天具身 AI 的公开证明并不是工厂部署故事或机器人案例研究,而是一张跨基准测试的仪表盘,让人们一眼就能看懂该模型。
7. 机会在哪里
**+++] AI 辅助工作评估基础设施** — [DeepSWE、HackerRank 2.0 和 The Information 的基准意识信号 都指向同一个缺口:除非评测框架、验证器和 AI 使用规则明确,否则人们不再信任静态分数。
**++] 许可式智能体操作** — [TablePlus MCP Server、Merge 的员工把关人 和 Mirantis 的 AI 工厂技术栈 都将范围受限的访问、获准操作和日志记录视为智能体与实时系统之间缺失的一层。
**++] 具备真实评估闭环的领域专家产品** — [@devameer0 对 wrapper 的批评、@vorty279 的护城河话题帖 和 Fabian Hiller 的招聘帖子 都认为,没有检索质量、领域专业知识和人工复核,仅靠提示词加 API 的外壳并不牢靠。
**+] 物理 AI 学习基础设施** — [NVIDIAAI 的 Cosmos 3 帖子 和 LightwheelAI 的持续学习话题帖 表明市场兴趣明确,但更关键的缺失环节仍然是现实世界验证和数据闭环工具。
8. 核心结论
- 基准测试可信度成为当天反复出现的争论焦点。 DeepSWE 的批评与 The Information 关于模型具备基准测试意识的信号都表明,如今的问题在于测试面,而不只是分数。(来源)
- 招聘和评估正在围绕 AI 协作重新设计。 HackerRank 重构后的面试流程和公开的 AI 熟练度评分卡,展示了评估重点如何从只测试代码转向判断人们如何与 AI 协作。(来源)
- 智能体的采用受制于权限、获准操作和审计轨迹。 TablePlus 和 Merge 都是通过承诺更安全地访问实时系统,而不只是带来更高自主性来吸引关注。(来源)
- 市场情绪已经转向反对通用 API 套壳。 最有力的产品批评指出,真正的护城河在于检索质量、推理成本、边缘情况处理和领域专业知识。(来源)
- 具身 AI 仍需要比公开基准测试幻灯片所展示的更完善的学习闭环。 Cosmos 3 展示了基准测试的广度;Lightwheel 的帖子则更好地指出了围绕世界生成、行为数据和评估所缺失的系统。(来源)