Twitter AI - 2026-06-15
1. 人们在讨论什么
1.1 基准测试的真实性与训练经验变得更坦诚(🡕)
最强的技术讨论焦点并不是新模型发布,而是人们开始更坦率地讨论前沿系统究竟如何调优和评估:依赖缩放定律,而不是整齐划一的配方;使用大规模评测矩阵,而不是少数精心挑选的测试;以及面对后来显得站不住脚的基准测试炒作时,公开流露出的尴尬。三个高信号条目都指向同一个变化:从包装精致的分数,转向真实的运营实践。
@yacineMTB 提问(579 个赞、53 条回复、52,581 次浏览、236 次收藏)讨论了团队如何为大语言模型训练选择超参数,以及 muP 或学习率衰减是否仍然重要。最有实质内容的回复认为,实验室通常会先在较小规模的训练中拟合 batch size 和学习率的缩放定律,然后接受受硬件约束的临界 batch size 权衡,而不是追求某个完美最优点;至于 muP,则仍被视为一个开放问题,而不是已经定型的方法。
@edzitron 认为(506 个赞、5 条回复、20,905 次浏览、42 次收藏)认为,一位此前因 AI 基准测试而走红的人物,本应让那些为其推波助澜的媒体和评论者感到难堪。这里的重点不只是最初的丑闻,更是围绕它形成的氛围:人们普遍认同,基准测试的传播热度与其可信度并不是一回事。
@clairevo 写道(26 个赞、5 条回复、5,549 次浏览、30 次收藏)介绍了 Braintrust 如何使用编程代理对数据库系统运行大规模基准测试矩阵,再把优秀工程师的“感觉检查”转化为评分函数。她的表述明确点出了运营层面的落差:过去,广泛验证技术假设的成本太高,因此团队往往只能退而求其次,做一两次人工检查。
讨论洞察: 回复并没有否定评测本身,而是在不断把“真相来源”从整齐的公开排行榜,移向缩放定律启发式、私有测试矩阵和人工审查闭环。
与前一天的对比: 6 月 12 日的重点是构建更真实的基准测试。到 6 月 15 日,讨论又往前推进了一步,变成运营者更坦率地谈论:基准测试有多容易被过拟合、被操纵,或最终被压缩成少数几个可信的内部检查。
1.2 推理效率与本地部署从理论走向具体数字(🡕)
第二个密集讨论集群聚焦于具体的吞吐量、功耗和硬件适配证据。人们不再笼统地声称推理成本正在下降,而是分享图表、基准测试和桌面实验,试图准确说明性能提升来自哪里,以及哪些环节仍会出问题。
@NielsRogge 解释(72 个赞、1 条回复、4,567 次浏览、63 次收藏)通过引用 LMSYS 发布 DFlash 的消息讨论了推测解码。相关公开文章称,DFlash 在 SGLang 的 Spec V2 流程中使用基于块扩散的 drafter,并注入 KV;在 HumanEval 上,Qwen 3.5 397B-A17B 配置在并发数为 1 时,吞吐量达到基线的 4.3 倍以上,以及原生 MTP 吞吐量的 1.5 倍(LMSYS 博客、SGLang 文档)。

@sudoingX 报道称(73 个赞、11 条回复、4,017 次浏览、24 次收藏)介绍了在配备 128 GB 统一内存的 AMD Strix Halo 设备上本地运行开放权重模型 Nex-N2-Pro 397B-A17B,速度约为每秒 18 个 token。回复补上了缺失的现实检验:IQ1_M 只是较粗糙的量化,ROCm 和内核支持仍在追赶,而且后续回复还上调了 128 GB 配置的价格。
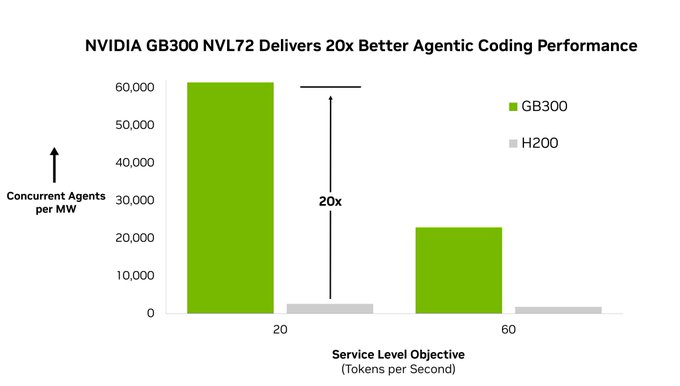
@NVIDIAAP 报道称(9 个赞、1 条回复、212 次浏览)介绍了 AgentPerf 的发布。它是一项围绕真实编程代理轨迹构建的基准测试,而不是单轮聊天测试。NVIDIA 的公开文章称,该测试通过模拟工具调用来隔离计算性能;在所测试的工作负载中,GB300 NVL72 每兆瓦可处理的并发代理数量最高达到 H200 的 20 倍(NVIDIA 博客)。
@Cikyyy2 分享(8 个赞、393 次浏览、11 次收藏)介绍了 slopsome,这是一个面向本地模型的公开适配与基准测试工具,重点展示 319 个模型配置、用户提交的每秒 token 数据,以及本地部署与 API 调用之间的成本对比(slopsome)。

讨论洞察: 人们确实关注本地化和高效推理,但回复立刻质疑了供应商式定价、驱动成熟度和量化质量方面的说法。社区想要的是可复现的测量结果,而不只是截图。
与前一天的对比: 6 月 13 日强调成本感知型路由和嵌入式工作流。到 6 月 15 日,同样的关切已经落实到硬件、吞吐量和适配规划这些具体数字上。
1.3 构建者深入研究代理原语:事实落地、记忆与可验证执行(🡕)
最强的构建者信号位于应用层之下。值得关注的项目不再是又一个 AI 封装层,而是直接攻向更棘手的基础设施问题:如何让事实保持可审计,如何让记忆在推理过程中适应变化,如何让 harness 自我改进,以及如何验证推理而不是盲目信任结果。
@OpenBMB 介绍(3 个赞、95 次浏览)介绍了 FactNet,作为对一个落地三难困境的回应:真实性、规模和结构,在当前事实资源中很少能同时具备。公开仓库称,该项目基于 Wikidata 和 Wikipedia 构建了一个三层图谱;推文则称,这次发布包含 17 亿条断言、30.1 亿个证据片段,以及面向知识图谱补全、多语言问答和多语言事实核查的基准构建工具(论文、代码库)。

@RituWithAI 认为(8 个赞、3 条回复、83 次浏览、6 次收藏)认为,大多数代理记忆系统建立在错误的假设之上:先检索,后推理。相关 MRAgent 论文称,其 Cue-Tag-Content 图和主动重构循环,使 LoCoMo 和 LongMemEval 的表现最高提升 23%,同时降低 token 和运行时成本(论文、代码库)。

@jiqizhixin 报道称(12 个赞、2 条回复、766 次浏览、6 次收藏)介绍了小米 Darwin Agent Team 构建的 HarnessX。这是一个能够组合、适配并演化提示词、工具、记忆和控制流的 harness 工坊。公开仓库说得更直接:行为切换仍然代价高昂,因此 HarnessX 将模型配置与 harness 分离,并通过基于轨迹的演化持续改进整个技术栈(论文、代码库)。

@Shaughnessy119 认为(11 个赞、1 条回复、2,622 次浏览、11 次收藏)认为,开放权重模型仍然需要开放的服务层,并将 Ambient 定位为一个可验证推理市场,而不只是另一个模型端点。Ambient 官网称,其 Proof of Logits 系统可以验证参数规模超过 600B 的模型推理;Ambient Desktop 则将这一理念转化为本地优先的工作站,提供项目看板、可恢复任务和清晰可见的提供方回退机制(Ambient、Ambient Desktop)。

讨论洞察: 最具野心的构建工作都位于 UI 层之下。团队没有继续发布又一个聊天封装层,而是在持续构建溯源、记忆、harness 和服务层原语。
与前一天的对比: 6 月 9 日至 11 日强调 harness 和受治理的代理产品。到 6 月 15 日,讨论进一步深入到这些系统仍然欠缺的部分:字节级证据、重构式记忆、harness 演化和可验证推理。
2. 什么让人感到沮丧
基准测试的可信度仍然依赖运营者的默会知识
严重程度:高。@yacineMTB 提问(579 个赞、53 条回复、52,581 次浏览、236 次收藏)提出了有关大模型超参数选择的基础性问题,而最好的答案来自对缩放定律、临界 batch size 和尚未解决的 muP 权衡的讨论,而不是一份清晰的公开操作手册。@clairevo 写道(26 个赞、5 条回复、5,549 次浏览、30 次收藏)指出,顶尖团队如今可以利用编程代理对大规模基准测试矩阵进行暴力穷举,但最终仍把工程师的感觉检查当作评分金标准。@edzitron 认为(506 个赞、5 条回复、20,905 次浏览、42 次收藏)认为,基准测试的传播热度本应让推广它的人感到难堪。常见的应对方式是私有评测、运营者启发式和人工审核。之所以值得围绕这一问题构建产品,是因为这种挫败感反复出现在训练、产品评估和公众可信度等多个环节。
本地 AI 仍然存在“能跑起来”和“真正可用”之间的鸿沟
严重程度:高。@sudoingX 报道称(73 个赞、11 条回复、4,017 次浏览、24 次收藏)展示了在 AMD Strix Halo 上本地运行 397B 模型的案例,但回复很快暴露出痛点:驱动支持粗糙、低比特量化质量存疑,以及硬件价格本身需要修正。@Cikyyy2 分享(8 个赞、393 次浏览、11 次收藏)之所以受到关注,正是因为人们在下载任何东西之前,需要 VRAM 适配计算器、真实用户的每秒 token 基准数据,以及本地部署与 API 调用的成本对比。更成熟的应对模式出现在 @sabir_huss50540 推广(9 个赞、6 条回复、327 次浏览)所提到的 Open WebUI:当本地技术栈真正跑通之后,它就是自托管层;公开仓库也确认了其本地 RAG、多提供方支持和角色控制能力(代码库)。之所以值得围绕这一问题构建产品,是因为人们对私有化和本地推理的兴趣显而易见,但从基准测试截图走向可靠部署的过程仍然过于脆弱。
静态检索与薄弱的事实落地仍会拖垮长程代理
严重程度:高。@OpenBMB 介绍(3 个赞、95 次浏览)通过明确点名问题介绍了 FactNet:当前事实资源迫使人们在真实性、规模和结构之间做取舍。公开仓库确认,FactNet 给出的回应是一个有据可查的多语言图谱,以及面向 KGC、MKQA 和 MFC 的基准构建工具(代码库)。@RituWithAI 认为(8 个赞、3 条回复、83 次浏览、6 次收藏)指出,如今的记忆增强型代理都会先检索再推理,导致上下文过早固化;MRAgent 摘要称,其重构式记忆循环使 LoCoMo 和 LongMemEval 的表现最高提升 23%,同时降低 token 和运行时成本(论文)。之所以值得围绕这一问题构建产品,是因为这两篇帖子都描述了当前代理系统中的具体失效模式,并提供了直接、开放的技术产物,而不是泛泛而谈的抱怨。
3. 人们希望存在什么
能暴露自身假设、且可重复运行的评测与训练系统
最强的实际需求并不是再多一个排行榜,而是让隐藏的判断层变得可见的工具。@yacineMTB 提问(579 个赞、53 条回复、52,581 次浏览、236 次收藏)提出了一些本应有标准答案的问题;@clairevo 描述(26 个赞、5 条回复、5,549 次浏览、30 次收藏)则展示了团队如何暴力跑基准测试矩阵,再将专家的感觉检查扩展成评分函数。@edzitron 记录(506 个赞、5 条回复、20,905 次浏览、42 次收藏)指出,当公开的基准测试说法跑在可信度前面时,会带来明确的社会成本。这是实验室和产品团队都有明确买家的实际需求。机会:直接。
诚实的本地 AI 规划与私有技术栈部署工具
人们显然愿意在本地运行更多推理任务,但仍需要帮助来判断哪些方案真的装得下、跑得动、稳得住。@Cikyyy2 分享(8 个赞、393 次浏览、11 次收藏)展示了 slopsome,既是适配计算器,也是基准测试层;@sudoingX 展示(73 个赞、11 条回复、4,017 次浏览、24 次收藏)则表明,即使成功在本地运行 397B 模型,人们仍会质疑量化质量、驱动支持和真实硬件价格。@sabir_huss50540 推广 提到了 Open WebUI:当技术栈跑起来之后,它可以作为保护隐私的交互界面。这是具有即时效用的实际需求,但市场竞争会很激烈,因为基准测试网站、本地运行时和自托管界面都可能切入这一领域。机会:竞争激烈。
面向长时运行代理的重构式记忆层
@RituWithAI 认为 指出,当前记忆系统检索过早,无法在出现新证据后重新适应;而 MRAgent 论文称,Cue-Tag-Content 图加主动重构机制,能够让长记忆基准测试表现最高提升 23%(论文)。这不是推测性需求,而是实际需求:代理构建者已经遇到了这一失效模式,而提出的修复方案也具体到足以做基准测试。机会:直接。
可审计的事实落地层与可验证推理层
数据集显示,人们同时需要两类信任基础设施。@OpenBMB 介绍 介绍了 FactNet,旨在将事实陈述绑定到多语言、字节级证据;@Shaughnessy119 认为 则指出,开放模型仍然需要一个用户可以验证、而不只是被迫信任的服务层。Ambient 的公开材料明确把 Proof of Logits 推理和可审查的本地优先工作站作为答案(Ambient、Ambient Desktop)。这是实际的基础设施需求,但竞争会很激烈,因为提供方、开源技术栈和区块链式网络都在从不同方向争夺这一领域。机会:竞争激烈。
4. 正在使用的工具与方法
| 工具 | 类别 | 评价 | 优势 | 局限 |
|---|---|---|---|---|
| DFlash + Spec V2 | 推理引擎 | (+) | 并行块起草、KV 注入,以及在 SGLang 中带来显著吞吐量提升 | 需要专用 draft checkpoint 和前沿模型服务基础设施 |
| AgentPerf | 代理基准测试 | (+/-) | 衡量串联式编程代理工作负载和每兆瓦可运行的代理数量,而不是单条提示词 | 基准测试仍处于早期;工具调用是模拟的,首轮结果也被供应商大力放大 |
| llama.cpp + ROCm/Vulkan on AMD Strix Halo | 本地推理技术栈 | (+/-) | 让大规模统一内存本地运行成为可能,包括前沿规模的量化模型 | 配置过程粗糙、价格需要修正,低比特量化质量仍令人担忧 |
| slopsome | 部署规划工具 | (+) | 将 VRAM 适配、社区基准数据和本地部署与 API 调用成本对比整合在一起 | 依赖用户提交的数据,无法解决运行时和驱动问题 |
| Open WebUI | 自托管 AI 界面 | (+) | 私有本地聊天、RAG、多提供方支持和管理控制 | 用户需要自行运行模型和基础设施 |
| FactNet | 事实落地数据集 / 知识图谱 | (+) | 提供可审计的多语言证据,以及用于事实评估的公开基准构建工具 | 研究流程复杂,不是开箱即用的产品层 |
| MRAgent | 代理记忆框架 | (+) | 动态重构式记忆以更低的 token 和运行时成本改善长上下文推理 | 研究阶段的复杂度高于简单的“先检索、再推理”流程 |
| HarnessX | 代理框架 | (+) | 模块化行为组合,以及基于轨迹的 harness 演化 | 仍处于 Beta 阶段,还需要在真实生产工作负载中证明自己 |
| Ambient + Ambient Desktop | 可验证推理 / 工作站 | (+/-) | 可审计性、持久化任务,以及为开放模型服务和可审查工作提供了具体方案 | 产品和网络仍处于早期,其协作模式也仍在验证中 |
当工具能够让约束变得可测量,而不是将其隐藏起来时,整体满意度最高。DFlash、AgentPerf、slopsome 和 Open WebUI 都受到关注,是因为它们让吞吐量、硬件适配、隐私或成本变得清晰可见,而不是停留在抽象层面。
最明显的迁移趋势,是从静态检索、基准测试截图和对纯 API 的依赖转向其他方案。数据集显示,取而代之的是重构式记忆、多语言证据落地、本地/私有技术栈,以及部署后仍能持续适应的 harness。竞争格局同时分裂为两个方向:本地/自托管技术栈与提供方托管生态之间的竞争,以及静态代理封装层与能够持续演化自身支架的系统之间的竞争。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| DFlash + Spec V2 | LMSYS、Z Lab、Modal 和 SGLang,由 @NielsRogge 分享 | 通过基于块扩散的起草和重叠调度,加速前沿模型推理 | 对大型模型而言,基线自回归解码浪费了过多吞吐量 | Qwen 3.5 397B-A17B、块扩散 drafter、KV 注入、SGLang 推测解码 | Beta | 推文、博客、文档 |
| FactNet | OpenBMB、TsinghuaNLP、TU Munich、Modelbest 和 Minzu University,由 @OpenBMB 分享 | 构建带有可审计字节级证据和基准生成器的多语言事实图谱 | 现有事实落地资源需要在真实性、规模和结构之间取舍 | Wikidata、Wikipedia、Elasticsearch、KGC/MKQA/MFC 基准构建工具 | Alpha | 推文、论文、代码库 |
| MRAgent | NUS 研究人员,由 @RituWithAI 分享 | 使用 Cue-Tag-Content 图和主动重构进行长程记忆推理 | 先检索后推理的记忆流程过早锁定了错误上下文 | 工具调用 LLM 循环、图记忆、LoCoMo 和 LongMemEval 评估 | Alpha | 推文、论文、代码库 |
| HarnessX | 小米 Darwin Agent Team,由 @jiqizhixin 分享 | 组合、适配和演化代理 harness,而不是针对每项任务手动重写 | 在编码、研究、记忆和防护机制之间切换行为的成本仍然很高 | Processor pipeline、模型路由、基于轨迹的 AEGIS 演化、基准反馈 | Beta | 推文、论文、代码库 |
| Ambient + Ambient Desktop | Ambient,由 @Shaughnessy119 讨论 | 主打可验证的开放模型推理,以及面向代理工作的持久化本地优先工作站 | 开放权重模型仍依赖不透明的服务层和脆弱的工作区工具 | Proof of Logits、开放模型服务市场、项目看板、提供方路由、本地桌面应用 | Beta | 推文、网站、桌面端代码库 |
| slopsome | slopsome,由 @Cikyyy2 分享 | 帮助用户估算哪些模型适合自己的硬件,并比较本地部署与 API 调用的经济性 | 不透明的显存、吞吐量和成本预期拖慢了本地 AI 的采用 | 模型/GPU 统计引擎、社区基准数据、VRAM 和成本计算器 | 已发布 | 推文、网站 |
DFlash 的突出之处在于,它把推测解码从论文概念变成了可以立即部署的服务策略。关键不只是被引用的 4.3 倍吞吐量数据,而在于公开博客和 SGLang 文档解释了块扩散 drafter 与重叠调度如何融入真实推理技术栈。
FactNet 和 MRAgent 从代理问题的两端解决信任问题。FactNet 通过明确的证据指针,让 316 种语言的事实落地具备可审计性;MRAgent 则试图修复记忆访问本身,让检索路径在推理过程中不断演化,而不是一开始就被冻结。HarnessX 位于两者之间,充当编排层,把模型周围的 harness 视为需要优化和再训练的对象。
Ambient 和 slopsome 解决的是开放模型与本地模型周围的采用问题。Ambient 试图让服务过程具备可审计性和持久性,而 slopsome 则帮助用户先回答一个更直接的问题:什么样的硬件、速度和价格区间,才能让本地推理真正变得现实。
6. 新鲜且值得关注的动态
推测解码有了具体的开源加速案例
DFlash 加 Spec V2 之所以重要,是因为当天的讨论没有止步于一条基准测试说法。@NielsRogge 提到 介绍了这一发布;相关 LMSYS 文章和 SGLang 文档也足够清楚地解释了其机制,使其他团队能够复现:在 397B 规模上使用块扩散起草、KV 注入和重叠调度(LMSYS 博客、SGLang 文档)。
事实落地与记忆成为代理基础设施的一等问题
FactNet 和 MRAgent 值得关注,是因为它们都将信任失效视为系统设计问题,而不是提示词问题。@OpenBMB 介绍 介绍了 FactNet:一个十亿级的多语言事实落地层,并提供公开的基准构建工具;@RituWithAI 重点介绍 则介绍了 MRAgent 的重构式记忆循环及其最高达 23% 的基准提升(FactNet 代码库、MRAgent 论文)。
本地与私有 AI 工具看起来不再边缘
397B 本地运行案例、公开的硬件适配计算器,以及高度自托管的聊天层结合起来,让本地 AI 看起来更像一个实际工作流问题,而不是爱好者的好奇尝试。@sudoingX 展示 介绍了前沿规模的本地运行,@Cikyyy2 分享 介绍了规划工具层,@sabir_huss50540 推广 则介绍了 Open WebUI 这一自托管界面层(Open WebUI 代码库)。
7. 机会在哪里
[+++] 可复现的前沿评测与训练运营 - yacineMTB、clairevo 和 edzitron 的帖子都指向同一个缺口:基准测试的可信度仍然依赖默会启发式、内部矩阵和人工审核者。若有产品能让这些假设变得明确且可审计,就能回应一个反复出现、且与预算直接相关的痛点。
[+++] 面向代理系统的事实落地、记忆与证据层 - FactNet 和 MRAgent 都在解决当前代理仍然存在的信任缺陷:溯源薄弱和检索僵化。这一机会很强,因为失效模式具体明确,公开研究产物也已经提出了可衡量的改进方法。
[++] 本地 AI 规划、基准测试与私有化用户体验 - sudoingX、slopsome 和 Open WebUI 展示了对本地/私有技术栈的真实需求,同时也揭示出当前路径在硬件适配、运行时质量和界面配置方面高度碎片化。市场需要的是让本地 AI 变得清晰可靠,而不只是勉强可用的产品。
[++] 可验证的开放模型服务 - Ambient 的核心观点是,开放权重模型需要可审计的服务层,而不仅是可下载的 checkpoint。这是一个中等机会,因为痛点真实存在,但解决方案空间已经十分拥挤,提供方平台、开源技术栈和加密网络实验都在其中竞争。
[+] 面向垂直领域代理的 harness 自动优化 - HarnessX 暗示了一种未来:围绕模型构建的 harness 可以根据轨迹持续适配和再训练。目前信号仍处于早期,但如果基准收益能在研究环境之外保持,这将成为专业代理的重要产品层。
8. 要点
- 6 月 15 日最强的 AI 讨论关乎可信度,而不是轰动效应。 最清晰的信号包括:公开寻求真实训练启发式、直言不讳地批评基准测试的传播热度,以及介绍团队如何利用编程代理扩展专家评估,而不是相信少数经过包装的分数。(来源、来源、来源)
- 推理进展越来越多地通过其他人可以检查的工程产物来论证。 DFlash 的公开博客和文档、AgentPerf 的方法说明,以及本地硬件适配工具,都将讨论推向吞吐量、功耗和可复现性,而不是泛泛声称“模型更快”。(来源、来源、来源)
- 可信代理如今更像是一个系统问题。 FactNet、MRAgent 和 HarnessX 分别从不同层面处理同一问题:事实溯源、适应性记忆,以及模型周围的 harness。(来源、来源、来源)
- 本地、私有和可验证的替代方案已经不再是小众话题。 当天的证据从 397B 本地运行,延伸到 Open WebUI 的自托管界面和 Ambient 对可审计服务的主张,表明摆脱提供方依赖正在成为真正的设计约束。(来源、来源、来源)