Twitter AI - 2026-06-18
1. 人们在讨论什么
1.1 模型访问正在变成一种治理产品(🡕)
最大的政策转向并不是某个新的基准分数,而是这样一种观念:如今,对前沿模型的访问需要正式评分、员工级控制和分层权限。四条彼此独立的帖子都支撑了同一个判断:强模型的访问权正被当作一种需要治理的资源,而不再是默认提供的 SaaS 权益。
@SophiaCai99 报道称(320 个赞、17 条回复、44,345 次浏览、82 次收藏)称,白宫和 Anthropic 正在就越狱制定一套正式的技术评估框架,包括用于衡量绕过严重程度、暴露能力和现实后果的通用基准。最强的信号不只是这项调查本身,更在于它正朝着一种可在未来事件中复用的方法论演进。
@shensi 表示(191 个赞、19 条回复、13,123 次浏览、56 次收藏)称,美国政府要求 Anthropic 切断外国公民对 Fable 5 和 Mythos 5 的访问,随后又在回复串中推介了基于员工属性的访问控制,把公民身份、角色、地点和团队都纳入权限判断。这让“模型治理”看起来不再是口号,而成了可操作的机制。
@HeyAnjula 认为(23 个赞、2 条回复、203 次浏览、5 次收藏)称,Anthropic 真正的故事是“同一个模型,不同级别的访问”:同一智能层级,不同权限。@robrombach 表示(76 个赞、7 条回复、7,202 次浏览、11 次收藏)向 G7 领导人表示,开放创新仍应是常态,但同时支持评估标准,以及针对易被滥用的视觉模型实施定向监管。
讨论洞察: 回复把白宫与 Anthropic 的故事类比成“越狱版 CVSS”,而开放模型阵营则认为,只靠压制的政策会把基础设施进一步集中到少数几家公司手中。
与前一天对比: 6 月 17 日已经出现了 G7 和司法部的信号。到了 6 月 18 日,具体机制变得更清晰:正式、可基准化的越狱评分,对外国公民的访问切断执行,以及产品化的权限分层。
1.2 评估进一步贴近真实工作流(🡒)
评估仍然是最主要的话题之一,但重心持续从通用排行榜转向那些会在生产环境中失效的工作流:语音代理的轮次切换、科学研究任务,以及冗长且噪声很多的医疗文件。共同趋势是,开放或半开放的测试框架开始衡量延迟、不确定性、工件和填充噪声,而不再只是单答案的问答题。
@livekit 宣布(57 个赞、12 条回复、2,175 次浏览、44 次收藏)介绍了 eot-bench:这是一个开放的回合结束基准,包含跨 14 种语言的 5,000+ 个真实人类到代理的对话轮次,提供实时排行榜,并公开延迟与误截断之间的权衡。配图显示,LiveKit Turn Detector v1 的误截断率为 9.9%,Deepgram Flux 为 12.9%,AssemblyAI 为 49.4%;这也解释了为什么该帖把时机判断定义为评估问题,而不只是模型问题。

@OpenAI 宣布(142 个赞、8 条回复、40,388 次浏览)介绍了 LifeSciBench:这是一项覆盖七类生命科学工作流的基准,目标包括证据处理、分析、设计与优化、科学推理、验证与运营、转化以及科学传播。OpenAI 的公开公告称,该基准包含 750 个专家编写任务、1,062 个工件和 19,020 条评分标准,而 GPT-Rosalind 目前也只能通过其中 36.1% 的任务(公告)。
@ArtificialAnlys 强调(70 个赞、2 条回复、5,662 次浏览、13 次收藏)介绍了 Wisedocs 面向长篇医疗与保险文件推出的新 MLCR 基准。其启动讨论串称,MLCR 包含 250 个问题,分为六个难度层级;开源了 10 个合成案例和较低的三个层级,并通过加入无关的填充上下文来模拟真实病历审阅,对模型进行压力测试(仓库)。
讨论洞察: 回复持续要求可复现性和运营中的边界情况——静音间隔、插话打断、隐藏二进制内容和真实工件——因此,愿意公开测试框架和数据集的评估,比只发布 headline 分数的评估更受认可。
与前一天对比: 6 月 17 日已经通过 LifeSciBench 和语音质量,明显押注基准测试。到了 6 月 18 日,这种压力继续存在,但进一步转向开放评估基础设施,以及噪声条件下长上下文稳健性的测试。
1.3 代理开发者关注的是控制平面,而不只是更聪明的模型(🡕)
最实用的开发者帖子谈的都是模型之外的东西:源代码管理、编排、审批、追踪和测试。它们共同表达了一个观点:通用代理已经有用,但真正的瓶颈在于如何安全、可重复地管理它们。
@_xjdr 写道(153 个赞、13 条回复、3,282 次浏览、67 次收藏)称,当团队在大型代码仓库上同时运行几十到上百个代理时,git、GitHub 和单模型编码 harness 已经变成两类主要的系统性风险。他们给出的答案是 NCode:浅层虚拟检出、JJ 草稿状态持久化、Sapling 提交栈、云同步、逐文件 ACL,以及围绕有边界工作区和云代理构建的终端 UI。

@praedico 开源了(16 个赞、52 次浏览、13 次收藏)介绍了 Arasaka,这是一个面向“受治理 AI 代理”的 Rust 运行时,把 LLM 输出视为提案而非权威。该运行时重点强调由策略门控的工具调用、审批检查点、可审计的 RunTrace 输出、具备租户感知能力的记忆,以及由 GraphRAG 支持的业务代理谱系追踪。
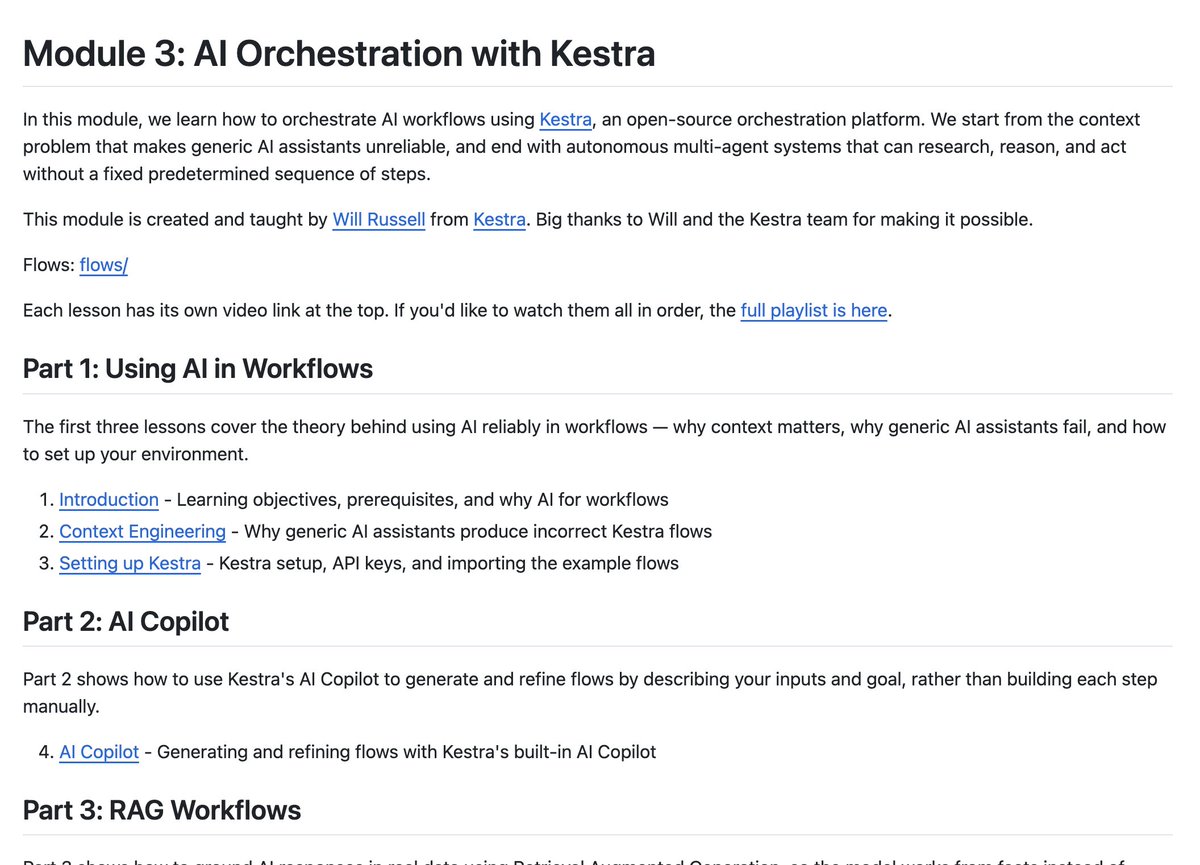
@Al_Grigor 表示(13 个赞、1 条回复、435 次浏览、8 次收藏)称,编排是从 notebook 演示走向真实 LLM 工作流之间缺失的一层。附带的 Zoomcamp 模块页面用 Kestra 把这一点具体化:步骤排序、状态传递、重试处理,以及让故障可观测,如今都已经成了教学内容,而不再是边缘问题。
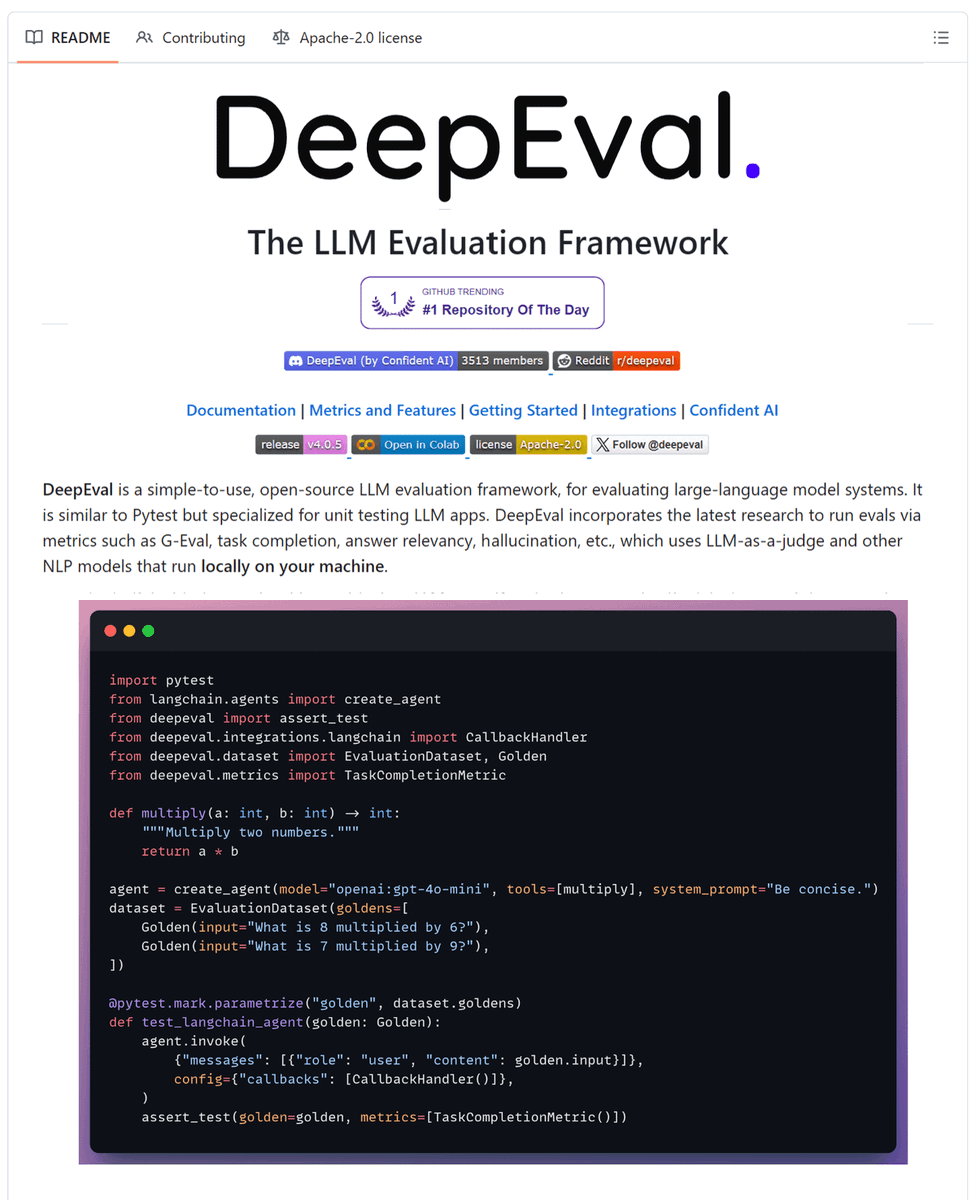
@Sumanth_077 展示了(9 个赞、2 条回复、144 次浏览、5 次收藏)介绍了 DeepEval 面向 LangChain 代理的 Pytest 风格集成,支持 CallbackHandler 追踪、端到端和组件级检查,以及 GitHub Actions 集成。截图进一步强化了这一趋势:代理测试 harness 正在被打包成更像传统软件工程工具的形态和体验(仓库)。
讨论洞察: 在这些帖子里,模型本身很少被当作完整解法。可靠性来自边界、重试、审计、追踪,以及更快协调大量代理的方式。
与前一天对比: 6 月 17 日强调的是医疗、机器人和宏观研究中的专用系统。到了 6 月 18 日,重心转向这些系统若要安全扩展运行所需的共用基础设施层。
2. 什么让人感到沮丧
前沿模型的访问可能因政策而消失或碎片化
严重程度:高。@shensi 表示(191 个赞、19 条回复、13,123 次浏览、56 次收藏)称,Anthropic 必须切断外国公民对 Fable 5 和 Mythos 5 的访问,而后续回复马上把这件事转成了基于员工属性的访问控制产品推介。@SophiaCai99 报道称(320 个赞、17 条回复、44,345 次浏览、82 次收藏)称,白宫和 Anthropic 现在正试图标准化越狱严重程度的评分方式。@HeyAnjula 认为(23 个赞、2 条回复、203 次浏览、5 次收藏)称,真正的变化不是模型更聪明了,而是权限管理更聪明了。当前浮现出的变通方案,是再叠加一层管理软件——基于属性的控制、可基准化的事件评分,以及带权限的产品分层——这值得投入,因为团队显然预期限制只会更多,不会更少。
一旦涉及大量代理,原生于 Git 的工作流就显得脆弱
严重程度:高。@_xjdr 写道(153 个赞、13 条回复、3,282 次浏览、67 次收藏)称,分支和 worktree 会变陈旧,评审逐渐偏离,大型仓库与环境配置会变成全职工作,而依赖单一模型加单一 harness 也会构成系统性风险。@Al_Grigor 表示(13 个赞、1 条回复、435 次浏览、8 次收藏)称,编排是 notebook 演示与真实工作流之间缺失的部分,因为生产系统需要有序步骤、重试、状态传递和可观测性。今天的应对策略是定制基础设施:浅层虚拟检出、云同步、逐文件 ACL 和编排层。这个方向值得投入,因为痛点出现得比模型失效更早;它出现在团队试图管理工作的时候。
团队仍然不信任代理的默认评估配置
严重程度:高。@livekit 表示(57 个赞、12 条回复、2,175 次浏览、44 次收藏)称,语音数据集是私有的,方法不透明,而且回合检测没有共享真值。@Sumanth_077 展示了(9 个赞、2 条回复、144 次浏览、5 次收藏)解释了为什么一旦 LangChain 风格代理混合使用 LLM、工具和检索,传统单元测试就会失效。OpenAI 公开发布的 LifeSciBench 公告则给出了最严峻的现实检验:即使是 GPT-Rosalind,也只能通过 750 个专家编写的生命科学任务中的 36.1%(公告)。团队目前的应对方式是开源 harness、发布排行榜,并把测试纳入 CI,因此这值得被当作核心基础设施来建设,而不是可有可无的研究项目。
敏感安全工作仍与云模型的隐私和双重用途风险相冲突
严重程度:中。@7h3h4ckv157 分享了(26 个赞、1,259 次浏览、18 次收藏)介绍了 Michos,这是一款通过 MCP 将 Ollama 托管模型连接到 Kali 的自动化渗透测试代理。公开 README 称,本地部署之所以重要,是因为客户数据、受监管环境和气隙系统都不能默认接受第三方处理;同时它也提醒,即使专有模型仍然领先,开放权重安全代理也已经足够强,值得认真对待(仓库)。当前的变通方案是本地或自托管模型部署,因此这值得投入,尤其是在安全团队需要可审计的自主能力、又不能把目标数据发给外部 API 的场景中。
3. 人们希望有哪些东西存在
可审计的模型权限和事件评分
人们似乎希望,模型访问权限能够按照角色、公民身份、任务和违规严重程度进行授予、收回和解释。@SophiaCai99 提出了建立正式越狱严重程度框架的推动力,@shensi 指向基于员工属性的控制,而 @HeyAnjula 则把新世界概括为一个模型、多个权限层级。这是一个有直接需求的现实问题。机会:直接。
超越 git 加临时脚本的代理原生工作区栈
@_xjdr 指出,git 和 GitHub 并不适合支撑几十到上百个同时运行的代理;@Al_Grigor 则把编排定义为从原型到工作流之间缺失的生产层。人们想要的不是另一个聊天窗,而是一个把状态、重试、评审边界和启动时间当作一等公民的运行时。机会:直接。
能承受现实噪声的共享评估系统
@livekit 呼吁在语音轮次切换上建立共同基础,@OpenAI 把评估推向研究工作流,@ArtificialAnlys 和 Wisedocs 测试了冗长且嘈杂的文件,而 @Sumanth_077 则把代理评估带进了 Pytest 和 CI。这个需求既实际又紧迫,因为团队已经不再信任私有或玩具级评估。机会:直接。
本地且受治理的安全代理
Michos 技术栈和 Arasaka 运行时都指向同一需求:代理要能在敏感环境中采取行动,同时又不能把模型当成最终权威。这意味着本地推理、审批门、审计轨迹、范围受限的工具,以及可逆操作。这个市场可能竞争激烈,但需求是明确的。机会:竞争性。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| eot-bench | 语音基准 | (+) | 5,000+ 个真实轮次、14 种语言、实时排行榜,以及直接展示延迟与截断阈值的权衡 | 一些回复仍质疑顶级本地模型配置是否容易复现 |
| LifeSciBench | 科学基准 | (+) | 覆盖七类工作流的 750 个专家编写任务,并采用重工件评分 | 目前公开披露的最佳模型也只能通过 36.1% 的任务 |
| MLCR | 长上下文基准 | (+) | 测试对填充噪声的韧性,包含六个难度层级、开放 harness 和合成案例 | 最难的保留层级仍未公开,初始用例也较窄 |
| DeepEval | 评估框架 | (+) | Pytest 风格的代理测试、本地指标、LangChain 追踪、CI 集成 | 仍依赖团队自行设计好数据集并选择正确指标 |
| NCode | 代理工作区 / SCM | (+/-) | 浅层检出、JJ 持久化、Sapling 栈、云代理、逐文件 ACL | 仍处于早期推出阶段,尚无广泛使用证据 |
| Arasaka | 受治理代理运行时 | (+) | 策略门控工具、审批检查点、可审计追踪、租户感知记忆 | 项目非常早期,公开采用信号有限 |
| Kestra | 编排平台 | (+) | 显式状态传递、重试、可观测性、工作流组合 | 这里的证据来自课程模块,而不是生产事故复盘 |
| Michos | 安全代理栈 | (+/-) | 本地隐私、通过 MCP 访问 Kali 工具、具体的进攻性工作流 | 属于敏感的双重用途领域,而且 README 仍称专有模型表现更好 |
总体来看,当某个工具把原本隐性的代理工作变成显性的基础设施时,整体情绪最积极。最清晰的迁移路径,是从“一个聊天窗口里的一个模型”走向分层技术栈:工作区或运行时、编排、评估,然后才是模型。
目前,治理运行时和评估工具的竞争压力看起来最强。数据还显示,本地安全栈正在形成一个独立类别;在这个类别中,隐私要求和进攻能力与模型原始质量同样重要。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| NCode / code app | @_xjdr | 面向代理的原生编码工作区和 SCM 层 | 在多个编码代理同时工作时,减少分支陈旧、仓库初始化缓慢和评审漂移 | 浅层虚拟检出、JJ 持久化、Sapling 栈、云同步、逐文件 ACL | Beta | 推文 |
| eot-bench | @livekit | 面向语音代理回合结束检测的开放基准和数据集 | 为语音团队提供衡量误截断率和延迟的共享方式 | Python 基准、14 语种数据集、实时排行榜 | Shipped | 推文, 仓库 |
| MLCR | @Wisedocsai | 用带噪填充上下文测试长上下文能力的医疗文档基准 | 衡量模型能否在真实医疗和保险文件上推理,而不是只会处理干净的玩具提示词 | 配置驱动 harness、合成案例、填充内容注入、LLM-as-judge 评分 | Shipped | 推文, 仓库 |
| Arasaka | @praedico | 面向业务代理的受治理运行时 | 为使用工具的代理增加策略、审批、审计和租户边界 | Rust、策略门控 ReAct、审批检查点、RunTrace、GraphRAG | Alpha | 推文 |
| Michos | @7h3h4ckv157 | 使用本地或云端开放模型的自动化 Web 应用渗透测试代理 | 让安全团队能够运行自主评估,而不必默认把模型处理交给第三方 | OpenCode、Ollama、Kali Docker、MCP server、Web 安全工具 | Beta | 推文, 仓库 |
NCode 之所以突出,是因为它直接切入了源代码管理和工作区这一层,而不是承诺提供一个更聪明的模型。其核心观点是:在团队能够安全扩展编码代理规模之前,代理需要更快启动、更好的状态跟踪,以及更严格的评审边界。
当天最反复出现的开发者模式,是评估基础设施。eot-bench 和 MLCR 都把测试本身打包成产品:前者用于实时对话中的轮次切换,后者用于带噪长上下文文档推理。这和常见的聊天包装器是不同类型的“AI 应用”,而且在当天最强的帖子中反复出现。
Michos 和 Arasaka 分别从信任问题的两端切入。Michos 展示了开放权重代理已经可以自动化敏感的进攻性工作流,而 Arasaka 则认为,业务代理需要一种运行时层:由模型提出行动建议,但由策略决定什么可以执行。

6. 新动态与值得关注的事项
越狱评分进入公共政策
@SophiaCai99 报道称(320 个赞、17 条回复、44,345 次浏览、82 次收藏)称,白宫和 Anthropic 正在制定针对越狱严重程度的正式技术评估框架。这很重要,因为它把“模型安全”从实验室内部的事件叙事,转成了一个可基准化、后果标准化的运营层。
多供应商 AI 算力更容易被想象
@CryptoTweets 报道称(41 个赞、10 条回复、4,105 次浏览、6 次收藏)称,Amazon 正在探索对外销售 Trainium 芯片,而不是只把它们留在 AWS 内部。回复立刻聚焦到真正的约束上——是否有任何东西能削弱 CUDA 的护城河——这也让该帖成为观察当下人们如何看待 AI 基础设施竞争的一张有用切片。
7. 机会在哪里
[+++] 模型治理与受治理代理控制平面 —— 证据已经出现在多个层面:白宫—Anthropic 越狱评分、基于员工属性的模型访问控制、分层模型权限、Arasaka 的策略门控运行时,以及 NCode 所体现的逐文件 ACL 思路。这一方向之所以强,是因为政策、企业管理和开发者工具三端已经同时显现出需求。
[+++] 以工作流为锚点的评估基础设施 —— eot-bench、LifeSciBench、MLCR 和 DeepEval 都指向同一个缺口:一旦真实代理、工件和带噪上下文进入场景,团队就不再信任玩具基准或确定性单元测试。这一方向之所以强,是因为人们要的不是更多仪表盘,而是在生产出问题之前就能派上用场的基础设施。
[++] Agent-native developer workflow and orchestration — NCode and Kestra both argue that model quality is only part of the work, while @_xjdr 明确把 git 和环境管理描述为系统性风险。这一方向属中等强度,因为痛点很清晰,但 IDE、源码管理层和编排平台都会涌入,赛道会很拥挤。
[+] 带可审计护栏的本地安全代理 —— Michos 展示了对私有、本地、可调用工具的安全代理存在真实需求,其 README 也明确说明了受监管或气隙环境中的隐私理由。这一方向正在形成,因为需求具体且明确,但它属于双重用途类别,面临的审查会比通用生产力工具更严格。
8. 要点
- 治理已从抽象的安全讨论转向可基准化的访问控制。 6 月 18 日最强的政策信号,是正式的白宫—Anthropic 越狱框架、对外国公民的访问切断,以及直接指出“谁能获得访问权”可能比模型原始 IQ 更重要。(来源)
- 评估持续转向混乱而真实的工作流,而不是干净的基准问答。 语音轮次切换、生命科学推理和带噪长篇医疗文件都迎来了公开基准推动,而 OpenAI 自己的公告仍称,表现最好的模型也只能通过 LifeSciBench 任务中的 36.1%。(来源)
- 开发者的建设热情集中在控制平面,而不只是更好的模型。 NCode、Arasaka、Kestra 和 DeepEval 都聚焦边界、编排、可审计性和测试——也就是模型周边的软件,而不只是模型本身。(来源)
- 开放权重和本地技术栈正在敏感领域变得更严肃。 Michos 把本地部署描述为渗透测试中的隐私和合规要求,而不只是爱好者偏好;这意味着代理式 AI 正在向受监管工作迈出有意义的一步。(来源)