Twitter AI - 2026-06-20
1. 人们在讨论什么
1.1 智能体工作被定义为编排能力和操作技能,而不只是更好的提示词(🡕)
高信号帖子普遍把 AI 进展看作一个协调问题。讨论重点不再是谁能写出最花哨的提示词,而是谁能搭建智能体、让其跨多次运行保留经验,并把工作拆解为可靠的子系统。三条不同内容共同支撑了这一转向:一条劳动力市场相关帖子、一项研究成果,以及一则关于检索架构的论点。
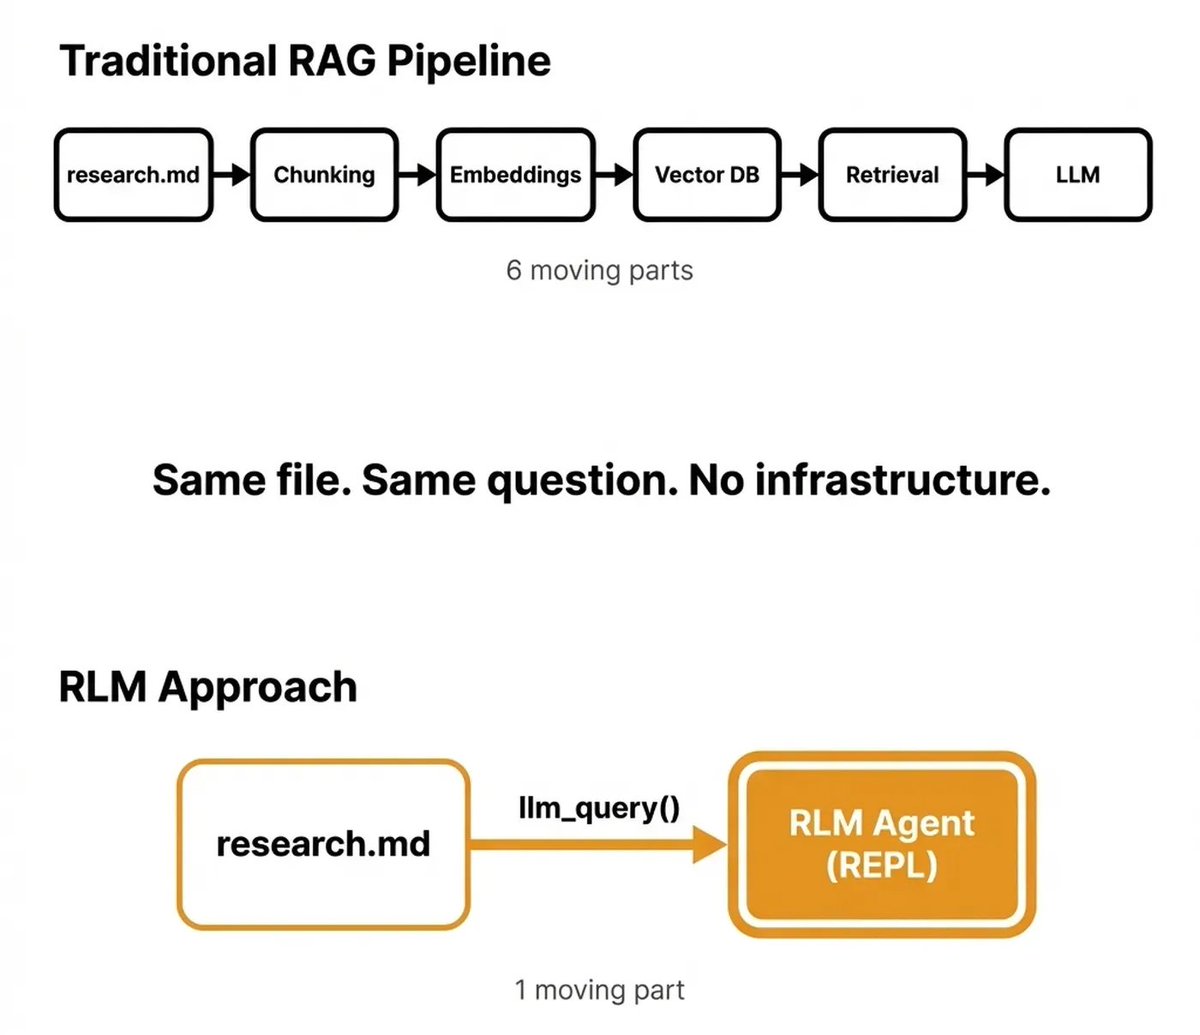
@gregisenberg 写道(230 个赞、44 条回复、7,905 次浏览、174 个收藏)认为,当前最有价值的技能是搭建智能体、运行本地模型、构建分发,以及将机器人技术与 AI 结合。@dair_ai 报道(17 个赞、3 条回复、1,243 次浏览、18 个收藏)介绍了 Skill-MAS:这是一篇论文及代码发布,在冻结前沿模型权重的同时,演化一种可复用的文本型元技能,用于任务分解、智能体工程和工作流编排(论文、代码库)。@pauliusztin_ 认为(15 个赞、3 条回复、791 次浏览、14 个收藏)则认为,递归语言模型可以把大文件、代码库和深度研究任务拆解为更小的调查任务,从而让部分检索基础设施变得非必需。

讨论洞察: 回复用更直白的话表达了同一个意思。有人在 Greg Isenberg 的帖子下回复称,真正的分界线在于:是否能搭建并运行本地 AI、是否能做机器人,以及是否能建立受众;而在 Skill-MAS 讨论串中,也有人追问它的反思循环能否经受分布偏移,这说明人们既感兴趣,也对编排能力相关说法保持怀疑。
与前一天的对比: 6 月 19 日的重点是智能体的运行时可信性、治理和生产控制。到了 6 月 20 日,关注点则沿技术栈再往前移了一层,转向谁能协调智能体工作,以及编排本身如何学习。
1.2 经济性与模型市场压力变得更难忽视(🡕)
当天最有力的经济类帖子谈的不是模型智商,而是 AI 需求能否支撑当前资本开支、更便宜的中国模型能否挤压高端定价,以及本地硬件是否已经足够好,足以替代持续性的订阅支出。
@FoamOnTheRunway 认为(100 个赞、17 条回复、17,468 次浏览、50 个收藏)认为,即使半导体股票尚未重新定价,AI 泡沫也已经破裂;其依据包括 GPU 租赁价格下跌、超大规模云厂商从债务融资转向股权融资,以及补贴结束后需求走弱。@C_Barraud 写道(47 个赞、3 条回复、3,399 次浏览、13 个收藏)认为,中国模型正在 OpenRouter 上赢得使用量、成本和采用率之争,同时也指出,Token 份额并不代表整个市场。三条独立的本地算力帖子又从构建者角度讲述了同样的成本故事:@gippp69 总结(30 个赞、17 条回复、1,360 次浏览、19 个收藏)介绍了一台 400 美元的二手 GPU 家用设备,用来替代每月 110 至 260 美元的托管方案;@starmexxx 声称(38 个赞、13 条回复、2,660 次浏览、17 个收藏)称,在一项被引用的本地基准测试中,M4 Mac mini 击败了 RTX 5060 Ti;@0xRicker 表示(25 个赞、3 条回复、534 次浏览、21 个收藏)称,Minisforum 迷你 PC 可以把 70B 和 120B 本地模型装入内存。


讨论洞察: 回复大致分成两派:一派对低成本本地部署很兴奋,另一派则怀疑 OpenRouter 的 Token 份额能在多大程度上代表整体市场。有人在 OpenRouter 讨论串下回复称,这只占总代币用量中的很小一部分;而 Mac mini 帖子的回复则主要聚焦于功耗和立刻下单的意愿。
与前一天的对比: 6 月 19 日已经显示,构建者在寻找更便宜的测试环境和本地执行方案。到了 6 月 20 日,这一趋势升级为更广泛的定价与变现叙事,覆盖半导体估值、API Token 份额,以及家庭实验室替代方案的成本核算。
1.3 严肃的 AI 部署讨论继续深入具体领域和机构基础设施(🡕)
在模型层以下,最有可信度的构建者帖子来自讨论具体部署环境的团队:非洲语言语音系统和军事规划。这些并不是泛泛而谈的“AI 将改变一切”,而是与具体运行场景绑定的技术栈描述。
@Abba_kakaa 写道(45 个赞、8 条回复、403 次浏览)认为,可靠的语音 AI 不仅需要语音模型,还需要数据集、转录流水线、标注系统、基准测试、方言评估、检索、工具执行、监控和反馈闭环。Dialectra 的公开网站用具体基础设施和基准数字印证了这一点,包括 1,240 小时经验证的 Hausa 数据、680 小时 Fulfulde 数据、420 小时 Kanuri 数据,以及训练后 WER 分别为 8.2%、11.4% 和 13.1%(Dialectra)。@shashj 引用(22 个赞、4,842 次浏览)提到,9 Deep Recce Strike Brigade 的一名指挥官表示,HIVEMIND 大语言模型把制订计划的时间从数天缩短到数小时;其链接的 British Army Review 则称,Project Asgard 让 Strategic Reserve Corps 能以前所未有的速度和规模,对从公开来源到 Above Secret 的海量数据进行分级筛查(CHACR PDF)。
讨论洞察: 共同模式是全栈思维。Dialectra 的讨论串明确认为,未来的赢家将理解从语音采集到部署的完整价值链;而军方案例则把大语言模型的价值界定为现有机构内部的规划提速和数据筛查,而不是面向消费者的助手。
与前一天的对比: 6 月 19 日已经把讨论下探到方言数据、基准测试和功耗。6 月 20 日,这一趋势进一步延伸到清晰可见的已部署系统:面向非洲语言的语音基础设施,以及面向军事总部的 AI 辅助规划。
2. 人们感到挫败的地方
编排能力仍比模型访问更稀缺
严重程度:高。@gregisenberg 表示(230 个赞、44 条回复、7,905 次浏览、174 个收藏)认为,智能体搭建、本地模型运维和分发能力如今已成为顶级技能,这意味着模型访问本身不再是主要瓶颈。@dair_ai 报道(17 个赞、3 条回复、1,243 次浏览、18 个收藏)展示了一整条研究方向:在不重新训练权重的情况下提升编排能力;@pauliusztin_ 表示(15 个赞、3 条回复、791 次浏览、14 个收藏)则明确指出,对某些工作负载来说,检索技术栈过于复杂。当前的应对模式是做规格定义、拆分子任务,并构建可复用的编排层。之所以值得投入,是因为这一痛点同时出现在研究、招聘和一线检索架构实践中。
托管式 AI 的经济性看起来愈发脆弱
严重程度:高。@FoamOnTheRunway 认为(100 个赞、17 条回复、17,468 次浏览、50 个收藏)认为,超大规模云厂商的资本开支经济性正在恶化;@C_Barraud 认为(47 个赞、3 条回复、3,399 次浏览、13 个收藏)则认为,够用且更便宜的中国模型正在加大定价压力。在构建者一侧,@gippp69 声称(30 个赞、17 条回复、1,360 次浏览、19 个收藏)称,一台二手 GPU 家用设备可以替代按月付费的托管方案;@starmexxx 声称(38 个赞、13 条回复、2,660 次浏览、17 个收藏)则称,在一项被引用的本地测试中,低成本 Mac mini 可以击败独立 GPU。当前的替代路径是本地推理、更小的开源模型,以及“够用就行”的路由策略,而不是始终为高端闭源模型付费。之所以值得投入,是因为市场评论者和一线用户正在围绕同一个定价问题形成共识。
领域部署仍需要过多定制化基础设施
严重程度:中。@Abba_kakaa 列出(45 个赞、8 条回复、403 次浏览)列出了语音智能体背后缺失的环节:高质量数据集、转录、标注、基准测试、方言评估、检索、工具执行和监控。@shashj 分享(22 个赞、4,842 次浏览)则给出了一个军事案例:只有把大语言模型支持整合进既有指挥流程后,规划速度才得到提升。当前的应对方式是搭建机构专属技术栈。之所以值得投入,是因为最有说服力的部署案例,仍要求团队在终端用户看到价值之前,先自己拼装许多层基础设施。
3. 人们希望存在什么
能积累经验的可复用编排层
人们似乎想要的不只是更强的基础模型,而是一种能跨多次运行保留工作流知识的方式。@dair_ai 分享(17 个赞、3 条回复、1,243 次浏览、18 个收藏)介绍了一个专门用来在不更新模型权重的情况下演化编排技能的系统;@gregisenberg 认为(230 个赞、44 条回复、7,905 次浏览、174 个收藏)则认为,如今稀缺的劳动力就在于智能体的搭建与规范管理。这是一项有直接需求的现实需要,因为人们已经在手动填补这层缺失。机会:直接。
性能可接受、价格可负担的私有算力
当天多条内容反复表明,人们需要足够私密、足够便宜、能够摆脱高价订阅服务运行的 AI。@gippp69 描述(30 个赞、17 条回复、1,360 次浏览、19 个收藏)介绍了一台用来替代每月 AI 账单的家用设备;@starmexxx 分享(38 个赞、13 条回复、2,660 次浏览、17 个收藏)讲述了低功耗 Mac mini 的基准测试叙事;@0xRicker 表示(25 个赞、3 条回复、534 次浏览、21 个收藏)则称,迷你 PC 能容纳远超用户预期的大型本地模型。这是一项有直接需求的现实需要,但竞争会非常激烈,因为硬件厂商、路由层和开源模型技术栈都在向这一方向收敛。机会:竞争激烈。
面向具体领域、可直接部署的数据与技术栈
@Abba_kakaa 提出论证(45 个赞、8 条回复、403 次浏览)认为,非洲语音生态仍需要从采集、标注到部署的完整链路;Dialectra 的公开网站用具体的数据集和基准测试基础设施说明了原因。@shashj 指出(22 个赞、4,842 次浏览)分享的 Asgard 案例,也在机构场景中指向同样的问题:只有当模型被嵌入能筛查数据并加快规划的工作流之后,模型本身才真正重要。这是一项现实需求,但它具有强烈的领域特异性,也高度依赖关系网络,而不是一个通用产品类别。机会:直接。
面向长上下文工作的更简化混合知识系统
@pauliusztin_ 认为(15 个赞、3 条回复、791 次浏览、14 个收藏)认为,RLM 可以在大文件和代码库任务中移除经典检索技术栈的部分环节;与此同时,@DanKornas 分享(39 个赞、1 条回复、1,219 次浏览、36 个收藏)展示了一条仍在活跃发展的工具链,包括向量数据库、Typesense、LangGraph、MongoDB Vector Search 和 RAG 评估。两者结合说明,人们仍希望有一种更简单的架构:既保留 RAG 的精度,又降低其运维开销。机会:竞争激烈。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| ChatGPT | 大语言模型助手 | (+/-) | 在一张对比矩阵中被描述为擅长创意工作、编程和日常生产力 | 用户明确将其与更专业的工具对比,而不是把它当成默认赢家 |
| Gemini | 大语言模型助手 | (+/-) | 定位于 Google Workspace 集成和最新网页数据;也是低成本竞争压力叙事的一部分 | 指导类帖子暗示,许多用户仍按使用 ChatGPT 的方式来用它,因此错过了工具特有的行为模式 |
| Claude | 大语言模型助手 / 编程 | (+) | 常与深度阅读、编程和规格驱动型工作流关联 | 更常出现在更大的工作流系统中,而不是单独构成完整架构 |
| Perplexity | 研究助手 | (+) | 在对比图中因具备引文支撑的研究和事实核查能力而受到重视 | 被视为碎片化技术栈中的一个工具,而非通用界面 |
| OpenRouter | API 路由器 / 市场代理指标 | (+/-) | 能反映快速变化的模型使用情况,并降低跨供应商切换摩擦 | Token 份额不代表整个市场,也无法直接映射到收入 |
| RAG 技术栈(Typesense、LangGraph、MongoDB Vector Search) | 检索流水线 | (+/-) | 仍被积极用于数据摄取、向量搜索、高级检索和评估 | 组件繁多、基础设施额外增加,使其对某些工作负载而言显得笨重 |
| 递归语言模型 | 推理方法 | (+/-) | 无需把所有内容塞进一个上下文窗口,就能分解大文件、代码库、法律和研究任务 | 不是完整的 RAG 替代方案;对更简单的查询来说,仍可能更慢或更复杂 |
| Skill-MAS | 多智能体编排框架 | (+) | 将任务分解、智能体工程和工作流编排演化为可复用的技能层 | 仍处于研究阶段,在生产环境中的稳健性和迁移能力方面存在未解问题 |
| Dialectra | 语音数据 / 基准测试平台 | (+) | 为非洲语言提供经验证、带方言标注的数据集、基准测试套件、分析工具和 API | 设计上就聚焦于特定区域的语音 AI 问题,范围较窄 |
| Project Asgard / HIVEMIND | 规划决策支持系统 | (+) | 公开证据表明,它能对海量数据进行筛查,并加快军事工作流中的规划 | 面向机构且高度专业化,并非面向公众的通用产品 |

整体满意度呈现出务实而非意识形态化的特征。用户并没有押注单一的通用模型,而是按任务对工具进行分工,把闭源助手与路由器、本地硬件、检索技术栈和编排方法混合使用。
最常见的应对方式是分层叠加技术栈。RAG 仍在被积极用于精确检索,但 RLM 式分解正获得更多关注,被视为一种减少长上下文任务基础设施负担的办法。在成本方面,OpenRouter 式路由和本地硬件相关说法都指向同一种迁移压力:如果更便宜或本地方案已经够用,那么愿意为每次请求支付高价的人就会减少。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Skill-MAS | Hehai Lin 等人 | 分三个阶段演化一种可复用的元技能,用于设计和编排多智能体系统 | 团队希望编排知识能够持续积累,而不必每次都重新训练基础模型 | 前沿大语言模型、多轨迹 rollout、对比式反思、生成式 MAS 代码 | Alpha | 论文、代码库、推文 |
| Dialectra | @Abba_kakaa | 为非洲语言构建具备方言感知能力的语音数据集、基准测试套件、分析工具和 API | 语音团队需要经验证的本地语言数据和评估体系,可靠产品才能落地 | 数据采集、母语者验证、标注、基准测试引擎、API | 已发布 | 推文、网站 |
| Project Asgard / HIVEMIND | British Army / CHACR | 用于筛查数据并加快军事规划工作流的 AI 辅助决策支持和规划工具 | 总部需要处理海量数据,并更快拿出计划 | 基于大语言模型的规划支持、跨密级数据筛查、总部工作流集成 | Beta | 推文、PDF |
@dair_ai 披露(17 个赞、3 条回复、1,243 次浏览、18 个收藏)是当天技术描述最明确的构建成果。公开仓库显示,Skill-MAS 会演化一个 SKILL.md 文件,使其负责任务分解、智能体工程和工作流编排,然后通过多轮 rollout 和对比式反思重写这项技能。这一点之所以重要,是因为它把“智能体 know-how”变成了团队可以做版本管理和优化的对象,而不必每次都从头摸索。
@Abba_kakaa 分享(45 个赞、8 条回复、403 次浏览)体现了另一种构建模式:为通用模型头部厂商服务不足的领域搭建基础设施。Dialectra 的网站明确写出了产品覆盖面,从带方言标签的语料库和母语者验证,到基准测试套件、API 和部署就绪度报告。
@shashj 引用(22 个赞、4,842 次浏览)是一个罕见的公开机构案例,而不是一次初创公司发布。所链接的 British Army Review 将 Project Asgard 描述为一个决策支持层,帮助一个军级规划组织筛查从公开来源到 Above Secret 的数据,因此它成为公开资料中最清晰的案例之一:把大语言模型支持嵌入既有指挥工作流。
反复出现的构建模式是基础设施,而不是外层封装。最强的项目并不是通用助手外壳,而是围绕具体瓶颈构建的编排系统、领域数据集和机构专属决策层。
6. 新消息与值得关注的内容
OpenAI 的人才争夺被视为架构竞赛
@MTSlive 写道(60 个赞、3 条回复、6,815 次浏览、9 个收藏)称,Noam Shazeer 将加入 OpenAI;此前,他曾在 Google 和 Character AI 参与核心 Transformer、扩展、混合专家、Gemini、Flash 和 Gemma 相关工作。这条讨论之所以值得关注,并不是因为名人八卦,而是其背后的框架:这次招募之所以重要,是因为架构研究仍被视为递归自我改进和前沿模型竞争中的决定性杠杆。
军事规划提供了最清晰的机构型 LLM 案例之一
@shashj 分享(22 个赞、4,842 次浏览)展示了一个公开的军事规划案例,打破了企业 AI 常见的模糊表述。该推文及其链接的 CHACR 评述,把价值主张明确绑定到具体结果:把制订计划的时间从数天缩短到数小时,并更快筛查大量机密和开源数据流。
7. 机会在哪里
[+++] 智能体编排与经验保留层 — Greg Isenberg 关于技能市场的帖子、Skill-MAS,以及 RLM/RAG 讨论都指向同一个缺口:模型访问很容易,但可靠的任务分解、编排和可复用工作流知识仍然稀缺。
[+++] 成本敏感的私有与本地 AI 基础设施 — 对半导体的质疑、OpenRouter 的定价压力,以及多条本地硬件基准测试讨论,都显示出对更低持续成本、更强隐私性以及更少依赖高价托管推理的需求。
[++] 面向具体领域的数据与部署技术栈 — Dialectra 和 Project Asgard 表明,真正的价值往往只会在团队解决了领域数据质量、评估、工作流集成和机构约束之后才出现。
[+] 混合检索与长上下文推理系统 — 活跃的 RAG 工具链与 RLM 式简化之间的张力表明,市场仍有空间做出既保留检索精度、又降低流水线复杂度的产品。
8. 要点
- 讨论焦点已经从“哪个模型最聪明?”转向“谁真正能把整套技术栈跑起来?” 当天最清晰、互动最高的高信号帖子,讨论的是智能体搭建、本地模型、机器人和分发能力,而不只是模型品牌。(来源)
- AI 的经济性看起来比 AI 能力本身更具争议。 看空市场的人、OpenRouter 使用量图表,以及本地算力基准测试讨论,都在追问同一个问题:当更便宜或本地的替代方案已经够用时,高溢价还能保住多少。(来源)
- 严肃的构建者仍在聊天机器人层以下持续投入。 Skill-MAS、Dialectra 和 Project Asgard 的重点都在编排、数据和工作流集成,而不是再做一个通用助手外壳。(来源)
- RAG 并没有消失,但正受到两面夹击。 Twitter 上一部分人仍在教授向量数据库、LangGraph 和评估,另一部分人则认为,递归式智能体推理可以在长上下文任务中移除这套技术栈的一部分。(来源)