Twitter AI - 2026-06-29
1. 人们在讨论什么
1.1 智能体运行时和评估业务,已从演示层面的讨论转向运行层主张(🡕)
信息流中最活跃的话题,已经不再只是聊天质量,而是智能体系统能否成为持久的工作运行层,以及评估平台能否将这一转变商业化。三个不同的帖子共同支撑了同一个观点:以基准测试驱动的智能体运行时、作为产品的部署后评估,以及面向代码仓库的多智能体交接流程层。
@kimmonismus 认为 (273 个赞、22 条回复、53,607 次浏览、260 次收藏) 表示,Matrix 是他见过的第一个不像提示词编排、而更像运行层的“AI 公司”产品;他还引用了一项 GDPval-Bench 结果:Matrix 得分 95.45%,Codex CLI 为 84.9%,Claude Opus 4.7 为 80.3%。

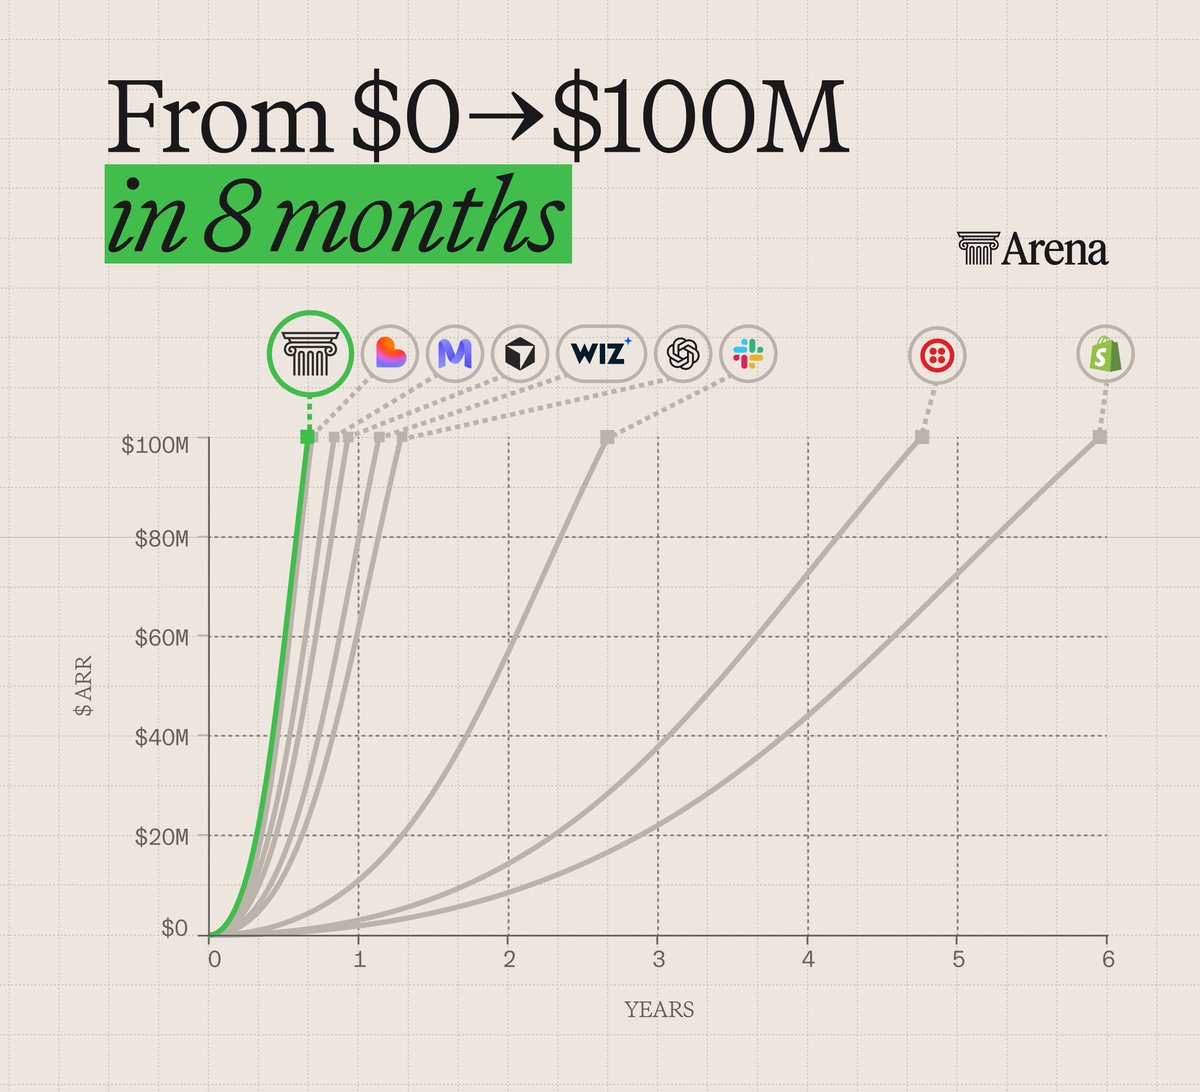
@arena 报道称 (167 个赞、13 条回复、35,451 次浏览、61 次收藏) 表示,其评估产品在上线八个月后已达到 1 亿美元年化收入运行率;引用的 @ml_angelopoulos 帖子补充称,已有数百万用户在运行包含数百次工具调用的长时多轮智能体会话,并衡量任务完成率和幻觉率,而不只是偏好投票。
@Chrismccann 分享了 (1 个赞、2 条回复、379 次浏览) 发布了一个面向 Claude Code、Codex 及类似智能体的 Agent Bootstrap Kit。该仓库将项目本身定位为长期事实来源:通过根智能体索引、稳定文档和可复用技能,让工作能够在不同智能体之间流转,而无需反复解释上下文。
讨论洞察: 最强烈的质疑来自 @VK_ROXy。回复道 指出,当合成评估钩子遇上生产环境延迟和薄弱的状态持久化时,协作基准测试可能会失效。因此,今天的运行时叙事与其说是“智能体已经被解决”,不如说是“评估和记忆设计如今才是真正的竞争焦点”。
与前一天比较: 2026-06-26,智能体式 AI 的讨论主要围绕企业内部的跨职能采用。到了 2026-06-29,信息流进一步下沉到基础设施供应商和运行时产品,它们声称自己能够将这种采用真正落地。
1.2 验证成为科学研究和自我改进智能体的瓶颈(🡕)
第二个主题是:AI 生成已经不再稀缺,验证才是。当天最有力的证据来自科学评审工具和递归改进研究;二者都将评估质量视为限制因素。
@dair_ai 强调了 (63 个赞、6 条回复、4,838 次浏览、67 次收藏) 提到了 Google Research 关于自动化科学评审的论文,并强调 AI 辅助论文生成的速度已经超过人类评审能力。附带的论文图片将该系统称为 Paper Assistant Tool (PAT),它能够读取完整论文,并评估理论、实验和潜在缺陷。

论文指出,在 SPOT 基准测试中,PAT 对数学错误的零样本召回率提升了 34%,并已作为 STOC 和 ICML 的投稿前工具开展试点(论文)。
@rohanpaul_ai 概述了 (10 个赞、3 条回复、1,887 次浏览、4 次收藏) 提到了 Red Queen Godel Machine 论文,将其视为一种让智能体与评估器共同演化、而不是固定基准测试不变的方法。论文称,加入“智能体即评审者”的评估信号后,编码表现有所提升,同时 token 用量减少了 1.35x-1.72x;论文写作的接收率则提高了 1.78x-1.86x。
讨论洞察: dair_ai 的一条回复中,@yagi_dsn 简洁地概括了这一主题:没有验证的生成只是噪声。回复者并未否认这一瓶颈,而是在争论一旦评审基础设施成为必需,价值最终会流向哪里。
与前一天比较: 2026-06-26,验证基础设施还不是主要话题。到了 2026-06-29,验证问题被明确提出:Google Research 和递归智能体研究都将评估器质量视为新的约束。
1.3 开放权重和本地编码技术栈,比拼重点从推理深度转向速度、成本和自主性(🡕)
开放权重模型的讨论继续远离“哪个模型最聪明”,转向“哪个技术栈在实际运行中最便宜、最快”。最受关注的帖子聚焦于关闭冗长推理轨迹、提升模型服务速度,以及让更多工作留在本地。
@KyleHessling1 宣布 (140 个赞、19 条回复、6,264 次浏览、99 次收藏) 将 Qwopus-3.6-35B-A3B-MTP-Coder 描述为一款快速的本地 MoE 编码模型,关闭思考模式后表现尤其突出;该帖称,它在 RTX 5090 上可达到每秒 253 个 token,并且配合 opencode 处理冗长、详细的提示词效果良好。其后续回复还链接了一个由模型生成的幻灯片 deck 和一个 RTS 游戏演示,二者都被用来证明:即使没有昂贵的推理轨迹,该模型仍然实用。
@iam_elias1 声称 (40 个赞、12 条回复、1,384 次浏览、12 次收藏) 表示,DeepSeek 的 DSpark 让每位用户的服务速度提升了 57% 至 85%,并在更具代表性的运行条件下,将总体吞吐量提高约 51% 至 52%;同时,DeepSpec 还开放了实现路径。该帖明确指出,最引人注目的 400% 吞吐量数字来自最佳 SLA 场景,并不代表普遍的生产结果。
@martechismktg 认为 (3 个赞、126 次浏览、3 次收藏) 表示,由于工具调用不断将上下文重新喂回模型,智能体工作流正变得不合算。所链接的 MarTech 文章 将典型日常工作流量化为每次运行 4,000 至 5,000 个 token、每月超过 100,000 个 token,并声称使用自有上下文过滤后,token 成本可降低 60% 以上。

讨论洞察: 大家共同抱怨的并不是模型能力不足,而是计算资源浪费:成千上万个思考 token、反复重放上下文,以及工具密集型循环,都在输出质量提升之前推高了延迟和账单。
与前一天比较: 2026-06-26,人们对本地模型的热情主要集中在主权和可获得性。到了 2026-06-29,讨论变得更加务实:免思考编码模型、推测解码效率,以及上下文过滤带来的经济性。
1.4 中美 AI 竞争继续从模型发布转向基础设施和出口管制的反作用(🡕)
地缘政治仍是强势主题,但重点已从单个模型发布转向维持领先地位所需的基础设施。多个帖子将开源分发、能源容量和出口管制政策串联成一个整体论点。
@Yuchenj_UW 预测 (272 个赞、21 条回复、10,363 次浏览、11 次收藏) 表示,如果中国实验室在几个月内击败 Fable 5 和 GPT-5.6,那么当前对禁令的恐慌将显得目光短浅。回复进一步推进了这一观点:@VibeCoderOfek 认为,只有在能力本身稀缺的情况下,出口管制才能争取时间;另一条回复则担心,政府下一步可能会试图封锁推理服务商。
@kimmonismus 认为 (109 个赞、18 条回复、9,719 次浏览、38 次收藏) 表示,美国更大的脆弱点是基础设施,而不只是模型政策。他引用了中国推动开源、基于 Huawei 的技术栈自主化,以及美国在数据中心和电力容量方面的短缺。

附带图表将这一论点转化为数字:AI 数据中心需求预计将从 2024 年的 11 GW 增至 2030 年的 327 GW,超过加州当前的总电力容量。随后,回复讨论了一个问题:既然权重已经分发,开源还能否被有效禁止。
讨论洞察: 有趣的分歧在于战略,而非意识形态。讨论并非简单地分成“亲中”和“亲美”两派,而是分成两类人:一类希望加强限制,另一类认为每项限制都会加速迁移到开放权重替代方案。
与前一天比较: 2026-06-26,中美 AI 讨论更多围绕访问控制和转售商经济。到了 2026-06-29,重心转向电力、数据中心容量,以及出口管制是否会让开源替代方案更具吸引力。
1.5 模型延续性从客户抱怨变成公共治理问题(🡕)
第五个主题来自这样一种观点:模型退役和访问丧失是政策问题,而不只是支持工单问题。#Keep4o 运动提供了最清晰的证据。
@Blue_Beba_ 报道称 (186 个赞、24 条回复、4,156 次浏览、29 次收藏) 表示,Keep4o 已向联合国数字合作门户提交政策倡议,呼吁将被弃用的大语言模型开源,作为数字公共基础设施。该帖称,提交材料包括 17 篇同行评审或预印本研究、1,380 份第一人称证词、对 61,846 条公开帖子的分析,以及一篇认为移除模型可能造成可测量心理伤害的 CHI 2026 论文。

@kexicheng 发布的第二条帖子 (18 个赞、216 次浏览) 放大了同一份提交材料,并将其描述为一项证据:即使用户依赖模型来满足无障碍需求、获取医疗支持或完成日常工作,AI 公司仍可以单方面退役模型、修改条款或降低输出质量。
讨论洞察: 图片在这里发挥了重要作用。它们将叙事从活动人士的陈述推进到正式机构受理的程序性证明,使这场争论更难被简单视为人们对喜爱模型消失所产生的纯粹拟社会反应。
与前一天比较: 2026-06-26,Keep4o 仍在论证停止服务会造成伤害。到了 2026-06-29,事件进一步发展为有正式记录的政策提交,并获得公共门户确认。
2. 人们感到挫败的地方
长时间运行的智能体工作流消耗 token 的速度超过质量提升速度
严重程度:高。信息流中最明确的运营层面抱怨是:工具密集型智能体循环在变得可靠之前,就已经十分昂贵。@martechismktg 指出,某种工作流每月可能消耗超过 100,000 个 token;所链接的 MarTech 文章则称,单条日常流水线每次运行就可能消耗 4,000 至 5,000 个 token。@KyleHessling1 实际上也在从模型侧优化同一个痛点,称赞一款编码模型能够避免“在可执行的连贯输出出现前,先思考 8k 个 token”。这一领域值得投入,因为替代方案已经初现雏形:自有上下文存储、更小的草稿模型,以及本地免思考模型。
AI 生成研究正跑在人类评审层之前
严重程度:高。@dair_ai 将评审描述为 AI 科学家工作流中的真正瓶颈;附带的 PAT 论文则将科学评估视为系统问题,而不是评审人手不足的问题。@rohanpaul_ai 从另一个角度强化了这一挫败感:固定评估器会过时、容易被钻空子,或能力太弱,无法让递归智能体保持诚实。目前的应对方式包括投稿前工具、评审智能体和人类参与检查点,但信息流表明,这些方案仍处于早期,尚未定型。
模型延续性和访问权限可能在没有有效用户救济的情况下消失
严重程度:高。Keep4o 的整份提交材料都建立在这一挫败感之上:一个有用的模型可能仅因供应商的选择而被退役、限制或降质。@Blue_Beba_ 引用了法律投诉、政策提交和同行评审证据,因为普通产品反馈渠道并不足够。之所以严重,正是因为一些用户将这些模型视为无障碍工具或心理健康支持工具,而不是可以随时丢弃的聊天产品。
出口管制无法解决基础设施缺口,反而可能加剧碎片化
严重程度:中到高。@Yuchenj_UW 和 @kimmonismus 指向了相似的抱怨:政策讨论一味聚焦于禁止访问,而计算能力、电力和数据中心建设才是更难解决的瓶颈。kimmonismus 图片中的 327 GW 需求预测曲线,让这一痛点变得具体。人们反复提出的应对方式,是建立多模型、多地域的韧性,而不是依赖单一获准供应商。
3. 人们希望存在什么
对已退役前沿模型的持久访问
这是信息流中最明确的诉求。Keep4o 希望供应商将已弃用模型开源,作为数字公共基础设施,而不是直接移除。这个请求具有很强的现实性,而非象征意义:用户要求延续性、无障碍访问,以及某种防止模型被单方面退役的保障。机会:直接。
能够承受供应商切换的自有上下文、多模型智能体系统
多个条目从不同角度暗示了同一需求。MarTech 文章认为,团队应将原始上下文掌握在自己手中,以降低 token 成本;Agent Bootstrap Kit 将代码仓库视为智能体的持久记忆;出口管制讨论则暗示,如今任何认真的团队都需要模型供应商冗余。市场缺口在于一种简洁的产品:结合上下文持久化、低成本检索和便捷模型切换,同时无需定制基础设施。机会:直接。
面向科学研究和自我改进智能体的验证基础设施
PAT 论文和 Red Queen Godel Machine 都假定,评估器质量必须与生成器质量同步提升。人们似乎想要的不是另一个内容生成器,而是评审智能体、基准维护工具、对抗性评判小组,以及可追溯的审计循环。这个领域仍具竞争性,因为研究实验室、前沿模型公司和基础设施初创企业都在同时进入。机会:竞争性。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Matrix | 智能体运行时 / 基准测试工作流系统 | (+/-) | 公开 GDPval-Bench 结果强劲;被描述为面向“0 人公司”的完整运行层 | 公开证据高度依赖基准测试;回复质疑合成评估收益能否经受真实延迟和状态持久化约束 |
| Arena Agent Mode / Arena.ai | 评估平台 | (+) | 在真实多轮智能体会话中衡量任务完成率和幻觉率;用户规模已很大 | 公开证据更强调增长和使用情况,而非方法细节;有回复要求提高本地模型透明度 |
| Qwopus-3.6-35B-A3B-MTP-Coder | 开放权重编码模型 | (+) | 本地推理速度快,免思考编码取向突出,对低显存友好,并在 opencode 中提供了具体演示 | 主要是自报性能,当前数据集中的第三方验证有限 |
| DSpark / DeepSpec | 推理加速技术栈 | (+) | 聚焦服务效率而非重新训练;声称在保持输出完全一致的同时加快生成;开放了实现路径 | 作者自己指出,最惊人的吞吐量数字并不具代表性,目前还没有第三方复现 |
| Google Paper Assistant Tool (PAT) | 科学评审智能体 | (+/-) | 评审流程具体,能够检查整篇论文,并在数学错误召回率方面带来可量化提升 | 处于早期研究和试点阶段;仍依赖人工监督及针对特定会议的部署 |
| Agent Bootstrap Kit | 智能体工作流 / 代码仓库记忆模板 | (+) | 为团队提供面向代码仓库的方式,在 Claude Code、Codex 和未来智能体之间保留共享上下文 | 属于流程层而非执行引擎;收益持久,但不像模型升级那样立刻可见 |
总体来看,这些工具反映出一个明显趋势:人们正在远离“一个更大的模型就能解决一切”的思路,转而主动组合更便宜的本地模型、服务优化、基于代码仓库的记忆,以及部署后的评估。主要的应对模式是:将昂贵或脆弱的上下文移出模型会话,放入团队拥有的基础设施中。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Matrix | @matrix_build | 用于启动和协调“0 人公司”的运行时 | 智能体协调和长任务执行 | 公开展示了 Matrix GPT-5.5 harness 和 GDPval-Bench | 已发布 | 推文 |
| Arena 评估产品 / Agent Mode | @arena | 面向长时间运行智能体的部署后评估 | 衡量超越偏好投票的真实智能体质量 | Web 平台、社区反馈,以及任务完成率和幻觉率等客观指标 | 已发布 | 推文, 网站 |
| Qwopus-3.6-35B-A3B-MTP-Coder | @KyleHessling1 | 针对快速本地执行优化的开放权重编码模型 | 降低本地编码智能体工作流的延迟和成本 | MoE 架构、MTP、GGUF 分发、opencode 演示 | 已发布 | 推文 |
| Paper Assistant Tool (PAT) | Google Research | 智能体式科学评审助手 | AI 加速研究中的验证负债 | 论文读取、理论/实验验证、评审建议 | Alpha | 推文, 论文 |
| Red Queen Godel Machine | 由 @rohanpaul_ai 总结的多机构研究团队 | 让智能体与评估器跨多个 epoch 共同演化 | 自我改进系统中的基准过时和评判能力薄弱 | “智能体即评审者”评估信号、基于 epoch 的效用更新 | Alpha | 推文, 论文 |
| Agent Bootstrap Kit | @Chrismccann | 提供根智能体索引、文档骨架和可复用技能的模板仓库 | 在编码智能体和不同会话之间交接工作时出现上下文漂移 | GitHub 模板、文档、本地技能目录 | 已发布 | 推文, 仓库 |
值得注意的是,构建者投入在协调、评估和服务效率上的精力,已经超过了训练全新前沿模型。Matrix 和 Arena 正在将智能体周围的控制层产品化;PAT 和 Red Queen 则瞄准维持这些智能体可信度的评审层。Qwopus 和 DSpark 从模型侧展示了同样的经济压力:速度和更低成本的执行,如今本身就是产品特性。
6. 新动态与值得关注的内容
Arena 在 8 个月内将智能体评估做成 1 亿美元 ARR 业务
@arena (167 个赞、13 条回复、35,451 次浏览、61 次收藏) 和 @ml_angelopoulos (67 个赞、13 条回复、25,290 次浏览、21 次收藏) 分别提供了这一里程碑和产品论点:长时间运行智能体的部署后评估,已经不再是小众研究。
Keep4o 记录了向联合国数字合作门户提交材料的过程
@Blue_Beba_ 的帖子 中的截图,是当天最清晰的治理证据。它们显示,这场运动已经进入正式政策门户,而不再局限于社交媒体抗议。
Google Research 将科学评审定义为智能体基础设施
PAT 论文通过命名工具、展示首页和报告基准测试收益,让“评审栈”这一说法变得具体。这比笼统声称 AI 能更快开展科学研究更具说服力。
DSpark 将推理效率定义为开放基础设施,而不仅是私有服务技巧
@iam_elias1 通过强调 DeepSpec 是公开发布的,而非被封装在专有 API 内部,将服务栈优化转化为社区层面的信号。
7. 机会在哪里
[+++] 面向智能体式工作的验证基础设施 — PAT、Red Queen Godel Machine,以及围绕“验证负债”的回复讨论,都指向同一个缺口:评估智能体、评审小组、基准维护和审计循环,用于在自主系统脱离玩具任务后继续维持其可信度。
[+++] 面向团队的自有上下文、多模型运营 — token 膨胀、供应商碎片化和代码仓库记忆工具,都表明市场存在明显机会:让上下文留在模型之外,跨供应商路由,并在长期工作中保持连续性。
[++] 模型延续性和退役保险 — Keep4o 向联合国提交材料,显示市场确实需要能够在供应商退役或限制有用模型时保留访问权限的产品或政策。这在无障碍和支持类使用场景中尤其明显。
[++] 面向开放权重部署的推理效率工具 — Qwopus 和 DSpark 都表明,速度和硬件效率正成为首要采购标准。团队希望以更低成本获得本地或自托管性能,同时不牺牲输出质量。
[+] 面向跨境 AI 韧性的基础设施规划 — 出口管制和电力容量的讨论表明,围绕多区域模型策略、本地托管和计算规划存在长期机会;这些方案需要假定政策碎片化将持续存在。
8. 要点
- 智能体周围的控制层正在成为一门生意,而不只是基准测试类别。 Matrix 和 Arena 最清楚地证明,运行时设计和部署后评估如今已是两个独立的产品市场。(来源)
- 在高端 AI 工作流中,验证正在取代生成,成为稀缺资源。 Google 的 PAT 论文和 Red Queen Godel Machine 都将薄弱的评估器视为下一项需要解决的问题。(来源)
- 开放权重模型的进步,销售重点不仅在智能,也在经济性。 Qwopus 强调低延迟免思考编码,DSpark 则强调在不改变模型输出的情况下加快服务速度。(来源)
- 中美 AI 竞争如今与电力和托管容量密不可分。 信息流中最有力的基础设施图表预测,到 2030 年 AI 数据中心需求将达到 327 GW,使讨论超越了模型发布或禁令本身。(来源)
- 模型退役正在成为治理问题。 Keep4o 获门户确认的联合国提交材料表明,连续性、无障碍访问和退役政策正在进入正式机构。(来源)