Twitter AI - 2026-07-02
1. 人们在讨论什么
1.1 商业护城河的讨论已上移到基础模型之上(🡕)
最有信息量的讨论,已经不只是哪个模型赢了基准测试,而是当模型已经好到可以互相替换、定价不同、访问还会被选择性限制时,持久价值到底落在哪里。四条高信号内容都指向同一方向:按任务路由模型、在模型之上构建应用层,并预期访问政策会直接塑造产品设计。
@anandmahindra 认为 (366 个赞,47 条回复,67,505 次浏览,170 次收藏) 认为,AI 有三层——算力、模型和应用——而关键基础设施不可能只靠模型就安全运行。其特别之处不在于“应用很重要”这句老生常谈,而在于他认为,拥有应用层就意味着拥有工作流知识、数据控制、可审计性以及模型选择权,而这正是持久商业优势所在。
@aiwithsally 将其表述为 (193 个赞,42 条回复,11,447 次浏览) 引用一场四模型对比作为“没有单一最佳 AI 模型”的证据:Fable 5 在输出质量上领先,GPT 5.5 的性价比最强,GLM 5.2 最便宜。这里的数据之所以重要,在于它把权衡变成了具体数字,而不只是口头说法;而回复很快又补上了第四个路由变量:延迟。
@slash1sol 强调 (37 个赞,15 条回复,827 次浏览,26 次收藏) 转述了 Mike Krieger 的说法:Claude Fable 5 在 SWE-Bench Pro 上达到 80.3%,在 Terminal-Bench 2.1 上达到 88.0%;随后又把这一进展翻译成“想法 -> 整个项目交接 -> 审查”的工作流。回复的价值在于,大家并没有太多质疑这一跃升本身,而是在追问:这种提升在什么情况下值得付出这个价格,以及当前版本是否比以前更受约束。
@deredleritt3r 报道称 (96 个赞,6 条回复,16,380 次浏览,32 次收藏) 称,美国官员正在讨论自愿性的前沿模型发布标准,包括针对具备网络攻击能力系统的基准、更明确的发布时间表和访问规则。这条内容把模型路由的讨论变成了运营约束:产品规划如今不仅要看模型质量,还要把模型可用性算进去。
讨论洞察: 回复不断把讨论从排行榜站队拉回到路由逻辑:语音和交易场景的延迟、单次成功结果的成本、“自愿”标准到底会不会产生约束,以及在模型可互换之后,应用层控制到底还有多重要。
与前一日比较: 2026-07-01 的前沿模型主线还是“受监管后的回归”与回退行为。到 2026-07-02,讨论又上移了一层:模型选择变成了受治理的应用栈内部的路由问题。
1.2 评估继续从基准测试扩展到机构与开放世界测试(🡕)
评估仍是最强的持续主题之一,而且范围再次扩大。讨论不再停留于回归检查或基准测试截图,而是开始涉及外部审计机构、持续一周的开放世界测试、基于轨迹的技能画像,甚至是会随着被测系统一起进化的评估器。
@prpaskov 宣布 (58 个赞,9 条回复,4,639 次浏览) 宣布加入 AVERI,担任首任标准总监,并明确把这个非营利组织定义为一项推动第三方前沿 AI 审计变得有效且普及的努力。AVERI 的发布材料把重点说得更尖锐:前沿实验室不该自己给自己的作业打分。
@sayashk 概述了 (7 个赞,426 次浏览,4 次收藏) 介绍了 CRUX #2:一项开放世界评估,考察智能体能否在持续一周的时间尺度上完成新颖 AI 研究,任务包括未发表论文相关问题、VM/GPU 预算和轨迹审查。这让评估目标比玩具基准或特定脚手架任务难得多。
@junfanzhu98 认为 (4 个赞,192 次浏览) 表示,Red Queen Godel Machine 更深一层的思想是递归评估:不只是让任务智能体进化,也让评估器共同进化,同时防止奖励黑客和评分标准老化。尽管互动量不高,这条内容仍然重要,因为它直接挑战了这样一种假设:智能体在变强时,裁判却可以保持不变。

@Steve_Yegge 称赞 (49 个赞,8,010 次浏览,50 次收藏) 介绍了 SkillBench:通过扫描编码智能体的轨迹来构建技能画像,并把 token 效率视为一个细粒度的技能发现问题,而不是含混的经验判断。公开仓库进一步说明,这是一项带有可运行任务的真实基准工作,而不只是关于智能体生产力的热评。
讨论洞察: 共同信念是:基准分数已经不够。人们想要的是外部审计、轨迹级证据、污染控制、持续一周的任务,以及在系统越来越擅长“钻测试空子”时依然站得住的评估设计。
与前一日比较: 2026-07-01,评估已经开始转向更严格的回归纪律和生产监控;到 2026-07-02,它又进一步扩展到机构、开放世界研究任务,以及关于评估器本身应如何演化的理论。
1.3 构建者继续把智能体收束为带预算、上下文和审批的工作流(🡕)
实操派构建者的讨论仍然更偏好狭义、可运行的操作系统,而不是宏大宣言。反复出现的信息是:有用的智能体需要有预算约束的工作流、持久上下文、恢复路径和明确的审批关卡,而不只是更好的提示词。
@startupideaspod 认为 (35 个赞,4 条回复,5,217 次浏览,69 次收藏) 认为,最好的 AI 智能体点子,起点是一份已经有人拿工资在做的工作:重复性强、终点清晰、边界情况已知,而且一旦出错会造成可见的业务损失。最有力的一条回复补上了缺失的护栏:只有当智能体能扛住接单、升级处理和后续跟进,而不是变成另一款需要人盯着的工具时,这套工作流才值得卖。
@TheEddyEth 表示 (28 个赞,31 条回复,130 次浏览) 表示,反复给 AI 重复上下文,改变了他评估工具的方式:在日常工作里,长期上下文比原始智力更重要。回复罕见地高度一致,很多人明确表示,宁要持久上下文,也不要更强推理。
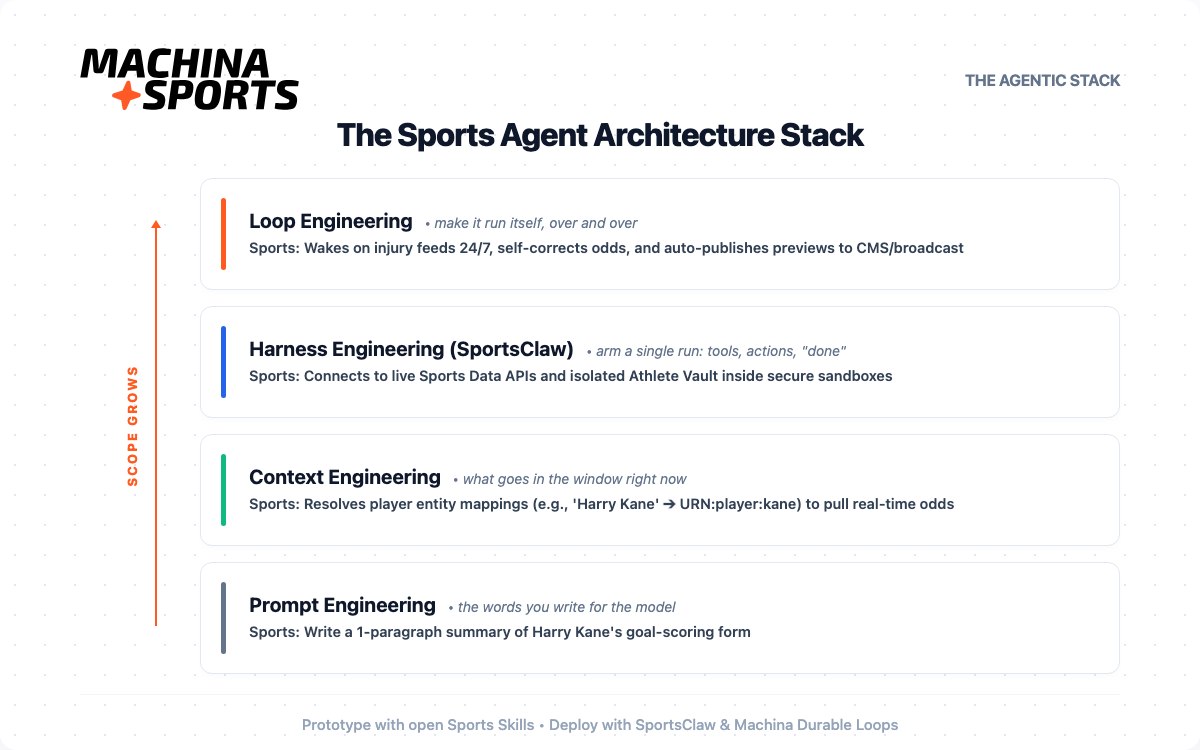
@_andreantonelli 分享了 (4 个赞,111 次浏览) 展示了一个“体育智能体架构栈”,把智能体工作拆成提示词、上下文、支撑框架和循环工程。图片把这个主张具体化,展示了实时实体解析、安全沙箱和 24/7 后台循环在垂直工作流中的实际位置。
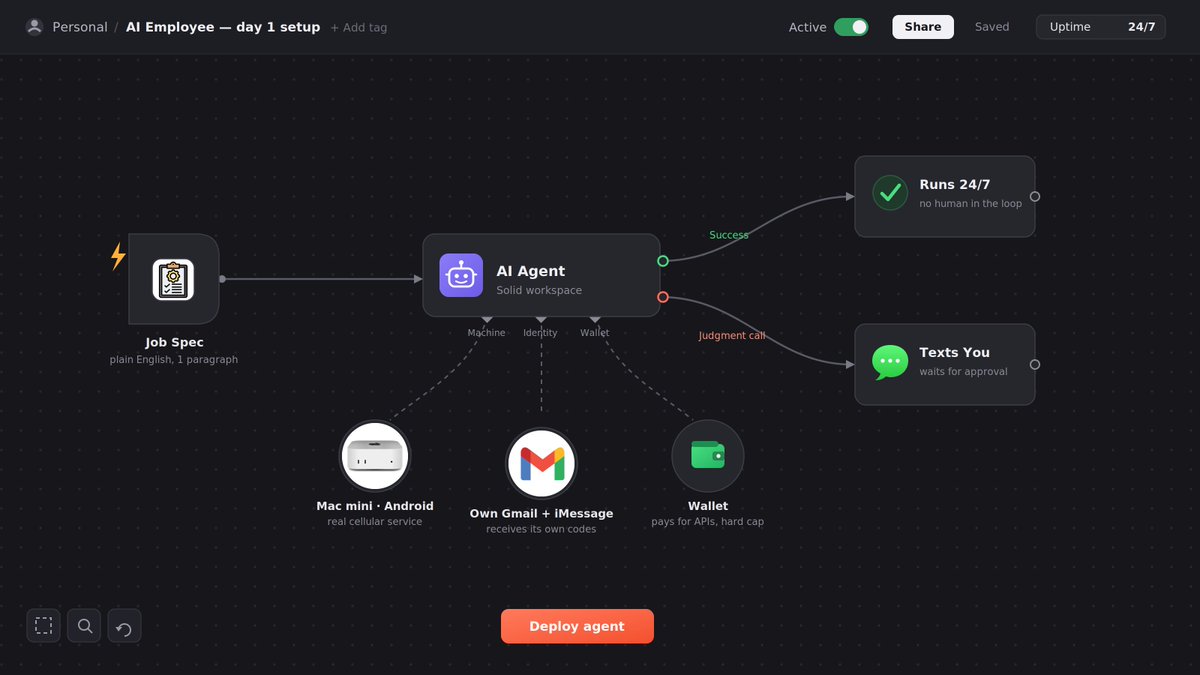
@MyWestLord 展示了 (2 个赞,2 条回复,322 次浏览) 展示了一个更偏运营的智能体工作空间设计:给智能体一台机器、一个身份、一个钱包、一个审批关卡,以及一条 24/7 运行路径。附带的工作流图是关键信号,因为它把“AI 员工”这种说法翻译成了 Gmail/iMessage 归属、支出上限和短信升级处理等具体组件。
@Jason 开启了 (111 个赞,27 条回复,23,495 次浏览,30 次收藏) 介绍了一个面向 AI 创业构建者的群聊。真正的信号在回复里:有人在做情境营销智能体,有人在做 Twitter 注意力追踪器,还有人在做“MCP 服务器的可观测性”。这正是当天构建者讨论中占主导的那种“工作流 + 基础设施”的混合形态。
讨论洞察: 最响亮的实操偏好是那种看似无聊的可靠性:有预算的工作流、长期上下文、清晰的审批边界,以及可恢复的失败状态。“它能不能在无人值守的情况下运行、还不增加额外工作?”出现得比“它是不是最聪明的模型?”更频繁。
与前一日比较: 2026-07-01,构建者已经在围绕隐私、记忆和窄工作流封装 AI;到 2026-07-02,这种封装变得更明确:循环、支撑框架、身份、钱包和审批关卡都成了一等构建模块。
1.4 开源套件继续出现在技术栈的每一层(🡕)
另一簇帖子显示,构建者在发布的是具体可用的套件,而不是泛泛的灵感。覆盖面的广度本身就很重要:教育、调查、移动 AI、机器人,以及链上智能体审计,都出现了可运行或可浏览的公开产物。
@amitiitbhu 分享了 (11 个赞,433 次浏览,7 次收藏) 介绍了一个开源教程仓库,内容从函数调用一路延伸到智能体循环、ReAct、记忆、编排、可观测性和评估。README 很清楚地表明,这不是一篇单独的博客文章,而是一个持续扩展的脚手架,面向那些想搞清这些部件如何拼在一起的人。
@VivekIntel 介绍了 (7 个赞,818 次浏览,10 次收藏) 介绍了 OSINT-D2,这是一款开源的智能体式 OSINT 工具,可通过自主调查、泄露检查、信任锚点和认知画像,把用户名和电子邮件转成结构化档案。公开 README 补上了关键实现细节:这是一款以 CLI 为主、支持多语言、可导出 PDF 或 JSON 报告的工具,而不只是一个概念帖。
@GithubProjects 重点介绍了 (10 个赞,2 条回复,4,067 次浏览,9 次收藏) 介绍了 OpenArm,这是一款用于高接触物理 AI 研究的开源 7DOF 人形机械臂。相关项目材料让这条内容在信息流里显得格外具体:标准化评估单元、ROS2 和仿真仓库,以及完整双臂系统 6,500 美元的报价。
@GithubProjects 还介绍了 (8 个赞,3,251 次浏览,7 次收藏) 介绍了 iOS GenAI Sampler,这是一个公开的 Swift 示例集合,涵盖 GPT-4o 对话、图像与视频理解、Perplexity 搜索,以及本地 Phi-3、Gemma 和 Mistral 模型。这是个很强的信号:构建者的工作面已不再只是后端智能体工具,移动端集成套件正在成为日常技术栈的一部分。
@wumpothere 分享了 (15 个赞,13 条回复,311 次浏览) 介绍了 Kansa Agent,这是一款面向 Mantle 的审计器,用于检查 ERC-8004 智能体注册文件是否完整、真实。公开 README 的重要之处在于,它展示了对 schema 完整性、端点健康状况、链上活动和注册表交叉引用的确定性检查,而不是空泛的“AI 信任”说法。
讨论洞察: 开源层正在以一种积极的方式分化。当天不是某个庞大的通用框架一统天下,而是人们在发布更窄的套件,把技术栈中某个具体切片做好。
与前一日比较: 2026-07-01,开源构建活力主要集中在智能体目录和法律 AI 等垂直工具;到 2026-07-02,公开产物已经更广泛地扩展到学习、移动端、机器人、调查和链上验证。
1.5 基础设施讨论继续聚焦部署经济学,而不只是更大的模型(🡒)
基础设施从未离开讨论,但重点从象征性的“AI 需求”叙事转向了部署机制:CPU 配比、内存占用、运行时成熟度,以及面向特定硬件的推理经济学。
@Jadzo1_ 汇编了 (18 个赞,60,715 次浏览) 汇总了 13 份关于“智能体 CPU”论点的卖方研究报告,并称到 2030 年,已有三个独立框架将服务器 CPU 的 TAM 估到 1,700 亿美元以上。附带的 BofA 表格把这一说法拆成收入、出货量、ASP,以及 ARM 或 x86 份额,让它变得可读,而不只是一个口号。

@TheValueist 认为 (1 条回复,422 次浏览) 认为,NVIDIA 的 Qwen3.6-35B-A3B-NVFP4 产物的重要性,与其说是一次模型事件,不如说是面向 Blackwell 级硬件的部署封装。附带幻灯片和公开模型卡在核心观点上是一致的:磁盘和 GPU 内存需求大约降低了 3.06 倍,但真实部署复杂度依旧存在,护城河更多在运行时工具和硬件适配,而不在模型本身。

讨论洞察: 最强的基础设施帖子并没有说“参数越多越赢”,而是在说推理经济学取决于整条路径:CPU 与 GPU 的比例、量化格式、运行时参数、硬件代际,以及工作流中到底有多少部分能被可靠封装并稳定提供服务。
与前一日比较: 2026-07-01,基础设施讨论更偏向主权技术栈和内存供应;到 2026-07-02,话题变得更偏运营:CPU 需求模型、Blackwell 专用封装,以及真实部署的经济学。
2. 什么让人感到沮丧
模型访问、定价和发布规则在真实工作流下不断变化
严重程度:高。@deredleritt3r 报道称 (96 个赞,6 条回复,16,380 次浏览,32 次收藏) 表示,前沿模型的发布标准和访问规则仍在积极协商中,这意味着“可用性”不再是默认背景条件。@aiwithsally 展示了 (193 个赞,42 条回复,11,447 次浏览) 表示,质量、成本和延迟如今正把模型选择拉向不同方向;@slash1sol 记录了 (37 个赞,15 条回复,827 次浏览,26 次收藏) 则体现了进一步的不满:即便模型更强,也仍需证明价格合理,并解释可能带来的工作流约束。常见应对方式是按任务路由,而不是押注单一供应商。这个方向值得构建,因为它把政策风险、延迟、定价和工作流可靠性叠加在了一起。
当工具在轮次之间忘记任务时,原始智能并不够用
严重程度:高。@TheEddyEth 写道 (28 个赞,31 条回复,130 次浏览) 表示,反复向 AI 重复上下文,改变了他的评估标准,而回复几乎一致选择了长期上下文,而不是更强推理。@startupideaspod 认为 (35 个赞,4 条回复,5,217 次浏览,69 次收藏) 表示,真正胜出的智能体工作流是那些终点清晰、恢复路径可接受的;其中一条回复还补充说,当影响半径很大时,“先起草、后确认”的模式更安全。@MyWestLord 展示了 (2 个赞,2 条回复,322 次浏览) 表示,构建者正在通过明确的身份、钱包和审批层来补这个缺口。这个方向值得构建,因为人们已经在围绕这道缺口拼接记忆和交接控制,而不是继续盲信基础助手。
真实的智能体评估仍然昂贵、缓慢,而且很容易做错
严重程度:高。@sayashk 描述了 (7 个赞,426 次浏览,4 次收藏) 介绍了持续一周的 CRUX 评估,并采用未发表论文相关任务,原因正是更简单的设置太容易被污染或过拟合。@Steve_Yegge 表示 (49 个赞,8,010 次浏览,50 次收藏) 表示,SkillBench 之所以重要,是因为 token 效率和智能体质量应通过轨迹级技能画像来理解,而不是依赖松散启发式。@junfanzhu98 认为 (4 个赞,192 次浏览) 表示,随着智能体变强,固定评估器本身会成为瓶颈;@prpaskov 将其联系到 (58 个赞,9 条回复,4,639 次浏览) 则把同样的痛点投射到第三方审计标准上。这个方向值得构建,因为多条独立内容都指向同一项运营负担:衡量真实能力如今已成为一个系统问题。
隐蔽或无法核验的 AI 使用会立刻引发信任反噬
严重程度:中高。@beaubyler 声称 (1,437 个赞,5 条回复,13,392 次浏览,41 次收藏) 表示,一篇被包装成人类创作的小说,其 HTML 中暴露出了 AI 痕迹;回复把这视为硬证据,而不是风格层面的猜测。在构建者一侧,@wumpothere 构建了 (15 个赞,13 条回复,311 次浏览) 介绍了 Kansa Agent,用于测试链上智能体注册文件是否完整、真实。这是同一个信任问题在另一领域的体现。绕行办法是可验证性:日志、公开检查、确定性审计,或可供外部查看的公开产物。这个方向值得构建,因为一旦信任滑坡,社会层面的惩罚往往比任何模型质量争论来得更快。
3. 人们希望存在什么
稳定的模型访问,以及清晰的任务路由经济学
最明显的现实需求,不是某个唯一的冠军模型,而是稳定访问强模型,并拥有足够清晰的定价、延迟和政策信息,能够放心地做任务路由。@aiwithsally 展示了 表示,模型选择已经取决于质量、成本和延迟;@deredleritt3r 展示了 则表示,连访问规则本身都在变成变量。这是一项会直接影响工作流和预算的现实需求。机会:直接。
能在真实工作中持续存在的上下文,而不是一次性聊天
@TheEddyEth 做出了 (28 个赞,31 条回复,130 次浏览) 把这个需求说得很明确:能理解用户正在做什么的工具,比只在孤立推理上更强的工具更有价值。回复强烈强化了这一偏好,而 @startupideaspod 补充说 则指出,智能体工作流还需要可控的失败与恢复路径。这是直接的运营需求,而不是一种理想化愿景。机会:直接。
带有身份、支付与审批关卡的智能体操作系统
最强的构建者帖子隐含着一点:“智能体”这个词仍不足以描述真正需求。@MyWestLord 展示了 展示了一种围绕自身机器、通信身份、钱包和升级路径构建的智能体设置;@_andreantonelli 拆解了 则把体育智能体拆成提示词、上下文、支撑框架和循环工程。人们看起来想要的,不只是更强智能,而是一个带权限、带状态、并设有安全人工检查点的运行时。机会:直接。
值得信任的第三方审计与评估系统
@prpaskov 加入了 专门介绍了 AVERI 为独立前沿 AI 审计建立标准;@sayashk 推动了 指向开放世界研究评估;@Steve_Yegge 指出 则指向基于轨迹的技能画像。这个需求既现实又紧迫:人们想要的是能够顶住优化压力、污染风险和产品营销的证据。机会:直接。
把“AI 工程师”从一种感觉变成一条路径的结构化提升体系
信息流里还出现了一个更柔性但持续存在的需求:清晰的学习阶梯。@ai_explorer25 发布了 (54 个赞,30 次转发,891 次浏览) 展示了一条从编程和数据工作,经由 ML、NLP、GenAI、MLOps,到系统设计的路线图;@amitiitbhu 链接了 则介绍了一个涵盖智能体基础、循环、记忆、编排和评估的公开教程系列。这一需求一部分是实用的,一部分也带有竞争属性,因为很多人都想获得这条路径,但最终赢家的形式仍未定。机会:竞争性。

4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Fable 5 | LLM | (+/-) | 编码能力强、长时程基准结果突出;在多条帖子里被视为质量上限 | 价格高、可能比以前更受约束,且受发布政策摩擦影响 |
| GPT 5.5 | LLM | (+) | 在引用的并列测试中,相对 Fable 5 具备很强的性价比论据 | 并不总被视为质量最高的选项 |
| SkillsBench | 基准 / 评估 | (+) | 基于轨迹的技能画像,以及面向智能体行为的任务型评估 | 仍是较早期的基准面;本数据集中最强主张仍主要来自倡导者 |
| CRUX + OpenClaw + Opus 4.8 | 开放世界评估框架 | (+) | 持续一周的任务、污染控制、轨迹审查和研究级难度 | 成本高、速度慢;公开结果数据尚未分享 |
| AVERI | 审计标准 | (+) | 推动前沿 AI 的独立审计和正式标准 | 仍处于机构建设阶段,而非可即用的运营工具 |
| SportsClaw / Machina Sports stack | 垂直智能体支撑框架 | (+/-) | 在真实垂直领域里,清晰拆分提示词、上下文、支撑框架和循环层 | 目前证据仍主要来自一位构建者的框架化阐述 |
| Solid workspace | 智能体运营平台 | (+/-) | 真实机器、身份、支付、审批与 24/7 执行路径 | 产品主张很具体,但在本数据集中验证仍然有限 |
| OSINT-D2 | 智能体式 OSINT | (+) | 多源身份关联、泄露检查、信任锚点、认知画像和报告导出 | 运营复杂度与调查风险顾虑仍在 |
| Qwen3.6-35B-A3B-NVFP4 | 量化开放权重模型 | (+/-) | 更低内存占用、长上下文、多模态,以及面向 Blackwell 的部署封装 | 运行时复杂度与硬件特异性限制了便捷迁移 |
| OpenArm | 物理 AI 平台 | (+) | 可复现的评估环境、开放硬件技术栈和相对较低的系统成本 | 更像研究平台,而不是可直接部署的商用机器人方案 |
| iOS GenAI Sampler | 移动开发套件 | (+) | 提供覆盖 GPT-4o 与 iOS 本地模型的具体 Swift 示例 | 更偏示例集合,而不是生产级框架 |
| AI Agents Tutorial | 学习资源 | (+) | 从函数调用到循环、记忆、编排和评估,路径清晰 | 是教学脚手架,不是运行时系统 |
| Kansa Agent | 智能体审计应用 | (+) | 针对实时 Mantle 活动,对智能体元数据真实性做确定性检查 | 范围较窄,且依赖特定网络 |
整体满意度光谱相当务实。人们对那些把问题某一层做具体的工具持积极态度——无论是基准测试、审计、移动端集成、机器人、OSINT,还是工作流封装;而对任何仍依赖不稳定模型访问或未经验证产品主张的东西,则态度更复杂。最清晰的迁移趋势,是从“以提示词为中心”的思维转向上下文、支撑框架、循环和审批设计。竞争态势也明显更尖锐:模型选择越来越由成本、延迟和任务匹配度来路由,而部署栈之间的竞争点,则转向运行时、硬件适配和信任保证,而不再只是模型本身的神秘光环。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| SkillsBench | @Steve_Yegge | 对 AI 智能体的技能使用能力做基准测试,并分析轨迹行为 | 智能体质量判断过于松散,且 token 效率缺乏可见性 | BenchFlow、任务包、智能体轨迹 | Beta | 帖子 · 仓库 |
| AI Agents Tutorial | @amitiitbhu | 从函数调用到评估的分步公开学习路径 | 缺乏学习现代智能体系统的清晰顺序 | GitHub 文档、博客、视频 | Shipped | 帖子 · 仓库 |
| OSINT-D2 | @VivekIntel | 可将用户名和电子邮件转成档案的智能体式 OSINT CLI | 跨平台身份关联依赖手工操作且支离破碎 | Python、Poetry、LLM providers、ScrapingAnt proxies | Beta | 帖子 · 仓库 |
| OpenArm | @GithubProjects | 开源 7DOF 人形机械臂与可复现评估单元 | 需要价格可承受、可复现的物理 AI 研究硬件 | Open hardware、ROS2、Isaac Lab、MuJoCo | Beta | 帖子 · 仓库 |
| iOS GenAI Sampler | @GithubProjects | 提供 iOS 上 GPT-4o 与本地模型能力的 Swift 示例 | 避免每次都从零重做基础移动 GenAI 集成 | Swift、GPT-4o、Phi-3、Gemma、Mistral、Perplexity | Shipped | 帖子 · 仓库 |
| Kansa Agent | @wumpothere | 根据实时 Mantle 活动审计 ERC-8004 智能体注册文件 | 智能体声明可能不完整或不诚实 | Next.js、TypeScript、viem、@mantleio/mantle-core | Beta | 帖子 · 仓库 |
| Machina Sports / SportsClaw stack | @_andreantonelli | 为体育智能体提供带上下文、支撑框架与循环层的垂直栈 | 通用提示词无法处理碎片化的实时体育数据与工作流 | Sports data APIs、secure sandboxes、loop orchestration | Beta | 帖子 |
| Solid workspace | @MyWestLord | 拥有自身机器、身份、钱包和审批流的智能体工作空间 | 沙箱智能体在生产环境中无法验证、支付或无人值守运行 | Real device or server、Gmail/iMessage、wallet、approval routing | Beta | 帖子 |
SkillsBench 之所以突出,在于它把 token 效率重新定义成一个测量问题,而不只是对定价的抱怨。仓库通过公开任务与轨迹结构,让“智能体技能可以被基准化、被组合,而不是靠猜”的主张更可信。
OSINT-D2 和 Kansa Agent 虽然来自不同领域,却指向同一个方向:验证与证据。OSINT-D2 把自主身份调查封装成 CLI 工作流;Kansa 则检查智能体的公开声明是否与其实时端点和链上活动一致。两者都是构建者试图用可检查输出取代“相信我,这就是 AI”的例子。
OpenArm 和 iOS GenAI Sampler 则展示了技术栈向外扩展。OpenArm 把物理 AI 研究封装成开放、可复现的硬件与仿真表面;iOS GenAI Sampler 则为云端和本地模型封装了移动集成模式。反复出现的构建模式已经很清楚:人们正在按环境逐个发布更窄、更具体的套件,而不是再讲一个抽象的“AI 平台”故事。
SportsClaw 和 Solid 代表了另一种反复出现的构建触发器:智能体在演示层面已经不再足够有趣,开始需要运行时结构。尽管一个来自垂直体育工作流,另一个来自更通用的“AI 员工”框架,但两条内容都收敛到了同一组操作原语——上下文、支撑框架、循环、身份、支付和审批。
6. 新鲜且值得关注的内容
预测仍然跑在公开基准现实之前
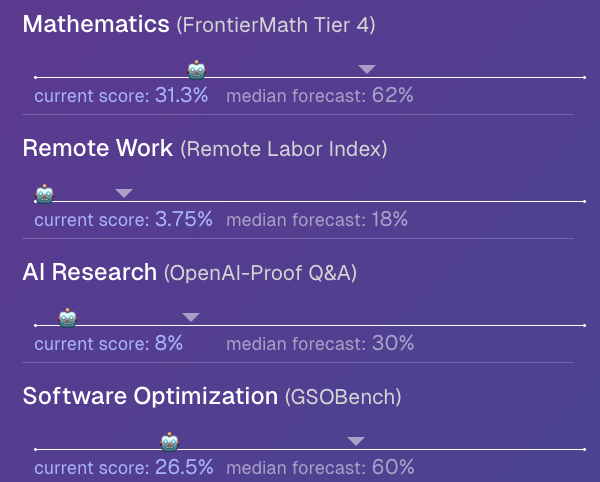
@GregHBurnham 查看了 (15 个赞,2 条回复,540 次浏览) 对比了当前公开结果与 AI 2026 预测调查,并附上了一张紧凑的基准差距图。图像本身就是信号:FrontierMath 为 31.3%,而预测中位数为 62%;Remote Labor Index 为 3.75%,而预测为 18%;OpenAI-Proof Q&A 为 8%,而预测为 30%;GSOBench 为 26.5%,而预测为 60%。这对当天更强烈的“整项目交接”叙事和基础设施兴奋情绪形成了有益制衡。
AI 被用来衡量科学论断在发表前会变化多少
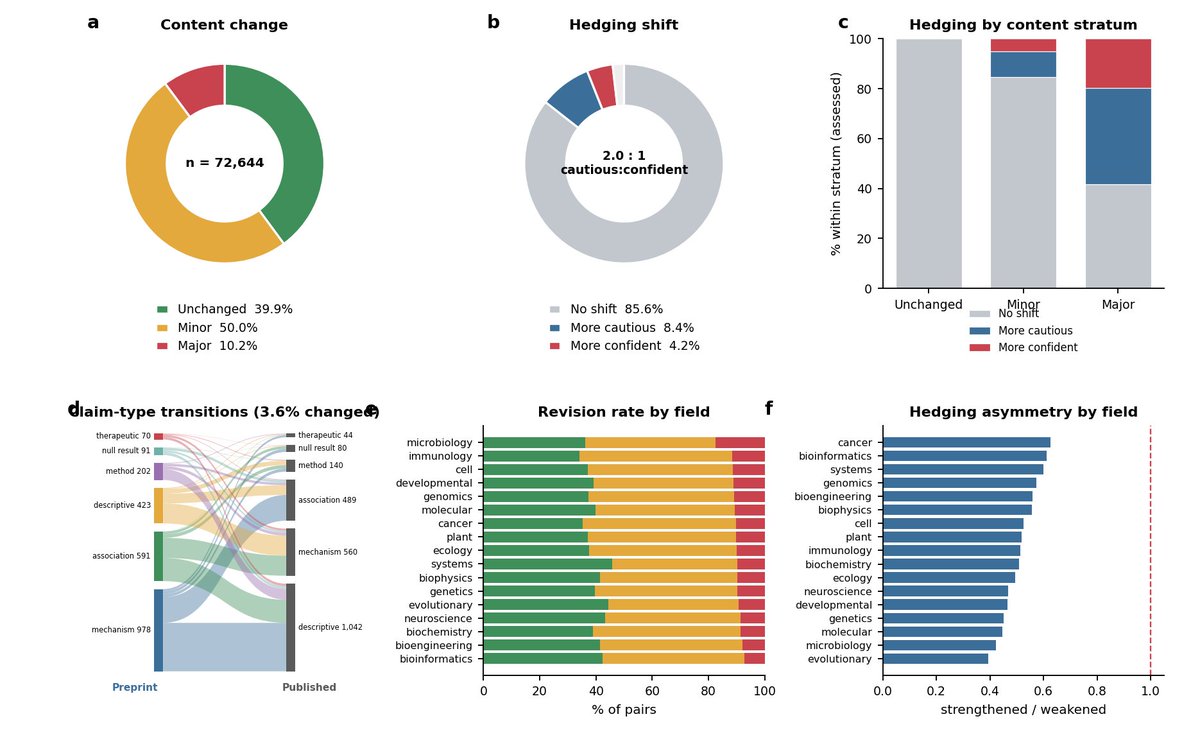
@rust_ruslan 报道称 (43 个赞,4 条回复,16,364 次浏览,14 次收藏) 介绍了一项研究:使用大语言模型比较了 2018 到 2025 年间全部 72,644 对可获得的 bioRxiv 到期刊论文配对。附图给出了核心证据:39.9% 的论断没有变化,50.0% 只发生轻微变化,10.2% 发生重大变化;而更谨慎的修订大约是信心增强型修改的两倍。
LLM 记忆中的品牌权威有了公开测量框架
@dejanseo 分享了 (23 个赞,863 次浏览,9 次收藏) 介绍了一套利用回忆调查和关联图上的 PageRank 来衡量模型记忆中品牌权威度的方法。相关文章补充了关键细节:该系统运行了 200,000 次 Gemini 回忆测试,在 290 万个品牌节点上构建图,并在计算权威分数前,从种子集合中人工移除了 2,163 个无效伪影。这是一个值得注意的例子,说明人们正在把模型记忆当作一种可测量、可查询、可排序的对象。
7. 机会在哪里
[+++] 真实世界智能体评估与审计基础设施 — 这一信号几乎无处不在:AVERI 在标准化外部审计,CRUX 在测试持续一周的研究任务,SkillsBench 在分析轨迹行为,RQGM 主张评估器也应演化,Kansa 则在检查公开智能体声明是否真实。这个机会很强,因为痛点横跨多个环节,而且成本已经很高。
[++] 保留上下文、带审批关卡的智能体工作空间 — TheEddyEth 的帖子、startupideaspod 的回复、Solid 的工作流图,以及 Anand Mahindra 关于应用层的框架,都指向同一个缺口:人们需要能记住上下文、遵守控制并安全升级处理的系统。这是中等机会,因为需求很明确,但赛道也会很拥挤。
[++] 面向特定环境与工作流的窄型开源套件 — AI Agents Tutorial、OSINT-D2、OpenArm、iOS GenAI Sampler 和 SportsClaw 都是通过封装技术栈中一个可用切片而获得关注,而不是承诺一个通用平台。这个机会中等,因为移动端、机器人、调查和垂直智能体的需求都已可见,但差异化会取决于分发与执行。
[+] 面向模型与硬件路由的部署经济学可观测性 — Fable 与 GPT 的权衡帖子、“智能体 CPU”TAM 主题,以及 NVFP4 部署讨论,都指向一个日益增长的需求:需要把基准质量与延迟、运行时适配、内存使用和成本连接起来的工具。这个方向仍在早期,但证据表明,随着团队在多个模型和硬件路径间做路由,它会越来越重要。
8. 结论
- 模型选择正在变成路由,而不是忠诚。 最强的帖子把质量、价格、延迟和政策访问视为彼此独立的变量,而不是排行榜上的单一赢家。(来源)
- 评估正在固化为技术栈中的独立一层。 第三方审计标准、开放世界研究评估和基于轨迹的技能画像在同一天的信息流中同时出现,这比单次基准争论更有说服力。(来源)
- 构建者正在围绕上下文、身份和审批来封装智能体。 最实用的构建不是通用副驾,而是带有循环、支撑框架、钱包、通信身份和明确人工检查点的系统。(来源)
- 开源构建活力仍然最高的地方,是产物足够具体的地方。 教程、OSINT 工作流、移动 GenAI、机器人和链上智能体审计的公开仓库,比含糊的平台宣称传递了更多信号。(来源)