Twitter AI - 2026-07-04
1. 人们在讨论什么
1.1 前沿模型正像“架构师”一样,被嵌入更便宜、更结构化的工作流中(🡕)
最强的一波讨论,并不围绕某个单一基准测试的赢家,而是聚焦于:昂贵的前沿模型时间,到底应该花在什么地方。共识是把它用在规划、判断和艰难决策上,而把周边那些重复性的执行工作交给更便宜的模型和更严密的编排框架。
@aniketapanjwani 报道称 (254 个赞,12 条回复,45,046 次浏览,219 次收藏) 表示,Fable 在软件、经济学和职业规划类仓库中给出了异常强的产品层和战略层建议,但最佳工作流仍然是把实现交给 Opus 或 Codex。其独特之处在于,模型的价值不在于原始“打字速度”,而在于在获得足够上下文后展现出的高层判断力。
@RoundtableSpace 认为 (88 个赞,14 条回复,52,495 次浏览,63 次收藏) 认为,Fable 5 应该被当作 CTO,而不是默认执行者:日常工作降低 effort level,让更便宜的模型去做调研和执行,只有当便宜模型卡住时,才升级到顾问式介入。回复把这种痛点说得更具体:一名用户表示,如今的订阅产品正迫使人们兼职充当优化工程师,只为避免被自己的使用量“宰”。
@tbrownio 总结道 (37 个赞,4 条回复,2,753 次浏览,30 次收藏) 将 AI Engineer World's Fair 概括为一种从“放手让智能体自己跑”转向结构化方法的变化:先定义最终状态,让人类保留在外层监督环节,按单项任务成本评估模型,并把技能、评测和 wiki 视为可移植资产。其实际信息与前两条讨论一致:没有边界的自主性,制造低质产出的速度会快于创造杠杆的速度。
讨论洞察: 分歧并不在于前沿模型是否强大,而在于工作流中到底有多少环节值得接触昂贵模型,以及当系统长时间连续运行时,还需要保留多少人工审查。
与前一天相比: 在 2026-07-03,信息流主要关注循环、记忆和降账单这类运行时组件。到 2026-07-04,这种讨论已经成熟为明确的操作手册:规划器—执行器拆分、effort 调节,以及以人为中心的工作流治理。
1.2 上下文、记忆和更丰富的输入,正变得比单纯切换模型更重要(🡕)
第二组讨论把记忆和上下文视为真正的产品界面。反复出现的抱怨是,每一轮都从零开始,既浪费钱,也浪费判断力。因此,构建者正在寻找办法,在跨会话中保留工作成果,并向智能体输入更丰富的任务状态。
@omarsar0 解释道 (32 个赞,1 条回复,5,189 次浏览,34 次收藏) 介绍了一套多模态提示工作流:记录语音、屏幕标注和点击轨迹,对其进行预处理,再把它们转化为可复用的技能。他的独特观点是,即便是较老的模型,只要拿到更丰富的任务上下文,而不是一条干巴巴的文本提示,也会没那么令人沮丧。
@vladuah 描述道 (18 个赞,3 条回复,391 次浏览,12 次收藏) 将 Hermes Agent 与 NotebookLM 结合为一个“24/7 自我改进的研究系统”:它可以读取个人资料库、交叉引用文档,并累积理解,而不是每次任务都从零开始。虽然信号较小,但产品形态异常具体。
@tbrownio 补充道 (37 个赞,4 条回复,2,753 次浏览,30 次收藏) 认为,如今最有效的记忆系统会使用明确的记忆保存工具,再加上一道综合提炼步骤;而可移植的技能、评测、数据和 wiki,比把自己绑定在某一个框架上更重要。
讨论洞察: 信息流已经把“更好的提示词”视为一个基本解决了的框架。更难的问题是持久上下文:如何一次捕获任务状态,把它保存下来,并让它能在长周期工作中反复复用。
与前一天相比: 在 2026-07-03,记忆主要表现为长会话中的一种失效模式。到 2026-07-04,它已经表现为产品设计问题:多模态任务捕获、持久知识库,以及可移植的上下文资产。
1.3 开源模型和通用模型,继续在对抗专业化技术栈中提升可信度(🡕)
开源模型和通用模型的论据变得更具体了。信息流不再只是抽象地谈“商品化”,而是出现了一个生态规模的采用信号,以及一个特定领域的基准信号,说明人们越来越不愿意把自己锁定在狭窄的垂直技术栈里。
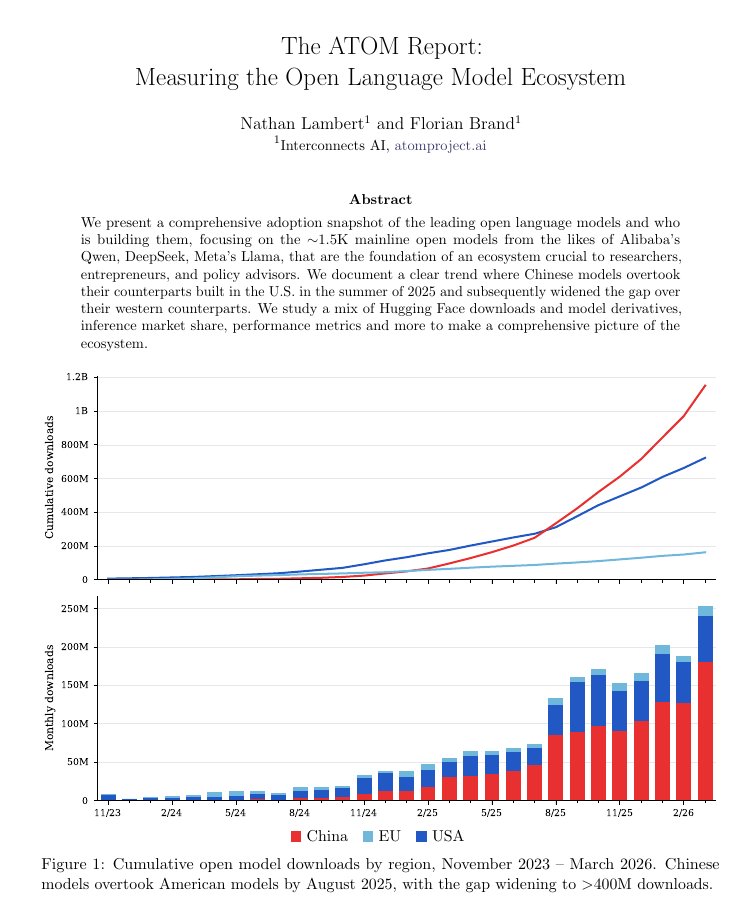
@rohanpaul_ai 分享了 (22 个赞,4 条回复,2,951 次浏览,9 次收藏) 转述了 ATOM Report 的说法:中国开源模型在 2025 年夏季的累计下载量已超过美国模型,并在 2026 年 3 月达到 11.5 亿次可追踪下载,而美国模型为 7.23 亿次。该帖的独特论点是,Qwen 的胜出并不是靠某一个爆款模型,而是靠成为跨多种规模、可反复复用的默认模型家族。
@DrEliDavid 指出 (186 个赞,16 条回复,14,824 次浏览,63 次收藏) 转述了一项 Nature Medicine 结果:通用 LLM 在 MedQA、HealthBench,以及一个由 100 条去标识化医生问询构成的真实临床查询基准上,表现优于专业临床 AI 工具。回复中的细节比标题本身更有价值:一名回复者指出,更强的基础模型并不能解决自动化偏差;与不断变化的前沿服务相比,冻结的专业检查点仍然更容易验证。

@tbrownio 还指出 (37 个赞,4 条回复,2,753 次浏览,30 次收藏) 认为,开源模型如今已经足够接近前沿系统,可以与更昂贵的模型配合,承担强度较低的工作。
讨论洞察: 支持开源或通用模型实力的证据确实更强了,但回复也表明,能力胜出并不能消除治理问题。验证、部署纪律和模型漂移仍然重要。
与前一天相比: 在 2026-07-03,开源模型的叙事主要围绕主权、应用层价值和价格压力。到 2026-07-04,它已经有了采用曲线和专业领域基准证据的支撑。
1.4 成本压力在 GPU 和 token 两层依然清晰可见(🡒)
经济性叙事并未降温。信息流显示,人们现在同时在优化两种不同的稀缺面:模型栈底层的原始算力成本,以及在模型栈中流动的 token 和上下文成本。
@Silicon_Data 认为 (36 个赞,1 条回复,18,780 次浏览,35 次收藏) 认为,不应把 Meta 出售算力的传闻解读为需求崩溃,因为 H100 租赁期限曲线是在上升并趋平,而不是在为供应过剩定价。随附图表让这一点更直观:图中的 12 个月期价格,从 2025 年末每 GPU 小时约 $1.80,上升到 2026 年 7 月 2 日约 $2.38。

@sairahul1 强调了 (19 个赞,10 条回复,3,218 次浏览,26 次收藏) 介绍了一个开源压缩层,并称它可以在日志、JSON 和代码抵达模型前先在本地缩小,从而将 Claude API 成本最多削减 95%。公开的 Headroom 仓库支撑了更广泛的判断:即便这条社交媒体上的具体说法仍需独立复现,上下文压缩也正在成为一种共享基础设施类别,而不再只是一次性的提示词技巧。
讨论洞察: 信息流里没有任何“资源充裕”的迹象。相反,优化前沿正在向外扩展:先控制哪个模型做哪项工作,再削减真正送到模型那里的上下文体积,而底层 GPU 市场看起来仍然紧张。
与前一天相比: 在 2026-07-03,经济性主要体现为模型选择器里的可见价格和会话压缩基准。到 2026-07-04,讨论已扩展到数据中心租赁曲线和本地优先的 token 压缩工具。
2. 什么让人沮丧
为前沿智能付费,如今意味着要精细管理支出、上限和路由
严重程度:高。@RoundtableSpace 写道 (88 个赞,14 条回复,52,495 次浏览,63 次收藏) 表示,Fable 用户必须主动降低 effort、拆分规划与实现,并避免用昂贵模型做调研。@aniketapanjwani 报道称 (254 个赞,12 条回复,45,046 次浏览,219 次收藏) 展示了真实使用中的类似“规划优先”模式,而其中一条回复还呼吁,在临时的 50% 可用性上限之外,提供更高额度。@sairahul1 补充道 (19 个赞,10 条回复,3,218 次浏览,26 次收藏) 表明,压缩工具已经足够有吸引力,能围绕降低 Claude 成本引发大规模关注。应对模式已经很清晰:激进地路由任务、压缩上下文,并把最昂贵的模型留给高杠杆决策。这值得围绕它构建产品,因为这种痛点同时混合了定价、用户体验摩擦和操作员注意力浪费。
智能体在任务、会话和模态之间仍然丢失过多上下文
严重程度:高。@omarsar0 表示 (32 个赞,1 条回复,5,189 次浏览,34 次收藏) 表明,多模态任务捕获通过预先提供更完整的任务状态,减少了令人沮丧的交互。@vladuah 提出了 (18 个赞,3 条回复,391 次浏览,12 次收藏) 介绍了一套由 NotebookLM 支撑的研究栈,正是因为智能体太常从零开始。@tbrownio 总结道 (37 个赞,4 条回复,2,753 次浏览,30 次收藏) 则显示,这种痛点在大会规模的讨论中也同样存在:记忆系统、可移植技能和持久上下文,如今已经是一等工作流组件。人们正在通过围绕模型构建个人知识层和可复用技能来应对。这值得围绕它构建产品,因为这一问题同时出现在研究、编程和智能体运营中。
基准测试胜利,仍不足以化解高风险领域的部署风险
严重程度:高。@DrEliDavid 声称 (186 个赞,16 条回复,14,824 次浏览,63 次收藏) 表明,专业医疗 LLM 已经开始输给通用前沿模型,并有公开的 Nature Medicine 研究作为支撑。但最有力的一条回复把这种沮丧又往深处推进了一层:如果临床医生只是对输出照单全收,而模型又会在部署后漂移,那么单纯的能力提升并不能形成可信的临床工作流。当前的应对方式是独立评估、尽可能使用冻结产物,并保持谨慎的人类审查。这值得围绕它构建产品,因为痛点不只是“哪个模型更强”,而是“究竟什么能够被验证并保持恒定”。
仍然没有可信的方法来裁决智能体之间的模糊争议
严重程度:中。@lami_thefirst 认为 (35 个赞,11 条回复,1,412 次浏览,9 次收藏) 认为,一旦一方自动化参与者说“你骗了我”,另一方说“去看合同”,智能体经济就需要一个快速裁决层。回复立刻强调了各种失效场景:验证者偏见、数据源被操纵、串通,以及智能体为了讨好裁判而不是遵守交易条款去优化。当前的应对策略基本还是回避:让合同尽可能狭窄且确定。这个方向值得构建,但仍处在早期,而且争议很大。
3. 人们希望出现什么
能跨模型变更存续并持续积累知识的持久上下文层
最明确的实际需求,并不是孤立的“更聪明的模型”,而是一个可靠的上下文层:它能够保留任务状态、复用过往工作,并在底层模型发生变化时依然保持知识可用。@omarsar0 展示了 (32 个赞,1 条回复,5,189 次浏览,34 次收藏) 展示了通过多模态任务记录实现这一点的一条路径,而 @vladuah 展示了 (18 个赞,3 条回复,391 次浏览,12 次收藏) 展示了另一条通过 NotebookLM 支撑研究记忆的路径。@tbrownio 进一步印证了 (37 个赞,4 条回复,2,753 次浏览,30 次收藏) 则用同样的思路,把技能、评测、数据和 wiki 视为可移植资产。机会:直接。
能自动判断何时该动用昂贵模型的编排系统
人们正在公开要求这样的系统:它知道什么时候值得为前沿推理花钱,什么时候不值得。@aniketapanjwani 描述道 (254 个赞,12 条回复,45,046 次浏览,219 次收藏) 展示了一种工作流:由 Fable 负责判断,由更便宜的模型负责实现。@RoundtableSpace 提出了 (88 个赞,14 条回复,52,495 次浏览,63 次收藏) 则把这一架构明确化为低 effort 模式、更便宜的研究执行者和顾问式升级。这个需求是紧迫的运营需求,而不是投机性的。机会:直接。
面向受监管 AI 的独立、固定版本评估
Nature Medicine 这条讨论让一个更窄但重要的需求变得可见。@DrEliDavid 披露了 (186 个赞,16 条回复,14,824 次浏览,63 次收藏) 提供了通用前沿模型击败专业临床工具的证据,但回复讨论很快转向了模型漂移、自动化偏差和可重复验证所缺失的基础设施。人们似乎想要的,不只是一个更好的医疗模型,而是一种能够固定行为、审计变更,并围绕稳定产物验证部署的方法。机会:竞争性。
面向自主交易的快速争议解决层
这是一个规模较小但很有辨识度的需求。@lami_thefirst 将其概括为 (35 个赞,11 条回复,1,412 次浏览,9 次收藏) 把这一缺口称为智能体经济中的“无需信任裁决”,而回复则给出了围绕模型许可、物流腐损和隐私争议的具体案例。数据表明,这个需求真实存在,但在设计上仍高度有争议。机会:理想型。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Fable 5 | 前沿 LLM | (+/-) | 产品层判断、规划和高上下文推理能力强 | 成本高、容量有限,且常被认为不适合日常执行 |
| 规划器—执行器路由 | 工作流方法 | (+) | 把昂贵推理留给架构设计,让更便宜的模型做实现或调研 | 需要严格的编排纪律,也可能把复杂性转嫁给用户 |
| Headroom | 上下文压缩 | (+) | 本地优先压缩日志、JSON、代码、文件和历史记录;支持可逆检索,以及 library、proxy 和 MCP 模式 | 节省幅度的说法很吸引人,但仍需在更多工作负载上得到更广泛的独立验证 |
| Qwen 家族 / 开源模型 | 开源 LLM 家族 | (+) | 覆盖多种规模、生态复用性强、部署成本低 | 在更难、判断负担更重的工作上,仍常与前沿模型搭配使用 |
| Hermes Agent + NotebookLM | 研究记忆栈 | (+) | 让智能体持续访问个人资料库,并拥有可累积的研究上下文 | 目前证据仍主要来自实践者,且高度依赖具体配置 |
| 多模态任务捕获 | 工作流方法 | (+) | 更丰富的任务状态可减少歧义,并使可复用技能成为可能 | 增加了预处理、录制和整理的开销 |
| DeepZero | 安全研究框架 | (+) | 支持 YAML 定义流水线、并行、可恢复运行、LiteLLM 集成和可复用处理器 | 只是框架;仍需要语料、规则和流水线设计才能产出价值 |
| 临床评估中的通用前沿 LLM | 医疗 AI 方法 | (+/-) | 在公开论文中相较专业工具取得了强基准表现 | 验证、漂移控制和临床监督仍未解决 |
整体满意度呈现出一种务实取向。人们喜欢的工具和方法,要么能保留稀缺上下文,要么能减少稀缺支出。迁移模式也很一致:用开源或更便宜的模型做解析、搜索和批量执行;把最强的前沿模型留给规划或边缘情况推理;再用压缩、记忆和可复用技能把两者包起来。竞争态势正在从基础模型之上,转移到路由、上下文管理和基础设施层——由这些层来决定模型最终能看到什么。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Headroom | headroomlabs-ai via @sairahul1 | 在工具输出、日志、文件、代码和对话历史抵达 LLM 前先进行压缩 | token 密集型工作流让强模型在日常使用中变得过于昂贵 | 本地优先的上下文压缩,library/proxy/MCP 模式,内容感知压缩器,可逆缓存 | 已发布 | 仓库 |
| DeepZero | 416rehman via @VivekIntel | 把长期漏洞研究工作流作为 YAML 流水线运行,而不是依赖临时脚本 | 没有可恢复的编排和可复用阶段时,大规模软件分析会很脆弱 | Python 3.11+、LiteLLM、Jinja2、Ghidra、Semgrep、REST API、YAML 流水线 | Beta | 仓库 |
| Hermes Agent + NotebookLM skill | @vladuah | 把智能体连接到一个持久化、由 NotebookLM 支撑的个人知识库 | 研究型智能体太常从零开始,并丢失累积上下文 | MCP、NotebookLM skill、资料库检索、累积记忆 | Beta | - |
| GenLayer 裁决流程 | @GenLayer via @lami_thefirst | 使用 intelligent contracts 和验证者共识来解决智能体之间的模糊争议 | 确定性智能合约难以裁决公平性或实时数据分歧 | intelligent contracts、实时数据拉取、验证者共识、申诉 | Beta | - |
Headroom 和 DeepZero 是当天最清晰的两类支撑层构建。@sairahul1 强调了 (19 个赞,10 条回复,3,218 次浏览,26 次收藏) 介绍了一个压缩层,并称它可以大幅降低 Claude 成本;而公开仓库描述的是 proxy、wrap、library 和 MCP 等部署模式,而不是单一的窄集成。@VivekIntel 介绍了 (25 个赞,2 条回复,914 次浏览,17 次收藏) 将 DeepZero 描述为漏洞研究的流水线引擎,其公开 README 也证实了 YAML 定义阶段、按样本保存且可恢复的状态,以及用于 Ghidra、Semgrep 和 loldrivers 过滤的示例处理器。

信号较弱的构建仍然指向同样的缺失层。@vladuah 展示了 (18 个赞,3 条回复,391 次浏览,12 次收藏) 介绍了一种研究记忆集成,让智能体能够持续建立在既有资料之上;@lami_thefirst 认为 (35 个赞,11 条回复,1,412 次浏览,9 次收藏) 则认为,自主商业在规模化之前需要一个裁决层。反复出现的构建触发点,并不是“再做一个助手”,而是填补支出、记忆或问责方面的控制缺口。
6. 新的和值得关注的动态
通用模型击败专业临床工具,如今已成为公开的医学话题
@DrEliDavid 放大了这一观点 (186 个赞,16 条回复,14,824 次浏览,63 次收藏) 指向一篇 Nature Medicine 论文,其标题和摘要都明确写道,通用 LLM 在多个医疗基准上优于专业临床 AI 工具。这很重要,因为它抬高了垂直模型厂商面临的门槛,同时也暴露了下一个问题:回复几乎立刻从能力转向验证、漂移和自动化偏差,而不是只庆祝排行榜结果。公开材料:Nature Medicine 论文。
ATOM Report 用一张图把开源模型的力量转移展示了出来
@rohanpaul_ai 总结道 (22 个赞,4 条回复,2,951 次浏览,9 次收藏) 转述了 ATOM Report 的说法:中国开源模型在 2026 年 3 月达到 11.5 亿次可追踪下载,而美国模型为 7.23 亿次,其中 Qwen 引领了这一转变的重要部分。这之所以值得注意,是因为它把“开源模型正在追赶”从一种靠感觉的说法,变成了一个生态规模的采用事实。公开材料:ATOM Report。
本地优先的上下文压缩,已从小技巧升级为产品层
@sairahul1 提醒注意 (19 个赞,10 条回复,3,218 次浏览,26 次收藏) 介绍了一个仓库,并称它已经获得 56K 星标,可在日志、JSON 和代码抵达 Claude 前先将其缩小。比宣传措辞更重要的是 Headroom 的 README:它描述了 library、proxy、wrap 和 MCP 模式,这意味着成本控制正被打包成共享基础设施层,供多个智能体和工具叠加其上。公开材料:Headroom repo。
7. 机会在哪里
[+++] 跨模型上下文与记忆基础设施 — 证据贯穿第 1、2、3 和 5 节:多模态任务捕获、NotebookLM 支撑的智能体记忆、可移植的技能和 wiki,以及对智能体反复从零开始的持续挫败感。这是一个强机会,因为这一问题同时出现在研究、编程和长周期智能体使用中。
[+++] 面向前沿模型工作流的成本感知编排与压缩 — Fable 的规划器—执行器模式、Headroom 的压缩层,以及持续紧张的 GPU 租赁市场,都指向同一个缺口:强模型有价值,但不能不加节制地使用。这是一个强机会,因为 token 支出和基础设施稀缺都已经在数据中清晰可见。
[++] 面向受监管 AI 的验证、固定版本与审计层 — 医疗 AI 讨论表明,能力提升并不能解决部署信任问题。这个机会处于中等强度,因为需求明确,但产品表面横跨基准测试、治理、变更控制和临床工作流。
[+] 面向技术团队的可复现 AI 辅助研究流水线 — DeepZero 展示了一个具体的安全研究案例,而更广泛的信息流也持续奖励那些把长期手工流程转化为可恢复流水线的工作流。这仍在形成中,但构建模式已经很清晰。
[+] 面向智能体间商业的裁决与审计层 — GenLayer 的争议解决讨论暴露出一个真实缺口:一旦合同变得模糊,就需要额外机制;但回复也表明,许多失效模式仍未解决。这个机会确实存在,但仍处于早期,且争议很大。
8. 要点
- 前沿模型的价值,正越来越体现在判断力上,而不是批量执行。 @aniketapanjwani 报道称 (254 个赞,12 条回复,45,046 次浏览,219 次收藏) 表明,Fable 最强的贡献是战略建议,而实现工作仍被交给更便宜的模型。
- 智能体体验的竞争,正从提示词转向持久上下文。 @omarsar0 展示了 (32 个赞,1 条回复,5,189 次浏览,34 次收藏) 表明,更丰富的多模态任务捕获能减少摩擦,而 @vladuah 展示了 (18 个赞,3 条回复,391 次浏览,12 次收藏) 展示了一个面向研究工作的具体记忆层。
- 开源模型和通用模型的实力,如今同时得到了生态和领域证据的支撑。 @rohanpaul_ai 分享了 (22 个赞,4 条回复,2,951 次浏览,9 次收藏) 提供了开源模型的生态规模采用数据,而 @DrEliDavid 分享了 (186 个赞,16 条回复,14,824 次浏览,63 次收藏) 则提供了有利于通用系统的公开医疗基准结果。
- AI 成本压力在数据中心和 API 两层都清晰可见。 @Silicon_Data 认为 (36 个赞,1 条回复,18,780 次浏览,35 次收藏) 表明,H100 租赁价格依然紧张,而 @sairahul1 强调了 (19 个赞,10 条回复,3,218 次浏览,26 次收藏) 则显示,对本地优先 token 压缩的需求正在上升。
- 构建者正在交付围绕模型的支撑层,而不只是再做一个聊天封装。 @VivekIntel 介绍了 (25 个赞,2 条回复,914 次浏览,17 次收藏) 将 DeepZero 展示为可复用的研究流水线引擎,而公开仓库也证实,编排、恢复和可扩展性如今本身就是产品能力。
- 自主商业仍缺少可信的争议解决层。 @lami_thefirst 认为 (35 个赞,11 条回复,1,412 次浏览,9 次收藏) 表明,一旦交易变得模糊,智能体就需要裁决机制,而回复也显示边缘情况会多么迅速地堆积。