Twitter AI - 2026-07-05
1. 人们在讨论什么
1.1 价值持续从基础模型上移至编排、应用层和持久化上下文(🡕)
反复出现的战略判断是:原始模型能力已不再是唯一的胜负手。大家不断把注意力放在模型周边这一层:编排、蒸馏、企业控制层,以及能够跨会话保留下来的持久化上下文。
@karlmehta 认为(92 个赞、19 条回复、11,615 次浏览、44 次收藏)认为,Alex Karp 真正想说的并不是模型本身稀缺,而是模型与企业数据之间的应用层,才是安全性和精确性产生的地方。更具体地说,Palantir 的本体之所以重要,是因为它既能避免模型直接接触底层业务数据,又能让输出在受监管和运营场景中真正可用。
@MilkRoadAI 解释称(51 个赞、7 条回复、8,426 次浏览、60 次收藏)把 Meta 的蒸馏叙事解读为部署经济学的变化:先训练一个巨型教师模型,再交付成本低得多、但保留大部分能力的衍生模型。其独特之处不在于新的基准图表,而在于一种成本结构论点:较小的开放模型可以继承前沿智能,却不必承担前沿模型的服务成本。
@murtuza_merc 认为(115 个赞、15 条回复、2,215 次浏览)认为,Hermes MoA 2.0 让编排层本身成为产品:它并行运行 GPT、Claude 和 DeepSeek,再综合各模型的输出。他的框架是,如果开放式集成系统在高难度推理上能胜过任何单一组成模型,那么溢价能力就会从单个模型转移到其上方的协调引擎。
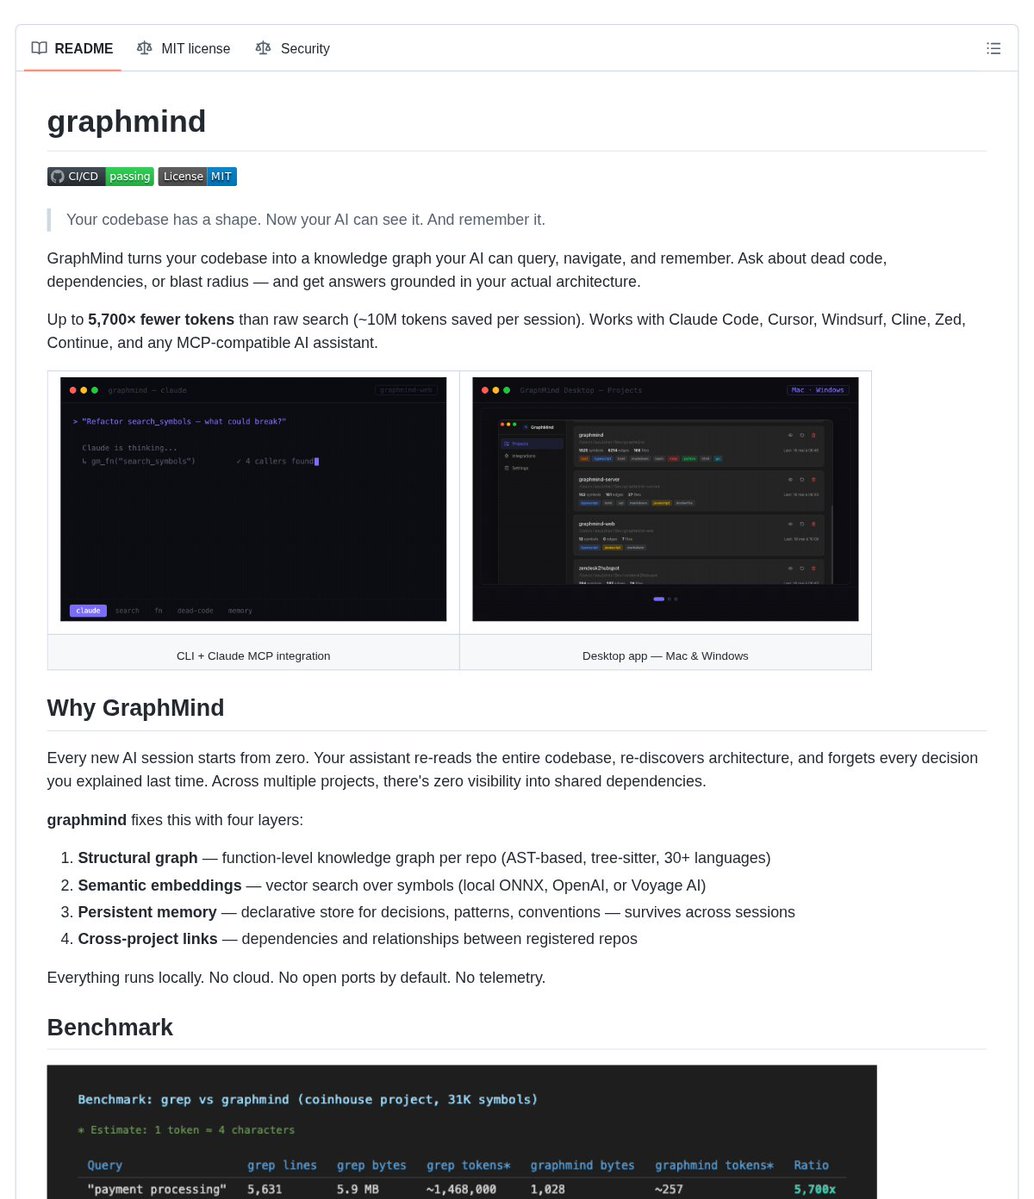
@DanKornas 分享了(1 个赞、1 条回复、644 次浏览)介绍了 GraphMind:这是一个本地优先的代码智能层,能将代码仓库转化为带持久记忆和跨项目链接的知识图谱。随附的 README 截图声称,相比原始搜索最多可减少 5,700 倍 token,这让论点变得非常具体:人们越来越把代码库上下文视为独立的产品层,而不是每次会话都重新构建的东西。
讨论洞察: 回复并没有否定模型进步,而是在不断追问:当模型已经足够强之后会发生什么——谁掌握路由,谁掌握记忆,谁负责企业安全边界,以及编排收益能否经得起额外延迟和成本开销的考验。
与前一天的比较: 2026-07-04,信息流还把前沿模型视为低成本工作流中的高价值规划器。到了 2026-07-05,这一逻辑进一步固化为商业论点:护城河越来越被描述为模型之上的那一层,而不只是模型本身。
1.2 专业化智能体基础设施变得更加具体,也更加垂直(🡕)
关于智能体的讨论持续远离泛化的“AI 助手”,转向为特定工作打造的操作界面。最重要的例子并不是更漂亮的聊天 UI,而是面向具体任务的控制面板、工具库、审批边界和记忆结构。
@elder_plinius 介绍了(1,298 个赞、78 条回复、63,986 次浏览、1,353 次收藏)介绍了 T3MP3ST:这是一个围绕 Claude Code、Codex、Hermes 和本地模型构建的自托管进攻型安全工具框架。该推文和公开仓库的证据密度异常高:包括浏览器端 War Room、95 工具武器库视图、8 名操作员阵容,以及可通过 npm run verify-claims 重新推导的基准声明,其中包括在 XBOW 的 104 项挑战套件上达到 90.1% 的 pass@1,以及在 2026 年 10 个留出 CVE 中,有 8 个能精确定位到文件、行号和 CWE。

@AnatoliKopadze 总结道(44 个赞、13 条回复、4,798 次浏览、52 次收藏)通过一场关于 Anthropic Managed Agents 的演讲提出:超过 90% 的 Anthropic 工程师已经在使用自我改进循环,而且有用的循环可以以低成本运行数小时。回复比原帖更清楚地划定了实践边界:智能体工程真正有用的部分,是循环、评测、工具调用、重试、日志,以及对触及外部世界的操作设置明确审批。
@DanKornas 还分享了(1 个赞、1 条回复、644 次浏览)把 GraphMind 的仓库截图视为同一模式的第二个例子。它并不试图让模型隐式“记住”代码库,而是把结构、记忆和依赖关系具象化,让助手不必每次都从零开始重新阅读同一个仓库。
讨论洞察: 最强的一层细微之处在于,没有人把自主性当成魔法。即使是最乐观的帖子,最后也都落回同样枯燥但必要的要求:工具边界、可重放的基准、记忆、审批闸门和日志。
与前一天的比较: 2026-07-04,信息流强调更丰富的输入和持久化上下文。到了 2026-07-05,这些理念开始以红队测试、代码记忆和自我改进循环相关的具体界面与仓库形式出现。
1.3 物理 AI 被描述为一场出货、部署和供应链竞赛,而不是演示竞赛(🡕)
一个独立的信息簇把机器人视为一场有硬数据支撑的 AI 部署故事,而不是围绕人形机器人的情绪化叙事。最有用的证据来自出货量对比、部署垂直领域和明确的供应瓶颈。
@aleabitoreddit 分享了(516 个赞、126 条回复、87,972 次浏览、342 次收藏)分享了 SVRC Research《State of Robotics 2026》报告的截图,认为美国在机器人技术的未来方向上领先,却在当下的实际出货上落后。截图把这一点说得很具体:一张卡片列出 Figure、Agility、Apptronik、Tesla、Boston Dynamics、Physical Intelligence、1X、Amazon Robotics、Covariant 和 Skild AI 作为美国阵营代表;另一张则显示,2025 年 Unitree 出货 5,500 台、AgiBot 出货 5,168 台,而 Tesla、Figure 和 Agility 各为 150 台。

同一讨论串中的另一张 SVRC 表格显示,商业部署已经集中在哪些领域:物流和电商已部署超过 780,000 台,汽车制造约 85,000 台;农业、餐饮服务和医疗/实验室支持的部署基数较低,但增长更快。这让讨论比泛泛的人形机器人热更扎实,因为它把机器人需求与实际垂直行业对应起来,并点名了 Amazon、Walmart、FedEx、GXO、Tesla、GM、Intel、TSMC 和 Samsung 等部署方。

讨论洞察: 回复把争论推向了运营现实。一位回复者指出,Amazon 的仓库已经使用超过 100 万台机器人,大约 75% 的配送流程都会在某个环节接触机器人;另一位则追问,美国机器人今天究竟能做什么,才能与 Unitree 公开展示出来的能力相提并论。
与前一天的比较: 物理 AI 并不是 2026-07-04 的主要组织性主题。到了 2026-07-05,它成为最清晰的新信息簇之一,因为证据不再只是模型层面的讨论,而是出货表、部署数量和供应商依赖。
1.4 评测持续从头条式基准转向可解释检查和真实软件任务(🡕)
信息流把评测视为设计问题,而不是记分牌问题。基准持平的说法仍在流传,但更持久的信号来自帖子对两件事的关注:如何诊断失败,以及如何在真正像工作的任务上测试智能体。
@WhaleInsider 报道称(431 个赞、110 条回复、52,598 次浏览、22 次收藏)称 Meta 即将推出的 Watermelon 模型在关键基准上追平 OpenAI 的 GPT-5.5。回复立即把讨论从头条拉回更实际的问题:现在推出是否已经太晚、能否转化为收入,以及现实表现是否会与基准措辞一致。
@IntuitMachine 认为(24 个赞、4 条回复、1,839 次浏览、29 次收藏)认为,整体式单一分数的 LLM 评判已经失灵,而 BinEval 的是/否拆解才是更好的模式。帖子的具体例子是:与其让模型给摘要打 1 到 5 分,不如逐项询问具体要求是否满足,再把答案汇总为可解释、可调试、可改进的分数。
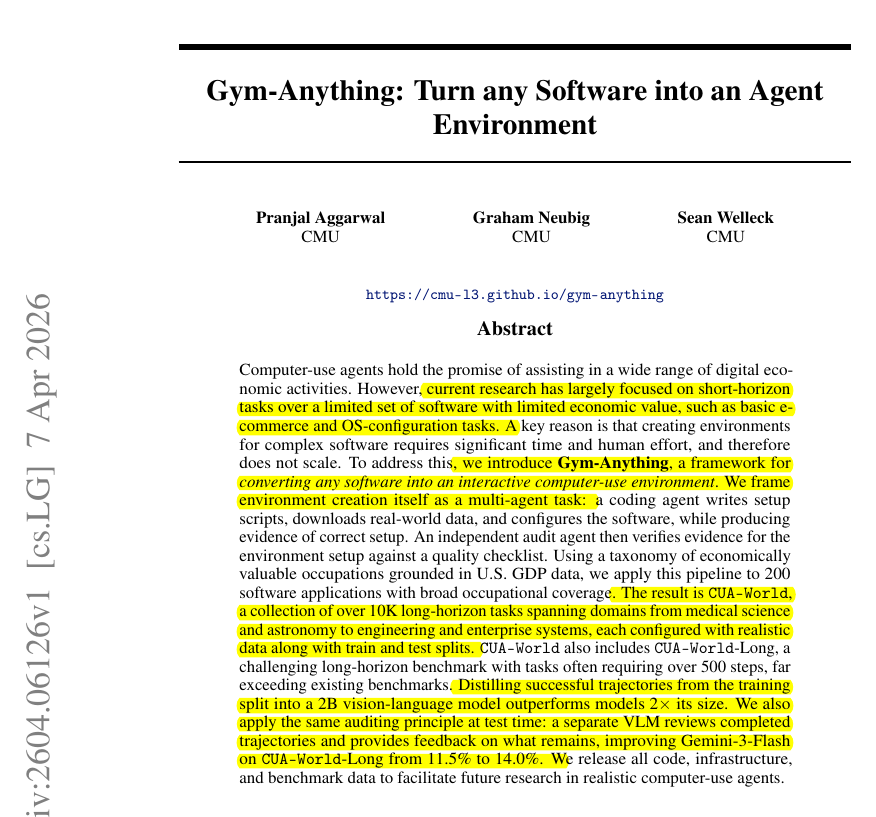
@rohanpaul_ai 强调了(30 个赞、14 条回复、3,699 次浏览、14 次收藏)介绍了 CMU 的 Gym-Anything 工作。其摘要称,当前智能体研究过度聚焦于短时域任务,并提出了 CUA-World,涵盖 200 个应用中的超过 10,000 项长时域任务。同一摘要还表示,即便是强模型,也只能解决其中最困难任务的一小部分,这让该帖子不只是一次基准发布,更像是对计算机使用型智能体仍有多远要走的一次现实检验。
讨论洞察: 普遍的不满并不是认为基准毫无用处,而是单一标量分数掩盖了系统为何失败;短小的玩具任务也掩盖了这样一个事实:一旦软件变得漫长、混乱且有状态,系统会多么频繁地失败。
与前一天的比较: 2026-07-04,评测更多是作为开放模型或通用模型正在进步的证据出现。到了 2026-07-05,重点转向评测方法本身:问题级诊断、真实软件环境,以及对缺乏依据的“持平”说法保持怀疑。
1.5 AI 经济学从 token 支出扩展到硬件投入、算力融资和本地加速(🡕)
成本压力仍居核心,但覆盖面再次扩大。信息流讨论的不只是 token 账单或模型定价,还包括被动元件、数据中心融资结构,以及能让整类云支出显得可以避免的本地开源工具。
@jukan05 报道称(248 个赞、21 条回复、43,947 次浏览、82 次收藏)称,AI 用 MLCC 价格已经上涨 3 倍到 10 倍,超过 20 家半导体公司从 7 月 1 日起开始涨价,华强北的经销商则发现报价在数小时内就会变化。该帖子的独特角度在于指出,AI 成本通胀并不局限于 GPU,而是在扩散到 AI 服务器周围整张物料清单中的元件。
@InTheAssembly 认为(206 个赞、41 条回复、68,920 次浏览、83 次收藏)称,Nvidia 新推出的收入分成式算力模式,让初创公司和新型云厂商无需先为购买硬件筹集巨额股权融资,就能扩大规模。讨论串中的例子包括 Sharon AI 计划部署 40,000 张 Grace Blackwell GPU,以及 Firmus 计划建设的 170,000-GPU 园区;回复很快把 Nvidia 重新定义为:它不仅是卖铲子的,也是在工作负载之上充当房东。
@Faazsh 强调了(22 个赞、10 条回复、591 次浏览、7 次收藏)介绍了 Insanely Fast Whisper,这是一个本地开源 CLI。根据仓库截图,它在 A100 上结合 Whisper Large v3 和 Flash Attention 2,可在约 98 秒内转录 150 分钟音频。虽然这条帖子的社交数据不大,但它让一种更广泛的应对模式变得可见:本地加速正越来越多地被用来把实际工作负载从付费 API 和云依赖中转移出来。
讨论洞察: 回复不断回到同一种稀缺:算力、资本,以及算力周围的配套部件。即使是支持性的回复,也把问题描述为获取和利用效率问题,而不是资源充足的问题。
与前一天的比较: 2026-07-04,成本压力体现在 GPU 租赁曲线和 token 压缩工具上。到了 2026-07-05,它进一步向下扩散到元件层,又向上延伸到算力融资和本地开源加速层。
2. 什么让人感到沮丧
基准说法仍然无法告诉从业者究竟哪里会出问题
严重程度:高。@WhaleInsider 发布了(431 个赞、110 条回复、52,598 次浏览、22 次收藏)给出了一个简洁头条:Meta 的 Watermelon 在关键基准上追平 GPT-5.5;但回复立即提出了更难的问题——发布时间、收入、隐私,以及现实世界表现。@IntuitMachine 认为(24 个赞、4 条回复、1,839 次浏览、29 次收藏)指出,标量式 LLM 评判本身就是问题的一部分,因为它掩盖了究竟是哪项要求失败;而 @rohanpaul_ai 指出(30 个赞、14 条回复、3,699 次浏览、14 次收藏)之所以转向一个包含 10,000 多项长时域任务的基准,正是因为玩具任务并不像真实工作。人们的应对方式是把评测拆解为更小的检查,使用更长时域的任务套件,并拒绝仅凭“持平”口号就下判断。这一方向值得投入,因为这种痛点同时影响模型选择、提示词迭代和智能体部署。
AI 基础设施还没变得更容易,成本却先变得更高了
严重程度:高。@jukan05 报道称(248 个赞、21 条回复、43,947 次浏览、82 次收藏)称,AI 用 MLCC 价格上涨了 3 倍到 10 倍,元件报价甚至可能在数小时内变化;这与普通的 token 账单抱怨完全不是一回事。@InTheAssembly 认为(206 个赞、41 条回复、68,920 次浏览、83 次收藏)称,Nvidia 的收入分成式算力计划之所以存在,正是因为前期硬件负担两年来一直在压制开发者。@Faazsh 分享(22 个赞、10 条回复、591 次浏览、7 次收藏)展示的本地 Whisper CLI,则让另一种应对路径变得可见:对部分工作负载来说,云端转录支出已经显得不是必需。这一方向值得投入,因为用户同时在元件、融资和工作流层面感受到成本压力。
如果构建者不加入记忆和控制层,原始助手仍会浪费过多上下文
严重程度:高。@DanKornas 分享了(1 个赞、1 条回复、644 次浏览)介绍 GraphMind,明确就是为阻止助手每次会话都重新阅读、重新发现同一个代码库。@AnatoliKopadze 表示(44 个赞、13 条回复、4,798 次浏览、52 次收藏)指出,Anthropic 工程师依赖自我改进循环;而回复立即把这件事翻译成大多数用户仍然感受到的缺失:重试、日志、成本控制和审批闸门。@karlmehta 做出了(92 个赞、19 条回复、11,615 次浏览、44 次收藏)则把同一抱怨的企业版说得非常明确:模型和你的数据之间到底隔着什么。人们正在通过加入知识图谱、显式记忆、本体和领域专用工具框架来应对。这一方向值得投入,因为这种挫败甚至早于模型在语义上失败就已经出现——问题出在工作流忘得太多。
物理 AI 仍然受制于供应约束,部署也很不均衡
严重程度:中。@aleabitoreddit 分享了(516 个赞、126 条回复、87,972 次浏览、342 次收藏)介绍了一份机器人报告,指出稀土暴露、执行器依赖、制造速度和监管都是现实瓶颈,同时也显示中国在 2025 年人形机器人出货量上远远领先美国厂商。回复进一步强化了这种现实不适:有人追问美国机器人今天究竟能做什么,才足以匹敌 Unitree 可见的公开能力;也有人说,六家资金充足的公司可能会在 2027 年正面碰撞,而市场甚至还没成熟。当前的应对策略是锚定物流和仓储部署,因为这些领域的经济性已经比较清晰。这一方向值得投入,但市场仍然资本密集且竞争激烈。
3. 人们希望有什么产品
能解释失败、而不是掩盖失败的可解释评测栈
最明确的现实需求不是又一个泛化的基准头条,而是一个能准确说明答案或智能体运行为什么失败的系统。@IntuitMachine 描述了(24 个赞、4 条回复、1,839 次浏览、29 次收藏)把 BinEval 作为一种将评测拆成原子化是/否问题的方法提出;@rohanpaul_ai 展示了(30 个赞、14 条回复、3,699 次浏览、14 次收藏)则通过一个包含 10,000 项任务的基准说明这为什么重要:真实软件工作依然会难倒强智能体。Watermelon 讨论串中的 @WhaleInsider 补充说(431 个赞、110 条回复、52,598 次浏览、22 次收藏)体现了同一诉求的社交版:展示失败模式,而不只是“持平”的口号。机会:直接。
能跨会话、跨项目持续存在的编码智能体本地记忆
人们一再寻找能阻止助手每次都从头开始的产品。@DanKornas 分享了(1 个赞、1 条回复、644 次浏览)介绍了一个把代码转化为可查询知识图谱、并提供持久记忆的仓库;而 @AnatoliKopadze 指出(44 个赞、13 条回复、4,798 次浏览、52 次收藏)则指向 Anthropic 内部对自我改进循环的使用,说明这正是智能体工作的那种平凡但有用的现实。人们想要的似乎并不是神秘的记忆,而是可复用的结构、被保存下来的决策,以及可预测的上下文传递。机会:直接。
位于强模型与私有运营数据之间的更安全应用层
企业侧需求被说得异常直白。@karlmehta 认为(92 个赞、19 条回复、11,615 次浏览、44 次收藏)指出,任何严肃的企业 AI 方案,都应该按模型与公司数据之间夹着什么来评判,而不只是看底层用了哪个模型。这意味着,缺失的产品不应只是“拿到最佳模型访问权限”,而更应该围绕模型提供安全、精准的路由、记忆和策略执行。机会:竞争性。
能摆脱巨额前期硬件承诺的算力获取模式
成本讨论体现出一种比便宜 token 更具结构性的愿望。@InTheAssembly 将其定义为(206 个赞、41 条回复、68,920 次浏览、83 次收藏)把 Nvidia 新推出的收入分成计划视为没有 5 亿美元战争资金的构建者的泄压阀;而 @jukan05 展示了(248 个赞、21 条回复、43,947 次浏览、82 次收藏)则指出,连服务器周边元件也在涨价。这里的诉求是融资、分配和路由产品,以降低严肃 AI 工作的前期负担。机会:直接。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| T3MP3ST | 安全智能体工具框架 | (+/-) | 自托管 War Room、可复现基准、35 个默认工具和更大的可选武器库,支持 Claude Code/Codex/Hermes/本地模型 | 协同 swarm 路径仍处于实验阶段,整个系统也仅限于经授权的安全测试 |
| GraphMind | 代码智能 / MCP | (+) | 本地知识图谱、持久记忆、跨项目链接,相比原始搜索声称可大幅节省 token | 需要索引和配置,且目前信号仍主要来自仓库热度,而非大规模采用 |
| BinEval | LLM 评测方法 | (+) | 将质量拆解为原子化的是/否检查,使失败可检查,并支持提示词和评测器改进 | 仍依赖高质量的问题生成和严格的提示词版本管理 |
| Gym-Anything / CUA-World | 智能体基准 | (+/-) | 将任意软件转化为智能体环境,并测试跨 200 个应用的长时域工作 | 基准本身显示,当前智能体仍会在许多最困难的现实任务上失败 |
| Hermes MoA 2.0 | 多模型编排 | (+/-) | 并行路由 GPT/Claude/DeepSeek,使协调层显性化 | 增加编排复杂度和潜在延迟,收益取决于聚合器设计 |
| Palantir 本体 / 应用层 | 企业 AI 工具框架 | (+/-) | 在模型与业务数据之间加入安全和精度层 | 专有、部署负担重,且讨论串中没有独立基准支撑 |
| Llama 蒸馏 | 模型部署方法 | (+) | 承诺将巨型教师模型的能力迁移给较小衍生模型,从而降低部署成本 | 经济性和质量差距仍需在供应商相关示例之外验证 |
| Insanely Fast Whisper | 本地 ASR CLI | (+) | 本地转录速度极快,支持说话人分离和时间戳,无需云依赖 | 基准与硬件强相关,优化路径也默认 CUDA 或 Apple Silicon |
整体满意度偏务实,而不是情绪化。人们喜欢那些要么能让失败变得可解释、要么能让成本变得可承受的工具。反复出现的迁移模式是:在模型周围增加更多结构——用明确的评测问题替代整体评分,用知识图谱替代反复搜索文件,用多模型委员会替代单一巨型模型,并在云支出显得浪费时采用本地加速。竞争态势也持续远离“哪个模型最好”,转向“模型周围的哪一层能让工作流更便宜、更安全或更易检查”。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| T3MP3ST | @elder_plinius | 将现有编码智能体转化为带有侦察、利用和报告界面的自托管红队工作流 | 通用编码智能体并不自带进攻型安全工具框架、配套工具或基准纪律 | Claude Code/Codex/Hermes/本地模型、浏览器 War Room、CLI、HTTP API、MCP、nmap、nuclei、semgrep、ffuf | Beta | 推文 · 仓库 |
| GraphMind | aouicher via @DanKornas | 将代码库转化为本地知识图谱,让 AI 助手能够查询、导航并记忆 | 编码助手会反复重读仓库,并忘记此前的架构决策 | Rust、tree-sitter、SQLite/FTS5、embeddings、MCP、桌面应用、CLI | Beta | 推文 · 仓库 |
| Insanely Fast Whisper | Vaibhavs10 via @Faazsh | 以支持时间戳和说话人分离的高速 CLI 在本地运行 Whisper 转录 | 云端转录比本地加速推理更慢、需要付费且隐私性更低 | Transformers、Optimum、Flash Attention 2、Whisper Large v3、Pyannote diarization、CUDA/MPS | Shipped | 推文 · 仓库 |
| Hermes MoA 2.0 | Nous Research via @murtuza_merc | 提供一个会并行咨询多个模型并综合答案的虚拟模型 | 构建者希望获得更强推理能力,而不必等待一个更大的单体模型 | Hermes Agent、GPT、Claude、DeepSeek、聚合模型、多供应商路由 | Beta | 推文 · 仓库 |
| Gym-Anything / CUA-World | CMU 研究人员 via @rohanpaul_ai | 将任意软件转化为智能体环境,并打包长时域评测任务 | 现有计算机使用基准过度代表短小、干净的任务,低估了真实软件工作 | 设置智能体、审计智能体、真实数据应用配置、长时域任务拆分 | Alpha | 推文 · 论文 |
T3MP3ST 和 GraphMind 是当天构建模式最清晰的例子:不要再发布一个通用助手,而要发布助手周围缺失的那一层。T3MP3ST 为编码智能体加入特定任务的操作员、基准和工具闸门;GraphMind 则加入结构和记忆,让编码智能体不必每次运行都重新发现同一个仓库。
Insanely Fast Whisper 让本地加速这一模式变得具体,而不是停留在口号层面。仓库截图用一张基准表支撑了头条,说明该项目并不只是把 Whisper 包装进更漂亮的界面,而是把速度、隐私和成本控制本身当成产品来卖。

这些构建背后反复出现的触发因素,是运营层面的痛点。有些构建者希望智能体能借助真实工具完成安全工作;有些希望助手不再遗忘架构;有些希望本地推理足够快,从而避开付费 API;还有些希望评测环境更接近人们实际使用的软件。
6. 新动态与值得关注的事项
Gym-Anything 让长时域计算机使用评测更难被忽视
@rohanpaul_ai 强调了(30 个赞、14 条回复、3,699 次浏览、14 次收藏)介绍了 CMU 的 Gym-Anything 论文,该框架可将任意软件转化为智能体环境。它之所以值得关注,是因为摘要描述了其发布基准的规模:CUA-World 覆盖 200 个应用中的超过 10,000 项任务;同一摘要还表示,即便是强模型,也只能解决最困难任务中的一小部分。公开产物:Gym-Anything 论文。
Z.ai 的 GLM-5.2 进入开放权重挑战者的讨论
@the_hindu 报道称(4 个赞、8,036 次浏览)称,智谱 AI 的 GLM-5.2 及其配套编码产品 ZCode,如今正被讨论为 Anthropic 在部分软件工程和网络安全任务上的严肃挑战者。让它值得关注的是所链接的文章:文中称,Semgrep 测试发现 GLM-5.2 在部分软件工程任务上优于 Claude Opus 4.8,并将此次发布描述为中国开放权重生态的又一个重要时刻。公开产物:《The Hindu》文章。
AI 治理持续从抽象争论变成正式的国际场域
@MCoeckelbergh 指出(7 个赞、177 次浏览)提到他抵达日内瓦,参加全球 AI 治理对话;独立国际人工智能科学小组的报告将在会上发布。联合国页面比这条帖子的少量互动数据更重要:页面明确表示,在《全球数字契约》框架下,这场对话是每个国家都能在 AI 治理问题上拥有一席之地的场合。公开产物:联合国 AI 治理全球对话。
7. 机会在哪里
[+++] 智能体评测与控制平面 —— 第 1、2、3、4、5 节的证据共同指向这里:BinEval 的二元检查、Gym-Anything 的长时域任务、对 Watermelon 的质疑、Anthropic 式循环,以及 DataScienceDojo 式 RAG 评测,都指向同一个缺口。这一机会很强,因为人们需要的是诊断、审批和失败定位,而不只是又一个排行榜。
[+++] 面向助手的持久化本地记忆与代码智能 —— GraphMind、关于 Anthropic 循环的讨论,以及人们反复抱怨助手每次都从零开始,都指向对理解架构的持久化上下文层的长期需求。这一机会很强,因为编码、企业部署和长时间运行的智能体使用场景都存在同样的痛点。
[++] 算力获取、利用率与成本可观测性层 —— MLCC 通胀、Nvidia 的收入分成式算力计划,以及 Insanely Fast Whisper 这类本地工具都表明,成本压力已经是结构性的,而不是表面问题。这是一个中等机会,因为需求十分明显,但解决方案横跨融资、路由、硬件供应和本地加速。
[++] 物理 AI 部署软件与供应商情报 —— 机器人讨论显示出明显分化:机器人正在何处出货、何处部署,以及关键零部件来自何处,并不是一回事。这是一个中等机会,因为证据很充分,但市场仍然资本密集且拥挤。
[+] 开放权重编排与企业工具框架层 —— Palantir 关于应用层的论点、Meta 的蒸馏评论和 Hermes MoA 2.0 都指向基础模型之上的价值获取。这一方向仍在形成,尚未定型,但当天已经出现多个例子,说明构建者正在把这一层当作产品。
8. 要点
- 人们讨论模型之上那一层的频率,已经高于讨论模型本身。 Palantir 的应用层论点、Hermes MoA 2.0 和 Meta 的蒸馏评论,都指向编排、路由和数据控制正日益成为价值获取中心。(来源)
- 智能体构建者正在交付领域专用的操作层,而不是通用副驾驶。 T3MP3ST 和 GraphMind 是最清晰的例子:前者把编码智能体包进红队工作流,后者则为其加入结构和记忆。(来源)
- 物理 AI 呈现出一场中国在出货量上领先的部署竞赛,而不只是人形机器人炒作周期。 最有用的证据是 SVRC 的截图组:它同时展示了美国代表性厂商名单,以及 Unitree/AgiBot 与美国人形机器人厂商之间的出货差距。(来源)
- 评测正被视为诊断问题,而不是打分问题。 BinEval 的是/否拆解和 Gym-Anything 的长时域环境,都在针对同一种失败模式:基准看起来很干净,却解释得太少。(来源)
- AI 成本压力正在扩散到元件、融资和本地加速。 MLCC 通胀、Nvidia 的收入分成式算力计划和 Insanely Fast Whisper 的基准都表明,构建者现在优化的是模型周围的整个技术栈,而不只是 API 调用。(来源)
- 开放权重挑战者和国际治理都在后台持续推进。 GLM-5.2 据称取得的进展,以及联合国全球 AI 治理对话,都表明当下的 AI 竞争同时发生在技术、商业和制度层面。(来源)