Twitter AI - 2026-07-06
1. 人们在讨论什么
1.1 数据覆盖与单次解决成本成为主导性约束叙事(🡕)
最明显的战略转向,是讨论重点从模型的原始智力,转向覆盖真实工作的成本。人们不断把未来进展与专有数据、更便宜的开放模型,以及在 API 支出不至于失控的情况下运行长期任务的能力联系起来。
@willdepue 认为(665 个赞、63 条回复、231,470 次浏览、883 次收藏)称,到 2030 年,各实验室每年的数据支出将超过 1,000 亿美元,而 AI 正从“算力受限”阶段转向“数据受限”阶段。他的具体判断是,前沿模型如今最明显的失败,出现在数据私有、稀缺或从未数字化的领域,这使得数据采集本身成为新的瓶颈。
@aiwithsally 认为(214 个赞、44 条回复、13,750 次浏览)认为,下一轮模型竞争的焦点正从基准成绩的光环,转向单任务成本。配图通过列出 DeepSeek V4 Pro Max 每项任务 0.04 美元、GLM-5.2 Max 0.37 美元、GPT-5.5 0.88 美元,让这一论点变得一目了然。

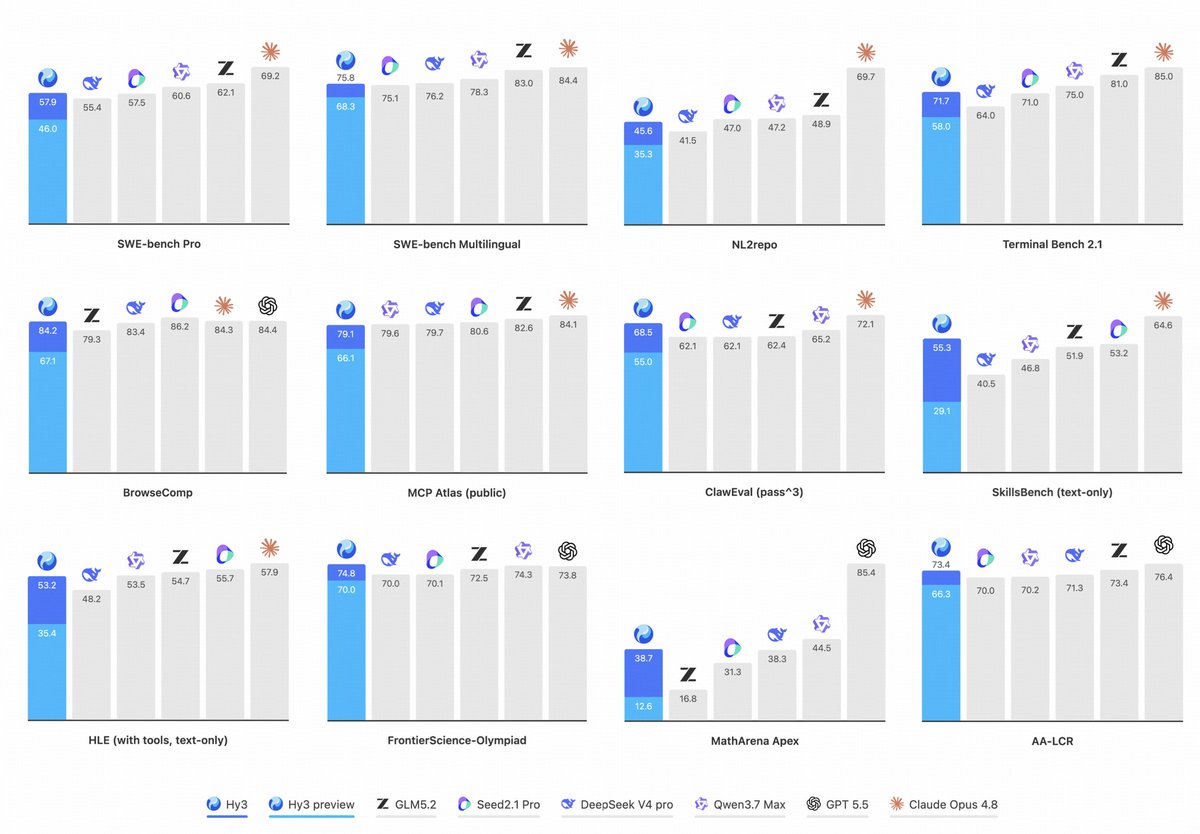
@testingcatalog 强调(72 个赞、3 条回复、8,229 次浏览、16 次收藏)将 Tencent 的 Hy3 描述为一个拥有 295B 参数的 MoE 模型,其相对 GLM-5.1 的基准优势,在前端开发、CI/CD,以及数据与存储相关工作中最为明显。这一点之所以重要,是因为公开的 Hy3 仓库将该模型定位为面向实际工程工作负载的开放权重竞争者,而不只是一个研究层面的新奇产物。
@AlexFinn 展示了(186 个赞、47 条回复、14,787 次浏览、135 次收藏)展示了这种经济性转变在本地模型上的实际形态:四个模型在六台电脑上全天候运行,用于安全扫描、代码优化、竞品监测、异常检测和创意生成。其独特之处不在于本地模型胜过前沿模型,而在于一旦边际 token 成本消失,持续运行的后台工作就变得负担得起。


讨论洞察: 关于单任务成本的讨论串中,回复补充了一个重要限定:低廉的标价可能会被重试消耗掉,因此人们越来越关注“每次完成的成本”,而不是“每次尝试的成本”。对 Alex Finn 帖子的回复,则把同一叙事进一步推向隐私和自有算力:本地模型之所以有吸引力,不仅因为便宜到可以常开,还因为日志、文件和内部上下文都无需暴露给第三方系统。
与前一天相比: 2026-07-05,经济性讨论已扩展到硬件部件和算力金融。到了 2026-07-06,重心进一步上移到专有数据覆盖,以及每项“已完成任务”的成本。
1.2 可靠性讨论从泛泛的基准怀疑转向具体的有状态故障模式(🡕)
评测讨论变得更偏向实际运维。人们不再抽象争论基准质量,而是聚焦于过时记忆、恶意网页输入、执行框架效率,以及针对高成本智能体基准的代理评测。
@omarsar0 总结(26 个赞、9 条回复、3,071 次浏览、21 次收藏)将 A-TMA 论文视为对“幽灵记忆”的直接回应:由于旧记录、当前记录和过渡记录会被同时检索,智能体会自信地重复已经不再成立的事实。其有用之处不仅在架构,也在方法论:该帖子认为,构建者应分别评估记忆库、检索阶段和回答阶段,而不能只依赖最终问答准确率。

@rohanpaul_ai 警告(9 个赞、2 条回复、1,106 次浏览、5 次收藏)认为,DeepMind 的 AI Agent Traps 工作将开放网络本身变成了自主智能体的威胁模型。他列举的具体例子包括隐藏的 HTML 指令、图像隐写、持久性记忆投毒,并指出在基准环境中,部分劫持的攻击成功率最高可达 86%。
@mattlam_ 介绍了(5 个赞、4 条回复、307 次浏览、4 次收藏)将 OpenBench 视为针对执行框架、而非只针对模型的基准测试。首批结果比较了 Pi、Cursor、Codex 和 OpenCode 在类型化编码任务上的单题求解耗时,这与 openbench.dev将评测视为与提供商无关、可复现基础设施的更大框架相一致。

@gurtej__gill_ 强调(6 个赞、1 条回复、116 次浏览、5 次收藏)介绍了 PACE 论文;据称,这一代理基准能以约低 100 倍的成本、低于 4% 的 MAE 和约 85% 的排名准确率,预测完整智能体基准的表现。这意味着评测成本本身也成了产品问题的一部分。
讨论洞察: 回复比标题更准确地点出了痛点:过时上下文投毒、智能体把页面内容当成指令,以及团队在付费运行完整端到端基准前,需要更便宜的筛选器。
与前一天相比: 2026-07-05,信息流主要在争论单一标量分数会掩盖失败原因。到了 2026-07-06,讨论更具体地指向这些失败发生的位置:记忆、环境、执行框架和评测预算。
1.3 具身智能仍然立足于出货量、部署数量和供应商瓶颈(🡒)
与软件和评测讨论相比,这一话题群更为狭窄,但证据异常具体。最有分量的帖子不是机器人演示,而是一组关于出货、部署和供应链的表格。
@aleabitoreddit 分享了(964 个赞、155 条回复、193,580 次浏览、650 次收藏)分享了 SVRC Research《State of Robotics 2026》报告的截图,称美国在机器人技术未来走向上领先,但在当前出货上正在落后。截图通过把美国头部企业名单与稀土、执行器、制造速度和监管方面的明确瓶颈并列,具体呈现了这一判断。

同一讨论串还展示了部署已经真正发生的领域:物流和电子商务领域超过 780,000 台,汽车制造领域约 85,000 台,而农业、餐饮服务以及医疗或实验室支持领域的基数更小,但增速更快。这使讨论串从“人形机器人竞赛”的叙事,转变为按垂直行业划分的部署地图。

讨论洞察: 回复把讨论进一步推向运营现实,指出 Amazon 已拥有超过 100 万台机器人,并警告称,即使美国企业赢得模型竞赛,执行器依赖仍可能卡住其发展。
与前一天相比: 这一主题与 2026-07-05 基本一致,但新的重点不再是对人形机器人的兴奋,而是机器人已经部署在哪里,以及哪些部件仍在限制规模化。
1.4 构建者持续以本地优先、专业化和可审计工具作出回应(🡕)
构建者关注的不是又一个通用助手。获得关注的项目,要么高度专业化,要么本地运行,要么对证据和失败模式异常透明。
@VivekIntel 分享了(10 个赞、525 次浏览、5 次收藏)将 T3MP3ST 介绍为围绕现有编码智能体构建的开源进攻性安全执行框架。公开的 仓库通过强调自托管运行、实时功能与路线图功能的状态表,以及可重新计算的基准声明,使这一主张尤其容易验证。

@doodlestein 分享了(9 个赞、1 条回复、941 次浏览、10 次收藏)介绍了 FrankenOCR。其 仓库称,这是一个纯 Rust、仅使用 CPU 的 OCR 引擎,无需 Python、CUDA 或 GPU 即可离线运行。这是当天“本地优先”应对模式的典型例子:把实际工作负载从付费 API 和重量级 ML 技术栈中迁出。

@DanKornas 分享了(1 个赞、2 条回复、784 次浏览、3 次收藏)介绍了 Meetily,这是一款隐私优先的会议助手。其 仓库称,录音、转录文本和转录模型都保留在设备上,而摘要则可通过本地模型或用户自行选择的提供商生成。

@DanKornas 还分享了(4 个赞、2 条回复、1,200 次浏览、6 次收藏)介绍了 ai-memory-comparison,这是一个基于来源证据的矩阵,覆盖 79 个记忆系统和 79 项特性。其底层 项目网站与其说是一个炫目的产品,不如说是一个可供审计的界面,这符合当天对明确证据的整体偏好,而不是含糊的智能体记忆宣传。

讨论洞察: 即使是看好市场的构建者,也不断汇聚到相同的信任基础:本地处理、明确的记忆机制、可复现的主张,或供人审计的证据文件。
与前一天相比: 2026-07-05,构建者主要在追逐模型之上的编排层和上下文层。到了 2026-07-06,他们更加强调隐私、专业化操作界面和可验证性。
2. 人们感到沮丧的地方
私有领域数据仍是一堵难以逾越的高墙
严重程度:高。@willdepue 认为(665 个赞、63 条回复、231,470 次浏览、883 次收藏)认为,当前方法与更广泛的经济自动化之间的主要阻碍,并不只是缺更多算力,而是缺少对私有工作流、隐性知识和未数字化领域的覆盖。一条把医疗数据单独指出为瓶颈的回复得到了他的明确认同;@Ivywen_W 指出(15 个赞、2 条回复、184 次浏览)还称,Global Dialogue on AI Governance 同样提出了对训练数据进行非歧视性访问的问题。人们正通过授权、专家标注和领域专属采集来应对,但挫败感依然强烈,因为缺失的数据恰恰是无法免费抓取的部分。这值得投入建设,因为这一抱怨处在模型性能的底层,而不是表层。
强大模型一旦遇到混乱的记忆、环境或工作流状态,仍然会失效
严重程度:高。@omarsar0 描述(26 个赞、9 条回复、3,071 次浏览、21 次收藏)描述了长期运行的智能体反复使用已经失效的事实;与此同时,@rohanpaul_ai 指出(9 个赞、2 条回复、1,106 次浏览、5 次收藏)把隐藏网页内容、记忆投毒和跨智能体劫持视为另一类独立故障。@rohanpaul_ai 提出(2 个赞、2 条回复、1,743 次浏览)则以医疗场景的形式提出了同一问题:模型在普通基准提示上可能表现惊艳,但输入一旦受到扰动或部分缺失,就会崩溃。当前一致的应对方式是:将评测拆分为多个阶段,把网络视为不可信输入,并在运行昂贵的端到端测试前,加入 PACE这类更便宜的代理筛选。这值得投入建设,因为这一痛点同时出现在智能体、企业评测和高风险领域。
前沿模型在日常使用中的经济性仍然令人头疼
严重程度:高。@aiwithsally 将其定义为(214 个赞、44 条回复、13,750 次浏览)把问题归结为纯粹的部署经济性;回复在计入重试后,立即将讨论从单任务价格推进到了单次完成成本。@AlexFinn 回应(186 个赞、47 条回复、14,787 次浏览、135 次收藏)通过在六台电脑上持续运行本地模型来应对这一问题,并明确表示,如果使用云端前沿模型完成同样的后台工作,每月成本将达到数千美元。就连 @kathrynwu1 进一步明确了(2 个赞、1 条回复、397 次浏览、1 次收藏)这样的小帖,也体现了从业者的抱怨:做几分钟非编码工作后就触及产品限制,会让一个在基准上领先的强模型在实际使用中体验很差。人们通过把持久性工作交给本地模型,以及关注 Hy3、GLM-5.2 等更便宜的开放模型挑战者来应对,这使其成为直接的产品机会,而不是暂时的不便。
具身智能受阻于部件与部署现实,而不只是软件
严重程度:中。@aleabitoreddit 揭示了(964 个赞、155 条回复、193,580 次浏览、650 次收藏)把稀土暴露、执行器依赖和制造速度列为现实瓶颈;与此同时,该讨论串显示,中国当前的人形机器人出货量已遥遥领先。回复提到 Amazon 已部署的机器人规模,认为这才是实际重要的部署背景,与由演示驱动的炒作形成了有益对比。目前的应对策略,是优先关注经济性已经显现的物流和汽车部署。这值得投入建设,但仍然是资本密集且对供应链敏感的问题。
3. 人们希望存在什么
更完善的数据获取与授权基础设施
最强烈的未满足需求,是一种能将私有领域中缺失的知识转化为可训练或可评估资产的方式,而无需等待新的算法突破。@willdepue 实际上是在问(665 个赞、63 条回复、231,470 次浏览、883 次收藏)呼吁建设“数据版 Stargate”;@Ivywen_W 揭示了(15 个赞、2 条回复、184 次浏览)则通过数据访问和本地语境的表述,提出了同一诉求的治理版本。这是一个现实需求,而非理想化愿景:人们需要采集、授权、脱敏和权利管理基础设施,以解锁当前模型表现仍然不佳的领域。机会:直接。
能识别事实何时发生变化的记忆系统
人们要的不是泛泛的“更好记忆”,而是能够区分当前事实与已被取代事实,并让故障诊断过程可见的记忆系统。@omarsar0 提出(26 个赞、9 条回复、3,071 次浏览、21 次收藏)通过“幽灵记忆”明确提出了这一需求;@DanKornas 间接表明(4 个赞、2 条回复、1,200 次浏览、6 次收藏)则通过推广一个基于来源证据的 79 个记忆系统矩阵,表达了同样的需求,因为目前选择哪一个系统仍然过于不透明。有些解决方案已经存在,但今天的证据表明,它们仍然太难比较、审计和信任。机会:直接。
面向真实智能体工作的低成本代理评测与执行框架比较
信息流反复提出,需要足够快以指导开发、又足够具体以解释失败原因的评测循环。@gurtej__gill_ 将其定义为(6 个赞、1 条回复、116 次浏览、5 次收藏)将 PACE视为一种以约低 100 倍成本预测昂贵智能体基准的方式;@mattlam_ 询问(5 个赞、4 条回复、307 次浏览、4 次收藏)则呼吁进行执行框架比较,而不是继续制作只比较模型的排行榜。这是迫切的现实需求,因为团队已经在为评测支付真金白银,但评测仍无法告诉他们,失败究竟来自模型、执行框架、记忆层还是环境。机会:直接。
私密、持续运行的本地 AI 工作空间
另一个明确需求,是一种能够持续运行、无需将敏感工作发送到云端,也不会让每项后台任务都变成 API 账单的 AI。@AlexFinn 描述(186 个赞、47 条回复、14,787 次浏览、135 次收藏)展示了这种工作负载模式,而 Meetily、FrankenOCR 和 FreeLattice等项目则表明,构建者已经在交付部分解决方案。这一需求既实际,也带有情感因素:用户希望降低成本、改善隐私,并更强烈地掌握 AI 如何围绕自己的工作运行。机会:竞争性较强。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Hy3 | LLM | (+) | 开放权重 295B MoE;被引用最多的优势出现在前端开发、CI/CD 以及数据/存储工作中 | 今天的讨论仍然偏重基准,而非生产实践 |
| GLM-5.2 | LLM | (+) | 低成本开放权重替代方案;长上下文定位使其成为单任务成本讨论的一部分 | 今天的信息流中缺乏直接的从业者证据 |
| 本地模型集群 | 部署模式 | (+/-) | 成本足够低,适合持续运行的后台工作;隐私与控制优势明显 | 比云端前沿模型更慢、更弱;需要自有硬件 |
| A-TMA | 智能体记忆 | (+) | 区分过时、当前和过渡性证据;让记忆故障模式更易诊断 | 仍处于研究阶段,更像叠加层而非标准产品 |
| OpenBench | 评测执行框架 | (+) | 比较执行框架效率和单题求解耗时,而不只是模型原始分数 | 首次迭代尚早,目前公开结果有限 |
| PACE / PACE-Bench | 代理评测 | (+) | 在运行完整基准前,大幅降低智能体模型分流成本 | 代理基准无法取代最终的端到端验证 |
| FrankenOCR | 本地 OCR | (+) | 仅使用 CPU、可离线运行、静态二进制;避免 Python/CUDA/GPU 开销 | 范围主要局限于 OCR 及相邻文档任务 |
| T3MP3ST | 安全执行框架 | (+) | 围绕现有编码智能体构建可复现的红队工作流;支持自托管和免密钥选项 | 专门面向获授权的进攻性安全用例 |
总体满意度偏务实,而非兴奋。@testingcatalog 将其视为(72 个赞、3 条回复、8,229 次浏览、16 次收藏)积极评价 Hy3,@KanikaBK 也这么做了(6 个赞、2 条回复、433 次浏览、3 次收藏)也对 GLM-5.2 表示看好。原因并不是人们突然不再关心模型质量,而是两者看起来都能以更好的经济性投入部署。
最明显的迁移模式是拆分工作负载。@AlexFinn 展示了(186 个赞、47 条回复、14,787 次浏览、135 次收藏)称,他仍让云端前沿模型参与顶级工作,但把持续运行的后台任务转移到本地模型。@doodlestein 展示了(9 个赞、1 条回复、941 次浏览、10 次收藏)和 @VivekIntel 展示了(10 个赞、525 次浏览、5 次收藏)则从软件形态上体现了同样的直觉:推出更窄但本地或自托管的工具,去掉整类云依赖,而不是试图取代每一次前沿模型调用。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| T3MP3ST | elder-plinius | 围绕现有编码助手的多智能体红队框架 | 为安全团队提供可复现、自托管的 AI 测试界面,替代临时式提示词测试 | TypeScript、MCP、HTTP API、Claude/Codex/Ollama 集成 | Beta | 推文, 仓库 |
| FrankenOCR | Dicklesworthstone | 仅使用 CPU 的 OCR CLI 和库 | 让 OCR 无需 Python/CUDA 或 GPU,即可在笔记本、CI 运行器和边缘设备上离线运行 | Rust、静态二进制、量化 VLM 内核 | 已发布 | 推文, 仓库 |
| FreeLattice | Chaos2Cured | 集成在单个 HTML 文件中的本地优先浏览器 AI 平台 | 无需后端,即可将聊天、记忆和创作工作流保留在设备上 | HTML/JS、浏览器运行时、Ollama/WebRTC 选项 | Beta | 推文, 仓库 |
| Meetily | Zackriya Solutions | 本地会议转录与摘要桌面应用 | 消除云端会议助手带来的隐私和合规风险 | Tauri、Rust、Next.js、Whisper/Parakeet、Ollama/Claude/Groq/OpenRouter | 已发布 | 推文, 仓库 |
| ai-memory-comparison | carsteneu | 面向编码智能体记忆系统的来源证据对照表 | 让构建者无需手动审计数十个记忆仓库 | 静态站点、证据文件、GitHub Actions | 已发布 | 推文, 仓库 |
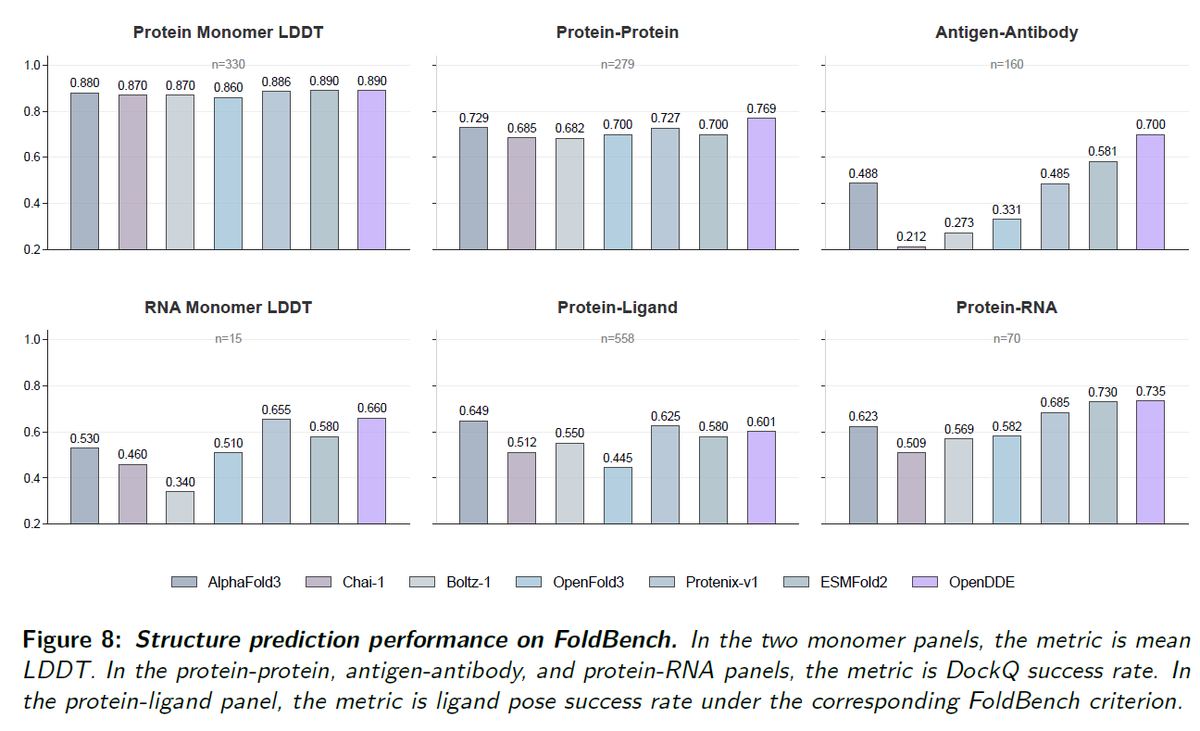
| OpenDDE-preview | Aureka Research | 用于药物发现的开源全原子共折叠模型 | 让类似 AlphaFold 的生物分子建模更易检查和改造 | Python、PyTorch、已发布检查点、Docker | Alpha | 推文, 仓库 |
| OKX.AI | OKX | 支持链上结算的智能体市场 | 为智能体提供寻找工作、雇用服务和收款的场所 | Web 应用、链上支付、智能体身份与托管 | 已发布 | 推文, 网站 |
@VivekIntel 分享了(10 个赞、525 次浏览、5 次收藏)将 T3MP3ST 定位为红队操作界面,而不是聊天机器人功能。它的独特之处不仅在于攻击工具,还在于坚持要求从已提交的数据重新推导基准声明,这与当天对可审计评测的更广泛需求相呼应。
@doodlestein 分享了(9 个赞、1 条回复、941 次浏览、10 次收藏)、@DanKornas 分享了(1 个赞、2 条回复、784 次浏览、3 次收藏)以及 @BitmanTW 分享了(19 个赞、7 条回复、2,822 次浏览、5 次收藏),都从不同角度汇聚到同一种构建模式:让数据留在本地,让界面保持简单,并让实际工作负载便宜到足以持续运行。这一模式比任何单个仓库都更有代表性,因为它以同一套隐私优先的经济逻辑,把 OCR、会议智能和浏览器原生 AI 联系了起来。
@miangoar 强调(29 个赞、1 条回复、1,414 次浏览、17 次收藏)将 OpenDDE-preview 称为开源的“AlphaFold 4”式共折叠发布版本,而公开的 OpenDDE 仓库明确将其定位为用于结构预测、设计和优化的预览版,而非生产流水线。这使它成为一个异常具体的开放科学构建信号:真实的仓库、真实的权重,以及明确声明的成熟度边界。
@okx 宣布(46 个赞、21 条回复、27,979 次浏览)将 OKX.AI 介绍为一个已经上线的市场,智能体可以在其中发现工作、雇用服务并进行链上结算。无论这种模式最终能否持久,它都是当天最清晰的例子之一:构建者正在测试智能体劳动力市场和支付轨道,而不只是打造更好的副驾驶。
6. 新动态与值得关注的事项
治理语言开始追上信息流中的开放性与本地语境关切
@Ivywen_W 报道称(15 个赞、2 条回复、184 次浏览)分享了 Global Dialogue on Artificial Intelligence Governance 第一天的笔记,其中呼应了信息流其他地方已经出现的多个主题:将开放模型和开放标准作为降低依赖与成本的方式;对训练数据进行非歧视性访问;以及 AI 能否带来益处,取决于从设计到评测的本地语境。该帖子之所以值得关注,不在于规模,而在于这种趋同:制度层面的治理语言开始越来越接近从业者对访问、隐私和控制权的抱怨。


医疗 AI 的基准胜利被明确与临床就绪度区分开来
@rohanpaul_ai 总结(2 个赞、2 条回复、1,743 次浏览)将一项 Nature Medicine 研究视为警示:前沿模型在常规测试中可能显得医疗能力很强,但在压力测试、输入缺失或图文设置被改动时仍然脆弱。重要信号在于这种表述方式本身:基准成功被呈现为能力证据,但并不等于已准备好投入真实临床使用。

智能体市场从概念跨入真实产品语言
@okx 宣布(46 个赞、21 条回复、27,979 次浏览)将 OKX.AI 介绍为一个已经上线的市场,智能体可以发现工作、相互雇用并进行链上结算,而 网站将其描述为 A2A 智能体经济。即使今天的证据还无法证明持续需求,它仍然是一次围绕智能体协作和支付轨道的真实产品发布,而不是又一个讨论智能体未来可能做什么的概念性帖子。
7. 机会在哪里
[+++] Domain-data acquisition and rights infrastructure — The most strategic bottleneck in today's feed was missing private-domain coverage, not lack of model ambition. The evidence came from @willdepue 的 帖子串,以及治理侧围绕数据访问展开的讨论——@Ivywen_W 的 笔记——都表明:谁能让授权、脱敏、来源追踪和专家数据生成变得更容易,谁就直接卡在模型部署的关键路径上。
[+++] Stateful agent memory, verification, and environment safety — Ghost memory, hostile web inputs, and brittle medical stress tests all pointed at the same gap: agents still need better state handling and clearer runtime trust boundaries. The evidence spans @omarsar0 的 A-TMA 帖子、@rohanpaul_ai 的 AI Agent Traps 帖子串,以及他的 Nature Medicine 摘要,共同构成了比单篇论文更强的信号。
[++] 更便宜的评测循环与模型路由基础设施 — PACE、OpenBench、单任务成本图表以及 Hy3 式挑战者发布,都指向同一个运营问题:解决一项任务最便宜且可靠的路径是什么?市场需要将代理评测、执行框架基准,以及依据成本、延迟和完成质量进行的路由结合起来的产品,而不是只按品牌选择模型。
**[++] 面向真实工作的本地优先后台 AI ** — Alex Finn 的六台电脑配置、Meetily、FrankenOCR 和 FreeLattice 都显示出人们对可在用户控制下持续运行的 AI 的需求。这是一个竞争性机会,因为已经存在一些解决方案,但这一模式足够广泛,仍可能凭借更好的产品包装、更简单的配置和更强的本地模型管理脱颖而出。
[+] 具身智能部署工具与供应链情报 — 关于机器人的证据比软件讨论更窄,但清楚指出了痛点所在:执行器、稀土、制造速度和部署行业。机会正在形成,但尚未迫在眉睫,因为市场是真实存在的,同时资本密集度和硬件依赖仍然拖慢着类似软件的迭代速度。
8. 要点
- AI 瓶颈被描述为数据覆盖,而不只是算力。 当天信号最强的讨论串认为,前沿进展正越来越受到私有和领域专属数据访问的限制,而不仅仅是集群规模。 (来源)
- 部署经济性正以任务为单位接受评判。 单任务成本比较、Hy3 等开放权重挑战者以及本地模型集群,都指向同一个运营问题:什么能以足够低的成本把工作做完,并值得持续开着? (来源)
- 可靠性讨论变得具体得多。 最有价值的帖子讨论了幽灵记忆、恶意网页输入、执行框架效率和代理评测,这表明团队如今正在诊断智能体究竟在哪里失效,而不只是争论它们是否足够好。 (来源)
- 本地优先工具成为应对成本和隐私压力的首选模式。 FrankenOCR、Meetily、FreeLattice 和本地模型集群都押注于同一点:让工作负载尽可能靠近用户,并在可能的情况下去除持续性的云依赖。 (来源)
- 具身智能仍然真实存在,但其推进方式比软件 AI 更加务实强硬。 最有力的机器人证据来自出货差距、部署表格和部件瓶颈,而不是演示,这使市场更容易看清,但仍受到约束。 (来源)
- 制度层面的治理语言正与从业者对开放性、访问权和安全保障的关注趋同。 Global Dialogue 的笔记和关于临床就绪度的警示都表明,公共讨论正在超越对基准成绩的庆祝,转向关注谁能安全使用 AI,以及应在什么条件下使用。 (来源)