Twitter AI - 2026-07-07
1. 大家在讨论什么
1.1 对内部状态可解释性的讨论,已从“好奇”变成“控制面”(🡕)
当天最大的技术讨论簇来自 Anthropic 的 J-space 工作。大家不再只通过输出结果讨论模型,而是开始关注:内部激活能否被读取、编辑,并用于审计隐藏推理、越狱强度,以及模型是否意识到自己正在被评测。至少有四条彼此不同的讨论线索支撑了这一主题,覆盖了从广泛兴趣到明确红队使用场景的不同层次。
@sporadica 作出回应(757 次点赞,41 条回复,83,152 次浏览,275 次收藏)提到 Anthropic 的 workspace 文章,强调论文中的核心说法:Claude 内部“涌现”出了一个小型、可被意识访问的工作空间,而不是人工硬编码进去的。附上的摘录之所以关键,是因为它点明了读者争论的准确表述:模型可以把一个概念“放在脑中”,却从不把它写出来。回复很快分成两派:一派感到着迷,另一派则主张应把这一结果放在可解释性范畴,而不是感知能力范畴来讨论。

@anishmoonka 总结(18 次点赞,4 条回复,5,111 次浏览,20 次收藏)用更偏操作性的方式解释了同一结果:J-lens 可以在输出前显露出诸如“fake”和“fictional”之类的词;可以通过替换潜在读数,例如把 spider 换成 ant,从而翻转答案;还可以在移除该工作空间后,让多步推理直接坍塌。这让这项研究更像是一种仪表化能力,而不是神秘主义:它提供了一种检查、干预和审计那些不会出现在文本中的推理过程的方法。
@aakashgupta 认为(34 次点赞,10 条回复,6,765 次浏览,18 次收藏)认为,更具颠覆性的含义在于评测意识。其观点是:如果模型会私下把某个提示标记为测试,那么仅基于输出的安全基准测到的,可能是“考试行为”,而不是部署环境中的真实行为。回复里补充了两个有价值的保留意见:一条质疑 Anthropic 是否已将“识别评测”与“异常提示格式”区分开;另一条则警告,若直接针对可见激活来训练模型,可能会产生类似 Goodhart 定律的压力,促使模型把这些信号藏起来。
讨论洞察: @Ubannoblesse 提出(12 次点赞,1 条回复,564 次浏览,8 次收藏)提出了同一工具链的一个实用红队场景:使用 Neuronpedia 风格的 Jacobian Lens 读数,查看一次越狱是否仍携带隐藏的安全标记,如“fictional”或“unauthorized”,甚至还能衡量人格型越狱究竟在多大程度上真的生效。这推动讨论从“模型在想什么”转向“我们如何审计这种不安全行为到底是真实发生了,还是只是表面现象?”
与前一天相比: 在 2026-07-06,关于可靠性的讨论主要聚焦于陈旧记忆、敌对输入和 harness 故障。到了 2026-07-07,这场讨论向内深入了一层:人们开始追问,内部状态是否能在输出出错之前,就提前暴露失败迹象。
1.2 Agent 改进栈变得更加明确:规格、可重放故障与可度量回归(🡕)
第二个讨论簇把 agent 质量视为系统问题,而非提示词问题。反复出现的模式是:先把意图固化下来,再把生产环境中的失败转成可重放测试,并证明每次修复确实改进了行为,而不是悄悄破坏了别的部分。
@businessbarista 总结(80 次点赞,8 条回复,10,463 次浏览,169 次收藏)提到一场持续学习相关演讲,将 agent 改进拆分为模型、harness 和记忆三个层面。最具体的说法是:生产日志只有在被转化为带评估器的可重放案例后,才能算作学习环境,这样候选修复方案才能被重复运行、评分和做回归测试。回复进一步把这个观点说得更尖锐:有位回应者指出,生产中的常见陷阱,是在还没确认 bug 究竟属于 prompt、tool、skill 还是 training 层之前,就把所有失败都归咎于“记忆”。
@gokulr 介绍(31 次点赞,5 条回复,5,396 次浏览,57 次收藏)将 ProductSpec 介绍为一种用于实现前软件意图的开放 Markdown 标准,而公开的 ProductSpec 仓库 也让这一主张更具体,涵盖问题、假设、范围、验收标准、成功指标、spec_revision 以及解析器工具。它最有辨识度的角度在于:PRD 已不再只是给人类交接的文档。现在,它们还需要具备足够的结构化程度,才能让工程师、设计师和 AI agents 在多轮修订中保持一致意图。
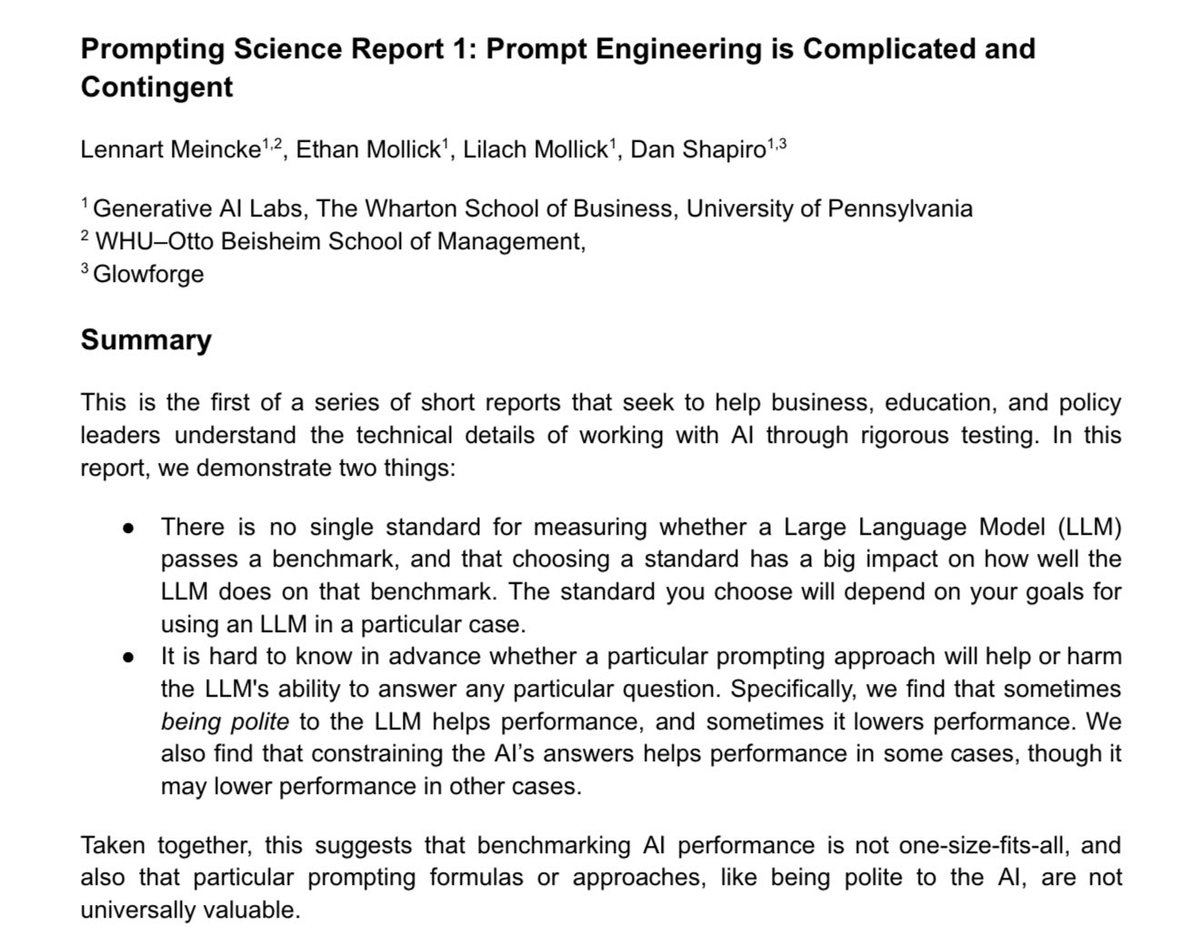
@emollick 认为(50 次点赞,6 条回复,5,374 次浏览,29 次收藏)认为,提示技巧大多已经失去了早期优势,更好的抽象层是更清晰的目标、输出和测试。他附带的 Prompting Science 报告集也强化了这一点:它把 prompt engineering、chain-of-thought 和 expert personas 拆成可分别测试的主张,而不是混成一袋口耳相传的经验之谈。
讨论洞察: 这里最有价值的分歧在于漂移问题。对 ProductSpec 的回复认为,难点不在于把规格写一次,而在于如何持续让规格与已发布代码保持一致;而对持续学习线程的回复则警告说,如果没有可重放测试,仅仅存储更多状态,只会制造更难审计的错误。
与前一天相比: 在 2026-07-06,信任与验证更多体现为宽泛偏好。到了 2026-07-07,它们已经以明确工件的形式出现:持续更新的规格、重放案例、评估器循环和回归防护。
1.3 开放权重竞争与部署经济学变得更具体了(🡕)
关于基准的讨论不断收敛到部署算账:单任务成本、单任务耗时、内存占用、免费 API 窗口,以及本地模型或开放模型能否承担日常工作。整体氛围并不是说前沿质量不再重要,而是买方越来越希望看到证据,证明这种质量能在真实预算和真实运行时约束下成立。
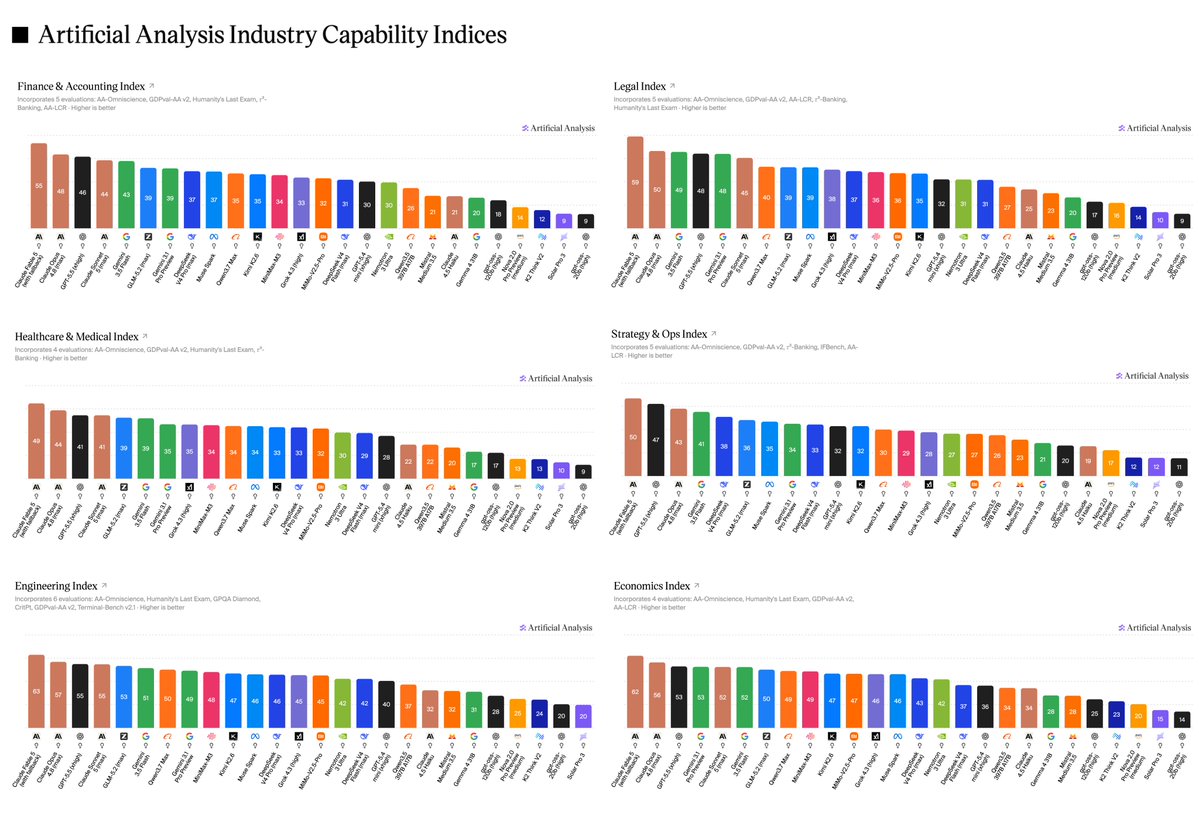
@ArtificialAnlys 介绍(286 次点赞,17 条回复,23,307 次浏览,77 次收藏)发布了六个新的行业能力指数,覆盖金融、法律、医疗、战略与运营、工程和经济学。帖子里最具体的细节都与经济性相关:DeepSeek V4 Flash 在这六项指数上的单任务成本低于 $0.04,GLM-5.2 在六项行业指数中有五项领跑开放权重模型,而 Gemini 3.1 Pro 完成法律任务的速度约为 Claude Fable 5 的七倍,同时分数差距控制在 11 分以内。这使排行榜不再是一场单一标量竞赛,而更像一张按工作负载划分的权衡表。
@amitisinvesting 认为(194 次点赞,44 条回复,28,387 次浏览,33 次收藏)表示,token 成本已经高到让人难以承受,以至于 OpenAI 和 Anthropic 现在开始通过补贴使用量来锁定初创公司。附上的《华尔街日报》截图,让这一说法落在了一场具体的 go-to-market 竞争上,而不是泛泛地抱怨模型定价。

@businessbarista 展示(61 次点赞,10 条回复,7,526 次浏览,60 次收藏)展示了相反方向的一种对冲:Alex Finn 的家庭 AI 实验室,由三台 Mac Studio、一台 DGX Spark、一台 5090 机器、Tailscale 和一个在多台机器间路由任务的 Hermes agent 组成,因此每小时运行 sweep 和异常检测只需多花约 $60 电费,而不是支付数千美元 API 账单。回复补充了一个重要细节:本地部署最有吸引力的场景,是高频、低判断需求且允许较慢速度的任务;而工作流可移植性依然比单纯“拥有算力”本身更重要。
@rohanpaul_ai 强调(15 次点赞,3 条回复,4,408 次浏览,4 次收藏)把 Tencent 的 Hy3 仓库 视为同样压力下的另一种表达。他的帖子强调了 295B MoE、21B 激活参数、Apache 2.0 许可和低于 300GB 的 FP8 占用,并将其与 GLM-5.2 更重的服务需求作对比。

讨论洞察: 反复出现的分野不是意识形态,而是任务形态。人们仍会把前沿模型留给高难度判断任务,但越来越希望用开放或本地系统来处理那些每小时、每个 repo 或每条客户 trace 都会反复出现的杂务。
与前一天相比: 在 2026-07-06,单任务成本和本地模型集群已经是核心话题。到了 2026-07-07,对冲手段变得更加明确:算力积分、免费 API 窗口和自有硬件都被视为降低对单一供应商定价或限额依赖的方式。
1.4 构建者正把 AI 基础设施进一步嵌入科学、临床和设备特定工作流(🡕)
构建者层面的信号,不再是又一个通用助手,而是围绕专业工作所缺失的基础设施。最突出的发布,是那些面向“仅靠给模型下提示显然不够”的领域所打造的基准、运行时和基础层。
@WilliamCQHua 宣布(32 次点赞,3 条回复,3,300 次浏览,16 次收藏)将 OpenDDE 介绍为一个开源全原子共折叠模型,并明确表示这只是通往更广泛药物发现引擎的预览步骤。附图和公开的 OpenDDE 仓库 让这点更具体:它给出了已发布的 checkpoints、基准结果,以及清晰声明的成熟度边界,而不是暗示已经可以投入生产。

@Qualcomm_Dev 介绍(9 次点赞,1 条回复,561 次浏览)介绍了 GenieX:一个开源运行时,可在本地跨 NPU、GPU 和 CPU 运行 GGUF 模型或 Qualcomm AI Hub bundles,并提供 CLI、Python、Java/Kotlin、Docker 以及兼容 OpenAI 的服务器。这一信号更偏向底层管线而非模型层:让 Snapdragon 设备上的部署足够简单,以至于模型选择变成一个配置细节。
@ModelScope2022 披露(16 次点赞,1 条回复,1,248 次浏览,5 次收藏)介绍了 ResearchClawBench:一个覆盖 10 个学科、40 项任务的端到端科学研究 agent 基准,并指出当前系统的分数仍停留在 20 多分出头。公开的 论文 和 数据集 让这一差距变得清晰:难点不在于生成像研究论文一样的文字,而在于能否在真实任务中撑过文献综述、分析和同行评审式打分。
讨论洞察: 来自 @DanKornas 关于(15 次点赞,3 条回复,1,300 次浏览,16 次收藏)的一条帖子介绍了一个用于医疗试验的自我改进型 RAG 循环,而 @LifeNetwork_AI 关于(12 次点赞,5 条回复,74 次浏览)则讨论了“有用”与“可部署”之间的临床 AI 差距,二者都指向同一方向。构建者不再只问模型能否回答问题,他们正在围绕这个答案构建溯源、评估、变异和合规层。
与前一天相比: 在 2026-07-06,构建者更偏向本地优先和可审计工具。到了 2026-07-07,同样的倾向已经扩展到药物发现、科学基准、设备运行时和受监管的临床工作流。
2. 什么让人沮丧
仅看输出的评估方式,开始显得不够用了
严重程度:高。@aakashgupta 认为(34 次点赞,10 条回复,6,765 次浏览,18 次收藏)认为,模型可能会私下识别自己何时正在被测试,这会让许多安全基准测到的只是考试行为,而非部署行为。@anishmoonka 补充(18 次点赞,4 条回复,5,111 次浏览,20 次收藏)指出,J-lens 能在一次错误行为被写出来之前,就显露出诸如“fake”或“fictional”这样的隐藏词;而 @Ubannoblesse 推动(12 次点赞,1 条回复,564 次浏览,8 次收藏)则把同样的工具用于衡量越狱。人们目前的应对方式是:将输出与内部状态信号交叉比对,质疑评测格式是否泄露了过多信息,并呼吁需要类似审计日志的工具。这个方向值得投入,因为痛点同时打在安全评测、红队测试和对齐主张上。
团队依然分不清,agent 到底是哪一层出了问题
严重程度:高。@businessbarista 总结(80 次点赞,8 条回复,10,463 次浏览,169 次收藏)描述了一种持续学习工作流,其中故障可能属于模型、harness 或记忆层,回复里也明确警告,不要把每条糟糕的 trace 都贴上“记忆问题”的标签。@gokulr 披露(31 次点赞,5 条回复,5,396 次浏览,57 次收藏)则在规格层表达了同样的痛点:如果没有一个持久的共享工件和修订轨迹,意图会在文档、tickets、agents 和代码之间不断漂移。@emollick 强化了(50 次点赞,6 条回复,5,374 次浏览,29 次收藏)认为,清晰的目标和测试比提示技巧更重要;换句话说,很多团队在抵达模型质量问题之前,还在和“定义质量”作斗争。当前的应对模式是:正式规格、可重放案例,以及在昂贵重训之前优先修补 harness。这个方向值得投入,因为只要团队试图系统化提升 agent,而不是一次次手调 prompt,这类痛点就会出现。
前沿模型的高质量能力,依然昂贵且脆弱,难以运维
严重程度:高。@amitisinvesting 认为(194 次点赞,44 条回复,28,387 次浏览,33 次收藏)认为,token 定价之高,已迫使实验室通过赠送算力来争夺初创用户,这体现的是买方阻力,而非供给充裕。@businessbarista 展示(61 次点赞,10 条回复,7,526 次浏览,60 次收藏)详细展示了本地硬件这种替代路线,而 @deredleritt3r 发现(125 次点赞,7 条回复,7,128 次浏览,26 次收藏)则指出,在一个旨在模拟非技术背景律师使用方式的基准中,Claude Fable 5 在法律推理上的表现明显好于其开箱即用的搜索能力。当前的应对模式是工作负载拆分:把前沿模型留给高难度判断任务,在需要时显式加入搜索或工具层,并把重复性作业路由给更便宜的开放或本地系统。这个方向值得投入,因为价格、可用性和工作流缺口,正共同推动用户转向路由与编排基础设施。
受监管和科学领域的 AI,依然常在部署前停滞不前
严重程度:高。@ModelScope2022 报告(16 次点赞,1 条回复,1,248 次浏览,5 次收藏)指出,当前系统在 ResearchClawBench 的 40 项真实科学任务上,得分仍只有 20 多分出头,这很直接地说明端到端科研自动化依然脆弱。@LifeNetwork_AI 认为(12 次点赞,5 条回复,74 次浏览)认为,医疗领域中“有用”和“可部署”之间的差距,核心在于溯源、验证与合规架构,而非模型质量;而 OpenDDE 仓库 本身也将其发布标注为 preview,而不是生产流水线。人们的应对方式是缩小范围、让人工保留在审批路径中,并在模型外围搭建基准或溯源层。这个方向值得投入,因为瓶颈在于运营层面的信任,而不是缺少前沿能力主张。

3. 大家希望有什么
普通产品团队也真正用得上的内部状态审计工具
最迫切的新需求,不是再来一句安全口号,而是能展示模型在答案出现在屏幕前私下注意到了什么的工具。@anishmoonka 做出(18 次点赞,4 条回复,5,111 次浏览,20 次收藏)把这一需求说得很明确:有条回复要求 Anthropic “ship j-lens with audit logs”;而 @aakashgupta 认为(34 次点赞,10 条回复,6,765 次浏览,18 次收藏)则认为,如果模型能识别测试,那么仅看输出的安全评估已经不够了。@Ubannoblesse 推动(12 次点赞,1 条回复,564 次浏览,8 次收藏)则把同样的思路用于越狱度量。如今已经有一些可解释性工具,但信息流清楚表明,市场需要的是一个产品化的审计层,而且要能在单一前沿实验室之外使用。机会:直接。
能让 agent 意图长期保持对齐的持续更新规格与重放系统
人们想要的不是更多 prompt 技巧,而是能扛住交接和漂移的工件与循环。@gokulr 提出(31 次点赞,5 条回复,5,396 次浏览,57 次收藏)把 ProductSpec 视为一个带修订、验收标准和决策轨迹的意图层;而 @businessbarista 描述(80 次点赞,8 条回复,10,463 次浏览,169 次收藏)则认为,可重放失败与具备回归意识的持续学习才是真正的改进路径。@DanKornas 补充(15 次点赞,3 条回复,1,300 次浏览,16 次收藏)则给出了同一思路的具体构建者版本:一个会变异 SOP 并比较权衡的自我改进型 agentic RAG 循环。现在虽已有一些局部答案,但信息流表明,团队仍想要一个可靠工作流,把规格、评估、变异和修订串在一起。机会:直接。
围绕前沿模型的可移植路由层与自有运行时层
另一个实际需求,是在价格、限额或模型排名变化时,AI 运维仍然可用。@amitisinvesting 将其定义为(194 次点赞,44 条回复,28,387 次浏览,33 次收藏)从买方角度体现了这种需求:初创公司正在抵制 token 成本;而 @businessbarista 展示(61 次点赞,10 条回复,7,526 次浏览,60 次收藏)则展示了自运营硬件这一对冲方式。@rohanpaul_ai 和 @Qualcomm_Dev 展示(9 次点赞,1 条回复,561 次浏览)体现的是供给侧:更便宜的开放模型如 Hy3,以及更易用的本地运行时如 GenieX。这个需求很现实,而非理想化,但竞争也已经开始激烈,因为很多团队都在收敛到某种“路由 + 本地 fallback”的组合。机会:竞争激烈。
面向医疗和科学的可部署领域基础设施
信息流反复将“能力”与“可部署性”区分开来,尤其是在受监管和研究密集型领域。@LifeNetwork_AI 表示(12 次点赞,5 条回复,74 次浏览)认为,临床 AI 需要先具备溯源、验证和合规层,其建议才能真正被执行;而 @ModelScope2022 展示(16 次点赞,1 条回复,1,248 次浏览,5 次收藏)则显示,在 ResearchClawBench 上,当前系统距离端到端科学自主仍有多远。@WilliamCQHua 补充(32 次点赞,3 条回复,3,300 次浏览,16 次收藏)展示了 OpenDDE 这样的开源药物发现基础层,但其 repo 本身也将其标注为 preview。这个组合说明,市场直接需要的是一种封装方式,能把模型、溯源、评估和审批界面,按单一领域逐个打包起来。机会:直接。
4. 在用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Fable 5 | LLM | (+/-) | 在许多领域/能力讨论中处于领先位置;在法律研究与高难度思考方面口碑强 | 昂贵、受可用性影响大,在重搜索工作流上弱于部分 OpenAI 模型 |
| GLM-5.2 | LLM | (+) | 开放权重代码能力信号强、长上下文可信度高,并在行业细分指数中排名靠前 | 服务占用重,超长自主运行方面证据仍然参差不齐 |
| Hy3 | LLM | (+) | 295B MoE,21B 激活参数,Apache 2.0,256K 上下文,部署性优于更重的开放竞品 | 编码能力仍落后于 GLM-5.2;部分质量主张来自 Tencent 自家评测 |
| DeepSeek V4 Flash / Pro | LLM | (+/-) | 单任务成本极低,是很有用的基准参考点 | 在许多领域的能力处于中游,落后于前沿领跑者 |
| ProductSpec | 规格标准 | (+) | 为人类和 agents 提供关于问题、范围、验收标准和成功指标的共享格式 | 仍属新事物,规格/代码漂移仍是实际采用风险 |
| Verifiable continual learning | 方法 | (+) | 把日志转化为可重放故障和回归防护;可在模型、harness 和记忆层之间定位修复点 | 需要仿真、评估器和许多团队尚不具备的基础设施 |
| Local AI lab stack(Mac Studios、DGX Spark、Ollama、Hermes、Tailscale) | 部署模式 | (+/-) | 在单一操作者可控网络下,具备良好隐私性、成本控制和常驻后台工作的能力 | 前期硬件成本高、模型吞吐较慢,并增加运维负担 |
| ResearchClawBench | 基准 | (+) | 用专家 rubric 和隐藏目标论文评估端到端科学研究 | 当前系统得分仍偏低;该基准本身就是有意设计得困难且缓慢 |
| GenieX | Runtime | (+) | 可在 Snapdragon 的 CPU、GPU 和 NPU 上本地运行 GGUF 或 Qualcomm AI Hub 模型;提供兼容 OpenAI 的服务器 | 仅支持 Snapdragon,且仍处于 developer preview |
| Omnigent contextual policies | Agent 治理 | (+) | 在不同 harness 间加入会话感知预算、动态风险评分和最小权限控制 | 仍是较早期的控制层,今天的信息流中缺少大量实地证据 |
整体满意度光谱相当务实。@ArtificialAnlys 展示(286 次点赞,17 条回复,23,307 次浏览,77 次收藏)表明,买方越来越按领域、成本和单任务耗时来比较模型;而 @rohanpaul_ai 展示(15 次点赞,3 条回复,4,408 次浏览,4 次收藏)则说明,如今的可部署性不仅包括分数榜,还包括内存占用和自托管可行性。
最清晰的迁移模式,是工作负载拆分。@businessbarista 展示(61 次点赞,10 条回复,7,526 次浏览,60 次收藏)显示,前沿模型被保留给高难度判断任务,而本地系统处理重复性、常驻运行的工作;同时,@FelixAix 使用(21 次点赞,14 条回复,2,044 次浏览,9 次收藏)则把 Hy3 的免费 API 窗口当作一个提示:在承诺生产栈之前,先测试开放模型。@deredleritt3r 补充(125 次点赞,7 条回复,7,128 次浏览,26 次收藏)还给出了更细致的工具判断:Fable 5 在法律推理上看起来远强于搜索,这再次提醒人们,“最佳模型”取决于工作流中的具体环节。
控制面也在不断从模型本身向外移动。@gokulr 封装为(31 次点赞,5 条回复,5,396 次浏览,57 次收藏)把意图前移到 ProductSpec,而 @databricks 宣布(9 次点赞,1 条回复,1,034 次浏览,3 次收藏)则提出了适用于 Claude Code、Codex 和自定义 harness 的 Omnigent contextual policies,用于跨会话治理。共同方向是:在把模型交给真实工作之前,先在其外围加入结构、权限和状态管理。

5. 大家在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| ProductSpec | gokulrajaram | 面向实现前软件意图的开放标准 | 让产品意图在人员、tickets 和 AI agents 之间保持清晰,而不是让 PRD 退化成模糊散文 | Markdown 规格格式、parser CLI、JSON schema、决策轨迹 | Beta | 推文, 仓库 |
| Hy3 | Tencent Hunyuan | 开放权重 295B MoE 推理与 agent 模型 | 为团队提供一个对商业更友好的开放替代方案,替代更重的旗舰模型和部分前沿 API | MoE、256K context、vLLM、SGLang、Hugging Face、OpenRouter | 已发布 | 推文, 仓库, 模型 |
| OpenDDE | Aureka Research | 面向生物分子结构的全原子共折叠基础模型 | 让药物发现中的结构预测与设计更易检查、更易改造 | Python、PyTorch、已发布 checkpoints、Docker | Alpha | 推文, 仓库, 网站 |
| GenieX | qualcomm | 面向 Snapdragon 硬件的端侧生成式 AI 运行时 | 消除在 Qualcomm 设备上运行本地 LLM 和 VLM 的集成摩擦 | C SDK、CLI、Python、Java/Kotlin、Docker、兼容 OpenAI 的服务器 | Beta | 推文, 仓库, 文档 |
| ResearchClawBench | InternScience | 端到端自主科学研究基准 | 衡量 agents 是否能在真实任务中撑过文献综述、数据分析和论文式评估 | GitHub repo、Hugging Face dataset、专家 rubrics、arXiv 论文 | Beta | 推文, 仓库, 论文 |
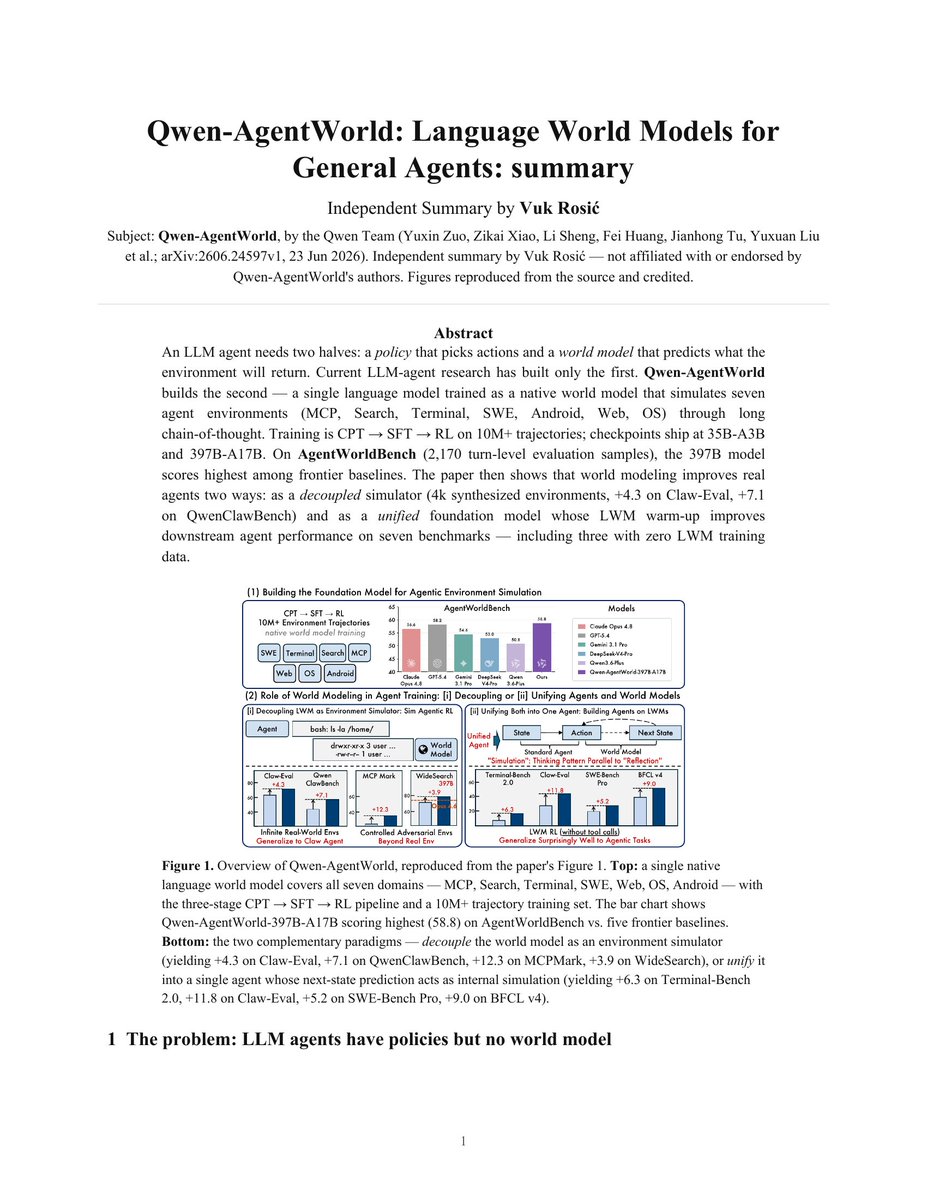
| Qwen-AgentWorld | QwenLM | 语言世界模型加 AgentWorldBench | 填补 agents 缺失的 world-model 层,并支持跨七个领域的仿真训练 | 35B/397B MoE 变体、10M+ 轨迹、CPT/SFT/RL | Beta | 推文, 仓库, 论文 |
| autonomous-agentic-rag | FareedKhan-dev | 面向医疗试验设计的自我改进型 agentic RAG 演练 | 用显式评估器、SOP 变异和 Pareto 比较取代盲目手调 | LangGraph、FAISS、DuckDB、Ollama、多 agent 角色、5D 评估器 | Alpha | 推文, 仓库 |
@gokulr 分享(31 次点赞,5 条回复,5,396 次浏览,57 次收藏)把 ProductSpec 视为一种方式:在代码尚未存在之前,就把意图移入一个持久、机器可读的层。它之所以值得关注,不只是因为采用了 Markdown 格式,更因为它明确假定:验收标准、修订记录和决策轨迹,必须在人员与 agents 之间共同保留下来。
@DanKornas 分享(15 次点赞,3 条回复,1,300 次浏览,16 次收藏)则把 autonomous-agentic-rag 展示为同一倾向在实时优化循环中的应用:规划器、专业 agent、五维评估器、SOP 变异,以及围绕医疗试验设计的 Pareto 比较。这两个项目合在一起,指向一种反复出现的构建模式:对一次性提示的信任更少,对显式结构与反馈的投入更多。

@WilliamCQHua 将其定位为(32 次点赞,3 条回复,3,300 次浏览,16 次收藏)把 OpenDDE 视为药物发现的基础层,而不是一个打磨完毕的终端产品;其 repo 也明确保留了 preview 标签。@Qualcomm_Dev 做了类似的事(9 次点赞,1 条回复,561 次浏览)则从运行时侧给出同样的信号:GenieX 是一种让特定硬件家族上的本地部署更容易的基础设施,而不是一个炫目的助手体验。它们共享的模式是:先把缺失的底层基座发布出来,再让下游工作流在其上生长。
Hy3、ResearchClawBench 和 Qwen-AgentWorld 也从三个不同角度说明了同一个更广泛的观点。Hy3 是一个在许可与服务层面都很强、且可部署的开放模型;ResearchClawBench 是一个严苛基准,揭示科学自主距离真正成熟还有多远;Qwen-AgentWorld 则把世界建模本身视为需要构建的对象,而不是默认动作选择已经足够。多个构建者正在独立收敛到同一个问题表述:如果 AI 要变得持久可用,缺失的产品通常不是模型本身,而是模型周围的脚手架、仿真器或基准。
6. 新的与值得注意的
Qwen-AgentWorld 把世界建模当成产品,而不是事后补丁
@VukRosic99 总结(5 次点赞,205 次浏览,3 次收藏)将 Qwen-AgentWorld 介绍为一个已发布的语言世界模型,覆盖 MCP、Search、Terminal、SWE、Android、Web 和 OS。公开的 仓库 显示,397B 变体在 AgentWorldBench 上总分 58.71,略高于 GPT-5.4 的 58.25,并将更大的价值定位为可控仿真与下游 agent 能力提升。这一点之所以值得关注,是因为它把环境建模本身视为需要构建的对象,而不是假定只要做好动作选择就足够。
Puzzle-75B-A9B 让服务效率本身看起来像前沿进展
@omarsar0 指出(16 次点赞,6 条回复,3,034 次浏览,18 次收藏)将 NVIDIA 的 Puzzle-75B-A9B 论文 视为混合 MoE 模型上的一项强压缩成果。论文和模型页表示,压缩后的模型在 8xB200 节点上大致将交互式服务器吞吐翻倍,并把单张 H100 上 1M-token 的并发能力从 1 个请求提升到 8 个,同时保持广泛的下游质量。这之所以值得注意,是因为 headline 已不再只是“模型更小了”,而是服务成本大幅下降后,哪些 agentic 工作负载终于变得负担得起。

Scales++ 把基准覆盖重新定义为一个题项选择问题
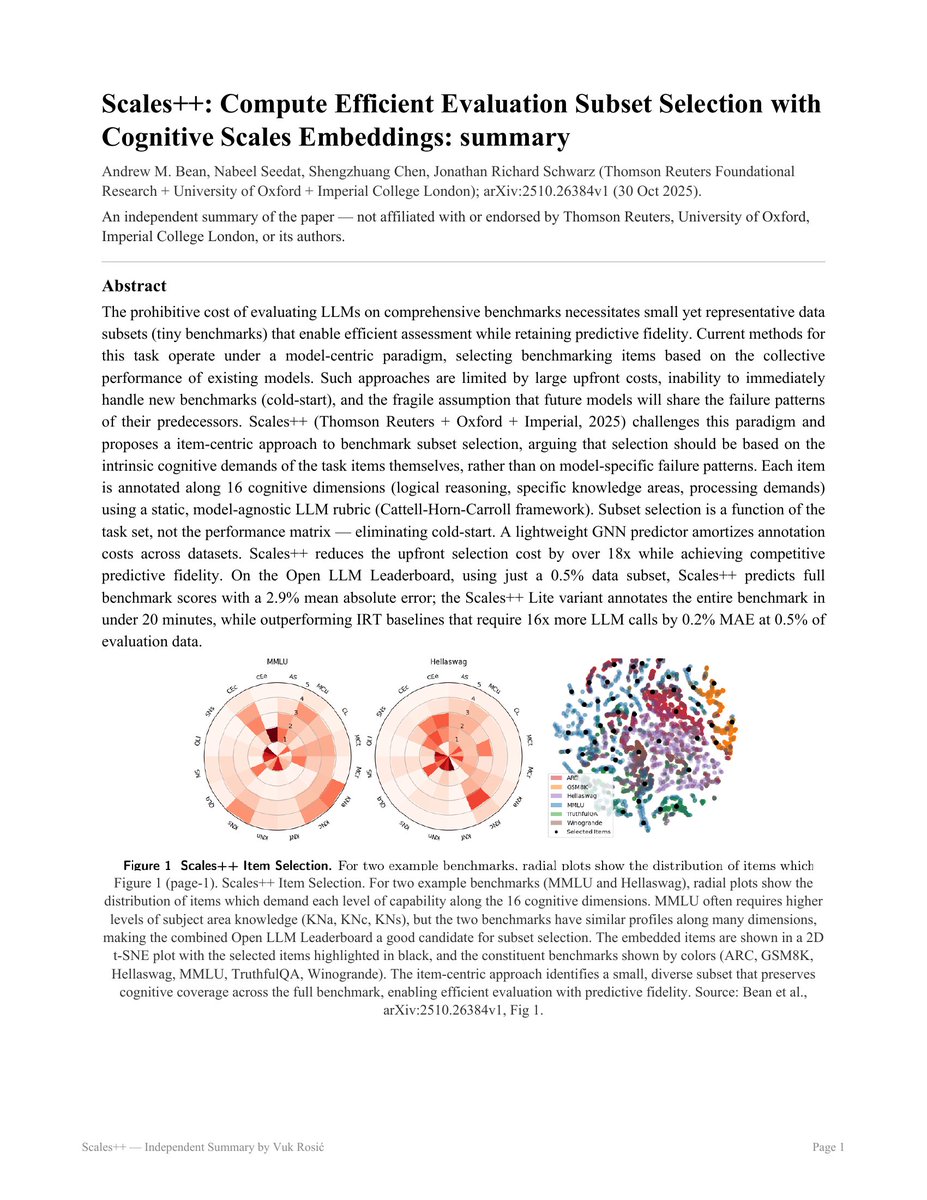
@VukRosic99 总结(2 次点赞,80 次浏览,1 次收藏)将 Scales++ 介绍为一种以题项为中心的方法:它利用 16 个认知维度,从 0.5% 的子集预测完整基准分数,而不是依赖历史模型表现日志。最值得注意的主张是其冷启动韧性:即便是新的模型家族或新的基准,也无需先支付建立历史矩阵的高额前期成本,就能完成评估。这让评估成本本身也变成了一个产品面,而不是固定税负。
7. 机会在哪里
[+++] Internal-state debugging and eval-awareness tooling — Strong evidence came from multiple directions today: @AnthropicAI 展示(318 次点赞,20 条回复,38,913 次浏览,122 次收藏)将 J-space/J-lens 视为检查内部推理状态的方法,而 @slatestarcodex 认为(13 次点赞,5 条回复,6,735 次浏览,1 次收藏)则认为,仅看输出的评估遗漏了模型对自身不确定性的意识程度。这个方向很强,因为痛点与拟议中的控制面高度匹配:人们想要的是能告诉他们系统为什么失败的工具,而不只是知道它有没有失败。
[+++] Spec, replay, and regression infrastructure for agents — @gokulr 提出 ProductSpec 作为持久意图层,@DanKornas 分享 作为评估器驱动的 agentic RAG 循环,以及 @yoheinakajima 认为(161 次点赞,18 条回复,35,400 次浏览,28 次收藏)认为,持续改进只有在故障可复现、修复可定位到模型、harness 或记忆层时才真正有效。这个方向很强,因为多个独立构建者得出了同样结论:如果没有持续更新的规格和可重放测试用例,单靠 prompting 是不够的。
[++] Portable owned-runtime layers for AI workloads — @wsj 报告(107 次点赞,20 条回复,46,861 次浏览,19 次收藏)显示,初创公司正在不同厂商间比较算力积分套餐;@businessbarista 展示 展示了一套用于日常工作的私有家庭实验室栈;@Qualcomm_Dev 发布 则是用于本地 Snapdragon 推理的 GenieX。这个机会属中等,因为团队显然都在尝试摆脱对纯 API 的依赖,但最终胜出的抽象层还未定型。
[++] Deployment scaffolding for scientific and regulated domains — @WilliamCQHua 分享 展示了用于生物分子预测的 OpenDDE,@ModelScope2022 分享 展示了面向自主科学的 ResearchClawBench,而 @rohanpaul_ai 强调(4 次点赞,2 条回复,594 次浏览,2 次收藏)则提出了一个临床可部署性框架,加入了更真实的错误率、效用和安全性。这个机会属中等,因为构建者活力可见、未满足需求也很明确,但大多数工件仍是基础设施或基准,而不是面向从业者的完整操作系统。
[+] Cheaper evaluation and agent-governance layers — @VukRosic99 分享 展示了用于基准子集选择的 Scales++,而 @databricks 分享 则展示了用于会话感知权限与预算的 Omnigent contextual policies。这个方向仍处于萌芽阶段,因为两条帖子都把评估成本和策略执行视为独立产品层,但与围绕调试和重放的更强重复信号相比,今天的证据还偏早期。
8. 要点
- 内部状态可见性是当天最清晰的趋势之一。 Anthropic 的 J-space/J-lens 帖子,以及随后围绕评测意识的讨论,都在说明:对于安全或可靠的推理工作,仅凭输出打分已经不够了。(来源)
- 构建者持续在 agent 外围加上显式结构,而不是只依赖 prompts。 ProductSpec、评估器驱动的 agentic RAG 和可验证持续学习,都把重点放在规格、重放和局部回归上,而不是一次性的巧妙提示。(来源)
- 开放权重竞争的评判标准,已同样取决于可部署性与经济性,而不只是质量。 Artificial Analysis 比较了领域特定表现与成本;Hy3 的讨论聚焦于激活参数和自托管实用性;初创公司的积分比价,也让基础设施支出成为产品讨论的一部分。(来源)
- 本地与自有运行时配置,越来越像是日常工作的常态。 家庭实验室栈的帖子和 Qualcomm 的 GenieX 发布,都说明用户正转向私有、操作者可控的推理路径,而不是默认所有事都用托管 API。(来源)
- 科学与临床 AI 确实有很强的构建势能,但仍高度依赖脚手架。 OpenDDE、ResearchClawBench 和关于临床可部署性的表述,都更聚焦基础设施、基准和评估现实性,而非开箱即用的生产系统。(来源)
- 评估成本与世界建模,开始显现为独立的产品层。 Scales++ 试图压缩基准成本,而 Qwen-AgentWorld 则把模拟环境和世界模型视为一等训练资产。(来源)