Twitter AI - 2026-07-09
1. 人们在讨论什么
1.1 私有评测和 harness 设计比 headline benchmark 更重要(🡕)
今天最强的一组讨论,并不是泛泛地争论“哪家实验室赢了”,而是:是否有人足够信任公开 benchmark 以据此做采购决策;团队该如何衡量每个已完成任务的成本;以及最终结果究竟有多少实际上来自模型外围的 harness。至少有五条保留内容支撑了这一转向,横跨企业编码、从业者评测和发布日 benchmark 讨论。
@alighodsi 表示 (161 个赞,9 条回复,14,899 次浏览) 表示,Databricks 针对自己的任务、基础设施和数百万行代码库做了内部评测,因为它不想“盲目信任公开 benchmark”。链接中的 Databricks 文章 则把这一说法具体化:GLM-5.2 以约 $1.28 的单任务成本进入最高能力梯队,Opus 4.8 约为 $1.94;即便底层模型不变,harness 的选择也可能显著改变端到端成本。
@rohanpaul_ai 重新诠释 (16 个赞,5 条回复,3,290 次浏览) 将同一结果解读为模型智能与 agent 效率的分离。他在帖子中认为,GLM-5.2 证明开放权重模型可以在真实企业代码环境中竞争,而 Pi 证明了 harness 中对上下文的约束管理可以在不牺牲质量的前提下降低成本。

@MatthewBerman 报道称 (150 个赞,14 条回复,15,454 次浏览) 提供了另一类证据:连续两个月使用 GPT-5.6 Sol,覆盖长期运行的 /goal 任务、基于浏览器的管理工作、Supabase 实例管理,以及完整的 Google Workspace 迁移。他最鲜明的观点是,在日常使用中,GPT-5.6 体感上比 Claude Fable 5 快 2—3 倍,因为它更少乱走弯路,到达解决方案的路径更短;但它仍会自信地犯错,需要人工监督。
讨论洞察: 即便人们讲出了更好的使用故事,信任问题也没有消失。@emollick 质疑 (155 个赞,18 条回复,16,922 次浏览) 质问 OpenAI 既然公开批评糟糕的 benchmark,为何又没有公布 GPT-5.6 的 GDPval 结果;他随后又 认为 (158 个赞,16 条回复,11,033 次浏览) 表示,Grok 4.5 发布时就应该附带 model card。贯穿这些讨论的一点是:当任务集、harness 或披露层缺失时,benchmark 取胜就显得没那么有说服力。
与前一天对比: 2026-07-08 的怀疑主要集中在公开编码 benchmark 是否已经失灵。到了 2026-07-09,讨论更贴近部署:私有评测、任务经济性和 harness 效率。
1.2 人们想要的是工作层 agent,而不只是更好的聊天(🡕)
GPT-5.6 发布日的讨论,最有意思的地方在于它不再只谈模型本身,而开始谈长期运行的工作、浏览器控制,以及知道何时回来汇报的后台 agent。问题不再是“模型是不是更聪明”,而是“这解锁了哪些新的工作界面?”
@kimmonismus 认为 (267 个赞,20 条回复,18,994 次浏览) 表示,GPT-5.6 在原始评测上的提升令人印象深刻,但并不意外;更值得关注的一层,是 ChatGPT Work 能从文档、Slack、Notion、Microsoft 365 和 Google Drive 中提取上下文,并将其转化为演示文稿、文档、表格、仪表盘和交互式解释。随附的对比表也不是围绕单一 benchmark 来框定这次发布,而是放在面向工作流的评测框架中,并列列出了 Agents' Last Exam、GDPval-AA v2、管理咨询任务、Big Finance Bench、Artificial Analysis、SWE-Bench Pro、DeepSWE 和 Terminal-Bench 2.1。

@RhysSullivan 询问 (139 个赞,48 条回复,9,368 次浏览) 呼吁一种从提示词到主动 agent 的 UX,覆盖代码仓库监控、Slack 分流、后续跟进闭环、生产异常监控和增长实验。关键一句说得很直白:他的“理想 UX”是给 agent 发一条提示词,然后得到一个主动运行的配置;而 Codex automations、Hermes、Eve 和 Flue 等现有选项仍然摩擦太大。
讨论洞察: 对 Rhys 的回复把现实中的替代方案简化成了 GitHub Actions 加 cron,而 Rhys 立刻回了一句“thanks i hate it”。对 Kimmonismus 的回复则追问,ChatGPT Work 到底是在取代 Codex,还是只是把更早的 workspace-agent 思路重新打包,这说明需求是真实存在的,只是产品边界仍不清晰。
与前一天对比: 2026-07-08 的编排讨论主要围绕企业规格和路由层。到了 2026-07-09,话题更个人化,也更贴合工作流:后台 agent、浏览器控制和工作超级应用 UX。
1.3 开放模型采用被框定为所有权、路由和摆脱供应商束缚(🡕)
关于开放模型的讨论,已经不再只是为了压低 API 成本。更强的框架是所有权、可移植性,以及从单一供应商技术栈中保留退出路径;具体证据既来自平台级公告,也来自面向特定任务的迁移案例。
@ollama 表示 (208 个赞,29 条回复,7,836 次浏览) 表示,其平台现已有 9M+ 活跃开发者,并已准备好把开放模型扩展为“你可以拥有的 AI”。Ollama 自己的 公告 补充称,平台有 890 万开发者在使用,财富 500 强中有 85% 使用它,公司还融资 $88M,并明确把所有权、可负担性和隐私作为开放模型的核心价值主张。

@samhogan 表示 (27 个赞,7 条回复,1,236 次浏览) 表示,他的团队帮助一位客户将 OpenAI 和 Anthropic 模型的月支出从约 $60,000 降至约 $12,000,方法是用经由任务专项评测选出的开源替代方案。随附矩阵把 GPT-5.5、GPT-5 Mini、Opus、Sonnet 和 Haiku,与 GLM-5.2 Max、MiMo V2.5 Pro、DeepSeek V4 Flash、Gemma 4 和 Kimi K2.6 等替代模型配对,从而让这次迁移一目了然。

@orbiteditor 将其定位为 (17 个赞,5 条回复,849 次浏览) 将 Orbit Editor 介绍为一款完全开源的 coding-agent beta,并且从第一天起就支持自带供应商。相关的 网站 和 GitHub 仓库 表明,这不只是口号:支持直接使用供应商 API 密钥、通过 Ollama 或自定义主机接入本地端点,并且已经有 beta 桌面应用,而不是停留在模糊路线图上。
讨论洞察: 最有价值的反驳并不是否定开放模型,而是点出了运维层面的摩擦。Ollama 讨论里有回复抱怨 GLM-5.2 当天停止了正常输出;Orbit 讨论里也有人指出,自带供应商的自由并不能解决 agent 产出错误架构时的调试和支持问题。
与前一天对比: 2026-07-08 的开放权重讨论更偏战略和地缘政治。到了 2026-07-09,话题更偏操作层面,出现了具体的迁移矩阵、平台级采用数据和供应商无关工具。
1.4 Physical AI 讨论聚焦商业化瓶颈,而不是人形机器人 spectacle(🡕)
具身 AI 的讨论异常克制。信息量最大的帖子,谈的不是未来主义演示,而是出货曲线、物料清单结构、感知失效,以及仍在限制真实部署的硬件约束。
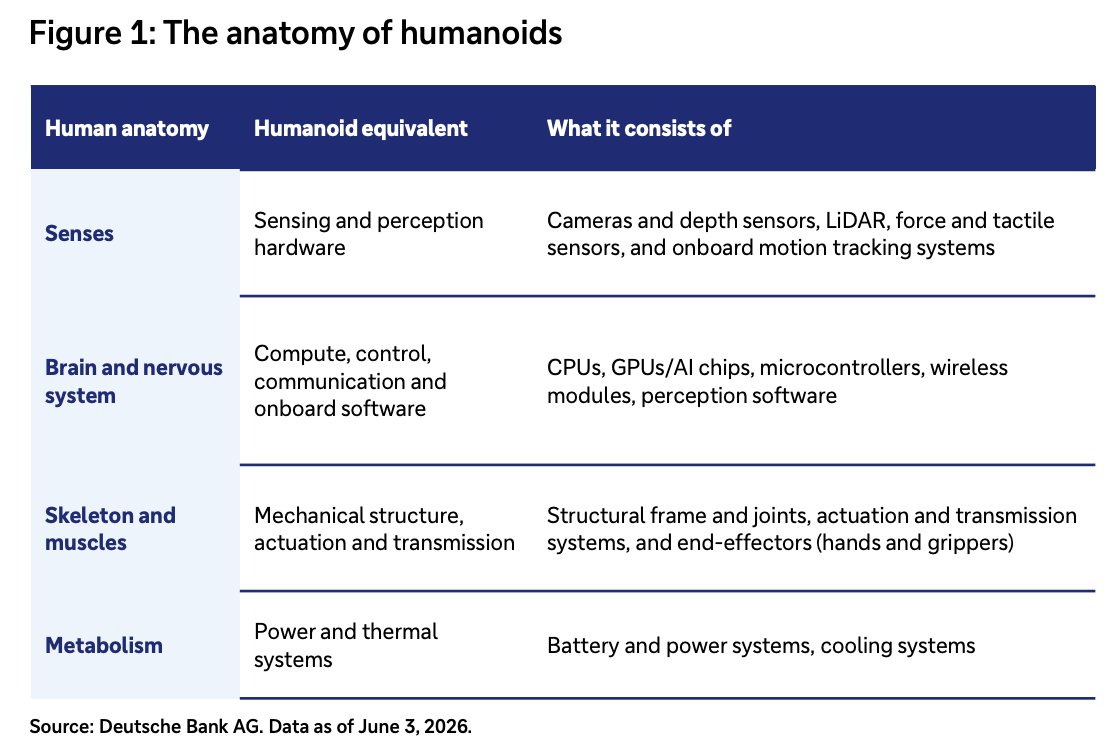
@pequityresearch 总结 (37 个赞,3 条回复,5,472 次浏览) 分享了 Citi 和 Deutsche Bank 的观点:机器人产业正在进入商业化落地阶段,但仍受数据稀缺、熟练人才短缺、电池续航、边缘计算限制和部署成本约束。同一帖子还认为,面向特定任务的 AMR 和专用平台,比高度曝光的通用人形机器人更早产生回报;执行系统约占系统成本的一半。
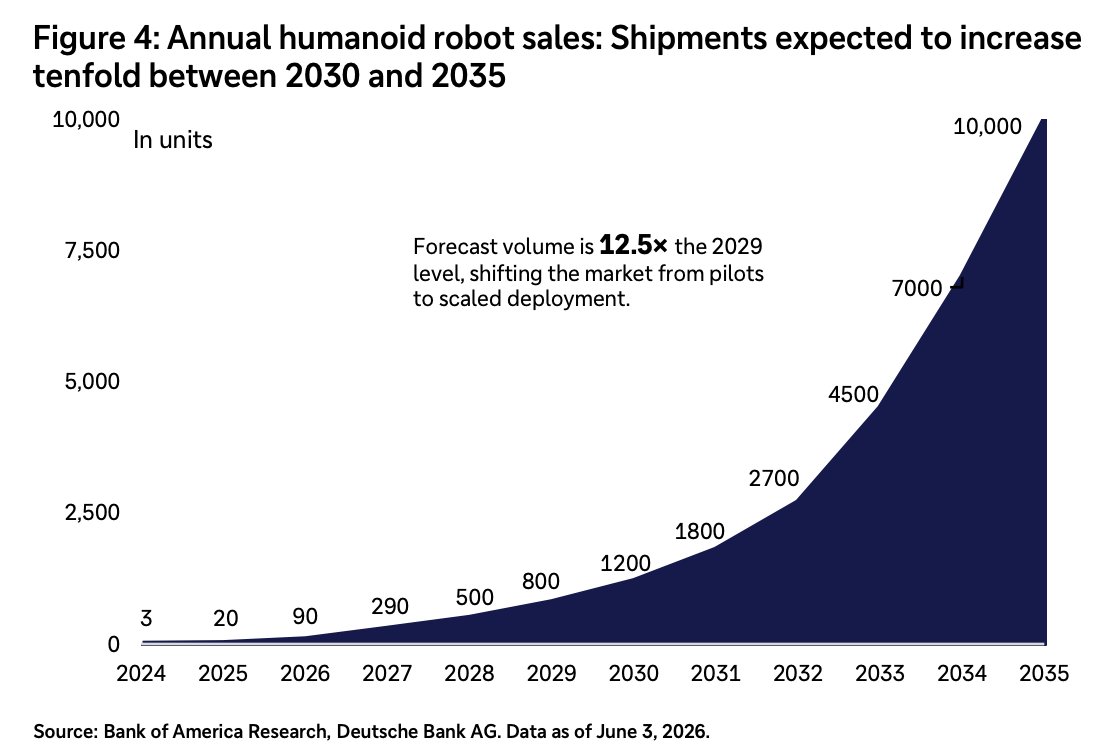
@TechByMarkandey 指出 (42 个赞,13 条回复,34,424 次浏览) 指向了一个具体失效模式:深度摄像头在玻璃、镜面和透明表面上会失效。他关于 LingBot-Vision 和 LingBot-Depth 2.0 的帖子之所以重要,是因为它展示了这些场景下改进后的深度图和点云,同时声称随着 RGB-D 训练规模从 300 万样本扩展到 1.5 亿样本,性能仍在持续提升。

另一条较小但形成印证的帖子来自 @pequityresearch 关于 Schaeffler 和 Goldman Sachs (12 个赞,0 条回复,1,772 次浏览),从供应链角度延伸了同一观点:轴承、编码器、扭矩传感器和执行器已经至少占标准人形机器人 BOM 的一半,因此短期价值正聚集在零部件和工业合作伙伴,而不只是模型软件。
讨论洞察: 这些帖子的共识是,近期价值位于任务专用系统和瓶颈供应商,而不是假设只靠模型进步就能让通用人形机器人具备经济性。
与前一天对比: 与 2026-07-08 相比,Physical AI 讨论从泛泛的 AI 乐观主义转向了出货预测、成本结构和感知边界案例。
2. 什么让人感到沮丧
长时间运行的 agent 仍然像是东拼西凑出来的
严重程度:高。@RhysSullivan 表示 (139 个赞,48 条回复,9,368 次浏览) 表示,他想要用于代码仓库监控、Slack 分流、后续跟进闭环、生产异常监控和增长工作的后台 agent,但现有方案仍然摩擦很大。帖子里最实际的替代方案基本就是“GitHub Actions 加 cron”,而 Rhys 本人的回应——“thanks i hate it”——准确概括了这种情绪:人们今天可以把触发器勉强粘起来,但还没有真正拥有一个从提示词到 agent 的产品。@MatthewBerman 补充说 (150 个赞,14 条回复,15,454 次浏览) 也从模型侧表达了近似的不满:他希望 Codex 能自动在 GPT-5.6 的不同尺寸和推理模式之间路由提示词。之所以值得投入,是因为这种需求明确、反复出现,并且直接绑定真实的日常工作。
对前沿模型说法的信任,仍受缺失评测和披露不足限制
严重程度:高。@alighodsi 构建了 (161 个赞,9 条回复,14,899 次浏览) 之所以做私有 benchmark,正是因为公开 benchmark 不足以支撑一个拥有 11,000 名工程师的组织做出真实的模型和 harness 决策。@emollick 质疑 (155 个赞,18 条回复,16,922 次浏览) 质疑 GPT-5.6 为什么没有 GDPval 结果;他还另行 认为 (158 个赞,16 条回复,11,033 次浏览) 表示,Grok 4.5 发布时就应该带上 model card。当前的应对模式是:做任务专项评测、比较已完成任务成本而不是 token 价格,以及更相信真实使用体验而不是榜单营销。之所以值得投入,是因为评测和披露现在已经是产品表面的一部分。
AI 图像生成持续与同意和来源追踪发生冲突
严重程度:高。@HedgieMarkets 认为 (134 个赞,12 条回复,5,325 次浏览) 表示,Meta 的 Muse Image 允许任何人用他人的公开 Instagram 照片生成 AI 图像,却不通知本人;退出选项还深埋在多层设置中,也没有承诺以后会删除已生成的图像。帖子回复提到了 Glaze 和 Nightshade 这类防御性工具,并建议生成图像可能需要类似参考文献的来源元数据。眼下的应对方式,更多还是退出开关、数据投毒工具和法律层面的愤怒,而不是持久的平台控制机制。之所以值得投入,是因为这种伤害是即时的、与身份绑定的,而且直接面向消费者。
具身 AI 仍受物理现实的瓶颈制约
严重程度:高。@pequityresearch 表示 (37 个赞,3 条回复,5,472 次浏览) 表示,商业化势头确实存在,但电池续航、边缘计算硬件、训练数据稀缺和部署成本仍在显著拖慢落地。@TechByMarkandey 展示了 (42 个赞,13 条回复,34,424 次浏览) 则给出了同一问题更接地气的版本:标准深度摄像头在镜面、玻璃和透明表面上会失效,因此感知在常见现实材料上仍会失败。当前的变通方式,是部署任务专用系统和专用感知模型,而不是假设一套通用机器人技术栈已经准备就绪。之所以值得投入,是因为真正的门槛仍是可靠性,而不是叙事热度。
3. 人们希望出现什么
从提示词到主动 agent 的配置方式
信息流里最明确的需求来自 @RhysSullivan 称 (139 个赞,48 条回复,9,368 次浏览):他的“理想 UX”是给 agent 发一条提示词,然后返回一个主动运行的配置。例子都很具体:代码仓库监控、Slack 分流、后续提醒、生产异常检测和增长实验。今天的部分答案是 cron 任务、GitHub Actions 和零散的自动化产品,但这条帖子把它们视为实现细节,而不是令人满意的产品。机会:直接。
按已完成任务经济性自动路由模型和 harness
@alighodsi 展示了 (161 个赞,9 条回复,14,899 次浏览) 表示,同一个模型在不同 harness 下成本可能显著降低;@rohanpaul_ai 解释 (16 个赞,5 条回复,3,290 次浏览) 表示,Pi 通过发送更少的重复上下文实现了这一点;@samhogan 分享了 (27 个赞,7 条回复,1,236 次浏览) 则展示了在用任务专项评测选出的开放权重替代模型替换实验室模型后,支出下降 80% 的案例。@MatthewBerman 补充说 (150 个赞,14 条回复,15,454 次浏览) 表示,他希望 Codex 能在 GPT-5.6 各变体之间自动路由提示词。尚未被满足的需求,是一个根据任务成功而非 token 单价来选择模型、harness 和推理预算的路由层。机会:直接。
具备通知、删除和来源追踪的同意感知型图像生成
@HedgieMarkets 描述 (134 个赞,12 条回复,5,325 次浏览) 描述了一种情形:人们甚至可能不知道自己的照片正被拿去做图像生成;回复则主张采用类似参考文献的元数据,并提到了 Glaze 和 Nightshade 等防御性工具。这既是实际需求,也是情感需求:人们想知道自己何时成了生成素材,想要更简单的退出方式,也希望此前生成的内容能以可追踪的方式被处理。机会:竞争性。
面向复杂环境的机器人感知和部署基础设施
@TechByMarkandey 强调 (42 个赞,13 条回复,34,424 次浏览) 指出,镜面、玻璃和透明表面仍是一个尚未解决的感知边界问题;@pequityresearch 描述 (37 个赞,3 条回复,5,472 次浏览) 则指出电池、执行器、传感器、部署成本和真实世界数据等更慢变量的约束。信息流并不是在呼唤另一个泛泛的机器人承诺,而是在隐含地要求一套支撑栈,让感知、运行稳定性和安全性足够可靠,能真正支持落地部署。机会:直接。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| GPT-5.6 Sol / Ultra | LLM | (+/-) | 在编码、浏览、长期目标执行和广泛公开评测覆盖上表现强劲 | 仍会自信地犯错;更高推理模式可能大量消耗 token;部分 benchmark 披露仍有争议 |
| Claude Fable 5 | LLM | (+/-) | 在开放式自主任务上表现强,在多项对比中仍具竞争力 | 有从业者认为它在日常工作中比 GPT-5.6 更慢,也不够直接 |
| GLM-5.2 | 开放权重 LLM | (+) | 在 Databricks 和迁移讨论中都被视为严肃的编码替代方案 | 需要良好的路由和 harness;托管版和开放模型的可用性仍可能不稳定 |
| Pi | Agent harness | (+) | 通过严格管理上下文,显著降低了单任务成本 | 效果依赖具体工作负载,只有配合相应任务集才有意义 |
| ChatGPT Work | 工作超级应用 / agent 应用 | (+/-) | 能把文档、Slack、Notion、Microsoft 365 和 Drive 中的上下文转化为具体产出 | 用户不清楚它与 Codex 的关系,也不确定这层工作流是否真的新颖 |
| GitHub Actions | 自动化 / 编排 | (+/-) | 触发器、日志、代码仓库集成和 cron 支持都很好 | 更像权宜之计,而不是人们想要的低摩擦主动 agent UX |
| Ollama | 开放模型平台 | (+) | 支持本地/私有所有权,集成范围广,获取开放模型相对直接 | 模型行为和托管可用性仍可能每天波动 |
| Orbit Editor | Coding IDE / agent harness | (+/-) | 开源、支持自带供应商,并支持本地或自托管端点 | 仍是早期 beta;调试和支持体系尚不成熟 |
| Ship Safe | 安全 CLI | (+) | 扫描 AI-agent、CI/CD、配置、密钥和依赖风险;核心命令可离线运行 | AI 辅助模式仍可能发送匹配到的代码片段,除非使用 --no-ai |
| LingBot-Vision / LingBot-Depth 2.0 | 机器人视觉模型 | (+) | 改善玻璃、镜面和透明表面的深度补全,并且会随着更多 RGB-D 数据继续扩展 | 解决的是一个范围较窄但重要的感知问题,并非完整的机器人部署方案 |
当天的满意度光谱,从“这是我的日常主力”到“够用,但我讨厌它”都有。@MatthewBerman 描述 将 GPT-5.6 称为自己最可靠的工作模型;@RhysSullivan 做出 则明确表示,GitHub Actions 式自动化并不能满足人们对主动 agent 的需求。最清晰的迁移模式并不是出于意识形态去拥抱开源,而是基于具体任务,把实验室 API 路由到开放权重替代方案;这一点既体现在 @alighodsi 显示 的内部 benchmark 结果中,也体现在 @samhogan 显示 的客户成本下降案例中。竞争态势越来越像是整栈竞争——模型加 harness、路由、应用层和供应商可移植性——而不是孤立的模型对模型竞争;@kimmonismus 将其表述为 对 ChatGPT Work 的框定,以及 @orbiteditor 将其表述为 对 Orbit Editor 的定位,都体现了这一点。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Orbit Editor | @orbiteditor | 支持供应商切换和本地模型的开源 AI coding editor | 避免 coding agent 的供应商锁定 | TypeScript 桌面应用;Anthropic/OpenAI/Google/开放权重/本地端点,可通过 Ollama 或自定义主机接入 | Beta | 帖子, 仓库, 网站 |
| Ship Safe | asamassekou10(由 @tom_doerr 分享) | 扫描 AI-agent、CI/CD、配置、密钥和依赖风险的 CLI | 让开发者通过一条命令检查 agent 时代的安全问题 | JavaScript CLI、SARIF/CI 输出、可选 AI 分类 | 已发布 | 帖子, 仓库, 网站 |
| LingBot-Vision / LingBot-Depth 2.0 | Robbyant(由 @TechByMarkandey 分享) | 用于稠密空间感知的自监督视觉骨干网络和深度补全模型 | 修复具身 AI 在镜面、玻璃和透明表面上的 RGB-D 失效问题 | ViT 骨干网络、PyTorch,RGB-D 训练扩展至 1.5 亿样本 | 已发布 | 帖子, 仓库, 权重 |
| Universal Cell Embedding (UCE) | Rosen、Roohani、Agrawal 等(由 @changmyung1981 分享) | 将新的单细胞数据集映射到共享生物学空间中的 zero-shot 基础模型 | 消除跨数据集、组织和物种整合时的重复训练与重标注工作 | 自监督 transformer、蛋白质语言模型基因嵌入、3,600 万细胞图谱 | Alpha | 帖子, 论文 |
| Lumen Sovereign | @yangli_ / Cosine AI | 拟在英国本土训练,并带有公众治理反馈回路的前沿模型 | 面向重视司法管辖和治理的国家机构使用场景 | 前沿模型训练,加上公开用例和治理意见征集 | RFC | 帖子, 输入表单 |
Orbit Editor 值得注意,因为它开放、供应商无关的定位,已经体现在真实的 beta 应用、公开代码库,以及对直接供应商密钥或本地端点的支持上,而不是绑定单一打包模型。这是对当下人们对被锁定在某个 coding assistant 中、以及自动化界面别扭难用这一挫败感的直接回应。
Ship Safe 展现了安全领域的一种平行构建模式:它不把 AI 风险当作通用 AppSec 的一个子章节,而是把提示注入、MCP 滥用、CI/CD 配置错误、密钥泄露和依赖问题统一打包进一个 CLI。代码仓库和网站将其定位为开发者无需注册即可本地运行的工具,这与当天更广泛的所有权和可移植性偏好相吻合。
LingBot-Vision、UCE 和 Lumen Sovereign,则分别指向构建者的三个不同方向。LingBot 针对一个具体的机器人失效模式,UCE 把细胞生物学视为共享潜在空间问题,而 Lumen Sovereign 则把司法管辖和治理视为产品本身的一部分,而不是事后再加上的政策层。
6. 新鲜且值得关注的内容
AI 原生 staffing 仍比舆论暗示的更少见
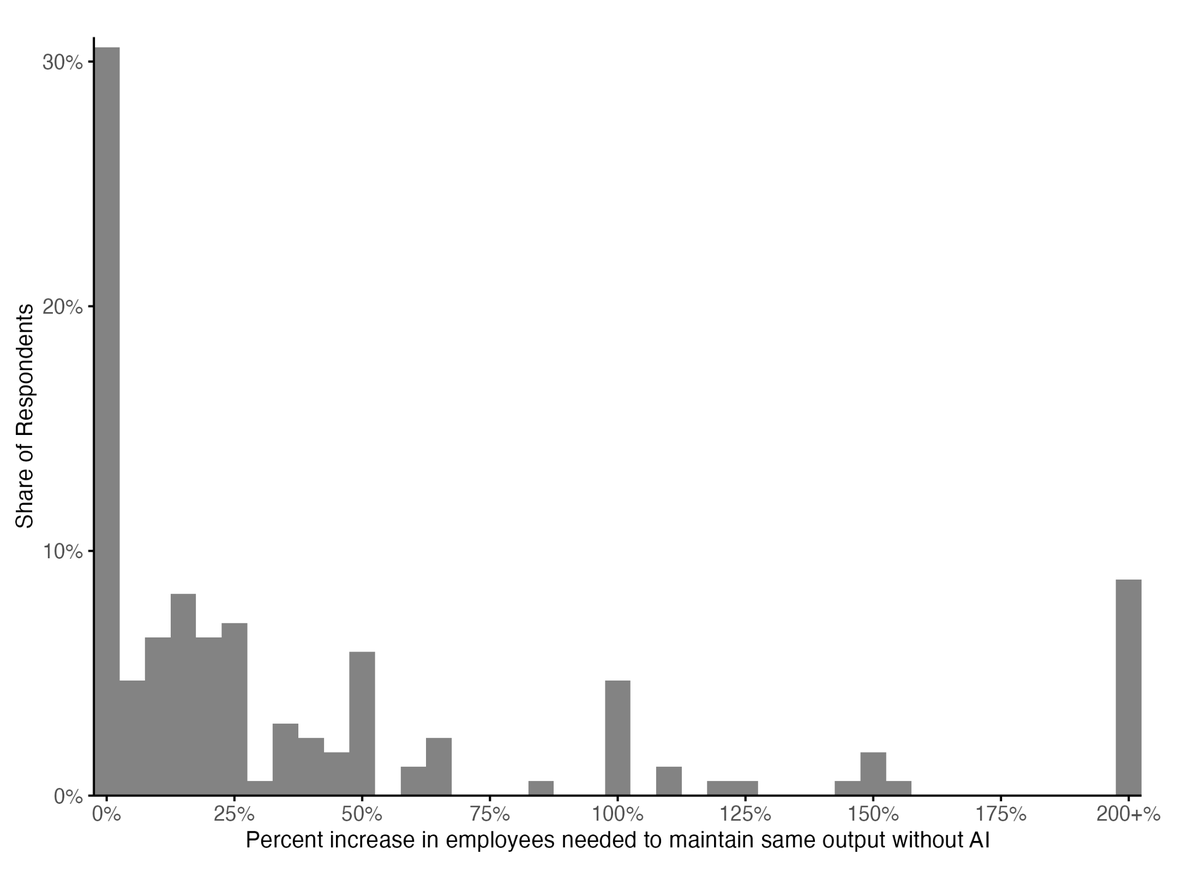
@emollick 分享了 (65 个赞,17 条回复,12,051 次浏览) 发布了一张直方图,询问创业公司创始人:如果没有 GenAI,要维持当前产出,他们还需要增加多少员工。之所以重要,是因为最高的柱子位于 0%,而延伸到 100%+ 和 200%+ 的部分只是更细的长尾,这使得极度“AI-pilled”的组织看起来确实存在,但仍不常见。
Universal cell embeddings 把基础模型逻辑进一步推入生物学
@changmyung1981 强调 (20 个赞,1 条回复,1,252 次浏览) 介绍了 Universal Cell Embedding,这是一种 zero-shot 基础模型,覆盖 3,600 万个细胞、300+ 个数据集、50 种组织和 8 个物种。有意思的不只是规模,而是它声称无需重新训练,就能把新数据集映射到共享生物学空间中;配图还总结了跨物种泛化能力,以及在肺部和心脏数据集中发现类似 Norn 的细胞。

Sovereign AI 从政策语言走向明确的产品简报
@yangli_ 表示 (23 个赞,6 条回复,1,694 次浏览) 表示,Lumen Sovereign 正被打造为英国首个完全在英国本土训练的前沿 AI 模型,并向公众征集使用场景、工作流和治理方面的意见。回复凸显了其中不寻常的一点:计算地理位置本身成了设计简报的一部分,人们立刻开始追问能源成本、电网容量,以及把前沿模型锚定在单一司法管辖区内究竟意味着什么。
7. 机会在哪里
[+++] Prompt-to-proactive-agent control plane — Evidence appears in multiple sections. @RhysSullivan 明确询问 提出了对一种 agent 的需求:只提示一次,就能在较长时间内持续监控代码仓库、Slack、后续事项和生产环境;而帖内给出的最佳变通方案仍然只是 GitHub Actions 加 cron。这种欲望与现有工具之间的落差既直接、反复出现,又很紧迫。
[+++] Task-aware model, harness, and reasoning-budget routing — @alighodsi 展示了 和 @rohanpaul_ai 解释 共同展示了 benchmark 一侧的问题:同一个模型在更好的 harness 下可能便宜得多;而 @samhogan 提供了 则从迁移一侧展示了任务专项评测后带来的 80% 支出下降。再加上 @MatthewBerman 询问 对 Codex 内自动路由的诉求,这一机会显然并不小众。
[++] Consent and provenance infrastructure for identity-linked image generation — @HedgieMarkets 描述 指向了一款现实中的产品:人们可以在未获通知的情况下被变成生成输入,而回复里提到的 Glaze、Nightshade 和类似参考文献的来源追踪,也都只是权宜之计。这里的需求涵盖通知、退出、删除和署名。
[++] Physical-AI reliability stack — @pequityresearch 展示了 表明,电池、执行器、传感器和数据仍是瓶颈;@TechByMarkandey 提供了 则指出了透明表面这一具体失效案例。这意味着机会更多在感知、运行稳定性、校准和部署工具,而不只是模型权重本身。
[+] Sovereign and regulated-domain foundation layers — @yangli_ 将其表述为 把计算地理位置和治理视为 Lumen Sovereign 的产品要求;@changmyung1981 强调 则展示了一个围绕领域特定整合痛点构建的细胞生物学基础模型。共同的机会并不是“再做一个通用模型”,而是围绕单一司法管辖区或单一高摩擦数据领域设计基础层。
8. 核心结论
- 任务专项评测正在取代对 benchmark 的信仰。 Databricks 的内部 benchmark,以及围绕 GDPval 和 model card 的抱怨,都说明人们越来越相信私有工作负载、harness 数据和披露质量,而不是 headline benchmark 的胜出。(来源;来源)
- 人们想要能在提示词之间持续运行的 agent,但不想靠 cron 任务把它们拼出来。 今天最强烈的未满足需求,是一个低摩擦的后台 agent 控制平面,能知道何时回来汇报。(来源)
- 开放模型的动能现在更像是整栈决策,而不只是价格偏好。 Ollama 的规模叙事、Sam Hogan 的替代矩阵,以及 Orbit Editor 的供应商无关 beta,都把开放模型放进了所有权、路由和可移植性的框架里。(来源;来源;来源)
- Physical AI 的讨论正变得更具体,也更受硬件现实约束。 出货曲线、BOM 构成、电池限制,以及透明表面上的深度感知失效,都指向仅靠软件进步无法抹去的部署瓶颈。(来源;来源)
- 基础模型思维仍在向领域层和治理层外扩。 ChatGPT Work 把企业上下文视为工作界面,UCE 把细胞生物学视为共享嵌入空间,而 Lumen Sovereign 则把计算地理位置和公众治理视为产品本体的一部分。(来源;来源;来源)