Twitter AI - 2026-07-10
1. 人们在讨论什么
1.1 GPT-5.6 的评价重点更多落在路由、返工和任务适配上,而不是发布日的热度(🡕)
最强的一组讨论并不是简单的“最好模型获胜”。更核心的是一些非常偏运营层面的讨论:什么时候该用 Sol,什么时候该用 Terra 或 Luna;GPT-5.6 是否真的能减少长任务中的返工;以及团队在为速度和成本做优化时,质量究竟还要让渡多少。至少有 7 条保留内容从重度用户轶事、二手 AMA 笔记、基准图表和分布外任务测试等角度支撑了这一主题。
@theo 表示 (593 个赞,34 条回复,31,081 次浏览) 表示,他过去一个月在 GPT-5.6 Sol token 上烧掉了超过 $200,000,并希望展示自己实际做出了什么,而不是对着基准测试做反应。回复几乎和原帖本身一样重要:怀疑者批评这种表述框架,支持者则认为,真正的检验标准是模型在长期使用后究竟能帮助人们交付什么。
@btibor91 总结 (141 个赞,12 条回复,11,575 次浏览) 把 OpenAI Codex AMA 总结成了一份路由指南:大多数工作用 Sol Medium;出错代价很高的任务用 Sol Ultra;更便宜的非编码或轻量任务用 Terra;子代理用 Luna。同一份总结还称,Codex 每周用户已超过 500 万,并强调目前仍没有真正的“Auto”模型,而这恰恰是许多回复聚焦的摩擦点。
@bindureddy 发帖 (61 个赞,17 条回复,3,262 次浏览) 分享了她自己的使用场景矩阵——主控代理用 Fable,子代理用 Grok 4.5 和 GPT-5.6 Sol,聊天用 Terra,开源模型用 GLM 5.2。随后立刻有人在回复中要求提供一个能自动切换模型的 CLI,让构建者可以专注于交付。这让“模型选择”本身变成了一个产品缺口。
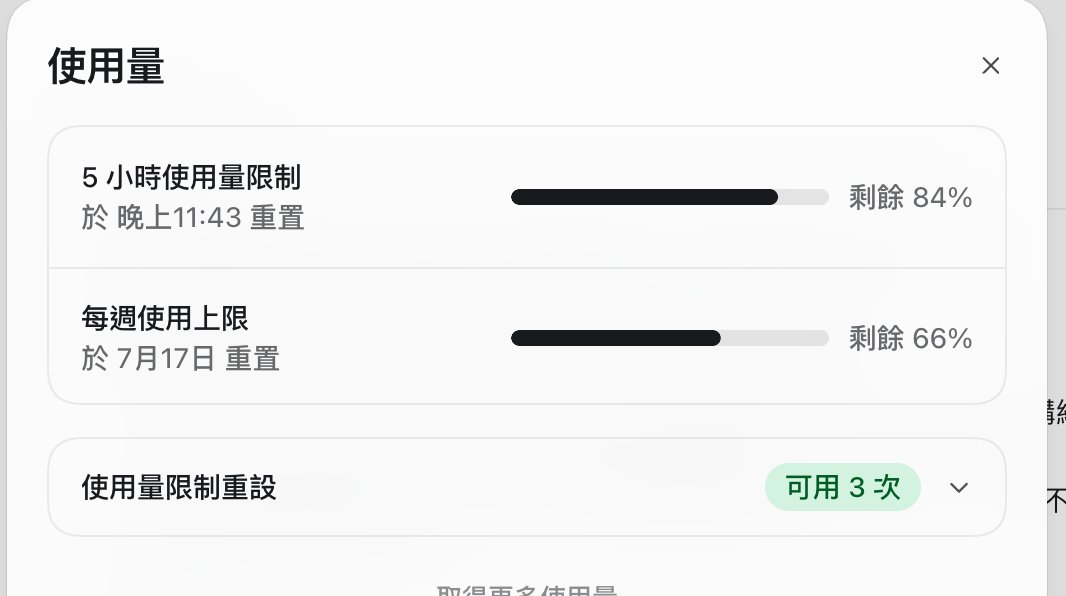
@LearnInvest2026 报道称 (1 个赞,2 条回复,179 次浏览) 表示,一次持续 12 小时的 GPT-5.6 Sol 测试体验比 GPT-5.5 更顺,因为 Sol 会在前期投入更多精力做对齐,后面需要修补的地方更少。附带截图让这套经济账更具体:5 小时上限还剩 84%,每周上限还剩 66%;另有一张来自 Claude Code 的缓存命中图表,显示长期运行的代理工作在多大程度上依赖上下文的重复复用。
@sayashk 测试了 (8 个赞,240 次浏览) 讨论前沿代理能否把手绘建筑草图转换成 CAD 楼层平面图,并发现 GPT-5.6 Sol Ultra 明显领先于旧模型,同时指出最糟糕的失败模式是悄悄改动方案。这一点之所以重要,是因为这不是又一个软件基准测试,而是一个混乱、特定领域的视觉推理任务,且输出由人类专家评分。

@QCXINT_ 认为 (5 个赞,2 条回复,279 次浏览) 表示,GPT-5.6 把前沿竞赛改写成了“每美元智力”,附带图表则通过绘制 Sol、Terra 和 Luna 系列在 BrowseComp 延迟、Terminal-Bench 2.1 成本以及 Agents' Last Exam 成本上的表现,让这一说法变得具体。@sergeykarayev 补充说 (8 个赞,1 条回复,530 次浏览) 则给出了最有价值的反向参照:在 Superconductor 的私有 Ruby on Rails 基准测试中,GPT-5.6 各版本统治了速度与成本前沿,但 Fable 5 在质量上仍明显胜出。

讨论洞察: AMA 总结和路由讨论串里的回复反复收敛到同一个抱怨:OpenAI 仍然要求用户自己充当模型和推理的路由器。最具体的批评出现在对 btibor91 的回复中,发帖者称命名方案令人困惑,并质疑平台支持;而 Bindu 的讨论串则明确提出,希望终端里有一层自动路由能力。
与前一日对比: 在 2026-07-09,人们还在较为抽象地讨论工作层代理。到了 2026-07-10,讨论已经转向具体的操作规则:模型阶梯、成本分层、缓存行为、真实任务评测,以及静默失败的边缘情况。
1.2 更便宜的模型扩大了竞争版图,但浏览器操作能力和质量差距依然明显(🡕)
价格压力已经不再只是常见的开源与闭源之争。今天更有力的表述是:Meta、Tencent、DeepSeek 以及其他低成本选项正在改变人们采购模型的方式,但低价只有在系统仍能胜任真实工作时才有意义。至少有 6 条保留内容从定价帖子、企业采用说法和负面的浏览器操作测试等角度支撑了这一主题。
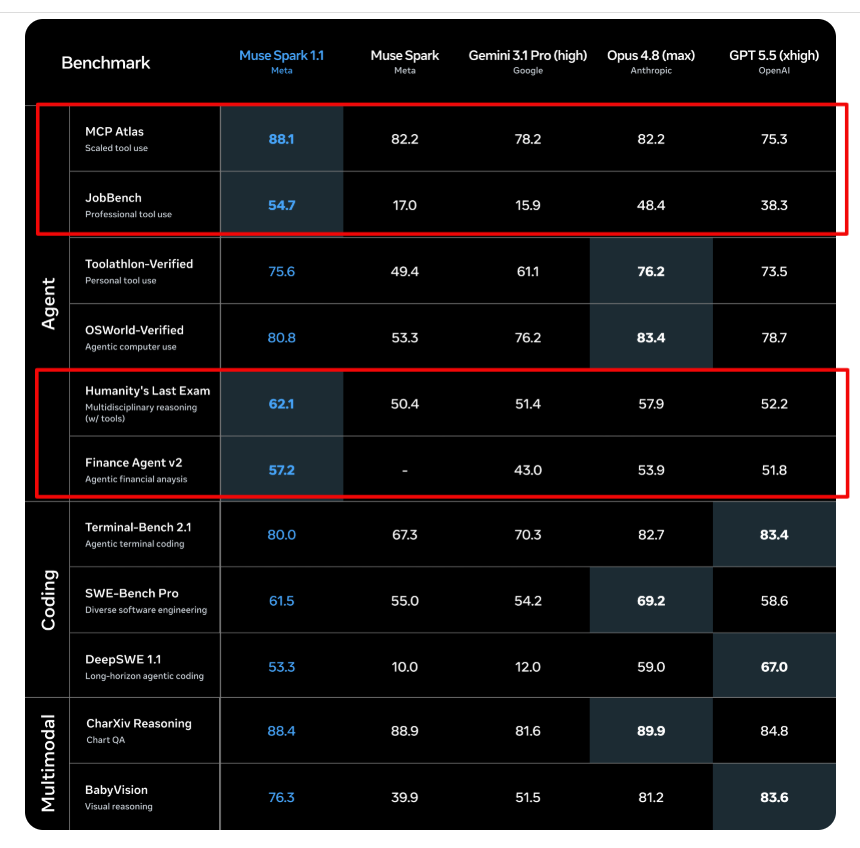
@rohanpaul_ai 表示 (6 个赞,3 条回复,1,873 次浏览) 表示,Muse Spark 1.1 的输入 token 价格为每百万 $1.25、输出 token 价格为每百万 $4.25,正在对 OpenAI 和 Anthropic 的代理式编码形成直接压力,尤其是在那些代理真正会花钱的基准测试上。附带的对比表突出标出了他认为最关键的基准:MCP Atlas 和 JobBench。
@kimmonismus 推荐 (32 个赞,10 条回复,5,498 次浏览) 介绍了 Tencent 的 Hy3:295B MoE 架构,仅 21B 激活参数,256K 上下文窗口,Apache 2.0 许可证,以及在 OpenRouter 上每百万 token 输入 $0.14、输出 $0.58 的定价。回复进一步明确了其中的取舍:一名用户提到其真实世界代理流量很重、工具调用错误率很低;但也有人表示,这个模型在上下文能力或多模态能力上仍弱于 DeepSeek V4 Pro。
@unusual_whales 报道称 (147 个赞,51 条回复,64,648 次浏览) 表示,亚马逊 CTO 称企业正在转向更便宜的开源模型以控制支出。@AiTechHubs 延长了 (2 个赞,2 条回复,102 次浏览) 则用一个更具体的迁移案例支撑了这一说法:美国企业中中国模型的 token 份额从 2025 年初的大约 4% 上升到 2 月的 30%,峰值达到 46%;DeepSeek V4 Flash 的价格是每百万 token $0.18,而 Claude Opus 4.7 为 $25;据称 Lindy 已把笔记生成工作负载切换到 DeepSeek,在性能相同的情况下大幅降低了成本。
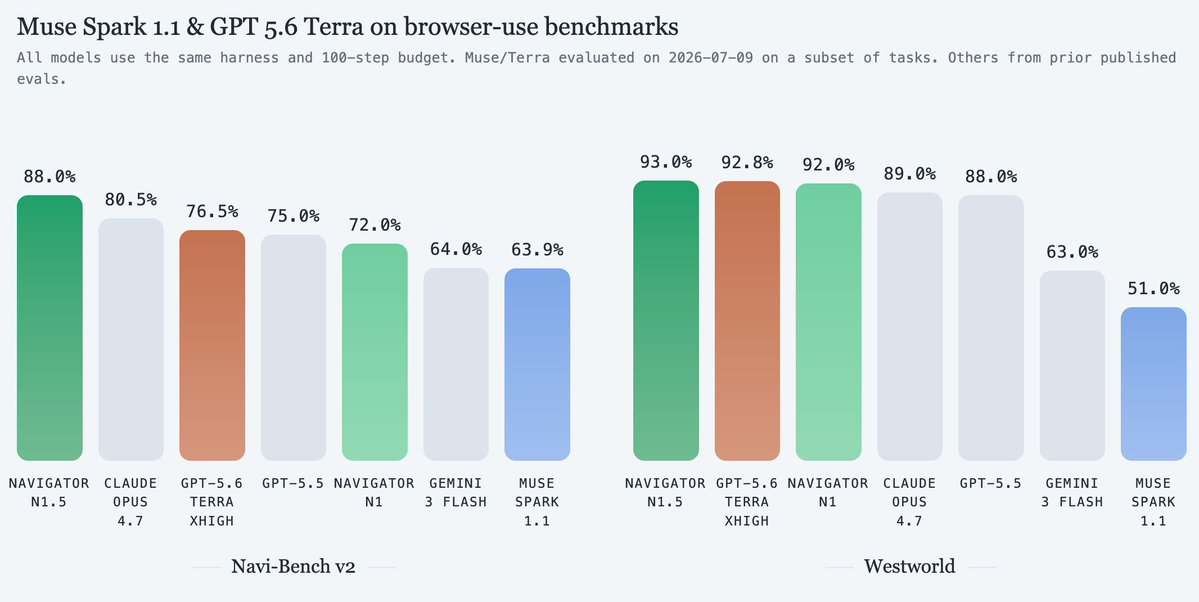
@DhruvBatra_ 提供了 (3 个赞,183 次浏览) 给出了最有价值的警示性结果。在 yutori.ai 的浏览器操作基准测试中,他发现 GPT-5.6 Terra 表现稳健且 token 效率高,而 Muse Spark 1.1 会陷入循环、因安全原因拒绝结账场景,并撞上 100 步上限。
@Daniel_Farinax 声称 (128 个赞,15 条回复,4,573 次浏览) 表示,Grok 4.5 已凭借速度成为他的日常主力,甚至让他愿意取消 Claude Max。但即便在一条明显偏正面的讨论串里,回复仍指出其 UI 较弱、使用上限也不够宽松。这与更广泛的模式一致:买家会奖励价格和速度,但也会立刻注意到工作流中的粗糙之处。
讨论洞察: 支持廉价模型最一致的论点不是意识形态,而是经济账。Hy3 和开源模型迁移讨论串中的回复一再把决策归结为性价比,其中一位发帖者将其概括为:美国实验室交付性能天花板,中国实验室则以其零头价格交付接近天花板的性能。最强的反驳来自浏览器操作结果,以及那些在高难任务上仍偏好更高质量模型的实践者。
与前一日对比: 在 2026-07-09,关于开放模型的讨论还集中在所有权和摆脱供应商束缚的后备方案。到了 2026-07-10,它已经变成一场更直接的采购争论:每 token 定价、基准效率,以及更便宜的系统是否能撑住真实的浏览器操作或编码工作负载。
1.3 评测与信任更贴近产品层面(🡕)
当天第三个强势主题是:人们到底需要什么,才会信任代理输出。讨论范围从开放式创造力研究,到明确招聘前沿评测人员,再到指控一篇已发表的经济学论文由语言模型写成。至少有 5 条保留内容支撑了这一“信任与评测”主题。
@SakanaAILabs 发布了 (248 个赞,18 条回复,35,248 次浏览) 介绍了其 AI Picbreeder 实验,该实验用 VLM 代理重现协作式图像演化。链接中的 博客 让结果更具体:人类 Picbreeder 档案仍优于纯 VLM 的运行结果;多样化的代理人格能缩小这一差距;零记忆会导致重复选择;记忆过多则会因上下文过载而拖累表现。
@sayashk 发帖 (28 个赞,2 条回复,4,543 次浏览) 表示,CRUX 正在招聘一名负责开放式前沿 AI 评测的高级研究员。截图补充了使其成为劳动力市场信号的关键细节:远程岗位、$150,000 至 $220,000 的薪资区间,以及评估那些无法被整齐地自动评分的长周期任务的职责。这比泛泛而谈“我们重视安全”更能说明,评测正在成熟为一项运营职能。
@JesusFerna7026 认为 (614 个赞,19 条回复,90,100 次浏览) 表示,Javier Milei 和 Demian Reidel 的一篇经济学论文看起来像由 LLM 撰写,而他附上的 4 张截图让这一指控变得具体:Pangram 对抽样段落返回了 100% 的 AI 生成概率;后续又对整篇论文给出了同样结果。

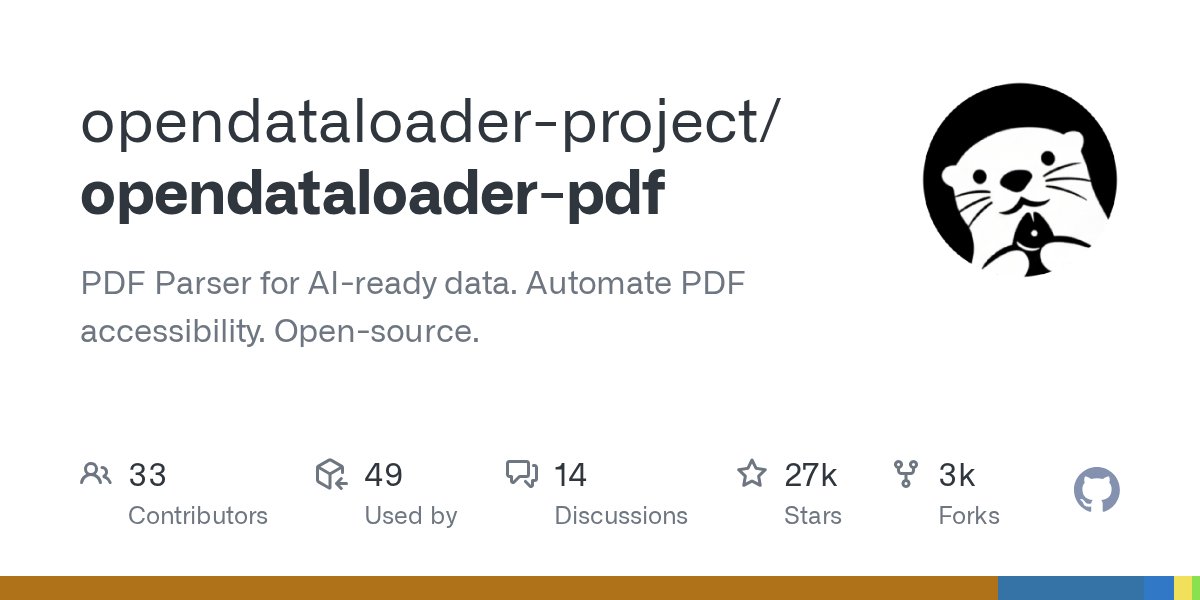
@N0V4Dev 分享了 (2 个赞,1 条回复,13 次浏览) 把 OpenDataLoader PDF 作为 RAG 和无障碍工作的文档基础设施。链接中的 仓库 远比单条帖子透露的信息更丰富:目前显示其 GitHub 星标数为 26,964,可将 PDF 转换为带边界框的 Markdown 或 JSON,支持 Python、Node.js 和 Java,并宣称提取准确率为 0.907,本地模式吞吐量约为每页 0.015 秒。@mattlam_ 补充说 (3 个赞,1 条回复,177 次浏览) 则给出了开放模型代理测试中的另一条信任教训:有些系统已经得到正确答案,却还继续探索,最终把通过做成了失败。
讨论洞察: 对 Sakana 帖子的回复指出,难点不在于产出新意,而在于识别哪些意外结果值得继续追。对 JesusFerna7026 的回复则在追问,问题究竟出在文字质量,还是底层模型本身。两组回复从不同方向指向同一个信任问题:评测越来越关乎在模糊条件下做判断,而不只是二元正确性。
与前一日对比: 在 2026-07-09,关于信任的争论还集中在缺失的基准披露和私有评测。到了 2026-07-10,信任讨论已经扩展到研究署名、长周期评测岗位招聘,以及生产系统的数据管线质量。
2. 人们感到沮丧的地方
手动模型路由仍然是一种产品税
严重程度:高。@btibor91 总结 (141 个赞,12 条回复,11,575 次浏览) 体现出 OpenAI 的一种现状:由于没有真正的 Auto 模式,用户仍需要按 Sol、Terra、Luna 以及推理等级来思考。@bindureddy 进一步印证了 (61 个赞,17 条回复,3,262 次浏览) 则通过她自己的按场景路由图展示了同样的现实,其中一条回复直白地要求提供一个能自动切换模型的 CLI。如今常见的应对方式是维护个人路由启发式,但反复出现的抱怨是:这是一种打断专注力的额外负担,而不是产品价值。这个方向值得做,因为需求非常明确,而且直接绑定日常工作。
廉价模型仍会在买家最在意的工作流里出问题
严重程度:高。@sayashk 显示 (8 个赞,240 次浏览) 表示,即便 GPT-5.6 Sol Ultra 在手绘楼层平面图任务中拿出了最强结果,仍然会有小错误,而最糟糕的失败模式是悄悄改动方案。@DhruvBatra_ 报道称 (3 个赞,183 次浏览) 表示,Muse Spark 1.1 会在浏览器任务中陷入循环、拒绝结账流程,并撞上步数上限。@sergeykarayev 补充说 (8 个赞,1 条回复,530 次浏览) 表示,GPT-5.6 仍会生成无效代码,而且在他的私有基准测试中,品味也落后于 Fable 5。现有补救方式是人工复核加缩窄任务范围,但差距仍大到足以让用户立刻察觉。
人们对 AI 生成研究和证据的信任十分脆弱
严重程度:高。@JesusFerna7026 认为 (614 个赞,19 条回复,90,100 次浏览) 表示,一篇政策论文看起来像是由 LLM 撰写,并附上了 4 张 Pangram 截图,显示抽样段落的 AI 生成概率为 100%。@mattlam_ 报道称 (3 个赞,1 条回复,177 次浏览) 则展示了代理评测中的另一种相关失败模式:有些模型已经解出了任务,却继续往下做,最终把自己做错。@N0V4Dev 分享了 (2 个赞,1 条回复,13 次浏览) 则介绍了一个 PDF 解析器,因为糟糕的文档提取会在模型回答之前就先污染 RAG 和评测管线。这个方向值得做,因为来源追溯、停止规则和源数据质量正逐渐成为产品的一部分,而不再只是 QA 的组成部分。
具身 AI 仍受制于电池、数据和执行机构成本
严重程度:高。@pequityresearch 表示 (85 个赞,4 条回复,10,929 次浏览) 表示,商业化正在推进,但数据稀缺、熟练劳动力短缺、电池续航、边缘计算约束和部署成本仍然占主导。同一讨论串还表示,许多系统的续航更接近 4 小时而不是 8 小时,而执行机构大约占总系统成本的一半。
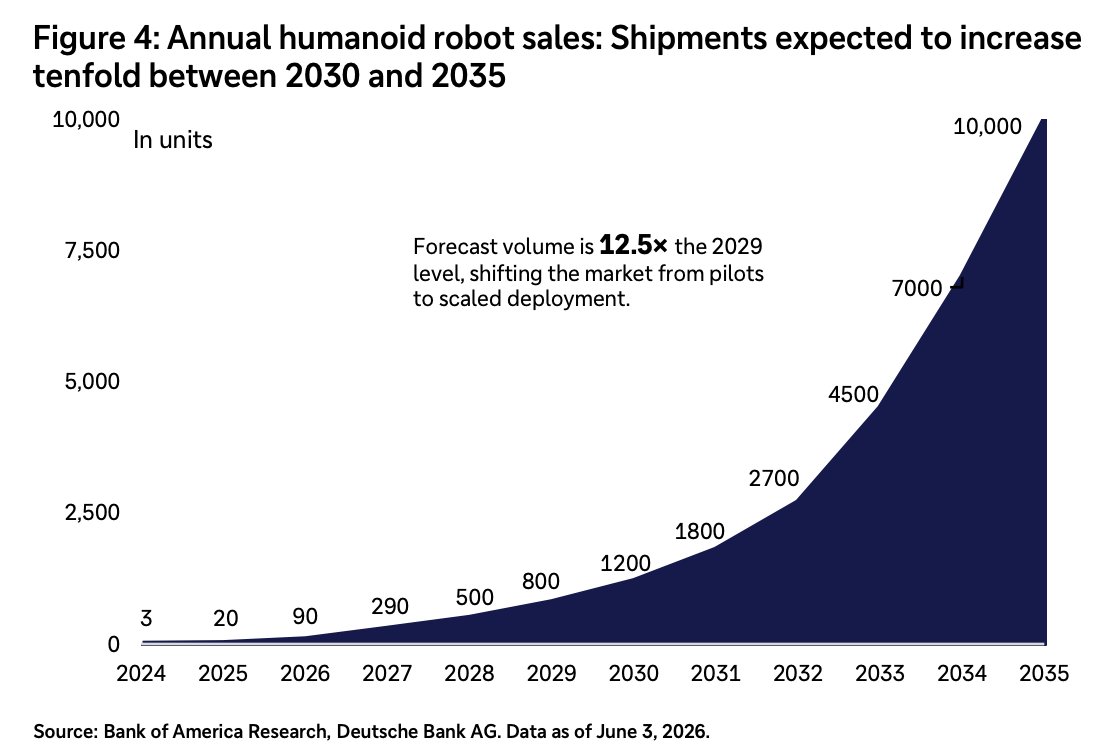
当前的应对策略都比较收窄:做特定任务系统、采用 RaaS 部署,以及押注上游组件,而不是假设通用型人形机器人已经准备就绪。这个方向值得做,因为卡点都很具体,而且反复出现。
3. 人们希望存在什么
自动化的任务感知路由
最明确的未满足需求并不是更高的基准分数,而是一套无需操作员多想,就能自行选择合适模型、投入强度和价格档位的系统。@btibor91 总结 (141 个赞,12 条回复,11,575 次浏览) 表示,目前仍然没有 Auto 模式;而在 @bindureddy 的 帖子串 (61 个赞,17 条回复,3,262 次浏览) 里,回复者要求提供一个能自动处理切换的 CLI。机会:直接。
普通终端用户真正会用的 AI 产品
@thdxr 询问 (145 个赞,50 条回复,24,425 次浏览) 询问旧金山最好的、终端用户真的在使用的 AI 创业产品,随后澄清他指的是 MAU 超过 500 万的产品。回复者甚至很难举出哪怕是面向开发者的例子,这比泛泛而谈“消费级 AI 很难做”更能说明问题。机会:竞争激烈。
面向长周期部署的更好评测基础设施
@sayashk 正在招聘 (28 个赞,2 条回复,4,543 次浏览) 提到要为前沿 AI 运行开放式 CRUX 评测;@mattlam_ 显示 (3 个赞,1 条回复,177 次浏览) 表示,测试框架设计会实质性改变开放模型的结果;@JesusFerna7026 显示 (614 个赞,19 条回复,90,100 次浏览) 则展示了当来源质量看起来像合成内容时,信任会以多快的速度崩塌。共同诉求是更好的测量、更好的来源追溯,以及随着时间推移更好的失败检测,而不是一次性的基准胜利。机会:直接。
无需猜基础设施方案的低成本私有推理
@HowToPrompt__ 重点指出 (7 个赞,3 条回复,821 次浏览) 介绍了 LiteRT.js:一种无需服务器或 API 账单、即可在浏览器中运行模型的方式;@pixeL_laugh 认为 (2 条回复,14 次浏览) 则表示,本地硬件应被视为一笔回本计算,而不是凭感觉决定。今天的部分答案包括浏览器运行时、本地机器和混合方案,但人们仍缺少一套适用于私有、生产级推理的清晰默认技术栈。机会:直接。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| GPT-5.6 Sol / Terra / Luna | LLM 系列 | (+/-) | 在编码、长上下文和代理基准中形成了很强的路由阶梯;多名用户表示其在长任务中返工更少 | 仍迫使用户手动路由;可能悄悄改动输出或生成无效代码;使用上限依然令人担忧 |
| Claude Fable 5 / Opus 4.8 | LLM 系列 | (+/-) | 仍在一些私有质量基准和设计密集型工作中胜出;长程上下文深度强 | 比新对手更慢或更贵;用户正遭遇资源稀缺和套餐变化 |
| Grok 4.5 | LLM | (+/-) | 速度快、定价激进,一些重度用户称其为日常主力 | UI 较弱、限制比预期更紧,在有利基准之外的证据表现不一 |
| Muse Spark 1.1 | LLM | (+/-) | 价格进取,主打高分数/低成本;在一些代理式和编码基准上有竞争力 | 浏览器操作评测显示其会陷入循环、拒绝结账,并受制于 100 步上限 |
| Tencent Hy3 | 开放权重 LLM | (+) | 价格极低,采用 Apache 2.0 许可证,代理式/编码定位明确 | 实践者仍质疑其上下文深度和多模态能力 |
| DeepSeek V4 Flash 及其他中国开放模型 | 开放权重 LLM | (+/-) | 成本优势巨大,企业采用率上升 | 地缘政治和访问风险仍是决策的一部分 |
| LiteRT.js / LiteRT | 运行时 / Web 推理 | (+) | 通过 WebGPU/WASM 在浏览器侧运行 ML,默认私有,无服务器账单 | 受客户端硬件和模型大小约束;回复者质疑小型本地模型是否足够 |
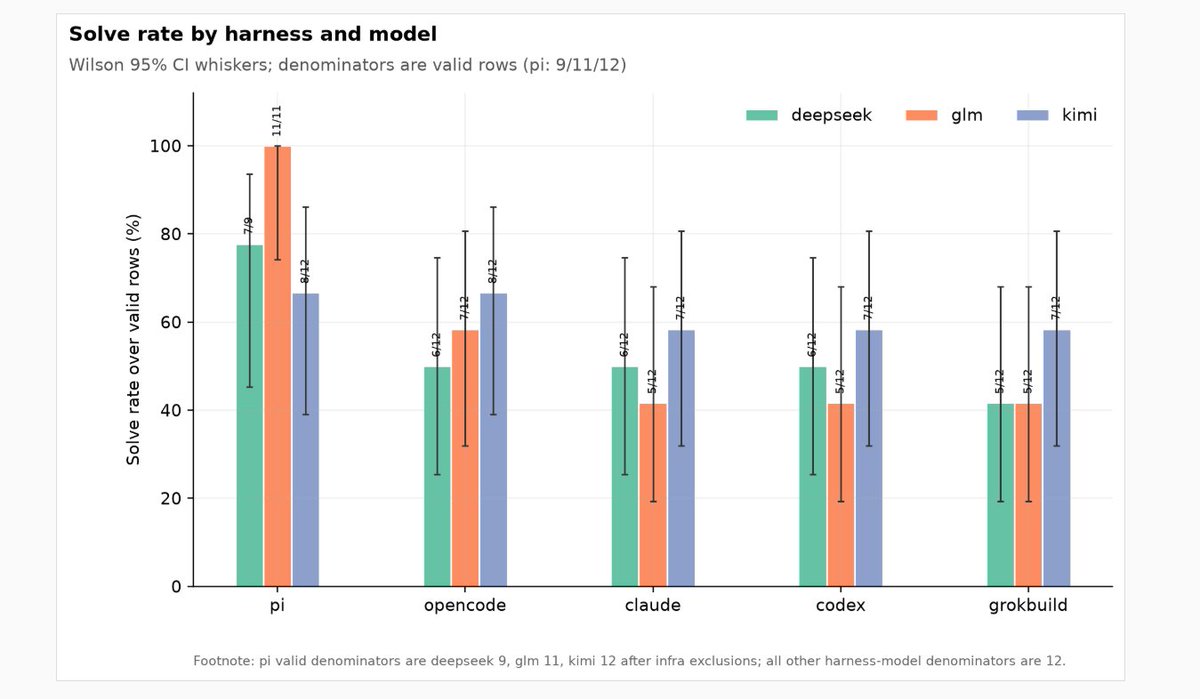
| Pi + GLM 5.2 / 开放测试框架 | 代理框架 + 开放模型 | (+) | 在已发布的 OpenBench 对比中拿到最强结果;说明框架质量很重要 | 结果依赖具体工作负载,而且有些代理会在得到正确答案后继续执行,而不是及时停止 |
满意度跨度从“这是我的日常主力”到“它更便宜,但仍不够值得信任”。@LearnInvest2026 使用了 (1 个赞,2 条回复,179 次浏览) 把 GPT-5.6 Sol 当成长上下文主力,把 Fable 5 当作设计收尾模型,这实际上是一种工作流级的组合。@sergeykarayev 显示 (8 个赞,1 条回复,530 次浏览) 解释了为什么会出现这种分工:GPT-5.6 位于成本或速度前沿,而 Fable 在他的内部基准中仍占据质量高地。

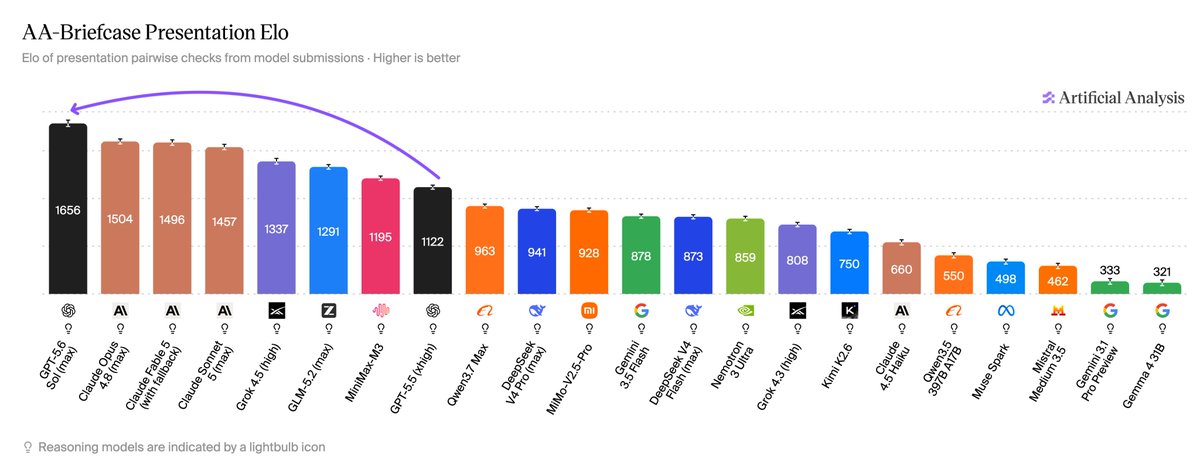
@mattlam_ 显示 (3 个赞,1 条回复,177 次浏览) 表示,模型选择只是故事的一部分,并通过 Pi、Opencode、Claude、Codex、Grok Build 与 GLM、Kimi、DeepSeek 的求解率对比图说明了这一点。@ArtificialAnlys 补充说 (36 个赞,5 条回复,2,654 次浏览) 则展示了完全不同的另一个维度:输出精修度,在他的 AA-Briefcase Presentation Elo 图表中,GPT-5.6 Sol max 位居榜首。
如今的变通做法正变得越来越复杂。人们把廉价模型路由到高频分类或代理循环,把前沿模型留给模糊任务,依赖提示缓存支撑长会话,并越来越把本地硬件视为一项财务决策。@pixeL_laugh 显示 (2 条回复,14 次浏览) 表示,一些本地配置在高强度使用下几个月就能回本;@LearnInvest2026 认为 (1 个赞,2 条回复,179 次浏览) 则指出,缓存命中和返工的重要性至少不亚于原始 token 价格。如今的竞争态势显然呈现出“栈化”特征:模型、框架、路由层、缓存行为和部署形态都很重要。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Claude for Financial Services | Anthropic,由 @cyrilXBT 分享 | 为投资银行、股票研究、私募股权、基金管理和财富管理工作流提供代理与插件模板 | 自动化重复性的分析师工作,同时保留明确的人类签核 | Python、Claude Cowork plugins、Managed Agents API、金融 MCP connectors | 已发布 | 帖子, 仓库 |
| LiteRT.js / LiteRT | Google AI Edge,由 @HowToPrompt__ 分享 | 通过 WebGPU 和 WASM 在设备端及浏览器中运行 ML 和 GenAI 工作负载 | 降低客户端 AI 应用在服务器、隐私和推理成本上的负担 | C++、JS、WebGPU、WASM、LiteRT toolchain | 已发布 | 帖子, 仓库, 文档 |
| OpenDataLoader PDF | OpenDataLoader Project,由 @N0V4Dev 分享 | 将 PDF 转换为带边界框的结构化 Markdown 或 JSON,并输出 Tagged PDF | 修复 RAG、文档 AI 和无障碍管线中的 PDF 摄取问题 | Java core、Python/Node/Java bindings、XY-Cut++、本地和混合提取 | 已发布 | 帖子, 仓库 |
| AI Picbreeder | @SakanaAILabs | 用 VLM 代理重现协作式 Picbreeder 风格图像演化 | 研究当前代理在开放式创意搜索中能做什么、做不到什么 | VLM agents、CPPNs、NEAT 风格进化、共享档案、公开代码与数据集 | Alpha | 帖子, 博客, 代码 |
最有意思的构建者模式并不是“又一个聊天套壳”,而是把高摩擦的专业工作流转化为带有明确脚手架的结构化代理系统。Anthropic 的金融服务仓库就是最清楚的例子:README 把输出界定为供人类审核的分析师工作产物,而不是自主执行结果,这正是对信任高度敏感的企业自动化正在被产品化的方式。
@N0V4Dev 分享了 (2 个赞,1 条回复,13 次浏览) 是这组内容中最实用的基础设施层。仓库截图和 README 共同说明了一点:“干净的 PDF 数据”不是锦上添花,而是可信 RAG 与文档自动化的前提条件。
LiteRT.js 和 AI Picbreeder 为构建者指向了两个不同方向。LiteRT.js 关注把推理迁移到客户端,让隐私或成本成为架构的一部分。AI Picbreeder 则把代理创造力与开放式搜索本身视作成果,并通过公开代码和数据为后续工作提供基础。
6. 新鲜且值得关注的内容
前沿评测招聘变得具体起来
@sayashk 发帖 (28 个赞,2 条回复,4,543 次浏览) 介绍了 CRUX 的一个高级研究员职位,重点是前沿代理的开放式评测。这张截图之所以重要,在于它把模糊的安全或评测叙事变成了真实的招聘画像:远程岗位、$150,000 至 $220,000 的薪资区间,以及研究长周期真实世界任务的职责。

本地 AI 硬件经济账不再模糊
@pixeL_laugh 认为 (2 条回复,14 次浏览) 表示,本地 LLM 硬件应结合实际回本周期与 API 成本来评估,而不是凭感觉判断。附带表格通过比较不同 Mac 和 Ryzen 配置与 API 等价模型支出,把这一点说得很具体:高强度使用可以很快回本,而低强度使用仍更适合租用 token。

Apple 与 OpenAI 的冲突让前沿 AI 看起来像一场经典的硬件商业机密之争
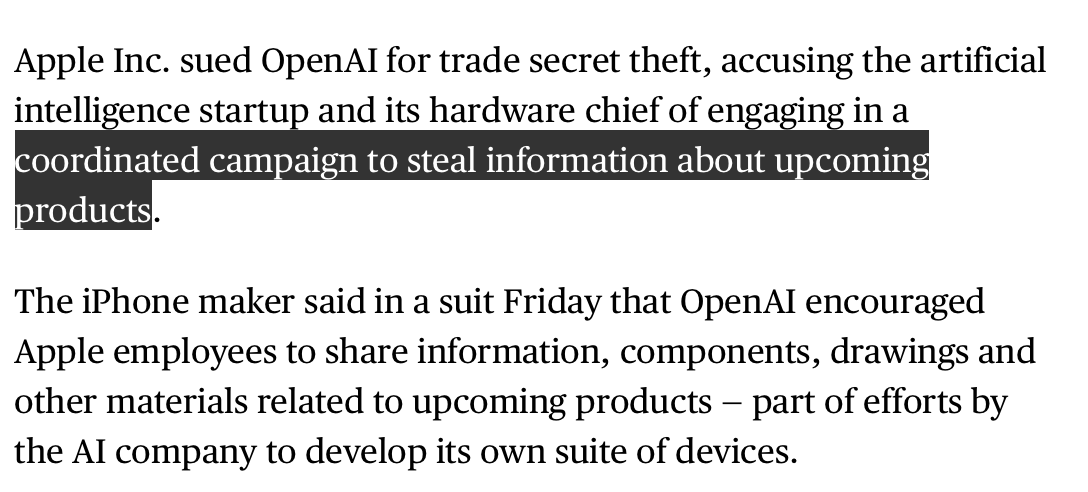
@kimmonismus 表示 (10 个赞,4 条回复,1,332 次浏览) 表示,Apple 因涉及未发布硬件计划的商业机密窃取起诉 OpenAI,并点名 Tang Tan 和 Chang Liu。传播最广的截图强调了 Apple 的主张:OpenAI 的硬件项目建立在被挪用的商业机密之上;而回复者则强调,这场争议针对的是硬件路线图,而不是 ChatGPT 的模型权重。
7. 机会在哪里
[+++] 自动路由与部署经济账这一层 —— 证据贯穿第 1、2 和 4 节。人们在发布自己的路由启发式,要求 CLI 自动切换模型,比较的是“完成任务”的经济性而不是 token 单价,并把缓存复用和返工与原始基准分数一并纳入权衡。
[+++] 面向长周期代理的评测、可观测性与来源追溯 —— CRUX 招聘、Pangram 论文指控、OpenDataLoader PDF,以及 OpenBench 中“做对了却继续做下去”的失败案例,都指向同一个缺口:团队需要更好的方法判断代理何时是对的、其来源何时是干净的,以及它何时应该停下。
[++] 客户端与本地推理基础设施 —— LiteRT.js、本地硬件回本表,以及开放模型带来的成本压力,都共同支撑了一个很强的机会:构建私有推理栈,并让非专业人士也能看懂成本、隐私与部署简易性。
[++] 高信任度的专业工作流代理 —— Anthropic 的金融服务仓库表明,当垂直代理公开连接器、审核步骤和明确的签核边界,而不是承诺完全自主时,其可信度会高得多。
[+] 具身 AI 瓶颈工具 —— 出货预测、电池约束和执行机构主导的成本结构,意味着除了更好的模型权重之外,围绕感知可靠性、部署正常运行时间、组件效率和 RaaS 运营的产品也存在空间。
8. 要点
- GPT-5.6 真正面对的竞争,并不是基准热度,而是路由负担、返工和质量取舍。 重度用户、二手 AMA 笔记和定制基准都把这次发布视为一项运营决策,而不是排行榜事件。(来源; 来源)
- 更便宜的模型正在重塑采购,但低价并不能抹平工作流失败。 Meta、Tencent、DeepSeek 和 Grok 都因经济性而受到关注,但浏览器操作循环、UI 抱怨和质量差距仍然立刻冒头。(来源; 来源; 来源)
- 评测工作正在变成一个有编制的职能,而不只是研究口号。 CRUX 招聘、私有基准分享,以及围绕来源追溯和停止规则的反复讨论,都表明评测正进入 AI 产品的运营核心。(来源; 来源)
- 文档、无障碍和金融工作流基础设施在这一天显得格外具体。 OpenDataLoader PDF、LiteRT.js 和 Anthropic 的金融服务代理都拿出了改善真实工作流的具体机制,而不只是概念。(来源; 来源; 来源)
- 凡是输出难以验证的地方,信任依然脆弱。 这一点体现在疑似由 AI 撰写的政策论文、会改动或拒绝任务的浏览器代理,以及仍受电池、执行机构和部署约束限制的具身 AI 系统上。(来源; 来源; 来源)