Twitter AI - 2026-07-13
1. 大家在讨论什么
1.1 基准测试图表仍是头条,但人们不断追问它们在现实中究竟意味着什么 (🡕)
2026-07-13 这一天,Twitter AI 的表层讨论几乎被基准测试文化占据,但图表之下的氛围,其实比榜单本身所呈现的更为怀疑。至少有七条保留内容支撑这一趋势:排行榜名次变化依然重要,但可部署性、用户挫败感和模型漂移不断打断那些“庆功时刻”。
@elonmusk 声称(5,849 次点赞,927 条回复,1,125,137 次浏览)称,Grok 4.5 在一些软件基准测试中略高于 Claude Fable。配图将这一说法具体化:Grok 4.5 在 SWE-Atlas-QnA 上得分 84,略高于 Fable 的代码变体。但回复很快把这一信号拆开:有用户说 Grok 在 C++ 计算机视觉任务中非常出色,也有人说它仍会凭空编造明显不可能的内容,或在真实编码会话中落后于 Sonnet/Fable。

@arena 报道称(444 次点赞,28 条回复,41,622 次浏览)称,GPT-5.6 Sol 在 Agent Arena 的 7.8K 次真实世界代理会话中排名第 2;与 Claude Fable 5 的最大差距,体现在“表扬 vs 抱怨”的满意度信号上,而不只是原始任务完成率。这一点之所以重要,是因为它把基准测试讨论从简单的通过率,转向了用户对代理产出物的实际感受。
@bnjmn_marie 表示(118 次点赞,15 条回复,8,028 次浏览)称,ThinkingCap-Qwen3.6-27B 通过缩短思考过程,在保持准确率的同时显著快于基础版 Qwen3.6-27B,并称赞了其背后的评测包。回复则补上了缺失的质感:一位实践者说,这个模型已经能在一张 RTX 6000 上同时运行八个 250k 上下文会话;另一位则说,同一个模型在 deepSWE 任务中反复无法进入工具循环。
@yunta_tsai 认为(191 次点赞,17 条回复,8,814 次浏览)称,有用性比基准测试更重要,因为旧指标可能捕捉不到范式转变。类似的怀疑也更直接地出现在一些挫败帖中:@n2parko 开玩笑说(102 次点赞,11 条回复,5,603 次浏览)抱怨,如今每周都得在多个 harness 上测试五个新模型;@ns123abc 称(87 次点赞,9 条回复,3,618 次浏览)则称,如果模型一周后就变了,那发布周基准测试就是营销。
讨论洞察: 分歧并不是要反对基准测试,而是在质疑基准测试的覆盖范围。人们希望先看到与部署的匹配度、跨版本更新的稳定行为,以及能够穿越模型频繁变化的个人评测,然后才会把一张发布图表当成定论。
与前一天相比: 在 2026-07-12,基准测试和排行榜讨论主要还是为了给模型排座次。到了 2026-07-13,同一话题变得更有自觉:人们明确开始质疑发布周数字、基准漂移,以及编码 harness 或医院部署场景是否会与图表结论一致。
1.2 推理效率从抽象优化讨论走向了具体构建工作 (🡕)
第二个重要主题是,推理经济学已经具体到足以让构建者直接采取行动。至少五条保留内容支撑了这一点:量化、后端统一、廉价本地硬件和集群脚本,都被讨论为能改变人们实际可运行何种 AI 系统的杠杆。
@waterloo_intern 解释道(173 次点赞,120 次收藏,10,202 次浏览)解释了一种新量化方法为何对 GLM 5.2 这样的前沿级模型服务如此重要。帖子详细拆解了从 bf16 到 fp8 再到 fp4 的内存计算,认为糟糕的量化会明显损伤模型质量,并声称这种新方法既比当前最先进方案更快、压缩更激进,同时在基准测试上的表现还更好。

@ClementDelangue 表示(142 次点赞,24 条回复,14,606 次浏览)称,Hugging Face Transformers 模型现在可以在 vLLM 中以原生速度运行,不再需要为每个新架构重复实现两次。基准图显示,在示例 Qwen-3 模型上,Transformers 后端达到了大约原生 vLLM 吞吐的 100% 到 102%;回复则表示,更大的收益在于删掉了一整层重复工程。

@lagerskoy 认为(130 次点赞,17 条回复,1,388 次浏览)称,本地 AI 竟已变得颇具竞争力:一台较老的 RTX 3060 机器跑出了约 52 tokens/s,而 Mac Mini M4 Pro 约为 38 tokens/s。类似的实操导向还体现在:@thelichhh 总结道(49 次点赞,23 次收藏,1,941 次浏览)提到 Jeff Geerling 的四主板 Framework 集群,并将读者引向公开的 Beowulf AI Cluster 仓库,同时也指出提示处理仍会卡住,以及效率在哪些方面仍落后于 Apple silicon。
讨论洞察: 共同传达的信息并不是“本地天然胜过云端”,而是推理如今已经成为一个可实际调优的层面:量化等级、后端重复实现、内存栈、集群拓扑以及提示处理开销,都成了人们可以改动的变量。
与前一天相比: 在 2026-07-12,本地控制的讨论更宽泛,也更偏产品层面。到 2026-07-13,它明显更偏工程化:意识形态更少,内存计算、吞吐图表和可复现的集群脚本更多。
1.3 关于代理的讨论进一步转向 harness、自有学习闭环和部署后适应 (🡕)
当天最强的系统层讨论,把代理视为长期运行的运维问题,而不是提示词技巧。至少六条保留内容支撑了这一主题,涵盖编排研究、架构建议、递归式大代码库方法、企业知识所有权,以及持续性评测环境。
@IntuitMachine 总结道(11 次点赞,13 次收藏,951 次浏览)展示了一项研究:仅改变围绕六个基础模型的编排层,就能把成本削减 33% 到 61%,中位延迟降低 44%,每个任务的 token 数减少 38%,同时质量大致持平。该线程的核心观点是,代理账单主要由 harness 选择决定,比如提示缓存、对话压缩、卸载体积庞大的工具输出,以及失败治理,而不仅仅是哪一个模型名称挂在 API 后面。
@lagerskoy 认为(51 次点赞,14 条回复,1,191 次浏览)称,代理并不那么需要更多工具,而是更需要更干净的架构:护栏、作用域清晰的工具、回退路径,以及能保持主上下文整洁的编排式子代理。@qyromat0 表达了类似观点(29 次点赞,20 次收藏,1,648 次浏览)则通过递归语言模型提出另一条路径:让编码代理把庞大仓库加载进一个可编程 REPL,再递归调用聚焦的子查询,而不是把整个代码库都塞进一个上下文窗口里。公开的 RLM 仓库 把这种模式变成了一个具体产物。
@aiwithsally 认为(122 次点赞,37 条回复,12,918 次浏览)称,企业真正要问的,不只是公司用哪个模型,而是谁拥有通过提示词、纠错、工作流和评测产生的学习成果。在评测侧,@Rixhabh__ 强调了(17 次点赞,7 条回复,3,279 次浏览)提到了 Skyfall AI 的开源 Morpheus,将其视为一种测试方式,用来判断前沿模型在持续、演化的企业环境中部署后是否还能适应,而不是只在静态基准任务上做判断。
在垂直 AI 领域,@DataChaz 强调了(19 次点赞,4 条回复,3,044 次浏览)将 ActAVA 的 CURA 描述为一款面向医疗的模型,并强调其在速度、成本和隐私方面的强势主张;而 @KaiteeShiks 回应道(59 次点赞,9 条回复,1,699 次浏览)则表示,真正的考验在于医院能否部署它、保护数据,并让日常工作变得更轻松。
讨论洞察: 共同关切在于“持续性”:如何让代理在演示之后、模型切换之后,以及部署改变环境之后,依然保持可靠。
与前一天相比: 在 2026-07-12,编排和评测已经很重要,但更多还是角色路由和信任层话题。到了 2026-07-13,讨论又向前走了一步,转向“所有权”:掌握 harness,掌握学习闭环,并在不会重置的环境里测试系统。
2. 什么让人感到挫败
基准测试频繁变动与个人评测负担过重
严重程度:高。@n2parko 打趣道(102 次点赞,11 条回复,5,603 次浏览)称,要跟上进度,现在意味着每周要在不同思考设置和 harness 上测试五个以上新模型,同时还得搭建个人评测,并绕开不断变化的使用限制。@ns123abc 说得更直白一些(87 次点赞,9 条回复,3,618 次浏览)则表示:如果模型一周后就变了,发布周基准测试就是营销。就连正面的模型帖也带着同样的压力信号——在 @bnjmn_marie 的 帖子 下方,一条回复称,ThinkingCap-Qwen3.6-27B 纸面上看起来很漂亮,但在 deepSWE 上却反复无法进入工具循环。人们目前的应对方式,是自己跑评测,并把公开排行榜当作暂时性参考。这值得围绕它构建产品,因为这种痛点同时打在买方和构建者身上,而且在部署开始前就先阻断了信任。
部署现实仍然会击穿基准测试叙事
严重程度:高。@KaiteeShiks 表示(59 次点赞,9 条回复,1,699 次浏览)称,在医疗场景里,关键在于医院能否部署模型、保护数据并让日常工作更轻松。这直接反驳了 @DataChaz 重点提到 CURA(19 次点赞,4 条回复,3,044 次浏览)的叙事:后者首先强调 CURA 的基准测试优势,但也不得不突出基础设施内部署和更低推理成本,才能显得足够适合企业。@aiwithsally 补充道(122 次点赞,37 条回复,12,918 次浏览)称,更深层的企业风险,是丢失在使用 AI 过程中产生的知识所有权;而 @Rixhabh__ 重点提到 Morpheus(17 次点赞,7 条回复,3,279 次浏览)之所以被提出,正是因为静态基准测试无法捕捉部署后的适应能力。团队目前通过私有部署、领域专属评测和更严格的工作流框定来应对。这值得围绕它构建产品,因为隐私、工作流适配和学习所有权,正成为第一优先级的采购标准。
推理底层仍在消耗时间和算力
严重程度:中高。@waterloo_intern 描述道(173 次点赞,120 次收藏,10,202 次浏览)认为,当下的量化算法既慢又常常不是最优解,并指出,想要低成本部署巨型模型,关键取决于这一层是否做好。@ClementDelangue 将其定义为(142 次点赞,24 条回复,14,606 次浏览)则把每种架构都要实现两次——一次给 Transformers,一次给 vLLM——视为一种生态税,既拖慢发布速度,也引入分叉。在硬件层面,@thelichhh 展示了(49 次点赞,23 次收藏,1,941 次浏览)指出,即便是可用的消费级硬件集群,仍然会卡在提示处理瓶颈上。人们现在的应对方式包括更激进的量化工作、后端统一,以及基于 Ansible 的集群自动化。这值得围绕它构建产品,因为每一项改进都会在成本、延迟和模型选择上产生叠加收益。
AI 搜索的测量仍与营收系统脱节
严重程度:中。@alexgroberman 报道称(25 次点赞,2,083 次浏览)称,受访团队中只有 22% 已将 SEO 与 AI Search 完全集成;而 40% 主要还是靠手动去问 ChatGPT 来检查可见性,49% 难以把 AI Search 与销售管道或营收挂钩,45% 难以衡量在 AI 回答中的可见度。该帖子还认为,内容、PR 与 SEO 系统彼此割裂,会导致品牌在助手回答中被错误描述、定位模糊,或被表达更清晰的竞争对手压过。构建者目前通过可见性工具、AI 搜索专用内容包,以及对 ChatGPT、Claude、Perplexity、Google AI 和 Grok 的人工监控来应对。这看起来值得做,因为痛点既具体又可衡量,但当下的解决方案仍然是拼凑出来的。
3. 人们希望存在什么
能穿越模型频繁变动、以工作流为锚点的评测
@yunta_tsai 认为(191 次点赞,17 条回复,8,814 次浏览)称,目标应该是有用性,而不是基准测试声望。@IntuitMachine 随后给出了具体说明 进一步说明,仅靠编排就可能比更换模型供应商更大幅度地改变成本和延迟;@Rixhabh__ 推动了 则将 Morpheus 作为一种在不重置环境中测试部署后适应能力的方式。共同需求是:一层可复用的评测层,能够贴合真实工作流,在模型更新后依然保留可比结果,并按每美元质量或每任务质量来衡量表现,而不仅仅是发布分数。机会:直接。
能跨越供应商切换、由企业自有的学习闭环
@aiwithsally 将其定义为(122 次点赞,37 条回复,12,918 次浏览)把企业的核心资产定义为通过提示词、纠错、工作流和评测产生的知识。这一需求也与 @lagerskoy 的 clean-architecture 帖子、@qyromat0 的 RLM 帖子 关于递归式大代码库推理的内容,以及 @OpenCodeLog 详细说明了 关于供应商/模型路由和更清晰本地上下文的讨论相呼应。人们似乎想要的,不只是代理自主性,而是一层控制层,让记忆、上下文纪律和工作流知识在模型变化时依然可以迁移。机会:竞争性。
没有重复工程、同时私有且可负担的推理栈
@waterloo_intern 展示了(173 次点赞,120 次收藏,10,202 次浏览)体现了对更好量化的需求,@ClementDelangue 推动了 体现了对单一实现模型后端的需求,而 @lagerskoy 认为 与 @thelichhh 认为 则都表明,廉价本地硬件已经足够值得认真调优。这里的需求很务实:更少的重复移植、更好的内存效率、更简单的集群编排,以及更明确的工作负载与本地硬件适配指引。机会:直接。
AI 搜索可见性与落地页情报
@alexgroberman 描述道(25 次点赞,2,083 次浏览)描绘了这样一种局面:企业可以整天谈论 AI Search,却依然失败,因为没人把内容、权威性、可见性和报告连接起来。配图和引用数字指向了一个明确需求:团队想知道助手是否引用了自己、哪些页面被展示、哪些竞争对手反而被点名,以及这些访问是否能转化。这个需求非常现实,并且具有即时商业价值,尤其适用于 SaaS、金融、医疗、法律和本地服务等信任与页面针对性很重要的行业。机会:直接。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Grok 4.5 | LLM | (+/-) | 顶层编码基准测试声量很强;部分用户反馈编码辅助确实有用 | 多条回复称它仍会出现幻觉,在真实工作流中也落后于 Claude 系列 |
| GPT-5.6 Sol + Agent Arena | LLM + 评测 | (+/-) | 代理排名强、可控性好,并且有可量化的用户满意度指标 | 在 Arena 上仍落后于 Claude Fable 5;对基准测试的怀疑依然存在 |
| ThinkingCap-Qwen3.6-27B | 开源 LLM 微调 | (+/-) | 思考更短、响应更快、准确率保持不变,长上下文并发反馈不错 | 至少有一位实践者报告,在微调覆盖范围之外出现了工具循环失败 |
| vLLM 中的 Transformers 后端 | 推理框架 | (+) | 同一套模型实现可从训练直接流向生产,吞吐接近原生 | 对较新架构和推理栈选择的覆盖仍有疑问 |
| 量化工具链(GLM 5.2 FP8/NVFP4,Waterloo method) | 推理优化 | (+) | 在保留更多质量的同时缩小内存占用和服务成本 | 量化做错依然会损伤能力;最佳方法仍在演进中 |
| 本地 GPU 设备与 Framework 集群 | 本地基础设施 | (+/-) | 基于旧硬件即可实现廉价私有推理;消费级设备也可组集群 | VRAM、提示处理和部署复杂度仍限制真实工作负载 |
| OpenCode + models.dev | 编码代理 / 模型路由 | (+) | 供应商路由、更清晰的本地上下文、公开对比页面、灵活的模型选择 | 快速变化的供应商限制和计费细节带来维护负担 |
| Morpheus / 持续性企业模拟 | 评测 / 持续学习 | (+/-) | 在不会重置的环境中测试部署后适应能力 | 证据仍偏早期,而且更强模型似乎仍会撞上能力下限 |
| GTM 自动化栈(n8n、Claude Code、Supabase、Clay、HubSpot) | 营收自动化 | (+) | 覆盖代理、RAG、CRM 和外联执行的具体生产栈 | 随着工具数量增加,维护负担会迅速上升 |
| SEO Stuff / AI 搜索可见性工具 | 搜索分析 | (+/-) | 给团队提供了一种检查品牌如何出现在各类助手入口中的方式 | 证据偏宣传性质,而且许多团队仍依赖人工检查 |
总体满意度从对更便宜的开源/本地栈的乐观,一直到对基准测试频繁变动和集成开销的明显疲惫。常见应对方式包括个人评测、按角色分配模型路由、提示缓存、更激进的量化,以及在需要更高控制力时,从无代码自动化转向代码。迁移模式不再是“从模型 A 切换到模型 B”,而更像是“在你已经使用的模型外面,加上一层更好的 harness、后端或路由层”。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Beowulf AI Cluster | Jeff Geerling | 将多台小机器组成集群,以运行并基准测试更大的本地 LLM 工作负载 | 单台消费级机器难以支撑超大模型和私有推理实验 | Ansible, llama.cpp, distributed-llama, Framework Desktop boards | 已发布 | 仓库, 帖子 |
| Morpheus | @skyfallai | 用于持续学习和适应性研究的持续性企业模拟环境 | 静态基准测试无法显示代理在部署后是否仍然有用 | 开源模拟器、Python SDK、Gymnasium 风格 RL 接口 | Beta | 仓库, 帖子 |
| OpenCode / models.dev | anomalyco / @OpenCodeLog | 开源编码代理,加上一个与供应商无关的模型目录与对比界面 | 团队需要供应商灵活的编码工作流,以及更清晰的模型选择 | CLI, TUI, desktop app, OAuth, model catalog | 已发布 | OpenCode, models.dev, 帖子 |
| SEO Stuff | @alexgroberman | 面向 AI 搜索发现和引用入口的可见性与内容包 | 企业无法判断助手如何描述自己,或引用了哪些页面 | AI 搜索监控、内容生产、权威投放 | 已发布 | 帖子 |
| M3 repo health reviewer | @FareaNFts | 将完整 GitHub 仓库流式送入一个 1M 上下文模型,并返回代码健康报告和首个 PR | 分块式仓库对话工具无法掌握整个代码库上下文及跨文件问题 | MiniMax M3, long-context prompting, GitHub repo ingestion | Alpha | 帖子 |
| AI Red Teaming: The Complete Guide | requie | 面向 AI 系统对抗测试与安全评估的公开 GitHub 指南 | 团队缺少一套可复用、与主流框架对齐的 AI 安全测试打法 | Markdown guide, NIST AI RMF, OWASP, MITRE ATLAS | 已发布 | 仓库, 帖子 |
值得注意的构建,大多不是新的基础模型,而是围绕现有模型叠加的控制层、基准测试环境、搜索可见性工具、本地集群和安全作战手册。反复出现的触发因素包括推理成本、模型行为不稳定、无法衡量生产质量,以及看不见助手是如何呈现某个产品或工作流的。多个构建者从不同角度攻向同一个元问题:如果模型层高度易变,那么价值就会转移到编排、评测、路由和测量上。
6. 新内容与值得关注的内容
Agnes 2.5 Pro 跳出常见的中美叙事,加入编码模型竞赛
@BrianRoemmele 表示(30 次点赞,10 条回复,4,089 次浏览)称,总部位于新加坡的 Agnes 2.5 Pro 正在交付前沿级编码性能,并附上了一张内部评测图。图片显示,Agnes 2.5 Pro 在 SWE-bench Verified 上为 82.7,在 SWE-bench Multilingual 上为 78.7,在 Terminal-Bench 2.1 上为 77.3;回复讨论则聚焦于这种“高分数 + 立刻可免费使用”的组合有多不同寻常。外部发布报道将 2.5 Pro 描述为预览版,而 2.5 Flash 则为当前可用版本。

AI 红队正在凝结成一套可复用的操作手册
@tom_doerr 分享了(9 次点赞,13 次收藏,2,512 次浏览)提到了公开的 AI Red Teaming:完整指南,它围绕 NIST、OWASP 和 MITRE 框架组织对抗测试与安全评估。这个仓库读起来更不像一篇博客,更像一个可实际部署的产物:这说明 AI 安全测试正在成熟为可复用的操作文档,而不再只是零散的提示注入经验谈。
面向文档图像的视觉预训练,出现了更清晰的公开证据点
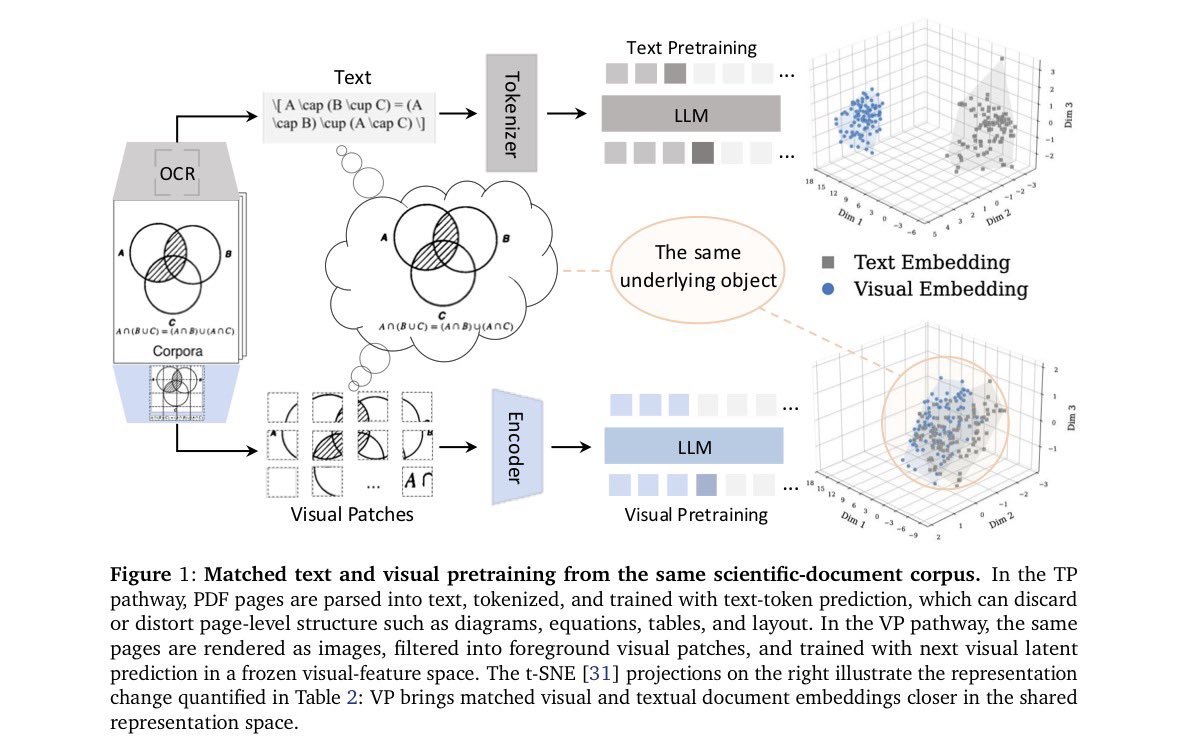
@BrianRoemmele 提到了(81 次点赞,14 条回复,26,243 次浏览)提到一篇题为 探索用于学习语言智能的视觉预训练 的论文,主张直接在视觉文档上做预训练,优于把同一语料展平成纯文本。他附上的图本身就很有信息量:它把同一科学文档语料上的 OCR 转文本路径,与视觉 patch 路径并列对比,让“版式和公式很重要”这一论点在读论文前就已经一目了然。
单摄像头物理 AI 继续推进
@CyberRobooo 重点介绍了(43 次点赞,4 条回复,2,688 次浏览)提到 Mistral 的 Robostral Navigate,将其描述为一款面向具身导航的 8B 视觉-语言-动作模型。值得注意的不只是又一个机器人模型,而是其声称:仅凭一台 RGB 摄像头、无需 LiDAR 或深度传感器,就能依据自然语言指令在陌生环境中导航,这降低了物理 AI 部署的硬件门槛。
7. 机会在哪里
[+++] Workflow-grounded eval and orchestration platforms - Evidence came from multiple directions at once: @IntuitMachine 展示了 显示,仅改 harness 就能把代理成本削减 33% 到 61%;@Rixhabh__ 指出 指向持续性的部署后环境;@KaiteeShiks 筛选了 则通过可部署性和隐私来审视医疗模型。这个机会很强,因为同一种需求同时出现在编码代理、企业运营、医疗和安全场景中。
[+++] Private inference optimization and local deployment tooling - @waterloo_intern 展示了、@ClementDelangue 报道称、@lagerskoy 认为 以及 @thelichhh 展示了 都指向同一个机会的不同部分:更好的量化、更少的重复后端、更清晰的硬件适配指引,以及更简单的集群编排。这个机会很强,因为它能立刻省钱,并扩大能私有运行严肃模型的人群范围。
[++] AI-search visibility and landing-page intelligence - @alexgroberman 展示了 明确展现了这样一种需求:需要把助手可见性、页面针对性、权威信号和营收报告连接起来的工具。之所以说这是中等而非强机会,只是因为当前证据主要集中在一条商业线程里,尽管痛点看起来真实且可衡量。
[+] Model-portable knowledge ownership layers - @aiwithsally 将其定义为 指向了掌握学习闭环的需求,而 @OpenCodeLog 展示了 与 @dan__rosenthal 展示了 则是团队已经在自行拼装的控制平面组件。这个机会仍在形成中,因为需求已经很清楚,但产品类别仍分散在代理、路由、记忆和运维工具之间。
8. 要点
- Twitter AI 这一天都在和自己的记分牌较劲。 最热门的帖子依然以排名开场,但后续最有力的讨论,谈的是幻觉、基准漂移、可部署性和有用性,而不只是排行榜炫耀。 (Grok 4.5 基准测试说法, 实用性高于基准测试, 对发布周的怀疑)
- 推理工作正在成为构建者变化最快的层之一。 量化进展、后端统一、旧 GPU 本地机器和消费级硬件集群,都指向同一件事:成本和部署方式将决定下一批 AI 产品会长成什么样。 (Waterloo 量化讨论串, vLLM 中的 Transformers, 框架集群总结)
- harness 设计正从工程偏好,变成损益表议题。 当天最具体的系统帖显示,仅靠编排调整,在质量大致不变的情况下,成本最多可降低 61%;这比一个小幅领先的头条模型差距重要得多。 (编排层研究总结)
- 企业买家正通过所有权、隐私和工作流适配来筛选前沿 AI。 这一点体现在学习闭环论点、医院对 CURA 的部署反应,以及推动建立持续性部署后测试环境的趋势中。 (学习闭环所有权, 医院部署筛选机制, Morpheus)
- 围绕模型层本身,正在形成一层新的软件层。 开源编码代理控制平面、AI 搜索可见性工具、安全作战手册和公开基准测试环境,都表明价值正转移到路由、测量和运维纪律上。 (OpenCode 发布, AI 搜索集成讨论串, AI Red Teaming 指南)