Twitter AI - 2026-07-15
1. 大家在讨论什么
1.1 基准测试仍是共同语言,但验证正成为真正的信任边界(🡕)
关于基准测试的讨论,已经从单纯为排行榜成绩兴奋,转向一个更棘手的问题:什么样的 AI 结果才真正值得信赖,足以用于部署、监管或实际依赖?最有分量的帖子,都把性能主张与对长时程真实性、污染以及证明机制的明确担忧结合在了一起。
@billyuchenlin 重点提到(44 个赞,4 条回复,3,446 次浏览)讨论了面向长时程软件工程任务的 RL 工作,同时引用了 Proximal 关于 Grok 4.5 的 FrontierSWE 结果。Epoch 的 FrontierSWE 摘要 表示,该基准测试关注长时程的实现、性能和研究任务,报告的是整体优势,而不是一次性的通过/失败分数,因此这篇帖子讨论的重点,更接近持久的智能体工作能力,而非短暂的代码演示。
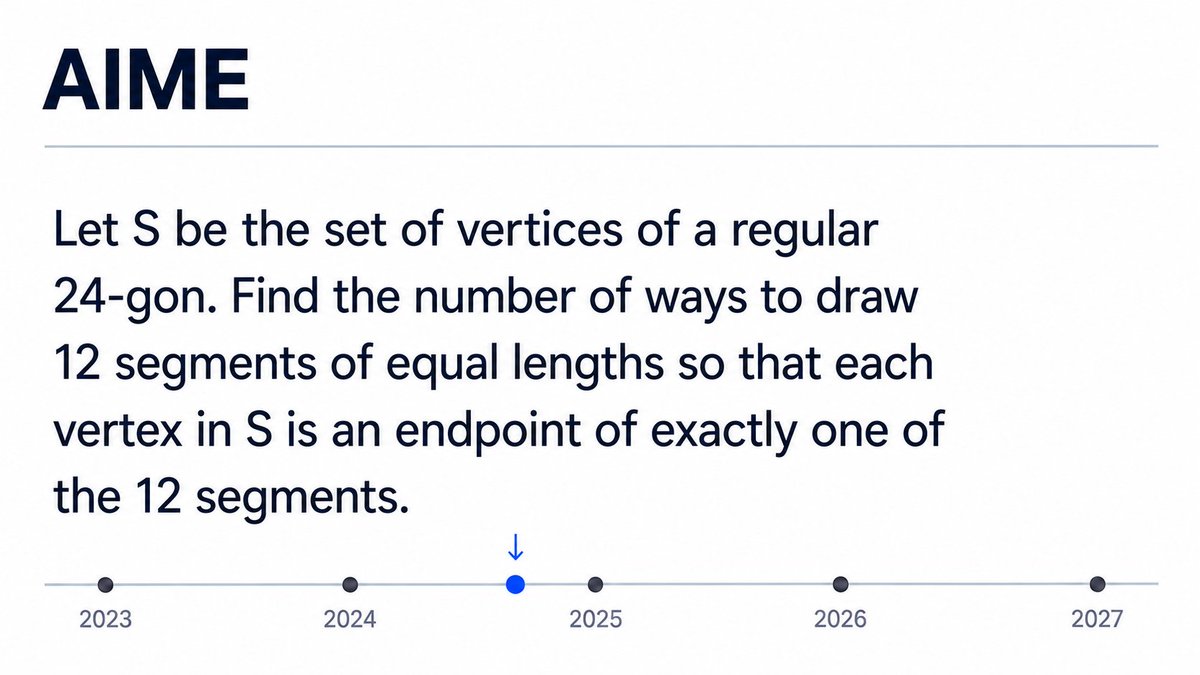
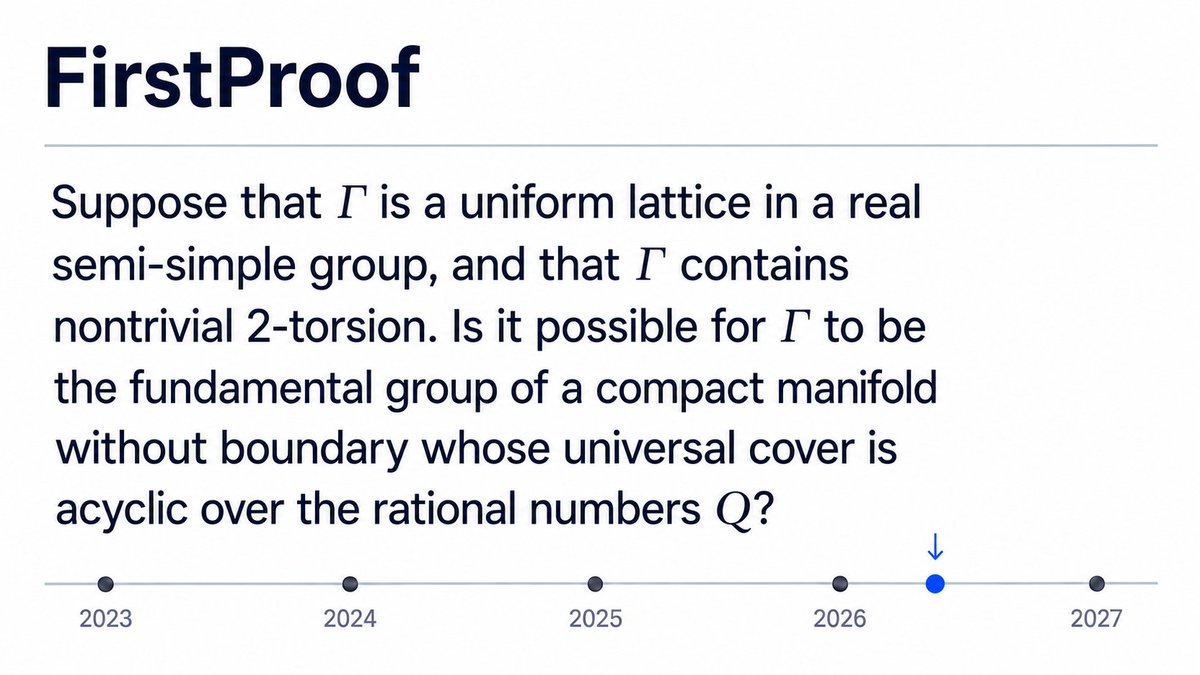
@tonylfeng 认为(23 个赞,1 条回复,1,176 次浏览)指出,进展速度可以直接从题目本身看出来:他发布的四图轮播展示了 MATH、AIME、FirstProof 和 IMO 的题目,并称如今 AI 系统已经能够解出这些题。相比又一张排行榜截图,这种材料更有说服力,因为它让不断收窄的难度前沿变得具体可见。


@ziv_ravid 警告(15 个赞,1 条回复,2,030 次浏览)认为,拟议中的“AI 版 FINRA”可能会在行业拥有能够抵御污染的留出测试和独立于实验室的测试之前,就把基准门槛写入法律。@zooko 补充说(11 个赞,1 条回复,605 次浏览)表示,只有当结果能够通过测试、基准、正确性证明和密码学证明得到验证时,他才看好 AI 驱动的软件工程;与此同时,@danfaggella 嘲讽(7 个赞,2 条回复,804 次浏览)则认为没完没了的基准测试讨论,正在分散人们对 AGI 更大影响的注意力。
讨论洞察: FrontierSWE 帖子下的回复并没有否认基准测试的重要性;它们强调,真正的实用性始于长时程任务,以及向生产环境的泛化。更尖锐的分歧来自治理层面:ziv_ravid 的帖子称,实验室可以针对已知测试进行训练,这意味着以基准测试为基础的市场准入可能带来被利益俘获的风险,而不是中立的安全措施。
与前一天的比较: 2026-07-14 的报告重点讨论了 BridgeBench、G-Eval 和 DeepEval 等实用评测工具。今天的讨论又深入了一层:不只是如何评估,还包括当基准测试成为信任、监管或上线决策的依据后,它是否还能保持可信。
1.2 智能体系统正围绕裁决、结算和机器可读原语展开(🡕)
关于智能体的讨论,重点不再是模型有多聪明,而是自主系统发生分歧后会怎样。高信号帖子都试图补上缺失的连接层:争议层、验证层,或供智能体可靠行动的产品原语。
@lami_thefirst 描述(32 个赞,11 条回复,1,440 次浏览)将 Internet Court 视为智能体商业缺失的接口:在一个流程中处理身份、谈判、义务、托管、执行和争议解决。引用的发布帖称,这是一个开放技能,两个智能体可以借此端到端完成一笔交易;回复则立即指出了难点:瓶颈、执行、模糊标准,以及协同智能体是否可能操纵这一层。
@0xdelula 做出(3 个赞,4 条回复,74 次浏览)提出了类似观点,将 GenLayer 视为智能体经济的裁决层。GenLayer 文档 表示,多样化验证者会独立评估交易,由多数同意来接受结果;如果提出申诉,则会扩大验证者集合,直到最终确定。这让帖子的主张进一步落实成了具体机制。
@NotionDevs 表示(13 个赞,651 次浏览)分享了其早期 GPT 时代工作的一个教训:必须重写产品封装层,使其同时对人类和智能体都清晰可读。其独特观点是,Notion 的文本、图像和数据库原语让它得以“跃入智能体工具调用世界”,因为产品界面本身已经具备智能体可以编辑的结构。
讨论洞察: 有价值的回复并非泛泛称赞,而是提出了具体失效模式:谁来制定中立标准;小额交易能否承受额外的争议处理成本;如果裁决无法在不同链或系统之间自动执行,它们是否仍然有意义。
与前一天的比较: 昨天关于智能体基础设施的帖子,重点是记忆层和角色路由。今天的重点从内部编排转向外部信任:解决分歧、编码义务,并让应用界面具备足够的机器可读性,使智能体能够安全运行。
1.3 本地 AI 正变得更聚焦、更快,也更接近具体产品(🡕)
端侧 AI 仍然是热门话题,但今天的例子不再主要围绕未来的硬件算力,而是人们现在就能运行或发布的具体软件成果。最强信号来自专用模型、本地语音系统、图像模型工具,以及原生面向智能体的手机构想。
@anshuc 报道称(13 个赞,4 条回复,947 次浏览)介绍了如何使用 GPT-5.6 Sol 和 Codex 式迭代,在 MLX 上构建一个 1.7B 自动纠错模型。作者称,在其自有的错误率降低基准测试中,该模型以 91.02% 对 90.56% 略胜 Sol,并在 MacBook GPU 上实现约 40ms 的首 token 延迟。作者在回复中进一步限定了这一说法:该原型目前对非英语文本的支持还不理想。
@GithubProjects 分享了(14 个赞,1 条回复,2,706 次浏览)介绍 NeuTTS,这是一个支持即时语音克隆的开源本地 TTS 技术栈。NeuTTS 仓库 表示,这个 Python 项目在 GitHub 上已有超过 6,100 个 star,提供面向手机和 Raspberry Pi 级设备的 GGUF 量化版本,只需约 3 秒音频即可完成克隆,并且会为输出添加水印。
@aisearchio 指出(14 个赞,584 次浏览)介绍了 NVIDIA 发布的 PiD v1.5,这是面向 Qwen-Image、Z-Image 和 Flux 等模型的更快开源超分工具。PiD 仓库 将其描述为一个拥有 917 个 GitHub star 的 Python 解码器,可用一次推理生成超分辨率像素,从而替代 VAE/RAE 解码器;其 7 月更新加入了 PiD v1.5 检查点,并可选支持 Boogu-Image。
@TechBuzzChina 报道称(4 个赞,1 条回复,324 次浏览)称 StepFun 发布了 STEPX、Step AOS 和 Amoo 智能体。一则 Gizmochina 文章 表示,StepX Neo 的定位是一款可离线运行、原生面向智能体的手机,支持 32 种语言翻译、基于 MCP 访问应用和系统工具,并搭载端侧 Step Edge 模型;不过价格和零售上市时间仍未公布。
与前一天的比较: 2026-07-14 的报告关注本地 AI 的容量限制、运行时支持和非 CUDA 编程模型。今天的证据更扎实,也更面向用户:用于输入的本地专用模型、端侧语音、图像解码工具,以及一款差异化重点在智能体层而非单纯芯片组的手机。
1.4 面向公众的 AI 发布,正迅速遭遇来源和语气方面的反弹(🡕)
今天一些信号最强的帖子,并不是开发者发布,而是公众对 AI 进入大众视野方式的反应。反弹既针对未披露的生成式媒体,也针对前沿实验室的安全营销。
@CultureCrave 报道称(158 个赞,24 条回复,14,724 次浏览)称,《Alvin and the Chipmunks》的回归计划包括招聘生成式 AI 工作流人员,并在下一部电影上映前进行类似网红营销的数字化推广。一则 Cartoon Brew 文章 引用《The Wall Street Journal》称,Big Shot Pictures 收购了 25% 的股份,将以 YouTube 优先的短视频作为主攻方向,并计划在 2028 年推出院线重启版;回复几乎一边倒地反对生成式 AI 方向。
@BackroomsForDBD 表示(22 个赞,1 条回复,321 次浏览)称,在得知某个表情包由 Viggle AI 生成后,他们删除了该内容,并明确要求 DBD 社区保持无 AI 状态。这是一篇规模不大的帖子,却非常清楚地表明,仅仅是内容来源的披露,就足以让创作者从分享转为删除。
@Polymarket 发布了(100 个赞,35 条回复,38,538 次浏览)称,Anthropic 最新的 AI 安全广告因末日式表达引发反弹。回复分成两派:少数人称赞其坦诚,更多人则认为这是利用恐惧进行定位;Polymarket 的 后续市场 给出的本年度 AI 安全法案通过概率仅为 15%。
讨论洞察: 回复并非从同一个维度拒绝 AI。影迷反对娱乐行业采用合成媒体工作流,社区成员基于真实性理由拒绝生成式内容,而安全广告的批评者则认为灾难叙事更像战略定位,而不是承担责任。
与前一天的比较: 昨天 Twitter AI 的讨论主要面向从业者。今天,一些最强互动来自公众对 AI 呈现方式的反应,尤其是在传统媒体品牌或安全实验室试图将技术包装给主流受众时。
2. 什么让人感到沮丧
基准测试有用,但太容易被过度信任
严重程度:高。@ziv_ravid 认为(15 个赞,1 条回复,2,030 次浏览)称,如果基准门槛成为监管准入条件,实验室就会有充分动机针对已知测试进行优化,而不是提升测试真正要衡量的底层能力。@zooko 表述为(11 个赞,1 条回复,605 次浏览)对软件工程提出了更直接的说法:他只相信那些能够通过测试、证明或密码学证据验证的结果。即便是 @billyuchenlin 倾向于(44 个赞,4 条回复,3,446 次浏览)发布的乐观基准测试帖子,也把重点放在长时程泛化,而不只是排行榜地位。这值得投入,因为这种挫败感并不是反对评测,而是要求评测经得起部署和治理压力。
智能体工作流在系统发生分歧时仍会失效
严重程度:高。@lami_thefirst 表示(32 个赞,11 条回复,1,440 次浏览)表示,当前的智能体商业是一组彼此割裂的工具,一旦交易出错就会停滞。回复将这一失效具体化:把所有争议都通过一个接口处理,可能造成瓶颈;自然语言义务对不同模型可能意味着不同的事情;而跨链或跨系统执行仍未解决。@0xdelula 重新框定(3 个赞,4 条回复,74 次浏览)指出,交付争议和发票问题同样存在这一痛点;GenLayer 文档 则明确将申诉和扩大验证者集合描述为应对机制。这值得投入,因为痛点直接位于交易完成、付款放行和信任之中。
面向公众的 AI 发布会迅速引发真实性和语气方面的反弹
严重程度:中高。@CultureCrave 报道称(158 个赞,24 条回复,14,724 次浏览)提到《Alvin and the Chipmunks》重启项目招聘生成式 AI 工作流人员,回复立即将其视为不信任该项目的理由。@BackroomsForDBD 删除了(22 个赞,1 条回复,321 次浏览)在得知 Viggle 采用生成式 AI 后删除了一个表情包,说明仅仅是来源问题,就足以让某些社区否定内容。@Polymarket 放大了(100 个赞,35 条回复,38,538 次浏览)记录了对 Anthropic 安全广告的反弹,回复称其末日式表达令人觉得具有操纵性。这值得投入,因为披露、同意和呈现方式如今已经是产品风险,而不只是公关细节。
3. 人们希望出现什么
能经受部署和监管考验的验证机制
反复出现的需求不是又一个通用基准测试,而是一套在实验室有时间研究、政策制定者开始将其视为准入门槛之后,仍然有意义的验证技术栈。@ziv_ravid 明确说明(15 个赞,1 条回复,2,030 次浏览)指出,需要速度快于前沿模型、且独立于实验室的留出评测;@zooko 请求(11 个赞,1 条回复,605 次浏览)则强调,在信任 AI 软件工程之前,需要测试、正确性证明和密码学证明。@billyuchenlin 补充说(44 个赞,4 条回复,3,446 次浏览)提出了实践角度:实用性必须在长时程 SWE 任务中体现出来。机会:直接。
面向智能体间商业的共享裁决层
Internet Court 和 GenLayer 的帖子,本质上都在请求同一个缺失组件:智能体完成谈判、付款、发货或工作验证后,如果出现分歧,能够在不把人类重新拉回流程的情况下解决问题。@lami_thefirst 想要(32 个赞,11 条回复,1,440 次浏览)提出了一个以自然语言为基础的界面,将声誉、义务、托管和结算整合起来;@0xdelula 想要(3 个赞,4 条回复,74 次浏览)则强调验证者共识和申诉机制。回复表明,公平性、执行和标准仍是开放问题。机会:直接。
针对单一任务优化的本地 AI 组件,而非面面俱到
今天的本地 AI 开发者需要的是专用能力、隐私和低延迟,而不是又一个通用助手。@anshuc 逐步推进到(13 个赞,4 条回复,947 次浏览)聚焦单一输入工作流;@GithubProjects 指向(14 个赞,1 条回复,2,706 次浏览)聚焦端侧语音克隆;@aisearchio 曝光了(14 个赞,584 次浏览)则提供能够接入现有模型流水线的图像解码工具。StepX Neo 的故事将同一需求延伸到了设备:让智能体处在系统层,同时让核心任务保持离线可用。机会:有竞争力。
清晰的来源标识,以及更好的生成式媒体社交默认设置
删除由 Viggle 生成的表情包,以及公众对带有 AI 色彩的娱乐发布的敌意,都指向一个较柔和但同样实际的需求:受众希望知道哪些内容是生成的、哪些经过编辑,以及特定社区适用什么规范。@BackroomsForDBD 展示了(22 个赞,1 条回复,321 次浏览)体现了通过退避来进行内容管理的需求,而围绕 Alvin 的回复则体现了品牌风险版本。机会:愿景型。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| FrontierSWE | 基准测试 / 智能体评测 | (+/-) | 聚焦长时程的实现、性能和研究任务 | 仍然属于基准测试层,因此可信度取决于能否泛化到测试套件之外 |
| 测试、证明和密码学证明 | 验证方法 | (+) | AI 软件工程中提到的最强信任边界 | 更难应用于混乱且不可验证的领域 |
| Internet Court | 智能体商业 / 争议层 | (+/-) | 将谈判、义务、托管、执行和结算整合进一条面向智能体的流程 | 中立标准、执行和瓶颈风险尚未解决 |
| GenLayer | 裁决协议 | (+/-) | 为模糊的智能体争议提供多样化验证者、申诉和最终确定窗口 | 在当前数据集中社会证明较少;仍然依赖协议信任和采用情况 |
| MLX + T5Gemma 自动纠错流水线 | 本地模型训练 | (+) | 快速、专用、本地化,针对单一任务优化;报告了 MacBook GPU 性能 | 目前以英语为主,且仅有自报评测作为依据 |
| NeuTTS | 端侧 TTS | (+) | 3 秒语音克隆、GGUF 部署、支持水印,面向边缘设备 | 完整音频流水线仍需配置编解码器和运行时 |
| PiD | 图像解码器 / 超分 | (+) | 一次推理完成超分辨率解码,近期支持 Flux、Z-Image 和 Qwen-Image | 需要针对模型进行配置,并依赖上游图像骨干模型 |
| Step AOS / Step Amoo | 原生面向智能体的设备技术栈 | (+/-) | 可离线执行跨应用和系统工具的任务 | 在当前证据中,可用性、价格和基准测试主张仍未验证 |
工具生态沿着两种信任策略分化。一类试图通过长时程基准测试、测试、证明和裁决层,让 AI 输出更可信。另一类则通过缩小任务范围,让 AI 更易用:本地自动纠错模型、端侧语音、更出色的解码器,或者将智能体内置于操作系统的手机。@NotionDevs 补充说(13 个赞,651 次浏览)提出了第三个方法层面的教训:稳定的产品原语可能与模型同样重要,因为它们决定了智能体能否真正操作界面。
细节中可以看到迁移压力。自动纠错项目从通用前沿模型转向针对错别字优化的小型本地流水线;NeuTTS 将语音 AI 封装进适合 GGUF 的端侧模型,而不是依赖 Web API;PiD 则接入现有图像模型系列,而不是彻底替代它们。三者面临的主要局限相同:专用能力的优势确实存在,但并不能消除配置、验证或互操作性工作。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Internet Court | @lami_thefirst | 连接智能体谈判、义务、托管、执行和争议解决 | 智能体交易一旦出错就会中断,而当前不存在共享的争议层 | 开放技能、声誉、托管、结算流程 | Alpha | 帖子 |
| GenLayer | @0xdelula | 使用 AI 验证者和申诉机制裁决模糊结果 | 智能体需要一种无需僵化的是/否合同即可解决分歧的方式 | Intelligent Contracts、验证者网络、申诉、Web 数据 | Beta | 帖子 · 文档 |
| 定制本地自动纠错模型 | @anshuc | 训练一个用于快速本地运行的 1.7B 错别字纠正模型 | 通用助手速度较慢,也没有针对单一输入工作流进行优化 | MLX、T5Gemma、错别字模拟器、自定义损失、束搜索 | Alpha | 帖子 |
| NeuTTS | @GithubProjects | 在设备上运行本地 TTS 和即时语音克隆 | 无需云 API,即可实现私密、低延迟的语音生成 | Python、GGUF、NeuCodec、小型 LLM 骨干 | 已发布 | 帖子 · GitHub |
| PiD | @aisearchio | 将潜在图像表示一次解码为超分辨率像素 | 图像模型用户希望提高解码质量,而不必搭建全新的生成技术栈 | Python、扩散解码器、Hugging Face 检查点 | 已发布 | 帖子 · GitHub |
| StepX Neo | @TechBuzzChina | 围绕 Step AOS 和 Amoo 智能体打造原生面向智能体的手机 | 当前手机 AI 分散在隐蔽功能和多次应用跳转中 | Step AOS、Step Amoo、Step Edge、MCP 集成 | Beta | 帖子 · 文章 |
最强的构建模式并不是“又一个聊天机器人”,而是围绕任务完成和信任搭建基础设施。Internet Court 和 GenLayer 都从同一种失效模式出发:自主系统可以谈判和执行,但仍然需要可信的争议解决方式。两者的实现方式不同:Internet Court 被定位为面向智能体的工作流界面,而 GenLayer 被定位为验证者共识加申诉机制。
第二种模式是专用本地工具。@anshuc 构建了(13 个赞,4 条回复,947 次浏览)介绍了一款以速度和任务适配性换取通用性的错别字纠正模型;NeuTTS 和 PiD 则分别为语音和图像工作流提供可复用的本地组件。StepX Neo 将这一理念延伸到了硬件:真正有意思的主张不只是“AI 手机”,而是重新构建手机操作系统,让智能体能够跨应用、文件、通信和系统工具执行操作。
反复出现的构建触发因素是摩擦,而不是新奇感。摩擦来自智能体的争议解决、面向窄任务的通用助手过于笨重,或手机 AI 仍像隐藏功能,而不是系统层。这使得今天的开发者活动显得格外务实。
6. 新动态与值得关注的内容
领域化学推理正拥有自己的编排式 LLM 技术栈
@ChineseChemSoc 分享了(5 个赞,72 次浏览)介绍了一篇关于化学知识问答和逆合成推理的论文,其具体程度高于普通的日常论文链接。论文摘要将该系统称为 ECNU-ChemGPT,采用经过提示蒸馏的化学问答数据、清洗后的 Pistachio 反应数据集,以及 BrainGPT 调度器,在不同化学任务之间进行路由;摘要还报告了其在 USPTO-50K 上 68.3% 的 Top-1 准确率。配图之所以重要,是因为它明确展示了一个将化学问答、逆合成和协调控制器结合起来的架构,而不是把化学仅仅当作另一个通用提示基准。

原生面向智能体的设备,开始被定位为系统问题,而不是应用问题
@TechBuzzChina 报道称(4 个赞,1 条回复,324 次浏览)介绍了 StepFun 发布 STEPX 品牌、Step AOS 和 Amoo 智能体。Gizmochina 报道 表示,这款手机围绕智能体操作系统、基于 MCP 的能力路由、离线任务执行和 32 种语言翻译打造。无论产品最终能否成功,值得注意的变化在于架构:其主张是,AI 应该位于设备的控制平面,而不是作为又一个助手标签页存在。
7. 机会在哪里
[+++] 智能体争议解决基础设施 — Internet Court 和 GenLayer 从不同角度切入了同一空白:一方提供托管加义务,另一方提供验证者共识加申诉。回复免费给出了产品需求:中立标准、低摩擦的小额案件处理,以及真正的执行能力,而不是仅供参考的裁决。
[+++] 以验证为先的智能体评测 — FrontierSWE、zooko 的验证标准,以及 ziv_ravid 对基于基准测试监管的批评,都指向同一个机会:将长时程任务、留出测试、部署检查和更强证明层连接起来的评测产品。开发者、买家和政策制定者都有这一需求。
[++] 面向具体工作流的专用本地 AI 组件 — 自动纠错项目、NeuTTS、PiD 和 StepX Neo 都表明,只要更快、更私密且范围清晰,用户就愿意采用更小型的本地系统。机会不在于构建一个单体式本地模型,而在于打造能够出色解决单一工作流的可组合本地组件。
[+] 面向生成式媒体的来源标识和受众控制工具 — Alvin 项目的反弹和 Viggle 内容的删除表明,披露和社区规范正成为采用障碍。让来源可见、权限明确,并能根据受众调整 AI 使用方式的工具,可能将声誉问题转化为产品功能。
8. 要点
- 验证压力增长得快于人们对基准测试的热情。 长时程 SWE 基准测试仍然活跃,但更持久的信号是:在生产环境中信任 AI 之前,人们要求测试、留出评测和类似证明的保证。@billyuchenlin 重点提到(44 个赞,4 条回复,3,446 次浏览)体现了这一变化的长时程一面。
- 智能体商业正从编排走向裁决。 今天最具特色的智能体帖子,讨论的不是如何让智能体先交流起来,而是它们发生分歧后会怎样。@lami_thefirst 描述(32 个赞,11 条回复,1,440 次浏览)指出了缺失的结算层。
- 本地 AI 正通过专业化,而不是通用化取胜。 一款纠错模型、一套端侧 TTS、一个图像解码器和一部原生面向智能体的手机,都在表达同一观点:对于合适的任务,专用本地组件可能比通用远程助手更具吸引力。@anshuc 展示了(13 个赞,4 条回复,947 次浏览)体现了最清晰的单一工作流版本。
- 公众对 AI 的反弹如今已成为产品层面的约束。 Alvin 重启项目的讨论、Viggle 内容的删除,以及对 Anthropic 安全广告的批评表明,在产品细节真正呈现之前,来源和语气就可能引发拒绝。@CultureCrave 报道称(158 个赞,24 条回复,14,724 次浏览)是当天最强的例子。
- 细分领域技术栈仍在主流消费叙事之外持续发展。 ECNU-ChemGPT 论文表明,即使更广泛的时间线讨论仍将注意力集中在智能体、基准测试和反弹上,领域化推理系统仍在通过任务路由和专用数据变得更加成熟。@ChineseChemSoc 分享了(5 个赞,72 次浏览)体现了这一信号。