Twitter AI - 2026-07-16
1. 人们在讨论什么
1.1 开放权重模型发布的评判标准,是可部署能力,而不只是规模(🡕)
2026-07-16,Twitter AI 的大量讨论集中在两个开放权重模型发布上:Kimi K3 可能成为新的编程与前端挑战者,以及 Thinking Machines 的 Inkling——一个刻意追求广泛适用、但并非“综合最强”的基础模型。重要变化在于,人们不再止步于参数量,而是不断把这些发布与具体的编程产出、产品形态、基准差距,以及大、小版本之间的权衡联系起来。
@chetaslua 报道称(553 个赞、20 条回复、52,494 次浏览)表示,在他测试过的编程和 3D 场景中,Kimi K3 达到了 Claude Fable 的水平,有时甚至更好。@VaibhavSisinty 展示(13 个赞、1,213 次浏览)进一步强化了这一点:Kimi 的发布对话称,K3 已上线,支持最高 1M 上下文 token,并重点面向编程、3D 游戏和复杂知识任务。社交平台上的热度很高,但回复也立即提出了一个保留意见:有人询问,出色的 three.js 风格效果是否真的能推广到大多数其他维度。
@rasbt 重点介绍(213 个赞、8 条回复、15,746 次浏览)关注的是 Inkling 的架构,而不只是其 headline 规模,具体提到了短卷积层、嵌入层上的 RMSNorm,以及取代 RoPE 的相对位置偏置。Inkling 官方发布 称,该模型总参数量为 975B,激活参数为 41B,上下文窗口为 1M token,经过 45T token 的多模态预训练,定位是可定制、广泛适用的基础模型,而不是在每项基准上都得分最高的模型。这种坦诚的定位也成了讨论的一部分:回复明确称赞该发布没有假装自己是综合最强模型。
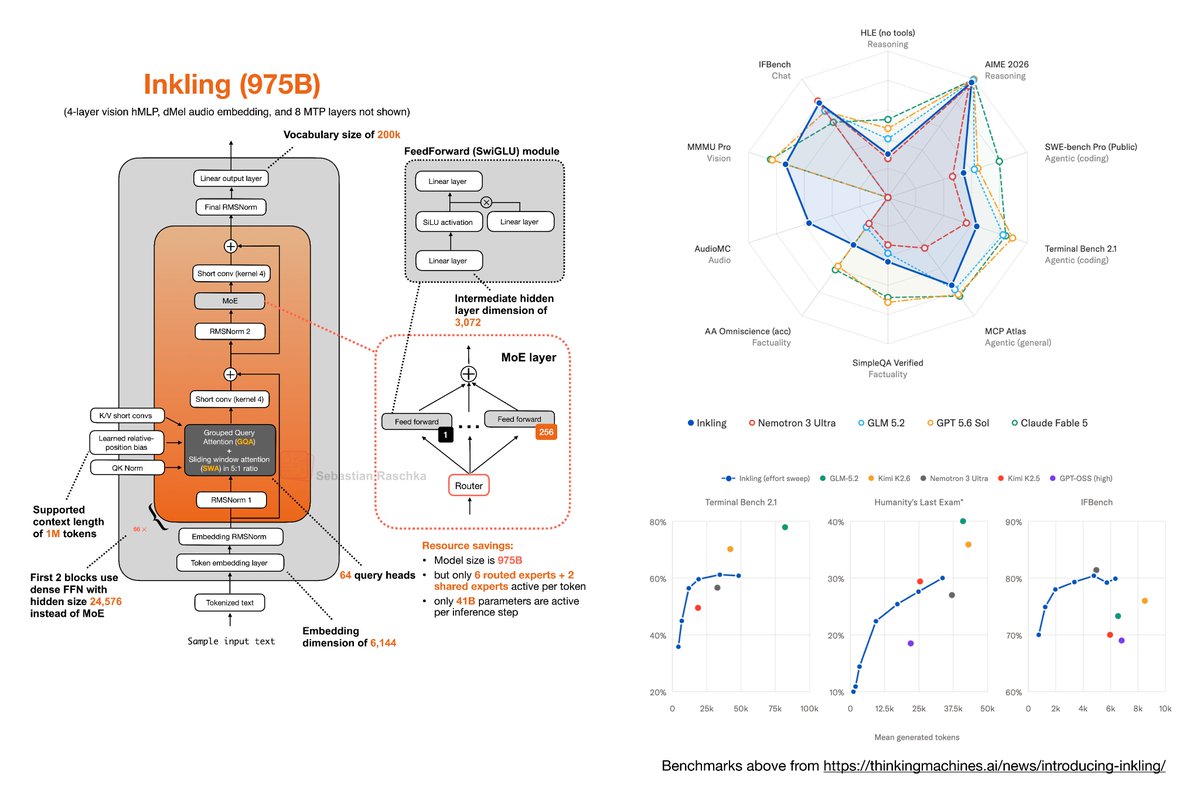
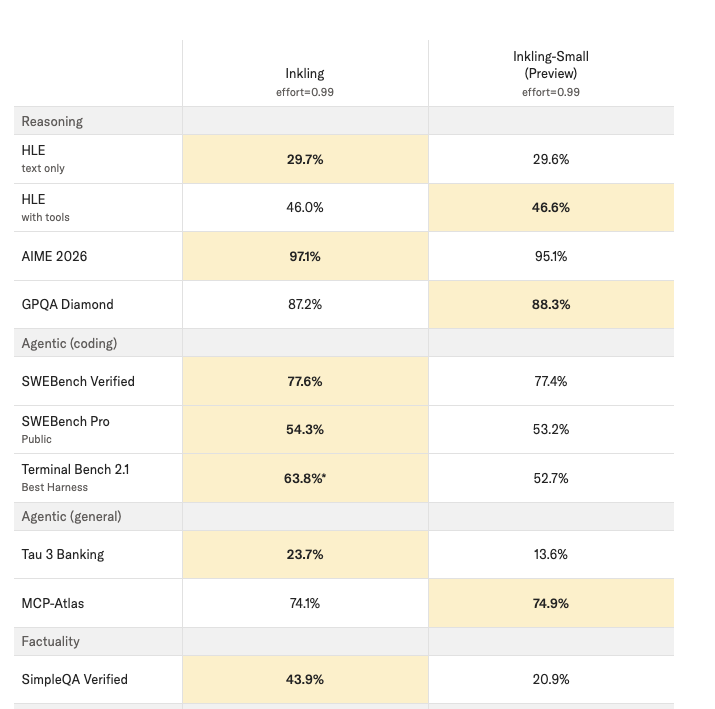
这种乐观情绪仍然有所保留。@ValsAI 报道称(12 个赞、2 条回复、736 次浏览)指出,Inkling 在开放权重类别中首次亮相时仅排名第 8;@nrehiew_ 展示了(14 个赞、2,757 次浏览)则指出,Inkling-Small 在多项推理和 SWE 行上仍接近完整版本,但在 Terminal Bench 和 SimpleQA 上的差距更大。由此,发布讨论显得更加成熟:人们开始区分“有意思的架构”“当前排行榜位置”,以及“小版本究竟保留了什么”。
讨论洞见: Kimi 的回复质疑,编程和 3D 展示中的胜出是否意味着全面领先;Inkling 的回复则追问,一个规模如此庞大的模型为何在部分公开结果中仍落后于竞争对手。共同情绪并不是怀疑开放权重本身,而是怀疑从狭窄证据片段中得出过度泛化的结论。
与前一天相比: 2026-07-15 的基准讨论主要围绕哪些证据值得信任。到了 2026-07-16,这种关注转化为发布日的实际行为:人们想看到产品形态、基准排名和明确限制,而不只是一个巨大的参数数字。
1.2 评估关注点从模型名称上移到了完整系统配置(🡕)
最具技术性的帖子把整个智能体流水线,而不是模型名称,视为优化的基本单元。成本、准确率、检索、工具使用和运行环境,都被视为需要协同选择的变量。
@diamai_ 认为(15 个赞、2 条回复、176 次浏览)提到,Melissa Pan 团队分析的一个基准成本约为 $11,000,而且几乎相同的问题可能需要完全不同的检索设置、摘要行为,甚至是否需要智能体循环。关联的 BRANE 论文 称,该系统会根据预测的正确率和成本,为每个查询路由到相应的流水线配置;在 MuSiQue、BrowseComp-Plus 和 FinanceBench 上,准确率可达到最佳固定配置的水平,同时成本最高降低 89%。这比“选择最佳模型”更进一步:真正被优化的是路由本身。
@DOE_CESER 宣布(2 个赞、1 条回复、156 次浏览)介绍了用于关键基础设施评估的 Stormbreaker。配套的 DOE CESER 文章 称,该测试平台支持配置迁移和极限发现,因此用户可以调整指令、提示词、技能、工具和环境,而不是只改变基础模型、将其他一切保持不变。文章明确将其与静态基准进行对比,称后者只会改变多个重要变量中的一个。
讨论洞见: 两项内容都指向同一个边界:团队需要的不只是更好的排行榜,还需要一种方法来决定应运行哪种配置、系统会在哪里失效,以及额外成本究竟买来了多少准确率。
与前一天相比: 2026-07-14 的报告聚焦 G-Eval、DeepEval 和盲测竞技场。2026-07-15 的报告则质疑公开基准能否继续保持可信。今天,讨论又深入了一层,把评估视为查询路由和环境测试问题。
1.3 运营层产品形态比模型新颖性更重要:搜索、记忆、语音与垂直部署(🡕)
第三组帖子关注 AI 系统实际接入工作流的地方:推荐搜索、笔记访问、实时通话和特定国家的企业部署。共同主题是范围控制:模型能搜索什么、能读取什么、响应中断有多快,以及能够针对哪个本地领域进行定制。
@alexgroberman 称(49 个赞、5 条回复、4,674 次浏览)称,一份截获的 GPT-5.6 Sol 系统提示词揭示了商业推荐是如何生成的。该讨论串的实用之处在于内容具体:如果推荐查询可能影响时间或金钱,就应触发实时网页搜索;超过一半的引用应来自广受认可的权威来源。但同一讨论串也在推销作者自己的 SEO 服务,而且一张截图显示,该服务在 ChatGPT 生成的列表中排名第一,因此其中声称的商业效果应谨慎看待。
@0xMoysei 曝光(21 个赞、8 条回复、434 次浏览)介绍了 Obsidian Headless,作为一种让智能体工具访问 vault、却不必访问整台电脑的方式。官方文档 和 代码仓库 支持了这一说法在操作层面的部分:通过 CLI 进行同步和发布、要求 Node.js 22+,并提供机器可读的 --json 输出用于自动化。与此同时,@nick_white 认为(4 个赞、1 条回复、44 次浏览)称,语音 AI 最大的瓶颈在于架构而非模型质量,并将级联式 STT → LLM → TTS 流水线与单一的 audio-to-audio 循环进行对比,后者可将工具和数据库访问保留在本地。

在 @StockMKTNewz 总结(136 个赞、5 条回复、27,181 次浏览)关于 NVIDIA 在日本部署 Nemotron 的内容中,同样出现了这种对运营层的强调。NVIDIA 官方公告 列举了 Swallow、Sarashina、ENEOS、NTT DATA,以及 Sakana AI 的 Fugu 路由平台,作为日语和行业特定适配的例子。这里的重点不是又一个通用助手,而是对金融、电信、能源和工作流编排的本地控制。
讨论洞见: 共同的设计压力是最小权限、按工作流塑形的访问方式。搜索应提取最新证据;笔记自动化应止步于 vault 边界;语音系统应压缩延迟跳转;国家级或行业部署则应让开放模型适应本地语言和监管要求。
与前一天相比: 2026-07-15 的智能体讨论强调裁决和机器可读原语。到了 2026-07-16,这些理念落到了更具体的产品形态上:推荐搜索规则、CLI 笔记访问、电话环路,以及本地化开放模型技术栈。
2. 人们感到沮丧的地方
全流水线评估的成本高到足以扭曲决策
严重程度:高。@diamai_ 表示(15 个赞、2 条回复、176 次浏览)称,Melissa Pan 团队分析一个基准的成本约为 $11,000,而相似问题可能需要不同的检索、摘要和智能体循环选择。BRANE 论文 进一步加剧了这种挫败感:如果按查询路由能够在准确率达到最佳固定配置水平的同时,最多降低 89% 的成本,那么静态调优就把大量资金白白留在了桌上。DOE CESER 介绍文章 从另一个角度明确指出了同样的痛点:静态基准只改变部署后多个重要变量中的一个。人们目前只能依靠手动路由逻辑、固定任务卡和针对特定环境的测试平台应对。之所以值得投入建设,是因为成本、信任和发布速度都被困在同一个配置问题中。
AI 搜索指导清晰可见,但独立证据薄弱
严重程度:中。@alexgroberman 称(49 个赞、5 条回复、4,674 次浏览)称,一份截获的 GPT-5.6 Sol 提示词解释了为什么一些企业会被推荐,而另一些会被忽略。其中具体的部分很有用:高风险推荐需要实时网页搜索、来源质量规则,以及严格的产品属性匹配。问题在于,同一讨论串还在销售 SEO 套餐,并展示作者自己的产品位于 AI 生成工具列表的顶部,因此,仅凭这些证据无法独立验证其中关于业务效果的因果主张。团队只能手动推断助手重视什么。之所以值得投入建设,是因为商业需求显然存在,但当前证据与宣传纠缠在一起。
语音和记忆自动化仍在架构边界处失效
严重程度:中。@nick_white 认为(4 个赞、1 条回复、44 次浏览)称,即使 Vapi、Retell、Bland 或 n8n 等封装让演示看起来很完善,大多数生产级语音智能体仍会继承 STT → LLM → TTS 模式带来的延迟跳转、脆弱的状态交接和糟糕的打断处理。在记忆方面,@0xMoysei 曝光(21 个赞、8 条回复、434 次浏览)提到 Obsidian Headless,正是因为构建者希望智能体能够操作 vault,却不必接触整台机器。应对方式是收窄架构范围:统一循环、将工具保留在本地,并减少权限。之所以值得投入建设,是因为痛点并不是缺少前沿模型,而是缺少一个能够同时保持速度和安全性的系统边界。
3. 人们希望存在的东西
面向查询级别的智能体系统控制平面
最强烈的实际需求不是又一次模型发布,而是针对具体任务决定运行哪种完整配置的方法。@diamai_ 指向(15 个赞、2 条回复、176 次浏览)说明了按查询路由的必要性,因为详尽分析的成本太高,无法靠人工反复执行;BRANE 论文 则将这一需求正式定义为成本—质量路由问题。Stormbreaker 将同样的诉求延伸到已部署环境,通过测试提示词、技能、工具和设置的边界,而不是假设某个固定基准可以代表生产环境。机会:直接。
遵循最小权限原则的智能体记忆接口
Obsidian Headless 的讨论实际上是在请求一种更安全的中间状态,介于“智能体什么都不能碰”和“智能体可以接触整台电脑”之间。@0xMoysei 希望了解(21 个赞、8 条回复、434 次浏览)希望在不扩大信任边界的情况下实现 vault 访问、同步和自动化,而 官方文档 说明了这一点为何重要:其产品形态是带有 JSON 输出的 CLI,而不是完整的 GUI 会话。其背后的情绪需求是控制——让智能体保持有用,同时让机器保持可理解、可恢复。机会:直接。
将来源规则与销售宣传区分开的 AI 搜索可观测性
尽管与商业推广纠缠在一起,截获的 GPT-5.6 Sol 提示词讨论仍提出了一个具体诉求:企业希望知道助手何时搜索、信任哪些来源、检查哪些产品属性,以及为什么一家公司会进入候选名单、另一家公司却消失。@alexgroberman 展示了(49 个赞、5 条回复、4,674 次浏览)称,人们之所以从提示词存档和截图中逆向推断这些规则,是因为手头没有更好的工具。需求务实、紧迫,而且服务提供商已经在将其商业化,这意味着即使当前证据嘈杂,这一缺口依然真实存在。机会:竞争性。
本地化、可治理的开放模型技术栈
Nemotron 在日本的讨论体现了一个更具机构性质的诉求:开放模型应能够适应本地语言、行业和治理要求,同时不必将控制权交给国外前沿 API。@StockMKTNewz 总结了(136 个赞、5 条回复、27,181 次浏览)涉及电信、金融、能源和模型路由,NVIDIA 官方公告 则将开放模型定义为各国和企业可以自行检查、适配、保护和部署的基础设施。机会:竞争性。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Kimi K3 | 开放权重 LLM | (+/-) | 1M 上下文的发布定位,编程和前端讨论热度高,具备多智能体“Swarm”定位 | 这里的大多数证据都来自发布周,且为自我报告;回复质疑了其广泛通用性 |
| Inkling | 开放权重多模态 LLM | (+/-) | 完整权重、975B/41B 激活参数设计、多模态预训练,以及明确的定制化定位 | 官方发布本身称其并非综合最强模型;第三方排名不一 |
| BRANE | 智能体配置路由器 | (+) | 按查询进行成本/质量路由,在论文中以匹配的准确率实现最高 89% 的成本降低 | 需要预先建立流水线目录,并积累经过分析的查询历史 |
| Stormbreaker | 评估测试平台 | (+) | 通过配置迁移和极限发现进行动态测试 | 面向关键基础设施设计,尚未成为通用自助式产品 |
| Obsidian Headless | 知识 / 记忆 CLI | (+) | 通过命令行同步和发布 vault,提供 JSON 输出,相比访问整台设备具有更窄的信任边界 | 需要 Node.js 22+ 和 Obsidian 账户;本身不能解决更高层的智能体编排问题 |
| 统一 audio-to-audio 环路 | 语音智能体架构 | (+/-) | 压缩 STT/LLM/TTS 跳转,将工具和数据库访问保留在本地,并支持打断处理 | 证据来自单个构建者讨论串的自我报告,而非外部基准 |
| NVIDIA Nemotron + NeMo | 开放模型定制技术栈 | (+) | 支持在日本电信、金融、能源和路由工作流中进行本地适配 | 企业集成负担仍然很高,技术栈依旧以供应商为中心 |
| 截获的 GPT-5.6 Sol 提示词操作手册 | AI 搜索 / 推荐方法 | (+/-) | 具体说明网页搜索触发条件、来源质量规则和零售约束匹配 | 基于一份截获的配置,并且嵌套在服务推广中 |
当天使用的方法大致分为两层。Kimi K3 和 Inkling 提供了模型层,但 BRANE、Stormbreaker、Obsidian Headless 和统一语音环路提供了控制层,决定这些模型如何被路由、测试、限定范围并呈现出来。即便是 AI 搜索讨论,本质上也是控制层故事:重点不是“哪个模型最聪明”,而是“它会搜索、信任和引用哪些证据”。
最大的迁移趋势,是离开单模型思维。数据集反复偏好那些围绕模型收窄或重塑工作流的方法——按查询路由、针对特定环境进行测试、仅访问 vault、在本地执行工具,或进行行业特定定制。当工具明确了这些边界时,满意度会上升;当其主张陷入发布炒作或推广时,满意度则会下降。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Inkling | Thinking Machines | 发布用于定制和微调的多模态开放权重基础模型 | 团队需要能够自行适配的广泛基础模型,而不是只能通过 API 使用的模型 | 975B MoE、41B 激活参数、1M 上下文、Tinker 微调 | 已发布 | 官方发布 |
| Obsidian Headless | Obsidian | 无需桌面应用即可通过命令行同步和发布 vault | 让自动化工具和智能体受控地访问笔记,而不是访问整台设备 | Node.js 22+、npm CLI、Obsidian Sync/Publish、JSON 输出 | 已发布 | GitHub, 文档 |
| BRANE | Melissa Z. Pan et al. | 将每个查询路由到最有可能达到准确率目标的最低成本检索—智能体配置 | 静态的一刀切流水线调优浪费资金,也忽略了查询之间的差异 | LLM 派生的查询特征,加上逐配置预测器 | Alpha | 论文 |
| Stormbreaker | DOE CESER + LLNL | 在电力系统和 OT 环境中动态测试 LLM 和智能体 AI | 静态基准无法发现真实运营环境中的稳健性边界 | Mjölnir 扩展、配置迁移、极限发现 | Alpha | 文章 |
| 基于 Nemotron 的日本部署 | NVIDIA 与 Swallow、Sarashina、ENEOS、NTT DATA、Sakana AI 等 | 为日语和行业特定工作流本地化开放模型 | 需要可治理的国家级和行业 AI,而不是通用的全球助手 | Nemotron、NeMo、Megatron-LM、Agent Toolkit、Fugu 路由 | 已发布 | 官方公告 |
当天的构建模式主要是围绕模型搭建支撑设施,而不是再造一个通用聊天机器人。Inkling 和 Nemotron 提供可适配的基础模型;BRANE 和 Stormbreaker 决定这些系统应如何路由或测试;Obsidian Headless 则收窄智能体能够接触的记忆表面。这比“发布一个更聪明的助手”更偏向实际运营。
在这里的公开证据中,Kimi K3 引发的兴奋多于文档。相比之下,参与度较低的 BRANE、Stormbreaker 和 Obsidian Headless,反而提供了最清晰的实现细节。反复推动人们构建产品的,并不是原始模型能力不足,而是缺乏成本控制、真实的评估环境或安全的工作流边界。
6. 新鲜且值得关注的动态
Dugout AI 的使用规模大到 MLB 不得不出手制止
@UnderdogMLB 报道称(268 个赞、26 条回复、32,719 次浏览)称,MLB 实际上已经禁止使用联盟提供的休息区 iPad 在比赛期间访问生成式 AI 以辅助策略制定;@TheAthletic 另行发布(46 个赞、5 条回复、26,537 次浏览)也提到了同一轮整治。这一点很重要,因为它提供了异常具体的证据,表明生成式 AI 已经从办公室试验进入职业体育中的实时运营决策支持,而联盟治理也立即作出了反应。
Inkling-Small 在多项推理指标上接近大模型
@nrehiew_ 展示了(14 个赞、2,757 次浏览)展示了一张对比表:Inkling-Small 在 HLE、AIME 2026、GPQA Diamond、SWE-Bench Verified/Pro 和 MCP-Atlas 上接近完整 Inkling,但在 Terminal Bench 和 SimpleQA 上的差距更大。这一点值得关注,因为它把“小模型正在追赶”这一模糊感受转化为更具体的判断:部分推理和编程能力能够被有效压缩,而长尾检索和工具密集型任务似乎仍需要更大的容量。
7. 机会在哪里
[+++] 查询级评估与路由控制平面 —— BRANE 和 Stormbreaker 从不同方向处理同一个问题:前者选择最有可能达标的最低成本配置,后者寻找已部署配置会在哪里失效。这一机会很强,因为它同时得到第 1 节的配置主题、第 2 节对基准成本的挫败感,以及第 5 节最具体的构建成果支持。
[++] 遵循最小权限原则的智能体记忆与接口边界 —— Obsidian Headless 和统一语音环路图都把系统范围本身视为产品:智能体能读取什么、工具在哪里运行,以及它需要接触机器或技术栈的多大范围。证据表明,市场确实需要既保持实用,又具备速度、范围控制和可恢复性的智能体。
[++] 独立的 AI 搜索可观测性 —— 截获的 GPT-5.6 Sol 提示词为运营者提供了足够的信息,让他们知道应该优化什么——最新信息、权威来源、完整产品属性——但没有提供足够的中立证据,无法判断某项声称的优化是否真的有效。机会在于,将提示词传闻和截图转化为可审计的引用、排名和转化轨迹。
[+] 本地化开放模型部署项目 —— Nemotron 在日本的部署,以及当天围绕 Kimi 和 Inkling 的关注,都显示出市场对能够适应本地语言、政策和工作流约束的模型存在需求。这一机会真实存在,但与上述控制层缺口相比,它所需资本更多,竞争也更激烈。
8. 要点
- 开放权重模型发布被当作产品来评估,而不是抽象的研究事件。 Kimi K3 的讨论围绕编程产出、上下文长度和发布形态展开;Inkling 的讨论则围绕架构、基准排名和定制范围展开。(来源)
- 成本前沿已经从模型定价转向流水线配置。 BRANE 的按查询路由主张和 Stormbreaker 的动态环境测试都表明,代价高昂的错误,是过早固定某一种配置。(来源)
- 智能体正在获得更窄的信任边界,而不是更宽泛的全局访问权限。 Obsidian Headless 明确限定了仅访问 vault 的自动化方式;语音环路帖子则将工具和数据保留在本地,以减少延迟和状态断裂。(来源)
- 国家和行业特定的 AI 技术栈正成为具体的部署方向。 Nemotron 在日本的发布将开放模型与电信、金融、能源和路由工作流联系起来,而不是再次推出一个通用助手。(来源)
- 运营层面的采用已经强到足以触发政策反应。 MLB 对休息区使用的限制表明,生成式 AI 已不再只是办公室生产力话题;它已经进入实时、高风险的决策环境。(来源)