Twitter AI - 2026-07-19
1. 人们在讨论什么
1.1 开放权重模型的能力主张,引发了更强烈的独立范围核查需求(🡕)
Kimi K3 仍是当天最受关注的模型话题,但真正有价值的讨论并不是一场干净利落的“胜利巡礼”。高互动帖子将其定位为前沿的开放权重安全模型;与此同时,业内人士则指出,在狭窄领域或创意前端任务中的出色表现,不应被泛化为整体领先。
@rauchg 报道称(1,549 个赞、57 条回复、161,537 次浏览)介绍了一组内部评测:Kimi K3 在网络安全方面属于“第一梯队”,Sol 更强但价格更高,而 Fable 则拒绝完成测试。回复进一步收窄了这一说法:一位评论者表示,在更广泛的推理基准上,K3 仍落后于 Sol 和 Fable;另一位则质疑帖中的价格比较,因为 token 用量会改变成本。
@stalkermustang 反驳称(46 个赞、9 条回复、8,849 次浏览)发布了一篇回顾性汇总,称此前中国模型在发布时的对比优势,在后续发布的基准测试中有所减弱。作者并未否定 K3,而是将其在 three.js 风格前端和简单网页游戏方面的潜在优势,与更广泛的编程能力区分开来;图表是作者自行汇总的内容,并非独立发布的基准测试。


@CommandCodeAI 分享了(1 个赞、127 次浏览)展示了一项公开的 Kimi K3 设计对比。其链接的 基准测试产物 记录了一次使用三个提示词生成 Tailwind/Three.js 落地页的运行,输出共 1,168 行,估算单次会话成本为 $0.77,并明确说明这不是按实际计量得出的账单。这是一次有价值的可复现尝试,但仍属于狭窄测试,而非全面排名。
讨论洞察: 最重要的纠偏在于明确边界:安全表现、前端生成、广泛推理、token 用量和模型拒答,衡量的是不同维度。
与前一天对比: 7 月 18 日的讨论已经出现异常高的 Kimi 和基准测试相关热度。到了 7 月 19 日,关注点从发布定位转向:这些公开演示和内部测试,在更广泛评估后是否仍然成立。
1.2 使用信号让性价比和供应商选择与排行榜并列受关注(🡕)
@KobeissiLetter 表示(955 个赞、123 条回复、137,486 次浏览)称,中国模型约占美国企业在 OpenRouter 上所用 token 的 58%,而 7 月初曾短暂达到 63% 的峰值。该帖子将其描述为相较 2025 年初不足 10% 的显著变化;回复反复将这一趋势归因于性价比,但有一条回复正确指出,OpenRouter 不包含直接通过供应商产生的流量,因此不能代表 AI 总支出。

因此,这确实是一个真实的采用信号,但并非完整的市场份额测量。图表及其限定条件说明了一个实际问题:多供应商路由层可以揭示快速切换,却无法仅凭自身确定整个市场的使用情况。
1.3 AI 工程讨论集中在路由、验证和发布控制上(🡕)
@adxtyahq 介绍了(59 个赞、14 条回复、3,597 次浏览)介绍了一款网站构建产品如何将报告中的平均 LLM 成本从约 $3-4 降至每次提示 $1-1.50;而在最初设计阶段,这一成本一度接近 $5。该自述系统基于 Vercel AI SDK 实现自定义编排:先判断请求复杂度,再将工作拆分为功能,逐文件验证并重新生成,进行模型路由,同时只加载相关上下文。回复提出了关键警告:错误分类和高昂的重试成本,可能抵消表面上的路由节省。
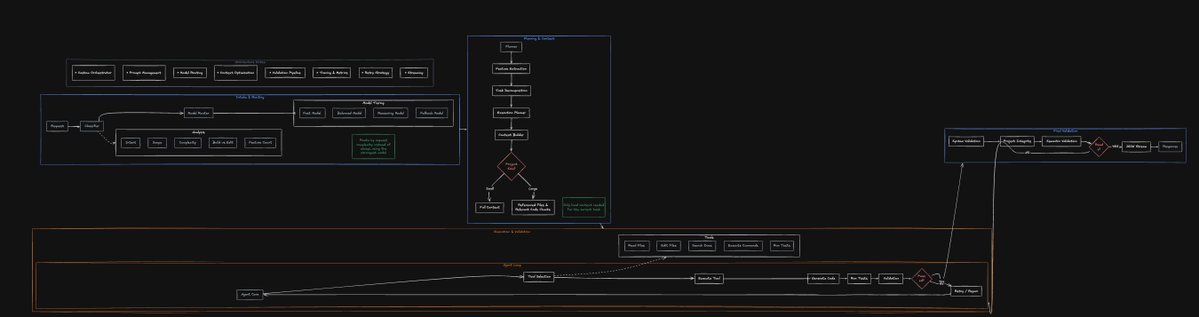
@dosco 构建了(16 个赞、1,067 次浏览)介绍了一个基于 DSPy/Ax 的推理路由器:它从能够通过评测的最低成本模式中学习,并调整推理预算、自洽性宽度以及是否进行 refinement。@shivam74689 记录了(57 个赞、3 条回复、1,458 次浏览)介绍了一条 CI/CD 流水线,将 AI 评测、延迟、成本、幻觉、工具使用、健康检查、回滚和可观测性设为发布标准,而不是事后补充。

讨论洞察: 成本路由讨论揭示了一种张力,而 CI/CD 帖子则把它落地为实践:只有在验证机制能在发布前捕获分类错误和输出质量下降时,更便宜的路径才真正有用。
与前一天对比: 此前的报告强调了配置感知评测。今天的案例则把它具体化为按请求路由、按功能验证、评测门禁、回滚和监控。
2. 人们感到不满的地方
评测主张超出了自身范围
严重程度:高。K3 的讨论说明,为什么发布当天的断言仍然难以直接用于决策。@rauchg 分享了(1,549 个赞、57 条回复、161,537 次浏览)展示了有利的内部网络安全结果,但回复质疑其更广泛的推理性能、成本核算和部署防护措施。@stalkermustang 认为(46 个赞、9 条回复、8,849 次浏览)指出,发布后的基准测试可能推翻最初的比较结果。两篇帖子都不是独立的评测发布,而这正是团队决定部署什么时面临的问题。
常见应对方式是发布公开、范围狭窄且可复现的产物,例如 Command Code 的 Kimi K3 设计运行,但这仍意味着团队必须针对真实任务类型自行拼接覆盖范围。这值得围绕其建设:模型比较需要明确工作负载、成本假设,并清楚区分演示与一般能力主张。
低成本路由可能因重试和错误分类而失效
严重程度:中。@adxtyahq 报道称(59 个赞、14 条回复、3,597 次浏览)介绍了一次艰难的迭代:通过路由、验证和上下文选择,将每次提示的成本从接近 $5 降至 $1-1.50,并明确归因于这些措施,而非简单修改提示词。回复指出了运营风险:如果将复杂请求送入廉价路径,触发多次重试,节省的成本就会消失。帖子的答案是加强流水线控制——分类、分块生成、验证并循环处理——但这也增加了实现复杂度。
有用但不完整的采用数据
严重程度:中。@KobeissiLetter 使用了(955 个赞、123 条回复、137,486 次浏览)使用 OpenRouter 活动来描述美国企业对中国模型使用情况的变化。图片本身说明,数据排除了直接流量,只覆盖总消费量的一部分;一条回复也提出了同样的代表性问题。团队可以观察路由层上的切换,却不能据此推断完整市场。这值得围绕供应商中立的采用与成本可观测性来建设,并明确覆盖边界。
3. 人们希望存在什么
保留任务和成本上下文的可比评测
人们直接需要的是这样的证据:模型完成了什么任务、在哪个任务上完成、成本是多少,以及结果在哪些地方不应继续泛化。@stalkermustang 询问(46 个赞、9 条回复、8,849 次浏览)讨论 K3 是否会重现此前从发布表现到后续基准测试的落差;@CommandCodeAI 发布了(1 个赞、127 次浏览)则是一项规模较小、可供检查的设计基准。后者是对前者的部分回应:公开产物和方法,但要把覆盖范围扩展到单一设计任务之外。机会:直接。
优化有效输出,而非廉价首次尝试的路由控制
@adxtyahq 介绍了(59 个赞、14 条回复、3,597 次浏览)展示了这一需求的实际形态:对工作进行分类、选择模型路径、逐项验证功能并控制上下文。@dosco 实现了(16 个赞、1,067 次浏览)介绍了一个由评测驱动的路由器,用于选择最可能通过评测的最低成本推理配置。尚未解决的缺口是一个控制平面:能够展示路由选择、重试成本、质量门禁,以及某条路径失败的原因。机会:直接。
保留同意权的社区记忆
@sascha_daemgen 宣布(4 个赞、212 次浏览)介绍了 Cinderella,这是一个面向公开 SimpleX 社区的 alpha 归档工具,社区和每位成员都必须选择加入。其 仓库 记录了内容抓取、PostgreSQL 持久化、同意门禁、管理后台基础功能,以及后续的公开嵌入和审核工作。实际需求并不是泛化的聊天摘要,而是支持搜索的集体记忆,并且成员同意可以撤回。机会:竞争性。
4. 正在使用的工具和方法
| 工具 | 类别 | 评价 | 优势 | 局限 |
|---|---|---|---|---|
| Kimi K3 | 开放权重 LLM | (+/-) | 网络安全和前端方面的主张很强;讨论度高 | 证据主要来自内部测试、自报结果或特定任务;回复质疑其泛化能力和价格 |
| OpenRouter | 多供应商模型路由器 | (+/-) | 能揭示经路由后的 token 份额切换,并支持用户比较供应商 | 其流量明确无法覆盖完整市场 |
| Vercel AI SDK | AI 应用框架 | (+) | 可作为自定义路由、追踪、提示词、评测和上下文控制的基础 | 据报告,该实现为获得更强控制而绕过了 LangChain 和 LangSmith,意味着需要在基础 SDK 之外进行额外工作 |
| DSPy + Ax | 提示词/程序优化 | (+) | 支持由评测驱动的推理路由器和可配置的工作量 | 仅有一位构建者的实现;未提供公开的汇总结果 |
| Docker + GitHub Actions | 交付 / CI/CD | (+) | 将测试、AI 评测、镜像、部署、健康检查、回滚和监控连接起来 | 流水线质量仍取决于其拥有的测试和评测数据 |
| Cinderella | 同意优先的社区归档 | (+) | 提供明确的成员级发布控制、可搜索存储,并记录了 TypeScript/Node.js 和 PostgreSQL 技术栈 | 公开嵌入和审核仍在规划中 |
最强的满意度信号来自那些让隐藏的系统选择变得可观察的方法:在选择模型前判断路由复杂度,在生成前拆分工作,将评测作为门禁,并在发布后进行监控。@adxtyahq 报道称(59 个赞、14 条回复、3,597 次浏览)介绍了如何从 LangChain 和 LangSmith 迁移到 Vercel AI SDK 上的自定义控制;给出的理由是更紧密地控制执行流程,而不是声称这些工具无法正常工作。
因此,当天的竞争焦点与其说是“最好的单一模型”,不如说是谁能围绕模型完成路由、验证、观测和撤销访问。最明确的警示是:路由质量和市场使用数据,都取决于其测量范围的边界。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Cinderella | @sascha_daemgen | 将选择加入的公开 SimpleX 社区内容归档为可搜索记录 | 在不公开未同意成员内容的前提下,保留有价值的公共社区知识 | TypeScript、Node.js、SimpleX SDK、PostgreSQL、文件系统媒体 | Alpha | GitHub |
| Kimi K3 设计展示 | @CommandCodeAI | 发布可复现的单提示词设计对比 | 让构建者能够检查具体的开放模型前端结果,而不只是看到一项主张 | Command Code /design、Kimi K3、Tailwind CSS、Three.js |
已发布 | 基准测试 |
| 评测驱动的推理路由器 | @dosco | 选择最可能通过评测的最低成本推理配置 | 避免每个请求都使用高工作量推理 | DSPy、Ax、GEPA | Alpha | 未提供公开项目 URL |
| AI CI/CD 流水线 | @shivam74689 | 以软件测试、AI 评测、健康检查和回滚作为部署门禁 | 在发布前或发布后发现行为、延迟、成本、幻觉和工具使用方面的回归 | GitHub Actions、Docker、评测、可观测性 | Alpha | 未提供公开项目 URL |
Cinderella 是文档最完整的构建项目:其代码仓库显示,核心消息/文件抓取、PostgreSQL 持久化、同意门禁和管理后台基础功能已经完成,而公开嵌入和审核被推迟。设计展示则体现了另一种构建者信号:它让范围明确的基准测试可供检查,并披露成本是估算值。
反复出现的构建模式,是围绕生成过程加强控制。路由器根据评测结果调整推理工作量,CI/CD 示例则将模型行为纳入部署门禁。两者都在应对同一种失败模式:应用可以正常运行,却可能成本过高或持续生成无效输出。
6. 新出现及值得关注的内容
针对酶的基础模型进入了具体的发现流程
@BiologyAIDaily 强调了(23 个赞、1 条回复、1,232 次浏览)介绍了 EnzGFM,称其为一种 Mamba-Transformer 蛋白语言模型,先在通用蛋白质序列上训练,再在酶数据上训练。帖子称,其 EnzGFM-Agent 会优先筛选诱变候选,并附上代码和论文链接;值得关注之处在于,它将酶表示模型连接到具体的筛选和变体选择流程,而不是停留在排行榜主张上。
本地 AI 硬件营销引发了对内存容量的纠正
@RetroChainer 警告称(26 个赞、6 条回复、1,450 次浏览)指出,一款售价 $70、面向本地 LLM 的 Raspberry Pi 套件使用了面向视觉任务的 Hailo-8L,且没有专用内存;帖子同时指出,价格更高的 Hailo-10H 主板也只能运行非常小的模型。帖子的实用贡献是一条购买判断标准:TOPS 本身无法证明设备适合运行 LLM,模型大小和可用内存同样重要。
7. 机会在哪里
[+++] 可复现、关注成本的模型评测 —— K3 的广泛能力叙事、回顾性基准反例,以及公开但范围狭窄的 Command Code 产物,都显示出市场对这类比较的需求:披露任务覆盖范围、推理配置和成本。该机会之所以强,是因为发布支持者和怀疑者都在要求更具体的证据。
[++] 面向 AI 应用的验证式路由和发布控制 —— 降本架构、DSPy/Ax 路由器和 AI CI/CD 工作流,都将路由、评测、回滚和可观测性置于关键路径上。机会中等偏强:证据来自具体实现,但报告结果大多来自单个构建者的叙述。
[++] 具备同意机制的社区知识系统 —— Cinderella 按社区和成员分别选择加入的发布设计,处理了一项明确的权衡:在不默认把私人参与变成档案的情况下,保留公开对话。已有文档记录的技术栈和 alpha 状态,使其不只是一个想法;公开嵌入和审核功能则为竞争者留下了空间。
[+] 供应商中立的采用情报 —— OpenRouter 展示的 token 构成,引发了围绕性价比切换的大规模讨论,同时评论者也强调了其市场覆盖不完整。若有一种测量产品能够明确展示覆盖范围、直接流量、单位成本和工作负载构成,就能弥补这一局限。
8. 要点
- Kimi K3 的故事,既关乎能力,也关乎验证边界。 高互动的内部网络安全主张,立即被关于更广泛推理能力、由 token 用量决定的成本以及安全性的回复所限定;另一篇回顾性文章则反对从狭窄优势推导出全面结论。@rauchg 报道称(1,549 个赞、57 条回复、161,537 次浏览)。
- 经路由的使用情况,是供应商切换的重要但不完整信号。 OpenRouter 图表显示,中国模型约占美国企业使用量的 58%;但图表自身的说明和回复都限制了这一数据对总消费量的解释范围。@KobeissiLetter 表示(955 个赞、123 条回复、137,486 次浏览)。
- 构建者正将路由和验证视为产品架构。 一个网站构建产品案例将报告中的成本下降归因于分类、按功能生成、验证和选择性加载上下文;另一个构建者则开发了一个路由器,学习能够通过评测的最低成本模式。@adxtyahq 介绍了(59 个赞、14 条回复、3,597 次浏览)。
- AI 发布流程正在超越软件测试。 CI/CD 示例明确纳入了针对质量、延迟、成本、幻觉和工具使用的评测,以及健康检查、回滚和监控。@shivam74689 记录了(57 个赞、3 条回复、1,458 次浏览)。
- 实用的 AI 记忆产品可以将同意机制设为核心数据模型约束。 Cinderella 的 alpha 设计会在公开归档前记录成员的选择加入决定,并在其代码仓库中记录这一模型。@sascha_daemgen 宣布(4 个赞、212 次浏览)。