Twitter AI - 2026-07-29
1. 大家在讨论什么
1.1 Agent 正被打包成工作空间,而不是聊天窗口(🡕)
今天信号最强的 agent 帖子,讨论重点不是模型本身的 IQ 有多高,而是界面和工作流该长什么样。它们共同传达的承诺是:agent 应该能够掌握上下文、构建软件、发布成果,并在跨会话过程中持续保留知识。共有四条不同内容支撑了这一主题,范围从替代团队聊天工具,到可复用的 agent 技能。
@gregisenberg 认为(214 次点赞,20 条回复,24,680 次浏览,375 次收藏)表示,Jack Dorsey 的 Buzz 很可能成为“Slack 杀手”,因为它结合了模型切换、实时语音小组讨论、由 agent 构建应用、把实时应用数据回流给 agent 的上下文闭环,甚至还支持共享本地算力,让多人分摊一台运行本地模型的机器。他同时也有所保留,称它仍是“alpha software”,而且“有些地方很慢”,这反而让这份热情显得比泛泛而谈的炒作更具体。
@JayminSOfficial 将其描述为(248 次点赞,27,858 次浏览,47 次收藏)将 Grok 的新 Build Mode 视为一种转向:从向 AI 要答案,转为让它直接创造产品。xAI 的 发布页面 表示,Build Mode 现在可以在聊天中实时创建可运行的网站、应用、游戏和仪表盘,并发布到可分享链接或自定义域名上,不过目前仍处于 Early Beta 阶段,仅限 SuperGrok Heavy 用户使用。
@pirroh 表示(64 次点赞,11 条回复,21,013 次浏览,13 次收藏)称,Replit 现在会基于内部基准测试,用推荐版本和投入强度等级来隐藏模型选择,让用户专注于“Outcome-Maxxing”。最有力的一条回复立刻要求在选择时显示 token 成本,这说明“把模型抽象掉”很有吸引力——直到预算变得重要为止。
@RituWithAI 重点介绍了(8 次点赞,3 条回复,166 次浏览,6 次收藏)book-to-skill,这是一个小型开源工具,可将书籍、PDF、EPUB、markdown 文件或抓取的网站转成可复用的 SKILL.md,供 Claude Code、Cursor 或 Codex 使用。这条帖子的互动不高,但它贡献了一种鲜明的构建模式:不只是今天给 agent 更多上下文,而是把外部知识打包起来,让同样的上下文在明天也能复用。
讨论洞察: 回复并没有否定这些产品;他们追问的是摩擦成本。Buzz 连支持者都承认它还很早期,而且速度偏慢;而 Replit 那条最明确的回复,要求的也不是更高的自主性,而是明确展示 token 成本。
与前一天相比: 7 月 28 日的 Twitter AI 报告仍主要被模型发布、基准之争和政策争论主导。到了 7 月 29 日,焦点又向工作流推进了一层:上下文闭环、发布、技能打包,以及模型选择 UI,都成了产品层面的核心表面。
1.2 成本感知的路由与采购,正在取代单纯炫耀基准成绩(🡕)
这批内容里最强的运营者信号,不是“哪个模型赢了”,而是“跑起来要多少钱,以及我能不能在不重写整套栈的情况下切换模型?”就在 OpenAI 宣传其内部效率提升的同一天,独立开发者推出了路由工具,并指出许多 agent 基准一旦把价格作为显性因素摆出来,就会站不住脚。
@OpenAIDevs 报道称(421 次点赞,30 条回复,17,975 次浏览,34 次收藏)称,GPT-5.6 Sol 已被用于 Codex 内部,以优化其自身基础设施。所引用的 OpenAI 原文让这一说法更具体:通过生产环境 GPU kernel 改进,服务成本降低了 20%;通过改进 speculative decoding,token 生成效率提升了 15% 以上。热门回复并未质疑这一方向;他们问的是,“更有用的工作”究竟指什么,以及为什么用户还没有直接感受到这些改进。
@ahmetb 发布了(56 次点赞,8 条回复,5,801 次浏览,43 次收藏)baseten-switch,这是一个本地网关,可在保持 harness 不变的情况下,把 Claude Code 和 Codex 的请求分流到 Kimi K3、GLM 5.2 等模型。公开的 README 将其描述为一款 beta 版 macOS 应用/网关,而下方截图也解释了它为何引发共鸣:一个窗口里集中展示了实时请求路径、按客户端划分的模型映射、流量视图、请求日志以及就绪状态。
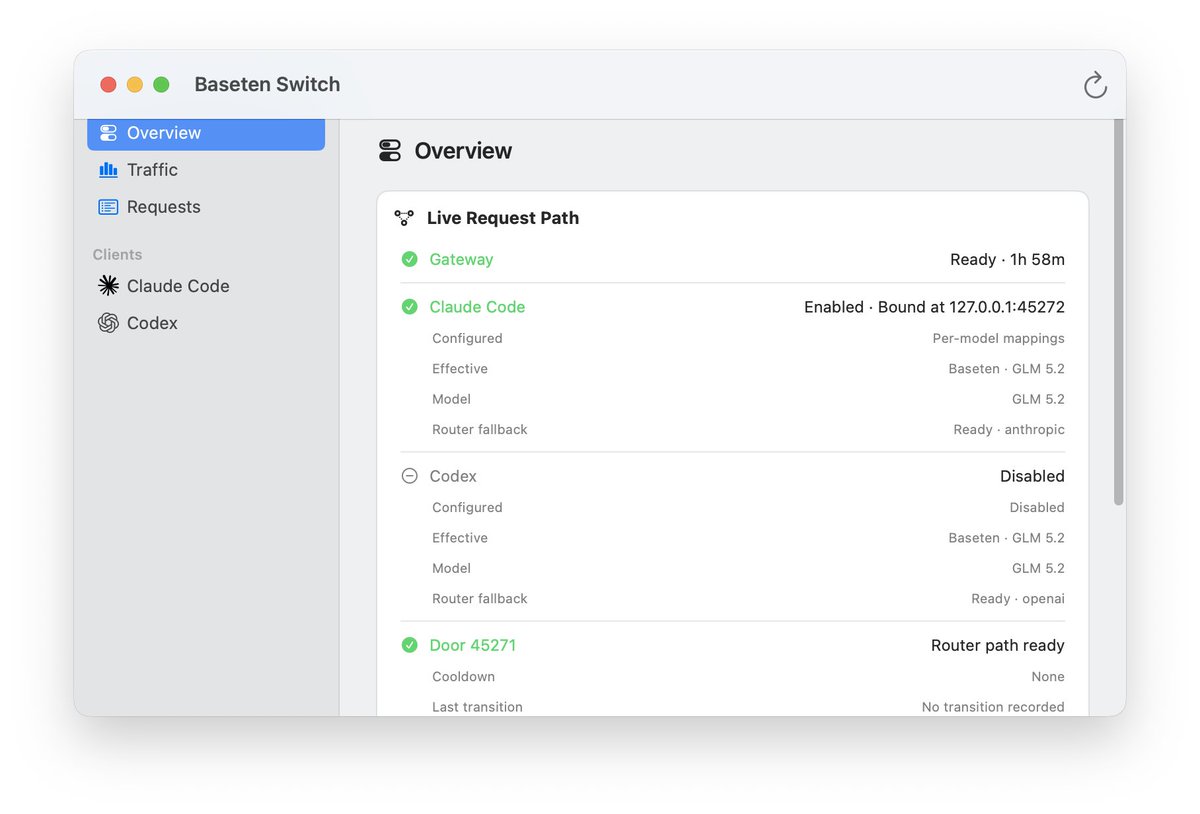
@lagerskoy 认为(20 次点赞,114 次浏览,14 次收藏)称,一旦把成本作为一级指标纳入,coding-agent 论文看起来就没那么亮眼了:在他引用的比较中,最昂贵的架构成本比一个 retry loop 高出 50 倍以上,但准确率并没有显著提升;17 个 agent 基准中有 12 个未通过恰当的 holdout 标准。这比泛泛而谈“基准不靠谱”更尖锐;它指出,被掩盖的不只是价格,还有实验设计本身。@neil_xbt 总结称(50 次点赞、11 条回复、2,616 次浏览)最直接点出了采购这一维度:当智能体一跑就是几小时,而不是按轮次交互时,“每美元知识量”如今比基准测试分数更重要。他在回复中又从另一个角度表达了同样的判断:真正的买方,已经从挑选赢家的研究人员,转向了管理持续成本曲线的运营者。
讨论洞察: 围绕路由和选择的讨论偏重实务,而非哲学层面:用户在问授权、缓存命中率,以及 UI 是否应展示 token 成本。眼下的摩擦点已不再是“模型能不能做到”,而是“模型做到之后,团队能否看清并管住这笔账单”。
与前一天对比: 7 月 28 日对基准测试的怀疑,主要集中在公开测试是否与实际上手表现一致。到 7 月 29 日,讨论已经转向生产环境中的财务问题:路由层、支出视图、重试基线,以及按工作量计成本的框架。
1.3 开源推动力分化为可部署的语音、视觉和 CPU 优先组件(🡕)
开放权重的重点,不再是某个庞大的旗舰模型,而是那些真正能交付上线的较小组件。当日帖子主要集中在端侧视觉、开放语音基础设施,以及能够降低硬件要求的压缩 ASR。
@qvac 推出了(61 次点赞、6 条回复、460,506 次浏览、12 次收藏)提到 VisionPsy-Nano:这是一个 4.6 亿参数的视觉语言模型,小到可以在手机上运行,采用 Apache 2.0 开放权重,并声称在 17 项基准测试中的 16 项上优于其他约 0.5B 级模型。关联的 Hugging Face 博客 补充了更有价值的部署细节:Flash 变体在保留约 99% 完整模型质量的同时,在 Pixel 和 Galaxy 手机上实现首 token 生成速度约快于部分同类模型 19–23 倍,在 iPhone 15 上最高可快 36 倍。随即就有回复要求给出以毫秒计的真实延迟,并披露 SigLIP 编码器成本——这正是如今边缘模型发布所面临的那类审视。

@JayminSOfficial 表示(223 次点赞、22,025 次浏览、39 次收藏)表明,Fish Audio 的 S2.1 Pro 展示了“开源作为增长引擎”这套打法正在向企业语音 AI 延伸。同日另一张由 @DataChaz 展示了(21 次点赞、3 条回复、607 次浏览)分享的图表显示,Fish Audio S2 Pro 在可见对比集中的 Bradley-Terry 得分最高,达到 3.07,高于 ElevenLabs V3 的 1.80 和更早的 Fish Audio S1 的 1.86,进一步印证了这次发布对质量的主张,而不只是价格优势。
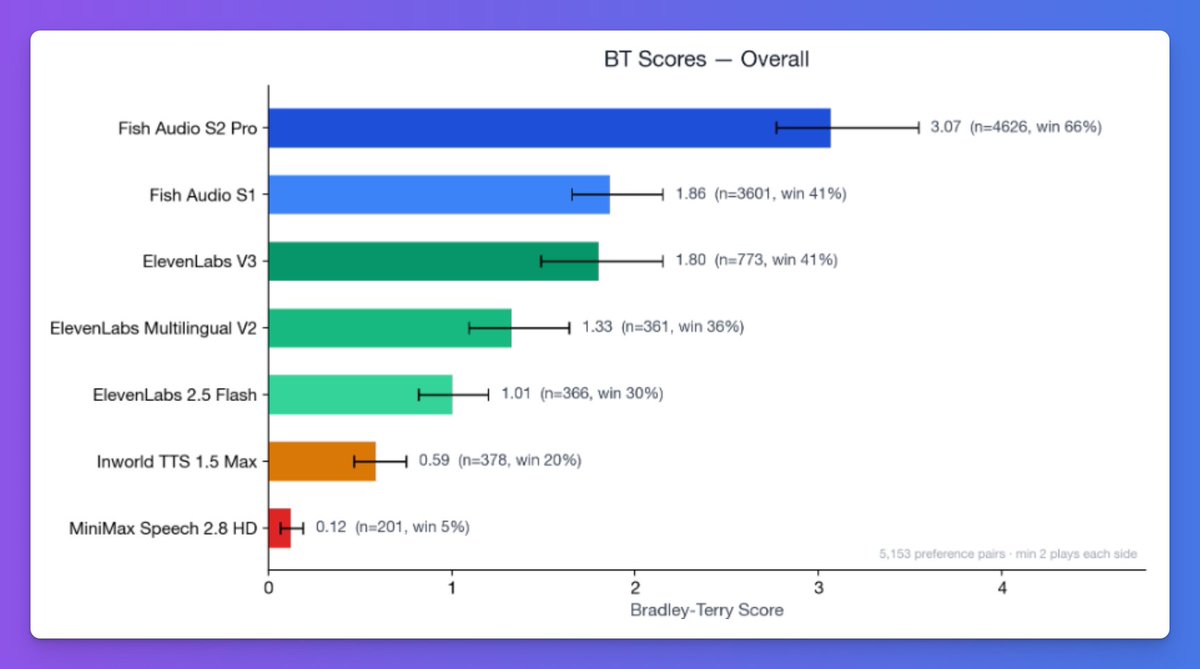
@HuggingApps 重点介绍了(24 次点赞、2 条回复、1,055 次浏览、24 次收藏)提到 Microsoft 的 VibeVoice-ASR-BitNet,将其描述为一个面向实时 CPU 推理构建的 1.58-bit 多语言转录模型。关联的 Hugging Face Space 则把定位说得很明确:“仅用 CPU 的多语言 ASR,配备 1.58-bit BitNet 解码器。”
@onton_ai 宣布(28 次点赞、13 条回复、1,474 次浏览、15 次收藏)将 Ontology 1 称为“搜索的下一代架构”。Onton 公开的 基准测试页面 表示,该系统在 90 个意图密集型电商查询中,有 52 个实现了明确胜出;尽管其索引的商品目录仅相当于 Google Shopping 和 Amazon 的 1%,但 top-10 准确率仍达到 63.0%,而 Google Shopping 为 54.3%,Amazon 为 46.9%。这代表了一条不同于通用前沿模型的 AI 杠杆路径:范围更聚焦、问题定义更精准,评估也更贴近特定领域。
讨论洞察: 对这些发布最尖锐的回应并不是反开源,而是要求可复现性和部署现实性:真实的手机延迟、真实的编码器成本,以及可观察到的质量差异,而不是停留在品牌层面的宣称。与前一天相比: 7 月 28 日开放权重的主线叙事,仍围绕 Kimi K3 这一个前沿事件展开。到了 7 月 29 日,同样的势头已扩散到可部署组件:手机 VLM、CPU ASR、开放语音栈,以及垂直搜索系统。
1.4 前沿治理从抽象的安全话术进入华盛顿政策流程(🡕)
当天的政策讨论,关注点不再是泛泛而谈的 AI 安全立场,而是具体的联邦层面时机:模型预览、行政分支流程,以及圈内人士公开提出的“控制前沿节奏”请求。
@imjustnewatai 认为(77 次点赞,6 条回复,6,832 次浏览,22 次收藏)表示,Sam Altman 此次赴华盛顿之所以重要,是因为他称 OpenAI 到 DC 是为了预览一款新模型,同时也认同《Pacing the Frontier》信中的许多原则。链接材料让这条帖子不止于猜测:Pacing the Frontier 网站明确呼吁政府协助开发必要的技术与治理工具,以便有意识地为整个前沿自动化 AI 的发展控速;而回复中还链接了 白宫页面,介绍联邦政府围绕先进模型评估与安全开展的工作。
@CNN 报道称(8 次点赞,6 条回复,12,642 次浏览)也独立报道了同一封公开信:来自主要 AI 和科技公司的高级幕僚敦促美国政府放慢 AI 发展速度,以便安全和安保措施能够跟上。第二个来源之所以重要,是因为它把这一主题从某位用户的综合判断,推向了更广泛的公共叙事。
@OpenAIDevs 和 @prathamgrv 让这一背景更难被视为作秀。前者显示 GPT-5.6 Sol 正在改善其自身服务循环的经济性;后者则 指出(31 次点赞,1 条回复,1,236 次浏览,14 次收藏),指向一篇立足执行的自动化 AI 研究论文:由 LLM 提出改进模型的想法,代码把这些想法转化为实验,GPU 运行实验,结果再反馈到后续的想法生成中。治理问题已不再只是模型会不会变得更强,而是自动化系统会以多快的速度开始帮助推动这种增强。
讨论洞察: 回复区分成两派:一派对新模型可能很快到来感到兴奋,另一派则不确定“更谨慎”这一主张的正面理由究竟是什么。分歧不在于这些信号是否是刻意释放的,而在于“控制前沿节奏”的另一端,究竟对应怎样的具体愿景。
与前一天相比: 7 月 28 日的政策争论聚焦于开放权重与限制之间的对立。到了 7 月 29 日,重点则从理念转向流程:华盛顿会面、具名公开信、联邦基准渠道,以及围绕有意识控速的公开争论。
2. 什么让人感到沮丧
基准测试数字不断出现,却缺少建立信任所需的上下文
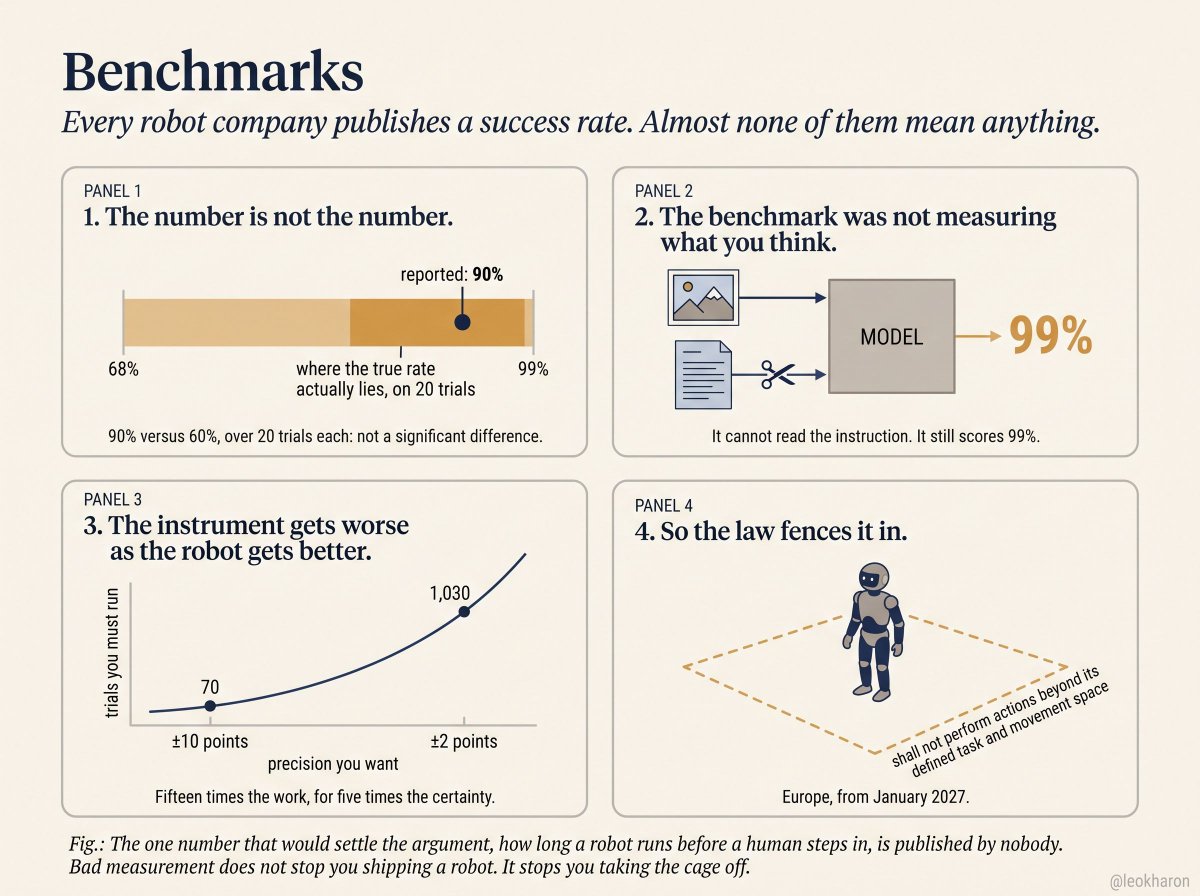
严重程度:高。数据集中最明显的挫败感,不是基准测试本身的存在,而是它们省略了那些能让结果真正可用于决策的细节。@lagerskoy 认为(20 次点赞,114 次浏览,14 次收藏)指出,一些 coding-agent 架构之所以看起来像最先进方案,只是因为还没人把成本和规范的留出集加进去;一旦补上这些因素,就会发现某种架构的成本比重试循环高出 50 倍,却没有显著收益,而且 17 个基准中有 12 个未采用恰当的留出集设计。在机器人领域,@LeoKharon 认为(4 次点赞,146 次浏览,2 次收藏)指出,20 次试验中宣称的 90% 成功率,实际上掩盖了 68%–99% 的真实区间;某个模型甚至不读指令,也能在某个基准划分上拿到 99%;而如果要把精度从正负 10 个百分点收紧到正负 2 个百分点,所需试验次数大约是 1,030 次,而不是 70 次。就连紧凑模型发布,也以缩小版形式遭遇了同样的抱怨:在对 @qvac 的 VisionPsy 讨论串的回复中,有人要求给出手机端真实延迟(毫秒)和编码器成本,而不是泛泛而谈“同类最佳”。人们的应对方式,是要求提供重试基线、索取更细的基准拆解,并在成本和部署细节未公开之前,将对厂商有利的评分卡视为信息不完整。这值得围绕它构建产品,因为这种痛点横跨 LLM agent、机器人和边缘模型,而不只是某一个子圈层。
Agent 的实用性仍然取决于模型之外的一切
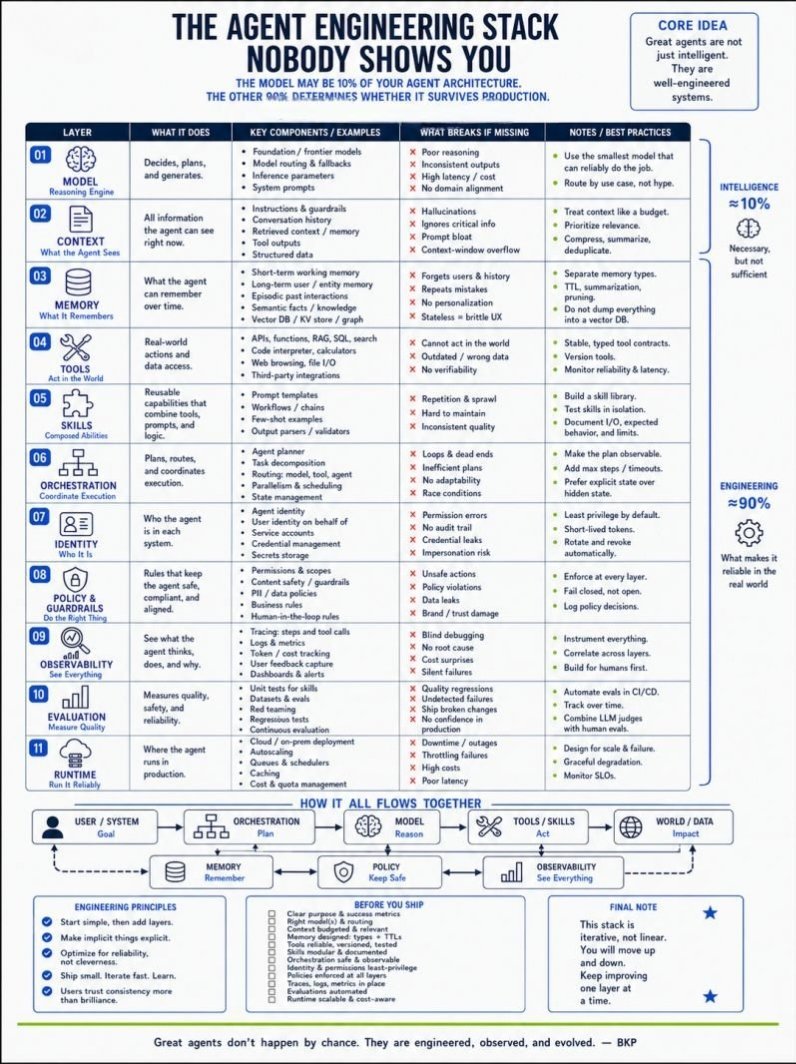
严重程度:高。多条帖子汇聚到同一个系统层面的抱怨:光有强大的模型,并不足以让 agent 变得可靠。@gregisenberg 表示 称 Buzz 是“alpha 软件”,而且“某些地方很慢”,尽管同时称赞其底层“上下文优先”的设计——这等于直接承认,产品形态和运行时质量仍然落后于其雄心。@HeyAnjula 认为(4 个赞,198 次浏览)指出,模型本身只占生产级智能体系统的大约 10%,其余 90% 则是上下文、记忆、工具、编排、身份、护栏、可观测性、评估和运行时。baseten-switch、Replit 的 selector 和 book-to-skill 这类工具的出现,从不同角度指向了同一个缺口:团队不想反复重写支撑框架,不想一次次手动重述上下文,也不想针对每条工作流逐个挑选模型。当前的权宜之计,是在模型外围一层层叠加更多软件;真正的机会,则在于把这些层做得平淡、可靠、可复用。
按量计费的 AI 经济学,往往要等变成预算问题时才会被看见
严重程度:中高。@OpenAIDevs 报道称 内部效率提升,因为如今服务成本降低 20%、token 生成效率提升 15% 以上,已经算是产品新闻,而不再只是后台实现细节。@neil_xbt 将其描述为 在买方视角将其概括为“每美元对应的知识量”,并认为在长时运行的智能体工作负载中,能力稍弱但便宜得多的模型反而会胜出。围绕 Replit 的 selector 和 Baseten Switch 的回复,则把这种挫败感具体化到了运营层面:用户要求显示 token 成本、明确授权方式、处理缓存命中情况,以及能够轻松回滚到原生模型。人们已经在通过路由层和更便宜的上游模型来应对,但反复出现的可见性诉求表明,痛点不在于一次性选定模型——而在于选定之后如何持续监控支出。
3. 人们希望存在什么
能被智能体复用、而不是每次会话都重新学习的持久上下文
人们无论是隐含还是明确表达出的诉求,都不只是更大的上下文窗口,而是一层能够持续存在的上下文层。Buzz 的核心卖点就是“上下文是基础”,而且实时应用数据应持续回流到智能体中;与此同时,@RituWithAI 重点介绍了(8 个赞,3 条回复,166 次浏览,6 次收藏)book-to-skill 之所以精准击中需求,正是因为它把长文档转化为可复用的 SKILL.md,供 Claude Code、Cursor 和 Codex 持续沿用。@HeyAnjula 将……视为 将上下文、记忆和技能视为彼此独立且缺失的层,这说明这是一种现实需求,而不是哲学层面的讨论。评级:直接机会,因为当前的帖子已经同时展现了痛点,以及产品化修复方案的早期尝试。
同时优化能力与成本的路由
Replit 的 selector、baseten-switch,以及“每美元对应的知识量”这种表述,实际上都在表达同一个愿望:让我保留现有工作流,同时由系统挑选合适的模型,并告诉我成本。@pirroh 承诺 提供模型推荐和 effort levels,但最尖锐的一条回复立刻要求看到 token 成本。@ahmetb 构建了 一层路由层,在保留 Claude Code 和 Codex 的同时替换上游模型;只有当模型选择和支出控制仍然痛苦到足以让人接受额外基础设施时,这种做法才说得通。评级:竞争性机会,因为已经存在多种解决方案,但用户仍希望获得更好的可见性,并减少手动调优。
当系统能够自我改进时依然有效的评估与节奏机制
当天的帖子显示,人们希望有一套基准和治理机制,不会在智能体变得更便宜、更自主或更能自我改进时立刻失效。@OpenAIDevs 展示了 某个模型正在改善自身的服务经济性;@prathamgrv 分享了 一个以执行为基础的自动化 AI 研究闭环;在前沿稳步前行 网站呼吁采用技术和治理工具,有意识地放缓前沿领域整体进展的速度;@lagerskoy 和 @LeoKharon 也都认为,现有基准过于薄弱,无法作为重大决策的可靠依据。评级:理想型机会,因为需求很明确,但完整解决方案横跨工具、标准和政策。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Buzz | Agent 工作空间 | (+/-) | 以上下文为核心的设计、实时应用数据闭环、音频协作、本地算力共享 | 即便是当天的支持者,也仍称其为 alpha,且速度较慢 |
| GPT-5.6 Sol in Codex | 前沿 LLM / 编程 Agent | (+/-) | 在 OpenAI 自有技术栈中展示出 20% 的服务成本下降,以及 15% 以上的 token 效率提升 | 用户追问“更有用的工作”具体指什么,以及为什么这些提升对他们来说并不明显 |
| Grok Build Mode | 提示词生成应用的构建器 | (+) | 直接在聊天中构建并发布网站、应用、游戏和仪表盘 | 仍处于早期 Beta,仅限 SuperGrok Heavy |
| Baseten Switch | 路由网关 | (+) | 在替换上游模型的同时保持 Claude Code/Codex 工作流不变;增加了请求路径和面向支出的控制能力 | Beta 版 macOS 应用;回复主要询问许可、缓存命中和端点行为 |
| Replit model selector | 模型路由 UI | (+/-) | 通过推荐版本和 effort level,减少选择过载 | 用户仍希望明确看到 token 成本 |
| VisionPsy-Nano | 端侧 VLM | (+/-) | 开放权重、约 0.5B 级别基准表现强劲、面向手机的 Flash 变体 | 回复中要求提供具体延迟毫秒数,以及编码器成本透明度 |
| Fish Audio S2.1 Pro | 语音模型 / TTS | (+) | 支持 83+ 种语言、约 90ms 延迟、开放权重/本地部署定位、可见 BT 分数表现强劲 | 现阶段证据仍主要停留在发布期,且更多是对比式展示,而非广泛的实际使用 |
| VibeVoice ASR BitNet | 语音识别 / ASR | (+) | 采用 1.58-bit 解码器,可在纯 CPU 环境下进行多语言部署 | 当前证据主要还是 HF demo 和发布公告,用户报告不多 |
| Ontology 1 | 垂直搜索模型 | (+/-) | 尽管目录很小,但在意图密集型查询上胜过 Google/Amazon;具备领域专用推理能力 | 基准仍依赖基于裁判模型的评分,且领域范围较窄 |
| book-to-skill | Agent 知识封装 | (+) | 可将书籍和长文档转化为可复用的 SKILL.md 工件,供编程 Agent 使用 |
项目非常早期,目前观察到的采用情况有限 |
总体满意度最高的,往往是那些在不要求用户放弃现有工作流的前提下,降低切换成本或部署成本的工具。最常见的变通方式并不是“挑一个最好的模型”,而是“保持 harness 稳定,在外围做路由、压缩或封装”:例如在 Claude Code/Codex 背后接入更便宜的开源模型,用可复用的 SKILL.md 知识替代反复重写提示词,以及采用更小型的语音/视觉组件,把一部分工作从云端迁走。竞争格局正日益分化为两层:一层是出售旗舰能力的前沿实验室,另一层则是在其上下游出售路由、封装、领域聚焦或硬件效率的产品。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Buzz | Jack Dorsey 的团队,通过 @gregisenberg | 被定位为 Slack 替代品的 Agent 工作空间,支持模型切换、音频协作、应用构建和实时上下文闭环 | 现有协作工具无法将 Agent 上下文、实时产品状态和本地模型工作流整合到同一处 | Buzz 工作空间、可切换模型、实时应用数据闭环、本地算力共享 | Alpha | 帖子, 视频 |
| Grok Build Mode | xAI | 在聊天中实时构建网站、应用、游戏和仪表盘,并发布为链接 | 无需配置,就能把基于提示词的创意过程转化为可分享的软件 | Grok、web/iOS/Android、聊天内代码生成、链接发布 | Beta | 发布, 帖子 |
| Baseten Switch | @ahmetb | 可将 Claude Code 和 Codex 重新路由到 Baseten 托管模型的本地网关 | 让团队在保留同一套编程 harness 的同时,对模型成本/性能进行套利 | macOS 应用、Baseten、Claude Code、Codex、GLM 5.2 / Kimi K3 | Beta | 帖子, GitHub |
| VisionPsy-Nano | @qvac | 460M 端侧视觉语言模型家族,提供质量版和 Flash 版 | 将 OCR、视觉感知和推理带到手机与离线工作流中 | SigLIP2、SmolLM2、GGUF、llama.cpp、vLLM | Shipped | 帖子, 博客 |
| Fish Audio S2.1 Pro | @FishAudio | 开放权重语音模型,支持快速克隆和可控表达 | 在保留自托管/本地部署选项的同时,降低实时语音 Agent 的成本和延迟 | 开放权重 TTS、本地部署 | Shipped | 帖子, 网站 |
| VibeVoice ASR BitNet | Microsoft | 纯 CPU 多语言 ASR demo | 无需 GPU 依赖即可实现实时转录 | 1.58-bit BitNet 解码器、纯 CPU 的 Hugging Face Space | Beta | 帖子, 演示 |
| Ontology 1 | @onton_ai | 面向意图密集型和多模态购物查询的神经符号搜索模型 | 关键词搜索和向量搜索难以理解偏好导向、否定条件和多重约束的搜索意图 | 神经符号模型, | Ograph 图数据库 | 已发布 |
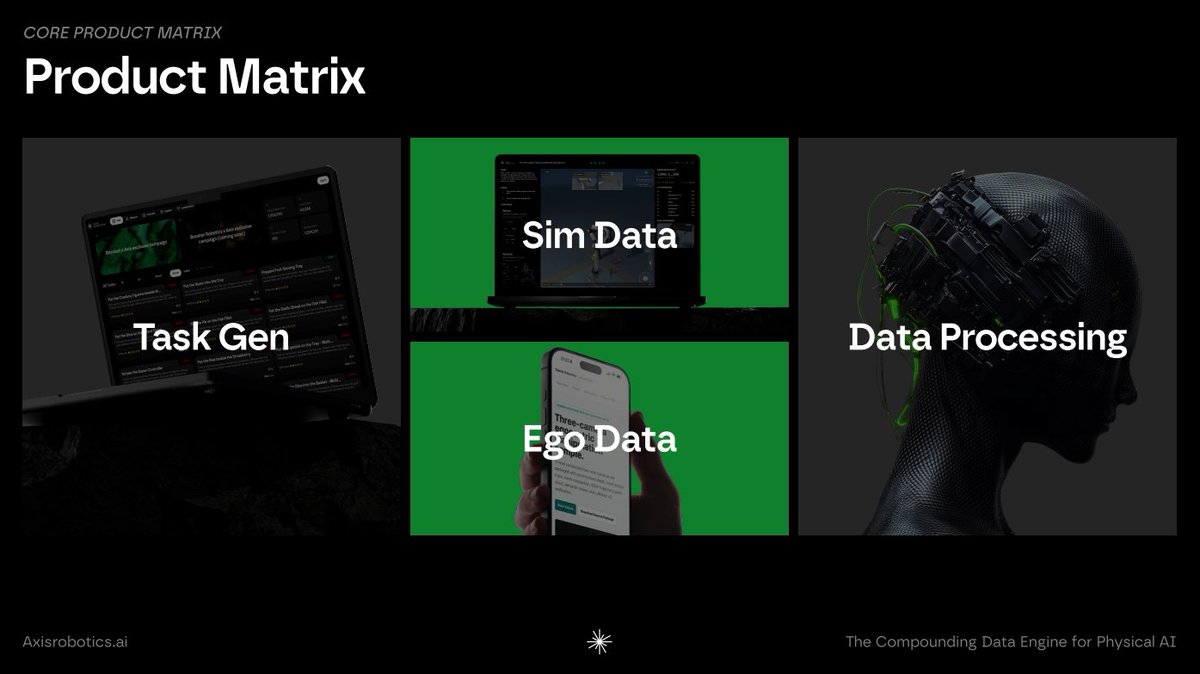
| Axis 数据引擎 | @axisrobotics | 面向机器人领域的任务生成、仿真采集、第一人称采集和数据处理闭环 | 将机器人数据采集与校正式后训练串联为一条可复利增长的流水线 | 浏览器遥操作、HG-DAgger、开源基础设施 | 测试版 | 帖子, GitHub |
反复出现的构建模式并不是“从零发明一个新的基础模型”,而是“改变现有工作流的经济性或易用性”:Grok 和 Buzz 缩短了从想法到可上线成果的路径;Baseten Switch 和 Replit 风格的选择器在上游模型变化时保持编码框架不变;VisionPsy、Fish Audio 和 VibeVoice 则进一步降低了硬件门槛,使相关工作能够转移到手机、CPU 或本地部署的语音栈上。
Onton 的 Ontology 1 和 Axis Robotics 指向了第二种模式:面向特定领域的复利闭环。Ontology 声称,通过在更收敛的领域内推理,并从高意图查询中学习,它能够提升搜索质量;而 Axis 则明确把任务生成、仿真采集、第一人称数据和部署反馈连接成一个统一的改进飞轮。这与通用聊天机器人产品有实质性区别,因为其价值来自结构化数据反馈,而不只是更强的基础模型。
6. 新动态与重点观察
训练数据污染从假设变得可观测
@DropSiteNews 报道称(176 次点赞,4,995 次浏览,13 次收藏)指出,与一场宣传活动相关的网站已被 Common Crawl 归档 912 次,而 Common Crawl 正是用于训练大语言模型的仓库之一。让这一说法格外值得注意的是随附图表:它显示归档次数从 1 月几乎为零,升至 4 月约 280 次、5 月约 350 次,并在 6 月维持高位,使“未来会影响模型”不再只是抽象的数据投毒担忧,而成为一种可见的数据摄取模式。

以执行为基础的自动化 AI 研究,从口号走向论文图示
@prathamgrv 分享了(31 次点赞,1 条回复,1,236 次浏览,14 次收藏)提到一篇关于自动化 AI 研究的论文:由 LLM 提出改进思路,系统将这些想法转成代码,GPU 实验负责运行,结果再反馈到后续的想法生成中。这张论文截图之所以重要,在于它呈现的不只是“智能体可以做研究”这种模糊说法:摘要和图示描述了一个具体的“实现器—调度器—工作器”闭环,以及清晰可见的结果差异,包括后训练上的 69.4% 对 48.0%,以及某个预训练配方上的 19.7 分钟对 35.9 分钟。

将书籍封装为可复用的智能体技能,成为一个虽小却颇具启发性的模式
@RituWithAI 浮出水面(8 次点赞,3 条回复,166 次浏览,6 次收藏)提到 book-to-skill,一个小型开源项目,可将书籍和长文档转换为供 Claude Code、Cursor 和 Codex 复用的 SKILL.md 文件。它值得关注,与其说是因为当前规模,不如说是因为它揭示了智能体构建者认为下一步杠杆会来自哪里:不是再多一个提示词模板,而是将持久、可移植的知识打包成智能体运行时已经懂得如何加载的格式。
7. 机会在哪里
** +++] 面向多模型智能体栈的成本可见路由与可观测性** — 来自多个部分的证据都指向同一个结论:baseten-switch 的存在是为了在不改变 harness 的情况下重路由 Claude Code/Codex,Replit 用户也明确提出,希望在选择模型之前先看到 token 成本,而 [@neil_xbt 将这一决策重述为“每美元对应的知识量”,而 @lagerskoy 认为,一旦把价格摆出来,一些已发布的智能体架构就会变得站不住脚。这是最强的机会点,因为需求已经用运营层面的语言表述出来,而不只是停留在理论层面。
** ++] 面向智能体的持久上下文、记忆与技能封装** — Buzz 主打实时上下文循环,book-to-skill 试图将文档转化为可复用的 SKILL.md 资产,而 [@HeyAnjula 明确指出,上下文、记忆、技能和编排构成了智能体系统缺失的 90%。市场需求很直接,但目前仍足够早期,尚未出现占据主导地位的产品模式。
** [++] 面向隐私敏感型生产负载的本地语音与多模态组件 ** —— VisionPsy-Nano、Fish Audio S2.1 Pro 和 VibeVoice ASR BitNet 都在推动同一个方向:更小的模型,既能运行在手机、CPU 或本地语音栈上,又能保留实用能力。这一机会很强,因为需求驱动因素是切实可感的——更低延迟、更低硬件成本,以及更少暴露给云端——而不是愿景式诉求。[+] 面向智能体与机器人的基准强化 —— 该数据集收录了代码智能体对缺少留出测试集的抱怨、机器人领域对“成功率”指标缺乏意义的批评,以及边缘模型对缺少真实设备延迟数据的不满。这看起来像是一种持久需求,但与成本路由机会相比,它也更加碎片化,因为它横跨多个子领域,而这些领域各自都有不同的评估失效模式。
**+] 训练数据溯源与爬取监控** — 由 [@DropSiteNews 分享的 Common Crawl 存档图表 只是其中一项,但具体得不同寻常。这表明一个新兴细分方向正在出现:开发工具来跟踪哪些公开数据正在进入未来的训练语料,并在操纵行为固化为模型行为之前发出预警。
8. 要点
- 7 月 29 日最有力的 AI 产品主张是“带着上下文交付”,而不是“交付最聪明的模型”。 Buzz、Grok Build Mode 和
book-to-skill的卖点,都是持久上下文、实时状态或可复用知识——这些才是让智能体显得有用的关键。 (来源) - 单位结果成本正在取代基准声望,成为实际采购中的关键指标。 OpenAI 强调了服务成本下降,
baseten-switch推出了路由与支出控制功能,而“每美元知识量”被认为比一次性的排行榜结果更有决策价值。 (来源) - 开放权重的势头,正分散到更小、更易部署的组件上,而不是继续围绕单一旗舰叙事展开。 VisionPsy-Nano 面向手机,VibeVoice 面向纯 CPU 的 ASR,Fish Audio 则瞄准实时语音的经济性。 (来源)
- 垂直化和领域专用系统,正相对于通用型既有巨头开辟出可信的立足点。 Ontology 1 的公开基准页面声称,在意图密集型查询上,其 top-10 准确率优于 Google Shopping 和 Amazon,尽管它索引的商品目录仅为后两者的 1%。 (来源)
- 面向华盛顿的前沿治理,正变得更加程序化,也不再那么抽象。 这封进度函、白宫政策页面,以及同日华盛顿特区关于模型预览的讨论,都表明焦点正从泛泛的安全争论转向具名的公共流程与评测渠道。 (来源)
- 训练数据来源,开始成为一级议题。 Common Crawl 档案图表给出了一个具体例子:影响力行动如何从操纵搜索结果,转而进入未来模型训练的输入。 (来源)