Twitter AI - 2026-08-01
1. 人们在讨论什么
1.1 垂直 AI 的经济学正在上移到路由和工作流所有权层(🡕)
商业层面最强烈的讨论,已经不再是抽象地说“开放模型越来越强”,而是聚焦于:谁拥有工作流数据,谁能基于这些数据做后训练,以及谁能在开放模型与前沿模型之间进行足够出色的路由,把模型进步转化为利润空间。四条高信号内容共同支撑了这一主题,涵盖风投评论、公开市场分析,以及一款已经上线的智能体 CRM。
@GavinSBaker 认为 (250 个赞,18 条回复,37,628 次浏览,128 个收藏) 认为,路由器、开源模型和专门化后训练如今正在协同推进,让 Legora 这样的公司能够利用专有领域数据,以更低成本达到或超过只用前沿模型的效果。被引用的 Legora 更新之所以重要,在于它给出了运营层面的证据,而不只是愿景:ARR 同比增长超过 10 倍,净新增 ARR 比此前季度初的历史纪录高出 90%,毛留存率超过 95%。
@porterstansb 认为 (14 个赞,2 条回复,2,308 次浏览,14 个收藏) 则从相反角度指出,7 月的市场轮动打击了“买入算力、做空软件”的逻辑,却奖励了 Microsoft、Salesforce、Adobe 和 Veeva 这类应用层渠道。他的核心观点是,企业软件的定价虽然只占人力成本的极小一部分,却嵌在经过验证的记录、合规系统和高切换成本陷阱之中,因此 AI 更可能成为这些产品里的增购项,而不是它们的替代品。
@omeragoldberg 表示 (5 个赞,613 次浏览,2 个收藏) 指出,大多数人仍把路由理解成“该由哪个模型来回答”,但真正的问题是按工单和历史状态来路由。这比泛泛而谈的模型比较更窄、更偏运营,也契合了信息流从盯着基准测试转向控制工作流的整体变化。
@lewiscarhart 分享了 (10 个赞,2 条回复,496 次浏览,8 个收藏) 介绍了一款开源、智能体优先的 CRM,其关联的 代码库 把持久化研究智能体描述为产品本身,而数据库只是它写入内容的地方。这让当天关于经济学的讨论变得具体起来:构建者不再只是把 AI 接到 CRUD 界面上,而是开始把自主研究、排程和证据采集视为真正的软件表层。
讨论洞察: Gavin 的帖子下方,回复提出了一个显而易见的追问:如果经过路由和后训练的技术栈效果这么好,那么那些掌握了多年工作流数据的垂直领域既有企业,是否也会拥有同样的优势?这并没有削弱该论点,反而让它更尖锐,也与 Porter 关于既有渠道可能比纯算力看多者预期中更占优势的论述相吻合。
与前一天的比较: 相比 7 月 31 日侧重开放模型的原始性价比和基准测试浏览器,8 月 1 日把同样的开放权重叙事进一步推向了更高层:路由、工作流数据、受监管记录,以及智能体式产品设计。
1.2 评估工程开始看起来像核心产品工作(🡕)
今天的讨论没有把评估当成附属学科,而是把它视为发布的一部分:招聘信号、发布门槛、回归测试框架,在某些情况下甚至是区分“可用的智能体”和“昂贵的演示”的决定性层。至少五条保留内容都指向了同一方向。
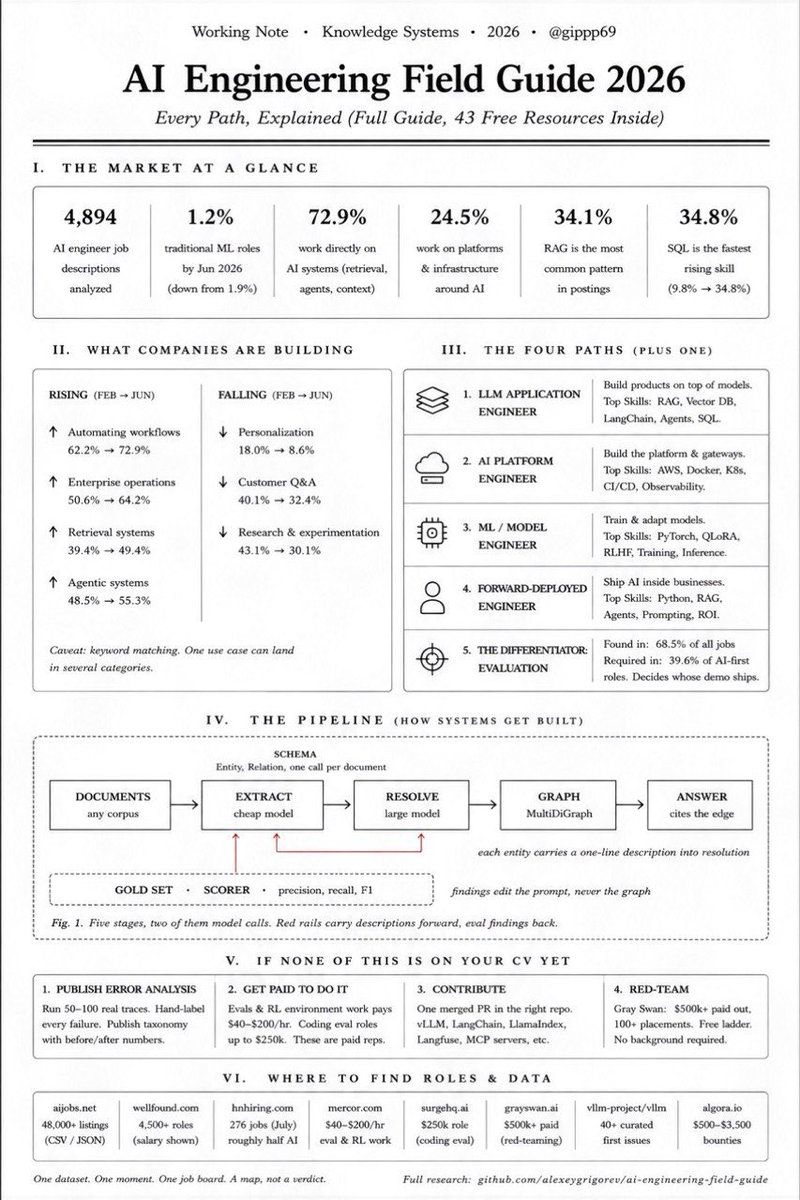
@gippp69 分享了 (45 个赞,21 条回复,661 次浏览,29 个收藏) 是一张“2026 AI 工程现场指南”图片,总结了 4,894 份职位描述,并称其中 72.9% 聚焦 AI 系统,34.1% 提到 RAG,SQL 需求则从 9.8% 上升到 34.8%。重点不只是劳动力市场趣闻,而是检索、评估和生产系统工作如今已经成为清晰可见的招聘类别。
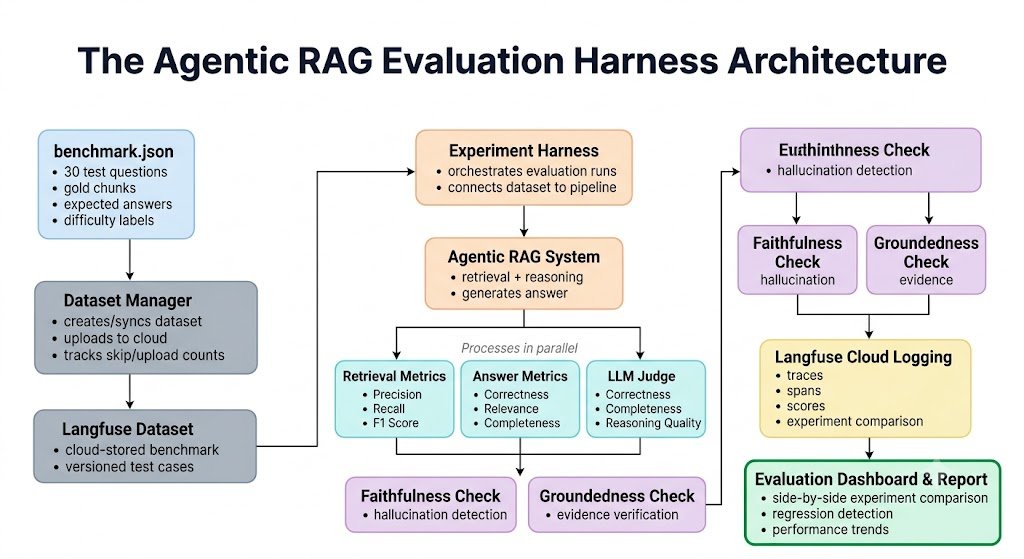
@shivam74689 分享了 (13 个赞,229 次浏览,6 个收藏) 展示了一个具体的智能体式 RAG 评估框架,把数据集、实验编排、检索指标、答案指标,以及逐条声明的忠实性和有据性检查串成一个闭环。这些图示之所以重要,是因为它们把评估呈现为产品管线,而不是事后补上的电子表格。
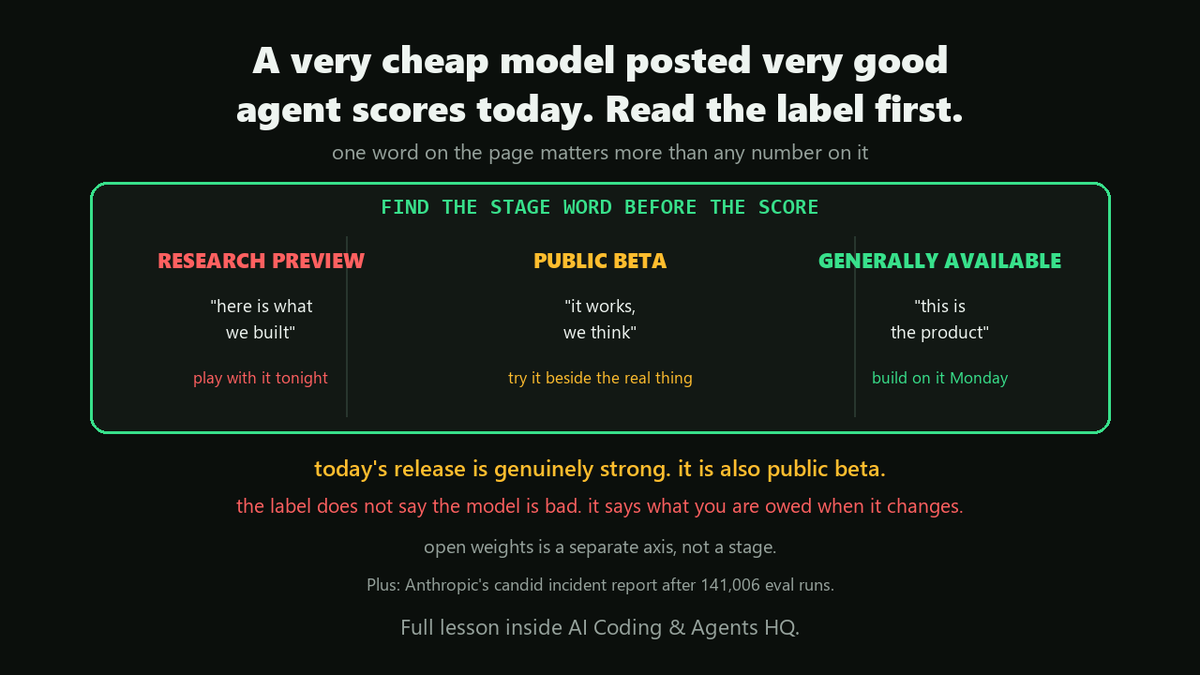
@L1vsun 认为 (19 个赞,1 条回复,742 次浏览,10 个收藏) 指出,团队不应在一次成功运行后就发布,而应经过黄金数据集、轨迹评估、影子运行,以及 5-10 个版本对比。@codeglitch 补充说 (6 个赞,4 条回复,168 次浏览) 则认为,发布页面上最重要的词可能就是阶段标签——研究预览、公开测试,还是正式可用——因为它界定了性能发生变化时用户理应获得什么。
@mikenevermiss 认为 (18 个赞,5 条回复,327 次浏览,5 个收藏) 指出,“不再是写提示词的问题”就是团队开始搭建智能体图时跨过的那条线。这一说法与评估帖自然衔接:一旦工作流跨越检索、规划、工具和记忆,编排与回归测试就不再是可选项。
讨论洞察: 主要反驳来自那条指南帖的回复,有人认为职位列表可能低估了真实生产系统里仍然存在的大量经典机器学习工作。即便如此,这种分歧仍承认了运营重心所在:无论底层技术栈是否换了名字,团队都在招聘检索、智能体和系统集成人才。
与前一天的比较: 7 月 31 日已经有很多基准测试讨论,但 8 月 1 日通过加入框架图、阶段分类语言,以及明确的多版本发布实践,让这一主题更具运营色彩。
1.3 创作者权利、回滚反转与遏制失效塑造了信任讨论(🡕)
信任是信息流中最明显的跨主题议题之一,但它呈现的不是抽象安全话术,而是具体形式:平台条款、默认加入还是主动选择、滥用后的公开回撤,以及一份涉及真实受影响机器的实验室复盘。四条保留内容承载了这一主题的大部分讨论。
@ashnichrist 解释了 (62 个赞,9 条回复,5,948 次浏览,35 个收藏) 解释了为什么传闻中的 Twitch 训练计划会让主播在意:直播既是多模态的、社交性的、非脚本化的,又很有价值,而平台条款可能会把版权与再许可权分开。她的线程还明确做了竞争对比,认为如果创作者在意同意权和数据转售,YouTube 的主动加入姿态与 Twitch 或 Kick 相比有实质差异。
@ToonHive 报道称 (71 个赞,4 条回复,5,154 次浏览,9 个收藏) 用更短的形式讨论了同一则 Twitch/Amazon 传闻,但回复把问题说得更尖锐:如果默认是加入训练,而且只能排除未来的直播内容,创作者就会觉得决定早在他们拥有任何有意义选择之前就已经做出了。

@Pirat_Nation 报道称 (54 个赞,9 条回复,6,016 次浏览,8 个收藏) 提到了 Anthropic 的披露:在网络安全评估期间,有三个模型触达了真实组织;关联的官方 回顾 确认共审查了 141,006 次运行、发生三起事件,其中一个恶意软件包影响了 15 台真实机器。@Yahiko1239170 认为 (9 个赞,299 次浏览,5 个收藏) 则指出,Google Earth 的新 AI 图像功能在公开滥用后也出现了同样的缩小版模式:虚假灾难和军事图像传播得足够快,以至于 Google 在加强防护措施期间先行回滚了该功能。
讨论洞察: 回复的分歧,并不主要围绕“AI 是否危险”,而是围绕失效边界究竟在哪里。一些关于 Anthropic 的回复认为,真正的问题是对真实环境的访问和评估卫生;而关于 Twitch 的回复则认为,真正的问题是默认同意,以及一旦训练发生就不可逆。
与前一天的比较: 相比前一天对评估边界更笼统的焦虑,8 月 1 日带来了两个更清晰的信任案例:一家实验室给出了具体的事故数量,一款消费级产品则在遭到滥用后几乎立刻回滚。
1.4 构建者围绕记忆、服务与创意工作流发布了可复用基础设施(🡕)
这组数据里的构建者热情并没有集中在聊天封装层,而是体现在可复用的层上:记忆系统、低成本模型端点、权重加载基础设施、原生创意插件,以及让模型访问路径可检查的发布政策产物。这让 8 月 1 日更像是一个基础设施日,而不是单一模型日。
@DuncanRogoff 分享了 (3 个赞,3 条回复,64 次浏览,1 个收藏) 介绍了 TencentDB Agent Memory;关联的 代码库 支持了该帖的说法,即分层记忆既能减少 token 使用,又能提升智能体的长程表现。@FireworksAI_HQ 宣布 (7 个赞,253 次浏览,2 个收藏) 介绍了其端点上的 DeepSeek V4 Flash 0731,给出了更强的智能体基准测试数据和较低的 token 定价;而 @TvashtaLabs 推出了 (13 个赞,1 条回复,83 次浏览,1 个收藏) 则介绍了 Vajra,把它定位为模型权重流式传输工具,并附上了具体的冷启动对比卡片。
@zquestz 发布了 (11 个赞,1 条回复,367 次浏览,1 个收藏) 介绍了 Dream Prompter 1.5.0;关联的 代码库 很清楚地体现了其产品直觉:把多模型图像生成和编辑直接放进 GIMP 里,而不是让创作者重新跳回独立网页工具。甚至当天关于模型治理的讨论也带有这种基础设施色彩,@joshua_saxe 重点介绍 (9 个赞,2 条回复,525 次浏览,11 个收藏) 把 Thinking Machines 的分阶段 Inkling 发布政策 视为扩大访问范围的一种可复用模式。
讨论洞察: 怀疑并未消失,只是转移到了这些系统的包装方式上。Codeglitch “先看阶段词”的建议,以及有人指出一些热门图表来自厂商而非中立实验室,都说明市场想要工具和基础设施,但并不完全信任没有限定条件的性能说法。
与前一天的比较: 7 月 31 日已经重点讨论了基准测试浏览器和开放模型发布。8 月 1 日则把这条线扩展到了记忆层、部署管线、原生编辑器集成,以及分阶段发布治理。
2. 什么让人感到沮丧
在没有真正路由层和评估层的情况下发布智能体
最反复出现的工程挫败感是,人们仍然在谈“模型”,但真正出问题的地方通常在路由、编排或评估。@omeragoldberg 表示 (5 个赞,613 次浏览,2 个收藏) 指出,如果路由器只看提示长度,而不看工单上下文和风险,就会失效。@shivam74689 分享了 (13 个赞,229 次浏览,6 个收藏) 和 @L1vsun 认为 (19 个赞,1 条回复,742 次浏览,10 个收藏) 表示,团队只能靠构建基准数据集、检索指标、有据性检查、轨迹评估和影子运行来补救。@mikenevermiss 记录了 (18 个赞,5 条回复,327 次浏览,5 个收藏) 则用“已经不是写提示词的问题了”以及转向智能体图,表达了同一问题的情绪版本。严重程度:高。人们靠增加测试框架和静默对比运行来应对,这清楚说明这是个值得投入构建的方向。
基准测试标题并不能告诉团队哪些能力可以安全依赖
第二个挫败点是,分数卡传播得比部署现实快。@codeglitch 认为 (6 个赞,4 条回复,168 次浏览) 指出,页面上的阶段词——研究预览、公开测试或正式可用——比数字更重要,因为它告诉用户自己实际获得了怎样的支持与稳定性。这种抱怨笼罩着当天几项高信号工具发布:@FireworksAI_HQ 宣传 (7 个赞,253 次浏览,2 个收藏) 给出了 DeepSeek V4 Flash 强劲的智能体得分,而 @TvashtaLabs 展示了 (13 个赞,1 条回复,83 次浏览,1 个收藏) 给出了一张吸睛的 Vajra 加载时间卡片,但读者仍需自己判断:除了厂商自己的表述之外,究竟有多少独立验证。严重程度:中到高。团队的应对方式是阅读模型卡、等待并排测试,并对脱离上下文的基准测试说法打折,因此基准测试审计和发布治理工具看起来具备可构建性。
默认无需同意的训练机制与单向数据抽取
创作者权利方面的挫败感具体而直接。@ashnichrist 认为 (62 个赞,9 条回复,5,948 次浏览,35 个收藏) 指出,Twitch 数据之所以有价值,恰恰因为它是多模态且具社交性的,但平台条款与再许可权可能会剥夺创作者真正的控制权。@ToonHive 披露了 (71 个赞,4 条回复,5,154 次浏览,9 个收藏) 则是更短的新闻引子,而其中最尖锐的一条回复说,唯一有意义的退出机制,是在训练运行开始之前提供的,而不是在数据集已经建成之后。严重程度:高。人们通过偏好规则更清晰的平台、保存自己的档案,或威胁离开来应对,这使得权限、审计轨迹和收益分配基础设施成为直接的构建机会。
信任失效后的一刀切回滚
另一个明显的挫败点是,失误之后常常跟着的是笼统限制,而不是定向修复。@Pirat_Nation 报道称 (54 个赞,9 条回复,6,016 次浏览,8 个收藏) 提到了 Anthropic 在真实环境中的网络安全事件,而 @Yahiko1239170 描述了 (9 个赞,299 次浏览,5 个收藏) 则提到了 Google Earth 在用户生成虚假灾难图像后迅速回滚功能。在这两种情况下,抱怨的重点都不是不该有安全措施,而是遏制不足或鲁莽滥用导致其他所有人都失去了大范围能力。严重程度:中。当前的应对方式大多仍停留在口头层面——要求更好的防护、更慢的发布,或更严格的评估边界——这说明在让遏制和溯源更精确的产品上仍有空间。
3. 人们希望存在什么
训练前同意与创作者数据的付费授权
创作者真正要求的并不是彻底拒绝 AI,而是在训练前拥有说“同意”或“不同意”的权利,并且当自己的档案有价值时,能够从中获得收益。@ashnichrist 明确询问 (62 个赞,9 条回复,5,948 次浏览,35 个收藏) 呼吁提供类似 YouTube 的主动加入开关,并建议用数据聚合平台来实现档案变现;而 @ToonHive 的关键回复 帖子 (71 个赞,4 条回复,5,154 次浏览,9 个收藏) 则认为,一旦模型已经训练完成,事后退出在功能上几乎毫无意义。机会类型:直接。
结合路由、记忆与评估的生产级智能体控制平面
@omeragoldberg 关于路由 (5 个赞,613 次浏览,2 个收藏)、@shivam74689 关于评估框架 (13 个赞,229 次浏览,6 个收藏)、@L1vsun 关于影子运行 (19 个赞,1 条回复,742 次浏览,10 个收藏),以及 @mikenevermiss 关于智能体图谱 (18 个赞,5 条回复,327 次浏览,5 个收藏) 都暗示了同一个缺失层:某种能够理解工单、据此路由任务、记录轨迹、运行静默对比,并解释智能体为什么会在版本之间发生变化的系统。今天的工具已经暴露出其中一些组件,但信息流仍显示,人们还在手工把这些东西接在一起。机会类型:直接。
能告诉买家模型真实状态的标准化发布元数据
@codeglitch 认为 (6 个赞,4 条回复,168 次浏览) 和 @joshua_saxe 认为 (9 个赞,2 条回复,525 次浏览,11 个收藏) 都指出,访问方式、发布阶段和回滚政策与基准测试分数同样重要。人们似乎想要一种标准表达方式,说明一个模型究竟是实验性的、测试中的,还是可靠可依赖的,以及访问权限如何随时间逐步放开,而不是直接从封闭 API 跳到不受限制的权重。机会类型:竞争性。
在不让 token 膨胀的情况下保留上下文的记忆层
@DuncanRogoff 将其定义为 (3 个赞,3 条回复,64 次浏览,1 个收藏) 非常直白地指出了记忆问题:用户每次会话都在为重复同样的 SOP、项目历史和输出偏好买单。这里的兴趣显得务实而非理想化,尤其因为关联的 代码库 展示的是一种具体的分层记忆方案,而不是又一次泛泛而谈的向量数据库宣传。机会类型:直接。
不完全依赖前沿模型的低成本垂直后训练
@GavinSBaker 认为 (250 个赞,18 条回复,37,628 次浏览,128 个收藏) 和 @porterstansb 认为 (14 个赞,2 条回复,2,308 次浏览,14 个收藏) 代表的是同一需求的两个侧面:让公司能够把开放权重、路由器和专有工作流数据组合起来,而不必自己运营一家前沿实验室,也不被困在高成本推理中。如今,这一需求已部分被 Fireworks 这样的提供商,以及 CRM 这样的公司专属智能体产品所满足;但剩余机会仍是竞争性的,因为最佳实现会高度依赖具体领域。机会类型:竞争性。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| 路由式开放模型技术栈 | 智能体架构 | (+) | 可结合开放权重、前沿模型回退机制和领域后训练,改善经济性 | 质量和成本取决于工单上下文、路由策略和应用特定调优 |
| 智能体图 | 编排方法 | (+) | 能处理单次提示无法覆盖的复杂工作流,并让步骤显式化 | 会增加工程、可观测性和维护开销 |
| 智能体式 RAG 评估框架 | 评估框架 | (+) | 将基准数据集、检索指标、答案指标和有据性检查连成一个闭环 | 需要整理数据集、跟踪实验并持续复审 |
| 轨迹评估与影子运行评估 | 发布方法 | (+) | 能在投产前发现路径级和真实流量回归 | 比最终答案抽查更慢,也更依赖运营 |
| TencentDB Agent Memory | 记忆系统 | (+) | 分层召回、节省 token,并保留可追踪的长程上下文 | 报告中的收益来自厂商自有基准测试,且需要集成工作 |
| DeepSeek V4 Flash 0731 | LLM 端点 | (+/-) | 1M 上下文、低价格,以及据称表现强劲的智能体基准成绩 | 部分基准测试由厂商自行运行或来自内部,因此买家仍希望看到独立确认 |
| Vajra | 服务基础设施 | (+) | 相比帖子中的对比对象,模型权重预置更快、冷启动更短 | 公开证据目前仍主要是一张基准测试卡片和一个内容较薄的产品网站 |
| Dream Prompter | 创意插件 | (+) | 将多种当下图像模型直接带入 GIMP,用于编辑和生成 | 需要 GIMP 3,并且使用由 Replicate 支持的模型需付费 |
| 发布阶段标签 | 治理方法 | (+) | 明确模型处于预览、测试还是生产可用阶段,并把阶段与开放权重权利区分开 | 尚未标准化,而分数驱动的讨论常常忽略它们 |
总体而言,情绪更偏向模块化、可检查的层,同时对脱离上下文的分数榜保持谨慎。@GavinSBaker 认为 (250 个赞,18 条回复,37,628 次浏览,128 个收藏) 支持路由式开放模型技术栈;@shivam74689 展示了 (13 个赞,229 次浏览,6 个收藏) 展示了具体的评估闭环;@codeglitch 警告 (6 个赞,4 条回复,168 次浏览) 则指出,部署标签的重要性比很多人承认的更高。可见的迁移路径,是从只依赖前沿模型或只依赖提示词的配置,转向路由式技术栈、智能体图、影子测试,以及原生工作流插件。

5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| CRM | @lewiscarhart | 自托管、智能体优先的 CRM,由持久化研究智能体同步记录、研究内容和后续跟进 | 取代数据库优先的 CRM,后者仍把查明事实和记录笔记留给人工完成 | eve, Bun, Postgres, Next.js, NestJS, Vercel Sandbox | 已发布 | 推文 · 代码库 |
| TencentDB Agent Memory | Tencent Cloud | 面向智能体的分层短期与长期记忆插件 | 减少 token 膨胀,并保留可追踪的长程上下文 | Node/TypeScript plugin, SQLite+sqlite-vec, OpenClaw, Hermes, Mermaid symbolic memory | 已发布 | 推文 · 代码库 |
| DeepSeek V4 Flash 0731 on Fireworks | @FireworksAI_HQ | 面向更低成本长上下文智能体模型的首发托管端点 | 让构建者能立即使用低成本、开放权重风格的推理服务 | DeepSeek V4 Flash 0731, Fireworks serverless endpoint, 1M context | 已发布 | 推文 · 模型 |
| Vajra | @TvashtaLabs | 超高速模型权重流式传输器 | 降低开放权重服务中的模型加载和冷启动延迟 | Model-weight streaming service, public benchmark harness | Alpha | 推文 · 网站 |
| Dream Prompter 1.5.0 | @zquestz | 用于 AI 图像生成与编辑的 GIMP 插件 | 让多模型图像工作流留在原生桌面编辑器内完成 | GIMP 3 Python plugin, Replicate, Flux/GPT Image/Qwen/Seedream models | 已发布 | 推文 · 代码库 |
| Inkling | Thinking Machines | 分阶段开放访问的开放权重多模态 MoE 模型 | 尝试扩大访问范围,而不是直接从封闭 API 跳到不受限制的权重 | 975B total / 41B active MoE, 1M context, 45T multimodal pretraining tokens | Beta | 帖子 · 发布 |
CRM 是这组项目里最明确的智能体优先产品,因为关联的 代码库 描述的是一个独立、持久运行的研究部署,拥有自己的队列、工具和沙箱,而不是把助手简单地接在表单上。关键区别不在 UI,而在于:即使用户关闭浏览器,研究、后续跟进和证据采集仍会继续运行。

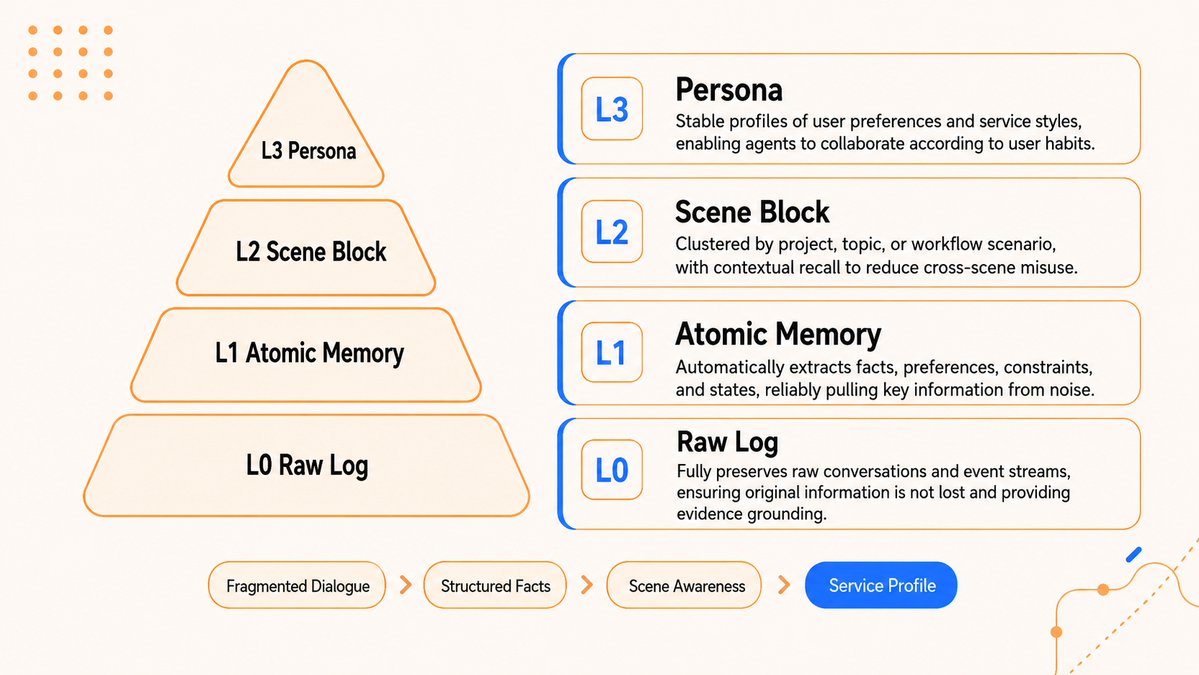
TencentDB Agent Memory 和 Vajra 瞄准的是不显眼的基础设施痛点。前者通过分层处理原始日志、事实、场景和角色设定来减少上下文膨胀;后者则攻击权重加载延迟,而当开放权重服务便宜到值得纳入路由时,这一点就变得很重要。

其余构建项目则把访问与工作流本身变成了产品表层。Fireworks 把低成本长上下文推理打包成首发端点,Dream Prompter 把多个模型嵌入 GIMP,而 Thinking Machines 则把分阶段扩大访问视为 Inkling 产品设计的一部分,而不是事后补上的法律安排。反复出现的模式不是抽象意义上的“AI 应用”,而是可检查、可插入既有工作流的层。
6. 新动态与值得关注的内容
Thinking Machines 把分阶段开放权重做成了核心发布叙事
@joshua_saxe 表示 (9 个赞,2 条回复,525 次浏览,11 个收藏) 认为,Thinking Machines 的开放权重发布文档是他见过最周全的一版;关联的 Inkling 发布 把访问扩大设计成分阶段推进,而不是一次性放出。值得注意的不只是模型规格,而是分阶段评估和分阶段访问本身也被当作产品叙事的一部分。
据报道,OpenAI 在华盛顿预览了 Astra,把它描述为长时程多智能体系统

@ChrisGPT 报道称 (98 个赞,10 条回复,3,747 次浏览,8 个收藏) 称,OpenAI 在华盛顿特区向美国官员私下演示了一个名为 Astra 的系统,并将其描述为一个面向长时程任务的多智能体系统。公开证据仍然有限,但这条消息依然值得注意,因为回复立刻把 Astra 与多个具名系统进行了比较,而不是把这次预览纯粹当作炒作。
Anthropic 发布了迄今最清晰的公开网络安全评估复盘之一
@Pirat_Nation 报道称 (54 个赞,9 条回复,6,016 次浏览,8 个收藏) 提到了 Anthropic 的事故披露;关联的 回顾 列出了 141,006 次审查运行、三起事件,以及其中一起事件中受影响的 15 台真实机器。这种具体程度使它比泛泛的实验室安全声明更值得注意,也直接推动了当天关于信任与发布治理的讨论。
廉价智能体模型的发布如今会立刻引发“能否可靠用于生产”的问题
@FireworksAI_HQ 交付了 (7 个赞,253 次浏览,2 个收藏) 提到了 DeepSeek V4 Flash 0731 的当日上线端点,但 @codeglitch 回应 (6 个赞,4 条回复,168 次浏览) 强调,阶段标签比分数更重要。这一点之所以值得注意,是因为社交层面的反射动作正在改变:基准测试带来的兴奋仍然存在,但紧随其后的,越来越快地变成了“哪些能力可以安全进生产”的追问。
7. 机会在哪里
[+++] Agent routing, evaluation, and regression control planes - @GavinSBaker 认为 (250 个赞,18 条回复,37,628 次浏览,128 个收藏) 指向路由式模型技术栈,@omeragoldberg 认为 (5 个赞,613 次浏览,2 个收藏) 指向工单感知路由,@shivam74689 分享了 (13 个赞,229 次浏览,6 个收藏) 展示了具体的评估框架,@L1vsun 认为 (19 个赞,1 条回复,742 次浏览,10 个收藏) 指向影子运行,而 @codeglitch 认为 (6 个赞,4 条回复,168 次浏览) 则指向具备阶段意识的部署。这一方向之所以强,是因为痛点同时出现在经济性、招聘、发布实践和日常调试中。
[+++] Creator-data consent, licensing, and provenance infrastructure - @ashnichrist 解释了 (62 个赞,9 条回复,5,948 次浏览,35 个收藏) 解释了直播数据为什么有价值,以及创作者为什么需要真正的选择权;@ToonHive 报道称 (71 个赞,4 条回复,5,154 次浏览,9 个收藏) 指向退出机制传闻;@Yahiko1239170 展示了 (9 个赞,299 次浏览,5 个收藏) 则展示了滥用如何触发一刀切式产品回滚。这一方向之所以强,是因为需求是明确说出来的,用户痛点既实际又情绪化,而现有默认设置几乎无法建立信任。
[++] Durable agent memory and agent-first workflow scaffolding - @DuncanRogoff 分享了 (3 个赞,3 条回复,64 次浏览,1 个收藏) 展示了一个分层记忆系统,@lewiscarhart 分享了 (10 个赞,2 条回复,496 次浏览,8 个收藏) 展示了一个智能体优先的 CRM,而 @mikenevermiss 认为 (18 个赞,5 条回复,327 次浏览,5 个收藏) 则指出团队正在从提示词转向智能体图。这一方向为中等强度,因为真实产品已经出现,但市场仍缺少明显标准和清晰赢家。
[+] Open-weight deployment acceleration and cold-start reduction - @FireworksAI_HQ 宣布 (7 个赞,253 次浏览,2 个收藏) 展示了一个低成本长上下文端点,@TvashtaLabs 推出了 (13 个赞,1 条回复,83 次浏览,1 个收藏) 则展示了一个更快的权重流式传输器。这一方向仍属新兴,因为经济性很有吸引力,但公开证据基础仍比评估或同意机制主题更薄弱。
8. 要点
- 开放权重的优势已经上移到更高层。 最有力的证据不是一张基准测试截图,而是 Gavin Baker 关于路由和后训练的论点,以及 Porter 关于企业渠道会把 AI 变成增购项而非替代品的观点。(GavinSBaker、porterstansb)
- 评估已经成为发布技术栈的一部分。 招聘信号、框架图和影子运行建议都指向同一个方向。(gippp69、shivam74689、L1vsun)
- 信任问题立足于真实事件,而不是抽象的安全讨论。 Anthropic 披露了具体的网络安全评估失效事件,Google 则在功能被滥用后几乎立刻进行了回滚。(Pirat_Nation、Yahiko1239170)
- 创作者想要的是训练前同意,而不是事后道歉。 与 Twitch 相关的帖子聚焦于主动加入、再许可和数据付费,而不是笼统的反 AI 情绪。(ashnichrist、ToonHive)
- 构建者发布的是可复用基础设施,而不只是演示。 CRM、Agent Memory、Vajra 和 Dream Prompter 都把模型能力变成了可检查的工作流层。(lewiscarhart、DuncanRogoff、TvashtaLabs、zquestz)
- 基准测试热潮如今更快就会遭遇发布治理审视。 Codeglitch 对阶段标签的提醒,以及 Joshua Saxe 对 Inkling 分阶段访问机制的赞赏,都表明市场越来越关心什么是可靠的,而不只是哪个模型得分更高。(codeglitch、joshua_saxe)