Twitter AI - 2026-08-02
1. 人们在讨论什么
1.1 AI 工程开始走向可运营、可教学、可基准衡量(🡕)
今天信息流中最明显的变化,并不只是某个新模型的发布,而是人们开始把 AI 工作拆解为明确的操作性分工:推理服务、上下文工程、可观测性、检索、记忆和评估。保留下来的三条内容都直接支持了这一主题,而且讲的都是具体产物或技能栈,而不是泛泛的“学习 AI”建议。
@akshay_pachaar 分享(230 个赞、18 条回复、11,413 次浏览、309 次收藏)分享了一份为期 10 周的推理工程计划,围绕一个交付物展开:兼容 OpenAI 的推理服务,包含 TTFT、token 间延迟、吞吐量、队列深度仪表盘、1,000+ 并发压测、量化/推测解码扫描,以及一个成本感知路由器。相关的 仓库 比单条推文更清楚,因为它把具体技术栈写得很明白:vLLM、SGLang、Grafana、Prometheus、Docker 和 Kubernetes,并以 Roofline 模型作为概念起点。

@databricks 宣布(12 个赞、1 条回复、1,369 次浏览、8 次收藏)提到新的 Context Engineer Associate 考试;相关的 认证页面 和 发布文章 则把这项工作定义为提示词设计、检索、记忆、压缩、MCP 集成,以及借助 Unity Catalog 进行治理。@e_opore 新增(13 个赞、1,011 次浏览、6 次收藏)则从草根实践角度呈现了同一理念:一张技术栈地图,涵盖 planner/executor 架构、RAG、向量数据库、LangGraph 或 CrewAI、FastAPI 或 Node.js、PostgreSQL 或 Redis、Docker、Kubernetes、可观测性、评估和护栏。
讨论洞察: Akshay 帖子下最有价值的回复,并不是再推荐一个工具,而是纠正了实践方式。一条回复说,在碰内核之前先读懂自己的 p99;另一条回复则说推理工程仍然“没有训练营”。这说明大家渴望的是操作纪律,而不是更多模型发布摘要。
与前一天对比: 8 月 1 日已经把评估视为核心产品工作。8 月 2 日则把这一点扩展成更完整的运维课程:服务、路由、压缩、可观测性和上下文工程都成了被点名的专业方向。
1.2 关于基准测试的讨论开始反对玩具式演示,转向真实工作(🡕)
对评估的怀疑是数据集中最清晰的主题之一。最强势的帖子并没有说基准测试毫无用处,而是指出:如今最流行的测试,往往测不到实践者真正关心的东西——待办事项清空能力、与人协作的质量、长周期一致性,以及开放式科学推理。至少有六条保留内容指向同一方向。
@kunchenguid 认为(266 个赞、35 条回复、13,090 次浏览、149 次收藏)认为,新一代前沿模型之所以让人感觉“更像机器人”,是因为 RLVR 比 RLHF 更易扩展,而且更奖励机器可验证的成功,而非人类更愿意互动的方式。@leo_linsky 的回复并非简单附和,而是进一步明确了这一点:如今,编码智能与社交/协作智能看起来已经是两个可以分别衡量的维度。@kimmonismus 认为(179 个赞、23 条回复、16,660 次浏览、22 次收藏)则认为,“骑自行车的鹈鹕”这类 SVG 提示词已经无法拉开顶级模型差距,并引用 Andrej Karpathy 转发的《指环王》到 Three.js 实验作为证据:更好的测试现在更像是冗长、别扭,但真实的产物。
@Da7_Tech 认为(25 个赞、7 条回复、2,278 次浏览)表示,他已经完全不再信任单条提示词演示,而是会让某个模型连续几天担任自己的主要助手,参与规划、研究、产品决策、设计、调试、生产环境工作和评审。@HowToPrompt__ 分享(50 个赞、4 条回复、3,406 次浏览、45 次收藏)总结了 科学发现中的大型语言模型评估 这篇论文:它测试的是模型在生物学、化学、材料和物理等场景中的工作能力,而不是选择题式的科学知识回忆。@ericweinstein 认为(522 个赞、105 条回复、77,031 次浏览、250 次收藏)则从更面向公众的角度指出,正确标准不该是再出一道刁钻数学题,而应是模型能否参与数学和物理中尚未解决的理论构建问题。
讨论洞察: 今天的分歧不在于模型有没有进步,而在于基准测试到底该更像人类的真实工作、真实研究循环,还是一个真正跨越长时间尺度的产物。即便是反对意见,也默认旧式、适合刷排行榜的提示词正在失去诊断价值。
与前一天对比: 8 月 1 日把评估框定为交付的一部分。8 月 2 日则更进一步,开始直接质疑测试本身:玩具式编码提示词、预制演示和静态科学基准都被视为现实工作的糟糕代理。
1.3 开放模型的评判标准变成已验收工作、价格和可迁移性,而不是炒作(🡕)
7 月 31 日和 8 月 1 日之后,开放模型与前沿模型的讨论并没有消失,只是变得更务实。人们仍然对 Kimi K3 和 DeepSeek V4 Flash 感到兴奋,但更有意思的是,讨论很快就从发布时的榜单,转向供应商定价、Codex 兼容性、人工复核时间,以及模型是否真的能完成待办任务。
@nykdotdev 认为(44 个赞、9 条回复、3,480 次浏览、8 次收藏)认为,应该在冻结条件下,用五个真实待办任务测试 Kimi K3,预先写好验收测试,并记录人工修正耗费的分钟数,因为“每个已验收任务的成本”才是唯一重要的数字。这种谨慎之所以重要,是因为引用的 Kimi K3 发布 本身就是个硬货:开放权重、2.8T 参数、104B 激活参数、原生多模态、KDA/AttnRes,以及 1M-token 上下文窗口。@Jason 表示(83 个赞、32 条回复、9,319 次浏览)则认为,他所使用的开源模型与前沿模型之间的差距已经微乎其微;回复进一步把这一说法限定为:差距只存在于一小部分长尾任务,而不是完全不存在。
@slash1sol 报道称(54 个赞、14 条回复、1,162 次浏览、32 次收藏)称,DeepSeek V4 Flash 0731 已经可以在 ZenMux 上零成本使用,而官方 API 定价仍然很低。相关的 DeepSeek Codex 文档 证实,当时只有 deepseek-v4-flash 这一款 DeepSeek 模型通过 Responses API 接入 Codex;ZenMux 页面 还明确提到一个受速率限制的免费版本,并指出只有 DeepSeek 自己提供官方 0731 构建版本。@ZhihuFrontier 分享(28 个赞、1,689 次浏览、3 次收藏)则是一份实践者评测,认为如今 300B 级模型已足够胜任许多工程任务,但也展示了 DeepSeek V4 Flash 相比 Kimi K3 或 Claude Opus 5 仍然较弱的环节。

讨论洞察: 回复很快聚焦到隐性劳动。人们在问人工编辑时间是多少、免费端点是不是暂时补贴,以及当模型需要更多步骤或消耗更多缓存读取时,低 token 成本是否还能成立。
与前一天对比: 7 月 31 日关注的是开放权重的性价比压力,8 月 1 日则把这一叙事推进到路由和工作流控制权。8 月 2 日又加上一道更严格的筛子:开放模型能不能在现有工具链里,以足够低的成本完成已验收工作,从而值得替换现有方案?
1.4 产品表面扩展到了工作流、合规与部署后的信任(🡕)
最后一个主题是,越来越多有意思的动作发生在模型之外。构建者正把 AI 封装进工作流分享社区、工业检测系统、合规界面和安全预警层。这看起来不像新一轮聊天机器人热潮,更像是一个生态系统开始解决模型周边的一切问题。
@rowancheung 发布(30 个赞、9 条回复、5,780 次浏览、22 次收藏)介绍了他所谓的“AI 用例版 Reddit”;真正让它成为有力证据的,是回复里出现的例子:个人 AI 招聘助手、可搜索的“老板分身”,以及一款成本约一美分的本地会议助手,能转录、提取行动项并创建任务。@lukas_m_ziegler 分享(22 个赞、4 条回复、1,288 次浏览、8 次收藏)介绍了 Codya 的装配线校验器;相关的 Codya 页面 进一步说明,该公司销售的是用于运营监控的视频分析系统,而推文补充的关键实现细节是:这个用例依赖在手部遮挡情况下持续跟踪螺栓,而不是只逐帧检测螺栓有没有出现。
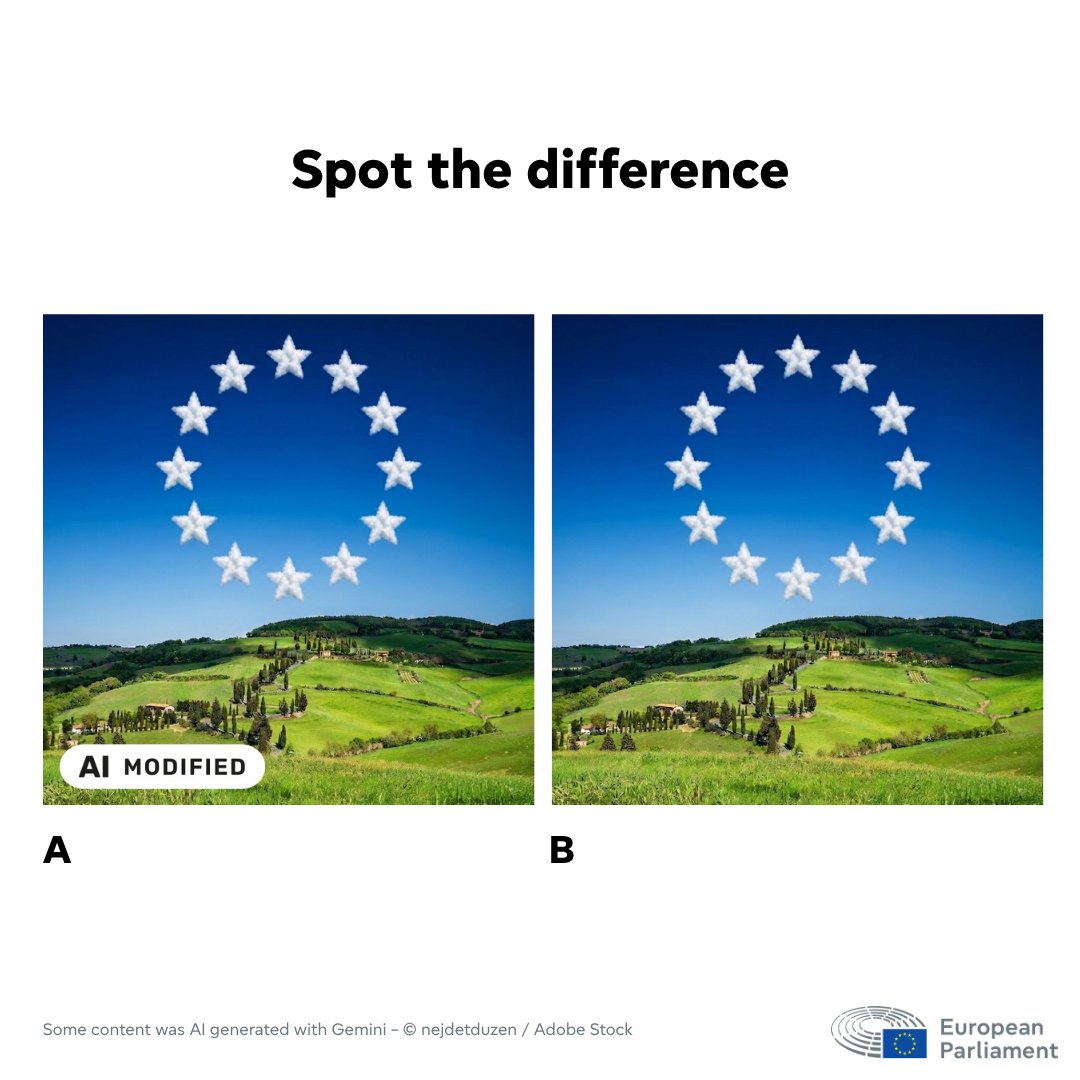
@Europarl_EN 报道称(28 个赞、5 条回复、2,998 次浏览)指出,欧盟透明度规则现在要求,对某些经 AI 修改的内容、未经审核的涉公共利益文本,以及聊天机器人进行披露。相关的 欧盟行为准则 通过明确深度伪造内容和某些文本出版物的部署者义务,把这件事具体化;附图还展示了“AI MODIFIED(AI 已修改)”标签在实际中的样子。@mardehaym 认为(14 个赞、6 条回复、987 次浏览)认为,vibe-coded 应用的发布速度已经超过其安全审查速度;相关的 Escape 报告 和 方法说明 则用一次针对 5,600 个应用的扫描支撑了这一说法:发现 2,038 个严重漏洞、400+ 个泄露的 secrets,以及 175 个暴露的 PII 实例。
讨论洞察: 这一组内容引发的意识形态争论,少于关于基准测试的争论。大家共同关心的是一个操作问题:一旦 AI 进入工作流,谁能检查它、给它打标、保障它的安全,或者在它犯错后把系统拉回来?
与前一天对比: 8 月 1 日,构建者的热情集中在记忆、服务和原生创意工具上。8 月 2 日则进一步向外扩展到用例社区、工厂质检、强制标注和应用层安全卫生。
2. 人们感到沮丧的地方
适合基准测试的模型,真实工作里却依然体验糟糕或做不成事
严重程度:高。最反复出现的抱怨,并不是模型整体太弱,而是常见的证明方式已经和日常工作脱节。@kunchenguid 认为(266 个赞、35 条回复、13,090 次浏览、149 次收藏)认为,以 RLVR 为主的训练让前沿模型在机器可验证任务上更强的同时,也变得更像机器人、更啰嗦。@kimmonismus 认为(179 个赞、23 条回复、16,660 次浏览、22 次收藏)认为,“骑自行车的鹈鹕”这类旧 SVG 测试提示词已经揭示不了太多东西;而 @Da7_Tech 认为(25 个赞、7 条回复、2,278 次浏览)则表示,真正的评估是让模型连续几天参与规划、设计、调试和生产环境工作。科学发现基准测试论文 在 @HowToPrompt__ 的放大下,以及 @ericweinstein 提出的开放问题挑战,都从另一个角度指向同一种挫败感:高基准分数仍然不能证明模型具备理论构建或研究能力。人们的应对方式包括编写验收测试、使用领域专用基准,并降低对精致演示的信任。这显然值得为之构建产品。
长上下文扩大了窗口,却没有带来更高可靠性
严重程度:高。@0x_Anni 认为(48 个赞、8 条回复、1,534 次浏览、35 次收藏)指出,模型常常在第 20 条消息左右开始重复自己,或忘记更早的指令;他把这种行为归因于上下文拉长,而不是智能突然崩溃。Chroma 的 上下文腐化 研究,为今天证据集中这一点提供了最强的公开支撑:即便在受控任务中,18 个模型也会随着输入长度增加而退化。Anthropic 自己的 Claude 5 上下文工程文章 则从厂商角度指向同一方向,主张用更简单的提示词、更好的界面和渐进式披露,而不是继续堆更多提示词内容。严重程度仍为“高”,因为压缩、检索、前缀复用、手动裁剪提示词和更好的记忆设计等应对策略,目前大多仍是定制化做法。
开放模型的低价优势,仍要经受待办任务现实的检验
严重程度:中。信息流喜欢低价访问和开放权重,但并没有完全信任它们。@nykdotdev 认为(44 个赞、9 条回复、3,480 次浏览、8 次收藏)认为,只有在把重试、工具调用失败和人工审核分钟数都算进去之后,模型仍能降低每个已验收任务的成本,它才配进入技术栈。@slash1sol 报道称(54 个赞、14 条回复、1,162 次浏览、32 次收藏)指出,DeepSeek V4 Flash 0731 在一家供应商处几乎免费,而官方价格仍然很低;但回复马上追问,这种情况是否可持续,还是只是获客手段。@ZhihuFrontier 分享(28 个赞、1,689 次浏览、3 次收藏)是一份评测,显示 DeepSeek V4 Flash 在部分 Web 和游戏工作负载中表现强劲,但在 Rust 和 iOS+server 任务上较弱;而 @Jason 表示(83 个赞、32 条回复、9,319 次浏览)则认为,开放模型已经足够接近,能胜任他大多数工作。团队的应对方式,是让多个供应商跑同一批待办任务,并统计人工清理成本。这让痛点维持在中等强度,但一直存在。
在缺乏默认安全与披露护栏的情况下发布面向公众的 AI 产品
严重程度:高。@mardehaym 认为(14 个赞、6 条回复、987 次浏览)指出,vibe-coded 应用正携带严重漏洞;相关的 Escape 研究也支持了这一说法:在扫描的 5,600 个应用中,发现了数千个暴露问题和数百个泄露的 secrets。在合规方面,@Europarl_EN 报道称(28 个赞、5 条回复、2,998 次浏览)指出,根据 8 月 2 日生效的欧盟制度,经 AI 修改的内容、某些涉公共利益文本和聊天机器人现在需要披露。可见的应对方式要么是上线后再做安全扫描,要么是在法律要求之后才补上界面级标签。这值得投入建设,因为市场显然已经跑在默认机制前面。
3. 人们希望存在什么
一条最终能落到可运行系统上的推理与上下文工程路径
人们真正想要的,似乎不是另一门泛泛的 AI 课程,而是一条从理论走向可运营基础设施的路径。@akshay_pachaar 分享(230 个赞、18 条回复、11,413 次浏览、309 次收藏)给出了一份路线图,最终交付一个带仪表盘、压测和路由器的可部署服务;而最有力的回复指出,推理工程仍然“没有训练营”。@databricks 宣布(12 个赞、1 条回复、1,369 次浏览、8 次收藏)介绍了一个围绕检索、记忆、压缩、MCP 和治理设计的上下文工程认证。@e_opore 新增(13 个赞、1,011 次浏览、6 次收藏)则提供了一张实用技术栈地图,把 agent 构建视为一门系统工程。机会类型:直接。
衡量已验收工作,而不是截图或发布榜单的评估体系
今天信息流中最明确的诉求,是一种能够跟踪团队实际交付成果的评估方式。@nykdotdev 认为(44 个赞、9 条回复、3,480 次浏览、8 次收藏)呼吁使用“每个已验收任务的成本”这一指标,并把重试、工具调用失败、复核分钟数和验收测试都内置进去。@Da7_Tech 认为(25 个赞、7 条回复、2,278 次浏览)认为,只有连续几天在真实工作流中使用模型,才能暴露其判断不稳、长上下文失效、不一致和返工问题。@kimmonismus 认为(179 个赞、23 条回复、16,660 次浏览、22 次收藏)则指出,既然旧式玩具提示词已经饱和,基准任务本身也必须升级。机会类型:直接。
让长上下文 agent 保持一致性的记忆与压缩层
今天围绕上下文的表述异常一致:更大的窗口还不够。@0x_Anni 认为(48 个赞、8 条回复、1,534 次浏览、35 次收藏)指出,更多上下文实际上可能把真正重要的指令埋掉;他在回复中明确说:“transcript is not memory(转录不是记忆)。”Anthropic 的 Claude 5 指南 也从厂商角度补充了同样的需求:相比巨型提示词,更应采用渐进式披露和更好的界面。这里的实际愿望很清晰:需要能保留意图的记忆系统、检索和压缩机制,而不是逼团队把所有内容都塞进一个窗口。机会类型:直接。
面向公众 AI 产品的默认合规与安全护栏
另一个具体需求,是让安全或合规路径成为默认路径的 AI 基础设施。@Europarl_EN 报道称(28 个赞、5 条回复、2,998 次浏览)指出,经 AI 修改的内容、某些涉公共利益文本和聊天机器人现在需要披露;官方欧盟 行为准则 则提供了相应框架和图标。@mardehaym 认为(14 个赞、6 条回复、987 次浏览)指出,面向公众的 vibe-coded 应用中已经出现数千个漏洞。机会类型:直接。
由真实用户沉淀出来的同行工作流库,而不是网红模板
@rowancheung 发布(30 个赞、9 条回复、5,780 次浏览、22 次收藏)介绍了一个围绕真实 AI 用例组织起来的社区。精选案例都指向同一个缺失的产品层:一个让构建者看到别人究竟自动化了什么、怎么组织流程,以及运行成本是多少的地方。这条推文明确将其定位为对泛化网红工作流内容的替代。机会类型:新兴。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| vLLM | 推理服务 | (+) | 是 Akshay 路线图中生产级服务、Paged Attention 和兼容 OpenAI 端点的核心参考点 | 团队仍需阅读 scheduler/block manager,并针对自身工作负载做基准测试;本身不是开箱即用的答案 |
| SGLang | 推理服务 | (+) | 在前缀复用和 batching 行为方面可作为 vLLM 的有用对照;明确被点名为工程师应部署并亲自检查的工具 | 增加了设计空间的复杂性;收益取决于工作负载结构和前缀复用情况 |
| Grafana + Prometheus | 可观测性 | (+) | 提供清晰的操作指标:TTFT、token 间延迟、吞吐量、队列深度和单请求成本仪表盘 | 只有在调优前先把埋点做好才有用;本身无法解决模型质量问题 |
| 上下文工程 | 方法 | (+) | 检索、记忆、MCP 集成、压缩和治理正被视为核心技能组合 | 仍是新兴学科,工具分散,技能缺口明显 |
| Kimi K3 | 开放模型 | (+/-) | 开放权重、1M 上下文、原生多模态,以及在长周期编码/知识工作上的强劲主张 | 今天最强的实践建议仍是:用真实待办任务测试,并统计人工修正时间 |
| DeepSeek V4 Flash 0731 | 模型/API | (+/-) | 低价甚至暂时免费的访问、Codex/Responses API 兼容性,以及第三方评测中较强的 Web/游戏 agent 得分 | 供应商基准测试需要独立核验;评测仍显示其在 Rust 和 iOS+server 任务中有弱点 |
| Claude 5 / Claude Code | 前沿模型 + harness | (+/-) | 仍是编码质量和长周期工作的高参考标准;Anthropic 现在鼓励更轻量的提示方式和更好的界面 | 用户抱怨部分较新的前沿模型感觉更像机器人,长上下文可靠性也仍会下降 |
| 每个已验收任务的成本 | 评估方法 | (+) | 把重试、复核分钟数、隐性劳动和验收测试强行纳入同一个决策指标 | 比适合截图传播的公开基准更慢、更难跑 |
总体满意度从推理基础设施和可观测性上的明显正面,一路延伸到模型选择上的褒贬不一。团队喜欢选择变多了,尤其是 Kimi K3 和 DeepSeek V4 Flash,但也反复提醒:便宜或开放,不等于适合生产。常见的变通方式包括:在真实待办任务上做基准;在优化内核前先观测队列深度和延迟;用检索或压缩代替盲目扩提示词;以及按成本、延迟和质量一起做路由。竞争态势与 7 月 31 日和 8 月 1 日保持一致:开放模型正在施加价格和兼容性压力,但要取代前沿模型的默认位置,仍必须先通过真实工作流评估。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| time-to-first-token | @akshay_pachaar | 一份为期 10 周的路线图,最终交付可部署的兼容 OpenAI 的推理服务和可复现的基准测试 harness | 弥合“读过推理资料”和真正把它跑起来、测起来、调起来之间的差距 | Python、vLLM、SGLang、Grafana、Prometheus、Docker、Kubernetes | 已发布 | 推文、仓库 |
| Kimi K3 | @Kimi_Moonshot | 面向长周期编码、知识工作和推理的开放权重前沿多模态模型 | 为团队提供一个可与闭源默认模型对比测试的前沿级开放模型 | 2.8T MoE、KDA、AttnRes、MoonViT-V2、1M 上下文 | 已发布 | 推文、博客、仓库 |
| DeepSeek V4 Flash 0731 | @deepseek_ai | 通过 Responses API 和兼容 Codex 的工具提供的高效率 agentic coding 模型 | 降低在现有编码工具中尝试强 agent 工作流的成本 | 284B MoE、13B 激活参数、1M 上下文、Responses API | Beta | 推文、文档、服务提供商页面 |
| Codya Video Analytics | Codya(由 @lukas_m_ziegler 分享) | 用于装配校验和运营监控的视频分析系统 | 处理工厂流水线上的边缘情况,例如手部遮挡下的螺栓跟踪,而简单 CV 往往会失效 | 计算机视觉、视频分析、ML 监控 | 已发布 | 推文、网站 |
| Databricks Certified Context Engineer Associate | @databricks | 面向可靠 AI agents 上下文工程的认证和培训路径 | 弥补检索、记忆、压缩、工具集成和治理方面的技能缺口 | Databricks、AI Search、Lakebase、MLflow、MCP、Unity Catalog | Beta | 推文、页面、博客 |
time-to-first-token 这个仓库之所以突出,是因为它把 AI 基础设施视为一种必须靠交付来证明的能力:先做出一个服务、一套仪表盘和一个压测 harness,然后只在有测量数据之后,再去做越来越昂贵的优化。这与当天对脱节教程和基准截图的普遍不满完全一致。
Kimi K3 和 DeepSeek V4 Flash 从模型侧展现了同样的构建模式:两者都不再只是抽象的研究发布,而是被定位为今天就能接入编码和 agent 工作流的东西。区别在于,Kimi K3 是以大型开放权重前沿押注的姿态登场,而 DeepSeek V4 Flash 则以低价、可替换的工作马身份出现,人们可以通过现有 Codex 风格接口来测试它。
Codya 是数据集中最清晰的非模型构建案例。有意思的地方并不是抽象地说“AI 在看装配线”,而是这个产品必须在工人的手挡住视线时,仍然记住哪颗螺栓是哪颗。这正是那类比“通用助手”宣传更能赢得信任的、狭窄但有价值的生产问题。
这些项目反复呈现出一个模式:构建者正在把那些不可见层产品化,包括服务、上下文、评估、合规和工作流发现。@rowancheung 上线 提到的用例社区,也是同一转变的一部分。相比再造一个新模型,他做的是一个帮助用户发现他人已验证工作流的入口。
6. 新动态与值得关注的内容
欧盟透明度规则变成了真实的界面要求
@Europarl_EN 报道称(28 个赞、5 条回复、2,998 次浏览)指出,针对某些经 AI 修改的内容、未经审核的涉公共利益文本和聊天机器人,新披露义务已于 8 月 2 日生效。官方欧盟 行为准则 及相关指南之所以重要,是因为它们把“给 AI 打标”从模糊规范变成了具体的部署者/提供方框架,并提出标准图标和机器可读标记的要求。
Databricks 试图把上下文工程定义为独立岗位
@databricks 宣布(12 个赞、1 条回复、1,369 次浏览、8 次收藏)介绍了首个 Context Engineer Associate 考试。它的意义不在于推文互动量,而在于 官方资料 所说的这份工作如今包含什么:推理时的检索、记忆、压缩、工具集成和治理。这是一个具体信号,表明上下文工程正在成为被认可的专业方向,而不只是流行词。
开放模型已经从发布讨论进入可插拔工作流阶段
关于 Kimi K3 的 @nykdotdev 与关于 DeepSeek V4 Flash 的 @slash1sol 合在一起,标志着一个值得注意的成熟节点。Kimi K3 带着开放权重、多模态和长周期能力主张登场;DeepSeek V4 Flash 则带着即时 Codex 兼容性,以及部分供应商处的临时免费访问到来。真正有意思的,不只是两者都存在,而是讨论如此迅速地转向验收测试、修正时间,以及在真实工具里替换 base URL。
7. 机会在哪里
[+++] 基于工作负载的 AI 质检与路由 —— 第 1、2 和 4 节都出现了证据:人们希望衡量已验收任务、重试、人工复核分钟数、长上下文失效和恢复行为,而不是相信演示或公共排行榜。这一机会很强,因为实践者和高互动评论者都反复提到了这一痛点,而且今天的应对方式仍然是手工操作。
[+++] 推理与上下文工程的运营层 —— Akshay 的仓库、Databricks 的认证推动,以及反复出现的技术栈图,都指向同一个缺口:团队需要把服务、可观测性、检索、记忆、压缩和治理组装成可用整体。这一机会很强,因为缺失的不是模型,而是围绕模型的操作系统。
[++] 长上下文记忆压缩与状态管理 —— 上下文腐化讨论、Anthropic 对提示词简化的建议,以及反复出现的“转录不是记忆”区分,都说明这里存在真实的产品缺口。证据表明,更长的窗口本身解决不了一致性问题,因此能更智能地压缩、检索并保留意图的工具仍有空间。
[++] 面向公众 AI 应用的默认合规与安全护栏 —— 欧盟标注制度与 Escape 对 vibe-coded 应用的扫描,从不同方向指向同一个机会:团队需要在发布前就默认具备披露、政策检查、secret 扫描、访问控制审查和安全发布护栏。这个机会中等偏强,因为监管与安全失败已经可见,而不是假设性问题。
[+] 工作流库与同行用例社区 —— Rowan Cheung 发起的用例社区表明,一个规模较小但真实存在的新需求正在浮现:构建者想看其他操作者的案例,而不只是网红提示词包。这是一个早期信号,但它与从模型迷恋转向工作流落地的更大趋势一致。
8. 要点
- AI Twitter 在 8 月 2 日把模型周边的技术栈进一步运营化。 最明显的热情集中在服务、可观测性、上下文工程、检索和记忆,而不是又一次泛泛的模型比较。(来源)
- 对基准测试的怀疑,已经硬化为对真实工作评估的需求。 实践者想看到的是已验收任务、多天工作流试用,以及更难的产物级或科学测试,而不是发布榜单和玩具提示词。(来源)
- 开放模型已经足够接近,足以迫使团队做真正的替换实验,但还没有接近到能消除复核开销。 Kimi K3 和 DeepSeek V4 Flash 被视为严肃选项,但讨论始终回到修正时间、薄弱领域和供应商差异。(来源)
- 长上下文仍然是可靠性问题,而不是一个已经解决的功能。 今天最可操作的建议,是做压缩、检索和渐进式披露,而不是继续往窗口里塞更多 token。(来源)
- 模型之外的表层,如今也成了产品的一部分。 用例社区、工厂质检系统、AI 标签和安全扫描都说明,价值与风险越来越多地位于工作流封装、合规和部署后控制层。(来源)