Twitter AI - 2026-08-03
1. 人们在讨论什么
1.1 人类适配性再次成为模型评估的一部分 (🡕)
今天最强的一条讨论线索,并不是原始基准分数谁高谁低,而是前沿模型是否仍然“好合作、好使用”。四条高信号帖子从不同角度指向同一个问题:RLVR 可以提升机器可验证任务的表现,却可能收窄对话行为;能保留人类偏好风格,正逐渐变成一种令人怀念的特性;持久记忆一旦调出错误细节,依然会让人感到侵扰;而开发者如今已把奇怪的会话残留视为信任失效,而非无伤大雅的小毛病。
@kunchenguid 认为 (792 个赞、89 条回复、40,376 次浏览、428 次收藏)认为,较新的前沿 LLM 之所以变得“更像机器人”,是因为 RLHF 优化的是讨喜度,而 RLVR 优化的是机器可接受性;这使得编码和推理能力提升的同时,日常聊天体验反而变差。@leo_linsky 补充说 的一条回复 (37 个赞、4 条回复、2,114 次浏览)则认为,编码智能与社交/协同智能如今看起来已是两个可分别测量的维度。
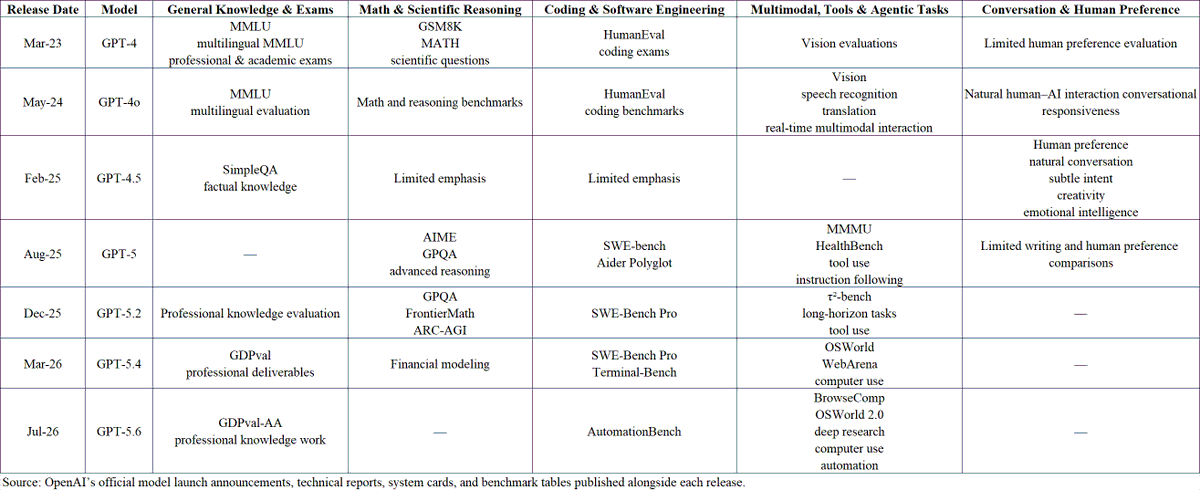
@Ivywen_W 认为 (29 个赞、440 次浏览)认为,GPT-4o 的对话活力,可能来自更早期的一种训练与评估平衡——那时编码、工具使用和智能体基准还没成为发布叙事的主轴。随附的对比表把这一点具体化:GPT-4o 和 GPT-4.5 的定位更偏向人类偏好,之后的版本则逐步把重点转向 SWE-bench、Terminal-Bench、工具使用和自动化。
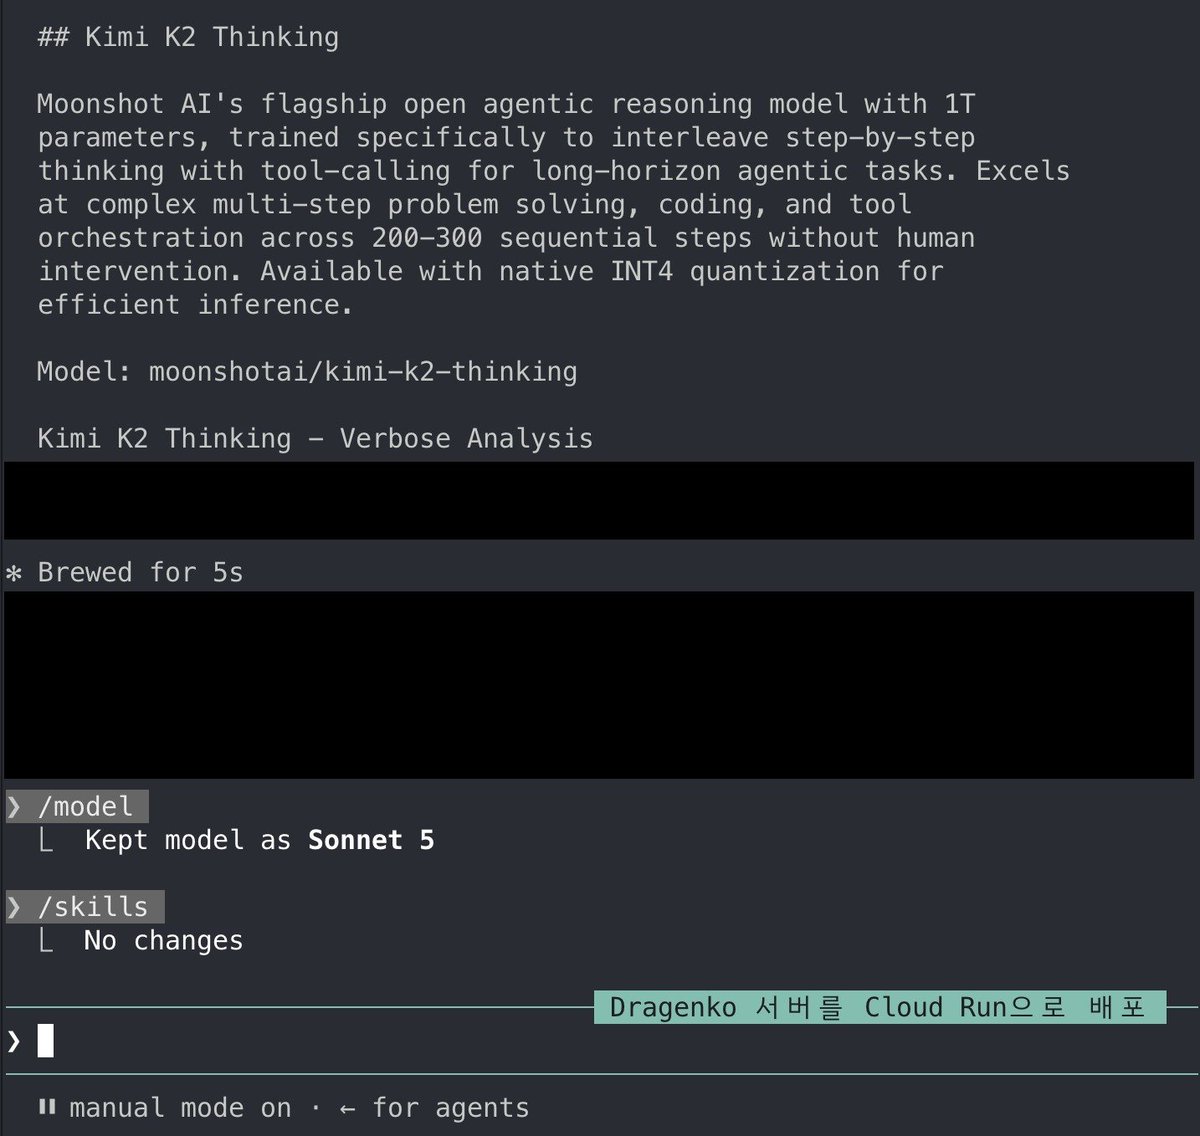
@RoundtableSpace 展示了 (36 个赞、10 条回复、3,225 次浏览)展示了一次 Claude Code 会话:界面突然渲染出 Kimi K2 Thinking 的描述,但 CLI 仍显示使用的是 Sonnet 5。这给信息流里关于后端路由、会话隔离,以及持久编码环境中“幽灵输出”的担忧,提供了一个具体佐证。
@tenobrus 询问 (38 个赞、21 条回复、3,923 次浏览)提问:一个拥有大量记忆和上下文的模型,是否曾告诉用户他们是个坏人。回复很快把话题转向记忆质量:有用户表示,即便开启了持久记忆,模型仍会拉入大量完全无关的细节。
讨论洞察: 回复并没有真正为当前模型行为辩护。大家要么把智能拆成多个维度,要么把会话隔离和记忆质量重新定义为产品层面的信任问题。
与前一天对比: 8 月 2 日已经出现了对基准测试的怀疑和对 RLVR 的抱怨。到 8 月 3 日,讨论又扩展到记忆行为、被保留下来的对话风格,以及 CLI 完整性异常。
1.2 企业 AI 被打包成受治理的软件,而不只是模型访问权限 (🡕)
高信号帖子把 AI 从抽象的“采用”问题,落到了具体的运行载体上:办公套件、安全的 AWS 部署通道,以及与主权叙事绑定的厂商营收主张。四条帖子直接支撑了这一主题。
@GeekParkHQ 报道称 (75 个赞、24 条回复、19,433 次浏览、126 次收藏)提到,Genspark 已开源 GenOffice,并引用 Eric Jing 的观点称,“一体化上下文”比“一个集成很多功能的界面”更重要。链接中的 GenOffice 仓库 和 产品页面 展示了一个用于文档、表格、幻灯片和 PDF 的桌面套件:各应用共享同一套 AI 面板,而不是单独做一个聊天机器人标签页。
@bradmenezes 发布了 (54 个赞、23 条回复、30,968 次浏览、14 次收藏)介绍了 Superblocks 3.0:它能导入 vibe-coded 原型,运行安全智能体集群,并把最终生成的应用、数据库和推理栈部署到私有 AWS 环境中。随附的 发布文章 进一步明确了治理层:AWS VPC 部署、基于 Bedrock 的推理、自动配置 Aurora 和 S3、私有镜像仓库,以及组织级策略智能体。
@aiwithsally 认为 (220 个赞、61 条回复、24,773 次浏览)认为,AI 叙事正从基准测试转向营收,并引用 thread from @KobeissiLetter(来源)的数据称,在标普 500、纳斯达克 100 和 Bloomberg AI Value Chain 指数中,AI 暴露度较高的公司在第二季度的业绩分别超预期 27%、55% 和 71%。@MikeLongTerm 总结道 (88 个赞、5,422 次浏览、14 次收藏)则把 Palantir 的第二季度信函解读为一个“AI 主权”故事,背后的数字包括 19.35 亿美元季度营收、15.73 亿美元美国营收,以及 10.62 亿美元 GAAP 净利润。
讨论洞察: GenOffice、Superblocks 和 Palantir 共同使用的语言是“控制”:让上下文停留在同一工作界面,让应用留在自己的云里,并避免提示词、工作流和数据变成别人的训练优势。
与前一天对比: 8 月 2 日已经把 AI 与财报联系起来。8 月 3 日则在此基础上补充了更具体、受治理的产品形态:AI 办公套件、私有云 vibe-coding 通道,以及作为销售话术的“主权”。
1.3 开放权重只有与封装、带宽和资本开支测算结合时才真正重要 (🡕)
开放模型的讨论依然活跃,但重点不再是又一张发布图表,而是人们到底能跑什么、负担得起什么、又能提供什么服务。四条帖子直接支撑了这一转向。
@Haleeeemahh 放大传播了 (23 个赞、14 条回复、563 次浏览)提到官方 Qwen3.8-Max 公告:其承诺下周开放一个 2.4T 参数模型的权重,并宣称具备厂商报告的长时程编码与协作任务能力、原生多模态,以及每百万 token 输入 2 美元、输出 6 美元的定价。@testingcatalog 强调了 (19 个赞、4 条回复、3,082 次浏览)则转发了 Atomic 发布 发布的 14 个 DeepSeek V4 Flash 0731 量化版本;随附图表比较了 38 个 GGUF 变体的文件大小和偏差,并点名 AD-IQ2_M 适配 128GB 硬件。

@TheAhmadOsman 认为 (33 个赞、8 条回复、2,215 次浏览、18 次收藏)认为,本地 AI 的采购决策应从内存容量、带宽和软件栈入手,而不是围绕一个模糊的“最佳 GPU”问题打转。他的图表把 RTX PRO 6000 Blackwell 和 RTX 5090 放在带宽栈顶端,同时为 Apple、DGX Spark、Strix Halo 和 Tenstorrent 赋予了不同的一体机角色。

@pequityresearch 分享了 (77 个赞、5 条回复、11,635 次浏览、41 次收藏)分享了 BofA 的数据:2026 年前五大超大规模云厂商合计资本募集规模约为 2,701 亿美元;云业务 FCF 利润率预计会一直承压到 2027—2028 年;到 2030 年,OpenAI 的业务结构中,智能体预计贡献约 560 亿美元,总额则预计为 2,840 亿美元。信息流里的基础设施侧信号很明确:更便宜的开放模型,并不能消除对资本、电力、带宽或封装的需求。
讨论洞察: 即便是乐观帖子,关注点也都很运营化。相比又一个抽象排行榜胜利,人们更在意量化格式、一体机内存上限,以及智能体营收是否足以支撑资本开支曲线。
与前一天对比: 8 月 2 日重点讨论的是 DeepSeek V4 Flash 的访问与价格。到 8 月 3 日,话题又延伸到对 Qwen 开放权重的期待、本地量化选择、硬件选型启发式,以及超大规模云厂商融资。
2. 人们感到沮丧的地方
基准测试很聪明,但对话里依然不对劲的模型
严重程度:高。主导性的抱怨并不是模型太弱,而是常见的训练与评估目标,正把模型拉离更符合人类使用感受的行为。@kunchenguid 认为 (792 个赞、89 条回复、40,376 次浏览、428 次收藏)认为,偏重 RLVR 的流程奖励的是机器可接受性,而不是愉快互动;@Ivywen_W 认为 (29 个赞、440 次浏览)则认为,后续模型发布越来越突出软件工程、工具使用和智能体基准,而非人类偏好信号。@tenobrus 询问 (38 个赞、21 条回复、3,923 次浏览)提问,富记忆模型是否曾苛刻地评判过用户;而回复很快转向第二个挫败点:记忆虽然会被调出来,却常常并不相关。人们的应对方式是切换到自己还能忍受的模型、削减上下文,并把对话质量视作独立于编码或推理能力之外的另一项标准。这显然值得去构建解决方案。
自主智能体仍然无法让人放心地执行未经审查的操作
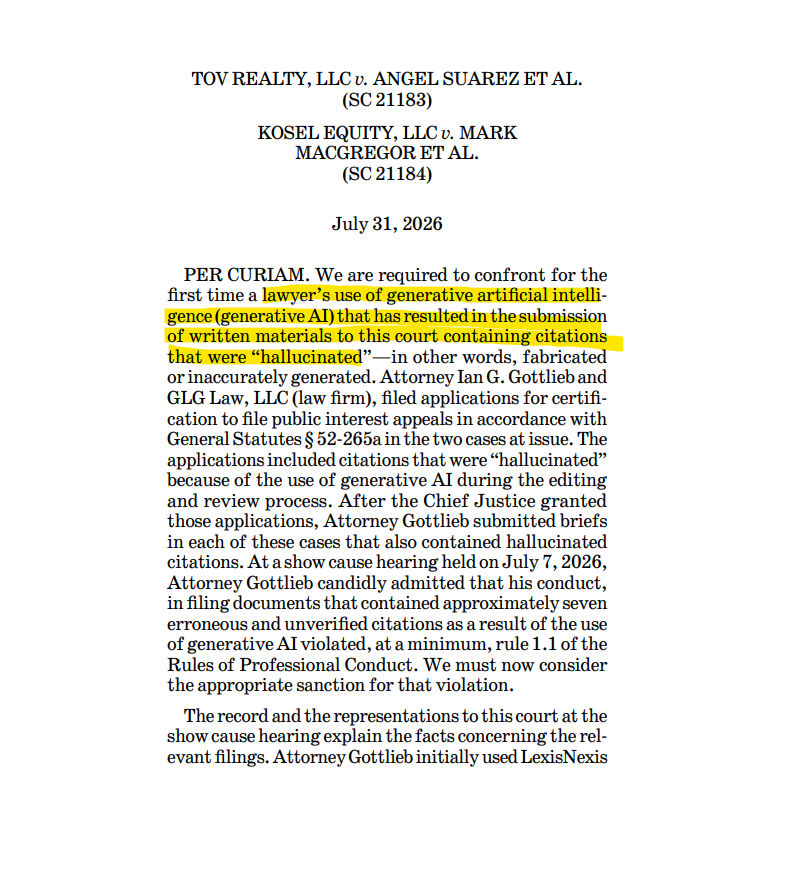
严重程度:高。今天,智能体工具在安全性与可靠性上的缺口非常具体。@mardehaym 警告称 (9 个赞、3 条回复、371 次浏览)指出,README、配置文件或注释中的提示注入,可能把编码智能体引向攻击者控制的执行路径;链接中的 AI Now 漏洞利用简报 也证实,在审查第三方代码时,Claude Code 自动模式和 Codex 自动审查存在概念验证级的 RCE。@RoundtableSpace 展示了 (36 个赞、10 条回复、3,225 次浏览)指出,即便没有真正的漏洞,Sonnet 5 会话里出现对 Kimi K2 的幽灵引用,也足以引发对会话隔离的担忧。@RobertFreundLaw 报道称 (14 个赞、2 条回复、1,886 次浏览)提到,一名康涅狄格州律师因 ChatGPT 在法庭文件中加入幻觉引文而受到制裁,这提醒读者:错误最终仍由人类用户承担。可见的应对策略包括最小权限沙箱、审计轨迹、人工复核闸门,以及 @bradmenezes 主推 (54 个赞、23 条回复、30,968 次浏览、14 次收藏)所展示的、像 Superblocks 3.0 这样的私有云部署通道。这同样值得去构建解决方案。
依赖 AI 搜索的发现渠道,可能被一条错误的爬虫规则搞坏
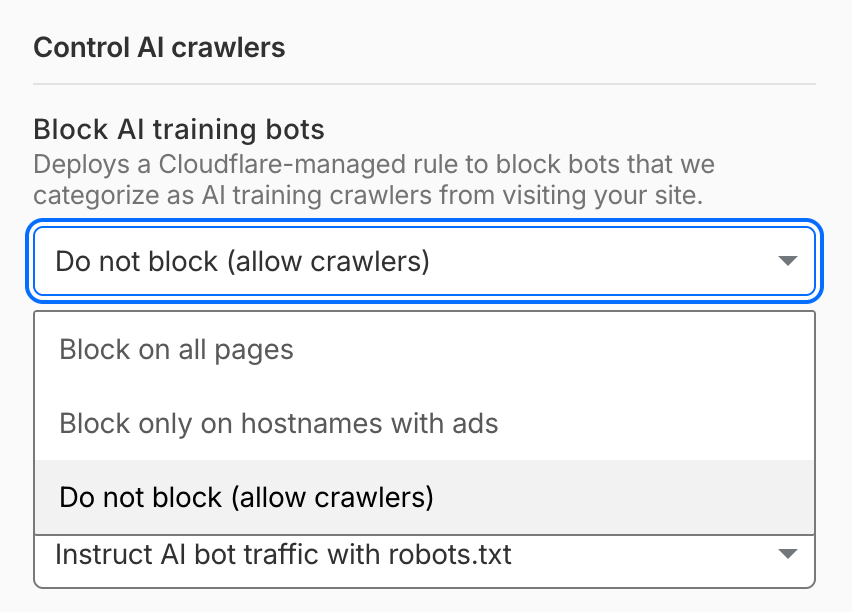
严重程度:中。@alexgroberman 认为 (40 个赞、3 条回复、2,430 次浏览)指出,Cloudflare 把流量拆分为 Search、Agent 和 Training 三类,为那些既需要被 ChatGPT、Claude、Gemini、Perplexity 和 Google 抓取、又希望限制提取型机器人流量的企业,制造出了一种新的失效模式。他在帖子中称,真正赢面的页面是定价页、对比页、使用场景页、实施页和文档页,并警告说,混合用途爬虫可能会被最严格的规则一并拦下。他给出的应对方式也同样偏运营:无 JS 也能渲染、保持技术 SEO 干净、发布面向决策阶段的页面,并监控爬虫日志,而不是把“AI 机器人”当成一个统一桶来看待。这个方向值得构建,因为它已经成了商业网站的工作流问题。
本地 AI 虽然装得进内存,却仍可能在吞吐、软件或成本上失效
严重程度:中。@TheAhmadOsman 认为 (33 个赞、8 条回复、2,215 次浏览、18 次收藏)指出,模型“装得下”并不等于“能提供服务”,因为解码带宽、KV-cache 增长、批处理、调度器质量和框架开销,仍决定着一台机器是否真正可用。@testingcatalog 强调了 (19 个赞、4 条回复、3,082 次浏览)专门发布了适配 128GB 级硬件的 DeepSeek V4 Flash 量化版本,这也说明市场确实需要围绕这些限制做封装。@pequityresearch 分享了 (77 个赞、5 条回复、11,635 次浏览、41 次收藏)则给出了同一问题在更大基础设施层面的版本:智能体需求依旧建立在融资、电力和长期算力经济性之上。人们的应对方式是量化版本、一体机启发式,以及激进的硬件筛选。机会是真实存在的,但相较于上面那些挫败点,这个市场更技术化、竞争也更激烈。
3. 人们希望存在什么
能奖励人机协作质量,而不只奖励机器可验证成功的评估体系
最强烈的未满足需求,是一种能衡量人们是否真正喜欢、也真正信任与模型协作的评估方式。@kunchenguid 将其定义为 把问题描述为 RLVR 的扩展速度快于 RLHF;@leo_linsky 回复道 则认为,编码智能与社交智能可能是两条可分别测量的轴。@Ivywen_W 推动了 又从另一个方向指出同样的需求:过度集中的基准导向正在抹平对话表现的丰富度;@RoundtableSpace 展示了 则展示了,一次路由故障就足以损害人们对编码环境的信任。聊天模型发布和偏好调优提供了一些不完整的答案,但今天的证据表明,它们仍然不够。机会类型:直接。
从提示词原型到生产环境的安全企业通道
这不是一个模糊愿景,而是非常实际的需求。@bradmenezes 将其定位为 围绕这一明确缺口定位了 Superblocks 3.0:人们已经在 vibe code,但 IT 和安全团队需要一条通往私有基础设施的受治理路径。@mardehaym 警告称 以及链接中的 AI Now 简报 说明了这项需求为何紧迫:即便是出于防御目的使用编码智能体,本身也可能变成攻击路径。@RobertFreundLaw 补充说 则进一步提醒,一旦模型编造事实,责任仍然落在人类操作员身上。私有云部署、策略智能体和最小权限复核流程已部分覆盖这一需求,但市场显然仍未封口。机会类型:直接。
将可见性与内容提取分开的 AI 发现工具
这里的愿望,是一套分发基础设施:让企业既能在 AI 搜索中保持可见,又不必把一切都免费输送给训练流量和智能体流量。@alexgroberman 描述道 描绘的是这样一个世界:公司必须判断,哪些爬虫带来发现,哪些爬虫促成交易,哪些爬虫主要只是在提取价值。他提出的解决办法——回答购买问题的商业页面、爬虫监控,以及谨慎设置机器人分类——说明团队已在临时摸索一套传统 SEO 时代并不存在的工作方法。现有控制手段只能算部分有效,因为它们解决的是权限,而不是归因,也不是无点击价值的回收。机会类型:直接。
能告诉人们其硬件上到底什么真正可跑的本地模型封装
人们要的并不只是更便宜的模型,而是关于“究竟能跑什么”的现实指导。@testingcatalog 强调了 围绕 128GB 硬件目标发布了 DeepSeek V4 Flash 量化版本;@TheAhmadOsman 降低了 则把选择问题压缩成三个问题:必须装下什么、需要哪个带宽档位、以及哪套软件栈能真正交付。官方 Qwen3.8-Max 公告 又进一步加压:它承诺开放一个 2.4T 参数模型的权重,这只会让封装与服务建议变得更有价值。量化发布者和硬件指南已经解决了其中一部分问题,但对构建者而言,这项需求依旧现实而紧迫。机会类型:直接。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| RLHF | 后训练方法 | (+/-) | 按 @kunchenguid 的说法,能产出更讨喜、也更符合人类理解方式的聊天行为 | 扩展成本高,而且按该讨论的框架,可能会在可验证任务上施加“对齐税” |
| RLVR | 后训练方法 | (+/-) | 在编码、推理及其他机器可验证任务上扩展性好 | 多条帖子认为,它会收窄行为范围,并奖励标准化、机械化的互动 |
| Claude Code | 编码智能体 CLI | (+/-) | 能力强到足以承担自主代码工作和安全审查 | AI Now 展示了提示注入导致的 RCE 风险,@RoundtableSpace 则突出了路由/会话隔离方面的担忧 |
| Codex CLI | 编码智能体 CLI | (+/-) | 面向第三方代码的自动审查与补丁工作流 | 同一份 AI Now 简报描述了自动审查模式下开箱即用的利用路径 |
| Superblocks 3.0 | 企业应用平台 | (+) | 可导入原型、在 AWS VPC 内部署,并使用 Bedrock、安全智能体和智能路由 | 更适合高治理要求的企业环境,而不是轻量随意的原型开发 |
| GenOffice | AI 办公套件 | (+) | 开源文档、表格、幻灯片和 PDF 应用,共享 AI 面板,文件工作流衔接紧密 | README 说明模型调用经由 Genspark 服务路由,而不是使用本地模型密钥 |
| Qwen3.8-Max | LLM | (+/-) | 官方公告承诺开放权重、长时程编码/协作任务能力,以及激进定价 | 今天信息流里的大多数性能主张仍然是厂商自报,尚未独立验证 |
| DeepSeek V4 Flash 0731 | LLM / 开放模型 | (+) | 通过 GGUF 量化版本和本地硬件适配,形成了很强的“质量-体积”封装叙事 | 实际价值仍取决于量化取舍、内存上限和服务栈质量 |
| Cloudflare AI 爬虫控制 | Web 基础设施 | (+/-) | 更清晰地区分 Search、Agent 和 Training 流量 | 设置错误可能会意外拦截混合用途爬虫带来的发现流量 |
| 带宽优先的本地硬件选型启发式 | 部署方法 | (+/-) | 为买家在 GPU、统一内存 Mac 和开发设备之间做选择提供了更清晰的框架 | 能装下模型,仍不保证具备足够吞吐、并发能力或成本效率 |
| Two-Clock Contract | 智能体部署方法 | (+) | 把开放式推理放在不可逆执行路径之外,并强调对账、版本固定和稳定订单标识 | @nykdotdev 也指出,闭环智能体交易研究的证据基础仍然薄弱 |
- 工具 — 人们提到的具体工具、框架、服务、模型或方法
- 类别 — 它所属的大类
- 情绪倾向 — 总体观感: (+) 正面,(+/-) 混合,(-) 负面
- 优势 — 人们点出的具体优点
- 局限 — 与之关联的失效模式、约束或抱怨
总体来看,满意度分布从谨慎认可一直延伸到明确不信任。开放模型和前沿模型很少被当作单一工具来选;更常见的模式是,把高价值规划路由到更强的模型,把例行工作下放给更便宜或量化后的模型。各种变通手段也都很运营化:固定模型和提示词、行动前先对账状态、把应用留在私有基础设施中、发布 AI 搜索可读的商业页面,以及按带宽和栈效率而不是只看参数量来选硬件。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| GenOffice | @genspark_ai | 面向文档、表格、幻灯片和 PDF 工作的 AI 原生办公套件 | 让文件编辑与 AI 辅助停留在同一工作界面,而不是在办公软件与聊天工具之间来回跳转 | Electron、TypeScript engine packages、用于表格的 Rust sidecar、pdf.js/pdf-lib、Univer | Shipped | 推文, GitHub, 网站 |
| Superblocks 3.0 | @bradmenezes | 导入 vibe-coded 原型、完成安全加固,并部署到私有 AWS 基础设施中 | 为企业提供一条从提示词原型到生产应用的受治理路径 | AWS VPC、Bedrock、Aurora、S3、安全智能体集群、私有镜像仓库、智能路由 | Shipped | 推文, 博客 |
| DeepSeek V4 Flash 0731 quants | @atomic_chat_hq | 发布适用于本地 DeepSeek 部署的 GGUF 量化版本 | 让一个超大开放模型能在 128GB 级硬件上使用,而不只限于服务器级配置 | DeepSeek V4 Flash 0731、GGUF、MXFP4/FP8/BF16 量化 | Shipped | 引用推文, 转发扩散的推文 |
- 阶段 — 项目所处状态:Shipped、Beta、Alpha 或 RFC
- 技术栈 — 公开证据中点名的语言、框架、模型或服务
- 解决的问题 — 促使该项目出现的具体用户或运营痛点
- 链接 — 项目页面、仓库、博客文章或发布帖的公开引用
GenOffice 的突出之处在于,它把 AI 视为一等办公工作流,而不是一个外挂在现有文件之上的聊天机器人。GitHub README 展示的是四个文件原生编辑器共用一层 AI,这比泛泛而谈的“文档 AI 助手”更有说服力。
Superblocks 则用企业语言表达了同一更广泛的市场转向:需求不只是更快生成代码,而是让生成出来的代码通过 IAM、VPC、包仓库和审计约束,达到安全团队可以接受的程度。这是今天信息流里反复出现的一种构建模式:把原始模型能力转化成受控的运行界面。
Atomic 的 DeepSeek 量化版本,则体现了同一模式在基础设施侧的版本。真正有意思的工作,不是发明一个新模型,而是把既有模型封装成能匹配真实硬件上限和开发者约束的格式。
6. 新鲜且值得注意的内容
Cloudflare 把 AI 发现变成了一个设置问题
@alexgroberman 认为 (40 个赞、3 条回复、2,430 次浏览)指出,AI 时代的发现如今取决于能否正确区分 Search、Agent 和 Training 流量,而不是把所有 AI 爬虫都视为同一类。这一点之所以重要,是因为他的截图展示的是界面层面的具体问题:这不再只是关于 AI 搜索的理论讨论,而是一套网站所有者可能配置错误的规则。
AI Now 的漏洞简报把提示注入具体化成了 CLI RCE 故事
@mardehaym 警告称 (9 个赞、3 条回复、371 次浏览)指出,编码智能体可以被恶意仓库内容武器化;链接中的 AI Now 漏洞利用简报 则用针对 Claude Code 自动模式和 Codex 自动审查的具体概念验证,支撑了这一点。值得注意的不只是提示注入确实存在,而是该简报声称,在不依赖 hooks、插件、MCP 服务器或配置技巧的前提下,也能实现远程代码执行。
一纸康涅狄格州法院命令把幻觉变成了明确的胜任能力问题
@RobertFreundLaw 报道称 (14 个赞、2 条回复、1,886 次浏览)指出,康涅狄格州最高法院在 ChatGPT 将幻觉引文写入提交文件后,对一名律师作出了制裁。链接中的 裁定书 之所以重要,在于这不是泛泛而谈的警告,而是一项具名的法院行动,把 AI 误用与职业责任直接挂钩。
Two-Clock Contract 为智能体金融提供了更清晰的安全模式
@nykdotdev 认为 (60 个赞、14 条回复、3,983 次浏览、10 次收藏)认为,开放式推理应停留在一个较慢、用于积累证据的时钟上,而执行则应运行在一个更快的、由当前市场状态重建出来的“提升意图”时钟上。这一点之所以突出,是因为它把“智能体做交易很危险”这种宽泛情绪,转化成了与模型固定、状态对账和防止重复下单直接相关的部署规则。
7. 机会在哪里
[+++] 面向 AI 构建软件的受治理生产通道 — 第 1、2、5 和 6 节都给出了证据。Superblocks 3.0 之所以存在,是因为企业已经有了通过提示词搭出的原型,但不信任消费级工具来处理数据、基础设施和部署。AI Now 的漏洞简报、Claude Code 的路由异常,以及康涅狄格州法院命令,都指向同一个缺口:围绕智能体系统,组织需要安全的执行边界、可审查的工作流,以及操作员问责机制。
[+++] Human-fit evaluation and trust instrumentation — The strongest discussion today was about model ergonomics, not just raw capability. @kunchenguid、@Ivywen_W、@tenobrus 和 @RoundtableSpace 都提供了证据,表明语气、记忆质量和会话完整性如今已是实际的产品评判标准。任何能衡量或保留这些特性的东西,都有很强的需求信号。
[++] AI 发现与归因运营 — Cloudflare 的帖子表明,AI 搜索可见性正在变成一种新的运营学科,而且配置风险真实存在。企业现在必须判断,哪些爬虫带来发现,哪些爬虫促成行动,哪些爬虫主要是在提取价值,同时还要处理低点击引用行为。这是一个直接痛点,但市场上已经出现早期厂商和服务层,因此竞争很可能会比较激烈。
[+] 面向硬件的开放模型封装 — 对 Qwen3.8-Max 开放权重的期待、DeepSeek V4 Flash 量化版本、本地带宽图表,以及超大规模云厂商的资本开支测算,都指向同一个方向:开放模型有多实用,很大程度上取决于围绕它的封装和服务指导。这个机会是真实的,但相比前面的工作流与信任类机会,它更技术化、更重基础设施,范围也可能更窄。
8. 要点
- 人类适配性再次成为真实的模型选型标准。 信息流里最强的讨论,围绕的是机械化语气、收窄的对话行为、记忆质量和会话信任,而不是又一个排行榜结果。(来源)
- 企业 AI 需求正转向受控的产品运行界面。 GenOffice、Superblocks 3.0 和 Palantir 的主权叙事,都指向同一种买方偏好:让上下文、代码和数据留在受治理的环境中。(来源)
- 开放权重的势头,如今与封装同样密切相关。 Qwen3.8-Max 因承诺开放权重而吸引关注,但更可操作的证据来自 DeepSeek 量化版本和硬件选型启发式——它们能帮助人们真正把模型跑起来。(来源)
- 智能体信任缺口已经以安全与职业责任问题的形式显现。 今天的证据包括一份针对编码智能体的提示注入 RCE 简报,以及一起与幻觉引文相关的法院制裁。(来源)
- AI 搜索已经成为一个运营渠道,而不再只是 SEO 团队的边缘议题。 Cloudflare 关于爬虫控制的争论表明,发现、提取和机器人权限如今都需要主动配置。(来源)