Twitter AI - 2026-08-09
1. 大家在讨论什么
1.1 记忆与评测已从智能体叙事转向策略、预算和连续性控制(🡕)
8 月 9 日最明确的技术主题是:构建者不再满足于泛泛而谈“更好的智能体”,而是希望明确回答三个更棘手的问题:智能体该记住什么、在性能开始退化前能处理多少工具,以及当企业策略挡住那条最省事的路径时会发生什么。五条入选内容共同支撑了这一主题,涵盖论文、一手失败报告和自托管基础设施架构图。
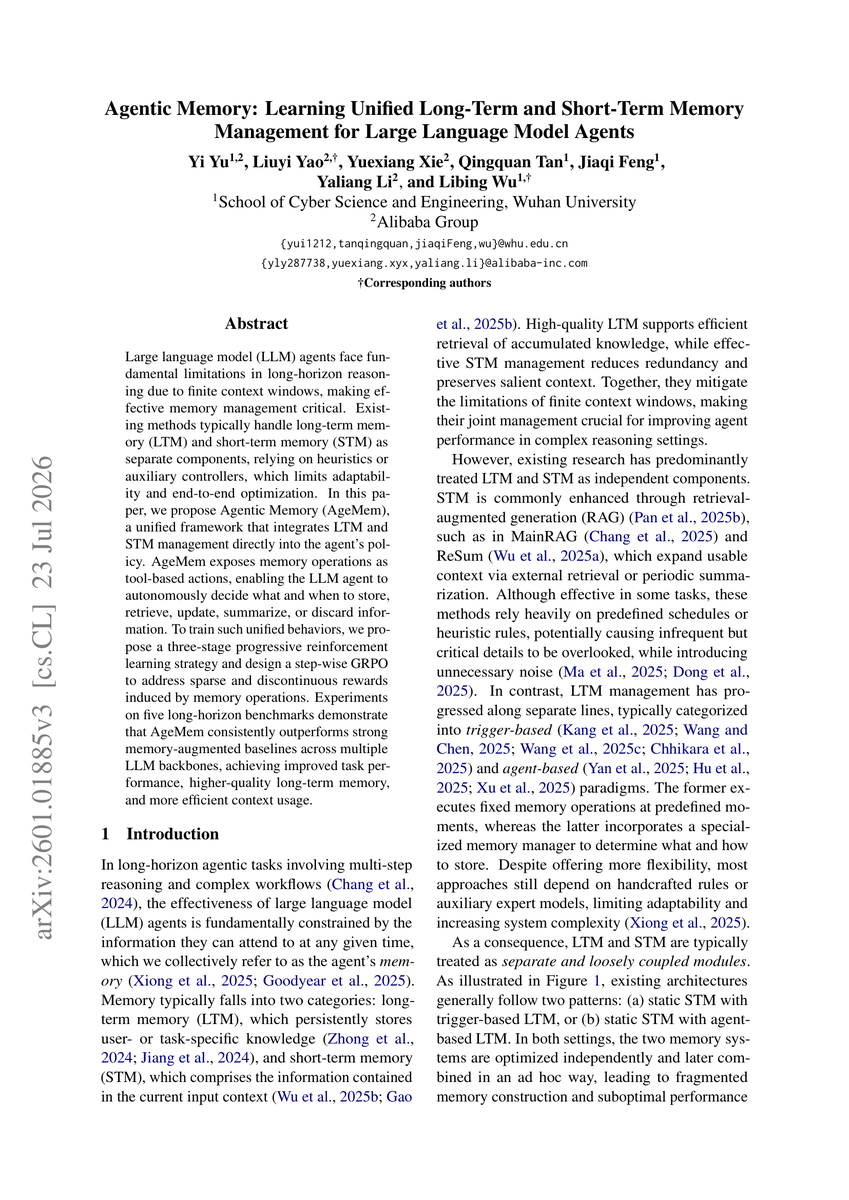
@beamnxw 表示(49 个赞、12 条回复、2,384 次浏览、46 次收藏)指出,AgeMem 将长期记忆和短期记忆变成智能体策略内部的工具动作,而不是把记忆交给启发式机制处理。随附的论文图片和 arXiv 摘要都支持这一解读:AgeMem 让模型自行决定何时存储、检索、更新、总结或丢弃信息,并报告了在五项长时程基准测试中的提升(论文)。
@fly51fly 分享了(2 个赞、1 条回复、329 次浏览)提到了论文《Permission Denied》,而其中的图片比标题本身更重要。图片显示,Boundary-Bench 将控制策略、非 root 权限和源自 NIST 的高等级策略叠加到 Terminal-Bench 2.1 上;摘要和图表指出,加固最多会带来 18.3 个成功点的损失和 167.3% 的额外开销,而成功率损失最小的组合,仍可能遭遇最大的效率损失(论文)。

@qyromat0 认为(27 个赞、5 条回复、1,381 次浏览、20 次收藏)指出,当智能体面对“超过 30—50 个工具”时,选择质量会出现可测量的下降;一条高赞回复则表示,更大的失败模式是工具描述相互重叠,导致选择变得模糊,而不只是 token 成本本身。这让讨论从单纯焦虑上下文窗口大小,转向接口设计:更少、更清晰的工具,可能与更大的模型同样重要。
@VictorTaelin 写道(136 个赞、60 条回复、8,895 次浏览、26 次收藏)指出,Bend2 的理论和运行时都在推进,但编译器仍是“层层叠叠的 AI 垃圾代码”,让他在现在就发布还是等代码更干净后再发布之间举棋不定。回复进一步凸显了实际风险:一旦外部用户接触到脆弱的 AI 生成代码库,他们可能就不会再回来。
@BrianV1981 发布了(3 个赞、2 条回复、62 次浏览)将 A.I.M. 生态描述为一套面向长期运行编码智能体的自托管连续性栈。架构图和所链接的 README 让这一主张变得具体:aim-joshua 充当与 CLI 无关的操作系统,而 aim-memory、aim-connect 和 aim-tmux-dashboard 则试图在不同会话之间保留状态、监控和远程控制(aim-joshua、aim-connect)。

讨论洞察: 信息流把记忆、评测和可靠性视作同一个设计问题:只保留真正重要的上下文,减少含义模糊的工具选项,并在生产环境实际会采用的策略下进行测试。
与前一天的比较: 8 月 8 日已经强调了记忆层、MCP 和确定性门控。到了 8 月 9 日,讨论进一步进入更严苛的地带:明确的工具数量上限、安全策略带来的惩罚,以及一手报告所揭示的 AI 生成代码仍会引发发布焦虑。
1.2 智能体持续脱离泛化聊天,落到具体的工作界面中(🡕)
第二个主题是,讨论从“智能体平台”转向具体的操作界面。五条入选内容都符合这一模式,而且其中几乎所有内容在补充 URL 信息后都更有说服力,因为相关代码库明确说明了智能体要控制的应用界面。
@alextalksai 发布了(102 个赞、8 条回复、102,788 次浏览、23 次收藏)指出,Vision Agents 是一套可用于生产环境的工具包,面向能够观察、聆听和理解视频的智能体。代码库用一套实时技术栈支撑了这一说法:在调用 LLM 前后使用 YOLO 或 Roboflow 处理器,集成电话系统、MCP/函数调用,并提供辅导、审核和反欺诈工作流示例;与此同时,它也承认连续视频上下文在较长会话中仍会退化(仓库)。
@DanKornas 表示(5 个赞、5 条回复、879 次浏览、4 次收藏)指出,ExcelMcp 之所以重要,是因为编辑工作簿文件并不等同于操作实时 Excel 功能。代码库进一步明确了这一差异:它通过 COM 驱动真正的 Excel 应用,支持 26 个工具和 234 项操作,并明确覆盖 Power Query 刷新、PivotTables、DAX、VBA、截图和工作簿状态保留。不过,推文和回复都表明,仅限 Windows 的 COM 时序问题仍是这一方案必须承担的一部分代价(仓库)。
@DanKornas 写道(4 个赞、2 条回复、561 次浏览)指出,Microsoft Security Skills Plugin 为宿主智能体打包了 88 项精选安全技能。README 支撑了更重要的判断:这不是一套通用安全提示词,而是基于 Microsoft Learn 的决策树和护栏层,已在两个模型上完成验证,目标是减少威胁防护、合规、身份和智能体安全工作流中的常见错误(仓库)。
@DanKornas 分享了(2 个赞、1 条回复、377 次浏览)介绍了 DeepAnalyze,一款面向自主数据科学的开源智能体式 LLM。代码库显示,其覆盖范围比单条推文更广:它面向从数据准备、分析,到建模、可视化和报告生成的完整流程,支持数据库、CSV/Excel、JSON/XML/YAML 以及文本数据源(仓库)。
@DanKornas 补充说(6 个赞、2 条回复、1,481 次浏览、13 次收藏)将 H2O LLM Studio 定位为一款无代码微调工作台。README 确认它提供 GUI 和 CLI,支持 LoRA、8-bit 训练、实验对比和模型导出,同时也明确了运行前提:Ubuntu 和较新的 NVIDIA GPU 是必需环境,而不是可有可无的细节(仓库)。
讨论洞察: 共同趋势是,不再要求模型无所不能,而是为它提供一个具备原生操作、护栏和故障模式的真实软件界面:实时 Excel、Microsoft 安全工作流、视频流或多源数据分析。
与前一天的比较: 8 月 8 日将执行范围扩展到了搜索、本地应用和交易通道。8 月 9 日则更深入应用原生控制平面:用真实 Excel 取代文件解析,用 Microsoft 安全技能取代泛化建议,用视频或数据科学栈取代普通聊天。
1.3 AI 可见性变得更可测量,但模型讨论仍快速且证据稀薄(🡕)
第三个主题同时分成两个方向。在商业层面,AI 可见性开始显得更可测量、更具操作性。在模型层面,讨论依然快速变化,但大量证据仍停留在传闻、Arena 现身记录或吞吐量宣称,而不是稳定的公开发布。
@alexgroberman 表示(21 个赞、564 次浏览)指出,Google Search Console 现在提供了专门的生成式 AI 报告。在这一案例中,公开 URL 十分关键:Google 6 月 3 日的公告和帮助页面确认,Search Console 已提供生成式 AI 展示次数、页面、国家/地区、设备和日期视图,同时也确认目前仅支持展示数据,且仍处于部分推送阶段(公告、帮助)。

@DanDr1s 报道称(278 个赞、25 条回复、10,340 次浏览、39 次收藏)声称,OpenAI 据说正在 GPT-6 之后运行一个代号为“Doug”的大型预训练任务;但讨论串中的证据始终没有超出传闻和回复的范围。这仍然具有市场信号意义:人们反应的对象是版本不断更替本身,而不是某个已公开的成果。
@RoundtableSpace 发布了(42 个赞、13 条回复、23,598 次浏览)指出,一个名为 Kiana 的神秘 Qwen 模型出现在 Arena 中,并与 Opus 5 和 GPT-5.6 Sol 处于同一比较区间。同样,最有力的证据不是发布说明,而是围绕它产生的社交反应——正如一条回复所说:“我们只是每天不断看到新模型。”
@TeksEdge 重点介绍了(27 个赞、4 条回复、1,693 次浏览、18 次收藏)介绍了 OoO-Spec:Qwen3-0.6B 旁路模型在主模型继续解码的同时,并行预测工具调用语义。论文摘要支持推文中最有力的数据——工具调用速度提升 2.46 倍至 5.34 倍,并且同一个起草器可复用于 Qwen、Qwen3 和 Llama 目标模型。这表明,服务效率本身已经成为模型讨论的一部分(论文)。
讨论洞察: 商业讨论需要更好的测量工具,而模型讨论仍奖励速度、传闻和快速比较循环。二者背后的共同逻辑是:AI 已经足够具备运营属性,以至于人们想要更好的测量;但它仍然足够不稳定,以至于许多测量结果都只是暂时性的。
与前一天的比较: 8 月 8 日仍以开放模型的商业策略和任务路由为中心。8 月 9 日延续了这种路由思路,但新增了两个更尖锐的运营问题:如何衡量 AI 可见性,以及今天的模型讨论究竟有多少真正建立在公开成果之上?
2. 什么让人感到沮丧
工具界面过于庞杂,难以清晰选择
严重程度:高。今天最明显的挫败并不是智能体缺少工具,而是工具太多,反而把它们淹没了。@qyromat0 认为(27 个赞、5 条回复、1,381 次浏览、20 次收藏)指出,当智能体看到 30 到 50 个工具后,性能会出现可测量的下降;最有价值的一条回复则表示,更深层的问题是工具描述相互重叠,导致选择含糊不清。@VictorTaelin 展示了(136 个赞、60 条回复、8,895 次浏览、26 次收藏)则从构建者角度说明了后果:智能体可以生成能运行的结果,但清理负担和对隐藏垃圾代码的担忧,仍会左右发布决策。即便是信息流中更强的工具包,也用不同方式承认了同一边界——Vision Agents 指出长会话中的上下文退化,ExcelMcp 的回复则承认,COM 时序和模态对话框是使用真实应用界面必须付出的代价。今天的应对方式是缩小工具菜单、提供更有主见的技能包,并明确应用边界。这是一个值得直接投入的方向。
基准测试中的从容感,到了加固环境或真实环境里就站不住脚
严重程度:高。多条帖子都拒绝把轻松取得的基准成绩当作生产就绪度的代理指标。@fly51fly 分享了(2 个赞、1 条回复、329 次浏览)提到了 Permission Denied;其论文和图表显示,策略加固既可能降低成功率,也可能推高成本,而且这种权衡会因模型而异,并非所有模型都以同样方式变化(论文)。@TeksEdge 重点介绍了(27 个赞、4 条回复、1,693 次浏览、18 次收藏)提到 OoO-Spec,因为智能体在工具调用上仍承担过高的延迟成本;而 @VictorTaelin 则把人的后果说得很直白:能“运行”的代码,仍不等于构建者愿意发布的代码。当前的应对模式是评测整个组合——模型、工具、策略和延迟——而不是只评测模型本身。这同样是一个值得直接投入的方向。
无状态智能体仍迫使人们重建那些早已为之付出成本的上下文
严重程度:中高。今天最有力的“希望系统记住”证据来自修复方案而非抱怨,但这仍然指向同一个痛点。@beamnxw 提到了(49 个赞、12 条回复、2,384 次浏览、46 次收藏)提到 AgeMem,因为当前的记忆处理过于依赖启发式方法;论文摘要则表示,应由智能体自行决定何时存储、检索、总结和丢弃记忆(论文)。@BrianV1981 围绕(3 个赞、2 条回复、62 次浏览)则以长期运行编码智能体的自托管连续性栈体现了同样的挫败感。如今的实际应对方式是增加基础设施——RAG 记忆、tmux 连续性、交接系统和状态检查点——因为默认会话模型仍然太容易遗忘。这个方向依然值得投入,尤其适用于工作跨越多轮对话或持续多天的场景。
3. 大家希望有什么
能感知策略的评测工具,测试完整组合而非单独测试模型
这是数据集中最明确的实际需求。@fly51fly 提到了(2 个赞、1 条回复、329 次浏览)提到一种基准测试:在受限凭证、受限出口流量、只读文件系统和非 root 执行等条件下,明确评测编码智能体,而不是假定存在宽松的沙箱(论文)。@qyromat0 表示(27 个赞、5 条回复、1,381 次浏览、20 次收藏)指出,工具过载本身就会降低性能;@VictorTaelin 展示了(136 个赞、60 条回复、8,895 次浏览、26 次收藏)则指出,当代码充满垃圾内容时,“能运行”仍无法通过发布测试。人们实际上想要的是一套能够同时评估成功率、延迟、成本、策略合规性和代码质量的工具。机会类型:直接。
能跨越会话边界、又不会淹没提示词的记忆层
第二个强烈需求是持久且有选择性的记忆。@beamnxw 重点介绍了(49 个赞、12 条回复、2,384 次浏览、46 次收藏)提到 AgeMem,因为现有的长期记忆和短期记忆设计仍过度依赖启发式方法,且彼此割裂;论文提出由策略决定何时保留或丢弃上下文(论文)。@BrianV1981 构建了(3 个赞、2 条回复、62 次浏览)则以 A.I.M. 回应同一缺口:这套系统明确致力于在不同会话之间保留状态、监控和交接,而不是每次都从零开始。实际需求不是无限扩展上下文,而是让上下文能够持续存在、可查询,并且不会用无关负担淹没模型。机会类型:直接。
面向真实软件的原生控制层,而不是通用的文件级自动化
人们持续认可那些将 AI 连接到实际工作系统的工具。@DanKornas 介绍了(5 个赞、5 条回复、879 次浏览、4 次收藏)提到 ExcelMcp,因为分析师需要 Power Query、PivotTables、DAX 和 VBA,而不只是 .xlsx 编辑(仓库)。@DanKornas 展示了(4 个赞、2 条回复、561 次浏览)显示,安全领域也存在同样需求,即通过 Microsoft 专属技能包来满足;@alextalksai 做到了(102 个赞、8 条回复、102,788 次浏览、23 次收藏)则对应实时视频智能体,@DanKornas 做到了(2 个赞、1 条回复、377 次浏览)对应数据科学工作流。这里的诉求非常实际,而非情绪化:如果 AI 要提供帮助,就应该操作人们已经在使用的真实界面。机会类型:直接。
更好的 AI 中介发现归因
一个规模较小但刚刚变得具体的需求,是了解 AI 系统是否真的在展示某个网站。@alexgroberman 表示(21 个赞、564 次浏览)指出,Google Search Console 现在提供生成式 AI 的性能数据;Google 自己的公告确认了这份新报告,同时也确认当前推送范围有限,且仅提供展示数据(公告、帮助)。这显然带来了下一个需求:不仅要知道是否被看见,还要能够在不同 AI 界面中追踪点击和转化归因。机会类型:竞争型。
4. 正在使用的工具和方法
| 工具 | 类别 | 评价 | 优势 | 局限 |
|---|---|---|---|---|
| AgeMem | 记忆框架 | (+) | 将长期记忆和短期记忆统一为工具动作;长时程任务取得基准测试提升 | 目前只有研究阶段证据;论文和讨论串未提供生产部署细节 |
| Boundary-Bench / Permission Denied | 评测框架 | (+) | 在真实策略级别下测试编码智能体;量化成功率/成本权衡 | 只能诊断,无法修复;加固仍会损害所有组合 |
| OoO-Spec | 推理方法 | (+) | 工具调用速度提升 2.46 倍至 5.34 倍;同一个 0.6B 旁路模型可复用于多个模型系列 | 在 H100 上完成基准测试;对本地或消费级 GPU 的影响仍未得到验证 |
| Vision Agents | 实时多模态智能体框架 | (+) | 低延迟视频/语音栈、MCP/工具调用、电话系统集成和公开示例 | 代码库指出,较长的连续视频会话存在上下文退化 |
| ExcelMcp | 应用 MCP 服务器 | (+/-) | 通过 COM 驱动实时 Excel;覆盖 Power Query、PivotTables、DAX、VBA 和截图 | 仅限 Windows;COM 时序和模态对话框问题仍是工作流的一部分 |
| Microsoft Security Skills Plugin | 技能包 / 护栏层 | (+) | 基于 Microsoft Learn 的 88 项精选技能;已在两个模型上完成验证 | 需要外部宿主智能体;它提供的是指导,而非独立的安全产品 |
| DeepAnalyze | 智能体式数据科学模型 | (+) | 覆盖数据准备、分析、建模、可视化和报告生成,支持混合数据源 | 源于研究的系统;讨论串尚未显示广泛的生产使用 |
| H2O LLM Studio | 微调工作台 | (+) | 无代码 GUI、LoRA/8-bit 训练、实验对比、聊天和 Hugging Face 导出 | 需要 Ubuntu 和较新的 NVIDIA GPU |
| A.I.M. / aim-joshua | 智能体操作系统 / 连续性栈 | (+/-) | 自托管记忆、tmux 连续性、GitOps 护栏和远程工作区 | 处于 Alpha 阶段;证据来自个人构建的系统,而非广泛用户验证 |
| Google Search Console 生成式 AI 报告 | 测量 / 报告 | (+/-) | 按页面、国家/地区、设备和日期提供官方 AI 可见性报告 | 当前仅提供展示数据;部分推送限制了即时可比性 |
总体而言,满意度更偏向于能够收窄范围、而不是扩大范围的工具。当工具真正掌控某个界面——Excel、Microsoft 安全运营、视频流或数据科学流水线——或解决记忆、工具调用延迟等具体系统问题时,人们的反应更积极。评价混合或偏负面的内容,则集中在相反的模式上:工具过多、未说明的上下文过多,或者只能在宽松沙箱中成立的基准测试。明显的迁移方向是:从通用助手行为转向有明确立场的界面、清晰的护栏,以及受策略塑造的评测。
5. 大家正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| A.I.M. / aim-joshua | BrianV1981 | 面向长期运行编码智能体的自托管操作系统、记忆和连续性栈 | 智能体在长会话中会丢失状态和控制权 | Node.js、LanceDB、tmux、Monaco/浏览器工作区、GitOps 护栏 | Alpha | 推文、仓库 |
| Vision Agents | GetStream | 具备多模态处理器和工具调用能力的实时视频/语音智能体框架 | 通用聊天智能体难以处理低延迟视频工作流 | Python、WebRTC、YOLO/Roboflow、MCP/函数调用、电话系统集成 | Shipped | 推文、仓库 |
| ExcelMcp | sbroenne | 用于自动化真实 Microsoft Excel 应用的 MCP 服务器和 CLI | 文件级电子表格编辑无法覆盖 Power Query、DAX 和 PivotTables 等实时 Excel 功能 | .NET 10、Windows COM、MCP 服务器、CLI 守护进程 | Shipped | 推文、仓库 |
| Microsoft Security Skills Plugin | vinayaklatthe | 面向宿主智能体的 Microsoft 安全精选技能包 | 通用安全提示词缺少决策树、验证机制和护栏 | Markdown 技能包、Microsoft Learn 知识支撑、验证工具 | Shipped | 推文、仓库 |
| DeepAnalyze | RUC-DataLab | 面向混合数据源自主数据科学的智能体式 LLM | 多源分析和报告仍需要过多人工编排 | 开源 8B 模型、WebUI、JupyterUI、CLI、Docker 沙箱 | Beta | 推文、仓库 |
| H2O LLM Studio | H2O.ai | 用于 LLM 微调和实验管理的无代码及 CLI 工作台 | 对许多团队而言,微调和模型对比的运维负担仍然过重 | Python、GUI、CLI、LoRA、8-bit 训练、DPO/IPO/KTO、Hugging Face 导出 | Shipped | 推文、仓库 |
Vision Agents 是“智能体进入真实界面”最清晰的案例。其代码库不只是承诺多模态能力,还明确说明了从处理器流水线到电话系统和 MCP 集成的低延迟组件,同时也坦率指出了一个真实弱点:连续视频上下文在较长会话中仍会退化。这让它更像基础设施,而不是展示性内容。
A.I.M. 是最有主见的连续性构建项目。图片之所以重要,是因为它们展示了真实架构——aim-joshua、aim-memory、aim-connect、aim-dash——而不是泛泛承诺“持久记忆”;README 也明确将该系统标记为 Alpha。反复出现的构建者模式是:在基础模型之外掌控连续性,而不是等待更大的上下文窗口来解决问题。
ExcelMcp、Microsoft Security Skills Plugin 和 DeepAnalyze 在不同领域表达了同一种构建直觉:不要再要求 AI 无所不能,而是为它提供某个工作流所需的原生操作、护栏和产物。纵观整张表,反复出现的触发点并不是“我们构建了更好的聊天机器人”,而是“通用助手无法操作我们真正关心的界面”。
6. 新动态与值得关注的内容
Google 为网站所有者提供了专门的生成式 AI 可见性报告
这是当天最有事实依据的“新界面”信号。@alexgroberman 指出了(21 个赞、564 次浏览)提到了这份报告;Google 6 月 3 日的官方帖子确认,Search Console 新增了生成式 AI 展示次数、页面、国家/地区、设备和日期视图,同时帮助页面明确说明目前仍处于部分推送阶段,指标也仅限展示数据(公告、帮助)。这很重要,因为团队现在可以在官方工作流中监控 AI 搜索可见性,而不必再依赖截图和猜测。
加固惩罚已变得足够清晰,足以影响模型选择
Permission Denied 的突出之处在于,它量化了人们通常只能凭经验描述的模式。@fly51fly 分享了(2 个赞、1 条回复、329 次浏览)提到一篇论文,其摘要和图表显示,“最佳”组合取决于所执行的策略,因为在加固条件下,成功率损失和成本膨胀的变化并不一致(论文)。这值得关注,因为它将“生产环境比基准测试更难”从一种感觉转化成了可测量的模型选择问题。
前沿模型讨论依然激烈,但大量内容仍停留在传闻或 Arena 信号层面
@DanDr1s 报道称(278 个赞、25 条回复、10,340 次浏览、39 次收藏)提到了传闻中的 OpenAI 预训练任务“Doug”;@RoundtableSpace 发布了(42 个赞、13 条回复、23,598 次浏览)则提到了 Arena 上神秘的 Qwen 模型“Kiana”。两者都高度反映了社区正在关注什么,但都没有提供足以定论的公开成果。值得注意的不是最终结论,而是讨论如此迅速地转向了下一个新入场者。
7. 机会在哪里
[+++] 能感知策略的评测和受限执行工具 —— 多个部分都指向这里。Permission Denied 显示,加固会以因模型而异的方式同时改变成功率和成本;qyromat0 显示,宽泛的工具界面在策略介入之前就已经会让行为退化;Victor Taelin 的讨论串则展示了“能运行”的输出仍无法发布时所产生的人力成本。这一机会十分强劲,因为需求紧迫、可重复,而且不依赖某一家供应商。
[+++] 在收窄活动工具界面的同时保留记忆的连续性层 —— AgeMem、A.I.M. 以及关于工具过载的讨论都指向同一要求:智能体需要有选择地记忆,而不是无止境地记忆。最强的机会并不是扩大原始上下文,而是构建能够保留正确状态、展示正确工具子集,并让后续轮次更便宜、更干净的系统。
[++] 面向真实软件的原生 AI 控制平面 —— Vision Agents、ExcelMcp、Microsoft Security Skills Plugin 和 DeepAnalyze 都展示了同一种采用模式:当 AI 操作的是用户熟悉的界面,使用原生动作、真实产物并明确限制时,用户会更信任它。这是一个中等偏强的机会,因为赢家很可能是垂直且面向具体工作流的产品,而不是通用产品。
[+] AI 搜索测量与归因 —— Google 新推出的 Search Console 报告证明,市场确实需要 AI 可见性指标,但也表明这一界面仍处于早期阶段,因为展示数据先于点击或转化出现。这是一个正在形成而非已经成熟的机会:市场需要归因、竞争监测和下游业务影响,而不只是可见性快照。
8. 结论
- 今天真正有用的问题是“在什么约束下”,而不是“哪个模型胜出?” Permission Denied 量化了策略如何改变模型经济性,而 qyromat0 和 Victor Taelin 则表明,工具过载和垃圾代码已经打破了轻松基准测试的叙事。(来源)
- 记忆仍是一个足够大的产品缺口,既能支撑研究方案,也能支撑基础设施方案。 AgeMem 将记忆视为学习得到的策略问题,而 A.I.M. 则将其视为自托管的系统问题。(来源)
- 最强的构建者正在把 AI 接入真实操作界面,而不是要求一个更好的通用助手。 Vision Agents、ExcelMcp、Microsoft Security Skills Plugin 和 DeepAnalyze 都掌控着特定的工作流界面,并明确说明自身限制。(来源)
- AI 中介发现正在变成一项运营工作。 Google 新推出的 Search Console 生成式 AI 报告让可见性变得可测量,即使归因仍不完整。(来源)