Twitter AI - 2026-08-13
1. 人们在讨论什么
1.1 更便宜的编程模型,靠完成的工作而不是 Token 数量赢得认可(🡕)
最强的一波产品讨论认为,只有当价格变化真正改变了模型在实际工作中能完成什么时,价格才有意义。信息流对抽象的“前沿”地位没那么在意,更关注编程基准、首轮通过的可靠性,以及更小或更便宜的模型能否在不额外重试的情况下完成生产任务。
@_philschmid 宣布(193 个赞、10 条回复、8,055 次浏览)宣布 Gemini 3.7 Flash 正式可用,并将这次发布与真实世界的编程和智能体基准、50% 的首发折扣,以及向 Managed Agents、Google AI Studio、Antigravity 和 Gemini Spark 的上线绑定在一起。Google 公开的 发布文章 也证实了 FrontierCode、DeepSWE 和 AutomationBench 上同样的基准跃升,这让这条推文读起来不像单纯造势,更像是在把它重新定位成一款能干活的模型。

@StasBekman 报道(7 个赞、540 次浏览)称,Snowflake 训练出一款新的 4B SQL 自动补全模型,相比此前的 30B-A3B MoE,精度更高、用户接受率更高,延迟则降低了 71%。Snowflake 公开的 工程技术文章 把这点说得很明确:对延迟敏感的 AI 交互界面而言,比起单纯追求更大规模,更重要的是基于 schema 的 grounding、经过校准的弃答机制,以及任务定制的后训练。
@levie 认为(22 个赞、4 条回复、3,854 次浏览)认为,同一天 DeepSeek 和 Grok 的更新之所以重要,是因为更便宜但能力足够的模型扩大了企业在智能体上的预算空间,使其能够持续扫描代码库、审阅文档并处理工作流。那条有价值的回复则进一步收紧了这个限定:降成本能释放预算,但最终决定一个用例能否真正上线的,仍然是可靠性的长尾表现。
讨论洞察: 信息流不断把模型进步重新表述为任务经济学:更高的首轮完成率、更低的重试成本,以及在更窄的应用面上,专业化胜过单纯的模型规模。
与前一天对比: 8 月 12 日已经强调了更便宜的私有模型和专用模型。8 月 13 日则进一步把这套逻辑推进到直接的任务成本比较,以及更小的领域专用模型。
1.2 评估从排行榜讨论转向面向部署的度量(🡒)
评估仍然处于核心位置,但重点已经从通用模型排名,转向更难被刷分、也更接近真实部署的测试设置。最强的帖子讨论的是二进制逆向工程、工作流结果、CI/CD 门禁,以及智能体团队的协作拓扑,而不是又一个抽象的推理分数。
@ValsAI 推出(60 个赞、5 条回复、6,542 次浏览)介绍了 SRE-Bench:这是一个面向处理二进制文件而非源代码的 AI 智能体逆向工程基准。公开的 ReverseEngBench 页面 解释了它为何重要:19 个内部程序、262 个无污染实例,以及覆盖网络协议、固件、游戏、文件格式恢复和恶意软件的 1,572 个可确定评分任务。

@freeCodeCamp 分享了(39 个赞、6,207 次浏览)介绍了 Ayobami Adejumo 的 手册,主题是如何构建生产级 LLM 评估平台。文章明确指出当前缺失的纪律性:黄金数据集、RAG 故障模式覆盖、LLM-as-judge、CI/CD 评估门禁,以及生产监控。@nykdotdev 认为(39 个赞、3 条回复、197 次浏览)则从编程智能体的角度指出,“当两个智能体都拥有同一项工作时,它们就会失败”,并指向论文 《An Empirical Study of Coordination Mode as the First-Class Citizen in From-Scratch Multi-Agent Coding》。该论文称,即便模型和任务保持不变,协作拓扑也可能让结果发生显著波动。
讨论洞察: 评估讨论已经不再是“哪个模型最聪明?”,而是“什么样的环境、评分闭环和协作图,才真正能预测生产行为?”
与前一天对比: 8 月 12 日聚焦轨迹、生命周期,以及对单一基准的怀疑。8 月 13 日则把这种担忧具体化为具名基准、确定性评分器和工作流级评估实践。
1.3 记忆与本地执行成为可靠性的核心基础设施(🡕)
另一条强势讨论线把记忆和本地执行视为系统原语,而不是可选插件。真正有意思的问题不是智能体理论上能不能记住,而是如何保留可追溯性、降低延迟,并让有用的上下文尽量贴近设备或操作人员。
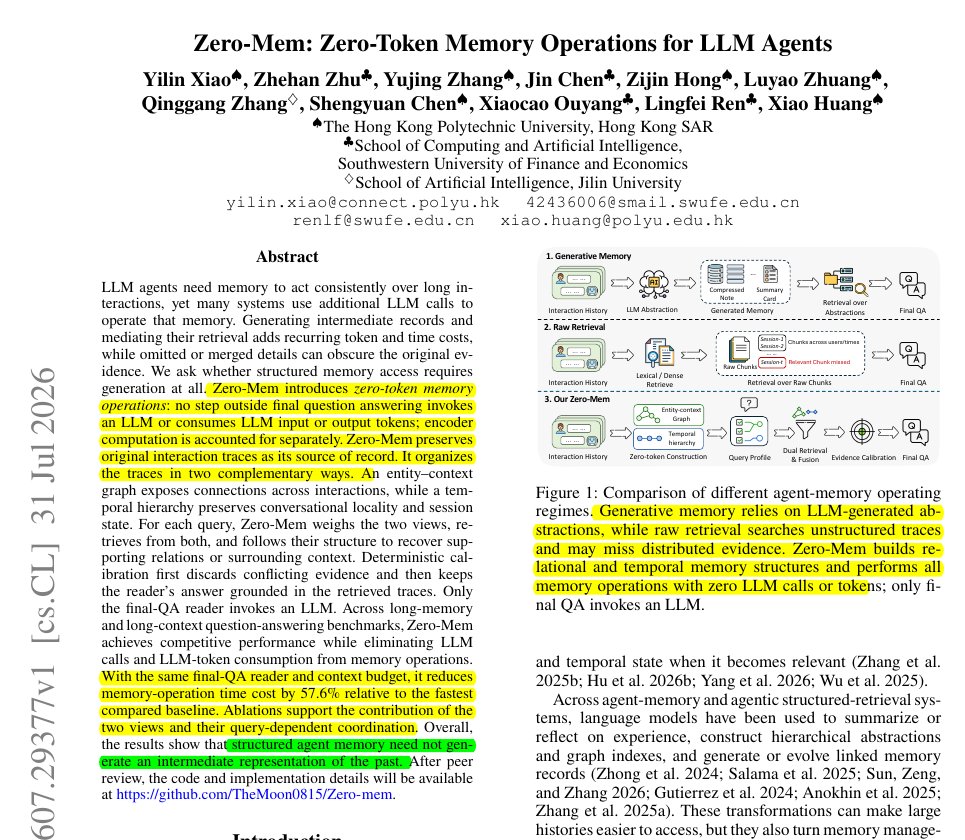
@rohanpaul_ai 重点介绍了(17 个赞、5 条回复、1,829 次浏览)介绍了论文 Zero-Mem。该方案保留原始轨迹,构建实体—上下文图和时间层级,并在最终 QA 之前完成记忆操作而不消耗 LLM Token。论文公开的 HTML 版本称,与速度最快的可比生成式记忆基线相比,这种零 Token 机制将记忆操作延迟降低了 57.6%。
@Kautukkundan 展示了(59 个赞、4 条回复、1,521 次浏览)介绍了一款运行在 Apple Watch 上、拥有 7,000 万参数的小语言模型;其队友 @TslShahir 在回复中表示,他们从零开始训练了一个三值 MoE,以适配应用约 70MB 的容量上限。@AtharvaXDevs 分享了(44 个赞、6 条回复、532 次浏览)展示了一个运行在 L4 GPU 上的量化模型 homelab,使用了 kind、NVIDIA 插件、Bifrost、OpenWebUI、Prometheus 和 KEDA;回复也立刻转向 KV-cache 调优和并发上限,而不是模型立场之争。

讨论洞察: 面对脆弱的智能体,大家偏好的修复方式不是“再塞更多上下文”,而是结构化记忆、本地状态和明确的基础设施边界。
与前一天对比: 8 月 12 日更偏向私有模型的所有权和部署控制。8 月 13 日则深入到了记忆层、可穿戴设备推理和自托管服务的具体细节。
1.4 构建者持续推出狭窄的 AI 工作界面,而不是通用聊天机器人(🡕)
构建热情依旧高涨,但最有说服力的发布都是边界清晰的狭窄界面:语音输出、SQL 自动补全、协作研究记录,或可导出的代码。信息流奖励的是那些能让某个工作流更快、也更容易建立信任的产品,而不是承诺一个智能体包打天下的产品。
@aleximarkett 表示(167 个赞、39 条回复、9,004 次浏览)展示的 Soniox TTS v2,看起来是为生产级语音工作打造的,而不是为了基准表演。Soniox 公开的 公告 支撑了这一点:支持 60 多种语言、低延迟流式处理、语音克隆、音频标签,以及每生成小时 0.70 美元的定价。@doodlestein 宣布(77 个赞、15 条回复、3,063 次浏览)介绍了 ASImposium:一个面向前沿智能体的公共科学账本,将私下工作坊与公开宣传和赞助区分开来。@hasantoxr 认为(10 个赞、1 条回复、4,174 次浏览)则认为,AI 应用构建器应当复制“导出代码、随处部署”的模式,而不是把原型困在平台内部。
讨论洞察: 一个反复出现的检验标准是:产品对自己的接口、交接方式或数据边界说得越具体,听起来就越可信。
与前一天对比: 8 月 12 日聚焦收件箱、PR 和企业任务自动化。8 月 13 日则把这个工作面拓展到了语音、研究协作、SQL 工具和可导出的应用构建器。
2. 什么让人沮丧
基准胜利到了部署阶段,仍留下太多不确定性
严重程度:高。最明确的挫败感在于,通用公开分数依然无法回答一个关键问题:智能体能否安全、稳定、可重复地完成真实工作。@ValsAI 推出(60 个赞、5 条回复、6,542 次浏览)之所以推出 SRE-Bench,正是因为面向源代码的安全基准漏掉了以二进制为起点的工作;公开的 基准测试页面 显示,当前前沿模型仍然只能解决其中少数任务。@freeCodeCamp 分享了(39 个赞、6,207 次浏览)介绍了一本围绕黄金数据集、CI/CD 评估门禁和生产监控构建的手册;与此同时,@nykdotdev 认为(39 个赞、3 条回复、197 次浏览)指出,多智能体编程结果会随着协作拓扑变化而剧烈改变。当前的变通办法是更多任务专用评分、私有评估套件和明确的编排测试。这是一个非常值得直接去构建的方向。
当记忆与所有权是隐式的,智能体仍会失去连续性
严重程度:高。多个高信号条目从不同角度描述了同一个底层问题:智能体本身可能有能力,但围绕它的系统会遗忘、冲突,或丢失上下文。@rohanpaul_ai 总结了(17 个赞、5 条回复、1,829 次浏览)介绍了 Zero-Mem,它的存在正是为了避免让记忆管理反复变成 LLM 生成税。@nykdotdev 表示(39 个赞、3 条回复、197 次浏览)指出,当两个编程智能体都拥有同一项工作时,它们会失败;@AtharvaXDevs 展示了(44 个赞、6 条回复、532 次浏览)则表明,即便只是个人 homelab,也会很快撞上缓存和并发限制。应对方式是明确文件所有权、采用结构化记忆,以及更严格地控制本地状态。这是一个非常值得直接去构建的方向。
用户仍然反感锁定和不透明的 AI 界面
严重程度:中。反锁定的抱怨更多出于实际考虑,而不是意识形态。@hasantoxr 认为(10 个赞、1 条回复、4,174 次浏览)认为,AI 构建器应支持代码导出,避免一旦取消订阅,产品也跟着失效;@doodlestein 设计了(77 个赞、15 条回复、3,063 次浏览)则围绕 ASImposium 强调具名的人类赞助者和公共账本,而不是黑箱式智能体群。即便对 Gemini 3.7 Flash 的热情,也强调模型部署在哪里、在循环中表现如何,而不只是模型名头本身。应对方式是让所有权可见、提供导出路径,并收紧权限边界。这值得投入建设。
3. 人们希望出现什么
团队能够信任的、按任务成本路由模型的系统
信息流持续在呼唤这样一种系统:选择那个既能可靠完成任务、又最便宜的模型,而不是把所有模型比较都降格为每 Token 价格的琐碎算术。@_philschmid 介绍了(193 个赞、10 条回复、8,055 次浏览)把 Gemini 3.7 Flash 视为更低成本的编程和智能体默认模型;@levie 认为(22 个赞、4 条回复、3,854 次浏览)认为,更便宜的前沿模型更新扩大了企业智能体预算;而 Snowflake 公开的 SQL 自动补全技术文章 则展示了一个更小的专用模型如何在窄任务上胜过更大的模型。这个需求既现实又紧迫:按任务经济性、延迟和失败成本做路由。机会类型:直接。
保持可追溯的共享记忆与本地状态
人们显然希望智能体能跨会话记住事情,同时又不把记忆本身变成另一层嘈杂的生成式模块。@rohanpaul_ai 重点介绍了(17 个赞、5 条回复、1,829 次浏览)介绍了 Zero-Mem 的零 Token 记忆操作;@Kautukkundan 展示了(59 个赞、4 条回复、1,521 次浏览)介绍了面向本地个人上下文的 Apple Watch SLM;@AtharvaXDevs 梳理了(44 个赞、6 条回复、532 次浏览)则展示了一个低成本的自托管推理栈。大家共同要的,是带来源可追溯性的连续性,而不只是更大的上下文窗口。机会类型:直接。
面向多智能体工作的审查与协作层
当天关于评估的帖子指向了一个更广泛的需求:团队想要的是能把所有权、评分和交接规则说清楚的智能体协作系统。@nykdotdev 认为(39 个赞、3 条回复、197 次浏览)指出,当两个智能体都拥有同一项工作时,智能体团队就会失败;@ValsAI 构建了(60 个赞、5 条回复、6,542 次浏览)介绍了围绕真实逆向工程任务建立的基准;@doodlestein 提出了(77 个赞、15 条回复、3,063 次浏览)则介绍了一个面向前沿智能体科学的公共账本。其紧迫性很高,因为在没有更好协作机制的情况下,增加更多智能体席位只会成倍放大混乱。机会类型:直接。
代码真正归用户所有、且可导出的 AI 构建器
反平台锁定主题的热度虽然不如评估主题,但诉求非常具体。@hasantoxr 想要(10 个赞、1 条回复、4,174 次浏览)呼吁能生成可导出代码的应用构建器;ASImposium 的公开仓库和具名赞助者模式,也体现了同样希望把控制权显性化的倾向。这不是空白幻想,而是竞争性需求:已有多个产品在逼近这个方向,但用户显然仍不满意。机会类型:竞争性。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Gemini 3.7 Flash | LLM / 智能体模型 | (+) | 以更低的发布价格取得更好的编程和智能体基准结果;广泛部署到 Google 各个产品面 | 发布指标来自厂商;仍需任务专用评估 |
| Soniox TTS v2 | 语音模型/API | (+) | 支持 60 多种语言、低延迟流式处理、语音克隆、自然语言混合、每小时 0.70 美元 | 证据主要来自厂商发布说法;专有服务 |
| ReverseEngBench / SRE-Bench | 基准 | (+) | 聚焦二进制、无污染、确定性评分、真实 RE 工具链 | 当前模型分数仍低;范围局限于逆向工程 |
| 评测驱动的 LLM 评估栈 | 方法 / 评估工作流 | (+) | 黄金数据集、RAG 指标、LLM-as-judge、CI/CD 门禁、生产监控 | 搭建成本高;评估覆盖质量取决于数据集设计 |
| Zero-Mem | 记忆层 / 方法 | (+) | 零 Token 记忆操作、保留轨迹、更低的记忆延迟 | 仍处研究阶段;最终 QA 仍依赖 LLM |
| Snowflake 4B SQL 自动补全 | 小型专用模型 | (+) | 相比更大的 MoE 基线,精度和用户接受率更高,延迟低 71% | 领域范围狭窄:仅限 Snowflake SQL |
| Lattice 风格 homelab 栈 | 自托管推理基础设施 | (+/-) | 本地控制、可观测性、量化推理服务,以及明确的扩缩容和护栏组件 | GPU 显存/KV-cache 限制与运维复杂性很快显现 |
| ASImposium | 协作平台 | (+/-) | 共享账本、赞助者监督,以及对智能体工作的公私边界做了明确划分 | 仍处早期;非正式声明的验证规则尚未稳定 |
| Marlow 风格可导出的构建器 | AI 应用构建器 | (+/-) | 快速生成,同时提供代码所有权和可导出性 | 公开技术细节有限;产品质量证据仍主要停留在演示阶段 |
总体情绪偏向更便宜、也更专用的系统,但这种热情是有条件的。人们喜欢 Gemini 3.7 Flash、Soniox 和 Snowflake,不是因为它们“更大”,而是因为它们看起来像能部署的工作界面。各条讨论中的常见变通模式其实一致:按任务路由、加入显式记忆、让所有权可见,并评估整个工作流,而不是只相信模型标签。主要的迁移压力,正从一刀切地使用前沿模型,转向由更便宜的模型、领域专用模型、路由层,以及自托管或用户可控状态组成的技术栈。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| ASImposium | @doodlestein | 一个公共科学账本:前沿智能体先私下工作,再在赞助者监督下公开推进主张 | 前沿智能体研究目前消失在本地聊天里,缺少共享审查 | Bun monorepo、Next.js 16、Workers、Google sign-in、智能体 harness 集成 | RFC | 网站 · 仓库 |
| Soniox TTS v2 | Soniox | 面向语音智能体的多语言文本转语音、语音克隆和低延迟流式处理 | 语音产品需要更干净的打断处理、语言切换和更低的服务成本 | 专有 TTS 模型、音频标签、流式 API、语音克隆 | 已发布 | 公告 · 产品 |
| Snowflake 4B SQL 自动补全 | Snowflake AI Research | 编辑器内基于 schema 的 SQL 自动补全 | 大型通用模型对于交互式 SQL 建议来说太慢也太吵 | 4B 稠密模型、基于上下文 grounding 的后训练、RL | 已发布 | 博客 |
| ReverseEngBench / SRE-Bench | @ValsAI | 面向处理受保护二进制文件的智能体的逆向工程基准 | 源代码基准漏掉了真实的二进制优先安全工作 | Clean-room 二进制、反分析套件、确定性评分器、Ghidra/radare2/GDB/angr 工具链 | 已发布 | 基准测试 |
| Apple Watch SLM 应用 | @Kautukkundan | 在手表上运行、支持本地推理的小语言模型应用 | 可穿戴和个人智能体工作流需要私密、低延迟的执行 | 7,000 万参数三值 MoE、Apple Neural Engine、手表应用打包 | 已发布 | 推文 |
| Lattice homelab | @AtharvaXDevs | 用于量化 LLM 服务和运维实践的最小化自托管推理环境 | 团队需要一个低成本、接近生产的地方来学习 LLM 上线后的日常运维 | JarvisLabs L4、kind、NVIDIA toolkit/DCGM、Bifrost、OpenWebUI、kube-prometheus-stack、KEDA | Alpha | 推文 |
ASImposium 的突出之处在于,它试图围绕智能体工作构建社会基础设施,而不是再做一个智能体本身。其公开网站明确表示,它不运行任何模型;产品是共享记录、赞助者控制,以及由验证者门控的公开界面。
Soniox TTS v2 和 Snowflake 的 SQL 自动补全都体现了同一种构建模式:狭窄的任务界面、严格的延迟要求,以及专业化优先于规模。前者优化的是实时语音与多语言控制,后者优化的是非常具体的编辑器工作流中的 schema-grounded 补全与弃答。
更小型的个人项目也指向同一个方向。Apple Watch SLM 和 Lattice homelab 不是在证明通用智能,而是在努力让本地推理和低成本的操作者控制变得可行。那种强调所有权的倾向,也同样出现在可导出代码的构建器讨论里。
6. 新动态与值得关注的事
Anthropic 在 Claude 内部展示了一个无声的推理工作区
@heynavtoor 指出(14 个赞、2 条回复、2,083 次浏览)指向 Anthropic 新发布的 全局工作空间研究。该内容称,Claude 出现了一种涌现的 J-space:内部表征可以被报告、调节,并用于多步推理,却不会被说出口。Anthropic 表示,这使研究人员能够在虚构数据、提示注入或隐藏目标出现在输出之前就捕捉到这些概念,这与事后审核有实质区别。
前沿模型治理开始看起来像行业标准问题,而不只是实验室政策问题
@kimmonismus 报道(62 个赞、17 条回复、4,611 次浏览)称,Demis Hassabis 曾讨论设立一个独立机构,为先进 AI 制定安全标准;附带截图则强调了一项提议,即把 AGI 级系统的护栏和最佳实践编纂成规范。真正有意思的地方不在于是否形成共识,而在于回复立刻提出了风险:标准机构最终可能成为所有人都必须跨过的明确门槛,也可能成为 incumbents 的护城河。
一个 4B 专用模型击败更大的自动补全基线,变得比又一款通用模型发布更重要
@StasBekman 报道(7 个赞、540 次浏览)称,Snowflake 的新 SQL 自动补全模型同时提升了精度和用户接受率,并大幅降低了延迟。Snowflake 公开的 工程文章 之所以让这件事更值得关注,在于它把专业化、grounding 和弃答机制,而不是更大规模,呈现为获胜公式。
7. 机会在哪里
**+++] 达到部署级别的 agent 评估与编排** — 证据同时来自多个方向:[SRE-Bench、AutomationBench、freeCodeCamp 评测手册 和 MSEval 协调论文 都指向同一个结论:最强的机会并不是孤立地再做一个“基准”,而是做理解工作流的评分、路由和交接系统,帮助团队判断一套智能体配置是否真的能上线。
**++] 持久化记忆加本地状态基础设施** — [Zero-Mem、Apple Watch SLM 演示和 Lattice homelab 都指向同一个缺口:连续性、来源可追溯性和低延迟本地控制,仍然缺少更好的基础原语。这是一个很强的机会,因为它同时触及智能体可靠性、隐私、所有权和服务成本。
**++] 面向狭窄且结果明确的 AI 工作界面** — [Soniox TTS v2、Snowflake 的 SQL 自动补全模型,以及对可导出代码构建器的需求,都表明人们会为把某一个工作界面做到极致的系统付费。这个机会强度中等,因为赛道已经开始拥挤,但证据显示,专业化正在赢得注意力。
**+] 用于协作式 agent 工作的共享审计层** — [ASImposium、Anthropic 的 全局工作空间,以及围绕 Demis 标准机构的讨论,都指向一个更薄但真实的需求:让智能体推理、审查和公共问责更容易被检查的系统。这一方向仍处早期,但信号已经开始出现。
8. 要点总结
- 已完成任务的经济性胜过模型声望。 Gemini 3.7 Flash、Snowflake 的 4B SQL 模型,以及更广泛的价格战讨论,都是按完成的工作、延迟和重试减少来定义价值,而不只是看 Token 价格。(来源)
- 评估正在成为独立的产品层。 二进制逆向工程基准、工作流结果基准和 CI/CD 评估手册都表明,团队已经不再相信通用模型分数能预测部署表现。(来源)
- 记忆已经从“可有可无”变成显式基础设施。 Zero-Mem、设备端手表推理和自托管 homelab 架构,都把连续性和本地状态视为设计原语,而不是提示词技巧。(来源)
- 最强的构建者在交付狭窄界面,而不是通用副驾驶。 语音生成、SQL 自动补全、协作式科学账本和可导出应用构建器,看起来都比泛泛而谈的“AI 解决一切”更可信。(来源)
- 治理和可解释性是随能力同步上升的,而不是事后补救。 Anthropic 的 J-space 工作,以及围绕先进 AI 标准机构的讨论,都表明实验室和观察者预期:更强的系统将需要更好的可见性和共享规则。(来源)