Twitter AI - 2026-08-14
1. 大家在讨论什么
1.1 智能体性能被视为编排设计问题,而不是“挑模型”问题(🡕)
反复出现的一个教训是,如今团队评估智能体时,看重的是连接方式、监督机制和反馈闭环,而不再只盯着模型本身。至少有三条高信号内容从不同角度说明了同一点:协调拓扑、执行框架设计和闭环评估,即便模型不变,也会实质性改变结果。
@Argona0x 认为(166 个赞,4 条回复,312 个收藏,36,535 次浏览)指出,Google Research 和 MIT 一项发表于 Nature 的研究在提示词、工具和算力都保持不变的情况下发现,仅仅改变智能体图结构,同样的任务结果就可能从比单智能体差 70%,变成比单智能体好 80.8%。其中给出的操作建议非常具体:先对单智能体做基准测试;只有在单智能体基线较弱时才加入监督者;不要让工作智能体互相读取对方草稿;模型升级后要重新跑一遍对比。
@0xClodex 总结道(17 个赞,10 条回复,18 个收藏,553 次浏览)总结了 Harrison Chase 的拆解:模型只占智能体栈的三分之一,其余部分在于上下文、执行框架、评估、可观测性,以及由轨迹驱动的改进闭环。最有代表性的一条回复概括了社区情绪:很多团队做到评估就停了,却从未建立起能把失败转化为更好路由和上下文的飞轮。
讨论要点: 回复并不否认更强模型的重要性,而是把问题收束到:在哪些场景下,监督、上下文时机和错误隔离比模型本身更重要。
与前一天的对比: 8 月 13 日已经强调了面向生产部署的度量;8 月 14 日则又往前推进了一步,开始深入讨论协调图本身。
1.2 后训练和本地执行同时进步,让开放权重模型重新站得住脚(🡕)
今天大家讨论开放模型时,重点不是意识形态,而是它们作为本地系统是否可用:借助后训练、权重发布和在消费级硬件上的实现技巧,这些模型正在可量化地变好。
@kimmonismus 报道称(173 个赞,17 条回复,31 个收藏,12,121 次浏览)指出,GLM-5.3 沿用了 GLM-5.2 的同一个 743B 基础模型,性能提升完全来自对更长流程、带工具调用任务的后训练扩展。Z.ai 的公开 GLM-5.3 文档 也重复了这一说法,并列出了具体提升:Terminal-Bench 3.0 从 4.6 提升到 28.3,DeepSWE v1.1 从 46.2 提升到 66.9,ExploitBench 从 24.4 提升到 54.4;权重则因安全评估尚未发布。


@sudoingX 显示(159 个赞,12 条回复,122 个收藏,6,709 次浏览)指出,Qwen 3.8 27B 的多 token 预测头其实已经包含在已发布的 GGUF 中,只需在 llama.cpp 里打开一个 flag 就能启用;RTX 3090 的速度从 31 tok/s 提升到 41.3 tok/s,5090 笔记本则从 36.7 tok/s 提升到 50.9 tok/s。回复里还补充了更多公开复现数据,包括一份 4090 在生成 18,000 个 token 时达到 106.2 tok/s 的报告,以及一位 RX 9060 XT 用户称速度大约翻倍。
@rohanpaul_ai 强调了(9 个赞,1 条回复,2,063 次浏览)介绍了 Alibaba 的开放权重模型 Qwen3.8-27B:这是一个面向本地部署的 27B 多模态模型,原生支持 262K 上下文,提供可选的推理控制,并据称在 SWE-bench Pro、CoWorkBench 及其他智能体类任务上具备竞争力。附带的对比表让“适合本地部署”不再只是口号,而是具体主张。
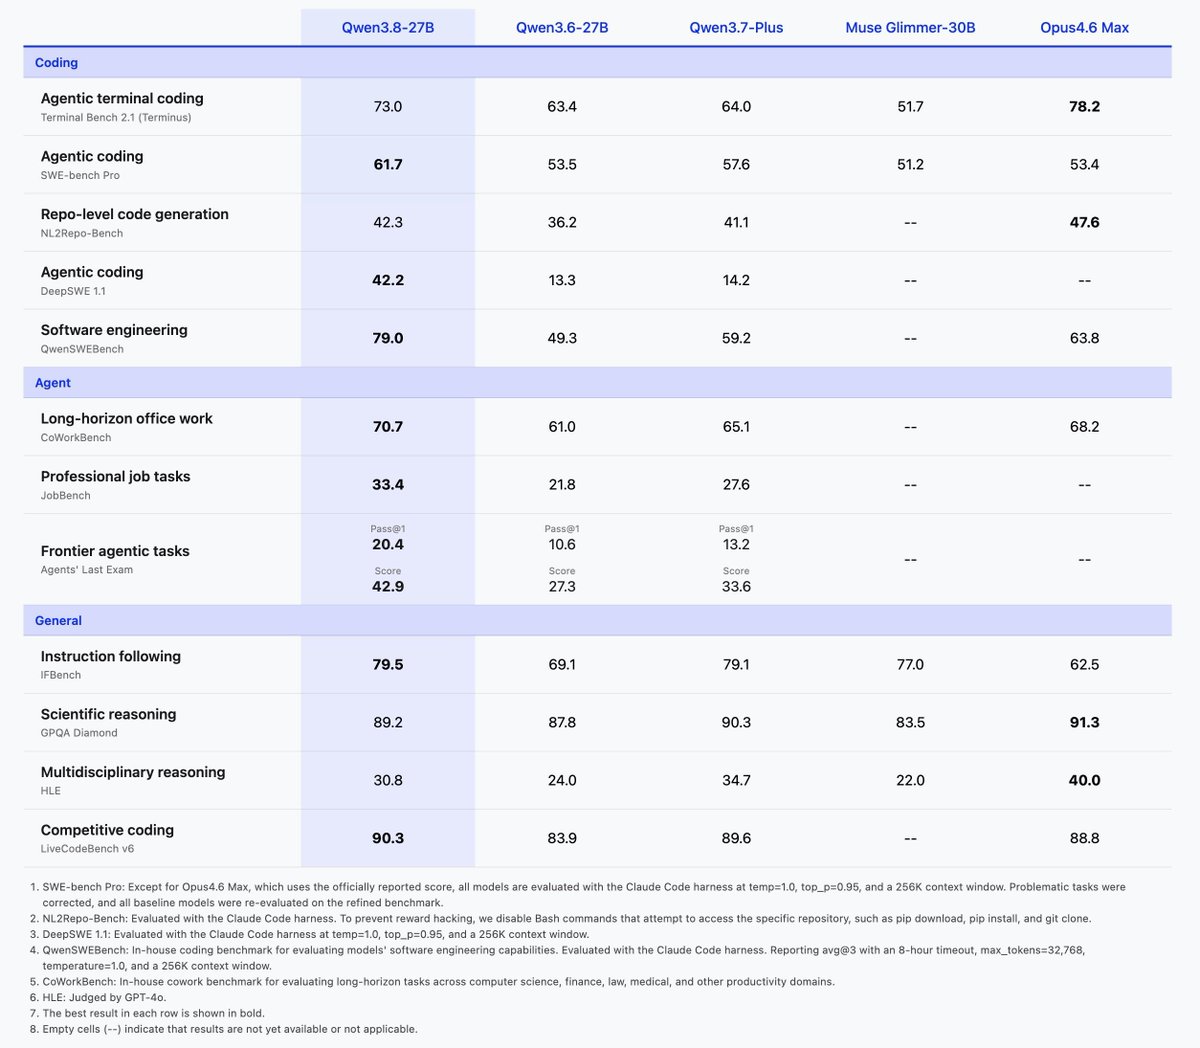
@paulg 指出(247 个赞,39 条回复,17,524 次浏览)称,一年前还被看衰的开放权重模型创业公司调优,如今“似乎又回来了”。回复把门槛说得很清楚:如果定制现在只要几小时而不是几周,且开放模型的任务质量已经足够接近,那么重新开启调优循环就值得了。
讨论要点: 实时争论已经不再是“开放还是闭源”,而是差距是否已经小到足以让后训练、微调和本地部署,实质性优于租用通用前沿模型。
与前一天的对比: 8 月 13 日聚焦更便宜的编程模型和任务经济性;8 月 14 日则补上了公开证据,说明开放权重和后训练如今确实可能改写这笔账。
1.3 团队更信工作负载调优和一手数据,而不是默认推理设置或通用提示词(🡕)
另一组强信号内容认为,现在真正有价值的 AI 增益,来自选对努力级别、给模型喂入真实运营数据,而不是盲目把推理强度拉高,或者让它泛泛地出点子。
@octane_security 报道称(15 个赞,6 条回复,596 次浏览)指出,在其安全检测流水线的两个阶段里,GPT-5.6 max 从来都不是最佳配置;在新变体胜出的那个阶段,xhigh 以更低成本击败了 max。这张图的重要性在于,它把“多想一点”变成了一个可以实证测试的工作负载调优问题。

@morganlinton 发布了(14 个赞,3 条回复,1,411 次浏览)介绍了一次 VulcanBench 努力度扫描:Grok 4.6 在 medium 下以 87.0% 的 pass@1 达到峰值,到了 high 反而降到 73.9%,到 xhigh 也只部分回升。一条回复还明确确认,在这套测试里 medium 优于 high 和 xhigh,这正是公开排行榜通常不会展示的“旋钮级”结果。

@0xrux 认为(18 个赞,5 条回复,397 次浏览)指出,对 YouTube 创作者来说,更有效的 Claude 用法不是“给我 10 个视频创意”,而是把模型接到真实的频道分析数据上,让它根据留存率、CTR、搜索和评论来推理。@yunta_tsai 表示(240 个赞,18 条回复,9,192 次浏览)则称,Grok 4.6 的多模态能力在日常使用中把视频审查工作流提速了 10 到 100 倍;回复还澄清,它可以处理任意视频速度,同时仍能很快返回答案。
讨论要点: 共同标准是“基于证据的 AI”:对的旋钮、对的连接器、对的工作负载、对的数据。
与前一天的对比: 8 月 13 日把评估推向面向生产部署的度量;8 月 14 日则把同样的直觉进一步延伸到了努力控制和实时数据连接器。
1.4 构建者持续交付的是窄任务智能体界面,而不是一个通用机器人(🡕)
今天最可信的产品分享,并不是“一个智能体包打天下”,而是边界明确、接口清晰的系统:法律审查、渗透测试、具身 3D 智能体,或机器人数据采集。
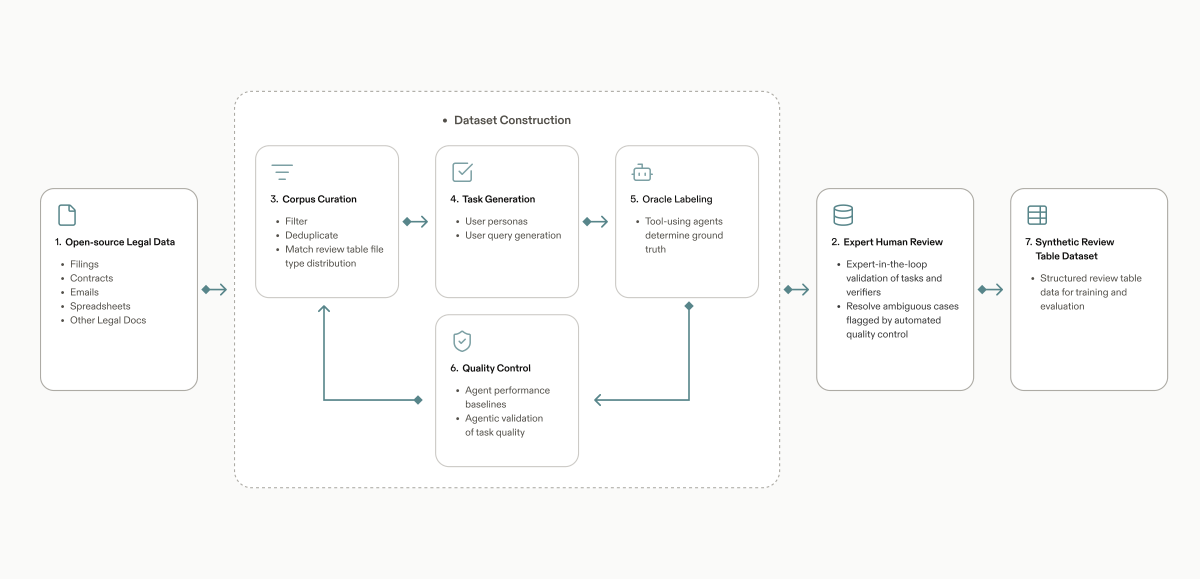
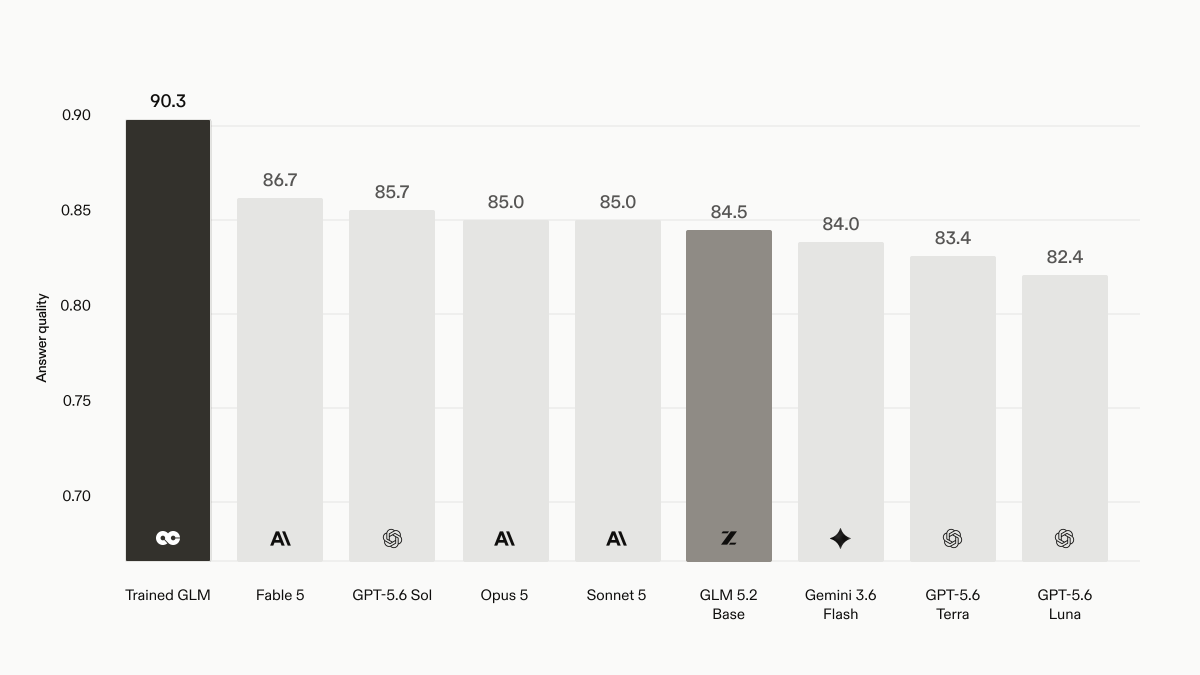
@harvey 表示(4 个赞,1 条回复,411 次浏览)介绍了其为 Review Tables 后训练的 GLM-5.2 变体:律师可以针对最多 10,000 份文档提出最多 500 个问题,同时把成本降低 50%,并提升答案和引文质量。配图非常具体:一张展示文档网格界面,一张说明合成数据集流水线,另外两张量化了相较前沿基线的答案质量与成本权衡。

@tom_doerr 分享了(7 个赞,2,206 次浏览)PentestAgent,公开 README 则介绍了一个基于 LiteLLM 的终端 TUI,支持 /assist、/agent、/crew、浏览器工具、带渗透测试实用程序的 Docker 镜像,以及用于分层协作的 MCP 子智能体生成。@fourjjjjt 回顾了(18 个赞,5 条回复,190 次浏览)介绍了 three.ws;其公开 README 和 网站 将其描述为一个浏览器原生 3D 智能体平台,支持文本/图像转 3D、实时语音与面部捕捉、MCP 和 A2A 工具连接,以及按聊天付费的 USDC 流程。@Kai_Nimo02 介绍了(18 个赞,17 条回复,96 次浏览)则把 Axis Robotics 描述为一个“复利式”的物理 AI 数据引擎:通过仿真和人工纠错,让下一批机器人数据更聚焦于当前模型的失败点。
讨论要点: 信息流更偏爱任务单一、数据边界明确、运营闭环可见的系统。
与前一天的对比: 8 月 13 日偏好窄任务工作界面而非通用聊天机器人;8 月 14 日则把这一趋势延伸到了智能体平台、企业审查系统和机器人数据基础设施。
2. 哪些事情让人感到沮丧
编排和推理旋钮仍会静默失效
严重程度:高。最明显的挫败感在于,智能体质量可能因为多数团队仍未明确度量的原因而崩塌。@Argona0x 认为(166 个赞,4 条回复,312 个收藏,36,535 次浏览)指出,仅改变智能体连接方式,同样的任务结果就可能从显著负面变成显著正面;与此同时,@octane_security 显示(15 个赞,6 条回复,596 次浏览)和 @morganlinton 显示(14 个赞,3 条回复,1,411 次浏览)表明,视工作负载而定,更高的推理设置可能花费更多,却仍不如 medium 或 xhigh。@0xClodex 总结道(17 个赞,10 条回复,18 个收藏,553 次浏览)则从执行框架一侧指出了同样的失败模式:智能体失败时,缺的往往是上下文传递,而不是模型原始智能。当前可行的应对方式是显式测试拓扑、按阶段扫描努力级别,并建立由轨迹驱动的评估闭环。这是非常值得直接投入构建的方向。
AI 系统在工作现场仍拿不到正确的数据
严重程度:高。多条内容抱怨的与其说是模型太弱,不如说是闭环里缺少证据。@0xrux 认为(18 个赞,5 条回复,397 次浏览)指出,创作者如果不给出真实 YouTube 分析数据、只是索要创意,得到的往往是泛泛空话;@Kai_Nimo02 介绍了(18 个赞,17 条回复,96 次浏览)则称,机器人领域的瓶颈在于缺少“行动互联网”,而不是模型智能不够。甚至 Harvey 的 帖子(4 个赞,1 条回复,411 次浏览)也从企业法务角度说明了同一点:只有团队在精确的文档审查执行框架里构建了合成、审核过的任务语料,质量才真正提升。应对方式是重连接器、重领域化的数据管道,而不是继续追加通用提示词。这是非常值得直接投入构建的方向。
买家仍分不清定制 AI 和薄封装
严重程度:高。@mardehaym 报道称(8 个赞,6 条回复,1,009 次浏览)讲述了一起私募股权尽调案例:一个号称专有的 AI 平台,最后被发现不过是套在 GPT-4o 外面的 React 前端和系统提示词;并借这个案例列出了四个反复出现的尽调缺口:模型依赖、训练数据责任、人才集中度,以及集成失败风险。@paulg 指出(247 个赞,39 条回复,17,524 次浏览)指出,开放权重模型调优之所以重新变得可行,只是因为经济性和质量差距变了;这也在无形中抬高了任何“薄封装也能形成持久差异化”的说法门槛。应对方式是做真正的技术尽调,检查模型实际所有权、训练数据来源和替换风险。这是非常值得直接投入构建的方向。
企业 AI 的 ROI 和供应商选择仍然不清晰
严重程度:中。@AlphaSenseInc 分享了(4 个赞,2 条回复,3 个收藏,510 次浏览)总结了一次 Dell 员工访谈:在上下文密集、token 用量高的任务上,Anthropic 已从 OpenAI 手中拿走了一部分工作负载份额,因为其质量保持得更好,规模上去后有效成本也更优;但非编程聊天机器人和推理场景的 ROI 仍为负,开源部署也带有隐性的人力和集成成本。有价值的抱怨并不是某家模型供应商永远“赢了”,而是只有把 token 规模、隐私约束、切换摩擦和内部运维人头都算进去,真实成本才会显现。这值得投入构建。
安全和审核系统可能存在不均衡执行
严重程度:中。@Wallface 认为(6 个赞,74 次浏览)指出,X 的 AI 安全流水线在扫描滥用内容时,似乎会跳过“High PageRank”账户,并附上了一张公开审计图:某个已认证账户有 406 条攻击性帖子被归档,而且这些帖子触达的中位数高于该账户的普通内容。该帖子并不能证明内部标签究竟如何分配,但它确实展示了一个具体的用户投诉,而且依据来自代码阅读和归档结果,而非泛泛的公平性口号。当前的应对方式是提高独立可审计性,并确保分类器在不同账户层级上得到一致应用。这值得投入构建。

3. 人们希望存在什么
能按任务自动选择最佳配置的编排与努力调优层
大家显然希望有一个控制层,能决定什么时候保持单智能体、什么时候扇出,以及每个阶段该买多少推理努力。@Argona0x 认为(166 个赞,4 条回复,312 个收藏,36,535 次浏览)指出,监督和拓扑对结果的影响,有时比多调用一次模型还大;@octane_security 显示(15 个赞,6 条回复,596 次浏览)和 @morganlinton 显示(14 个赞,3 条回复,1,411 次浏览)则表明,默认的 high/max 推理在真实流水线里可能反而是错误选择。这个需求务实、紧迫,而且直接关联金钱、延迟和失败率,而不是出于好奇。机会类型:直接。
低成本、本地化定制强大开放模型
信息流里不断有人在追问这样一种世界:强大的本地模型可以快速适配真实工作。@paulg 指出(247 个赞,39 条回复,17,524 次浏览)称开放权重模型调优又回来了,@sudoingX 显示(159 个赞,12 条回复,122 个收藏,6,709 次浏览)指出 llama.cpp 的一个 flag 就能显著提升 Qwen 3.8 在消费级 GPU 上的吞吐,@RituWithAI 展示了(8 个赞,65 次浏览)则把 Unsloth 视为在笔记本或免费 Colab 上做微调的一条路径。这是直接的产品需求,因为大家要的是更快的适配循环,而不只是更便宜的推理。机会类型:直接。
基于用户自有数据、以证据为基础的副驾驶
多条内容都指向同一种缺失产品:副驾驶能看见用户的真实数据,并在其上推理,而不需要手动导出数据或依赖脆弱的提示词技巧。@0xrux 想要(18 个赞,5 条回复,397 次浏览)展示了直接连接 YouTube 分析数据的 Claude;Harvey 的 帖子(4 个赞,1 条回复,411 次浏览)展示了以真实法律文档任务为基础的审查执行框架的价值;@Kai_Nimo02 想要(18 个赞,17 条回复,96 次浏览)则展示了由聚焦失败的行动数据驱动的机器人模型,而不是由通用互联网规模文本驱动的模型。这个需求既务实又紧迫,因为大家抱怨的是缺证据,不是缺 token。机会类型:直接。
面向 AI 企业的技术尽调与来源追踪工具
市场也在呼唤一种方式,用来核实一家 AI 公司到底真正拥有什么。@mardehaym 报道称(8 个赞,6 条回复,1,009 次浏览)讲述了一次揭穿薄封装的尽调失败案例;GLM-5.3 的讨论则补充了另一个角度:如果同一个基础模型在后训练后就能发生巨大变化,那么仅凭“模型是谁”已经不足以理解它的能力、安全性或防御性。这既是实际需求,也是围绕采购、并购和合规的信任需求。机会类型:竞争性。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Graph Engineering | 编排方法 | (+/-) | 把监督、扇出和单智能体基线明确化;能显著改善任务结果 | 效果依赖任务;额外智能体也可能让结果更差 |
| GLM-5.3 | 开放权重基础模型 | (+) | 基础模型不变、后训练更强、编程/网络安全得分更高、支持 1M 上下文 | 权重因安全审查延迟发布;在部分任务上仍落后于顶级闭源模型 |
| Qwen3.8-27B | 本地多模态开放模型 | (+) | 本地编程/智能体得分强,原生支持 262K 上下文,提供推理控制,可在消费级 GPU 上运行 | 基准集仍在演进;部分说法仍主要来自厂商或推文 |
| Unsloth | 微调技术栈 | (+) | 降低内存需求,可在廉价硬件上运行,可导出到 Ollama/vLLM/GGUF | 本数据集中的公开证据属于二手信息,仍需用户自行验证 |
| VulcanBench effort 扫描 | 基准测试 / 评估方法 | (+) | 揭示非单调努力曲线、未完成运行,以及“每解决一个任务的成本”权衡 | 套件规模较小且运行间有波动,结果不具普适性 |
| Octane 配置扫描 | 内部评估方法 | (+) | 按阶段测试配置优于默认 max 推理,并将成本与得分挂钩 | 仅适用于一条安全流水线;设置不一定能直接迁移 |
| Claude YouTube 连接器工作流 | 连接器 / 分析副驾驶 | (+) | 建议基于留存率、CTR、评论和频道数据,而非泛泛提示词 | 依赖连接器接入,且只在存在一手数据时才有帮助 |
| Anthropic 关于高 token 企业工作负载的观点 | 模型供应商选择 | (+/-) | 在某个企业案例中,高 token 用量下长上下文性能更好、有效成本更低;隐私立场也影响供应商选择 | 基础价格更高、工作流锁定更强,整体非编程 ROI 仍为负 |
| PentestAgent | 安全智能体框架 | (+/-) | 支持多模型、浏览器与终端工具、Docker 镜像和 MCP 子智能体 | 在敏感领域需要配置、API 密钥和操作员判断 |
| three.ws | 具身智能体平台 | (+/-) | 浏览器原生 3D 智能体、文本/图像转 3D、工具连接、支付和 AR | 覆盖面复杂;长期采用的证据仍很早期 |
| Harvey Review Tables 定制模型 | 任务专用模型 + 执行框架 | (+) | 在明确的法律工作流中,以更低成本获得更好的答案和引文质量 | 强领域专用,且仅由一家公司的内部任务界面支撑 |
总体情绪偏向具有明确任务界面的窄任务系统,但这种乐观带有条件。大家喜欢 GLM-5.3、Qwen3.8-27B、Harvey 的定制模型,以及由连接器驱动的 Claude 工作流,不是因为它们单纯更大或更新,而是因为它们看起来可部署、可度量。@AlphaSenseInc 分享了(4 个赞,2 条回复,3 个收藏,510 次浏览)也讲述了一个更谨慎的企业迁移故事:Anthropic 正在上下文密集型工作中从 OpenAI 手中拿走份额,但除编程外的整体 ROI 仍为负,开源栈也仍带着隐性的集成成本。当天反复出现的应对模式其实一致:调优执行框架、调优努力旋钮、接入一手数据,并先在真实工作流上验证,再决定是否为更多推理或更多智能体付费。迁移压力正从通用前沿默认配置,转向一套由开放模型、评估扫描、领域连接器和边界明确的智能体界面构成的栈。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Harvey Review Tables 定制模型 | @harvey | 经过后训练的法律审查模型与执行框架,用于在超大文档表中回答问题并给出引文 | 在审查表规模下,前沿模型推理成本过高,且引文质量需要提升 | GLM-5.2、Applied Compute AC2、合成法律任务生成、单轮 RAG、agentic search | 已发布 | 帖子 |
| PentestAgent | @tom_doerr | 用于黑盒安全测试的开源框架,支持 assist、agent、crew 和 interactive 模式 | 手动渗透测试工作流仍需要操作员在工具和模型之间做过多编排 | Python、LiteLLM、Docker、Playwright、浏览器 + 终端工具、MCP 子智能体 | Beta | 仓库 |
| three.ws | @trythreews | 浏览器原生 3D AI 智能体平台,支持具身化身、工具、支付和可选链上身份 | 纯文本智能体缺少差异化界面、变现通道和可迁移的具身接口 | Forge 文本/图像转 3D、MCP、A2A、LiveKit、ElevenLabs、Base/Solana、WebXR | 已发布 | 网站 · 仓库 |
| Axis 复利式数据引擎 | @axisrobotics | 以仿真优先的机器人数据平台,把人工工作引导到当前模型失败点上 | 机器人模型缺少可扩展的行动数据和针对失败的纠正闭环 | 浏览器遥操作、仿真轨迹、AXIS-V1 数据集、第一视角采集、贡献追踪 | Alpha | 帖子 |
Harvey 是当天最清楚的例子:一家公司把一个昂贵的前沿模型问题,收窄成了一个领域专用的后训练加执行框架问题。附带材料同时展示了工作流界面和成本/质量权衡,这让它比一句泛泛的“我们微调了一个模型”具体得多。

PentestAgent 和 three.ws 则指向了另一条路:构建更有主张的智能体平台,而不是通用聊天。PentestAgent 把任务范围收窄到安全工作流和工具访问;three.ws 则把界面扩展到化身、支付和实时交互。Axis 则符合第三种模式:构建者正在沿栈向下移动,试图掌控未来机器人模型所依赖的数据引擎。
6. 新动态与值得关注的内容
开放权重发布开始继承前沿模型式的安全延迟
@kimmonismus 报道称(173 个赞,17 条回复,31 个收藏,12,121 次浏览)指出,尽管 GLM-5.3 已经发布,其权重仍大约延后两周;Z.ai 的公开 GLM-5.3 文档 也表示,基础模型保持不变,但后训练让编程和网络安全得分显著上升。这一点之所以重要,是因为数据里出现了一个开放模型发布被放慢的案例:不是因为能力不足,而是因为在权重放出前,需要先评估并加固新增能力。
一个 flag 带来的本地提速,变成了社区基准测试事件
@sudoingX 显示(159 个赞,12 条回复,122 个收藏,6,709 次浏览)指出,Qwen 3.8 随模型一同发布的多 token 预测头,可以直接在 llama.cpp 中启用,而不需要单独构建草稿模型。后续回复把这条内容变成了一个小型公开复现串,不同 GPU 用户纷纷汇报自己的提速幅度和设置。这很值得注意,因为它说明社区已经把推理 flag 视作产品界面的一部分。
关于 AI 审核的公开投诉,正变得越来越像审计
@Wallface 认为(6 个赞,74 次浏览)依据的是归档帖子、代码阅读和触达率对比,而不是泛泛的公平性抱怨。即便该帖子不能独立证明内部标签分配,其证据结构仍然值得注意:指标、归档内容和分类器行为被呈现为读者应自行核验的对象,而不是单纯要求相信的说法。
7. 机会在哪里
[+++] Orchestration and eval tuning for agent systems — Evidence appears across sections 1, 2, and 4. @Argona0x 说明,拓扑能让结果从大幅负面摆到显著正面;而 Octane 和 VulcanBench 则显示,默认推理设置可能又慢又差。一个能按阶段选择图结构、监督水平和努力设置的产品,正好回应了这种反复出现的现实抱怨。
[+++] 面向领域工作流的一手数据副驾驶 — Harvey 的审查表模型、Claude 的 YouTube 分析连接器,以及 Axis 的机器人数据闭环,都指向同一个缺口:人们希望副驾驶能基于用户自己的证据推理,而不是依赖通用提示词。这个机会很强,因为数据边界明确,痛点也已经进入实际运营环节。
[++] 本地开放模型加速与定制工具包 — GLM-5.3、Qwen3.8-27B、Qwen MTP 提速讨论串和 Unsloth 都显示,市场需要一套栈,让强大的开放模型更快运行、更便宜适配,也更容易掌握在自己手里。竞争会很激烈,但需求具体,而且已经有从业者实验在支撑。
[++] AI 尽调与来源追踪基础设施 — 薄封装尽调案例和 GLM-5.3 的安全延迟,都指向买家、投资者和运营者在评估 AI 系统时存在的信任缺口。能够梳理模型依赖、训练数据来源、后训练历史和替换风险的工具,将服务于采购、并购和合规,而不仅仅是构建者。
[+] 机器人数据基础设施 — Axis 的帖子仍然很早期,互动量也不高,但它点出了一个明确瓶颈:模型需要更多聚焦失败的行动数据。如果物理 AI 持续升温,数据层的价值可能会超过任何单一机器人演示。
8. 要点
- 智能体质量越来越是系统问题,而不只是模型问题。 最清楚的证据来自图结构工程和执行框架相关帖子:监督、上下文时机和评估闭环都可能主导最终结果。(Argona0x)
- 开放权重模型的势头确实回来了,因为后训练和本地执行在同一天都取得了进展。 GLM-5.3 的提升并未改变基础模型;而 Qwen 3.8 的讨论关注的是实际本地吞吐和部署,而不只是发布时的标题效应。(kimmonismus)
- 把默认 max 推理当作通用策略,正越来越失去公信力。 Octane 和 VulcanBench 都表明,在实际被测工作负载上,更高努力可能花得更多、做得更差。(octane_security)
- 最可信的构建者都在持续收窄任务,而不是承诺一个万能智能体。 Harvey 针对法律审查表,PentestAgent 针对黑盒安全测试,three.ws 针对具身化的浏览器原生智能体,Axis 则针对机器人数据瓶颈。(harvey)