Twitter AI - 2026-08-16
1. 大家在讨论什么
1.1 本地开源模型把入门门槛降下来了,但运行工况并没有变简单(🡕)
最强的话题簇仍然是本地开源推理,但争论的焦点已经从“它能不能媲美前沿 API?”收窄为“加入真实上下文、harness 逻辑和长时间运行后,到底会先在哪些地方出问题?”四条入选内容呈现出一种分裂:可负担性取得突破,但可靠性成本依旧顽固存在。
@analogalok 显示(368 次点赞、22 条回复、33,694 次浏览、484 次收藏)称,通过结合 Unsloth 的 IQ4_XS 权重、CPU/GPU 混合卸载、q4 KV cache 和原生 MTP,Qwen 3.8 27B Q4 可以塞进一张配备 8GB VRAM 的 RTX 4060,并支持 64,000-token 上下文窗口。帖子对运行配方写得异常具体:prefill 速度为每秒 150 个 token,decode 速度为每秒 5 个 token,磁盘占用 14.6GB,以及精确的 llama-server 参数。回复一方面让这项说法更可信,另一方面也进一步收窄了它的适用边界:有后续回复强调,这套配置全程没有落到磁盘分页;也有人指出,它主要适合非交互式工作流。
@DogukanUrker 进行了基准测试(46 次点赞、5 条回复、2,200 次浏览、24 次收藏)在一张 12GB RTX 3060 上测试了三个本地模型,并认为“选一个 2-bit 的大模型”优于“选一个 4-bit 的小模型”。附图显示,2-bit 的 Qwen 3.8 27B 和 Muse Glimmer 30B 在 HumanEval、MBPP、GPQA 和 IFEval 上都超过了 4-bit 的 Gemma 4 12B;正文还补充了一条实用提醒:当模型处在智能体循环里时,循环速率和分数同样重要。

@witcheer 测试了(35 次点赞、2,227 次浏览)测试了同一 Qwen 系列在长上下文埋藏事实检索上的表现,结果发现便宜档位并非没有代价:Q6_K 在 16k、32k 和 64k 噪声窗口下始终保持满分,而 UD-IQ3_XXS 则跌到 73、67 和 80。@burkeholland 报道称(85 次点赞、54 条回复、19,446 次浏览)则展示了同一故事的另一面:即便拥有 64GB 的 VRAM,他的 Qwen 3.8 27B 在 harness 和上下文增长后也慢了下来,以至于 Grok 4.6 和 Kimi K3 大约 30 分钟就完成了同一任务,而本地运行六小时后仍未结束。

讨论洞察: 回复并没有否认本地模型的进展,而是在收紧“胜利条件”。大家接受 27B 级模型可以跑在更小的显卡上,但不断追问:一旦加入 harness 提示、上下文压缩、长上下文和多步执行,它们是否还能保持稳定。
与前一天的比较: 8 月 15 日的焦点已经是开源模型,但更多还停留在“到底能不能部署”。到 8 月 16 日,讨论又往下深了一层,进入运行时经济学:量化档位、循环速率、上下文深度,以及“能跑”和“能用”之间的界线。
1.2 AI 产品之争从模型质量转向了支出透明度、分发和所有权(🡕)
至少五条入选内容把产品选择当成操作系统层面的问题,而不是跑分问题。信息流关心的是:使用限制会出现在哪里,harness 能不能迁移,AI 搜索是否正在改写分发,以及内部自建现在是否已经快过采购。
@Da7_Tech 评测了(138 次点赞、34 条回复、7,751 次浏览、72 次收藏)不是按基准测试快照,而是按日常使用体验来评估主要 AI 订阅服务。长线程详细表扬了 SuperGrok 的速度和 X 访问能力、MiniMax 明确的 token 计量、ChatGPT 在研究中的实用性,以及 Cursor 的编码环境;同时批评了 Grok 的硬性限制、GLM 在缓存计费上的模糊性、Claude 不透明的使用规则和惊人的 token 消耗,以及 Factory 封闭的 harness——一旦打到套餐上限,实用性就大幅下降。
@chamath 认为(230 次点赞、49 条回复、54,883 次浏览、115 次收藏)称,AI 已经把“自建还是采购”的天平明显拨动了:内部工作流软件可以在企业采购外部 SaaS 还在走审批的同一时间窗口内,完成定义、开发、测试和上线。最有价值的一条回复并未否认这一变化,而是把更优模式收窄为:自建真正差异化的窄环节,乏味但通用的部分继续采购。
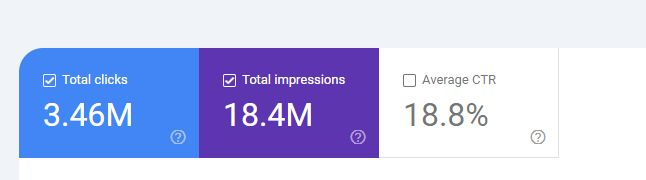
@alexgroberman 表示(44 次点赞、4 条回复、4,271 次浏览)称,Google 现在已经公开告诉企业,要跳出传统 SEO,去衡量 AI 驱动发现渠道的“全貌”。这组截图之所以重要,是因为它把 John Mueller 的原话和实际操作界面放在了一起:AI 搜索流量截图、趋势视图、关键词探索,以及 ChatGPT 生成的 AI SEO 工具列表。这让帖子不像是在做预测,更像是在提出一种可测量的主张。
@lianshangpixiu 将其定义为(26 次点赞、23 条回复、2,740 次浏览)介绍了 KOR Protocol 的 Streamline,把它定位为帮助创作者决定“下一步该做什么”的工具,而不是帮助他们“更快产出更多内容”的工具。KOR 的公开文档把 Streamline 描述为其更广义创作者操作系统的一部分,同一套协议栈同时延伸到视频、视觉艺术和多格式工作流。@ctatedev 发布了(14 次点赞、827 次浏览、9 次收藏)则提到了 json-render 中的 named-slots 功能;其公开 GitHub README 将该项目描述为一个带护栏的生成式 UI 框架,可将 AI 生成的 JSON 安全渲染到 React、Vue、Svelte、Solid、Next.js、终端、PDF 和电子邮件等目标环境。
讨论洞察: 回复反复指向同一个杠杆:当原始模型质量差距缩小时,可迁移性和可观测性就变得更重要。用户想要的是可信的 token 计量、在打到套餐上限后仍然可控的 harness,以及能够覆盖 AI 答案而不只是搜索排名的分发测量。
与前一天的比较: 8 月 15 日,大家偏爱能把配置成本藏起来的智能体产品。到 8 月 16 日,产品焦点还在,但讨论已经转成一场关于计费和所有权的争论:读者想看清支出、限制,以及这些产品所处的分发层。
1.3 计算需求依然广泛,但瓶颈正向网络和数据闭环外移(🡕)
计算仍然是看涨主题,但当天最好的内容把它说得更具体了。证据已经从“我们需要更多 GPU”扩展为“我们还需要更多站点间光纤、更多机器人数据,以及更多仿真闭环”。
@danroberts0101 认为(1,074 次点赞、85 条回复、59,469 次浏览、104 次收藏)称,每建成一个新的 AI 数据中心,带来的不是需求满足,而是更多 AI 需求,因为能力提升、更便宜的推理和新的软件用例,会以快于电力、混凝土和输电建设的速度把消费继续推高。回复大多同意需求会继续增长,争论更多集中在时点和供给滞后上。
@SMASIMHO 补充说(75 次点赞、3 条回复、3,263 次浏览)引用 Goldman Sachs 的估算称,到 2030 年,AI 智能体带来的 token 使用量可能增长 24 倍,并把同样的逻辑延伸到物理 AI 和生成式智能体。附图的价值在于,它把企业智能体、消费者智能体、生成式智能体和物理 AI 分开来看,而不是把“AI 需求”画成一条没有区分的总线。

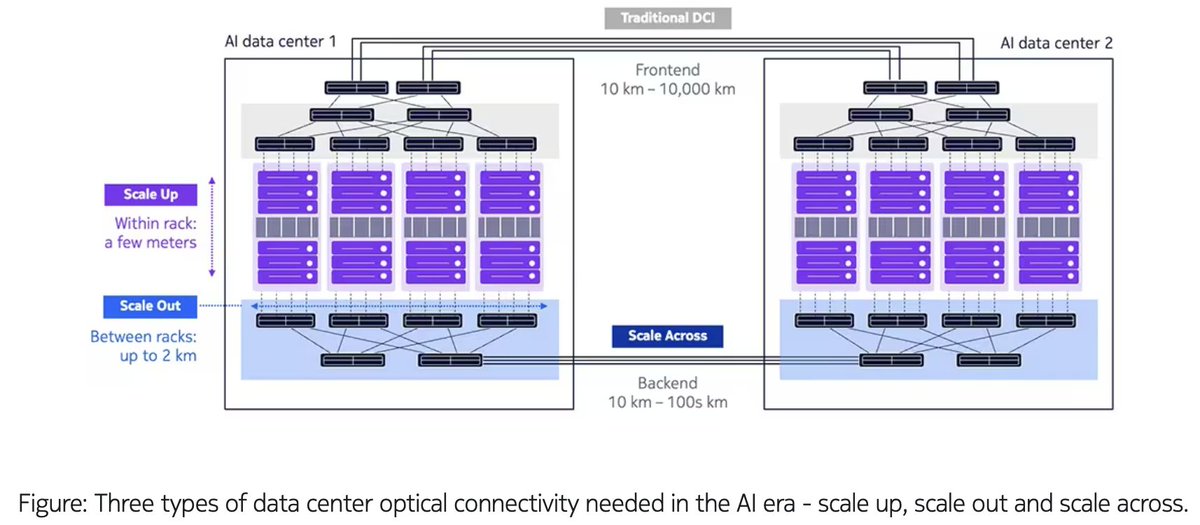
@KawzInvests 强调了(94 次点赞、16 条回复、21,749 次浏览、44 次收藏)指出了栈更底层的一个基础设施约束:连接 AI 数据中心站点所需的光网络。附图把问题拆成 scale up、scale out 和 scale across;引用的财报评论则称,仅连接两个 hyperscaler 站点,就可能需要相当于该客户过去十年所建骨干网容量两倍的带宽。
物理 AI 也符合相同模式。@Tamimofficial39 报道称(31 次点赞、27 条回复、212 次浏览)称,Axis Robotics 正在向 OpenRoboto 的开放数据池送入 3M+ 条多模态轨迹;@JannatSariha 强调(24 次点赞、21 条回复、211 次浏览)则强调了真实世界数据、模型训练、随机化评估和更优模型之间的循环。合作示意图之所以重要,是因为它把机制写得很清楚:Bittensor Subnet 80 竞赛、miners 基于 π0.5 基础模型进行微调、持续评分,以及随机化的 LIBERO-Pro 评估。

讨论洞察: 有意思的分歧已经不再是 AI 基础设施会不会扩张,而是下一个卡点究竟在哪里。网络、数据采集、基准可审计性和仿真真实性,受到的关注几乎已经接近原始模型算力本身。
与前一天的比较: 8 月 15 日让开放机器人“数据到模型”的闭环更清晰了;8 月 16 日则把这套逻辑扩展到了更广的计算栈,涵盖光纤、光互连、仿真和机器人数据采集。
1.4 安全讨论变得更偏操作层:扫描技能、锁住动作、解释组织架构(🡕)
相比前一天更抽象的评估争论,这一波安全讨论更具体。四条入选内容聚焦于操作者控制、在线安全工具,以及当前沿实验室重组负责 preparedness 的团队时,这到底意味着什么。
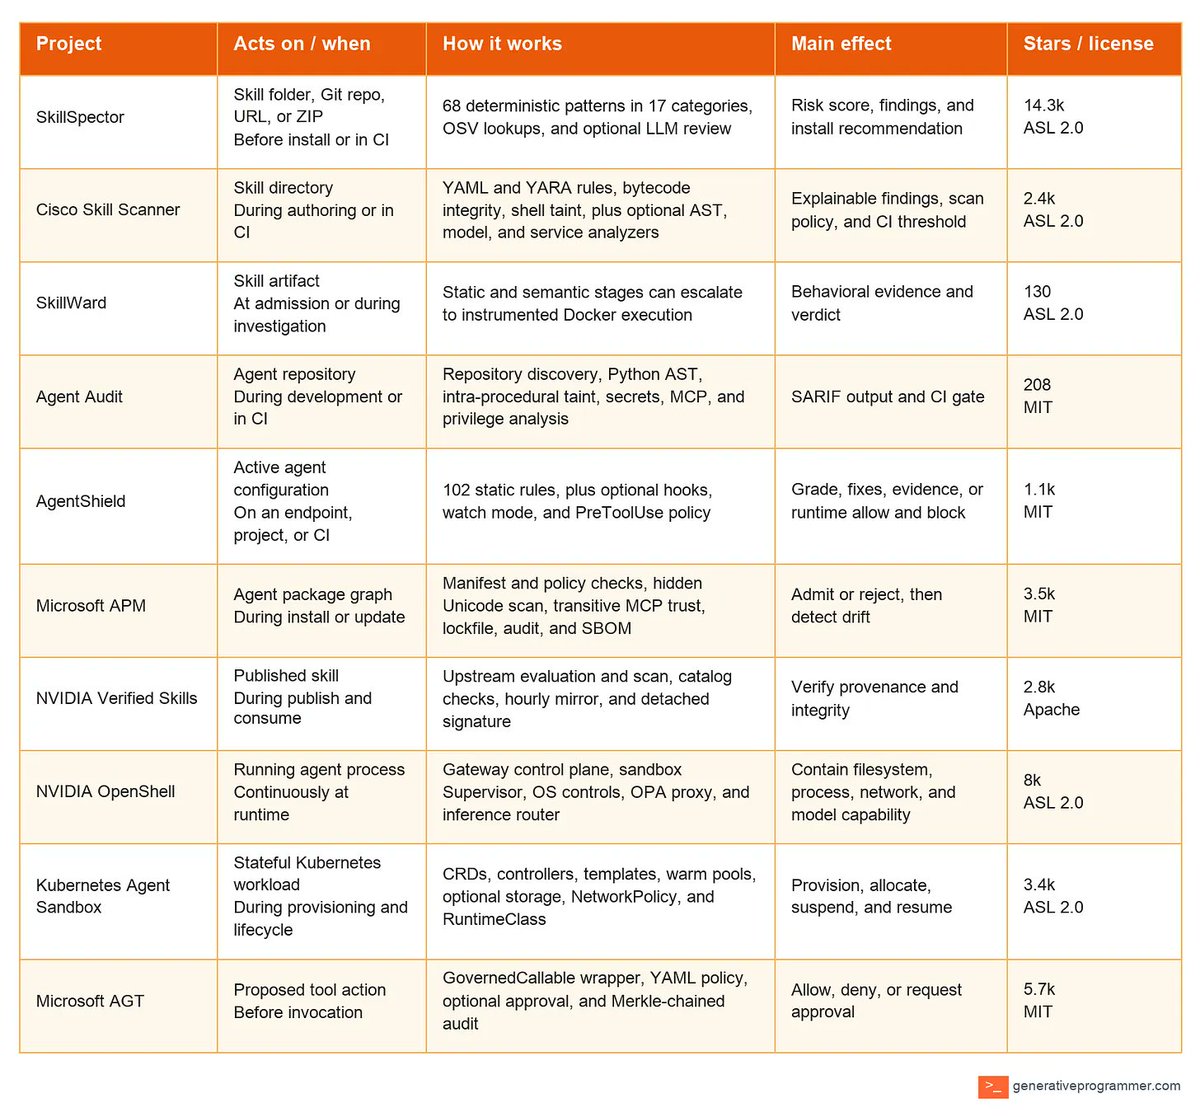
@bibryam 梳理了(11 次点赞、732 次浏览、18 次收藏)介绍了用于保护 AI 智能体技能的开源工具。附带的对比表本身就信息量很大,链接到的公开代码仓库还补充了更多细节:SkillSpector 描述了 17 个类别下的 69 种漏洞模式,而 Cisco Skill Scanner 结合了静态签名、行为数据流分析、LLM 分析和 CI/CD 输出。
@0xCristal 建议(14 次点赞、6 条回复、391 次浏览)提到了再往上一层的防护:起飞前检查、审批闸门、可见篡改痕迹的日志、严格的云权限,以及针对高风险操作的人在回路审核。@NitinGavhane_ 指出了(2 次点赞、73 次浏览)则给出了一个更令人警惕的进攻性安全案例,链接到 pwn.ai 的公开 XSS2Shell write-up;该内容称,一套基于开源模型的工作流发现了一条 pre-auth 的 WordPress XSS-to-RCE 漏洞链,影响所有受支持的 WordPress 分支,直到 7.0.3 紧急补丁和回移补丁上线后才被修复。
@AISafetyMemes 总结了(20 次点赞、1,969 次浏览)报道称 OpenAI 解散了其 preparedness 团队,The Verge 还独立确认,相关职责已重新分配到现有的 bio 和 cyber 团队。@_NathanCalvin 认为(26 次点赞、2,123 次浏览)则称,OpenAI 现在应当直接向公众解释:为什么这次重组会在公司持续讨论更强模型和“相称 safeguard”的同时,被视为一种安全提升。
讨论洞察: 这些内容的共同模式不是抽象地说“我们需要更多安全”,而是“把具体扫描器拿出来,把具体审批闸门拿出来,把具体缓解路径拿出来,再把公司内部究竟谁负责说清楚”。
与前一天的比较: 8 月 15 日把推理和网络安全评估视为操作工程问题。到 8 月 16 日,这种操作视角仍在,但更贴近部署:包审查、运行时护栏、漏洞发现,以及前沿实验室的团队结构。
2. 大家感到沮丧的地方
本地推理在真实智能体工作负载下仍会退化
严重程度:高。最反复出现的抱怨并不是开源本地模型不够强,而是廉价、快速的演示路径一旦遇到长上下文、harness 提示和循环执行,就撑不住了。@burkeholland 报道称(85 次点赞、54 条回复、19,446 次浏览)称,他在 64GB VRAM 上运行 Qwen 3.8 27B 时,速度下降到 hosted 的 Grok 4.6 和 Kimi K3 大约 30 分钟就完成了任务,而本地任务跑了六小时仍未结束。@witcheer 显示(35 次点赞、2,227 次浏览)称,短上下文基准分数接近,可能掩盖长上下文检索上 27 个点的差距;@DogukanUrker 认为(46 次点赞、5 条回复、2,200 次浏览、24 次收藏)则指出,决定一个本地模型是否适合进入智能体循环的,不只是分数,还有循环速率。当前的权宜之计是缩小使用范围:本地模型用于短对话、固定流水线或廉价后台任务;长周期执行则回退到托管系统。这一方向非常值得投入建设。
套餐限制和不透明计费仍在扭曲工具选择
严重程度:高。@Da7_Tech 评测了(138 次点赞、34 条回复、7,751 次浏览、72 次收藏)几乎是从“最先坏掉的是什么”这个角度审视了所有主流订阅:Grok 的限制、GLM 把缓存命中算进用量、Claude 不透明的 token 消耗、Codex 的每周上限、Factory 被套餐封死的 harness,以及 Perplexity 被扭曲的开源模型体验。痛点不只是贵,更在于不可预测。用户不知道缓存命中、一次长会话,或某一天高强度使用,是否会让套餐价值瞬间塌掉,就无法稳定规划工作流。权宜之计是叠加多个订阅、保留更便宜的后备方案,或优先选择 MiniMax 这类 token 计量明确的套餐。这一方向非常值得投入建设。
企业采购仍然慢于 AI 驱动的内部自建
严重程度:中。@chamath 认为(230 次点赞、49 条回复、54,883 次浏览、115 次收藏)称,AI 已经实质性改变了“自建”这一侧的能力边界;而回复则指出,真正的瓶颈在采购流程,而不是代码。@alexgroberman 补充说(44 次点赞、4 条回复、4,271 次浏览)称,甚至分发本身也在运营者脚下变化,因为旧 SEO 指标已无法描述用户发现产品的完整表面。当前的权宜之计是快速自建狭窄的内部工作流,而把采购决策留给那些非差异化部分。这值得投入建设,因为抱怨是程序性、反复出现的,而非一次性的。
自主系统仍然需要明确的安全闸门和更清晰的责任归属
严重程度:高。@bibryam 分享了(11 次点赞、732 次浏览、18 次收藏)呼吁使用具体的扫描器和策略工具,因为围绕智能体技能的默认信任模型依旧太弱。@0xCristal 表示(14 次点赞、6 条回复、391 次浏览)称,如今任何授予写入或执行权限的人,都需要护栏、审批闸门、沙箱和审计轨迹。在前沿实验室层面,@AISafetyMemes 报道称(20 次点赞、1,969 次浏览)报道称 OpenAI 解散了其 preparedness 团队,而 @_NathanCalvin 认为(26 次点赞、2,123 次浏览)则称,OpenAI 现在需要解释为什么这算是一种改进。当前的权宜之计是更强的扫描、更紧的权限,以及人工审核层。这一方向非常值得投入建设。
3. 大家希望出现什么
面向消费者、且在长上下文下仍可靠的本地技术栈
信息流并不是在抽象地要求“更多开源模型”。它要的是:开源模型在加入 harness 提示、长上下文和多步执行之后,依然能用。@analogalok 显示(368 次点赞、22 条回复、33,694 次浏览、484 次收藏)展示了把 Qwen 3.8 27B 挤进一张 8GB 显卡需要多少调优;@witcheer 显示(35 次点赞、2,227 次浏览)则表明,便宜量化版本在长上下文下,埋藏事实检索任务仍可能丢掉四分之一。这个需求既现实又紧迫:现在很多人已经能把模型跑起来,但真正敢把它用于 repo 规模或文档规模工作的,还少得多。机会类型:直接。
透明定价与可迁移的 harness
人们反复要求两件事:套餐要把成本说清楚,harness 要在打到套餐上限后仍然有用。@Da7_Tech 评测了(138 次点赞、34 条回复、7,751 次浏览、72 次收藏)明确肯定了 MiniMax,因为它公开 token 计量;同时也批评 GLM、Claude、Factory 和 Codex 的套餐不透明,或存在额度断崖。这个需求不是理想化诉求,而是很实际的:用户想要可预测的成本控制、可延续的记忆,以及自带模型的可迁移性。机会类型:直接。
面向 AI 原生发现渠道的测量,而不只是传统 SEO
@alexgroberman 认为(44 次点赞、4 条回复、4,271 次浏览)称,连 Google 自己都在告诉企业,要考虑传统搜索排名之外的“全貌”;他的截图聚焦的是 AI 搜索流量和类似引用的可见性表面,而不只是蓝链排名。这看起来是一项现实需求,因为运营者已经相信这个渠道存在;他们缺的,是稳定的测量层。机会类型:直接。
面向物理 AI 的可验证数据与基准闭环
Axis/OpenRoboto 这一簇,关注点并不是人形机器人秀,而是机器人基础设施栈缺失的部分应该长什么样。@Tamimofficial39 报道称(31 次点赞、27 条回复、212 次浏览)提到开放数据池新增了 3M+ 条多模态轨迹;@JannatSariha 强调(24 次点赞、21 条回复、211 次浏览)则强调随机化评估和持续基准测试。这个需求很现实:开放机器人进展仍然依赖可扩展的数据采集,以及可审计的晋级规则。机会类型:竞争型。
连接扫描、审批和审计的智能体控制平面
@bibryam 列出了(11 次点赞、732 次浏览、18 次收藏)提到了扫描器和治理项目;@0xCristal 介绍了(14 次点赞、6 条回复、391 次浏览)则提到了团队在写入和执行权限周围仍然需要的运行时控制。机会不只是再做一个静态扫描器,而是补上一层真正连起来的系统:能审查技能、执行审批策略、记录可见篡改痕迹的日志,并在风险升高时让人保持在回路中。机会类型:直接。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Qwen 3.8 27B | 开源 LLM / 本地推理 | (+/-) | 通过激进量化可跑在廉价 GPU 上;基准口碑强;支持长上下文和 MTP 调优 | decode 速度仍可能偏慢;长上下文质量高度依赖量化;在智能体运行中,循环速率仍然关键 |
| Muse Glimmer 30B | 开源 LLM / 本地推理 | (+/-) | 在 12GB 显卡上以 2-bit 运行时可与 Qwen 竞争;在引用的 harness 中循环速率更稳定 | 仍需按任务权衡准确率;这里并未声称它彻底解决了长周期稳定性问题 |
| Gemma 4 12B | 开源 LLM / 本地推理 | (-) | 4-bit 下占用更小 | 在引用的 harness 中四项基准全输,并在许多任务上陷入重复输出 |
| SuperGrok / Grok Build | 智能体产品 / 订阅服务 | (+/-) | 输出快、执行强、可访问 X、编排实用、PDF 处理好 | 以当前价格看,使用限制偏硬 |
| MiniMax Token Plan / M3 | 开源模型订阅服务 | (+) | token 计量透明、速度快;在 $20 价位上,网页开发和创意工作价值感强 | 指令遵循和长周期任务可能漂移 |
| ChatGPT / Codex | 聊天机器人 / 编程订阅服务 | (+/-) | 通用研究、规划、事实核查很快;Luna 适合较小任务的编码 | 每周编码额度可能很快见底;Sol 在指令执行上可能过于莽撞 |
| Claude / Claude Code | 聊天机器人 / 编程订阅服务 | (+/-) | 写作、头脑风暴、设计品味、视觉工作和 3D 相关任务表现强 | 用量不透明、token 消耗高、响应慢,且很难迁移到第三方 harness |
| SkillSpector | 智能体技能安全扫描器 | (+) | 覆盖 17 类中的 69 种漏洞模式;可扫描仓库、URL、压缩包和目录;支持输出 JSON/Markdown/SARIF | README 明确表示其定位是风险评分和尽力扫描,并不保证安全 |
| Cisco Skill Scanner | 智能体技能安全扫描器 | (+) | 结合模式检查、行为数据流、LLM 分析和 CI/CD 输出;对非标准技能提供宽松模式 | README 明确警告:没有发现问题并不代表没有风险 |
| json-render | 生成式 UI 框架 | (+) | 带护栏的组件目录、可预测的 JSON 输出、跨平台渲染,以及更丰富布局控制所需的 named slots | 需要开发者自行定义并维护组件目录和 schema |
| Qdrant + vLLM on OCI OKE | 自有智能体基础设施 | (+) | 提供基于 Terraform、FastAPI 和 Kubernetes 的公开参考架构,用于自控 RAG + 智能体服务 | 相比直接调用托管 API,运维负担更重 |
总体满意度取决于工作负载形态。对于廉价、短时且大多确定性的任务,人们越来越愿意接受开源模型或更低档套餐。对于长上下文、长周期或业务关键型执行,信息流仍偏好恢复能力更强、分发入口更好的托管系统。最清晰的迁移趋势不只是模型与模型之间的切换,而是:不透明的套餐和脆弱的本地技术栈,正在输给那些要么把计量摊开来讲、要么把控制权留在操作者手里的工具。
5. 大家正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Streamline | @KorProtocol | 审核创作者近期产出,与高表现内容做对比,并建议下一步该测试什么 | 降低内容策略背后的研究与决策成本 | 基于创作者/账号数据的 AI 分析;KOR 协议面向创作者工作流的界面 | Beta | 推文, KOR 文档 |
| json-render named slots | @ctatedev | 为带护栏的生成式 UI 框架增加命名布局区域 | 让 AI 生成界面更结构化、更可组合 | TypeScript、组件目录、React/Vue/Svelte/Solid/Next.js 渲染器 | Shipped | 推文, GitHub |
| Clude memory model | @sebbsssss | 一个 4B 专用记忆模型,基于 490 万个样本、覆盖九种记忆操作训练而成 | 试图让持久记忆比只靠通用模型更便宜、更可靠 | 4B 专用模型、本地量化推理、MemOps 风格评估 | Alpha | 推文 |
| Open Generative AI | @VaibhavSisinty | 开源应用,封装 14 家 studio 的 400+ 个图像、视频和 lip-sync 模型 | 用一个自托管入口替代多个付费媒体生成订阅 | 开源应用;根据 README,通过 MuAPI 提供模型访问 | Shipped | 推文, GitHub |
| SkillSpector | NVIDIA | 在安装前扫描智能体技能中的漏洞、恶意模式和高风险行为 | 降低第三方 AI 智能体技能带来的信任风险 | Python CLI;静态分析加可选语义检查 | Shipped | 仓库 |
| Skill Scanner | Cisco AI Defense | 面向 AI 智能体技能的尽力扫描器,结合行为分析和 LLM 分析 | 为团队提供 CI/CD 就绪的方法,以捕捉提示注入、数据外泄和恶意代码模式 | Python CLI;YAML/YARA、数据流、LLM、SARIF、GitHub Actions | Shipped | 仓库 |
| OCI RAG + agent reference app | @OracleDevs | 面向 OCI 的自托管 RAG 加智能体工具公开参考应用 | 向基础设施团队展示,如何自己掌控调度、服务和检索,而不是把一切都外包给 API | React、FastAPI、Qdrant、vLLM、OKE、GitHub Actions、Terraform | Shipped | 推文 |
最有意思的构建模式,是在压缩操作者投入。Streamline 试图把创作者策略工作从数小时压缩到数分钟;json-render 把生成式 UI 组合压缩成更安全的“目录 + 插槽”模型;Clude memory model 则试图把持久记忆成本压缩进一个更小的专用系统。
第二个模式是控制权。SkillSpector、Cisco Skill Scanner 和 Oracle 的自有 RAG 参考应用,都默认团队并不想把信任或运行时所有权完全外包。就连 Open Generative AI 也符合这一逻辑,只是方向不同:它不要求你去信任一个封闭媒体套件,而是提供一个开放入口,背后连接许多模型。
反复触发新构建的,并不是“AI 很酷”,而是工作负载摩擦:策略开销太大、运行时风险太高、订阅太多,或者对智能体允许运行的位置控制得还不够。
6. 新动态与值得关注的内容
OpenAI 的 preparedness 重组,成了公众信任信号
最强的组织层面信号,不是新模型发布,而是 报道 称 OpenAI 解散了其 preparedness 团队,并将职责并入现有的 bio 和 cyber 团队。@AISafetyMemes 放大传播了(20 次点赞、1,969 次浏览)引用了 FT 的内容,强调内部不安;@_NathanCalvin 追问了(26 次点赞、2,123 次浏览)则要求直接解释,为什么新结构会比旧结构更安全。它之所以值得关注,不在于愤怒情绪有多大,而在于证据标准变了:人们要的是结构性问责,而不是品牌层面的安抚。
自主安全工作出现了具体的进攻性安全证明点
@NitinGavhane_ 指出了(2 次点赞、73 次浏览)提到了 pwn.ai 的公开 XSS2Shell post;该内容称,一套基于开源模型的工作流发现了一条 pre-auth 的 WordPress XSS-to-RCE 漏洞链,影响受支持的 WordPress 分支,直到 WordPress 7.0.3 和回移补丁发布后才得到修复。这项说法之所以重要,是因为它把“AI 可以帮助做安全研究”从泛泛的愿景,推进成了具体漏洞、具体 CVE 和具体补丁事件。
推理成本研究继续把 RL 重新界定为更窄的优化目标
@mark_k 总结了(15 次点赞、4 条回复、1,171 次浏览)提到一篇论文,认为面向 LLM 推理的 RL 主要是在基础模型本来就会的解法之间重新分配概率,并提出了一种名为 ReasonMaxxer 的无 RL 替代方案。其核心主张是:只需对 1–3% 的 token 做定向干预,一种成本低得多的方法就能达到或超过完整 RL 的效果。这一点值得关注,因为它直接契合了当天更广泛的支出控制焦虑。
7. 机会在哪里
[+++] Long-context local agent runtimes — Multiple items agree that the next gap is not basic local inference but stable long-context execution with compaction, low loop rates, and predictable speed. @analogalok 展示了可负担性上的突破,而 @burkeholland、@DogukanUrker 和 @witcheer 则展示了当前技术栈究竟会在哪些地方出问题。
[+++] Transparent usage, limits, and harness portability — @Da7_Tech 几乎完全是从限制不透明和 harness 锁定的角度来谈订阅选择,而 @chamath 则认为,相较采购流程,内部自建正变得更快。一款能够给团队提供稳定计量、理解套餐约束的编排能力,以及自带模型可迁移性的产品,可以同时回应第 2、4、5 节的痛点。
[++] Agent control planes for risky actions — @bibryam、@0xCristal,以及公开的 pwn.ai XSS2Shell write-up 都指向同一个缺失层:光有扫描还不够。团队还想要审批闸门、执行策略、审计日志,以及在生产环境中始终附着于智能体的沙箱边界。
[++] AI-search measurement and optimization — @alexgroberman 认为,AI 搜索已经成为一个独立运营渠道,但工具侧仍明显偏早。机会不在于再做一个 SEO 仪表盘,而在于构建一个能跨搜索和 LLM 答案引擎跟踪引用、答案表面出现率,以及归因变化的系统。
[+] 开放的物理 AI 数据与评估基础设施 — Axis/OpenRoboto 这一簇表明,对共享数据池、可审计的基准晋级,以及与仿真相连的训练闭环的需求正在上升。这个信号今天还小于编程智能体市场,但它仍然是开放基础设施明显欠建设的少数明确方向之一。
8. 要点
- 本地开源模型跨过价格门槛的速度,快于跨过可靠性门槛的速度。 Qwen 3.8 现在已经可以被挤进便宜得多的硬件里,但长上下文检索、harness 降速和循环稳定性仍是现实约束。(来源)
- AI 产品选择越来越取决于计量与控制权,而不只是输出质量。 当天最强的订阅评测表扬了 token 用量清晰可见的套餐,也批评了那些因限制、缓存规则或封闭 harness 而让成本变得不可预测的工具。(来源)
- 计算需求正外溢到网络和机器人数据,而不只是模型训练。 信息流把关于 AI 需求持续扩张的宏观判断,与 scale-across 光互连和开放机器人轨迹池的具体证据放在了一起。(来源)
- 安全讨论变得更偏操作层。 人们分享的是扫描器、审批层和漏洞披露,而不再只是停留在宽泛的对齐术语上。(来源)
- 构建者仍在围绕工作流压缩与所有权发力。 当天最清晰的项目,都在试图削减研究开销、掌控更多运行时,或把多个订阅压缩进一个开放入口。(来源)