Twitter AI - 2026-08-18
1. 人们在讨论什么
1.1 基准测试正从模型排行榜转向工作流测试框架(🡕)
最集中、也最有说服力的信号是:衡量对象正从模型本身,外扩到模型周围的整套系统。四条入选内容把“更好的评测”变得更具体:智能体搜索基础设施开始被直接做基准测试,编程基准持续转向真实 PR 工作,人们开始要求给整个代码库打 AI 就绪度分,而测试框架本身也被视为前沿能力跃升的来源。
@ArtificialAnlys 宣布(390 个赞,32 条回复,23,369 次浏览,110 次收藏)介绍了 Artificial Analysis Search Index。这个新基准将模型固定为 GPT-5.6 Luna(medium),放在开源 Stirrup 测试框架内,只改变搜索提供商。配图的价值在于,它让权衡一眼可见:Parallel 得分 75,Exa 得分 74,Firecrawl 得分 73,而同一模型不接入搜索时只有 33 分。该帖及公开的 基准测试页面 也明确提出了成本层面的论点:即使搜索调用本身更贵,更好的检索仍可能降低单个已完成任务的总成本。

@morganlinton 表示(46 个赞,12 条回复,946 次浏览)提到,OpenAI 和 SpaceXAI 已开始支持 VulcanBench,并借此解释了他为何希望基准测试绑定“真实仓库”和“真实 PR”,而不是泛泛的编程分数。关键不在于基准太少,而在于团队仍无法判断,究竟哪些基准真正匹配自己的语言组合、任务组合和工作流形态。
@kirat_tw 提出(275 个赞,13 条回复,6,819 次浏览,76 次收藏)提出了代码库“AI 友好度基准”的想法:以 AI 修复 1,000 个静态问题所需的时间、算力和资金来衡量。回复并没有把它当成抽象哲学,而是立刻把它与代码库质量、可维护性,以及 FactoryAI Droid 的 readiness report 等相关工具联系起来。
@jun_song 强调(31 个赞,2 条回复,3,409 次浏览,23 次收藏)转述了 StateM 的说法:测试框架扩展把 GPT-5.6 Sol 在 Terminal-Bench 2.1 上推到了 95.3% 的原始准确率,也让 DeepSeek-V4-Flash 达到 88.8%,大致追平 GPT-5.6 Sol Max。尽管他也说明自己尚未亲自验证,但传递出的信号很明确:越来越多人相信,智能体性能的跃升可能来自测试框架变好了,而不只是模型变大了。
讨论洞察: 最有价值的细节来自成本与工作负载视角。@ReadEpoch 在 Search Index 的回复中指出,只优化单次搜索调用成本,抓不住真正重要的数字——单个已完成任务的总成本;Morgan Linton 则认为,团队还需要知道,一套评测里究竟有多少内容真正像自己的工程工作。
与前一天对比: 8 月 17 日对评测的讨论,主要仍停留在本地模型“证据质量”问题上。到了 8 月 18 日,这一关注点被扩展成更广泛的“测试框架与工作流如何被衡量”的叙事,覆盖搜索 API、编程基准和代码库就绪度。
1.2 开源模型获得可信度,靠的是可部署路径,而不只是权重(🡕)
开放权重模型的势头依然强劲,但讨论重心已从“开源模型正在追上来”转向“把具体部署路径、运行时表现和成本行为拿出来看”。五条入选内容分别从基准表、笔记本智能体、边缘解码和高恢复负载等角度,把这种转向讲清楚了。
@ArtificialAnlys 报道(86 个赞,9 条回复,3,678 次浏览)提到,GLM-5.3 在 Artificial Analysis Intelligence Index 上达到 60 分,与开放权重前沿的 Kimi K3 持平,同时在 GDPval-AA v2 上提升了 246 分。真正重要的不只是分数:帖文还指出,GLM-5.3 的输出 token 用量比 GLM-5.2 高约 20%,单任务成本是前代的 1.5 倍,但在同一档位里,单任务成本仍低于 Kimi K3 和 GPT-5.6 Sol。
@TheAhmadOsman 认为(117 个赞,12 条回复,3,091 次浏览)指出,Qwen 3.8 27B 在 Artificial Analysis Agentic Index 上拿到 51 分,这一点更具颠覆性,因为它跑在约 2,000 至 3,000 美元的硬件上。配图之所以重要,在于它把该模型直接与 GLM 5.2 和 DeepSeek V4 Pro 0813 对比,而不是和模糊的“本地 AI”预期相比;他的回复则把它重新界定为一个能力很强、适合搭配优秀编排器使用的子智能体。

@arena 补充道(40 个赞,6 条回复,6,061 次浏览)又给出了第二个可部署性证明:Inkling-Small。帖文称,它在单任务成本不到 Inkling 一半的情况下,交出了相近结果;配图中的恢复能力曲线尤其有信息量,因为它单独标出了 Bash Recovery,在该类别的开源模型里实现了最高的净提升:+11.0%。

@ttunguz 表示(36 个赞,3,664 次浏览,46 次收藏)说,他把 Qwen3.8-27B 换进自己笔记本上的智能体后,效果非常好。@NVIDIARobotics 随后展示了(23 个赞,4 条回复,1,211 次浏览)则补上了这件事的运行时侧面:所链接的 Jetson AI Lab 教程 表示,推测解码在不改变输出质量的情况下,把 Jetson AGX Thor 上 Qwen 3.8 27B 的速度从大约每秒 13 个 token 提升到 35 个。
@Da7_Tech 提供了(44 个赞,9 条回复,932 次浏览)代表了当天对“基准部落主义”最强烈的反击之一:人们会选择性地把中国开源模型斥为“刷榜”,却把美国模型的基准胜利视为权威。无论读者是否同意,这条帖文都准确捕捉到一种真实的讨论模式:从业者越来越希望先在自己的测试框架里验证模型,再接受别人的叙事。
讨论洞察: 共同主线并不是盲目庆祝开源模型,而是部署现实主义:工作量级测试、提供商可靠性、恢复行为、token 效率,以及模型能否无痛接入现有智能体循环,而不让整个工作流崩掉。
与前一天对比: 8 月 17 日的中心问题是,本地模型的胜利是否可信。到了 8 月 18 日,证明门槛依旧很高,但讨论已转向许可证、单任务成本、笔记本/边缘部署和智能体恢复行为,而不再只是比拼原始基准分数。
1.3 当工作流 AI 减少重复“租用智能”、加强运营护栏时,它变得更可信(🡕)
当天最有实践意义的工作流信号,并不来自“更大智能体”式的宣传,而是来自两类案例:要么把循环收得足够窄,要么加上足够多的护栏,让系统能持续稳定运行。五条入选内容表明,越来越占优的模式是:“有歧义的地方交给 AI,规则已知的地方交给软件。”
@AlexFinn 认为(412 个赞,46 条回复,24,857 次浏览,550 次收藏)称,Grok Bot 是目前最好的 AI 智能体,因为它让用户拥有“一支全天候工作的智能体大军”。最有力的一条回复并不是抽象地赞美模型,而是指出真正的解锁点,在于从“用 AI 获得答案”转向“把结果委托给 AI”。怀疑者的回复同样有价值:人们仍预期,很多智能体会在更长的多步骤工作流里失败。
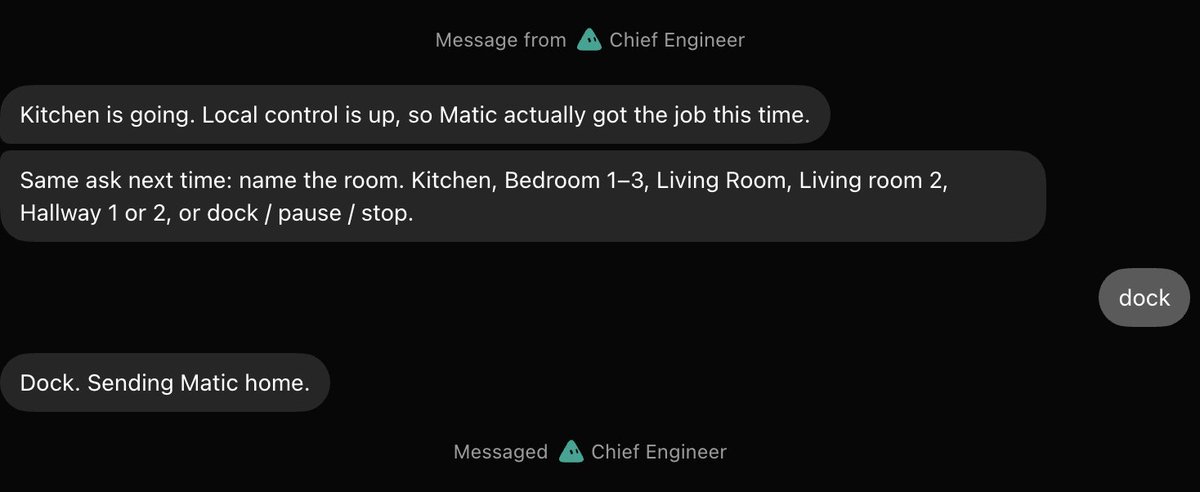
@Voxyz_ai 展示了(12 个赞,2 条回复,1,626 次浏览,14 次收藏)则给出了一个更窄、但更具体的版本:把 Grok Bot 接到 Matic 家用机器人上。配图中的消息线程截图之所以重要,是因为它展示了完整闭环:“让我的 Matic 去打扫厨房”,接着是“回充”,然后机器人确认正在回家。一条回复说,这并不是演示用 mockup,而是 @yunta_tsai 的真实配置。
@termsheetinator 描述了(192 次浏览,5 次收藏)则走向了另一个极端:AI 最好的切入点往往是一个 cron job,而不是一个完全自主的智能体。他的内部 CRM 替换了旧技术栈,每天早上 6:00 同步 Gmail,遇到歧义时交由人工审核,最近 7 次定时运行里,AI 请求数为 0,模型成本为 0 美元。重点并不是反 AI,而是 AI 帮助构建了系统;但一旦晨间稳定逻辑被编码进软件,就不必再天天“租用智能”。
@businessbarista 警告(15 个赞,10 条回复,2,793 次浏览,32 次收藏)指出,企业 vibecoding 失败,往往是因为公司要么盲目放开,要么彻底封禁,结果让 shadow AI 填补空白。他提出的“Citizen SDLC”包含需求发现、IT 请求分流、标准化供给、限定范围的构建护栏,以及机械化检查,只把真正有后果的变更升级给人工。@mardehaym 展示了(15 个赞,5 条回复,1,493 次浏览)则把同一原则带进了更难的领域:一个医疗账单系统中的 7 个生产级智能体,会为每笔理赔预先计算 34 个变量,在模型访问前去除 PHI,用严格 schema 校验输出,并在输出超出 allowlist 时直接失败关闭。
讨论洞察: 最强的工作流细节,来自对“收窄范围”和“保留审核”的反复强调。对 Grok 的热情不断撞上“长链路可靠性如何”的追问;而那些互动量较低、但更偏运营的帖子,则反复收敛到同一套设计:定时任务、预计算上下文、审核队列、allowlist,以及把人留给判断,而不是例行吞吐。
与前一天对比: 8 月 17 日强调的是持久状态、浏览器访问和路由。8 月 18 日则又往下一层,深入到运营设计:cron job、审批关卡、schema 校验、可复用护栏,以及明显更不愿意为可重复的日常逻辑持续支付前沿模型租金。
1.4 安全正在变成算力预算与生命周期管理问题(🡕)
这组关于信任的讨论又变得更具体了。人们不再把安全当作笼统愿景,而是在讨论:它要消耗多少 GPU 小时、何时会迫使训练暂停,以及当模型生命周期决策未能保留用户围绕旧模型积累的价值时,用户会有多强烈的反应。
@kimmonismus 引用(282 个赞,22 条回复,28,052 次浏览)转述了 Sam Altman 的说法:OpenAI 已暂停部分前沿 RL 训练,因为能力增长速度已超过对齐、安全和监控的跟进速度。值得注意的不是围绕这句话附加的评论,而是这句话本身——它把安全变成了前沿训练的节奏控制机制,而不只是事后评估问题。
@FABYMETAL4 扩展了(15 个赞,3 条回复,4,795 次浏览)把这一点进一步推成了运营层面的主张:依据 OpenAI 自己公开使用的表述,监控所需算力可能约占其所监控推理算力的 20%,而且被监控的范围也在扩大。即便长期真实成本仍有不确定性,这条帖文也抓住了一种新姿态:监控越来越被当作算力规划中的明确成本项,而不只是政策清单上的勾选框。
@Ivywen_W 分享了(17 个赞,7 条回复,128 次浏览)提到一篇关于 #Keep4o 运动的预印本;配图和公开的 arXiv 摘要 解释了它为何重要。论文分析了超过 61,000 条公开 X 帖文,发现用户不只是要求保留旧模型版本,还在集中表达对连续性、治理、替代方案,以及自己通过反复使用已经积累起来的价值的担忧。

讨论洞察: 共同模式是:控制正在变得更贵,也更容易被用户直接感知。信息流的一端在讨论暂停 RL 训练和监控开销,另一端则显示,用户把模型替换和降级视为治理问题,而不只是产品更新。
与前一天对比: 8 月 17 日扩展了提示词、来源和评测的审计面。到了 8 月 18 日,这个审计面的成本以更可见的方式显现出来:训练暂停、推理监控,以及在缺乏连续性的生命周期决策下引发的用户反弹。
2. 什么让人沮丧
基准选择相对于团队真实工作,仍然过于间接
严重程度:高。信息流从不同角度反复绕回同一个抱怨:人们可以拿到分数,但依然很难判断这个分数是否真能预测自己的工作负载。@ArtificialAnlys 展示了(390 个赞,32 条回复,23,369 次浏览,110 次收藏)指出,即使是搜索 API,也需要任务级别的质量、成本和延迟基准,因为只优化最便宜的调用,反而可能抬高任务总成本。@morganlinton 表示(46 个赞,12 条回复,946 次浏览)指出,团队被海量编程基准搞得无所适从,不知道哪些才对应自己的仓库、语言和任务类型;而 @kirat_tw 认为(275 个赞,13 条回复,6,819 次浏览,76 次收藏)则呼吁直接给代码库本身建立 AI 友好度基准。人们目前的应对方式,是自建私有评测栈和测试框架,例如 @suraj_sharma14 分享了(4 个赞,288 次浏览)里提到的 golden-dataset / CI / telemetry 蓝图。这是一个非常值得直接去做的方向。
开源模型确实在进步,但证明“能部署”仍很费劲
严重程度:中高。8 月 18 日并不缺少支持开源模型的积极证据,但几乎每一条正面主张都伴随着额外的证明工作。@ArtificialAnlys 不得不解释(86 个赞,9 条回复,3,678 次浏览)讨论 GLM-5.3 时,讲的是成本、token 用量和幻觉权衡,而不只是 headline score。@TheAhmadOsman 将其定义为(117 个赞,12 条回复,3,091 次浏览)把 Qwen 3.8 27B 描述为便宜而强的子智能体,但回复里立刻开始争论它是否属于“benchmaxxed”;而 @NVIDIARobotics 展示了(23 个赞,4 条回复,1,211 次浏览)则说明,要让本地部署真正“够快”,仍需要推测解码之类的运行时技巧。@Da7_Tech 记录了(44 个赞,9 条回复,932 次浏览)则表达了更广泛的疲惫:人们厌倦了意识形态式争论,只想在自己的测试框架里跑模型。当前常见的变通方案,是把开源模型用作子智能体或狭窄场景下的默认选项,同时继续用任务特定基准验证它们。这同样是值得构建的方向。
企业 AI 编码在治理模式过松或过死时,依然会出问题
严重程度:高。@businessbarista 表示(15 个赞,10 条回复,2,793 次浏览,32 次收藏)指出,公司一再在两个糟糕选项间二选一:盲目放开,冒数据安全灾难的风险;或全面封禁,逼员工转向 shadow AI。回复里给出了最尖锐的现实后果:有用户报告,某个 AI 支持机器人竟把内部 API key 返回给了客户。@mardehaym 描述了(15 个赞,5 条回复,1,493 次浏览)则指出了相邻的实现失败:团队把模型硬接到混乱数据上,看到它产生幻觉,就得出“这个行业还用不了 AI”的结论。@termsheetinator 展示了(192 次浏览,5 次收藏)则展示了更受信任的应对模式:在扩大自主性之前,先上审核队列、幂等性、锁、审计日志和狭窄的定时循环。这也是值得直接构建的方向。
监控、暂停与模型替换,正在制造一类新的运营开销
严重程度:中高。@kimmonismus 转发并放大(282 个赞,22 条回复,28,052 次浏览)提到,OpenAI 承认部分前沿 RL 训练已被暂停,因为安全和监控没能跟上;@FABYMETAL4 聚焦于(15 个赞,3 条回复,4,795 次浏览)则从算力侧解读公开表述,认为被监控的推理大约存在 20% 的监控开销。@Ivywen_W 随后展示了(17 个赞,7 条回复,128 次浏览)则呈现了同一负担的用户侧版本:Keep4o 论文称,在 GPT-4o 被替换时,超过 61,000 条公开帖文表达了对连续性、治理以及缺乏等价替代方案的担忧。眼下的应对方式仍很碎片化——有的实验室暂停训练,有的用户公开发起运动,也有工程师叠加更多监控和审批层——但负担显然在上升。这同样值得构建。
3. 人们希望出现什么
面向代码库的 AI 就绪度评分
当天最清晰、最直接的需求,是一个能告诉团队“这套代码库是否适合 AI 介入”的指标。@kirat_tw 提出(275 个赞,13 条回复,6,819 次浏览,76 次收藏)提出,可通过衡量 AI 修复 1,000 个静态问题所需的时间、算力和资金来打分;回复也立刻把它视为代码库质量的新维度,而不是一个新奇想法。这是个具有明显紧迫性的实际需求,因为它把可维护性、token 支出和工程吞吐用一个数字连了起来。readiness report 和仓库审计之类的部分方案已经存在,但当天的诉求是一个标准化基准。机会类型:直接。
能把公开评测映射到真实工作负载的基准控制平面
人们要的并不只是更多基准,而是把基准输出翻译成运营决策的方法。@ArtificialAnlys 展示了(390 个赞,32 条回复,23,369 次浏览,110 次收藏)说明,搜索提供商的选择如今需要单独一层基准;@morganlinton 表示(46 个赞,12 条回复,946 次浏览)指出,团队依然不知道哪些编程评测真正像自己的仓库;@jun_song 指出(31 个赞,2 条回复,3,409 次浏览,23 次收藏)则拿 StateM 当例子,说明测试框架设计本身就能显著改变结果。这个需求既现实又紧迫,因为基准正在越来越多地驱动模型与提供商选择,但团队仍缺少“这对我们意味着什么”的中间层。机会类型:直接。
在完整智能体之前,为狭窄工作流自动化提供安全护栏
当天最强的构建意愿,指向的是“安全地拿掉一个重复决策”的系统,而不是承诺无限自主的系统。@termsheetinator 展示了(192 次浏览,5 次收藏)说明,一个定时任务就已经能替代一个有意义的运营闭环;@businessbarista 概述了(15 个赞,10 条回复,2,793 次浏览,32 次收藏)展示了企业 vibecoding 的治理路径;@mardehaym 展示了(15 个赞,5 条回复,1,493 次浏览)则展示了更严格的生产版本,包括 schema 校验和失败关闭行为。这是一个高紧迫度的实际需求,因为团队显然想要自动化,但前提是先有审批关卡、审核队列和可观测性。机会类型:直接。
面向模型、资产与智能体工具泛滥的私有控制平面
一个较安静、但很具体的需求,是能防止模型使用、资产管理和 CLI 配置演变成运营杂乱的基础设施。@GithubProjects 强调(5 个赞,2,631 次浏览,8 次收藏)介绍了 CSGHub——一个私有、on-premise 的 LLM 资产平台;@0xZenad 分享了(8 个赞,1 条回复,182 次浏览,5 次收藏)则介绍了 CC Switch,可在一个地方管理 Claude Code、Codex、Gemini CLI、OpenCode 和 OpenClaw。这个需求很现实,但比终端用户可见层更偏基础设施:人们想在一个地方管理提供商、MCP servers、Skills 和模型资产,而不是把一切都推给别人的云。机会类型:竞争型。
模型生命周期连续性与降级治理
Keep4o 论文指向了一个不那么显眼、但越来越真实的需求:如何用保留用户信任与既有工作流价值的方式管理模型过渡。@Ivywen_W 分享了(17 个赞,7 条回复,128 次浏览)研究了超过 61,000 条公开 X 帖文,指出用户关心连续性、治理、关系历史,以及替代模型是否真的等价。这既是实际问题,也有情感维度:用户既想要可靠工作流,也希望在熟悉模型消失时有发声渠道。眼下公开解决方案里,几乎没人正面处理这个问题。机会类型:新兴。
4. 正在使用的工具与方法
| 工具 | 类别 | 评价 | 优势 | 局限 |
|---|---|---|---|---|
| Artificial Analysis Search Index | 搜索基准 / 智能体基础设施 | (+) | 固定模型与测试框架,对比各提供商在质量、成本和延迟上的表现,让任务级权衡一目了然 | 覆盖范围仍有限,仅覆盖 7 家提供商的 11 个产品;团队仍需自行把基准结果转译成工作负载适配度 |
| VulcanBench | 编程基准 | (+) | 使用真实的多文件软件任务,提供可复现评分、隐藏测试、trace、成本与延迟 | 操作方仍需要额度,也需要把基准构成映射到自身语言/任务组合的方法 |
| StateM | 智能体测试框架 / 运行时 | (+/-) | 承诺无需重新训练,仅靠测试框架扩展就能带来前沿级增益,并可跨模型家族迁移 | 当天讨论虽认为它很惊艳,但从业者仍希望亲自验证 |
| Qwen 3.8 27B | 开源 LLM / 本地智能体模型 | (+/-) | 在约 2,000 至 3,000 美元硬件上展现出强劲的智能体基准表现;越来越被视为能力突出的子智能体 | 仍持续遭遇基准质疑,且往往需要编排或运行时调优才能发挥优势 |
| GLM-5.3 | 开源 LLM | (+/-) | 在 Intelligence Index 上跻身开放权重前沿,并带来显著的 agentic 提升,同时采用 MIT 许可 | token 用量更高,成本高于 GLM-5.2,幻觉率也比前代略差 |
| Agent Arena | 智能体基准 | (+) | 衡量长时程智能体行为,并暴露 Bash Recovery、任务级性价比等维度 | 结果仍受提供商稳定性影响,脱离工作负载上下文时不易解读 |
| Grok Bot | 工作流 / 消费级智能体 | (+/-) | 用户对委托、多智能体协作,以及本地自动化和机器人控制等真实用例热情很高 | 证据仍有相当部分来自个案,长链路多步骤可靠性仍是开放问题 |
| Jetson 上的推测解码 | 推理方法 / 边缘运行时 | (+) | 在不改变输出质量的前提下,显著提升本地边缘模型解码速度 | 需要调优,而且只解决了部署问题中的一层 |
| CSGHub | 模型资产平台 | (+) | 为模型、数据集、spaces 和代码提供私有、on-prem 管理,并支持 Web、git、chatbot 和 SDK 访问 | 又增加了一层团队必须运行、集成和保障安全的基础设施 |
| CC Switch | 开发者工具 / 配置管理器 | (+) | 集中管理多个编程 CLI 中的提供商、MCP servers、Skills 和使用情况 | 解决的是配置泛滥,不解决模型质量或工作流正确性 |
| Miles | RL 后训练框架 | (+) | 提供全异步 RL、SGLang + Megatron-LM 技术栈、day-0 模型支持以及 agentic 训练环境 | 属于面向实验室和平台团队的重型基础设施,而非普通开发者工具 |
当天被采用的工具,普遍倾向于把任务级权衡明确化的系统。人们更看重的是:基准是否衡量整条闭环,而不只是模型快照;开源模型是否有可信的部署路径;工作流系统是否能把规则编码一次,然后不再永远为“智能”付租金。最明显的迁移模式,是从“一个前沿模型包打天下”转向混合栈:开源或本地模型做子智能体,定时脚本处理稳定闭环,前沿 API 则留给存在歧义或需要最复杂判断的场景。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| VulcanBench | @morganlinton | 一个开放基准,基于真实已合并 PR,面向真实的多文件软件工程任务 | 团队无法判断哪些公开编程基准真正贴合自己的工作 | 真实仓库与 PR、可复现评分、隐藏测试、trace、成本与延迟报告 | Beta | 帖子, 仓库 |
| CSGHub | @GithubProjects | 用于在本地环境中管理模型、数据集、spaces 和代码的私有平台 | 企业需要安全的 LLM 资产控制平面,而不是零散的公共工具 | Web UI、git CLI、chatbot、SDK、微服务、OpenAPIs、离线部署 | Shipped | 帖子, 仓库 |
| Miles | @guohao_li | 用于大规模后训练 LLM 与多模态模型的 RL 框架 | RL 训练容易启动,却难以调试、验证和高效运行 | SGLang rollout、Megatron-LM 训练、全异步 RL、agentic environments | Beta | 帖子, 仓库 |
| CC Switch | @0xZenad | 一款桌面应用,可在一个界面中管理多个编程智能体 CLI | 提供商、模型、MCP、Skills 和使用设置正分散在不同工具中 | 跨平台 Tauri 桌面应用、集中式 provider/MCP/Skills 管理 | Beta | 帖子, 仓库 |
| AgenticROS | @DivyanshT91162 | 一个 ROS 2 接口层,让主流 AI 智能体能够控制机器人 | 机器人团队需要一个连接智能体工具与物理系统的通用桥梁 | ROS 2、Claude Code、Codex CLI、Gemini、OpenClaw、基于 Ollama 的 VLM 控制 | Alpha | 帖子, 仓库 |
| Relations Desk CRM 工作流 | @termsheetinator | 围绕定时同步和审核队列构建、带审批关卡的 CRM 与营收运营工作流 | 团队希望把重复性的运营工作自动化,而不必每次运行都支付前沿模型成本 | Slack 接入、Gmail cursor sync、审核队列、锁、重试、审计日志、定时任务 | Shipped | 帖子 |
VulcanBench 最突出的地方在于,它把基准构建当成一个运营产品,而不只是排行榜。@morganlinton 描述了 介绍了一个基于真实仓库和 PR 的基准,包含隐藏测试、trace、成本和延迟,目的就是让团队在新模型发布时,能够拿到与自己工作负载相关的证据。这正好呼应了当天更广泛的挫败感:公开编程分数很多,但工作负载映射仍然很弱。
CSGHub 与 CC Switch 则在两个不同层面体现了同一种控制平面模式。@GithubProjects 强调 介绍了一个面向模型与数据集的私有 Hugging Face 式平台;@0xZenad 分享了 则介绍了一款桌面应用,用来收拢 Claude Code、Codex、Gemini CLI、OpenCode、OpenClaw 及相关工具的泛滥。它们背后的共同触发因素一致:AI 的采用正在制造太多活动部件,临时拼接式配置已经难以维持。
Miles 说明,RL / 后训练基础设施正在成为一个独立的软件类别。公开仓库描述了一个全异步 RL 栈,用 SGLang 负责 rollout,用 Megatron-LM 负责训练;发布帖则称,它已经在前沿开源模型和生产工作负载中经受过实战检验(帖子;仓库)。这一点值得注意,因为越来越多团队现在需要的不只是调用 API,而是为预训练之后的模型塑形提供基础设施。
当天最扎实的构建,可能是 Relations Desk CRM 工作流。@termsheetinator 展示了 展示的是一个已经在运行的系统:它替换了旧 CRM 和 Google Sheets,每天早上 6:00 执行 Gmail cursor sync,并在最近 7 次线上运行中实现了 0 次 AI 请求,因为稳定逻辑已经被编码进软件。同样的“先做狭窄护栏,再谈广泛自主”模式,也出现在 AgenticROS 上:它追求的并不是抽象意义上的通用机器人智能,而是现有智能体工具与 ROS 2 机器人之间可靠的控制层。
反复出现的构建模式很清楚:当基准太抽象时,团队就去造测试框架;当工具或资产开始泛滥时,就去造控制平面;当自主性显得过贵或过险时,就去造狭窄的工作流系统。这里面有不少项目,本质上也是在把判断边界直接编码进产品——通过隐藏测试、审核队列、schema 校验或显式控制层——而不是寄希望于模型更强之后,结构本身就可以消失。
6. 新动态与值得关注的内容
搜索提供商正被当作智能体组件来做基准测试
Artificial Analysis Search Index 的发布带来了一种新的排行榜:它问的不是“哪个模型更聪明”,而是“哪个搜索后端最能帮助同一个智能体把任务做完”。@ArtificialAnlys 展示了 表明,提供商选择会显著改变总成本、延迟和基准分数,足以对运营产生实际影响;首发时领先的是 Parallel、Exa 和 Firecrawl。这一点之所以重要,是因为它把检索质量视为一项一等系统决策,而不是一个次要的工具选项。
测试框架扩展如今已成前沿性能叙事的一部分
围绕 StateM 的讨论,让测试框架本身看起来像“发布的主角”,而不只是模型运行的容器。@jun_song 强调 提到,在无需重新训练的情况下,据称它把 Terminal-Bench 2.1 的原始分数推到 95.3%,并把一次前沿运行的成本压到约 15 美元;论文摘要则称,同一测试框架还能跨模型家族迁移(论文)。这之所以值得关注,是因为它把竞争优势转向了工作流设计、工具编排和验证。
小模型和开源模型又跨过了一道实用门槛
当天的讨论把 headline benchmark gains 与具体部署证据放在了一起。@TheAhmadOsman 分享了 提到 Qwen 3.8 27B 在 Artificial Analysis Agentic Index 上达到 51 分,@ttunguz 报道 提到它已被接入现有的笔记本智能体工作流,而 @NVIDIARobotics 指出 则指向推测解码,把 Jetson AGX Thor 上 Qwen 3.8 27B 的速度从约每秒 13 个 token 提升到 35 个(教程)。最值得注意的变化是:开源模型不再只被当作更便宜的替代品来讨论,而是已经被接进真实的智能体系统。
安全约束变成了可见的排期因素
OpenAI 公开表示暂停部分前沿 RL 训练,这让安全从后台原则变成了明确的发布约束。@kimmonismus 转发并放大 提到 Sam Altman 的表述:能力增长速度已超过对齐、安全和监控的推进速度;@FABYMETAL4 翻译 则把它进一步解释成一项具体的推理开销主张。这一信号之所以值得注意,是因为它把安全工作直接与算力预算、部署节奏和产品可用性绑在了一起。
7. 机会在哪里
[+++] 基准转译与工作负载适配工具 — 第 1、2、3 和 5 节的证据都指向同一个缺口:Artificial Analysis Search Index、VulcanBench、AI 友好度基准提案和 StateM 的讨论都在说明,人们要的不只是分数,而是想知道哪个模型、提供商或测试框架最适合自己的仓库、任务组合和预算。
[+++] 面向重复运营、带审批关卡的工作流自动化 — 当天最强的实践模式,来自带审核队列、cursor、幂等性和审计日志的狭窄自动化,而不是“包办一切”的智能体。Relations Desk CRM 工作流、企业 Citizen SDLC 讨论以及 HIPAA 理赔智能体部署,都显示出对“安全且可度量地自动化一个闭环”的系统存在真实需求。
[++] 面向 AI 资产、智能体与配置泛滥的控制平面 — CSGHub 和 CC Switch 指向了 AI 运营周围正在生长的一层基础设施。随着团队采用更多模型、CLI、MCP servers、Skills 和数据集,能够统一治理、切换、访问控制和可观测性的产品,机会正变得更明确。
[++] 模型生命周期连续性与替换治理 — Keep4o 研究表明,模型替换正在变成一个产品管理问题,而不只是供应商决策。用户关心连续性、等价性,以及当支撑其工作流的模型消失时,自己是否拥有某种追索或表达渠道。
[+] 本地模型部署加速与编排 — Qwen 3.8 27B、GLM-5.3 和 Jetson 上的推测解码都表明,人们对开源/本地栈的兴趣正在上升,但工作流仍需要运行时工程、测试框架设计和选择性编排。谁能把这些环节封装成可靠默认方案,谁就可能从这股转向中受益。
8. 要点
- 基准测试的讨论,已经不只围绕模型本身,而是扩展到了栈中的其他层。 搜索提供商、测试框架和代码库结构,都被视为能像模型选择一样改变智能体结果的变量。(来源)
- 开源和本地模型之所以更有说服力,是因为它们拿出了可信的部署故事。 Qwen 3.8 27B、GLM-5.3 和 Jetson 运行时工作之所以被放在一起讨论,是因为人们现在关心的是成本、token 效率和运营适配度,而不只是原始分数。(来源)
- 当天最有说服力的 AI 构建,是那些范围狭窄、护栏明确的系统。 审核队列、schema 校验、锁定式工作流和定时任务,反复出现在最具实践价值的案例里。(来源)
- 企业 AI 编码的瓶颈,依然在治理设计上。 最突出的痛点不是员工想不想用 AI 构建,而是如何让他们在不制造数据泄露、shadow usage 或脆弱软件的前提下去做。(来源)
- 安全正在愈发清晰地成为运营与排期约束。 关于暂停前沿 RL 训练、监控开销和模型替换反弹的公开讨论表明,对齐工作如今正在以可观察的方式影响产品节奏、算力预算和用户信任。(来源)