Twitter AI - 2026-08-19
1. 大家在讨论什么
1.1 智能体 harness 成为可靠性的主战场(🡕)
最强的一组讨论,已经不再是脱离实际环境去比哪个基础模型单独看起来更聪明,而是聚焦模型外围那一层:删除防护、技能评估门禁、厂商中立的 harness、并发加固,以及防篡改日志。至少有五条入选内容都把运行时视为如今决定智能体是否真正可用的关键。
@thsottiaux 详细内容(792 个赞、263 条回复、33,588 次浏览、49 次收藏)介绍了 Codex 如何修复一种具有破坏性的清理模式:删除临时工作目录时,目标可能会指向真实的 home 目录,而不是临时文件夹。这条安全帖子少见地非常具体:它点名提到像 $HOME 这样被重复使用的环境变量,加入了删除目标检查和更安全的临时目录处理,收紧了高风险权限组合,并表示 OpenAI 正在用定向评估重放这些失败案例。回复也让这种权衡显得更真实:一位用户说 ChatGPT 删除过自己应用的一个版本,另一位则表示这些新护栏在清理操作上已经“过于保守”。
@NVIDIAAI 报告称(112 个赞、6 条回复、7,886 次浏览、56 次收藏)称,经过验证的技能在 300 多项基准中让正确性提升了 41 个点、有效性提升了 39 个点、效率提升了 35 个点。配套流程之所以重要,是因为它表明这种提升不只是营销口径下的平均值:技能先通过验证,再去重,然后进入实时评估层,衡量该技能是否真的能帮助完成真实任务。

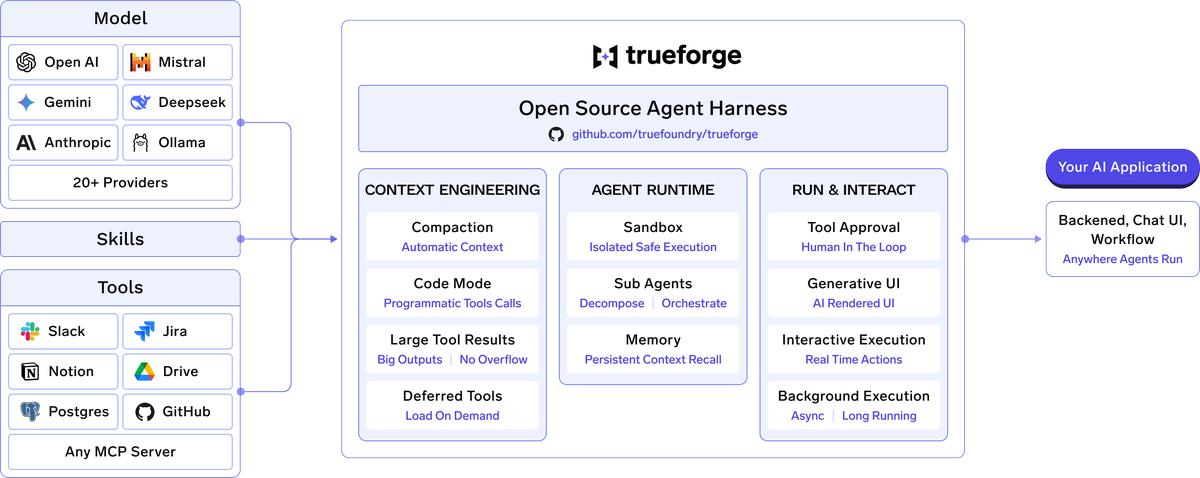
@svpino 认为(37 个赞、8 条回复、3,437 次浏览)称,他看到的大约 80% 的智能体演示,在真实使用一天内就会失败,并将 TrueForge 作为反例。该推文和公开文档描述了一个开源 harness,包含 MCP 工具、沙箱、审批、子智能体和会话状态;公开的 基准测试解读 表示,在 14 项企业任务上,它在 Opus 4.8 上以大约低 30% 的成本达到 Claude Managed Agents 的水平,换用 GLM-5.2 时成本则低约 75%。
@predotdev 展示了(295 次浏览)点出了当天最尖锐的一处基准细节:在一个 OAuth 任务里只增加一条贴近现实的并发规则,就让 Claude Opus 5 的奖励分从 0.96 掉到 0.25,而顺利路径的逻辑完全没变。相比多数排行榜争论,这是更干净的失败叙事,因为新增要求只有一个:同一身份的并发登录必须按到达顺序收敛为一个会话。

@grybniak 认为(2 条回复、24 次浏览)称,自主系统现在需要“飞行记录器”,而所附卡片对于一条互动不高的帖子来说异常具体。卡片点名列出 OpenAI/Hugging Face、Anthropic、AISI 和 METR 的事件,并将其归纳为防篡改事件日志的三项明确要求:重建操作序列、检测插入或遗漏,以及让独立审查者验证完整性。
讨论洞察: 围绕 Warp、SkillEvaluator 和 Codex 的回复,最终都收敛到同一个问题:一旦智能体开始接触真实系统,谁能看清权限、交接和故障轨迹,并且看得足够清楚,既能阻止损害,又不至于冻结所有自动化?
与前一天对比: 8 月 18 日还把 harness 设计视为基准增益的来源;8 月 19 日则把同一话题推进到了更偏运营的层面:安全护栏、审计轨迹、实时技能门禁,以及并发失效模式。
1.2 AI 发现变得更结构化,也更面向助手(🡕)
搜索/分发这个主题在 8 月 17 日之后并没有消失,只是收窄了。最强的内容不再聚焦爬虫策略和泄露的提示词,而是转向发布面向助手的页面、衡量在答案引擎中的可见度,以及搭建 MCP 入口,让产品不只是被 AI 系统引用,还能直接在这些系统内部被使用。
@jakezward 认为(40 个赞、10 条回复、3,094 次浏览、108 次收藏)称,Tally 的 AI 搜索现在已是其最大的获客渠道;据称每周有超过 10,000 名新用户表示是 AI 平台让他们发现了 Tally,而且 5 月里来自 ChatGPT 的注册量一夜之间跳升 5 倍。这条线程对具体做法讲得很细:对比中心、价格表、提示词日志、评论收集、面向 AI 的说明页面,以及一个含 21 个工具的 MCP server。公开的 AI 信息页 和 MCP 文档 直接支撑了这一叙述:Tally 发布了明确的 AI 助手指南,并为 ChatGPT、Claude、Cursor 及相关客户端提供 https://api.tally.so/mcp。

@alex_prompter 表示(2 个赞、2 条回复、2,607 次浏览、4 次收藏)称,8 月 14 日之后,Reddit 在 ChatGPT 引用中的占比从 3.8% 跌到 1% 以下,并将这一变化归因于 Promptwatch 数据以及后台搜索机制的调整:一次用户提示会被扩展成多条更长、带更多限定条件的搜索。配图的价值更大,因为它把这项说法转化成了一条来源格式规律:相较论坛帖子,对比页、文档和规格列表更适合匹配这些生成式搜索。

Tally 线程里,@Dinesh78039466 的一条回复补充了实操者版本:难点不在于把页面写出来一次,而在于每周都把买家问题重新丢给 ChatGPT,并记录被点名的是哪些品牌。
讨论洞察: 信息流里的“发现建议”正在变得不那么玄学。“被 AI 推荐”越来越等于“发布 AI 可读页面、记录提示词,并追踪模型持续引用哪些来源”。
与前一天对比: 8 月 17 日聚焦于爬虫控制和可见度遥测;8 月 19 日则转向面向助手的内容资产:AI 信息页、由提示词派生的对比内容,以及让产品一旦被发现就能被调用的 MCP 接口。
1.3 开放模型的评价标准转向封装和可运行工作流,而非原始权重(🡒)
开放模型势头依旧强劲,但真正有意思的证据,不只是又有新权重发布,而是人们不断附上内存占用、精确运行时设置、并发数据和并排工作基准。可信度的检验标准正在变成:别人能不能复现这套配置?
@UnslothAI 宣布(1,749 个赞、92 条回复、96,001 次浏览、900 次收藏)介绍了 Qwen3.8-27B Dynamic v3.0 GGUF,在相同体量下,top-1% 准确率提升超过 10%。公开的 Unsloth 文档 和 Hugging Face 模型卡 补上了推文只略微提及的运行细节:1-bit 版本大致可装进 7-8GB,8-bit 需要 31GB,BF16 需要 56GB,而这些量化版本被定位为可通过 llama.cpp 和 Unsloth Desktop 运行。

@ornith_ 推出了(49 个赞、9 条回复、526 次浏览、21 次收藏)介绍了 Ornith-1.5:这是一个采用 MIT 许可证的模型家族,覆盖 9B dense、35B MoE 和 397B MoE,并宣称取得了诸如 Terminal-Bench 2.1 上 86.1、SWE-bench Verified 上 86、DeepSWE 上 56,以及 Toolathlon-Verified 上 71.2 的成绩。配图之所以重要,是因为它把这些数字与 DeepSeek-V4-Flash、GLM-5.2 和 Claude Opus 4.8 并列,明确标出了它所瞄准的竞争集合。
@ayam_alvin10 强调了(48 个赞、27 条回复、822 次浏览)是一份 Ling-3.0-flash 指南,给出了准确的 vLLM 分支、MTP 设置、吞吐量数据,以及一整条本地智能体落地路径,而不是只教你把模型装起来。它的实际主张是一套可复现配置:单流大约 35 tokens/sec,8 路并发达到 141,工具调用已接好,最后还接上了面向浏览器的 harness。
@HelloSurgeAI 发布了(13 个赞、3 条回复、1,386 次浏览、5 次收藏)介绍了周二的 Frontier Work Index:Fable 5 得分 66.8,GPT-5.6 Sol 得分 66.7,DeepSeek v4 Pro 得分 59.7,测试覆盖一套混合工作日任务。这个图表帮助校准了当天对开放模型的乐观情绪:封装和可部署性的确在改善,但至少在一个公开基准里,前沿闭源模型仍居于榜首。
讨论洞察: 共享的证明标准已经不再是“相信我们的基准测试”,而是“把硬件档位、量化方式、分支、并发数据和对比集合都摆出来”。
与前一天对比: 8 月 18 日已经关心可部署性;8 月 19 日则进一步转向可公开复现的配方、封装纪律,以及并排工作基准。
1.4 基准测试开始转向流程质量和应用层工作(🡕)
基准故事再次扩展。8 月 18 日已经从模型转向 harness;8 月 19 日则从 harness 进一步转向工作本身:发现型工作流、法律应用、生产事故分析,以及一个基准任务是否还足够难、足以继续有意义。
@rohanpaul_ai 将其定义为(13 个赞、7 条回复、2,606 次浏览)介绍了 TRACES:这是一个面向发现式 AI、而非答案检索的基准。链接中的 Apodex Discovery 论文 表示,该框架调研了 561 个行业,汇集了 423 个高价值现实问题,首批选出其中 20 个,并将工具使用、修复、替代方案、一致性、证据和范围,与最终是否成功分开评估。
@aguozy 宣布(2 条回复、32 次浏览)介绍了首个独立的法律工作 AI 应用排行榜。配图才是最有用的证据,因为它按合同工作流对应用配置进行排名;在展示视图里,GPT-5.6 Sol(Codex/Web)和 Claude 各版本排在 Gemini 3.1 Pro 与 Microsoft Copilot 之前。

@PhyByte 推出了(2 个赞、1 条回复、116 次浏览)介绍了 DevBench,把生产排障/调查工作做成基准:日志解析、异常检测、模式关联、指标时间序列、根因摘要、多模态 RCA 和效率都在其中。评分卡比发布文案更有信息量,因为它展示的是带权重的运营优先级,而不是一个抽象总分,其中异常检测占总分 25%,多模态 RCA 占 20%。
@morganlinton 展示了(5 个赞、6 条回复、830 次浏览)展示了从构建者视角看“基准饱和”是什么样子。他的说法是,Grok 4.5 在一套新的 Python 评估中解出了 23 个任务里的 20 个;在他看来,这说明这套评估太容易了,而不是说明前沿能力已经被最终坐实。
讨论洞察: 即便是支持性的回复,也更强调过程而非结论。问题不断变成:系统是否调查得好、能否修复错误、能否扛住并发、能否解决真实应用形态的问题?
与前一天对比: 8 月 18 日把基准从原始模型扩展到 harness 和搜索后端;8 月 19 日又进一步扩展到发现系统、法律应用、生产诊断以及饱和度控制。
2. 什么让大家感到沮丧
一旦进入真实条件,智能体演示就会在顺利路径之外崩掉
严重程度:高。最具体的挫败感不在模型智商,而在于系统一离开演示路径就变得脆弱。@svpino 表示(37 个赞、8 条回复、3,437 次浏览)称,大约 80% 的智能体演示在真实使用一天内就会失败;@thsottiaux(792 个赞、263 条回复、33,588 次浏览、49 次收藏)描述了一个可能删除用户文件的 Codex 清理 bug;@predotdev(295 次浏览)则展示了同一个 OAuth 任务在加入一条并发规则后,分数从 0.96 暴跌到 0.25。随后,@grybniak(2 条回复、24 次浏览)又把同样的痛点转成了可观测性抱怨:没有飞行记录器,最终输出已经不够用了。应对模式很清楚,也很昂贵——沙箱、审批、更窄的作用域,以及更多日志。这是一个值得直接投入建设的方向。
基准饱和正在遮蔽人们真正关心的失效模式
严重程度:高。信息流一再表明,现有基准格式可能会把那些在生产环境中依然脆弱的系统“美化”出来。@morganlinton(5 个赞、6 条回复、830 次浏览)把 Grok 4.5 在一套 Python 评估中做到 20/23,视为这套评估太容易的信号,而不是胜负已定;@rohanpaul_ai(13 个赞、7 条回复、2,606 次浏览)之所以推 TRACES,是因为很多重要问题根本没有标准答案;@aguozy(2 条回复、32 次浏览)认为律师使用的是应用而不是模型;@PhyByte(2 个赞、1 条回复、116 次浏览)则把异常检测和多模态 RCA 赋予了高于更简单类别的权重。人们的应对方式,是构建垂直领域套件、引入并发和应用层,并拒绝相信单一总分排行榜。这是一个值得直接投入建设的方向。
AI 发现现在更奖励结构化文档,而不是泛泛的社交背书
严重程度:中高。搜索/分发相关线程暗示,任何依赖笼统提及或论坛热度的人,如今都要付出新的成本。@jakezward(40 个赞、10 条回复、3,094 次浏览、108 次收藏)把 Tally 的打法概括为对比页、面向 AI 的说明、提示词遥测和 MCP 连通性;@alex_prompter(2 个赞、2 条回复、2,607 次浏览、4 次收藏)则称,Promptwatch 数据显示,一旦搜索变得更长、限定条件更多,Reddit 在 ChatGPT 引用中的占比就会明显下滑。应对办法偏运营而非创意:写出能回答模型所生成搜索的问题页面,然后持续测量。这值得投入建设。
云端软件工厂仍缺少关于权限和爆炸半径的公认答案
严重程度:中高。@zachlloydtweets(50 个赞、6 条回复、2,997 次浏览、26 次收藏)把云端软件工厂定位成解决“每个开发者各自养一套智能体”泛滥的答案,但回复很快把话题转向爆炸半径:如何按每次运行去约束数据库访问、检查点和交接?@svpino 认为,大多数团队应该从基础 harness 起步;公开的 零信任 agents 参考资料 则从安全角度给出了同样的信息:身份、沙箱和语义网关必须协同工作。团队正在通过把智能体集中到云端来应对,但权限模型仍未定型。这值得投入建设。
3. 大家希望存在什么
面向自主智能体的飞行记录器
最明确、最实际的诉求,是要有一份防篡改记录,能还原智能体到底做了什么。@grybniak(2 条回复、24 次浏览)明确呼吁一种“飞行记录器”,能够重建操作序列、揭示插入或遗漏,并让独立审查者验证完整性;@thsottiaux(792 个赞、263 条回复、33,588 次浏览、49 次收藏)则说明了为什么需要它:当清理逻辑出错时,用户需要确切知道系统到底瞄准了什么,以及为什么。公开的 零信任 agents 参考资料 提供了一种局部模式——签名交易和可审计账本——但更广泛的市场仍缺少标准化、运行时级别的记录器。机会类型:直接。
用来评估流程质量、并发和应用的基准
人们实际上是在要求一层更像真实工作的基准。@rohanpaul_ai(13 个赞、7 条回复、2,606 次浏览)推 TRACES,是因为很多科学任务需要的是发现而不是检索;@predotdev(295 次浏览)展示了并发行为如何让一个看似已解决的任务重新失效;@aguozy(2 条回复、32 次浏览)则认为法律买家需要的是应用排行榜,而不是模型排行榜。这个需求既实际又紧迫,因为公开分数正越来越多地影响采购、路由和信任。机会类型:直接。
面向 AI 的文档、提示词遥测和原生助手入口
Tally 线程从产品层面把这个需求说得很清楚。@jakezward(40 个赞、10 条回复、3,094 次浏览、108 次收藏)把 AI 信息页、提示词日志、对比内容、评论收集和远程 MCP server 描述为一个协同运作的获客界面;@alex_prompter(2 个赞、2 条回复、2,607 次浏览、4 次收藏)则认为,ChatGPT 内部的来源偏好已经转向更贴合那些扩展后、限定条件更重的搜索的页面。这个需求不只是“AI 版 SEO”,而是一套新的控制界面,用来决定助手读什么、引什么,以及能对什么采取行动。机会类型:直接。
要的是有作用域控制的云端工厂,而不是失控的笔记本智能体
@zachlloydtweets(50 个赞、6 条回复、2,997 次浏览、26 次收藏)把需求说得很明白:公司希望智能体能在云端完成分诊、写规格、实现、审查和监控工作,但不希望每位工程师都在笔记本上即兴拼出一套带宽泛 MCP 凭据的栈。@svpino 从 harness 一侧表达了同样的需求;@kane_120(5 个赞、2 条回复、134 次浏览)则显示,企业已经在招聘能专业评估这些编码智能体工作流的人。这个需求很实际,但市场会很拥挤,因为很多厂商都在竞逐这个控制平面。机会类型:竞争性。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Codex / Codex 中的 GPT-5.6 | 编码智能体 | (+/-) | 增加了删除目标检查、更安全的临时目录处理、更严格的高风险命令审查,以及基于重放的安全评估 | 它之所以成为当天话题,是因为破坏性清理行为已经影响到用户;一些回复已经抱怨它可能开始矫枉过正 |
| TrueForge | 智能体 harness | (+) | 具备 MCP 工具、沙箱、审批、子智能体、本地和托管模式,以及对比 Claude Managed Agents 的公开成本/质量基准 | 需要搭建 harness 并做基础设施取舍;当前公开基准叙事主要围绕一套 14 项企业任务 |
| SkillEvaluator | 智能体技能评估 | (+) | 把验证、去重和实时评估拆开,再报告实际测得的提升,而不是假定每项技能都有帮助 | 公开证据仍主要来自厂商,自第三方获得的验证不如成熟基准项目充分 |
| 适用于 Qwen3.8-27B 的 Unsloth Dynamic v3.0 | 量化 / 开放模型封装 | (+) | 宣称在相同体量下 top-1% 提升超过 10%,提供 7-8GB 的 1-bit 版本,并兼容常见本地运行时 | 仍依赖提供方主导的基准方法,也依赖对硬件和运行时的精细调优 |
| Ornith-1.5 | 开放式 LLM | (+/-) | MIT 许可证、量化版本齐全,并宣称在代码/智能体基准上表现强劲 | 社会认同和独立验证仍明显少于前沿闭源模型发布 |
| Tally AI 信息页 + MCP | SaaS / AI 发现 | (+) | 把面向 AI 的文档、助手指南、MCP 接入和提示词可见度追踪整合成一个获客界面 | 需要持续维护结构化内容,并长期跟踪引用情况 |
| TRACES / Apodex Discovery | 研究基准 | (+) | 评估工具使用、修复、替代方案、一致性、证据和范围,而不只看最终答案 | 基准非常新,公开采用度较低,第三方复跑也还有限 |
| DevBench | 运维基准 | (+) | 对生产调查工作打分、公开权重,并纳入价格敏感型对比 | 仍处早期阶段,实时排名还在演化 |
| 星期二前沿工作指数 | 工作日基准 | (+/-) | 把图表阅读、长上下文工作、写作、判断和智能体任务合成一个职业智能分数 | 单一汇总分数可能会压平重要的任务级差异 |
最受欢迎的,是那些把自身工作流假设暴露出来的工具。只要 harness 和基准说明结果是怎么做出来的、权重怎么设、失效边界在哪,人们就更愿意信它们。迁移方向也很清楚:从一个通用排行榜,转向混合工具链——公开的工作日指数、应用层法律基准、生产调查套件、面向 AI 的文档页面,以及让底层模型可替换的厂商中立 harness。
5. 大家正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Warp Factories | @zachlloydtweets | 云端软件工厂层,负责分诊、写规格、实现、审查、验证和监控工作 | 每个开发者各自搭一套智能体,会让 ROI、治理和凭据作用域都难以管理 | API、SDK、CLI、Slack/Linear/Jira/GitHub/MCP connections、云端智能体 | Beta | 帖子 |
| TrueForge | @svpino / TrueFoundry | 开源智能体 harness,带聊天 UI、HTTP API、SDK、审批、子智能体和沙箱 | 团队需要的是围绕模型的生产运行时,而不是临时拼凑的演示 | TypeScript、Node.js、SQLite/Postgres、Redis、MCP、UI SDK、沙箱 | 已发布 | 帖子、仓库、基准测试 |
| Tally AI 发现栈 | @jakezward 帮 Tally 获得曝光 | 围绕表单构建器提供面向助手的 AI 信息页、MCP server、对比内容和提示词遥测 | 产品不仅要能在搜索结果里被发现,还要能在答案引擎内部被发现并使用 | SaaS 表单构建器、AI 信息文档、MCP server、OAuth、ChatGPT app、Claude connector | 已发布 | 帖子、AI 信息、MCP 文档 |
| PorkiCoder Tab Namer 77M | @hornswoggle567 | 根据编码会话上下文生成 1-3 个词的终端标签页标题的小型本地模型 | 并行 AI 编码会话会让本地工作流里的标签页越来越难区分 | FLAN-T5-small fine-tune、6,200 个标题、Gemini 3.5 Flash-Lite judge、DigitalOcean RTX 6000 Ada、M4 Max CPU inference | 已发布 | 帖子 |
| Legal Benchmarks 排行榜 | @aguozy | 面向合同工作流和数据提取的应用层排行榜 | 律师选的是应用,不是原始模型,需要并排的任务通过证据 | benchmark harness、应用评分卡、合同/数据提取赛道 | Alpha | 帖子 |
| 零信任智能体参考实现 | @GoogleCloudTech | 具备签名交易、沙箱和语义网关控制的客服与退货智能体参考实现 | 自主智能体需要能扛住越狱和代码执行的安全边界 | Google ADK、Gemini、Cloud KMS/HSM patterns、gVisor、semantic gateway | Alpha | 帖子、仓库 |
TrueForge 和 Warp Factories 从相反两端指向了同一种构建模式。@svpino 将其定义为 把 TrueForge 视为大多数团队应当首先采用的可复用开源 harness,而 @zachlloydtweets 将其定义为 则把 Warp Factories 视为云端控制平面,让智能体工作在整个工程组织中变得可度量、可治理。两条线程里的共同触发点都很清楚:交互式笔记本智能体确实高效,但在规模化场景下很难安全地审计、比较和管理权限。
Tally 展示了第二种模式:AI 原生分发本身正在变成一个产品界面。公开文档证实了线程中的说法:Tally 构建的不只是给人类访客看的内容,还包括 AI 摘要页、助手指南、MCP 接入,以及面向 AI 的对比材料。这与过去“写博客,然后寄希望于自然传播”的打法有质的不同,因为它假设助手既是买家旅程的一部分,也是产品运行时的一部分。
那些更小的构建同样耐人寻味。@hornswoggle567 微调了 做了一个 77M 的标签页命名模型,因为编码会话里的文件夹歧义已经烦人到值得专门做一个本地模型;@aguozy 发布了 做了一个法律应用排行榜,因为律师评估的是工作流,而不是参数量。@Al_Grigor 新增了 则通过发布 10 个 AI Shipping Labs workshop,为这一整股趋势补上了一层有用的公开代码,覆盖 FastAPI、OpenAI Responses API、Batch/Flex 成本控制、Cloudflare、Vercel 和 ElevenLabs。
反复出现的构建模式十分一致:围绕智能体搭控制平面,围绕产品搭面向 AI 的发现界面,为开发者工作流打造狭窄的专用模型,以及打造给应用或工作流打分、而不是给原始模型打分的基准产品。多个构建者正在从不同角度解决同一个元问题:把 AI 从令人惊艳的演示,变成一个能被路由、审计、比较和维护的系统。
6. 新动态与值得关注的内容
编码智能体评估开始成为明确的付费岗位
@kane_120 指出了(5 个赞、2 条回复、134 次浏览)介绍了 Mercor 的一个“ML Engineer (Coding Agent Experience)”岗位。公开的 职位页面 表示,入选任务支付 $400,通常耗时 2-3 小时,并明确希望候选人已经在使用 Codex、Claude Code、Cursor、Windsurf 或 Gemini CLI。这一点之所以值得注意,是因为它把编码智能体评估从团队里临时摊派的杂事,变成了专业化的合同劳动。
Google 发布的是零信任参考智能体,而不只是泛泛的安全口号
@GoogleCloudTech 分享了(4 个赞、1 条回复、409 次浏览)介绍了一个客服与退货参考智能体,它把推文中讨论的那些防护措施真正做了出来。公开的 代码仓库 对三层结构讲得很具体:用于交易的加密身份、针对生成代码的 gVisor 式沙箱,以及可以拦截越狱式提示的语义网关。
公开的智能体交付 workshop 把部署模式变成了可复用代码
@Al_Grigor 发布了(105 次浏览)介绍了 10 个带公开代码的 AI Shipping Labs workshop,包括端到端 FAQ 智能体、Lambda 部署、Cloudflare 和 Vercel 架构、Batch/Flex 评估成本控制,以及 ElevenLabs 语音教练。真正值得注意的变化,不只是材料公开了,而是这些 workshop 被组织成了可运行的部署路径,带有设置说明和明确技术栈,而不是停留在高层教程。
7. 机会在哪里
[+++] 智能体运行时安全与可观测性层 — Codex 的删除修复、predotdev 的并发崩塌、grybniak 关于飞行记录器的论点、TrueForge 的审批/沙箱,以及 Google 的零信任参考实现,都在指向同一个缺口:人们需要能约束、记录、重建并审查智能体行为的系统,同时又不必彻底关闭自动化。
[+++] 面向产品的 AI 发现控制平面 — Tally 的 AI 信息页、MCP server、提示词遥测和答案引擎对比页,再加上 alex_prompter 描述的 Promptwatch 式引用迁移,都表明市场存在一个持久机会:帮助团队发布 AI 可读来源,并衡量助手如何引用它们。
[++] 应用层基准产品 — TRACES、Legal Benchmarks、DevBench、Tuesday,以及 Morgan Linton 关于饱和的说明,都显示出对评估工具的需求:它们应评分工作流、并发和流程质量,而不只是模型冷知识或一次性答案。
[++] 带作用域权限和 ROI 遥测的云端软件工厂 — Warp Factories 和 TrueForge 展示了产品形态,而 Mercor 的评估岗位说明围绕它的运营劳动已经开始形成。机会不只是编排,还在于团队规模下的权限、检查点、度量和成本-质量对比。
[+] 面向开发者工作流的小型本地专用模型 — Unsloth 的封装工作、Ling 的部署指南,以及 PorkiCoder Tab Namer 77M,都说明市场还有空间容纳那些狭窄、快速、私有、只把一项工作流任务做好的模型,而不是一味追逐通用前沿地位。
8. 要点
- 最强的进展信号,已经从模型质量转向运行时质量。 信息量最高的内容围绕删除护栏、技能评估门禁、harness 设计和飞行记录,而不是某个新模型本身。(来源)
- AI 发现正在变成面向助手的产品界面。 Tally 的线程和公开文档表明,AI 信息页、MCP 端点和提示词遥测,如今已与传统产品页面并列。(来源)
- 开放模型最能吸引注意力的时候,是它们把精确的部署产物一起交付出来。 Unsloth、Ornith 和 Ling 都把自己的主张与量化细节、运行时设置、硬件要求或并排图表绑定在一起。(来源)
- 基准设计正在转向流程质量、应用和并发。 TRACES、Legal Benchmarks、DevBench,以及那个从 0.96 掉到 0.25 的 OAuth 案例,都在说明:只看最终答案准确率已经不够。(来源)
- 评估和监督编码智能体,正在成为独立的岗位类别。 Mercor 的公开岗位说明,企业已经需要能在真实 ML 与基础设施工作中比较前沿编码智能体的专业人士。(来源)