Twitter AI - 2026-08-20
1. 人们在讨论什么
1.1 开放本地模型不再像“下载即用”,而更像部署配方(🡕)
最强的一组开放模型讨论,重点并不在抽象的“开放性”,而在于精确的打包方式:文件大小、量化方法、运行时分支、上下文上限、解码速度,以及到底哪类消费级 GPU 真能扛起负载。至少有五条入选内容把“可部署性”当作检验标准。
@Eschalabs 称(243 个赞、38 条回复、11,634 次浏览、201 次收藏)表示,其 2-bit Qwen3.8-27B 构建在单张 RTX 5090 上可跑到 82.6 tokens/sec,同时完整模型在磁盘上仅占 10.15 GB。公开的 模型卡 让这条推文不只是宣传:其中写明采用 Apache-2.0 许可证,已在 24 GB 显卡上验证,并提供基于 Escha 的 SGLang 运行时、兼容 OpenAI 的服务器。回复区立刻体现出当天的讨论氛围:有人追问 2-bit 是否真能匹敌 FP8,也有人说现在缺的就是 DFlash2 支持。
@analogalok 展示了(68 个赞、12 条回复、5,594 次浏览、86 次收藏)表示,战场其实已经进一步下沉到推理工程层。他那张严格的 A/B 对比图,在同一套 Qwen3.8 27B / RTX 4090 配置下比较了原生 MTP 与 DFlash2,显示在 150k 上下文下,解码速度从 66.8 提升到 77.4 tokens/sec;在高精度设置下,则从 70.8 提升到 80.8,而预填充仍是原生 MTP 更占优。

@TeksEdge 重点提到(12 个赞、914 次浏览、11 次收藏)展示了一个规模更小、但同样重要的动作:Empero 的 Qwen3.8-4B GGUF 将一位 2.4T Qwen 教师模型的推理能力蒸馏到一个推荐大小为 2.783 GB 的本地构建中。附带卡片的价值在于没有掩盖权衡:MMLU 从 35.4% 提升到 55.3%,但 GSM8K 从 85.0% 降到 78.5%。
@aisearchio 放大了(47 个赞、3 条回复、2,301 次浏览、13 次收藏)提到 Ornith-1.5 的说法:前沿开放权重模型正在进一步缩小差距。公开的 Ornith 发布 显示,这个 397B MoE 旗舰模型在 MIT 许可证下拿到了 Terminal-Bench 2.1 的 86.1 分、DeepSWE 的 56.0 分和 HLE 的 44.6 分;而 @ayam_alvin10 指出(53 个赞、34 条回复、899 次浏览)则指向下一个实际步骤:Ling 的一份指南列出了把本地权重变成可用智能体所需的准确 vLLM 分支、MTP 设置,以及工具调用/浏览器 harness 路径。
讨论洞察: 回复区对含糊说法异常不耐烦。人们要看的是量化质量的凭证、明确的运行时设置,以及清晰可见的基准退化,而不是又一个“这比 Opus 强”的标题。
与前一天对比: 8 月 19 日已经在奖励可部署的开放模型配方。8 月 20 日则把这一主题进一步推进到 2-bit 量化、4B 蒸馏和解码路径调优。
1.2 智能体产品越来越被描述为技术栈,而不是单个机器人(🡕)
最活跃的智能体讨论,不再是某个助手要取代一切,而是如何拼出一支小团队:用云端执行器处理应用密集型任务,在其下叠一层更便宜或更具主权性的执行器,再加一个开放 harness 层,供想掌控工作流界面的产品复用。信息流把编排设计视为真正的产品。
@KanekoaTheGreat 表示(329 个赞、55 条回复、83,490 次浏览)称,Grok Bot 是他第一个“开箱即用”、完全零编码就能上手的智能体系统,并描述了几个基于他 X 存档、从云端运行的助手,分别处理研究、写作、剪辑和记账。回复让这一说法保持落地:有人立刻质疑大约 300 美元/月的价格,作者则回应说,这仍是早期测试版,只有在它能自动化创收工作时才说得通。
@milesdeutscher 梳理了(22 个赞、10 条回复、8,814 次浏览、18 次收藏)给出了同一思路下更清晰的架构。他的图示不是把 Grok Bot 和 Hermes 当替代品,而是拆成不同岗位:Grok 负责 Salesforce、Slack、Gmail 和 Figma 上的登录与应用密集型工作;Hermes 则凭借自托管记忆,处理敏感或成本较高的后台任务,并把成本底线压得更低。

@TheRealAdamG 推动了(48 个赞、2 条回复、2,797 次浏览、17 次收藏)提到公开的 作为平台的 Codex 帖子,其中称开源 Codex harness 现已支撑应用、CLI 和 IDE 扩展。关键在于,文章明确写出这个可复用层到底包括什么:上下文管理、工具、沙箱、审批,以及智能体循环本身,并通过 app-server、SDK 和 exec 接口对外暴露。
更偏开源的一种变体出现在 @LoFiAlon 重点提到(9 个赞、19 条回复、1,940 次浏览、5 次引用)中:Open Bot 是一个类似 Grok 的“单人公司”技术栈,包含 AI 同事、生成式 UI、计算机操作、智能体与人类交接,以及用户自有录制内容。引用推文和 @grok 的回复,重要性与其说在于证明规模,不如说在于证明方向:单人公司自动化已经开始被翻译成开源原语。
讨论洞察: 最有力的反作用力来自 @LukasHozda,其 Autolith 功能清单引来了回复区的追问:当一个智能体可以重定义自身环境的一部分时,信任边界到底落在哪里?即便在最兴奋的线程里,悬而未决的问题仍是:谁批准什么。
与前一天对比: 8 月 18 日和 19 日聚焦的是 harness 质量和运行时护栏。8 月 20 日则把“可组合性”讲得更直白:幕僚长型机器人、主权执行层,以及位于应用专用界面之下的可复用开放 harness。
1.3 基准文化转向证据闭环与垂直工作(🡕)
关于基准的叙事继续远离“哪个基础模型最聪明”,转而关注一个系统能否在真实任务形态中搜索、验证、修复和专业化。被引用最多的说法,不再是通用答案检索,而是发现式工作流、文档密集检索,以及经过领域训练的子智能体。
@igus_ai 总结了(98 个赞、2 条回复、1,573 次浏览、10 次收藏)把 TRACES 定位为“发现式 AI”的基准;公开的 TRACES 论文 加上 Apodex 概览,把这种转向说得很具体:这个框架会在没有已知答案键的问题中,对工具使用、修复、替代方案、连贯性、证据和范围进行评分。这是对“什么才算好”的一次实质性重定义。
@murtuza_merc 报道(103 个赞、14 条回复、9,119 次浏览、11 次收藏)称,Mistral Agentic Search 把测试中的 filing accuracy 从 26.7% 提升到了 86%,相当于翻了三倍多。无论是 Mistral 自己的 发布帖,还是 Fathom 总结,都说明这一层是通过给模型提供五种类文件系统工具来实现的——search、open、navigate、read 和 grep——同时还能把 p90 延迟最多降低 39.6%,并把 token 使用量最多削减三分之一。
@BrendanFoody 认为(43 个赞、1 条回复、3,287 次浏览)称,Harvey 的 Tenet 代表了同一转向在应用层的版本。Harvey 公开的 后训练更新 写道,Tenet 以 Kimi K3 为基础模型,针对长周期法律工作做了后训练,并配有服务于并购尽调、审查表格和律所知识的专业子智能体,同时兼顾性能与 token 效率优化。
讨论洞察: 怀疑并未消失,只是变得更具体了。@bindureddy 表示(55 个赞、8 条回复、36,415 次浏览)称,模型炒作周期如今只有“72 小时”;最尖锐的一条回复则说,真正的开发者不会只问一个可被基准衡量的问题,而是会在不断变化的上下文里连续追问 20 个,真正的问题通常在第 3 天才暴露。
与前一天对比: 8 月 19 日已将评估从模型分数扩展到法律应用、发现系统和运维诊断。8 月 20 日则把新测试标准写得更明确:证据、修复、专业化和可追溯检索,比一次答对更重要。
1.4 AI 原生运营模式正在变成真正的管理问题(🡕)
几条最有用的帖子,已经完全不再讨论模型选型,而是在讨论团队如何让本地模型晋级、如何在不同系统间路由工作、如何重构岗位设计,以及当 AI 开始接触生产工作流时,如何治理自主行为。
@rachelwolan 表示(7 个赞、2 条回复、1,586 次浏览、10 次收藏)称,在“The Lenny 100”的 1,858 个职位空缺中,AI 原生产品组织之所以看起来更精简,是因为前线部署工程正在吸收一部分过去属于 PM 的职责。她的线程称,PM 工作正在转向评测、边缘案例和模型行为;与此同时,如今 89% 的产品岗位和 76% 的设计岗位都要求 5 年以上经验。
@chadwahl 分享了(88 个赞、4 条回复、2,948 次浏览、12 次收藏)转述了 Deutsche Bank 的观点:Palantir 的“主权”叙事越来越不是单模型锁定,而是模型流动性。附带说明称,AIP Evolve 可以根据客户分层需求测试前沿模型、开放权重模型和专有模型,重路由工作负载、重写提示词,并用确定性代码替换不必要的模型调用。
@lordbarmz 展示了(16 个赞、12 条回复、99 次浏览)展示了当天最具操作性的产物:Chronara 的一块构建周看板,上面写着本地模型要先对外部模型做影子运行,达到固定标准后才能接真实工作负载,若性能下滑还会被自动降级。同一块看板也同样醒目地展示了尚未解决的问题——监控崩溃、手动重启,以及尚未验证的故障切换。

@stanine 补充说(36 个赞、2 条回复、418 次浏览)则直接展示了治理覆盖层:Rippling 的 AI 治理套件包括 MCP Gateway、AI Gateway、Agent Identity Management 和 Shadow AI Detection,并与既有员工身份体系和合规政策联动。
讨论洞察: 这些帖子背后的共同规则是:模型不会因为会回答提示词,就自动晋级到生产环境。它们还需要路由规则、身份体系、审核关卡,以及在发生漂移时安全回退的能力。
与前一天对比: 8 月 19 日集中讨论的是技能门控、并发和审计轨迹等智能体护栏。8 月 20 日则展示了下一层在实践中的样子:组织重构、本地模型的晋级门槛,以及治理控制平面。
2. 人们感到沮丧的地方
基准测试标题一碰到真实工作流就会塌掉
严重程度:高。让人沮丧的不是基准测试本身,而是它们仍然过度奖励那些在第 1 天适合拿来炫耀的东西,却低估了买家和构建者到第 3 天才会摸清的问题。@bindureddy 降低了(55 个赞、8 条回复、36,415 次浏览)把这个问题概括成一个很适合传播的循环——基准爆红、随后在基础数学或边缘案例上翻车——而最尖锐的回复则说,真正的开发者会在不断变化的上下文中连续问 20 个问题。入选的 TRACES、Mistral Agentic Search 和 Harvey Tenet 线程,展示了目前的应对思路:把评估迁移到可验证的检索闭环或领域专用子智能体里。这一方向非常值得直接投入。
智能体同事令人兴奋,但信任边界依旧模糊,价格也可能很现实
严重程度:高。@KanekoaTheGreat 提供了(329 个赞、55 条回复、83,490 次浏览)给出了当天关于 Grok Bot 最强烈的正向采用信号之一,但线程里最让人记住的回复仍然是:“我每月付不起 300 美元买这个 bot。”在更技术的一面,@LukasHozda 揭示了(40 个赞、8 条回复、2,098 次浏览、13 次收藏)下面的回复追问:什么样的审批机制,才能阻止一个可自我修改的 harness 越过 Unix 信任边界?而 @stanine 回答了(36 个赞、2 条回复、418 次浏览)则给出了企业版答案:Rippling 的 MCP gateway、智能体身份和 shadow-AI 检测层。团队眼下的应对方式,是在高价编排器之下叠加更便宜或更具主权性的执行器、集中策略,并要求更清晰的审批界面。这一方向非常值得直接投入。
开放本地模型仍然让用户承担过多“举证”工作
严重程度:中高。信息流对本地进展很兴奋,但几乎每一条表现出色的帖子都附带额外的验证劳动。@Eschalabs 报道(243 个赞、38 条回复、11,634 次浏览、201 次收藏)给出了很强的结果,但立刻有人质疑 2-bit 是否真能匹敌 FP8;@analogalok 不得不发布(68 个赞、12 条回复、5,594 次浏览、86 次收藏)则给出了 DFlash2 对比 MTP 的精确数字和显存调优矩阵;@TeksEdge 明确指出了(12 个赞、914 次浏览、11 次收藏)暴露了 Empero 4B 蒸馏在 GSM8K 上的退化;而 @ayam_alvin10 随后展示了(53 个赞、34 条回复、899 次浏览)则体现了当下的应对模式:一条好线程已经不再是“下载模型,完事”,而是“这里有分支、设置、并发数、harness 和坑点”。这一方向值得投入。
消费级 AI 仍面临不信任、上手摩擦,以及与许多人生活方式不匹配的问题
严重程度:高。@omooretweets 认为(50 个赞、13 条回复、3,382 次浏览、19 次收藏)表示,对主流用户而言,“AI”这个词仍意味着一场 uphill battle,并列出四个具体缺口:更多免费使用、更多日常场景、更少上手摩擦,以及更好的公众传播。附带的截图拼图之所以重要,是因为它表明这种敌意并非理论上的;其中包括“F*ck AI”和“Smart people hate AI”这样的评论。而在同一条不适曲线的另一端,@viemccoy 抱怨(135 个赞、21 条回复、3,848 次浏览、57 次收藏)则称,模型提供方不断把一切压缩成同一种默认助手人格,而回复更倾向于角色训练和更多元的人格。这一方向值得投入。

3. 人们希望存在什么
融合审批、路由、身份与支出的智能体控制平面
信息流从多个角度反复描述这一需求。@KanekoaTheGreat 展示了(329 个赞、55 条回复、83,490 次浏览)体现了对常驻型智能体同事的需求;@milesdeutscher 拆分了(22 个赞、10 条回复、8,814 次浏览、18 次收藏)把编排与主权执行拆开;@TheRealAdamG 指出(48 个赞、2 条回复、2,797 次浏览、17 次收藏)指向一个已经处理审批和沙箱的开放 harness;@stanine 明确推出了(36 个赞、2 条回复、418 次浏览)则指向围绕身份和 shadow-AI 检测的治理层。其紧迫性非常现实:人们已经有了能行动的 bot,却仍缺一个明确的位置来定义 bot 可以成为什么、能碰什么、能花多少钱,以及什么时候必须求助。机会类型:直接。
评估调查过程而不只评估答案的基准与检索层
TRACES、Mistral Agentic Search 和 Harvey Tenet 都指向同一个缺失层。@igus_ai 介绍了(98 个赞、2 条回复、1,573 次浏览、10 次收藏)提供了一个面向“无答案键发现”的基准;@murtuza_merc 重点提到(103 个赞、14 条回复、9,119 次浏览、11 次收藏)提供了一个在回答前可 search、open、navigate、read 和 grep 的检索闭环;@BrendanFoody 介绍了(43 个赞、1 条回复、3,287 次浏览)则展示了面向真实文档密集型工作流训练出的法律专业子智能体。这个需求既现实又紧迫,因为买家越来越清楚,排行榜胜利本身并不能预测工作是否值得信赖。机会类型:直接。
面向普通硬件与普通团队的本地模型举证工具包
人们显然想要的不只是原始权重。他们想要一套可复现的包装,告诉他们什么硬件够用、该用哪个运行时分支、接受了哪些质量权衡,以及在真实智能体循环里这套配置是否仍然成立。@Eschalabs 报道(243 个赞、38 条回复、11,634 次浏览、201 次收藏)、@analogalok 发布了(68 个赞、12 条回复、5,594 次浏览、86 次收藏)、@TeksEdge 揭示了(12 个赞、914 次浏览、11 次收藏),以及 @ayam_alvin10 记录了(53 个赞、34 条回复、899 次浏览)各自解决了其中一部分,但没有哪一条帖子完整打通从基准凭证到生产信心的全流程。这个需求很现实,但运行时、量化器和基准封装器已经让赛道变得拥挤。机会类型:竞争性。
价格可承受、低摩擦且更具人性差异的消费级 AI
这一需求既现实,也带有情绪层面。@omooretweets 询问(50 个赞、13 条回复、3,382 次浏览、19 次收藏)呼吁更多免费 AI、更简单的上手方式,以及真正对普通人有意义的使用场景,而不只是服务重度用户。@viemccoy 询问(135 个赞、21 条回复、3,848 次浏览、57 次收藏)则指向另一种不同诉求:人们想要的不是更便宜地使用同一个助手,而是能训练出更古怪、更丰富多元的角色,而不是把一切压缩到同一种默认人格上。这个需求不像企业治理那样标准化,但这种不满是真实存在的。机会类型:理想型。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Escha Qwen3.8-27B-Escha-W2 | 本地 LLM / 运行时 | (+) | 10.15 GB 的 2-bit 构建,已在 24 GB 消费级 GPU 上验证,本地吞吐强,采用开放权重许可 | 依赖 Escha 运行时且需要谨慎验证;读者仍质疑质量是否真能匹敌 FP8 |
| Qwen3.8 27B 上的 DFlash2 | 推理优化 | (+) | 在同一套 4090 配置上显著提升解码速度;给出明确的显存/上下文权衡表 | 预填充更弱、存在单 GPU 场景限制,且调优更复杂 |
| Empero Qwen3.8-4B GGUF | 本地 LLM | (+/-) | 推荐构建仅 2.783 GB;在普通硬件上带来明显的 MMLU 提升 | GSM8K 出现明显退化;该架构需要较新的运行时支持 |
| Ornith-1.5 | 开放权重 LLM | (+/-) | 在 MIT 许可证下,据称具备很强的推理、编码和智能体能力;带有自我改进训练循环 | 公众热情高,但最强分数仍主要来自厂商自报 |
| Grok Bot | 智能体平台 | (+/-) | 持久化云电脑、跨应用执行、多 bot 协作、上手门槛低 | 测试版价格引发抱怨;信任与审批边界仍未解决 |
| Hermes | 自托管智能体 / 记忆层 | (+) | 廉价、常驻执行、具主权性,适合敏感或重记忆任务 | 单独使用时,并不定位为处理应用密集型编排的最佳层 |
| Codex 开源 harness | 智能体运行时 / harness | (+) | 开放的 app-server、SDK、审批、沙箱、工具使用与可复用智能体循环 | 更适合愿意将其集成进自有工作流软件的团队 |
| Mistral Agentic Search | 检索 / 企业搜索 | (+) | search/open/navigate/read/grep 闭环;在 FinanceBench 和 OfficeQA Pro 上提升明显;延迟与 token 使用更低 | 真实世界中的权限、版本和语料混乱仍可能破坏承诺 |
| Harvey Tenet | 垂直法律模型 | (+) | 针对法律工作做后训练,配备专业子智能体,任务完成度与 token 效率更高 | 强领域限定,且绑定 Harvey 的法律 harness 与数据集 |
| Rippling AI 治理套件 | 治理 / MCP 层 | (+) | 智能体身份、shadow-AI 检测,以及与现有员工身份系统的策略联动 | 当前公开证据仍以发布定位为主,缺少广泛运营结果 |
| Chronara 本地模型路由器 | 主权 AI 技术栈 / 路由方法 | (+/-) | 明确的晋级规则、对外部模型的影子运行、请求日志和自动降级 | 监控、备份、重启行为和故障切换仍公开处于未完成状态 |
| Cyberscan | 安全智能体 | (+/-) | 聚焦仓库漏洞工作流、公开可用、基于开放模型技术栈 | 现有证据多为发布文案;效果说法未在讨论中独立验证 |
整体满意度从强烈认可,到复杂且分化的观感不等:人们最看好的是那些给出精确配置、角色边界清晰的工具;而对高价的全能型智能体,以及重基准宣传的开放模型发布,则态度更为复杂。最主流的应对模式是分层:云端编排器叠在主权执行器之上、把一次性检索升级成可导航的搜索闭环,以及用垂直 harness 或治理控制平面去包裹通用基础模型。迁移压力也同时朝两个方向发力——一边远离含糊的“最佳模型”说法,一边走向具体的本地部署配方,或能在工作本身上验证价值的领域专用系统。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Escha Qwen3.8-27B-Escha-W2 | Escha Labs | 提供一个 2-bit Qwen3.8-27B 构建,让前沿级本地推理适配单张消费级 GPU 工作流 | 在不过多牺牲质量的前提下,降低本地部署成本和硬件要求 | Qwen3.8-27B、Escha 运行时、SGLang、CUDA | 已发布 | 帖子, 模型, 运行时 |
| Empero Qwen3.8-4B Distill GGUF | Empero | 将大型 Qwen3.8 教师模型蒸馏成面向常见本地运行时的小型 4B GGUF | 让笔记本和小型 GPU 也能获得更强推理能力,而不必等待官方推出小模型 | Qwen3.8 2.4T teacher、Qwen3.5-4B architecture、GGUF、llama.cpp / Ollama / LM Studio | 已发布 | 帖子, 模型 |
| Codex 开源 harness | OpenAI / Codex 团队 | 暴露 Codex 背后的智能体循环,让团队可将其嵌入自家产品 | 无需从零发明新运行时,也能复用上下文、工具使用、沙箱和审批逻辑 | Codex harness、app-server、SDK、exec、MCP-compatible integrations | 已发布 | 帖子, 博客, 仓库 |
| Mistral Agentic Search | Mistral AI | 增加一个多步骤检索层,可在长文档中 search、open、navigate、read 和 grep | 修复密集、表格繁多、多文档企业问题上的一次性 RAG 失效 | Mistral Search Toolkit、indexed retrieval、multi-step agent loop | 已发布 | 帖子, 发布 |
| Harvey Tenet | Harvey | 经过后训练的法律模型,配有处理并购尽调、审查表格和律所知识的专业子智能体 | 在领域专用 harness 中降低成本,并提升长周期法律任务表现 | Kimi K3 base、post-training RL、legal benchmarks、specialist subagents | Beta | 帖子, 研究更新 |
| Chronara sovereign stack | Chronara | 连接规划型产品工作流、本地模型和私有 mesh,并仅在达到固定标准后让本地模型晋级 | 在受控基础设施内保留请求与数据,同时减少对外部模型的依赖 | Hyvia、local models、router、shadow-eval loop、private Supernode network | Alpha | 帖子 |
| Cyberscan | Prem | 面向公众的安全智能体,可连接 GitHub 仓库并用开放模型扫描漏洞 | 将漏洞检测收敛成一个更快、摩擦更低的智能体工作流 | Kimi-K3、Qwen-3.8-Max、GitHub integration | Beta | 帖子 |
最有意义的构建模式,是压缩加打包。Escha 和 Empero 不只是发布权重,而是在交付经过适配验证的本地占用体积、点明运行时前提,并展示出哪一类硬件因此开始变得可行。这个模式之所以重要,是因为它把“开放模型进展”变成了小团队无需专门基础设施组也能采用的东西。
第二种模式,是通过 harness 设计实现垂直化。Mistral Agentic Search 和 Harvey Tenet 都默认基础模型本身并不够:前者把它包进可导航的检索系统,后者则把它包进法律专用的后训练和专业子智能体。平台侧的 Codex 也体现了同样冲动:产品团队应该拥有界面、工具和审批,同时复用智能体循环。
第三种模式,是先治理、后晋级。Chronara 尤其能说明这一点,因为附带看板明确写着:本地模型先对外部模型做影子运行,达到固定标准后才接真实工作负载,如果表现下滑还能被降级。即便是更偏营销的发布,如 Cyberscan,也刻意保持狭窄范围——扫描一个代码仓库的安全问题,而不是抽象地“解决 AI”。
6. 新鲜且值得关注的内容
监督助手开始随着它们所监控的模型一起扩展
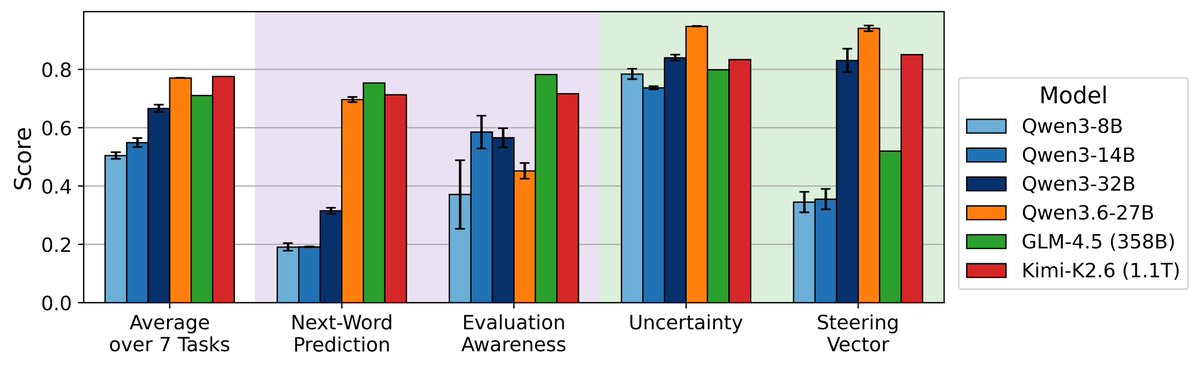
@TransluceAI 报道(25 个赞、1 条回复、604 次浏览、7 次收藏)称,他们已为参数规模最高达 1.1T 的模型训练出 activation oracles,并在一套广泛评估中看到了有希望的扩展趋势。公开的 详解 之所以值得关注,是因为它不只是又一个可解释性口号:它点名了评估感知、不确定性、steering vector 分类和奖励黑客检测等具体监督任务,并称 oracle 性能会随着模型规模、数据规模和数据质量提升而改善。
“单人公司”的叙事正在变成一份开源规格
@LoFiAlon 重点提到(9 个赞、19 条回复、1,940 次浏览、5 次引用)把 Open Bot 描述为一个开源的、Grok 风格的配置,包含 AI 同事、生成式 UI、计算机操作、智能体与人类交接,以及用户自有录制内容。这一点之所以重要,是因为“单人公司”不再只是围绕封闭产品的励志营销;截图和引用线程把它变成了一份其他构建者可以照着抄的具体功能清单。

7. 机会在哪里
[+++] 智能体治理与晋级基础设施 — 跨多个章节看,最大的缺口并不是又一个智能体演示,而是围绕智能体的控制平面。证据来自 Grok Bot 的价格与信任摩擦、Codex 可复用的审批与沙箱循环、Rippling 的身份层、Chronara 对本地模型设置的晋级门槛,以及 Autolith 那些仍无答案的信任边界问题。机会之所以强,是因为采用已经发生,而管理层仍未定型。
[+++] 以证据为先的垂直 AI 层 — TRACES、Mistral Agentic Search 和 Harvey Tenet 都指向同一个赢家:能在领域内部搜索、验证、修复或专业化,而不只是“听起来很聪明”的系统。这是一个强机会,因为信息流中的基准怀疑并不是反 AI,而是在要求产品证明自己真的调查对了。
[++] 本地模型部署与举证工具 — Escha、DFlash2、Empero、Ornith 和 Ling 指南都显示出对本地推理的需求,但也暴露出当前工具链有多碎片化。这里仍有空间做出能统一量化选择、运行时配置、评测凭证和真实工作流验证的产品,让用户不必把自己变成一支基础设施团队。
[+] Consumer AI onboarding and persona diversity — Mainstream users still resist AI when it feels expensive, coercive, or too assistant-shaped, while power users like @viemccoy 明确想要(135 个赞、21 条回复、3,848 次浏览、57 次收藏)提出对更古怪、更多元模型人格的需求。这个机会还处于萌芽阶段,而非成熟赛道,但不信任与情感匹配缺口并存,说明这里可能孕育出新的产品形态。
8. 要点
- 本地 AI 的胜利,只有附带可运行的凭证时才真正有说服力。 最受信任的开放模型帖子都会写清文件大小、运行时、硬件档位和权衡,从 Escha 那个 10.15 GB 的 2-bit Qwen 构建,到 analogalok 明确列出的 DFlash2 解码图表,都是如此。(来源, 来源)
- 智能体产品正在收敛成分层栈,而不是一个万能 bot。 Grok Bot 引发的热情、Grok 与 Hermes 的分工,以及 Codex harness,都指向同一个方向:编排、记忆、审批和应用上下文,正变成可以拆分的层。(来源, 来源, 来源)
- 基准测试的重心转向了证据、检索和领域工作流。 TRACES 把评估重心转向调查质量,Mistral Agentic Search 把检索变成多步骤导航闭环,而 Harvey Tenet 则在法律工作中通过专业子智能体体现了同样逻辑。(来源, 来源, 来源)
- AI 原生运营如今需要晋级规则、路由逻辑和治理,而不只是提示词。 Rachel Wolan 的招聘数据、Chronara 的影子评测看板,以及 Rippling 的治理发布,都表明组织正在围绕评测、身份和回退控制进行重构。(来源, 来源, 来源)
- 主流信任仍是最大的非技术约束。 一条线程展示了评论区对消费级 AI 的公开敌意,另一条则认为默认助手人格本身过于单一;光靠更便宜的访问成本,并不能解决这种匹配问题。(来源, 来源)