Twitter AI - 2026-08-21
1. 人们在讨论什么
1.1 AI 应用开发被视为一门工程学科,而不是提示词技巧(🡕)
最受关注的管理话题并不是“哪个模型赢了”,而是如今要把 AI 应用做得可靠,究竟需要什么。至少有四条被保留的内容都认为,评测、审批和运营上的严谨性,才是区分演示与可部署系统的真正分水岭。
@AndrewYNg 浮出水面 (2,816 个赞,62 条回复,152,810 次浏览,4,754 次收藏) 介绍了构建和部署 AI 应用所需的技能图谱。公开复盘把这项工作拆分为 LLM 基础、基于数据的 grounding、智能体系统、评测驱动开发、生产运维和 ML 基础(摘要)。这条帖子的价值在于回复中的反驳:几位从业者认为,生产环境中的工作最终仍然取决于触发器、事实源边界、验收测试、回滚路径和 trace 阅读,而不只是给输出打分。
@realmadhuguru 认为 (41 个赞,1,645 次浏览,54 次收藏) 提出了分层评测策略,而不是寄希望于一道单一的基准高墙。他的体系区分了用于爬坡优化的长评测、回归评测、冒烟测试和上线评测,让当天更广泛讨论的“评测驱动开发”变得具体起来。
@bybardiia 警告 (100 个赞,71 条回复,3,010 次浏览) 指出,在自动生成的 PR 上点击“Approve”并不是真正的安全方案。链接中的“有纪律的智能体工程”公开讨论也指向同一方向:先规划,明确访问控制,审查最终发布的内容,不要部署自己都不理解的代码。
讨论洞察: 这些帖子的共同反对意见是,能编译通过的答案或一个绿色勾号都远远不够。人们想看到系统为何表现正确的证据、由谁批准有实质后果的操作,以及工作流发生漂移时,系统会如何安全失效。
与前一天的比较: 8 月 20 日已经强调了评测和治理护栏。8 月 21 日则把这一关切进一步具体化为明确的技能图谱、分层命名的评测体系,以及更严格的安全纪律。
1.2 廉价和开放模型通过路由与混合运行持续进入技术栈,而不是直接替代现有模型(🡕)
开放模型的讨论有所推进,但整体氛围更偏操作层面,而非意识形态。被保留的帖子将更便宜、可本地运行的模型视为路由策略中的一层,而前沿模型仍被保留给更重或需要更高信任度的工作。
@deepseek_ai 宣布 (2,291 个赞,137 条回复,111,964 次浏览,326 次收藏) 介绍了 DeepSeek-V4-Flash-Vision-Exp,这是一款实验性多模态模型。官方 DeepSeek 更新日志 称,该模型保持了 V4-Flash 级别的文本性能,同时增强了视觉智能体表现。随帖基准表给出了少见的具体数据:Terminal Bench 2.1 得分 83.9,DeepSWE 得分 59.3,ApexBench Pass@1 得分 36.5,Chartography 得分 64.3,ZeroBench 得分 35.0。这意味着,该模型在多项多模态任务上已接近 Opus-4.8,但价格仍处于 Flash 水平。

@viditchess 报道 (235 个赞,22 条回复,10,963 次浏览,24 次收藏) 分享了当天关于混合使用最扎实的一条观察:他在 DGX Spark 上使用 10 天后,暂时取消了超过 $300 的前沿模型订阅,将大量 Hermes 工作流迁移到本地模型,但仍为更困难的任务保留前沿模型,因为他更信任后者。关键限制在于速度,而不是理念:他在串帖中表示,Qwen 3.8 27B 在 Spark 上约 20 tok/s 的速度“几乎无法使用”。
@bindureddy 推广 (48 个赞,9 条回复,267,276 次浏览,22 次收藏) 介绍了 RouteLLM API:这是一个兼容 OpenAI 的路由器,会把简单轮次发给更便宜的模型,把昂贵任务交给更强的模型。公开信息 TokenRouter 文档 用单一基础 URL、对 Codex CLI 的 Responses API 支持,以及明确的模型表格,为这项基础设施主张提供了依据;但回复也暴露出其中的张力:用户马上要求自托管选项,并指出只有当大量流量确实足够简单时,节省才会真正体现出来。
讨论洞察: 被保留内容中没有人表现得像是前沿模型已经过时。更明显的模式是选择性使用:本地或更便宜的模型负责记忆、日常轮次和成本控制;前沿模型则处理那些人们仍不完全信任量化模型或低配系统的工作。
与前一天的比较: 8 月 20 日聚焦于可部署的本地模型方案。8 月 21 日则上移了一层,开始讨论路由、混合经济性,以及 Flash 级价格下的多模态能力。
1.3 智能体界面开始触及广告、网站和资金,并明确划定审批边界(🡕)
智能体产品的讨论,正从抽象的副驾驶转向能够在真实商业和金融界面中行动的系统。引人注目的不仅是可操作性,还有它们试图明确界定哪些操作必须停下来并请求许可。
@XFreeze 表示 (112 个赞,27 条回复,291,290 次浏览,61 次收藏) 指出,X Ads 已通过 MCP 层实现“原生智能体化”:智能体可以通过普通对话读取效果、创建广告活动、调整定向并推广帖子。串帖中最可信的细节是安全默认设置:新的广告活动和 line item 默认以暂停状态创建,因此在人工激活之前,智能体无法开始花钱。
@Kimilooweb3 认为 (33 个赞,24 条回复,1,660 次浏览) 认为,对 AI 来说最关键的权限将是动用资金,而不是访问电子邮件。MoonPay 的公开信息 PayBox 发布 将这一担忧具体化:用户可以选择“Always Ask”的 passkey 审批,也可以选择带用户自定义限额的“Autonomous”模式。同时,MPC 和安全 enclave 旨在确保智能体始终不会直接持有完整凭证。
@rauchg 分享 (39 个赞,7 条回复,4,011 次浏览,24 次收藏) 介绍了 Is Agentic,这是一个公开扫描器,用来评估智能体读取和使用网站的能力。is-agentic.com 的产品页面值得注意之处在于,它公开了完整技术栈:稳定的报告 URL、JSON、CLI、OpenAPI 和 MCP。但帖中最有价值的回复质疑了评分本身:通过循环运行评分器拿到 100/100,并不等于证明一个陌生智能体首次访问网站时就能成功完成任务。
讨论洞察: 这三条帖子共同指向的产品问题并不是原始能力,而是受约束的行动。默认暂停的广告支出、资金转移前始终询问,以及网站审计的公开证据,都指向同一个需求:智能体界面需要明确的信任边界。
与前一天的比较: 8 月 20 日聚焦于测试框架、审批和治理层。8 月 21 日则展示了这些层如何附着到具体界面——广告账户、网站和支付金库。
1.4 物理 AI 的讨论转向数据引擎、一次学习和单位经济性(🡕)
物理 AI 相关帖子之所以引人注目,是因为它们较少谈论人形机器人的 spectacle,更多关注真正能规模化的因素:物理数据、任务覆盖范围,以及一台有用的机器人能否便宜到足以部署。最有力的证据来自研究总结和公开基础设施文档的结合。
@starlitmatcha 总结 (21 个赞,2 条回复,2,057 次浏览,14 次收藏) 介绍了 Generalist AI 的 GEN-1.5,将其称为机器人领域里类似 GPT-3 式一次学习的模型。官方 GEN-1.5 帖子 表示,该模型无需梯度更新,只需 3–12 秒的演示就能学会新任务;在 10 项任务上的平均成功率为 59%,而在每项任务约 5 分钟数据上执行 10 步梯度更新后,成功率可升至 83%。
@Shohel98787959 将其表述为 (29 个赞,19 条回复,204 次浏览) 介绍了 Axis Robotics 如何将浏览器遥操作转化为机器人训练数据。公开信息 AXIS 网站 和 研究笔记 让这条帖子的分量远超其热度所显示的程度:AXIS 报告称,系统包含 207 项任务、50K+ 条轨迹和 60K+ 个场景变体;经过 AXIS 预训练后,π0.5 的总体成功率从 83.9 提升至 88.8。

@KyleNoble 表示 (27 个赞,7 条回复,7,267 次浏览,11 次收藏) 表示,他的团队花了三个月时间,打造一台“足够有用、能够完成真实工作,同时价格足够低、可以大规模部署”的机器人。串帖后续给出了最重要的数字:目标是起步时把成本控制在每小时 $10 以下。这个细节看似很小,却正是许多机器人公告中缺失的单位经济性视角。
讨论洞察: 共同主题是,仅仅提升模型能力还不够。被保留的证据不断回到物理提示、稳健的数据分布、由失败驱动的数据采集,以及足够清晰、能在实验室之外产生意义的经济账。
与前一天的比较: 8 月 20 日主要由软件智能体治理和本地模型运行占据。8 月 21 日则增加了更具体的物理 AI 层面:一次学习式的物理学习、基于浏览器的机器人数据采集,以及面向部署的价格目标。
2. 人们感到沮丧的地方
智能体输出的速度,已经超过了围绕它建立的审查纪律
严重程度:高。@bybardiia 警告 (100 个赞,71 条回复,3,010 次浏览) 指出,盲目批准自动生成的 PR 并不是安全模型;@AndrewYNg 强调 (2,816 个赞,62 条回复,152,810 次浏览,4,754 次收藏) 则分享了一份技能图谱,而回复很快转向 trace、验收测试、回滚和可观测性。@realmadhuguru 补充说明 (41 个赞,1,645 次浏览,54 次收藏) 通过分别设置爬坡长评测、回归、冒烟和上线评测,补上了缺失的运营细节。人们不断采用的解决方式不是“把提示词写得更好”,而是用明确的测试、审批和可供事后复盘的证据把模型包起来。这是一个值得直接投入建设的方向。
混合和本地技术栈更便宜,但仍受速度、隐私和使用限额制约
严重程度:高。@viditchess 报道 (235 个赞,22 条回复,10,963 次浏览,24 次收藏) 表示,混合本地模型与前沿模型的运行方式大幅降低了他的月度支出,但他也承认,Qwen 3.8 27B 在 DGX Spark 上约 20 tok/s 的速度“几乎无法使用”。@bindureddy 主打 (48 个赞,9 条回复,267,276 次浏览,22 次收藏) 讨论了在更便宜和更强的模型之间进行路由;第一批回复也在意料之中:有没有自托管版本?如果困难查询仍会进入前沿模型层,节省是否会消失?就连 @AlexFinn 遭遇 (356 个赞,40 条回复,23,495 次浏览,503 次收藏) 发布的乐观 Grok Bot 帖子,也有人抱怨使用限额、必须重读每一条输出,以及不确定何时才能安全地信任结果。这是一个值得直接投入建设的方向。
物理 AI 面临的仍是数据瓶颈,而不仅是模型瓶颈
严重程度:高。@Shohel98787959 表示 (29 个赞,19 条回复,204 次浏览) 指出,当前并不存在互联网规模的抓取数据语料库;公开信息 AXIS 研究笔记 基本也认同这一点:真正重要的是多样化、经过筛选且对失败敏感的数据分布,而不是轨迹数量本身。@starlitmatcha 使用 (21 个赞,2 条回复,2,057 次浏览,14 次收藏) 则通过 Generalist AI 的 GEN-1.5 从模型侧说明了同一个观点——物理提示之所以有效,是因为预训练引擎持续吸收了数月的交互数据。@KyleNoble 补充道 (27 个赞,7 条回复,7,267 次浏览,11 次收藏) 则通过将机器人运行目标设定为每小时 $10 以下,给出了部署现实检验。人们的应对方式是把数据采集变成闭环,并要求明确的部署经济性,而不只是演示视频。这是一个值得直接投入建设的方向。
3. 人们希望存在什么
融合权限、评测和支出策略的智能体控制平面
这一需求同时从多个角度显现出来。@bybardiia 认为 (100 个赞,71 条回复,3,010 次浏览) 指出,审查纪律必须先于智能体生成代码;@XFreeze 强调 (112 个赞,27 条回复,291,290 次浏览,61 次收藏) 展示了广告工具,其中最重要的功能是默认暂停支出;@Kimilooweb3 指出 (33 个赞,24 条回复,1,660 次浏览) 将资金权限视为真正的前沿;@rauchg 分享 (39 个赞,7 条回复,4,011 次浏览,24 次收藏) 则展示了面向网站的公开就绪度审计。实际需求是提供一个统一位置,让人们定义智能体可以触碰什么、如何评估、能够花多少钱,以及人在批准下一步之前能看到哪些证据。机会类型:直接。
私有混合路由器和本地模型验证套件
人们似乎已经不再寻找单一的“最佳模型”,而是在寻找路由和证明。@deepseek_ai 宣布 (2,291 个赞,137 条回复,111,964 次浏览,326 次收藏) 展示了一个更便宜、具备多模态能力的模型,并公开了官方基准数据;@viditchess 展示 (235 个赞,22 条回复,10,963 次浏览,24 次收藏) 展示了运营者按任务混用本地模型和前沿模型的真实行为;@bindureddy 提供 (48 个赞,9 条回复,267,276 次浏览,22 次收藏) 则展示了路由层本身。未满足的需求是一个能整合隐私控制、路由策略、成本可见性,以及对量化或本地部署进行可信验证的软件包,让用户不必自己同时充当基础设施和评测团队。机会类型:直接。
面向纯文本聊天之外智能体的领域专用基础层
最有趣的构建者信号,来自聊天不再是自然界面的场景。@DavidSacks 转发推荐 (554 个赞,33 条回复,58,911 次浏览,135 次收藏) 介绍了 Harvey Tenet,这是一个带专业子智能体的法律模型;@try_litefold 推出 (105 个赞,5 条回复,12,380 次浏览,59 次收藏) 介绍了 LiteMol-1,这是一个方便智能体使用的分子生成模型;@OpenBMB 发布 (23 个赞,604 次浏览,8 次收藏) 介绍了带 Lean 验证循环的 MathForm;@Shohel98787959 介绍 (29 个赞,19 条回复,204 次浏览) 介绍了 AXIS,这是一套基于浏览器采集机器人轨迹的系统。人们需要的是紧凑、可编辑的领域表示,以及内置验证器或数据引擎,让智能体能够在法律、分子、形式化数学和机器人领域工作,而不是假装一切都只是文本。机会类型:直接。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| DeepSeek-V4-Flash-Vision-Exp | 多模态 LLM / API | (+) | 保持 V4-Flash 级别的文本性能,视觉智能体基准表现强,API 形态和 Flash 价格不变 | 基准由厂商自行报告,模型仍处于实验阶段,未披露开放权重 |
| TokenRouter API | 模型路由器 / 网关 | (+/-) | 单一基础 URL、兼容 OpenAI、支持 Codex CLI、模型目录广泛 | 回复中存在隐私担忧,节省多少取决于实际“简单”流量的比例 |
| DGX Spark + 本地/前沿模型分工 | 运行方式 | (+/-) | 降低订阅支出,保留本地记忆和私有工作流,并为困难任务保留前沿模型兜底 | 本地速度瓶颈和对量化模型的信任问题仍会打破理想状态 |
| Harvey Tenet | 垂直法律模型 | (+) | 针对法律领域进行后训练,配备专业子智能体,任务完成度更高且 token 效率有所提升 | 面向特定领域,评估仍主要依赖 Harvey 选定的测试框架 |
| X Ads MCP | 商业 API / MCP 界面 | (+/-) | 通过对话管理广告活动,支持多种广告账户操作,支出默认暂停 | 目前公开证据仍停留在线程层面,核心信任边界仍有争议 |
| MoonPay PayBox | 智能体支付金库 | (+) | 支持“Always Ask”和“Autonomous”两种策略模式,采用 MPC/TEE 托管设计,交易覆盖面广 | 需要谨慎设置权限,并要求用户信任策略限额 |
| Is Agentic | 智能体就绪度审计 | (+/-) | 100+ 项检查、稳定的公开报告、CLI、JSON API、MCP 服务器 | 高评分可能仍与智能体首次访问时的真实成功率不一致 |
| LiteMol-1 | 科学基础模型 | (+) | 一个模型覆盖多类分子,比依赖结构的技术栈更适合智能体搜索和编辑循环 | 公开基准细节仍主要集中在发布帖和图片中 |
| MathForm-8B | 形式化数学框架 / 模型 | (+) | 从 Mathlib 检索,运行 Lean 验证循环,尽管规模更小,Pass@8 结果仍然强劲 | 专用于 Lean 4 自动形式化,而非通用推理 |
| AXIS | 物理 AI 数据引擎 | (+/-) | 浏览器遥操作,大规模任务/轨迹集合,通过数据精炼和增强获得可测量的稳健性提升 | 嘈杂的众包数据仍需要后端进行大量筛选和验证 |
| EnvHarness / EnvRigger | 智能体训练环境方法 | (+) | 在适应陈旧环境的同时保留可信验证器,以更少步骤提升留出集性能 | 仍处于研究阶段,尚不是日常生产工具 |
用户满意度从高度认可那些能公开明确界面、验证器或限制的工具,到对仍依赖隐性信任假设的产品持复杂态度。人们偏好的替代方案是分层:把便宜请求路由到前沿模型之外,把私密或内存密集型工作留在本地,用审批或策略包住操作界面,并将领域工作放入带有原生检查机制的专用基础层。
迁移压力同时来自两个方向。在供给侧,更便宜的开放模型和实验性模型持续把日常工作负载从高价订阅中拉走。在需求侧,真正胜出的产品不是通用聊天封装,而是那些要么让关键操作更安全、要么让专业工作流对智能体更可读的工具。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Harvey Tenet | Harvey | 经过后训练的法律模型,配备负责尽调、审查表格和律所知识的专业子智能体 | 在降低单项任务成本的同时,改善长流程法律工作 | Kimi K3 基础模型、Fireworks research、RL、法律测试框架、子智能体 | Beta | 帖子, 研究更新 |
| TokenRouter API | Bindu Reddy / TokenRouter | 在前沿模型和开放模型之间提供兼容 OpenAI 的路由网关 | 降低多家模型供应商之间的成本和工具碎片化 | TokenRouter 网关、Responses API、路由、缓存 | 已发布 | 帖子, 网站, 文档 |
| PayBox | MoonPay | 支付金库,让 Claude 或 ChatGPT 智能体在用户定义的策略限额下进行交易 | 让智能体能动用资金,同时不把托管权交给它们 | 自定义连接器、passkey、x402、MPC、TEE | 已发布 | 帖子, 发布 |
| Is Agentic | Vercel / Ora | 评估网站是否能被 AI 智能体发现和使用 | 帮助团队发现并修复公开的智能体就绪度缺口 | 公开扫描器、报告 API、CLI、OpenAPI、MCP 服务器 | 已发布 | 帖子, 网站 |
| LiteMol-1 | LiteFold | 面向智能体分子设计的多分子扩散语言模型 | 让大规模分子搜索和编辑比依赖结构的工作流更便宜 | 扩散语言模型、分子序列 token、MCTS | Alpha | 帖子, 研究 |
| MathForm-8B | OpenBMB | Lean 4 自动形式化框架、数据集和模型 | 通过检索和迭代,将自然语言数学转换为经过验证的形式化代码 | Mathlib 检索、LeanExplore、FormalVerse、SFT + RL | Alpha | 帖子, 论文, 代码仓库 |
| AXIS | Axis Robotics | 用于机器人策略训练的浏览器遥操作和数据引擎 | 无需本地模拟器或机器人硬件,扩大物理 AI 数据采集规模 | MuJoCo-WASM 浏览器控制、验证管线、增强、评测套件 | Alpha | 帖子, 网站, 文档 |
@DavidSacks 转发推荐 (554 个赞,33 条回复,58,911 次浏览,135 次收藏) 是当天最清晰的垂直模型构建案例。Harvey 的公开更新表示,Tenet 不只是微调后的法律聊天机器人;它以 Kimi K3 为基础模型,经过面向长流程法律工作的后训练,并配备负责尽调、审查表格和律所知识的专业子智能体。后训练与面向任务的路由相结合,越来越成为这份信息流中“应用护城河”的具体形态。
@Kimilooweb3 指出 (33 个赞,24 条回复,1,660 次浏览) 指向了另一种垂直层:原生面向智能体的支付。MoonPay 的 PayBox 发布 值得注意,因为它把信任本身当作产品界面的一部分——passkey、用户范围内的权限模式,以及智能体不会直接获得密钥或银行卡托管权的主张。Is Agentic 则从网站侧体现了同样的元层模式:在智能体能够良好使用网站之前,网站本身必须提供可读的结构、可恢复的错误和面向机器的接口。
@try_litefold 推出 (105 个赞,5 条回复,12,380 次浏览,59 次收藏) 介绍了当天最有实质内容的科学智能体工具之一。帖子和图片显示,LiteMol-1 覆盖多类分子,同时停留在可编辑的序列空间内,而不是依赖昂贵的纯结构搜索循环。
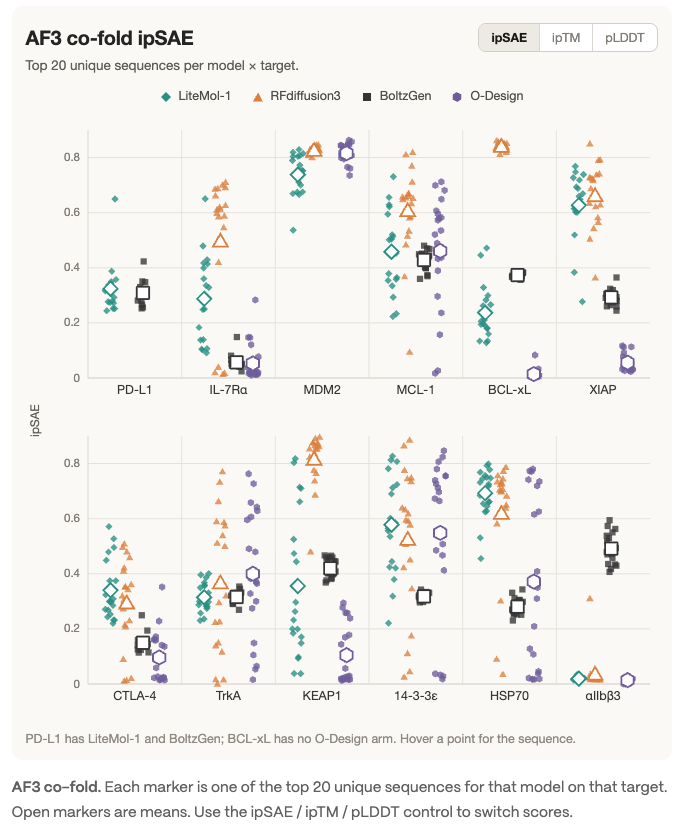
第二张 LiteMol 图表让这一说法不只是雄心勃勃,而是更有实质内容:在共享的 docking 图中,LiteMol-1 及其搜索变体在 MDM2、KEAP1 和 MCL-1 等靶点上接近或超过了多个肽类基线;另一张图则显示,小分子变体的中位 docking 分数为 8.02,接近 ProtoBind-Diff 的 8.17。重点并不是分子设计已经被解决,而是构建者正在为智能体提供一个紧凑的分子工作空间,让它们可以反复编辑、评分和重新生成。
@OpenBMB 发布 (23 个赞,604 次浏览,8 次收藏) 介绍了一个同样以验证器优先的形式化数学技术栈。公开信息 MathForm 代码仓库 表示,该系统会检索正确的 Mathlib 定义,运行 Lean 编译和语义检查,并在训练发布的 8B 模型之前反复改进输出。

随附的基准表具体呈现了规模上的主张:MathForm-8B 的语法检查 Pass@8 平均为 88.06,一致性检查 Pass@8 平均为 72.37;尽管面对多个 32B 自动形式化模型的竞争,它在 FATE-H 上达到 63,在 FATE-X 上达到 37。AXIS 则从机器人领域补上了这一模式:它不是一个机器人 persona,而是一个数据引擎,把浏览器控制、筛选、增强和留出集评测转化为可训练的内容。
这些项目反复呈现出一种清晰的构建模式:只有当构建者提供合适的基础层,智能体才不再显得通用。在法律工作中,这一基础层是文档测试框架和专业子智能体;在支付领域,是带权限控制的托管轨道;在分子领域,是可编辑的序列空间;在形式化数学中,是检索加 Lean 验证;在机器人领域,则是可持续扩展的数据引擎。
6. 新动态与值得关注的内容
Anthropic 自己的能力图表暗示,下一步提升幅度可能有限
@ChrisGPT 强调 (47 个赞,11 条回复,3,865 次浏览,7 次收藏) 提供了 Anthropic 发布材料中的一个细节,虽然很小,却很重要:一条内部 AECI 轨迹显示,“Model 2”仅比 Claude Mythos 5 高约 1.5 分,且误差线很大。这一点很重要,因为图表本身明确警告,Anthropic 的内部得分不能直接与 Epoch 的公开排行榜比较;但它仍然让市场少见地看到,一家前沿实验室如何思考能力随时间的进展。

Google 的 EnvHarness 将环境设计本身纳入智能体进步
@omarsar0 提示关注 (14 个赞,3 条回复,1,442 次浏览,14 次收藏) 介绍了 EnvHarness,旨在避免智能体学习环境逐渐过时。公开信息 论文 表示,EnvHarness 可以在不改变可信验证器的情况下封装静态环境,而 EnvRigger 则根据智能体轨迹合成有针对性的修改;据报告,留出集得分最高提升 9.0 分,同时执行步骤减少 9.8%。这值得注意,因为它把进步的重心从“更好的模型”转向“模型与环境之间更好的共同演化”。
7. 机会在哪里
[+++] 受权限控制的智能体运营 — 跨越多个章节的最强机会,在于让智能体接触真实系统时,不会悄然越过信任边界。证据来自 X Ads 默认暂停的广告活动创建、PayBox 的“Always Ask”与“Autonomous”模式、Is Agentic 的公开证据层,以及针对自动批准 PR 的安全质疑。需求之所以强烈,是因为行动能力到来的速度,已经超过了可信控制界面的建设速度。
[+++] 混合路由与验证基础设施 — DeepSeek 更便宜的多模态模型发布、viditchess 的混合 DGX Spark 配置,以及 TokenRouter 兼容 OpenAI 的网关,都显示出市场对成本感知型编排的需求。机会很强,因为用户希望在一个地方获得路由、隐私和可信验证,而不是分别用多个工具处理不同问题。
[++] 带原生验证器的领域专用智能体基础层 — Harvey、LiteMol、MathForm 和 AXIS 都指向同一种模式:当基础层本身针对任务进行了专门设计时,智能体才真正有用。法律测试框架、分子序列空间、Lean 验证器和机器人数据引擎,都在缩小“聪明的输出”与“确实可以检查的工作”之间的差距。
[+] 物理 AI 数据引擎与部署经济性 — Generalist AI 的一次学习式物理学习、AXIS 的浏览器数据引擎,以及 Kyle Noble 每小时低于 $10 的目标,展现了一个正在出现但仍处于早期阶段的机会。与如今的软件智能体基础设施相比,这一信号较弱;但数据瓶颈与单位经济性压力的结合,使其成为信息流中更可信的机器人发展方向之一。
8. 核心结论
- AI 工程本身成为顶层话题。 最重要的帖子不只是发布模型,而是定义了安全交付 AI 系统所需的技能、评测层和审查纪律。(来源, 来源, 来源)
- 本地模型与前沿模型的混合运行,已经成为常规的成本和信任策略。 DeepSeek 按 Flash 价格发布多模态模型、viditchess 的 DGX Spark 工作流,以及 TokenRouter 的路由层,都指向按任务选择模型,而不是只忠于一个模型。(来源, 来源, 来源)
- 真正的智能体普及,不仅取决于模型质量,也取决于权限控制轨道。 广告账户、网站和支付金库如今都需要明确的审批、证据和支出边界。(来源, 来源, 来源)
- 最强的构建者信号来自专用基础层,而不是通用聊天封装。 Harvey 的法律测试框架、LiteMol 的分子工作空间、MathForm 的 Lean 验证循环,以及 AXIS 的机器人数据引擎,都让智能体对其服务领域更可读。(来源, 来源, 来源, 来源)
- 当讨论聚焦数据和经济性,而不是 spectacle 时,物理 AI 显得更可信。 Generalist AI 的一次学习式物理提示、AXIS 的数据集引擎,以及每小时低于 $10 的机器人目标,都将讨论拉回了可部署性。(来源, 来源, 来源)