Twitter AI - 2026-08-22
1. 人们在讨论什么
1.1 Agent 的工作正向上迁移到 harness 和上下文控制层(🡕)
今天最密集的讨论并不是某个单一模型的发布,而是模型之上的那一层:上下文压缩、可复用技能、Agent 轨迹,以及自动化 harness。在一条高互动帖子和几条互动量较低的开发者帖子中,大家反复提出同一个判断:与其说提示词措辞最重要,不如说关键在于 Agent 被允许看到什么、存储什么、复用什么,以及如何评估这些内容。
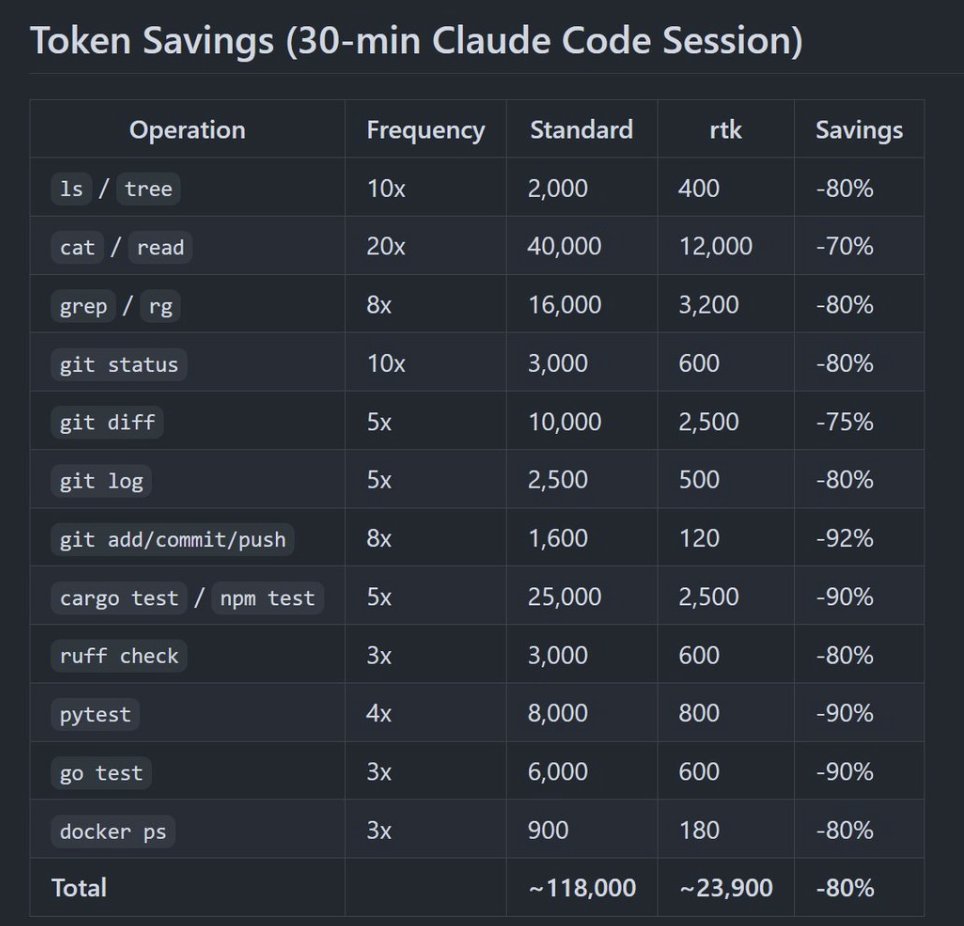
@sairahul1 认为,编码 Agent 把预算浪费在终端输出、代码仓库转储、日志、MCP 载荷和冗长回复上的程度,远高于浪费在提示词本身上的程度(帖子,115 个赞、10 次转发、2.52 万次浏览)。附带表格把这一点说得很直观:在 Claude Code 的一次 30 分钟会话中,如果在命令输出送达模型前先进行压缩,Token 用量可从约 118,000 降至约 23,900。
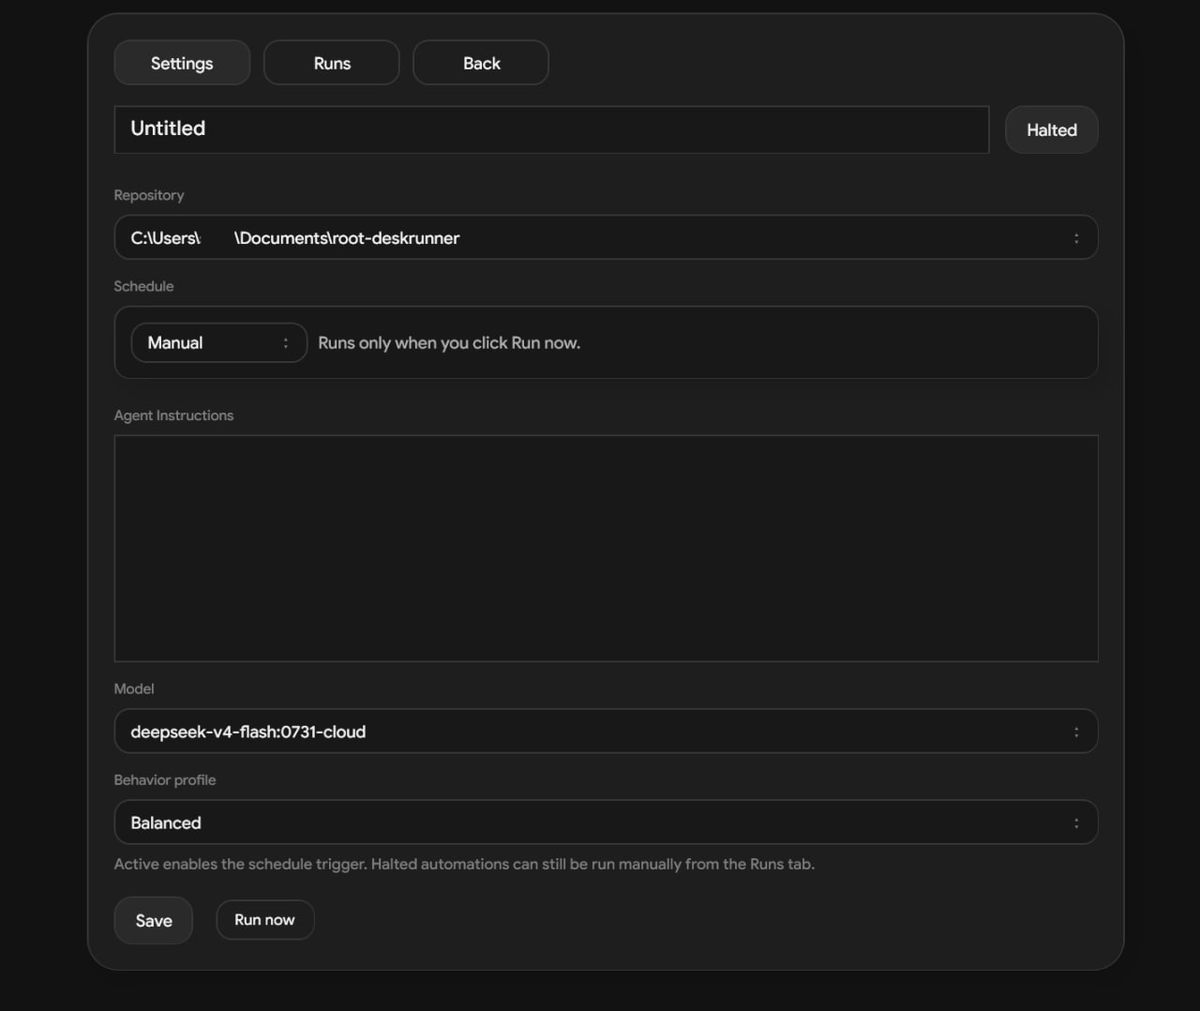
@palmaierc 展示了 /root 的自动化功能:它不是一次性提示词,而是可复用的 Agent 任务,支持按技术栈调整提示词并进行动态评估(帖子,28 个赞、16 次转发、884 次浏览)。其公开网站目前信息仍然不多,但截图已展示出一个具体的 harness 界面,包含可复用模板、仓库路径选择、定时安排和模型选择控件。
@DanKornas 发布了两个互补的控制平面项目:PandaProbe 用于追踪、评估、监控和调试(帖子,6 个赞、1 次转发、800 次浏览);SkillNet 用于封装技能,使技能可以在不同 Agent 之间被搜索、安装、评估和组合(帖子,5 个赞、2 次转发、764 次浏览)。它们与那条关于 Token 的讨论共同指向同一种架构转变:把状态、日志和可复用能力,从临时聊天轮次里迁出,放进持久化基础设施中。
讨论洞察: 那条 Token 讨论下最有价值的回复,并不是建议把提示词写得更短,而是建议把探索性工作交给子 Agent,由它们返回摘要而非原始日志。这与更广泛的趋势一致:重点转向轨迹、技能封装和外置上下文,而不只是单纯依赖更大的上下文窗口。
与前一天对比: 前一天已经有人提出,AI 产品能否胜出取决于审批流程、护栏和集成纪律。到了今天,这一抽象判断进一步落到了具体工具上:上下文压缩、自动化、可观测性和可复用技能。
1.2 基准测试正围绕真实任务、预算与调查质量重建(🡕)
第二个主要主题,是人们对静态答案键式基准测试的不满。来自基准测试、研究和安全审查方向的帖子,几乎都指向同一个抱怨:好看的分数比在杂乱任务中稳定完成工作更容易被“刷出来”,因此评估必须更贴近真实工作流。
@coastyai 发布了 CoArena:一个众包的计算机使用竞技场,让两个前沿 Agent 在完全相同的沙盒中执行同一项真实任务,再由人类在盲评条件下判断结果(帖子,44 个赞、5 次转发、3.3k 次浏览)。其发布数据刻意并不讨喜:只有约 66% 的 Agent 运行最终完成了任务;表现最好的前沿 Agent 在相同运行中的完成率约为 87%,最差的约为 42%;约 7% 的对局以两个 Agent 都失败告终。
@Nozelcode 重点介绍了 TRACES。它评估的是调查过程本身,而不只是最终答案,并把工具使用、修复、替代方案、一致性、证据和范围拆成不同维度分别打分(帖子,105 个赞、1 次转发、2.9k 次浏览)。公开的 TRACES 网站 和 工作原理页面 也明确表达了同样的观点:更难的科学问题往往没有标准答案,因此基准测试必须评估 Agent 如何探索、如何论证。
@marfinxx 将 Google DeepMind 的 BATS 工作概括为一种从 harness 侧修复工具使用失控问题的方法,并称其可将复杂多步任务的完成率从 51.4% 提升至 84.6%,同时将冗余调用减少 54.2%(帖子,18 个赞、393 次浏览)。公开的 budget-aware-agent 仓库 则把同一方法描述为:在 Agent 循环中显式进行预算跟踪、验证与重规划。与此同时,@XFreeze 分享了更新后的 Artificial Analysis τ³-Banking 图表:Grok 4.6 领先,但在规则密集型银行工作流中的完成率仍只有 51%(帖子,56 个赞、12 次转发、3.9k 次浏览)。

@ChainfireXDA 又补充了一个实务审查者的反对意见:Claude 在某项目中发现了已知问题,却漏掉了关键逻辑漏洞,因为它从未把实现与正确的领域模型进行对照(帖子,8 个赞、2 次转发、571 次浏览)。换一种说法,这仍是同一问题:当任务要求基于证据推理系统应当如何运作时,模式匹配式审计并不够。
讨论洞察: 今天最刺眼的基准数据并不是谁拿了第一,而是失败区间:CoArena 中有三分之一的任务在出分前就失败了,而银行基准中的第一名也只解决了大约一半任务。
与前一天对比: 昨天的讨论已经偏向审批关卡和评估层。今天的讨论则更尖锐、也更实证:出现了新的竞技场、明确的失败率,以及专为未知答案任务设计的基准方案。
1.3 Physical AI 的讨论聚焦于数据引擎和纠错循环,而非机器人本体(🡕)
Physical AI 仍然活跃,但讨论重点并不是人形机器人演示,也不是泛泛而谈的机器人乐观主义。最强的帖子聚焦于如何创建、筛选并利用有价值的交互数据:更短的纠正、更好的场景覆盖,以及把仿真重新连接回物理输出的闭环。
@BossMon_02 总结了 Axis 的结果:660 次人工纠正最终只沉淀出 161 段值得用于训练的片段;直接模仿反而把成功率从 40.0% 降到 36.7%;而经过验证的短纠正则把三个随机种子的平均成绩提升到 48.3%(帖子,134 个赞、393 次浏览)。这很有力地说明,筛选和验证比单纯堆高纠正数量更重要。

@Etheliaeth 将更广泛的问题概括为“Physical AI 的数据问题”,认为机器人真正需要的是生成交互的基础设施,而不只是更好的模型(帖子,48 个赞、762 次浏览)。公开的 AXIS 概览 和 研究页面 也支撑了这一表述:207 项任务、超过 50,000 条轨迹、超过 60,000 个场景变体;据称在使用完整 AXIS 数据集训练后,π0.5 在 LIBERO-Plus 上的成绩从 83.9 提升到了 88.8。

@starlitmatcha 放大了 Generalist AI 的 GEN-1.5 结果:只需 3 到 12 秒的演示,就足以实现 one-shot 任务迁移,在 10 项任务上的平均成功率为 59%;在约 5 分钟数据上进行 10 个梯度步骤后,成功率升至 83%(帖子,33 个赞、1 次转发、3.3k 次浏览)。公开的 GEN-1.5 介绍 补充了相同的 one-shot 和 few-shot 细节。@ProfBuehlerMIT 则把同一主题推进到创客工作流中:描述了 Agent 如何从图像出发,生成仿真,完成 47 次实验,再导出 STL 并在 Bambu Lab H2D 上进行 3D 打印(帖子,129 个赞、26 次转发、2.20 万次浏览)。
讨论洞察: 这些帖子背后的共同操作思路是:Physical AI 的进展取决于交互闭环的质量和结构——经过验证的短纠正、多样化场景,以及从仿真快速迭代回物理世界的能力。
与前一天对比: 前一天已经出现了 Physical AI 相关内容,但今天的帖子更具体地讨论了模型背后的数据引擎,以及更好的纠错处理所带来的可量化提升。
1.4 本地化与多模态部署变得更务实,但前提是明确目标机器(🡕)
最后一个强主题是部署适配的务实性。最有用的帖子并不是笼统宣称“本地 AI 要来了”,而是把内容绑定到特定模态或特定机器:macOS 上的本地语音输入、更小前沿模型带来的更快原型开发、多模态发布对比表,以及面向单机推理的硬件适配图。
@elliotarledge 发布了 Phonon:一款面向 macOS 的本地语音输入工具,支持屏幕上下文 OCR、Parakeet ASR 和基于 Gemma 的纠错,安装后全部保留在设备端运行(帖子,12 个赞、1 次转发、1.0k 次浏览)。公开的 Phonon 网站 和 仓库 更详细地描述了这一本地优先的流水线。@rakyll 也给出了同方向上的一手生产力对比:一个办公室模拟器,18 个月前用某个 pro 模型要尝试 50 多次,如今用 Gemini Flash 3.7 只需 7 到 8 次(帖子,69 个赞、3 次转发、5.4k 次浏览)。
@RoundtableSpace 传播了 DeepSeek-V4-Flash-Vision-Exp 的消息,并附上一张基准表,把这款快速视觉模型定位为:文本能力与 V4 Flash 大致持平,同时提升多模态 Agent 表现(帖子,21 个赞、19.4k 次浏览)。官方的 DeepSeek 更新 则补上了推文中缺失的细节:Terminal Bench 2.1 为 83.9、DeepSWE 为 59.3、ApexBench Pass@1 为 36.5、Chartography 为 64.3、ZeroBench 为 35.0。
@sudoingX 则从更贴近操作者的角度,梳理了哪些“flash”模型真的能装进单台 DGX Spark,哪些装不进去(帖子,6 个赞、951 次浏览)。图表显示,只有 118B 至 124B 的狭窄区间能较为从容地适配这台机器,而 Step 3.7 Flash 比可用内存预算多出约 13GB。

讨论洞察: 今天人们对“Flash”“lite”和“mini”这些标签持明显怀疑态度。真正有意义的问题是模型是否适配预期硬件和工作负载,而不是营销标签是否暗示了高效率。
与前一天对比: 前一天的讨论更多停留在泛泛的混合路由上;今天则更偏操作层面:本地语音输入、单机适配约束,以及明确的工作流前后对比收益。
2. 人们对什么感到沮丧
基准测试的真实性与隐藏的失败率
严重程度:高。多条帖子不满的并不是分数低,而是基准测试叙事看起来过于整洁、容易误导。@coastyai 表示,在 CoArena 中,真实的计算机使用任务只有约三分之二能完成,三分之一的运行在甚至还没有分数之前就已经失败(帖子,44 个赞、5 次转发、3.3k 次浏览)。随后,@XFreeze 又展示了一项银行基准,其中领先模型也只解决了 51% 的任务(帖子,56 个赞、12 次转发、3.9k 次浏览)。这看起来很值得围绕它做产品,因为差距并不抽象:开发者希望评估系统在部署前暴露失败模式,而不是在部署后才发现。
编码 Agent 工作流中的上下文膨胀
严重程度:高。今天最明确的沮丧点,是编码 Agent 一直把预算烧在不该烧的地方。@sairahul1 认为,终端日志、代码仓库转储、MCP 载荷以及 Agent 的冗长输出,可能会造成比必要多出 10 到 50 倍的 Token 浪费,并附上表格说明,在一次实际工作会话中,命令输出占了 Token 账单的大头(帖子,115 个赞、10 次转发、2.52 万次浏览)。讨论中可见的实用应对策略并不是“把提示词写短”,而是对原始输出做摘要、把探索性工作路由给子 Agent,并把大型工具响应外置出去。
领域逻辑依然会从 AI 审查中漏过去
严重程度:高。@ChainfireXDA 描述了一次具体的审查失败:Claude 标出了已知问题,却漏掉了关键 bug,因为它从未把代码与审查者期待它套用的领域规则进行对照(帖子,8 个赞、2 次转发、571 次浏览)。这与 TRACES 和 BATS 背后的诉求一致:人们想要的不只是流畅输出,而是能够基于证据推理、节约预算,并在当前推理路径不够时意识到这一点的 Agent。
Physical AI 中的问题在于数据质量,而非原始数据量
严重程度:高。机器人相关帖子里的沮丧主要针对噪声过多或无效的数据。@BossMon_02 报告称,660 次人工纠正里只有 161 次足够好、值得保留;朴素模仿一度让结果变差,之后是经过验证的片段把效果拉了回来(帖子,134 个赞、393 次浏览)。@Etheliaeth 则把这概括为一个更大的抱怨:Physical AI 甚至还缺少收集正确交互所需的基础设施(帖子,48 个赞、762 次浏览)。这同样看起来值得投入,因为痛点位于模型层之下,而且在多条独立帖子中反复出现。
本地部署指导依然碎片化
严重程度:中。@sudoingX 指出,模型卡通常会公布参数量和基准分数,却很少解释某个模型究竟能否在某台具体机器上跑起来,于是他发布了一张 DGX Spark 适配图来填补这一空白(帖子,6 个赞、951 次浏览)。回复说得很直接:这类知识至今仍大量散落在零碎时间线里。Phonon 和 Gemini Flash 3.7 说明,本地工作流和小模型工作流可以很好用,但前提是操作者知道具体模态、内存预算和任务形态。
3. 人们希望出现什么
奖励调查过程,而不只是奖励碰巧答对的评估体系
这是数据集中最明确的现实需求。TRACES 之所以存在,是因为许多重要任务没有已知答案;CoArena 之所以存在,是因为静态计算机使用测试集一旦样例泄露进训练数据,就会不断趋于饱和(TRACES 帖子,105 个赞、1 次转发、2.9k 次浏览;44 个赞、5 次转发、3.3k 次浏览)。这不是一个遥远愿景,而是紧迫需求:人们想要能够在真实任务中评估工具使用、证据、恢复能力和步骤质量的基准。机会:直接。
可复用的 Agent 控制平面,而不是一次性的提示词手艺
几位开发者其实都在要求同一个缺失层:一个能保存自动化、检查轨迹、封装技能,并在聊天记录之外运行评估的地方。/root 把自动化变成可复用任务,PandaProbe 集中管理轨迹和评估,SkillNet 则把提示词、代码仓库、文档和轨迹转成可安装的技能包(/root 帖子,28 个赞、16 次转发、884 次浏览;6 个赞、1 次转发、800 次浏览;SkillNet 帖子,5 个赞、2 次转发、764 次浏览)。这看起来是切实的工作流需求,而不是一个新奇功能。机会:竞争激烈。
把私密上下文留在设备端的本地优先界面
Phonon 证明,围绕模型构建私密、本地的交互层确实存在真实需求,而不只是对“本地模型”这个概念的抽象兴趣(帖子,12 个赞、1 次转发、1.0k 次浏览)。DGX Spark 适配讨论则补上了缺失的运维需求:人们还想要可信的指导,知道哪些模型真的适合自己的机器和工作负载(帖子,6 个赞、951 次浏览)。这些帖子合起来,指向的是“本地优先 UX + 清晰部署指导”的现实需求。机会:直接。
面向受监管工作的垂直 harness
最明确的领域化诉求来自金融。@FundamentEdge 认为,华尔街需要的与其说是通用的 Claude Code 模式,不如说是带有领域专家、harness、评估集、上下文图谱和工作流专属知识的垂直系统(帖子,70 个赞、3 次转发、1.32 万次浏览)。再结合银行基准测试并不理想的分数,这更像是在明确要求:围绕模型构建面向特定领域的操作系统。机会:竞争激烈。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| RTK / 上下文缩减技术栈 | 编码 Agent 工作流 | (+) | 在命令和工具输出送达模型前先去噪;在活跃会话中可显著节省 Token | 需要额外的工作流衔接,且本身并不能解决任务拆解不佳的问题 |
/root |
Agent 工作空间 / harness | (+/-) | 可复用自动化、动态提示词调整、评估钩子、模型选择界面 | 公开证据目前主要还是截图和发布文案,深度文档不足 |
| PandaProbe | Agent 工程平台 | (+) | 统一的追踪、评估、监控与调试;支持云端或自托管部署 | 仍属早期项目,目前公开使用信号较弱 |
| SkillNet | 技能封装 / 编排 | (+) | 技能可搜索、可安装;还能从提示词、代码仓库、文档或轨迹生成技能 | 今天公开能看到的证据主要还是 README 截图和发布帖 |
| Phonon | 本地语音界面 | (+) | 设备端音频处理、OCR 上下文、开源技术栈,以及聚焦口述输入模型的交互体验 | 仅限 macOS,且针对的交互模式较窄 |
| Gemini Flash 3.7 | 模型 | (+) | 至少在一条一手原型开发案例中,能更快从提示词得到可工作的输出 | 这里的证据更偏轶事,而不是大量基准数据 |
| DeepSeek-V4-Flash-Vision-Exp | 多模态模型 / API | (+) | 在维持接近 V4 Flash 文本能力的同时,对视觉 Agent 任务给出了较强的公开基准表现 | 仍然是托管模型方案,不是本地部署答案 |
| DGX Spark 适配区间 | 部署方法 | (+/-) | 让单机推理规划变得具体,而不是依赖营销标签判断 | 有用的适配信息仍然零散,需要人工拼装 |
| BATS | Agent 执行方法 | (+) | 具备预算感知的工具使用、重规划与自验证,可在不重训的情况下提升完成率 | 更像研究方法,而非现成产品 |
| EnvHarness | 基准 / 环境方法 | (+) | 通过插件重塑静态环境,同时保留原有验证器 | 目前仍属于研究基础设施,尚不是广泛应用的生产工具 |
总体上,大家对能让 Agent 行为更可观测、更便宜或更可复用的基础设施持积极态度;而对那些仍主要停留在承诺或截图阶段的东西,则态度偏混合。一个反复出现的应对模式,是把昂贵状态移出主对话:压缩输出、单独存储轨迹、把重复工作流变成自动化,并将成功行为封装成可复用技能,而不是每次都重写提示词(sairahul1 帖子,115 个赞、10 次转发、2.52 万次浏览;PandaProbe 帖子,6 个赞、1 次转发、800 次浏览;SkillNet 帖子,5 个赞、2 次转发、764 次浏览)。
与此同时,也能看出一条清晰分野:有些工具让 Agent 更容易运营,有些模型则让特定工作负载更容易跑起来。Phonon、Gemini Flash 3.7、DeepSeek-V4-Flash-Vision-Exp 和 DGX Spark 适配图都在说明,与其讲一个通用“最佳模型”的故事,不如面向更窄、定义更清楚的工作负载(Phonon 帖子,12 个赞、1 次转发、1.0k 次浏览;rakyll 帖子,69 个赞、3 次转发、5.4k 次浏览;sudoingX 帖子,6 个赞、951 次浏览)。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| /root | @palmaierc | 支持可复用自动化、动态提示词调整和评估感知运行的本地 AI 工作空间 | 取代重复性 Agent 任务中反复手动设置提示词的流程 | 桌面端 harness 界面、按技术栈感知的提示词、评估钩子、模型选择控件 | Beta | 网站, 推文 |
| Phonon | @elliotarledge | 带有 OCR 屏幕上下文的模型本地语音输入 | 提供私密、低延迟的输入层,替代云端听写 | macOS 应用、Parakeet ASR、Gemma 纠错、OCR 上下文 | Shipped | 网站, 仓库, 推文 |
| PandaProbe | @DanKornas | 面向轨迹、评估、监控和调试的 Agent 工程平台 | 让 Agent 的失败可检查,而不是不透明的黑箱 | FastAPI, Next.js, PostgreSQL, Redis, Celery, LiteLLM | Beta | 网站, 仓库, 推文 |
| SkillNet | @DanKornas | 面向 Agent 的可搜索、可安装、可评估技能包 | 避免团队一遍遍从零重建相同的 Agent 能力 | Python SDK, CLI, 技能封装, 搜索与评估层 | Alpha | 推文 |
| CoArena | @coastyai | 面向真实用户任务、由人类盲评的计算机使用 Agent 竞技场 | 暴露基准测试饱和问题,比静态测试集更少掩盖失败 | 相同沙盒、前沿 Agent、对局记录、人工评判 | Beta | 推文 |
@palmaierc 把 /root 定位为一个服务于重复性自动化任务的 harness,而不是通用聊天机器人外壳(帖子,28 个赞、16 次转发、884 次浏览)。这一点值得注意,因为它的产品定位明确强调:提示词和评估逻辑应根据仓库或任务适配,而不是让用户反复手动重做设置。
@DanKornas 把 PandaProbe 和 SkillNet 作为同一运维问题的两种不同答案推出:当失败像黑箱一样不可见、技能又被困在单个提示词里时,Agent 很难改进(PandaProbe 帖子,6 个赞、1 次转发、800 次浏览;SkillNet 帖子,5 个赞、2 次转发、764 次浏览)。PandaProbe 把执行过程变成可追踪的证据;SkillNet 则把有用行为变成可复用的软件包。


共同的构建模式已经很清晰:开发者不只是在发布新模型,也在构建 Agent 周边的“操作系统”。就连 Phonon 也符合这一模式。它是一个边界清楚、技术栈明确并带有隐私承诺的窄接口层,而不是泛泛声称自己是“AI 助手”;CoArena 则在测试侧体现了同样的冲动:把真实任务评估产品化,而不是再做一个静态排行榜。
6. 新鲜且值得关注的动态
CoArena 让前沿模型的失败率公开可见
CoArena 是这批数据里最明确的新发布之一,因为它带来了实时排行榜、人工评判工作流,以及来自真实任务、并不体面的基线数据,而不是精修过的演示片段。真正重要的与其说是发布本身,不如说是它的 framing:@coastyai 正试图在产品层把基准饱和与隐藏失败显性化(帖子,44 个赞、5 次转发、3.3k 次浏览)。
DeepSeek 以视觉导向版本扩展其快速产品线
DeepSeek-V4-Flash-Vision-Exp 之所以突出,是因为这条推文背后有一份官方更新日志,提供了具体的多模态 Agent 基准。@RoundtableSpace 强调了对比表,而 DeepSeek 自己的更新则把该版本定位为:文本能力接近 V4 Flash,同时提升视觉 Agent 任务表现(帖子,21 个赞、19.4k 次浏览)。

Phonon 把本地语音接入模型做成了一个具体产品
Phonon 之所以值得关注,并不是因为“本地语音输入”这个想法新,而是因为它公开的实现细节足够多,足以建立信任:开源仓库、明确点名的 ASR 与纠错模型、清晰的设备端隐私承诺,以及直接映射到日常使用的窄工作流。这让 @elliotarledge 的发布,成为今天信息流里更可信的本地优先产品信号之一(帖子,12 个赞、1 次转发、1.0k 次浏览;仓库)。
7. 机会在哪里
**+++] Agent 可靠性与评估基础设施** — 当天最强机会。CoArena、TRACES、BATS、PandaProbe,以及 ChainfireXDA 评测失败事件,都指向同一个缺口:团队需要更好的方法,在 agent 行为进入生产环境之前,基于真实任务对其进行测试、追踪、评分和调试([CoArena 帖子,44 个赞、5 次转发、3.3k 次浏览;TRACES 帖子,105 个赞、1 次转发、2.9k 次浏览;PandaProbe 帖子,6 个赞、1 次转发、800 次浏览)。
**+++] Physical-AI 数据优化与纠错工具** — Axis、GEN-1.5 和 Buehler 工作流都表明,关键杠杆点不只是原始机器人数据量本身,而是用于收集更高质量交互、筛选纠正内容,并将少量演示转化为有效训练信号的系统([BossMon_02 帖子,134 个赞、393 次浏览;starlitmatcha 帖子,105 个赞、17 次转发、4.8k 次浏览;ProfBuehlerMIT 帖子,17 个赞、4 次转发、502 次浏览)。
**++] 本地优先的 agent 界面与部署指南** — Phonon、DGX Spark 适配图表,以及 Gemini Flash 3.7 原型开发轶事,都指向一个现实机会:打造将合适的本地工作流与合适的模型和硬件边界相匹配的产品,而不是把本地 AI 当作一种模糊的身份标签来售卖([Phonon 帖子,12 个赞、1 次转发、1.0k 次浏览;sudoingX 帖子,6 个赞、951 次浏览;rakyll 帖子,69 个赞、3 次转发、5.4k 次浏览)。
**+] 受监管领域的垂直化 harness** — Wall Street 帖子和 banking 基准测试都表明,对于那些工作流、证据链和失败成本都高度专业化的领域,通用 copilot 并不足够。虽然这一信号弱于上述基础设施主题,但足够具体([FundamentEdge 帖子,70 个赞、3 次转发、1.32 万次浏览;XFreeze 帖子,56 个赞、12 次转发、3.9k 次浏览)。
8. 要点
- 模型周围的操作系统,今天比模型本身更重要。 上下文压缩、可复用技能、轨迹和自动化,是高互动与低互动帖子中反复出现的最强模式。(sairahul1 帖子,115 个赞、10 次转发、2.52 万次浏览;PandaProbe 帖子,6 个赞、1 次转发、800 次浏览)
- 关于基准测试的讨论正变得更现实,也更不留情面。 CoArena 有三分之一的任务在出分前失败,而 τ³-Banking 的第一名也只有 51%,这让可靠性缺口变得难以忽视。(CoArena 帖子,44 个赞、5 次转发、3.3k 次浏览;XFreeze 帖子,56 个赞、12 次转发、3.9k 次浏览)
- Physical AI 相关帖子最终都落在“精炼数据”,而不是“把数据集做得越大越好”。 Axis 和 GEN-1.5 都在强调:短小但有用的演示,以及经过验证的纠正,可能胜过蛮力式收集。(BossMon_02 帖子,134 个赞、393 次浏览;starlitmatcha 帖子,105 个赞、17 次转发、4.8k 次浏览)
- 当本地 AI 绑定到具体界面或具体机器时,表现最有说服力。 Phonon 展示了一条可信的设备端语音工作流,而 DGX Spark 适配图则把本地部署变成了具体的硬件规划问题。(Phonon 帖子,12 个赞、1 次转发、1.0k 次浏览;sudoingX 帖子,6 个赞、951 次浏览)
- 垂直领域系统仍然是一个明显机会。 金融方向的帖子主张采用面向领域调优的 harness 和评估集,而不是通用副驾驶;银行基准中并不理想的分数也支撑了这一判断。(FundamentEdge 帖子,70 个赞、3 次转发、1.32 万次浏览;XFreeze 帖子,56 个赞、12 次转发、3.9k 次浏览)