Twitter AI - 2026-08-24
1. 人们在讨论什么
1.1 评估已从基准分数转向生产级验证闭环(🡕)
数据集中最密集的主题是评估,但已不再是过去那种“哪个模型赢了?”的讨论。最受关注的内容集中在:如何在生产环境中保持评审器校准、如何在完全相同的设置下对智能体做基准测试,以及如何防止受污染或过于粗糙的测试掩盖运营层面的失败。
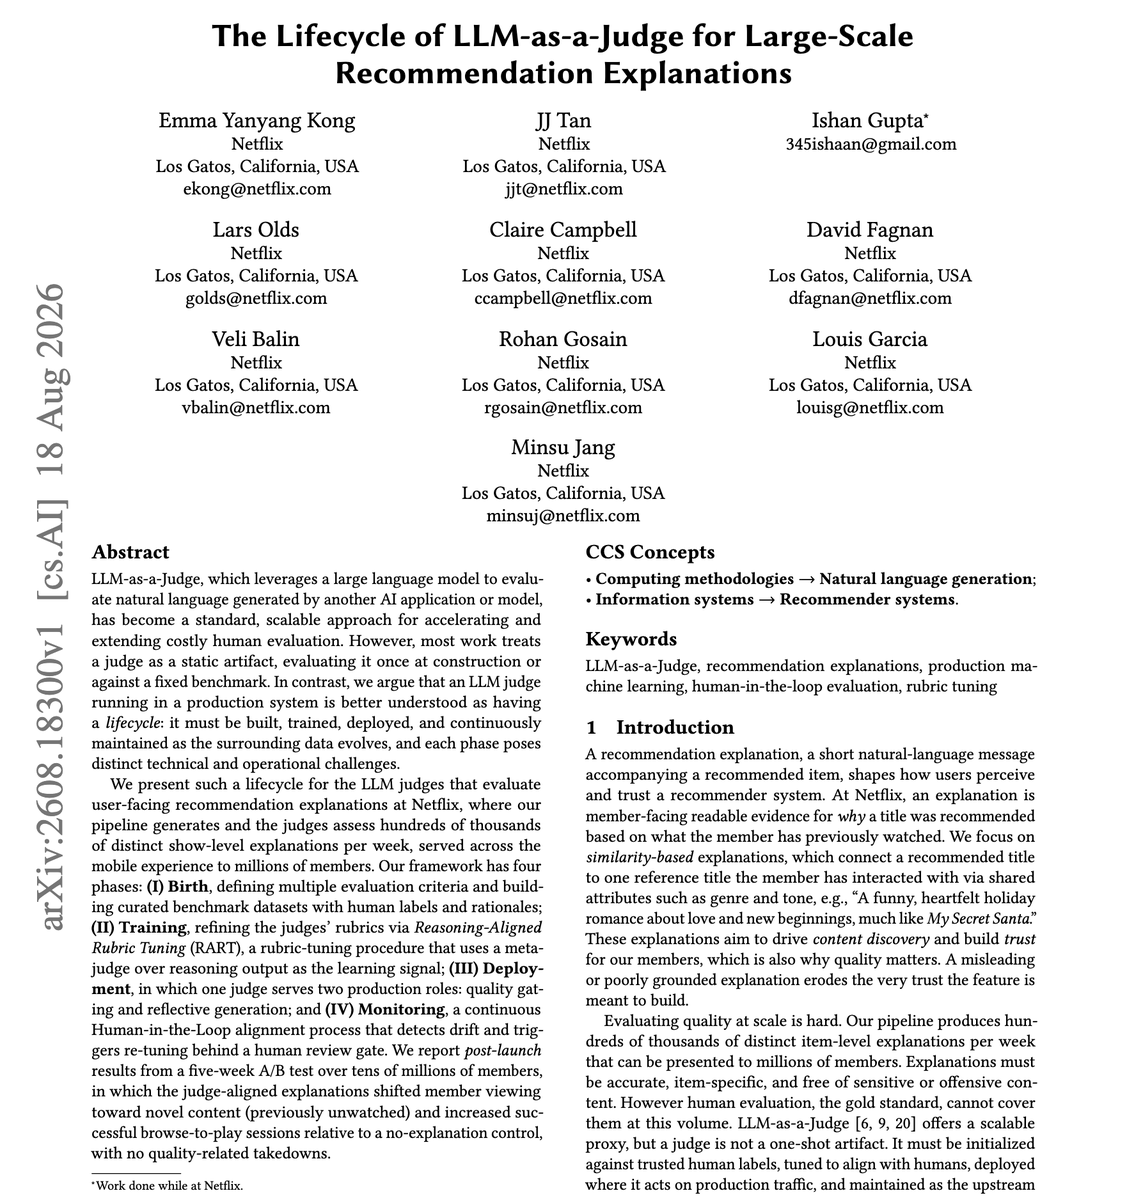
@omarsar0 强调(37 个赞、2 条回复、2,786 次浏览、56 次收藏)提到 Netflix 关于全生命周期管理 LLM 评审器的论文。公开的 论文 和这条推文都表示,Netflix 的评审器每周会评估数十万条推荐理由说明,把评估视为一个四阶段生命周期,而不是一次性的基准测试;在覆盖数千万会员、持续五周的 A/B 测试中,浏览到播放的转化行为有所改善,且没有因质量问题而下线。
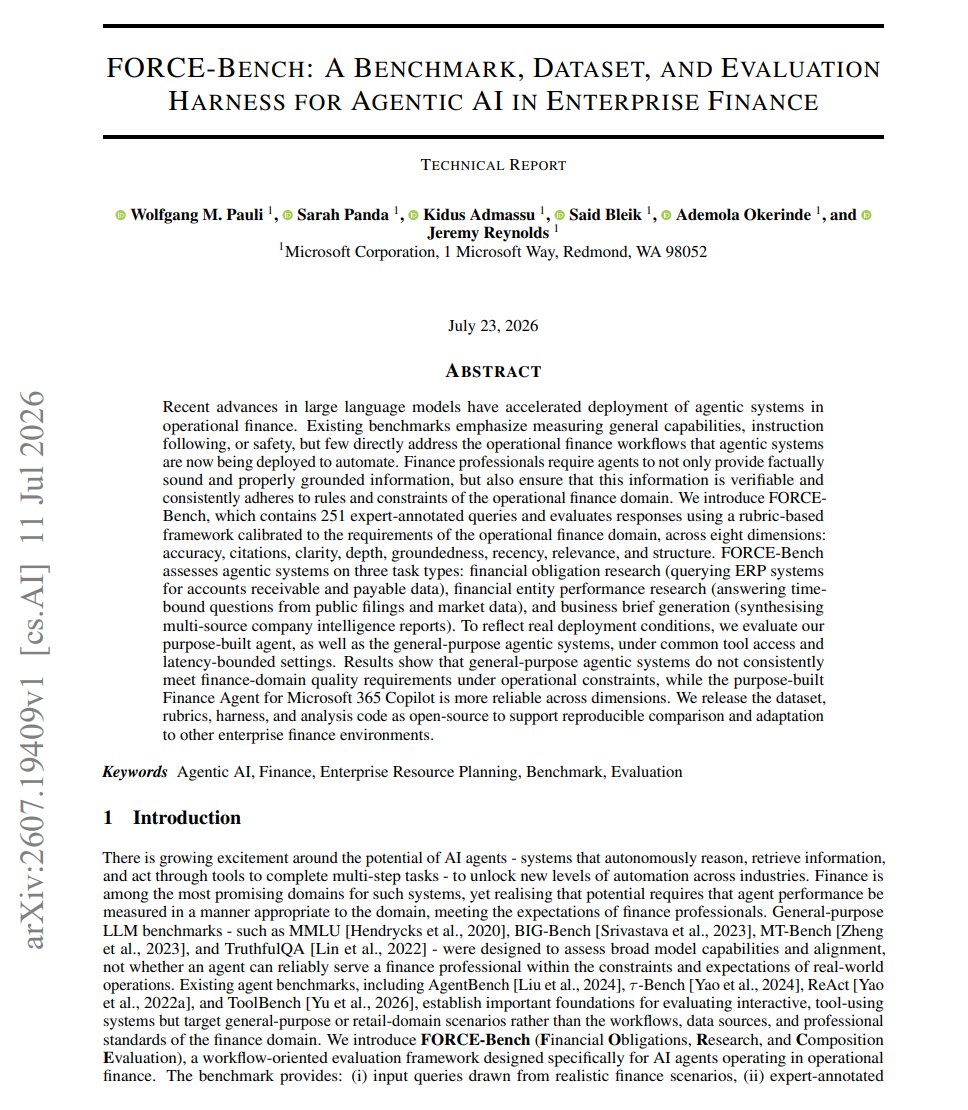
@marfinxx 认为(20 个赞、3 条回复、734 次浏览、15 次收藏)说明,Microsoft 的 FORCE-Bench 展示了为何企业智能体需要领域专用测试框架,而不是通用聊天式评分。公开的 FORCE-Bench 论文 和附带摘要称,该基准使用了 251 条由专家标注的金融查询,从八个维度评分;结果发现,在工具和延迟受限的条件下,专门打造的 Microsoft 365 Copilot Finance 比通用智能体更可靠。
@DataChaz 将其定义为(27 个赞、6 条回复、16,084 次浏览、12 次收藏、2 次引用)则从工具层面指出了同一个信任问题:如果每个智能体基准都运行在自定义浏览器、自定义工具和自定义测试框架上,最终比较只能落到“视情况而定”。被引用的发布帖和公开的 AgentSky 网站 描述了一个可面向多个云端智能体的统一 API、持久化会话,以及在同一任务、同一浏览器和同一工具上并排运行。
@Blue_Beba_ 运行了(20 个赞、10 条回复、148 次浏览、11 次收藏、7 次引用)提到“Phantom API Test”——一个围绕不存在的 React hook 构建的小巧但很直观的幻觉探针。附图比线程本身更能说明问题:GPT-4o 在 20 次运行中全部拒绝了这个虚构 API,而对比中的较新模型有 10% 到 90% 的概率编造答案。

@Al_Grigor 补充了(36 个赞、4 条回复、1,386 次浏览、33 次收藏)指出,在 4,894 份 AI 工程岗位描述中,“评估”如今已是最常出现的主题;而 @1jehuang 推出了(9 个赞、4 条回复、1,391 次浏览)则提到 Jcode Bench,这是一个围绕可运行参考实现、穷举式验证和确定性指令计数评分构建的编程基准,而不是依赖静态答案键。
讨论洞察: 最尖锐的分歧不在于评估是否重要,而在于当实验室和开发者都已经见过这些任务后,什么样的评估仍然值得信任。对这些帖子的回复持续偏向穷举式验证器、同设置比较和受领域约束的测试框架,而不是面向公众排行榜的表演。
与前一日比较: 在 2026-08-23,关于验证的讨论仍集中在重复搜索、产物检查和长周期回归测试。到了 2026-08-24,话题进一步贴近部署:全生命周期管理的评审器、ERP 路由式测试框架、同设置智能体竞技场,以及旨在抵御污染的基准设计。
1.2 物理 AI 的讨论收窄到纠正质量与回放保真度(🡕)
物理 AI 相关帖子依然聚焦数据,但今天的讨论更具体地落在:数据采集之后,怎样的数据集才值得信任。保留下来的 AXIS 相关讨论并不只是要求更多远程操作数据量,而是反复追问:哪些人工纠正能通过验证,以及一条轨迹能否在浏览器采集、回放、训练和评估的整个流程中保持有效。
@yapslingerx 认为(66 个赞、59 条回复、1,197 次浏览)指出,机器人领域仍有一个语言模型从未遇到过的瓶颈:一名受训操作员一次只能占用一台机器人。他在帖子中将 AXIS 描述为一系列逐步拆解这一瓶颈的尝试——浏览器远程操作、公开任务生成,以及一种训练后闭环:先让策略失败,再由人类只纠正失败发生的瞬间。
@Olamicryptt 展示了(41 个赞、19 条回复、438 次浏览、1 次引用)解释了为什么最后一步很关键。帖子称,AXIS 将 660 个纠正候选筛到只剩 161 个经验证的片段,在不同随机种子下把成功率从 41.3% 提高到最高 52.5%;同时还发现,用完整人工轨迹训练的效果不如用筛选后的纠正数据训练。公开的 AXIS 网站 与这一底层逻辑一致:前端在浏览器中采集,后端再做成功检查、质量筛选、平滑、增强和固定协议评估。

@juraucrypt 补充了(22 个赞、17 条回复、261 次浏览)讨论的是回放保真度这一层。他的观点是:一条人工轨迹如果在浏览器里有效,但在由策略或物理运行时回放时行为发生变化,那它就不只是噪声,而会污染后续评估和训练。相比前一天更宽泛地呼吁增加机器人数据,这是一种更偏运营层面的抱怨。
讨论洞察: 这些帖子下的回复罕见地高度一致:更多数据本身并不是突破。反复得到认同的观点是,有用的人类纠正必须先经过筛选,提炼成信号,而不是盲目追加进语料。
与前一日比较: 在 2026-08-23,物理 AI 的讨论主要还围绕浏览器规模化采集,以及一个拥有 50K+ 轨迹的引擎是否存在。到了 2026-08-24,重点进一步深入到纠正选择、回放对齐,以及同一份示范能否经受完整训练闭环。
1.3 智能体经济学开始被量化为 token 曲线、价格表和吞吐图(🡕)
今天,AI 的商业面讨论明显更偏运营。不再是抽象地争论“AI 需求”,保留下来的内容不断量化智能体负载对 token 规模、硬件预算和价格竞争的影响。
@SciTechera 报告称(6 个赞、2 条回复、183 次浏览、2 次收藏)指出,OpenRouter 的智能体使用量七日均值,从 2 月初约 0.51 万亿 token 增长到了 8 月 10 日的 7.3 万亿。附图显示,智能体流量在 2 月 6 日超过人类流量,之后又增长了约 14 倍;公开的 OpenRouter 排行页 还补充了一个关键限定:这些数据衡量的是经 OpenRouter 路由的流量,而不是整个市场。

@P_Bonnet 将其定义为(64 个赞、9 条回复、24,329 次浏览、129 次收藏、6 次引用)则在定价层面描述了同一趋势,把 AI token 比作铝:先是昂贵材料,随后价格暴跌 99.9%,接着市场规模大幅扩张。这个比喻之所以重要,是因为回复立刻把它转译成了应用层后果,其中一位读者认为,即便 2026 到 2030 年价格下降 90%,也可能仍低估了接下来会发生的事。
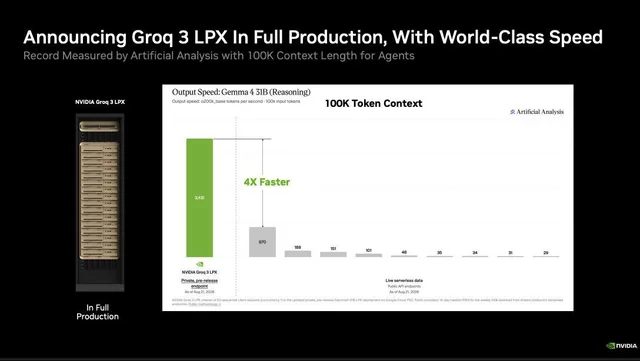
@ionet 警告称(29 个赞、3 条回复、4,039 次浏览、1 次引用)指出,即使模型访问变便宜,AI 服务器涨价仍可能掐住初创公司的生存空间;而 @StockSavvyShay 强调(30 个赞、23 条回复、4,089 次浏览、1 次收藏)则展示了另一种杠杆:Groq 3 LPX 在 100K 上下文下的输出速度约为每秒 3,431 个 token,而他分享的幻灯片里第二名大约只有 870 个。
@jiahanjimliu 发布了(4 个赞、779 次浏览、2 次收藏)并排展示了 Terra、Sol 和 Kimi 的价格表,借此说明模型价格战已经在压缩。附带截图之一显示,GPT-5.6 Terra 的短上下文输入价格为每百万 token 2 美元、输出为 12 美元,而 Sol 还提供更低价的 batch 和 flex 版本。

讨论洞察: 最有价值的回复模式并不是“最聪明的模型会赢”。无论是在智能体基准帖还是 token 经济学帖子下,读者都反复回到同一个想法:一旦更便宜的模型在更长工作流中已经“足够好”,单任务经济性和吞吐量就会开始压过品牌层级的智能水平。
与前一日比较: 在 2026-08-23,竞争叙事主要还围绕谁资助开放权重、谁控制技术栈。到了 2026-08-24,这种竞争被重新表达为单位经济学:token 价格、每秒 token 数,以及智能体闭环能否扛住基础设施账单。
1.4 智能体产品正在从聊天上移到持久化环境与适配规划器(🡕)
另一个明显模式是,开发者在努力让智能体的存在超出单个提示窗口。这里保留下来的内容,与其说关心某个单一更强的模型,不如说更关注那些能保留上下文、选择合适运行时或保持工具连接稳定的工作区、协议和适配检查器。
@Suryanshti777 认为(46 个赞、14 条回复、1,269 次浏览、8 次收藏)指出,Offloop 真正的优势不只是基准成绩,而在于智能体存在于共享频道中,能承接之前的决策,并把工作交给下一个负责人,而不是逼着每位团队成员都从一条空白提示重新开始。公开的 Offloop 网站 也用类似的话描述了这款产品:小团队使用 AI 智能体来处理发布、跟进、研究、增长和运营等周期性工作。
@dr_cintas 指出(1 个赞、330 次浏览、3 次收藏)提到 canIrun.ai,这是一款浏览器侧的本地 AI 适配检查器,会在用户下载任何内容前先判断哪些开放模型适合在给定机器上运行。公开的 解读 对其工作方式给出了难得具体的说明:通过 WebGL 和 WebGPU 检测硬件、给出考虑量化的 VRAM 估算、基于带宽估算每秒 token 数,并在客户端完成评分,而不是给出不透明的兼容性说法。
@gemchange_ltd 补充了(9 个赞、1,284 次浏览、7 次收藏)则提供了一次很有用的硬件适配现实校验:用一张表把内存、带宽、价格和结论放在同一视图里,并认为仅看 TOPS 是购买本地推理硬件时错误的指标。

@LomashKumar52 写道(11 个赞、775 次浏览、10 次收藏)指出,常见的“MCP 是 AI 领域的 USB-C”这种说法掩盖了实际的运营权衡,包括运行时发现、有状态会话和安全故障模式;而 @zoolsher 宣布(29 个赞、4 条回复、1,199 次浏览、6 次收藏、4 次引用)则提到 RomeAI Lab 开源的 Rome,它将自己定义为一个围绕工具、工作流、记忆和持久化应用构建的 agentic OS,而不是依赖隐藏的测试框架状态。
讨论洞察: 这些项目共享的设计直觉是“持久化”。人们在设法保留智能体周围的环境——频道历史、硬件适配、工具状态、工作流记忆——因为社区越来越把“从零重来”视为智能体产品的默认失败模式。
与前一日比较: 在 2026-08-23,本地 AI 的讨论仍主要被稀疏化技巧、KV-cache 增长和原始硬件适配主导。到了 2026-08-24,讨论上移了一层,进入环境本身:频道、协议、持久化会话,以及下载前适配规划器。
2. 什么让人感到沮丧
在真实工作下仍会失效的评估表面
严重程度:高。最强烈的不满并不是模型缺少基准,而是太多基准仍在掩盖生产环境里真正重要的失败模式。@marfinxx 认为(20 个赞、3 条回复、734 次浏览、15 次收藏)指出,FORCE-Bench 之所以存在,是因为通用智能体在工具和延迟受限时,无法可靠满足金融领域约束;@Blue_Beba_ 运行了(20 个赞、10 条回复、148 次浏览、11 次收藏、7 次引用)则是一个虚假 API 探针,显示若干较新模型仍会自信地编造技术答案。@DataChaz 表示(27 个赞、6 条回复、16,084 次浏览、12 次收藏、2 次引用)指出,自定义测试框架使智能体比较变得滑不留手;@1jehuang 将其定位为(9 个赞、4 条回复、1,391 次浏览)则把 Jcode Bench 作为对基准污染和粗粒度评分的回应。人们的应对方式是:构建领域测试框架、同条件竞技场、穷举式验证器,并直接招聘具备 eval 能力的人。这是值得直接投入建设的方向。
采集之后反而更难信任的物理 AI 数据
严重程度:高。机器人相关讨论反复回到同一个抱怨:采集示范只是第一步;更难的是证明这些数据在回放、筛选和再训练之后仍然有效。@yapslingerx 认为(66 个赞、59 条回复、1,197 次浏览)指出,物理在场仍是最原始的数据瓶颈;@Olamicryptt 展示了(41 个赞、19 条回复、438 次浏览、1 次引用)指出,660 条人工纠正里只有 161 条通过验证;@juraucrypt 警告称(22 个赞、17 条回复、261 次浏览)指出,浏览器采集与回放必须保持一致,否则后续训练数据就很难再信任。公开的 AXIS 网站 展示了社区当前的答案:浏览器采集,然后在后端做验证、平滑、增强和留出评估。这是值得直接投入建设的方向。
仍然很容易判断失误的算力预算与本地模型适配
严重程度:高。关于单位经济学的帖子清楚表明,模型价格更低并不意味着规划痛苦消失。@ionet 警告称(29 个赞、3 条回复、4,039 次浏览、1 次引用)指出,如果基础设施已经占据主要支出,服务器价格上涨 15% 就可能终结初创公司的 runway;@gemchange_ltd 认为(9 个赞、1,284 次浏览、7 次收藏)指出,决定一台本地设备是否真的适配的,是内存带宽和 VRAM,而不是 TOPS。@dr_cintas 指出(1 个赞、330 次浏览、3 次收藏)提到 canIrun.ai,正是因为人们仍在凭猜测下载错误模型,最终撞上内存不足错误。现实中的应对模式很务实:先用浏览器侧适配检查,按价格和吞吐量比较服务商,并在可能时把长工作流路由到更便宜的模式。这是值得直接投入建设的方向。
如何在不过度暴露私有上下文的前提下验证自主智能体
严重程度:中。最明显但尚未解决的设计张力之一,是智能体问责是否必须暴露原始提示。@Mmenyene_C 认为(60 个赞、59 条回复、219 次浏览)指出,自主系统需要的是可追溯记录、明确的策略边界和可观察结果,而不是暴露每一条私有输入;@LomashKumar52 警告称(11 个赞、775 次浏览、10 次收藏)则指出,像 MCP 这样的协议选择同样带有安全和数据处理后果,而宣传式线程往往略过这些问题。Thomson Reuters 的 发布说明 也从另一方向体现了同样的信任本能,明确表示客户数据绝不会用于训练 Thomson。这是值得直接投入建设的方向。
3. 人们希望有什么产品
难以污染、易于比较的基准
这是数据集中最明确的实际需求。@DataChaz 表示(27 个赞、6 条回复、16,084 次浏览、12 次收藏、2 次引用)指出,一旦每个团队都换了浏览器、工具和测试框架,智能体比较就会失效;@1jehuang 构建了(9 个赞、4 条回复、1,391 次浏览)提到围绕穷举式验证和确定性成本构建的 Jcode Bench。@marfinxx 使用了(20 个赞、3 条回复、734 次浏览、15 次收藏)则在企业金融场景下通过 FORCE-Bench 表达了同一个意思:真实工作流需要真实测试框架。人们要的不是又一个综合排行榜,而是那种即便实验室已经见过题目,仍然清晰可读,并且能在同一条件下比较同一系统的基准。机会:直接。
兼顾隐私与可验证性的智能体审计轨迹
这里的需求,是在不无差别暴露日志的前提下建立信任。@Mmenyene_C 认为(60 个赞、59 条回复、219 次浏览)指出,自主智能体应暴露策略边界、可追溯记录和可观察结果,而不是每一条私有输入;Thomson Reuters 的 发布说明 则表示,Thomson 的部署有一项明确约束:客户数据绝不会用于训练。缺失的产品,是隐私与问责之间一个可信的中间层。

这里的情绪并不是反隐私,而是反不透明:读者一再更偏好有限的安全信号、持久记录和可审查结果,而不是要么完整转储对话记录,要么盲目信任。机会:直接。
本地 AI 适配规划器与成本路由器
这个需求既有技术层面,也有财务层面。@dr_cintas 指出(1 个赞、330 次浏览、3 次收藏)提到 canIrun.ai,因为人们仍需要在浪费时间下载模型之前,先知道自己的机器到底能跑什么;@gemchange_ltd 认为(9 个赞、1,284 次浏览、7 次收藏)指出,带宽和 VRAM 比营销话术里的 TOPS 更重要;@jiahanjimliu 展示了(4 个赞、779 次浏览、2 次收藏)则指出,即便是前沿模型定价,如今也已经分裂为 standard、batch 和 flex 等模式。人们想要的是一个规划器,能针对具体任务选择合适的模型、量化方式、服务商和计费模式,而不是逼他们用踩坑的方式学会理解市场。机会:竞争激烈。
能记住团队上下文的持久化智能体工作区
这个需求更多是通过对产品的赞赏表达出来,而不是明确的“希望有某样东西”,但缺口很清楚。@Suryanshti777 认为(46 个赞、14 条回复、1,269 次浏览、8 次收藏)指出,Offloop 重要之处在于输出不再死在聊天窗口里;@zoolsher 宣布(29 个赞、4 条回复、1,199 次浏览、6 次收藏、4 次引用)则提到 Rome,作为一个面向持久化工具、记忆和工作流的开源环境。缺失的产品,是一个共享工作区:智能体状态在交接后仍能留存,周期性工作有自己的“家”,下一位同事不必从零开始。机会:竞争激烈。
面向物理 AI 的运动数据反馈闭环
物理 AI 相关讨论实际上是在呼唤一种发布后还能持续改进的数据引擎。@yapslingerx 认为(66 个赞、59 条回复、1,197 次浏览)指出,机器人数据仍依赖稀缺的人体劳动力;@Olamicryptt 展示了(41 个赞、19 条回复、438 次浏览、1 次引用)指出,只有经过筛选的一小部分纠正才能转化成有用信号;@juraucrypt 补充了(22 个赞、17 条回复、261 次浏览)则指出,回放对齐决定了这些纠正能否继续保持可信。公开的 AXIS 网站 展示了这种闭环的一个可行版本,但需求反复出现,说明在更广泛的采集、溯源、筛选和回放验证层面仍有空间。机会:直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| LLM-as-a-Judge 生命周期 | 评估框架 | (+) | 将评审器视为构建/训练/部署/监控系统,并把评估与可量化的产品结果绑定 | 需要整理好的标签、持续再调优和人工监控 |
| FORCE-Bench | 领域基准 / 测试框架 | (+) | 251 条专家金融查询、八维评分标准,以及真实的工具和延迟约束 | 仅适用于金融领域,也进一步暴露出通用智能体在运营约束下的脆弱性 |
| AgentSky | 智能体 API / 对比竞技场 | (+/-) | 在相同任务、浏览器和工具下比较,并支持持久化云会话 | 平台由供应商运营;公开宣称仍依赖开发者自有平台运行结果 |
| Jcode Bench | 编程基准 | (+) | 穷举式验证器、确定性指令计数评分、持续改进曲线 | 任务族较窄,更聚焦底层原语,而不是广义软件工作 |
| AXIS | 物理 AI 数据引擎 | (+) | 将浏览器远程操作、验证、筛选、增强和留出评估整合为一个闭环 | 仍较早期,且高度依赖回放保真度和后端清洗 |
| OpenRouter 排行 | 使用可视化 | (+/-) | 揭示真实的路由 token 规模趋势和模型采用窗口 | 只衡量 OpenRouter 流量,不代表整个市场,也不衡量模型质量 |
| Offloop | 智能体工作区 | (+) | 用持久化频道承载团队周期性工作,而不是一次性聊天输出 | 基准和成本相关说法来自厂商自身,未经独立审计 |
| canIrun.ai | 本地 AI 规划器 | (+) | 客户端硬件检测、考虑量化的适配评分、无需服务器的本地评分 | 估算可能与真实世界的散热、驱动和运行时条件存在偏差 |
| MCP | 智能体协议 | (+/-) | 为工具、数据源和有状态工作流提供标准化连接 | 在真实部署中,安全与实现陷阱仍然重要 |
| Rome | Agentic 环境 | (+) | 持久化应用、工作流、记忆和基于 Docker 的分发方式 | 仍处于预览阶段,环境占用比聊天工具更重 |
| GLiNER2.5 | 抽取模型 | (+) | 小型开放模型,支持长上下文抽取、边界预测和 Apache 2.0 许可 | 更偏抽取/分类,非通用智能体工作 |
| Thomson | 领域模型 | (+) | 专有法律数据与专家调优,以更低构建成本带来强劲基准竞争力 | 初始部署范围较窄,模型仍是专有的 |
| SenseNova-Vision | 多模态视觉模型 | (+) | 单一统一模型覆盖 OCR、检测、分割、深度和点图任务 | 研究系统要求较重,不如小型视觉技术栈即插即用 |
今天人们最信任的工具,是那些把约束摆出来、而不是制造“魔法感”的工具。@marfinxx 使用了(20 个赞、3 条回复、734 次浏览、15 次收藏)用 FORCE-Bench 展示通用智能体在金融约束下如何失效;@1jehuang 发布了(9 个赞、4 条回复、1,391 次浏览)提到一个采用穷举式验证、而非秘密答案键的基准;@dr_cintas 指出(1 个赞、330 次浏览、3 次收藏)则指向一个会解释自己如何打分的适配检查器;公开的 AXIS 网站 也坦率描述了数据引擎的每个阶段。
现实中的应对方式是“分层”。团队会把通用模型和领域测试框架搭配使用;在承诺使用某个智能体前,先把多个智能体并排比较;在延迟允许时,把任务路由到更便宜的 batch 或 flex 模式;在本地下载前先做浏览器侧适配检查;并把周期性工作迁移到持久化频道或应用环境中(@DataChaz 表示(27 个赞、6 条回复、16,084 次浏览、12 次收藏、2 次引用);@jiahanjimliu 发布了(4 个赞、779 次浏览、2 次收藏);@Suryanshti777 认为(46 个赞、14 条回复、1,269 次浏览、8 次收藏))。
几乎所有主题簇都显示出同一个迁移方向:从单模型英雄主义转向路由、评估、记忆、溯源和部署适配。也因此,在同一天的信息流里,基准测试框架、工作区层、价格路由器和可扩展数据引擎会和模型发布并列出现。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Offloop | Offloop 团队 | 面向团队周期性工作的频道式 AI 智能体工作区 | 防止多步骤团队工作退化为一次性聊天会话 | 持久化频道、周期性工作智能体、团队工作流编排 | Beta | 网站 |
| AgentSky | AgentSky 团队 | 面向多个云端编程 / 浏览器智能体的统一 API 和演练场 | 让智能体托管和并排比较在同一任务和工具下保持一致 | 云端智能体、持久化会话、频道连接器、统一 API | Beta | 网站 |
| Jcode Bench | @1jehuang | 带穷举式验证和确定性成本评分的公开编程基准 | 用可审计、持续性的测量替代容易受污染的编程排行榜 | 公开 GitHub 测试框架、穷举式验证器、Callgrind 指令计数 | 已发布 | 网站, 仓库 |
| AXIS | Axis Robotics | 面向机器人策略训练的浏览器远程操作数据引擎和基准 | 无需本地模拟器搭建,即可扩展机器人数据采集和质量优化 | MuJoCo-WASM 浏览器控制、后端验证、增强、留出评估 | Alpha | 网站 |
| canIrun.ai | midudev | 基于浏览器的本地 AI 模型硬件兼容性检查器 | 在下载前告诉用户哪些开放模型及量化版本适合其机器 | WebGL/WebGPU 检测、客户端评分、考虑量化的 VRAM 估算器 | 已发布 | 网站, 仓库 |
| Rome | Rome AI Lab | 面向持久化应用、工作流和记忆的开源 agentic OS | 给周期性智能体工作提供持久环境,而不是短暂的聊天线程 | Docker 分发、应用运行时、应用 Web SDK、持久化能力 | Beta | 仓库, 网站 |
| GLiNER2.5 | Fastino Labs | 采用边界预测架构的小型开放抽取模型 | 让长上下文实体与关系抽取更便宜、更易部署 | 74M/0.2B/0.3B checkpoints、边界预测、Hugging Face、Apache 2.0 | 已发布 | 模型 |
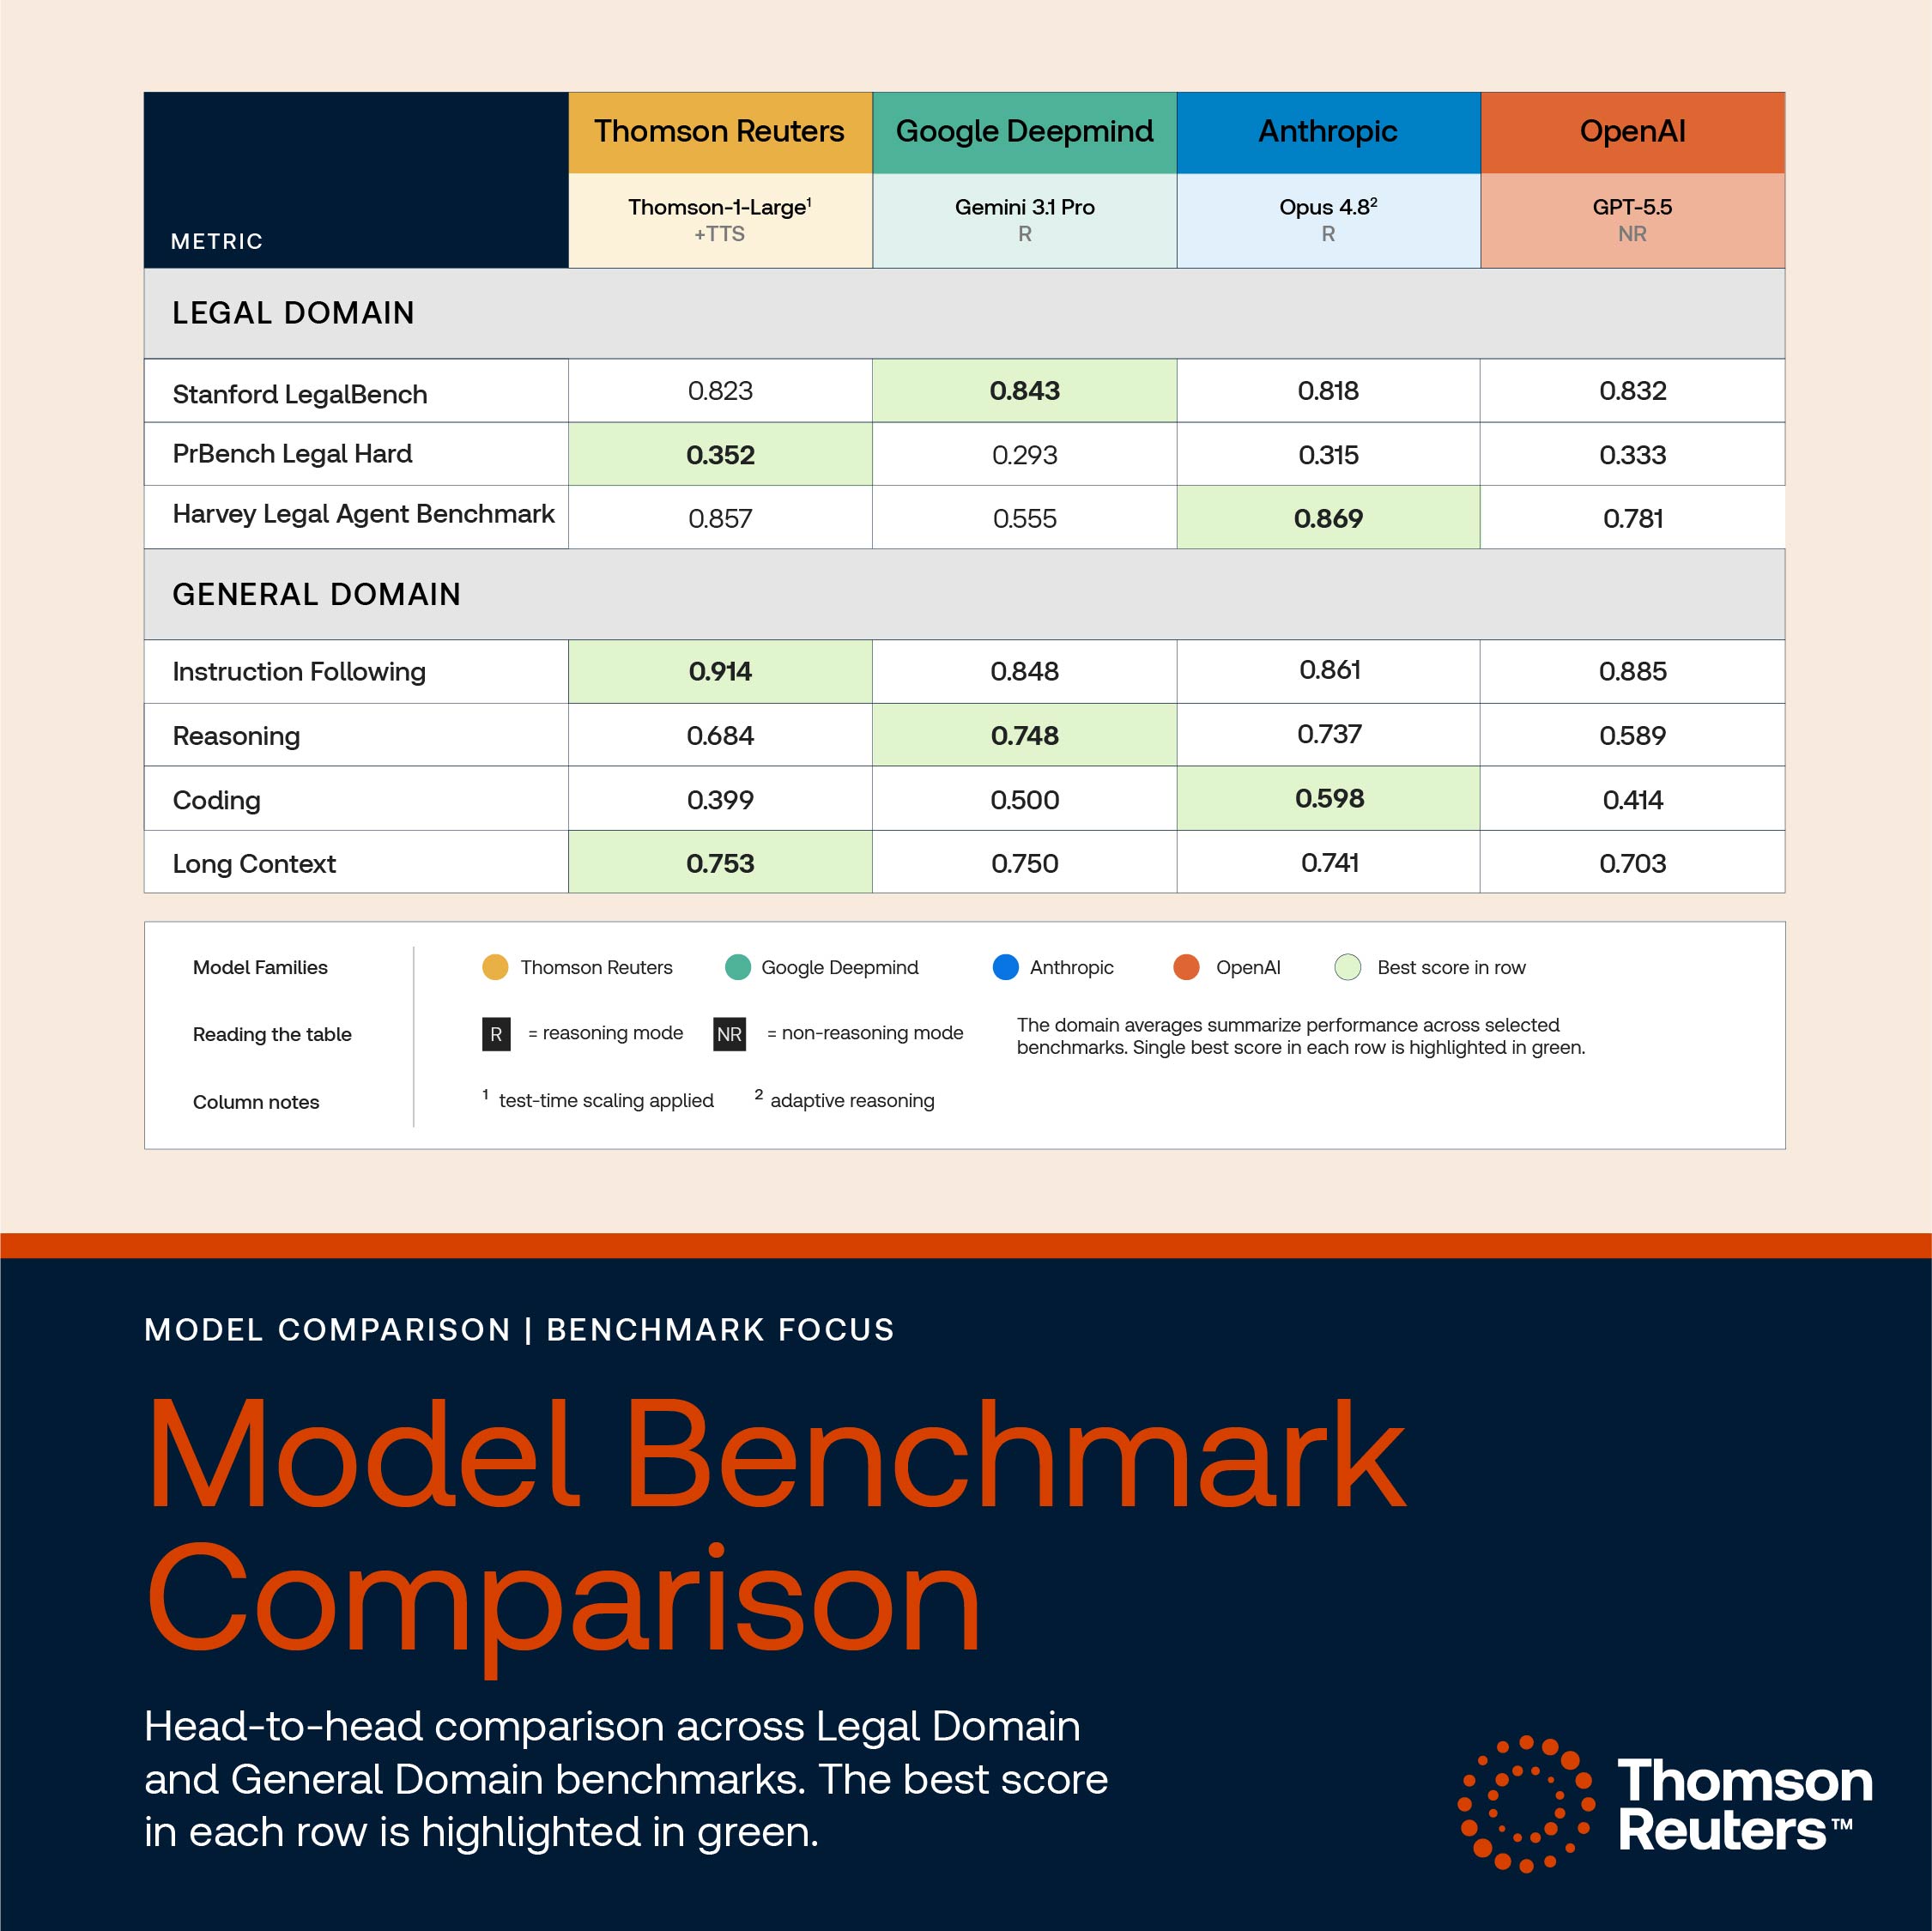
| Thomson | Thomson Reuters | 基于开放底座模型和专有法律数据构建的专有法律模型 | 让专业 AI 超越“租用通用前沿模型”的路径 | 开源底座模型、Westlaw/Practical Law/Reuters 内容、专家调优、CoCounsel 部署 | Beta | 概览, 新闻稿 |
| SenseNova-Vision | OpenSenseNova | 面向文本、图像和混合结构输出的统一多模态视觉模型 | 将彼此分离的视觉任务头折叠成一个生成式接口 | 统一多模态模型、混合文本-图像解码、7B-MoT 运行时、基准套件 | Alpha | 仓库 |
@Suryanshti777 认为(46 个赞、14 条回复、1,269 次浏览、8 次收藏)指出,Offloop 真正的产品是持久化频道记忆,而不只是较低的基准成本;而 @DataChaz 将其定义为(27 个赞、6 条回复、16,084 次浏览、12 次收藏、2 次引用)则把 AgentSky 视为基础设施层,让人们能通过一个 API 比较并托管多个智能体。合起来看,它们呈现出一个反复出现的构建模式:开发者正在把测试框架、状态和交接层外置,而不是把模型输出本身当作产品。
@1jehuang 推出了(9 个赞、4 条回复、1,391 次浏览)提到 Jcode Bench,因为他认为编程基准太容易被 benchmaxx 或刷到饱和;@dr_cintas 指出(1 个赞、330 次浏览、3 次收藏)提到 canIrun.ai,则是因为本地模型实验仍然以太多猜测为起点。这两个项目处理的是不同痛点,但本质上都属于“测量层”:一个更严格地衡量智能体编程能力,另一个衡量某个模型是否值得在用户机器上尝试。

AXIS 仍是物理 AI 簇里最强的构建项目,因为它不只是一次数据集投放。公开的 AXIS 网站 记录了一个浏览器远程操作流水线、207 个任务、50K+ 轨迹,以及一个可生长的快照模型;而 @Olamicryptt 展示了(41 个赞、19 条回复、438 次浏览、1 次引用)则指出,真正的产品优势也许不在原始示范量,而在那些经过验证的短纠正片段。
模型构建这一簇分成了三种不同策略。@fastinoAI 推出了(17 个赞、1 条回复、781 次浏览、6 次收藏、1 次引用)提到 GLiNER2.5:一个采用 Apache 许可的小型抽取模型,把方法从 span 枚举转向边界预测;@ConorBronsdon 披露了(6 个赞、2 条回复、243 次浏览、1 次收藏、1 次引用)提到 Thomson:一个面向法律领域、以更低训练成本实现接近前沿质量的模型;@rsasaki0109 分享了(51 个赞、2,287 次浏览、31 次收藏)则提到 SenseNova-Vision:一个面向密集与符号计算机视觉任务的统一多模态生成栈。
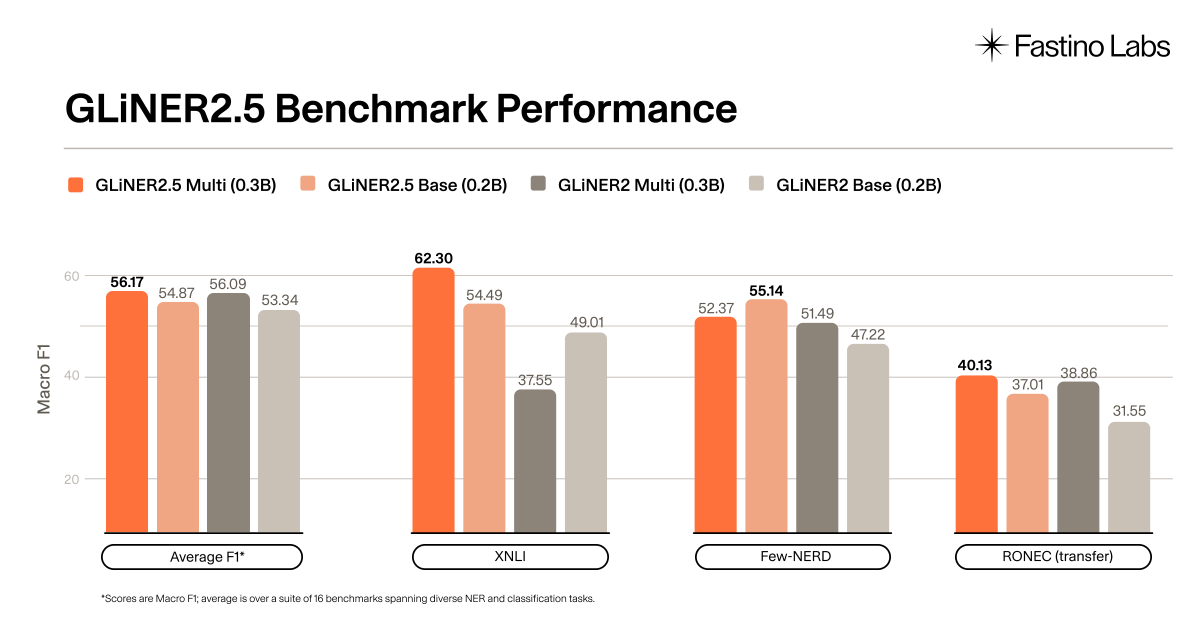

这些项目背后共同的构建者直觉,是围绕工作流边界做专业化:有些团队在模型周围的环境上做专业化,有些团队在测量层上做专业化,还有些团队则把模型本身专门针对法律、抽取或多模态视觉任务来做。这比“又发布了一个新模型”的叙事更宽,也更实用。
6. 新进展与值得关注的动态
Thomson 1 展示了领域模型凭借专有数据和专家调优能走多远
@ConorBronsdon 披露了(6 个赞、2 条回复、243 次浏览、1 次收藏、1 次引用)把 Thomson Reuters 推出 Thomson 1 视为一家有 175 年历史的信息公司在模型层做出的决策,而不是又一个应用包装层。Thomson Reuters 自己的 介绍文章 和 新闻稿 表示,该系统建立在开源底座之上,并结合了专有法律与新闻资产,总成本约为 4,000 万美元,目前已经部署到 CoCounsel Legal 的表格分析中。这使其成为当天最清晰的例子之一:一家公司选择为某个特定专业掌握模型层。
GLiNER2.5 推进了小模型抽取这一细分方向
@fastinoAI 推出了(17 个赞、1 条回复、781 次浏览、6 次收藏、1 次引用)提到 GLiNER2.5:采用边界预测架构、提供三种小参数规模、并采用 Apache 2.0 许可。公开的 模型页面 让这次发布显得格外值得注意,因为它不只是又一个 NER checkpoint:它还加入了长上下文抽取、联合关系解码、受约束分类和 span 属性,并以一个可部署的开放软件包形式提供。
Anthropic 的“内省”研究进入主流讨论,但也伴随明确限定
@itsharmanjot 放大传播了(20 个赞、4 条回复、1,267 次浏览、7 次收藏、2 次引用)提到 Anthropic 关于涌现式内省意识的研究,仿佛模型可能在察觉自身隐藏状态被篡改。公开的 arXiv 论文 Emergent Introspective Awareness in Large Language Models 则把结果限定得更具体、也更窄:研究人员向激活中注入概念向量,并在受控条件下观察到部分且不稳定的检测能力。这一区分也立刻出现在回复里,大家更把它当作一种测量信号,而不是机器自我意识的证明。
SenseNova-Vision 让当天的话题不再局限于文本智能体
@rsasaki0109 分享了(51 个赞、2,287 次浏览、31 次收藏)提到 SenseNova-Vision:一个统一的多模态生成系统,既能输出 OCR 和框等符号结果,也能输出掩码、深度、法线和点图等密集结果。公开的 GitHub 仓库 让这次发布值得注意,是因为它把计算机视觉框定为一个统一的生成接口,而不是一堆针对单项任务的头部和解码器。
主权 AI 从口号转向了结构化项目细节
有两条帖子把主权 AI 变得具体,而不只是修辞。@ArtificialAnlys 表示(15 个赞、2 条回复、2,302 次浏览、4 次收藏)提到,韩国的主权 AI 计划已从四支团队缩减为三支,评估占评分权重的 25%,每支晋级团队预计可获得约 1,000 张 B200 GPU、持续六个月;而 @DhatriKamat 描述为(419 个赞、2 条回复、34,874 次浏览、17 次收藏)则从 OEM 信任、IP 模块成本和三年营收滞后等角度讨论了印度芯片商业化的瓶颈。真正值得注意的变化不是爱国主义,而是围绕算力资助、基准治理和采购杠杆出现了更具体的运营细节。
7. 机会在哪里
[+++] Verification-bound agent workflows — The strongest repeated signal was demand for systems that prove what an agent did, not just what benchmark score it posted. Evidence came from FORCE-Bench in finance (@marfinxx 帖子(20 个赞、3 条回复、734 次浏览、15 次收藏)、Jcode Bench 难以污染的编程测试框架设计(@1jehuang 帖子(9 个赞、4 条回复、1,391 次浏览))、AgentSky 的同任务比较层(@DataChaz 帖子(27 个赞、6 条回复、16,084 次浏览、12 次收藏、2 次引用)),以及 Phantom API 幻觉探针(@Blue_Beba_ 帖子(20 个赞、10 条回复、148 次浏览、11 次收藏、7 次引用))。这一方向很强,因为痛点、需求、方法和构建者活动都对齐了。
[+++] Persistent agent workspaces and handoff layers — Offloop and Rome pointed to a growing product layer above chat where tasks, channels, memory, and tools persist across sessions and collaborators (@Suryanshti777 帖子(46 个赞、14 条回复、1,269 次浏览、8 次收藏);@zoolsher 帖子(29 个赞、4 条回复、1,199 次浏览、6 次收藏、4 次引用)。这一方向很强,因为人们赞赏的不只是 UX 打磨,而是在回应一个非常具体的失败模式:有价值的多步骤工作会随着聊天结束而消失。
[++] Local-model fit and inference-cost routing — The combination of canIrun.ai, VRAM/bandwidth guidance, OpenAI's tiered pricing, OpenRouter token-growth data, and server-price warnings suggests a real opportunity in choosing the right model, quantization, provider, and billing mode for each workload (@dr_cintas 帖子(1 个赞、330 次浏览、3 次收藏);@gemchange_ltd 帖子(9 个赞、1,284 次浏览、7 次收藏);@ionet 帖子(29 个赞、3 条回复、4,039 次浏览、1 次引用)。这一方向属中等强度,因为虽然已经有若干局部解法,但市场仍然分散,也很容易被误读。
[++] Privacy-preserving audit and compliance layers for autonomous systems — The MOSS framing of defined strategy, verifiable actions, traceable records, and observable outcomes without revealing every private input lines up with Thomson's explicit customer-data boundary and with broader protocol-security caution around MCP (@Mmenyene_C 帖子(60 个赞、59 条回复、219 次浏览);@LomashKumar52 帖子(11 个赞、775 次浏览、10 次收藏)。这一方向属中等强度,因为需求很清晰,但实现空间很可能已经挤满治理、日志和安全厂商。
[+] Physical-AI correction, provenance, and replay validation — AXIS and related discussion showed that raw demonstration volume is less differentiated than verified correction snippets, provenance, and replay-safe data loops (@yapslingerx 帖子(66 个赞、59 条回复、1,197 次浏览);@Olamicryptt 帖子(41 个赞、19 条回复、438 次浏览、1 次引用);@juraucrypt 帖子(22 个赞、17 条回复、261 次浏览)。这一方向正在形成,因为信号质量很高,但目前仍集中在规模较小的物理 AI 子社区中。
[+] Specialized model stacks for regulated or structure-heavy domains — Thomson in legal, GLiNER2.5 in extraction, and SenseNova-Vision in multimodal structured perception all point to the same opening: smaller or domain-tuned systems can win when the output format, provenance requirements, or task ontology are unusually specific (@ConorBronsdon 帖子(6 个赞、2 条回复、243 次浏览、1 次收藏、1 次引用);@fastinoAI 帖子(17 个赞、1 条回复、781 次浏览、6 次收藏、1 次引用);@rsasaki0109 帖子(51 个赞、2,287 次浏览、31 次收藏)。这一方向正在形成,因为它要求领域资产或专门的研究深度,但价值主张却异常具体。
8. 要点
- 信任已经从基准总分转向可验证的测试框架。 最强的帖子讨论的是金融领域专用评估设计、难以污染的编程测试、并排智能体竞技场和公开的幻觉探针,而不是通用排行榜上的输赢。(FORCE-Bench、Jcode Bench、AgentSky、Phantom API 测试)
- 物理 AI 的讨论重点是让数据在采集后仍然可信,而不只是采集更多数据。 与 AXIS 相关的帖子强调浏览器采集、验证、纠正筛选和回放对齐,其中一个例子显示,660 条纠正里只有 161 条通过筛选。(AXIS 概览、纠错质量帖子、回放帖子)
- 模型使用量在扩大,而价格压力迫使团队更严格地做路由。 OpenRouter 的 token 增长图、OpenAI 的新价格菜单,以及基础设施成本警告,都指向同一个结果:团队仍想增加智能体使用量,但对把预算花在哪里变得更加挑剔。(OpenRouter 使用量帖子、OpenAI 定价帖子、服务器成本警告)
- 模型之上的产品层正在变厚。 Offloop、Rome、canIrun.ai 以及围绕 MCP 的讨论,都围绕记忆、交接、部署适配和工具连接,而不只是模型新鲜度本身。(Offloop、Rome、canIrun.ai、MCP 说明)
- 专业化模型带来了最具体的发布叙事。 Thomson、GLiNER2.5 和 SenseNova-Vision 都把模型绑定在了清晰的工作流边界上:基于专有数据的法律推理、长上下文抽取,以及统一的多模态感知。(Thomson、GLiNER2.5、SenseNova-Vision)
- 主权 AI 看起来更像运营议题,而不是修辞口号。 韩国这场有算力支持的竞赛,以及印度芯片商业化相关线程,都给出了围绕评估、采购和收入兑现周期的具体数字,而不是泛泛的国家 AI 品牌叙事。(韩国主权 AI、印度芯片战略)