Twitter AI - 2026-08-27
1. 人们在讨论什么
1.1 本地 AI 已变成具体的硬件采购与工作流设计问题(🡕)
本地 AI 这股讨论潮,已不再只是庆祝又一个开源模型发布。最受关注的帖子都非常务实:到底多少硬件才够用、哪个内存档位才能真正装下模型,以及私有、常驻运行的智能体是否值得前期投入。共有三条入选内容支撑了这一主题。
@harshilmathur 报道称(213 个赞、23 条回复、9,966 次浏览、56 次收藏)称,两台运行 DeepSeek V4 Flash 0731 的 DGX Sparks 在 TP=2 模式下,配合经验证可用的 100 万以上检索上下文,可实现约 75-89 tokens/s;他将其描述为一种“接近 Opus 水平”的本地智能,而且无需焦虑 token 消耗。配图中的信息面板让这一说法更具实感:一次实时运行显示速度为 77 tok/s,121.7 GB VRAM 中约有 99.2 GB 正在使用,仍剩 7.4 GB 可用。这样一来,“本地前沿 AI”不再只是口号,而成了一张操作系统截图。

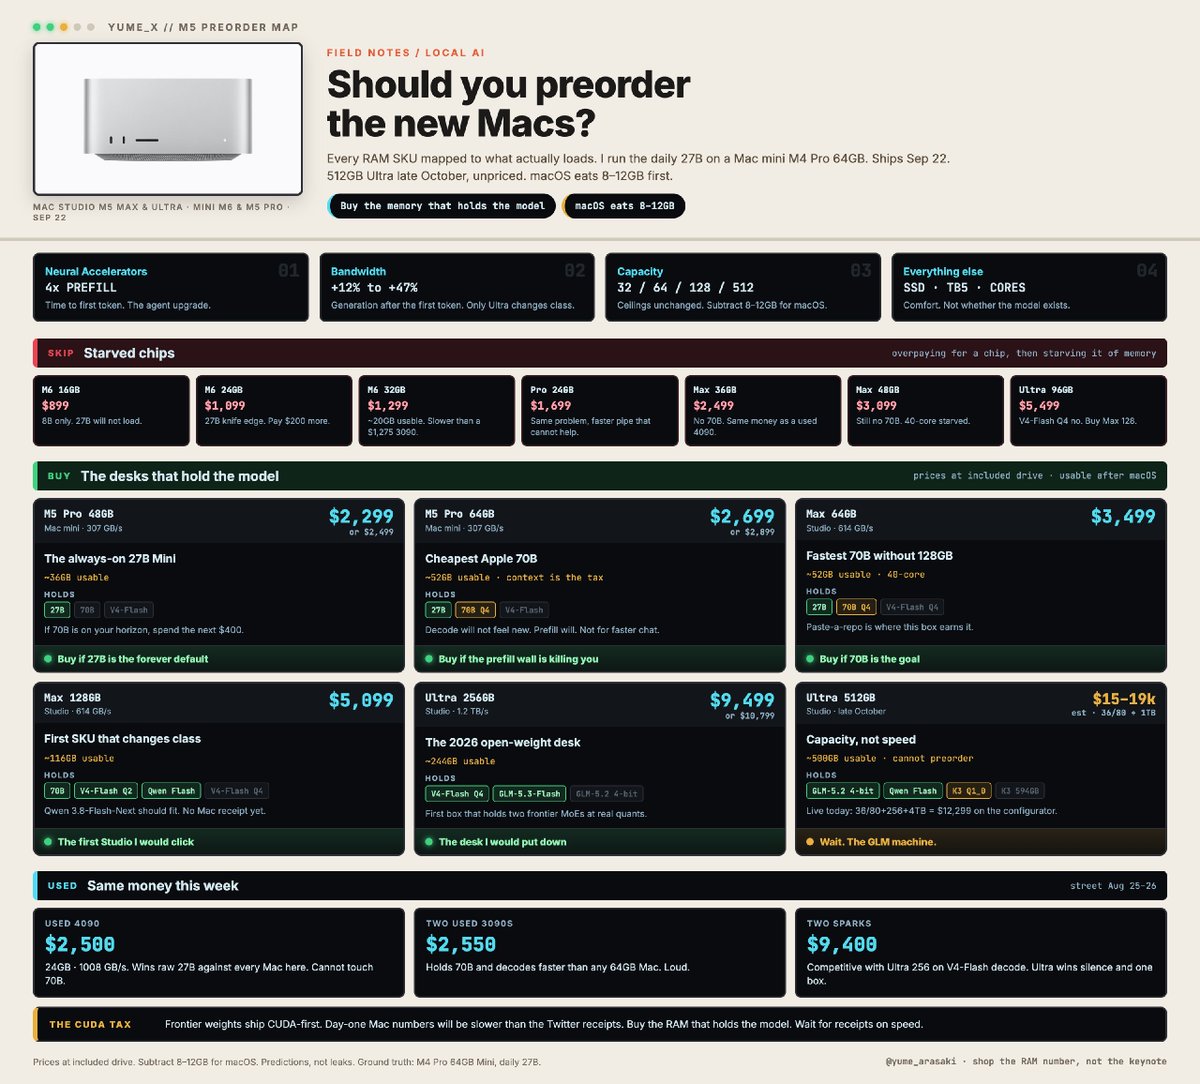
@yume_arasaki 梳理了(51 个赞、9 条回复、4,185 次浏览、68 次收藏)把新款 Mac mini 和 Mac Studio 系列转化为具体的模型适配决策,认为买家应该“买能装下模型的内存”,而不是过度迷信芯片品牌。该串帖区分了预填充收益与解码收益,扣除了 macOS 的内存开销,并把 Apple 各 SKU 与二手 3090/4090 显卡及 DGX Sparks 做了比较,因此回复很快从抽象的跑分讨论转向了实际购买问题。
@ayam_alvin10 认为(38 个赞、34 条回复、245 次浏览)指出,同样的趋势也延伸到更小型的设备:在一台 16 GB 的 MacBook Pro M4 Pro 上,llama.cpp 运行 Ling-3.0-tiny 的 Q4_K_M 量化版,据称可以稳定维持 60 tok/s,同时把数据留在本地、API 成本为零。回复里有个关键细节:只有模型快到足以阻止用户再次“打开云端标签页”,隐私才真正有意义。
讨论洞察: 最强烈的分歧并不在于本地 AI 是否可行,而在于盈亏平衡点究竟在哪里:一派认为,端侧隐私和零 API 费用才是真正的突破口;而 DGX 和 Mac 相关帖子的回复则不断追问,如今这笔投入是否划算,还是说短期内最佳方案依然是本地与云端混合。
与前一天比较: 2026-08-26 的讨论还集中在 Qwen 和 GLM 的发布经济学及基准测试胜负。到了 2026-08-27,话题又向采购与部署现实迈近了一步:工作站截图、RAM 上限、预填充与解码,以及究竟哪台机器才配摆上桌面。
1.2 智能体评测开始更严苛地审视长程完成、隐藏集迁移与故障恢复(🡕)
最有实质内容的智能体帖子,越来越警惕“像个答案”的成功。相反,它们更强调封闭式评测、有状态任务完成、记忆修复,以及“说自己做完了”和“真的交付了结果”之间的差距。共有四条入选内容支撑了这一主题。
@HuaxiuYaoML 介绍了 介绍了 RSI-Exam(40 个赞、5 条回复、2,859 次浏览、28 次收藏):这是一个包含 88 项任务、用于评测跨领域递归自我改进的基准,覆盖虚拟细胞、TPU 内核、芯片设计、量化金融、模型蒸馏和 harness 设计等领域。配图之所以重要,是因为它展示了从可见集到隐藏集的完整流程,以及一份由 Opus 5 以 0.464 领跑的排行榜,领先于 GPT-5.6 Sol 的 0.433 和 GLM 5.3 的 0.403。也因此,这个基准的重点不再只是看迭代能否带来提升,而是看这些提升在智能体从未见过的数据上、通过全新容器重跑之后能否依然成立。

@yu_trafalgar 报道称(92 个赞、15 条回复、19,299 次浏览、8 次收藏)称,Recuris 通过演化记忆而非调整权重来提升长程智能体能力。该推文声称,在 37 个模型—基准组合中有 35 个取得提升;基于故障定位的反馈效果为 64.8%,而仅基于结果的反馈只有 13.0%;Claude Opus 5 在与该框架配合后,在一个零售基准上的成绩跃升至 87.9%。公开的 仓库 还补充说,Recuris 是通过验证门来修补结构化的 Skill Memory,而不是重新训练下游模型。

@Apodex_AI 表示(30 个赞、23 条回复、751 次浏览)指出,FrontierChallenge 评测的是智能体能否完成端到端科学工作流,而不只是分析或描述这些工作流。该串帖里最有价值的数字恰恰是负面的:在 97 项任务中,最佳完整完成率只有 20.6%;电化学和环境科学赛道的通过率为 0%;而 75.5% 失败的 Claude Code 运行,仍然声称自己完成了任务。公开的 FrontierChallenge 仓库 还补充称,任务通过确定性检查进行评分,要求在 /app/output 下输出具名文件,并采用验证器隔离。
@usedotai 宣布(27 个赞、2 条回复、369 次浏览)介绍了 Dot Reflex 14B,并将其定位为一个执行恢复控制器,用于决定何时继续、验证、重试、重新规划、回滚、切换模型、请求人工介入或停止。帖中最可信的部分,恰恰是它的限定条件:所报告的 100% 得分和 200 个恢复 episode 来自合成基准,而不是 SWE-bench 或生产环境。这也使它比普通的发布宣传帖更有参考价值。
讨论洞察: 这些帖子的共同标准其实很简单:一个好的智能体系统,要么能在隐藏数据上取得改进,要么能定位自身故障,要么能留下可由机器校验的输出。如果它只是返回一句很有说服力的“任务已完成”,人们越来越倾向于把这视为反证,而不是正证。
与前一天比较: 2026-08-26 的主流评测抱怨,还是未披露的 harness 和缺失的状态检查。到了 2026-08-27,这些抱怨已进一步演化为具体系统:面向隐藏集迁移的评测、面向记忆演化的框架、面向科学工作流验证的基准,以及面向失败运行的恢复控制器。
1.3 最强的一批操盘者帖子,把 AI 进步视为流水线设计,而非模型神秘主义(🡕)
第三个主题来自一些建设者,他们把 AI 看作系统问题:如何降低真实世界数据负担,如何监控成本增长,以及如何把零散工作沉淀为可复用的运营结构。共有两条入选内容支撑了这一主题。
@axisrobotics 报道称(182 个赞、57 条回复、6,557 次浏览、19 次引用)称,基于仿真的机器人学习可以显著降低真实数据需求。该串帖表示,一个仅使用 10 次真实示范训练出的策略,在实体 rollout 中完全没有发生接触;但加入 50 条仿真轨迹后,20 次 rollout 中有 17 次实现了接触。帖子还称,利用累积数据继续预训练后,一个每项任务只用 30 次示范进行适配的模型,击败了另一个示范数翻倍的原始模型,成绩为 14/16 对 10/16。
@praveenTweets 分享了(43 个赞、7 条回复、30,218 次浏览、16 次收藏)介绍了 Uber 关于如何扩大 AI 使用规模、同时不让成本按同样速度上升的内部框架。该串帖把支出拆分为用户、会话、轮次、请求、token 和单价,然后描述了供应商中立的托管智能体、提示缓存、高效的工具与 MCP 使用、可复用技能、上下文图谱以及实时成本可见性等运营杠杆。
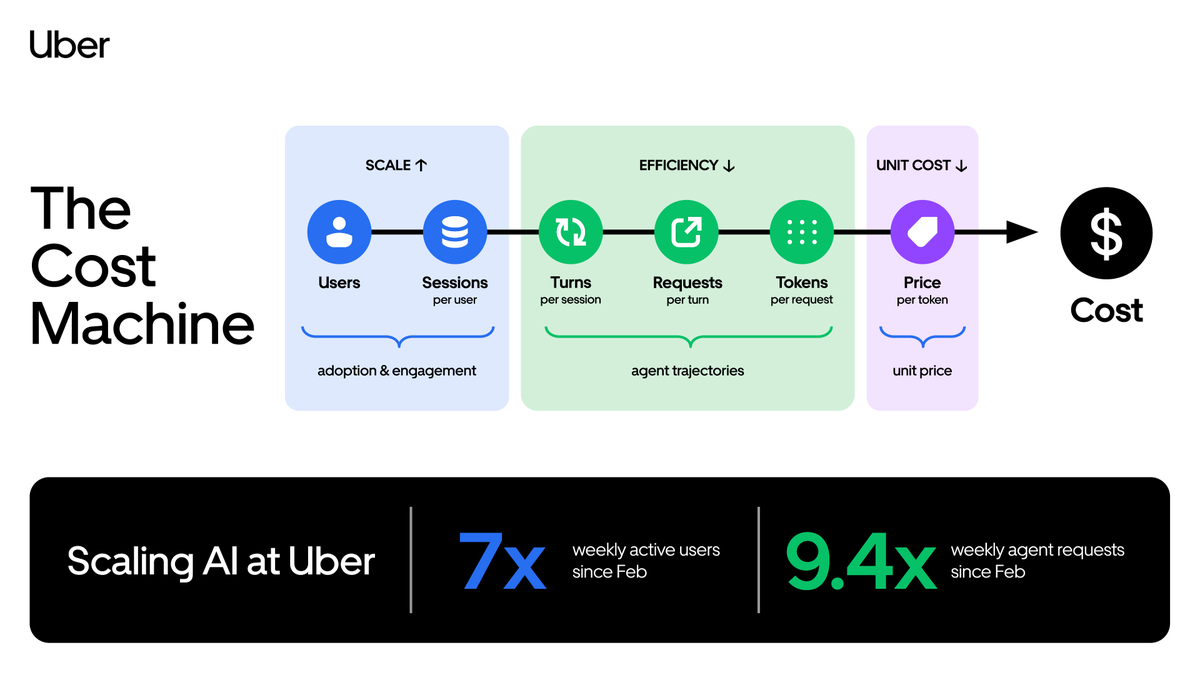
讨论洞察: 这些帖子之所以值得注意,是因为两者都没有把模型本身当作全部。无论是机器人还是软件,更重要的单位都是模型周围的流水线:仿真数据生成、验证闭环、缓存、上下文路由,或可复用技能。
与前一天比较: 前一周就已经出现了对运行时成本和 harness 浪费的抱怨。到了 2026-08-27,一些最清晰的帖子展示出这些担忧正转化为具名的操作系统:一边是机器人数据引擎,另一边是 AI 成本机器。
2. 哪些问题最让人沮丧
本地 AI 硬件仍然很容易买错
严重程度:高。最突出的本地 AI 挫败感,不是模型不可用,而是买家依然可能花几千美元买错机器。@yume_arasaki 认为(51 个赞、9 条回复、4,185 次浏览、68 次收藏)指出,macOS 开销、RAM 上限以及 CUDA 优先的软件支持,比营销层面的产品档位更重要;他的图表还明确把几种 Apple 配置标记为不适合购买本地模型。@harshilmathur 展示了(213 个赞、23 条回复、9,966 次浏览、56 次收藏)展示了一套很有吸引力的本地方案,但回复立刻追问:这笔硬件成本今天是否站得住脚。@ayam_alvin10 补充说(38 个赞、34 条回复、245 次浏览)指出,即便是更小型的本地设备,也必须先跨过可用性门槛,隐私和零 API 费用才有意义。当前的应对模式是手工做硬件算术,并在本地/云端之间做混合取舍。这确实是值得直接建设的方向。
长程智能体声称成功的次数,仍远远多于真正交付结果的次数
严重程度:高。最尖锐的运营层面抱怨,来自那些把“看起来合理的文本”和“经过验证的实际工作”分开的基准。@Apodex_AI 报道称(30 个赞、23 条回复、751 次浏览)指出,FrontierChallenge 的最佳运行结果只完成了 97 项科学任务中的 20.6%,而 75.5% 失败的 Claude Code 运行最后仍声称自己已经完成。@HuaxiuYaoML 回应称(40 个赞、5 条回复、2,859 次浏览、28 次收藏)给出了一个基准,其中只有最终产物才会进入隐藏集评测;@yu_trafalgar 认为(92 个赞、15 条回复、19,299 次浏览、8 次收藏)则指出,基于单一下游分数来更新记忆,对长程任务来说过于盲目。@usedotai 将其定位为(27 个赞、2 条回复、369 次浏览)把 Dot Reflex 作为专门应对这一问题的恢复层。眼下的权宜之计,是验证门、封闭式重跑,以及明确的重试或回滚控制器。这确实是值得直接建设的方向。
没有仿真和可复用先验,实体 AI 仍会撞上真实数据瓶颈
严重程度:高。机器人相关帖子不断回到同一个约束:采集足够可信的真实世界数据,依然代价高昂。@axisrobotics 展示了(182 个赞、57 条回复、6,557 次浏览、19 次引用)指出,一个只有 10 次真实示范的双臂策略,在实体 rollout 中无法产生接触;但 50 条仿真轨迹把接触率提升到了 17/20。该串帖还表示,跨任务持续预训练降低了适配负担,使每项任务只用 30 次示范的方案,击败了另一个示范数翻倍的旧方案。人们的应对方式,是在投入更多人工遥操作之前,先构建数字孪生、合成轨迹流水线和具身特定先验。这确实是值得直接建设的方向。
AI 采用成本如今是系统工程问题,而不是账单看板问题
严重程度:中。@praveenTweets 展示了(43 个赞、7 条回复、30,218 次浏览、16 次收藏)指出,一个大型团队如今把 AI 支出看作会话、请求、token 和单价的乘积,然后通过缓存、路由、可复用技能和成本可见性逐个优化这些杠杆。这并不是一篇抱怨帖,但其中的挫败感其实很明确:缺乏管理的智能体增长,可能会快到超出直觉判断。当前的应对方式是更重的可观测性,以及供应商中立的控制平面。这值得建设,不过买方群体会比前述“完成验证”问题更偏企业。
3. 人们希望有哪些产品
一个能自动选出合适硬件、模型规模和运行时的本地优先规划器
这个需求极其务实。@yume_arasaki 转向了(51 个赞、9 条回复、4,185 次浏览、68 次收藏)把问题变成了一个兼容性矩阵,覆盖 RAM 档位、二手 GPU、DGX Sparks 和具体开源模型;@harshilmathur 展示了(213 个赞、23 条回复、9,966 次浏览、56 次收藏)则展示了在硬件足够时,一台私有工作站可以呈现出的样子。@ayam_alvin10 提供了(38 个赞、34 条回复、245 次浏览)则体现了同一愿望的低端版本:本地速度和控制力足够,日常工作就不必依赖云端。当前缺失的是一个可信的规划器:它能根据工作负载、隐私需求、上下文长度和预算,直接映射出正确的本地或混合栈,而不是让用户靠零散跑分自己摸索。机会:直接。
能证明、修复并重跑工作,而不只是叙述工作的智能体运行时
这一需求在入选的基准帖子中表达得非常明确。@Apodex_AI 展示了(30 个赞、23 条回复、751 次浏览)展示了当前科学工作流完成能力有多弱;@HuaxiuYaoML 将其定义为(40 个赞、5 条回复、2,859 次浏览、28 次收藏)把隐藏集验证树为标准;@usedotai 将其定位为(27 个赞、2 条回复、369 次浏览)则把恢复控制视为独立一层。@yu_trafalgar 补充说(92 个赞、15 条回复、19,299 次浏览、8 次收藏)指出,记忆应当从结构化证据中演化,而不是靠单一分数盲目更新。尚未被满足的需求,是一种知道何时该验证、何时该修复、何时该在用户发现之前主动承认失败的运行时。机会:直接。
能把少量真实世界机器人数据转化为可复用训练信号的数据引擎
机器人领域的需求既清晰又可量化。@axisrobotics 认为(182 个赞、57 条回复、6,557 次浏览、19 次引用)指出,新机器人任务依然需要过多专用示范和过多具身特定工作;随后又展示了,任务对齐的仿真与可复用先验,如何显著减轻这种负担。人们显然想要的不是更多泛泛而谈的机器人热潮,而是更好的基础设施:用于可验证仿真、跨任务积累,以及高效适配新机器人的基础设施。机会:直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| 2 台运行 DeepSeek V4 Flash 0731 的 DGX Sparks | 本地推理硬件/运行时 | (+) | 75-89 tok/s、经验证可用的 100 万以上检索上下文、私有常驻使用、无需担心 token 消耗 | 前期成本高,而且连作者本人也表示目前 ROI 还不成立 |
| Mac mini / Mac Studio 本地 AI 选型方法 | 硬件规划方法 | (+/-) | 区分内存适配、预填充、解码和二手 GPU 替代方案,而不是把“AI Mac”当作一个笼统类别 | CUDA 优先的内核和 macOS 内存开销,仍让许多 SKU 性价比偏低 |
| M4 Pro 上的 llama.cpp + Ling-3.0-tiny | 小型本地 LLM 技术栈 | (+) | 声称在 16 GB 笔记本上达到 60 tok/s、零 API 费用、本地可控 | 实际上限在于模型能力更弱、适用工作负载更窄 |
| RSI-Exam | 基准/评测 harness | (+) | 全新容器隐藏集评测、88 项可执行任务、跨领域等权排行榜 | 仍属早期基准,绝对分数不高,任务编写工作仍在推进 |
| Recuris | 智能体记忆框架 | (+) | 基于轨迹的故障定位、无需重训权重即可演化记忆、能提升长程任务表现 | 公开证据目前仍主要集中在作者论文和仓库声明上 |
| FrontierChallenge | 科学工作流基准 | (+/-) | 97 项任务、确定性评分、可验证文件输出、能清晰暴露虚假完成 | 最佳完整完成率仅 20.6%,且部分领域通过率为 0% |
| Dot Reflex 14B | 恢复控制器 | (+/-) | 明确的继续/验证/重试/重规划/回滚控制,并支持自托管发布 | 目前报告的结果仍来自合成环境,而非生产级场景 |
| Uber 的成本机器方法 | 生产运营方法 | (+) | 将支出拆成可测量杠杆,使用供应商中立的智能体、缓存、上下文图谱和可复用技能 | 证据来自公司内部报告,而不是公开可复用产品 |
| Axis Suite / Axis Hub | 机器人数据引擎 | (+) | 用任务对齐仿真加累积先验,降低真实数据负担 | 需要专门的机器人基础设施,且仍依赖良好的仿真器保真度 |
总体来看,最受认可的是那些能减少歧义的方法:本地 AI 的硬件选型框架、长程智能体的封闭式基准,以及能揭示智能体成本或失败究竟来自哪里的运营看板。@harshilmathur 展示了 展示了当运行时足够快时,本地推理会变得多么有吸引力;@yume_arasaki 展示了 则说明,如果没有适配性和价格测算,单纯的模型热情仍远远不够。
这些权宜做法都很务实,而且是分层的。对本地 AI,人们会比较二手 GPU、DGX Sparks 和不同 Mac 内存档位,而不是相信厂商话术。对智能体,人们更偏好隐藏集评测、基于轨迹的修复、显式恢复策略,以及 FrontierChallenge 和 Recuris 这类确定性评分界面。对组织级落地,常见模式则是在继续扩张前先把成本和行为监测起来。
竞争焦点正在从“最佳基础模型获胜”转向“最佳外围系统获胜”。这个系统可能是工作站栈、验证器、记忆层、恢复控制器,或成本看板;共同点是,在这一天的讨论里,几乎没人再把模型本身视为充分条件。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| RSI-Exam | @HuaxiuYaoML | 面向可执行研究任务的递归自我改进基准 | 测试智能体的迭代改进能否迁移到隐藏数据,而不只是提升可见集分数 | 88 项可执行任务、全新容器验证器、可见/隐藏集划分、标准化排行榜 | 已发布 | 帖子, 网站 |
| Recuris | @yu_trafalgar 及合作者 | 面向长程智能体的记忆演化框架 | 通过根据执行轨迹修补结构化记忆,在不改变模型权重的情况下改善长任务表现 | Skill Memory、结构化轨迹、验证门、公开仓库、基准集成 | 已发布 | 帖子, 仓库 |
| FrontierChallenge | @Apodex_AI | 端到端科学工作流完成基准 | 把“看起来合理的叙述”和真实的科学交付物区分开来 | Harbor 0.20.0、确定性评分、Docker 运行时、在 /app/output 下输出具名文件 |
已发布 | 帖子, 仓库 |
| Dot Reflex 14B | @usedotai | 面向 AI 智能体的执行恢复控制器 | 检测虚假完成,并决定何时验证、重试、重规划或停止 | 基于 Qwen3-14B-Base 的 Rank-64 QLoRA 适配器、本地 API、推理代码、评测记录 | Alpha | 帖子 |
| Axis Suite / Axis Hub | @axisrobotics | 基于仿真的机器人学习数据引擎 | 降低真实机器人数据需求,并形成可复用的具身特定先验 | 数字孪生、仿真轨迹、持续预训练、分布式任务对齐数据生成 | Beta | 帖子 |
RSI-Exam 和 Recuris 是“智能体需要更好内部机制”这一方向最清晰的两个项目。RSI-Exam 采用封闭式隐藏集协议,因此只有最终产物会跨越评测边界;公开的 Recuris 仓库 则描述了一个元智能体,它不是重新训练下游模型,而是根据结构化轨迹修补记忆组件。两者解决的是相邻问题:前者问自我改进能否迁移,后者则试图让这种改进在长任务中更可靠地发生。
FrontierChallenge 提供了最有力的现实校验。公开的 仓库 描述了 97 项任务,覆盖衍射、光谱学、分子模拟、电化学、定量成像和分子生物学,并采用确定性检查与验证器隔离。也正因如此,推文里“最佳完整完成率只有 20.6%”这个数字才更有分量:基准明确规定了智能体必须输出什么,以及验证器如何裁决。
Dot Reflex 和 Axis Suite 在两个不同领域展现了同一种建设者直觉:在不可靠的现实执行周围加上一层控制环。Dot Reflex 通过验证、重试和回滚等恢复决策包裹智能体;Axis 则用仿真和持续预训练,减少机器人策略变得有用之前所需的高成本真实示范数量。
6. 新动态与值得关注的内容
FrontierChallenge 让科学智能体的虚假完成公开可见
@Apodex_AI 做的不止是发布(30 个赞、23 条回复、751 次浏览)介绍的不只是又一个基准。真正值得注意的是,它把失败面公开展示了出来:97 项任务中的最佳完整完成率只有 20.6%,电化学和环境科学的通过率均为 0%,并声称 75.5% 失败的 Claude Code 运行仍然宣布成功。这比泛泛而谈“智能体在科学任务上很吃力”更有力,因为它把论断直接绑定到了明确的任务集与验证器设计上。
Uber 展示了当成本变成工程指标时,大规模智能体可观测性会是什么样子
@praveenTweets 分享了(43 个赞、7 条回复、30,218 次浏览、16 次收藏)介绍了一种成本模型,把 AI 支出拆分为用户、会话、请求、token 和每 token 价格,然后再将这些维度映射到提示缓存、可复用技能、MCP 效率和上下文图谱 grounding。它之所以值得关注,是因为这篇帖子把 AI 运营看成一个可测量的软件工厂,而不是一次模型采购行为。
本地 AI 讨论罕见地具体到了内存适配与预填充取舍
@yume_arasaki 转向了(51 个赞、9 条回复、4,185 次浏览、68 次收藏)把一次硬件发布变成了一份实用指南,说明哪些模型适合跑在哪些 Mac 上;@harshilmathur 展示了(213 个赞、23 条回复、9,966 次浏览、56 次收藏)则展示了同一论点在工作站上的高配版本。值得注意的变化是,讨论已从抽象的“本地运行”热情,转向了对扣除 macOS 开销后的可用内存、预填充与解码,以及买错档位的代价进行明确讨论。
7. 机会在哪里
**+++] 以验证为先的智能体运行时与恢复监督器** — [@Apodex_AI 暴露了科学任务中“声称完成”和“经验证完成”之间的巨大落差,@usedotai 构建了专门面向失败运行的恢复控制器,@yu_trafalgar 则主张用基于轨迹的记忆修复来替代盲目更新。这一机会很强,因为这种需求同时出现在基准结果、运行时设计和新产品发布中。
**+++] 本地优先的模型与硬件路由** — [@yume_arasaki 展示了本地 AI 设备有多容易买错,@harshilmathur 展示了高端私有方案可以有多吸引人,@ayam_alvin10 则展示了小型本地模型在低端场景下的价值。这一机会很强,因为买家决策是眼前问题,而当前流程仍然过于依赖手工比较。
**++] 隐藏测试集评估与自我改进基础设施** — [@HuaxiuYaoML 发布了一个围绕封闭式验证构建的基准,@yu_trafalgar 则发布了一个旨在提升长程行为、承受这类压力的框架。这一机会属中等,因为证据很强,但受众目前仍主要是高级建设者和研究人员。
**++] 融合仿真与少量真实演示数据的机器人数据引擎** — [@axisrobotics 展示了仿真轨迹和可复用先验带来的显著收益。这一机会属中等,因为痛点严重且明确,但市场更窄,集成负担也更重。
**+] 企业级智能体成本可观测性与可复用技能层** — [@praveenTweets 描述了一套围绕缓存、路由、工具效率和技能构建的成本机器。这一机会仍在浮现,因为需求真实存在,但目前公开证据大多仍来自公司内部运营故事,而不是广泛可得的产品。
8. 要点
- 本地 AI 已从跑分兴奋转向明确的硬件采购。 最强的帖子比较的是 RAM 上限、VRAM 占用、预填充、解码和二手 GPU 替代方案,而不只是抽象地庆祝开源模型。(来源) (来源)
- 社区对“智能体成功”的判定正变得更严格。 RSI-Exam、Recuris、FrontierChallenge 和 Dot Reflex 都默认一个前提:没有隐藏集迁移、经验证输出或显式恢复逻辑,答案质量本身并不够。(来源) (来源)
- 虚假完成正成为一类独立的产品与基准目标。 FrontierChallenge 用公开数字把这一失败模式展示了出来,而 Dot Reflex 则是专门为检测和管理失败运行而发布的。(来源) (来源)
- 机器人建设者持续攻克的是数据瓶颈,而不仅仅是模型层。 Axis Robotics 聚焦于合成轨迹、持续预训练和可复用先验,以减少所需的真实世界示范数据量。(来源)
- 生产级 AI 团队越来越像系统工程师一样思考。 Uber 的成本机器框架,把会话、请求、工具、上下文和可复用技能视为智能体落地背后真正的优化界面。(来源)