Twitter AI - 2026-09-01
1. 人们在讨论什么
1.1 多模态发布正收敛到具体工作闭环,而不再是泛化聊天(🡕)
这一轮最强的发布集群,并不是又一个通用助手,而是面向语音、声音、视频和 3D 世界重建的专用感知模块。有四条入选内容支撑这一主题,前一周的对比也在上升:在前 80 条推文中,多模态发布相关匹配数从 2026-08-31 的 9 条升至 2026-09-01 的 14 条。
@AIatMeta 推出(231 个赞、14 条回复、12,346 次浏览、56 个书签)介绍了 Muse Voice Transcribe,称其为 Meta Superintelligence Labs 首个真正的实时音频感知模型,宣称具备流式 ASR、20 多名说话人的说话人分离、端点检测、多语言语码切换能力,并在流式语音转文本和说话人分离基准上获胜。Meta 自己的 公告 补上了推文里缺失的技术细节:80 ms 音频分块、来自 Muse Spark 家族的自回归多模态模型,以及一种逐词权衡延迟与准确率的自适应延迟强化学习方案。同一线程还表示,该模型已经可通过 Meta Model API、Meta AI for Mac 和 Muse Code 使用,因此这更像一次产品发布,而不只是实验室预告。


@drfeifei 宣布(176 个赞、21 条回复、12,183 次浏览、45 个书签)介绍了 World Labs 的 Atlas:一个从零开始训练的多模态世界模型,用于摄像机可控生成、稀疏视角 3D 重建和时空模拟。官方 Atlas 页面 进一步明确了这一说法:Atlas 是一个多模态自回归扩散 Transformer,可处理文本、图像、视频和 3D,最长可生成 1 分钟的 1440p 视频,并将摄像机几何作为原生输入,而不是从文字描述中推断镜头运动。这种组合把世界模型的讨论从电影化演示话术,推向了对 VFX 和机器人真正重要的可控输入。
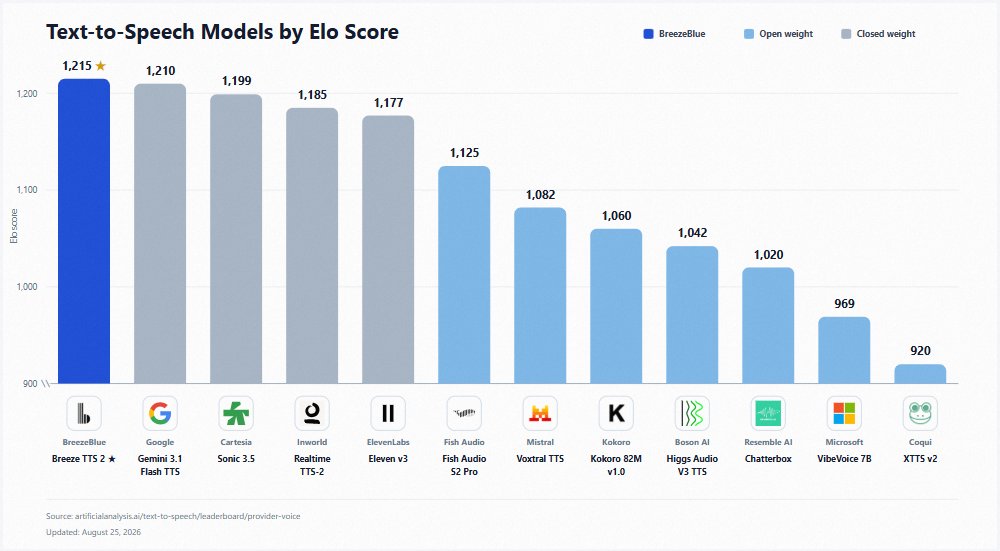
@ModelScope2022 发布(44 个赞、3 条回复、2,346 次浏览、29 个书签)介绍了 Breeze-TTS-2,将其称为一款实时语音克隆与语音控制模型;随附排行榜并非装饰,而是有信息量的证据:Breeze TTS 2 位居 Artificial Analysis 公共文本转语音 Elo 榜首。公开的 模型页面 加上推文正文,补充了读者真正需要的实用细节:Apache 许可证代码、研究/非商业权重条款、预热路径下低于 40 ms 的首音频延迟,以及建议用 12 GB GPU 自托管。
@_philschmid 撰文(57 个赞、1 条回复、2,557 次浏览、28 个书签)指出,Gemini 的视频理解现在已经具备智能体特征:模型可以自行选择查看转录文本、音频或视觉帧,也可以动态搜索时间线,而不必为固定帧率付出恒定成本。Google 针对 智能体式视频理解 的发布文章用具体数字印证了推文摘要:在 Gemini 3.7 Flash、3.6 Flash 和 3.5 Flash-Lite 上,最多可减少 88% 的 token、降低 66% 的成本,并将基准准确率最多提升 7%。这让多模态效率本身也成了产品叙事的一部分,而不只是模型智商的附属项。

讨论洞察: 最有价值的回复,并没有质疑这些系统到底能不能工作,而是在追问“投入生产使用”到底意味着什么。一条回复 Meta 的评论说,真正的产品问题是谁能查询实时转录流、谁不能;另一条 Atlas 相关回复则表示,把摄像机位姿作为原生输入,比“世界模型”这个营销说法更重要。
与前一天对比: 2026-08-31 的多模态讨论已经很活跃,但更偏向预测和泛化视觉推理。到了 2026-09-01,讨论明显更可操作:语音、TTS、视频搜索和 3D 摄像机控制,都带着可部署接口或产品路线图一起出现。
1.2 模型采购者不再把静态基准当作选型指南(🡕)
第二个主题,是对“排行榜表演”的不信任。最有代表性的帖子认为,模型选择如今是由任务形态、会话形态和基础设施形态共同决定的,因此单提示对比已经不够。有四条入选内容支撑这一主题,这也是前一周扫描中最明显的加速项:前 80 条中,评测与 harness 相关匹配数从 2026-08-31 的 34 条升至 2026-09-01 的 50 条。
@AlexFinn 认为(52 个赞、16 条回复、5,684 次浏览、31 个书签)认为,任何在评估新编码模型的人,都应该围绕自己反复出现的工作类别搭建私有 harness,而不是相信厂商基准或时间线上的基准测试。这条推文异常可操作:先给工作分类,再生成多步骤测试,把它们封装进一个小应用,然后通过路由器让新模型正面对比。重点不是“忽略所有基准”,而是“把基准边界不断往里收,直到它更像你真正付费的工作”。
@MaorShlomo 推出(48 个赞、5 条回复、2,843 次浏览、7 个书签)介绍了 Base44 的 Model Comparison,提出了同样的批评:最佳模型会随任务而变,在自己的应用里并排看输出,比看图表更有信息量。之所以强调这一功能描述,是因为它把这种抱怨变成了具体产品行为:一个提示、两个模型、两条分支,然后在构建器里决定保留一个还是两个结果。
@gippp69 认为(33 个赞、11 条回复、524 次浏览、20 个书签)认为,编码智能体基准一直在衡量错误的东西,并引用了 Tomas Hernando Kofman 发布的交互式模型路由基准方法。被引用的说法足够具体,因此值得重视:某个路由器在交互式基准上始终保持帕累托占优,同时以低 20% 到 80% 的成本达到大致 Opus xhigh 的质量,因为它在路由时考虑了会话历史和缓存行为,而不是只优化单轮交互。
@edwardjhu 分享了(50 个赞、3 条回复、2,196 次浏览、27 个书签)则提供了一个最可信的浅层评测反例:Mercor 的 397B SkyRL 训练指南 附带代码、权重、轨迹、任务格式,以及一张显示 Qwen3.5-397B-A17B 在 APEX-Agents 上 Pass@1 从 16.11% 升至 27.29% 的图表。这条帖子之所以重要,在于它用一套可复现的训练与评测配方,替代了基准截图,其中还包括 Mercor 所说的、在投入任何严肃算力之前会先完成的三项降风险步骤。

讨论洞察: 回复不断把讨论推向更贴近现实的方向。一条回复 Alex Finn 的评论说,有用的 harness 必须纳入过去失败的案例,而不只是常见任务;另一条回复 Jafar Najafov 后续 Hugging Face 课程线程的评论则说,难点在可观测性和评测,而不是围着 API 再套一层循环。
与前一天对比: 2026-08-31 已经有较强的评测讨论,但仍主要停留在模型与 harness 搭配的高层次。到了 2026-09-01,人们又向采购和运营靠近了一步:私有测试集、并排分支、交互式路由,以及公开发布的评测轨迹成了重点。
1.3 网络能力讨论从红队炫技转向受控发布与防御闭环(🡕)
网络安全讨论依然高度能力导向,但叙事框架变了。最强的内容不再是抽象庆祝攻击能力,而是在说明:为什么攻击能力一旦增强,就会迫使产品设置发布约束、采用专用模型栈,并建立闭环防御系统。有两条入选内容支撑这一主题,前 80 条中,网络安全相关匹配数从 2026-08-31 的 8 条升至 11 条。
@testingcatalog 撰文(271 个赞、12 条回复、15,981 次浏览、27 个书签)称,Astra 即将推出,但其网络安全能力会受到限制,尽管它的漏洞利用表现远强于 GPT-5.6 Sol。被引用的 OpenAI 帖子和官方 Path to Astra 说明了原因:Astra 越过了 OpenAI 的 Critical 网络安全阈值,在公开 ExploitBench 上拿到 100%,并且还在一个私有的 20 漏洞 Internal Port 基准上接受了测试,该基准覆盖较新的高严重性 V8 漏洞。线程中的信息图把性能差距展示得足够清楚,以至于“有限发布”不再像公关式模糊说法,而更像真正的产品级门控。

@NVIDIAAI 撰文(23 个赞、5 条回复、3,241 次浏览、8 个书签)介绍了 CrowdStrike 的 SafeMind 系统:它把攻击智能体和防御智能体放进同一个闭环里,生成检测规则,并用新攻击重新测试这些规则。NVIDIA 的 Fal.Con 回顾 以及推文回复补充了具体机制:Red Tempest 攻击智能体、Blue Solano 防御智能体、Nemotron 3 Ultra 编排、Falcon 遥测,以及一份内部报告。报告称,回测平均检测率从 16.5% 提升到 41.9%;在后续测试中,三条被提升采用的规则捕获了全部 8 次未见攻击。重点并不是某个前沿模型单独取胜,而是一个持续学习的专用红蓝对抗外骨骼。

讨论洞察: 最尖锐的回复聚焦在控制面上。一位评论者在 Astra 讨论下追问,“有限”在工具和升级路径上究竟意味着什么;另一位则指出,账户级审核和模型权重内部的拒答行为,是不同的控制层。
与前一天对比: 2026-08-31 的网络安全帖子还主要在扩充评测词汇。到了 2026-09-01,讨论变得更可操作,也更克制:哪些系统可以发布,哪些防御能够自我改进,以及控制边界到底在哪里。
1.4 物理 AI 看起来仍然首先是个数据工程问题(🡕)
物理 AI 仍然是个明确主题,但证据一再指向数据质量,而不是机器人奇观。入选帖子没有庆祝人形硬件,而是聚焦数据集、轨迹清洗、回放保真度,以及演示数据在预处理之后是否还能保留任务信息。有两条入选内容支撑这一主题。
@Jaxon0x 认为(61 个赞、34 条回复、1,725 次浏览)认为,Axis Robotics 正在构建机器人领域那个常被低估的护城河:可扩展的高质量预训练数据。这条推文没有停留在模糊感觉层面,而是把说法落到公开基础设施上,提到了 Axis Franka Dataset、16 万+ 下载量,以及向 1,200 个任务、120 万条轨迹扩展的计划。核心观点是:机器人领域也许终于开始拥有自己的预训练数据飞轮。
@juraucrypt 认为(37 个赞、30 条回复、216 次浏览)认为,更难的问题不是收集更多人工演示,而是把真正有意义的修正和偶然噪声区分开来。随附信息图通过清洗与重采样后加速度伪影和 jerk 的下降数据,让这一论点更具体;但帖子也坚持认为,仅仅让轨迹更平滑还不够,还必须做回放检查和任务评测。这比“更好的数据有助于机器人”要窄得多,也有用得多。

讨论洞察: 回复始终围绕同一个瓶颈。一条回复 Jaxon 的评论说,大家都在看机器人,几乎没人看数据,这准确概括了该线程对真正约束因素的理解。
与前一天对比: 2026-08-31 的物理 AI 讨论已经以数据闭环为中心。到了 2026-09-01,讨论进一步具体化:开始把数据集规模和轨迹质量分开看,并把回放可靠性当作一项一等要求。
2. 人们在为什么而烦恼
静态排行榜依然过不了“它能在我的应用里跑起来吗?”这道题
严重程度:高。@AlexFinn 表示(52 个赞、16 条回复、5,684 次浏览、31 个书签)认为,开发者既不该相信厂商基准,也不该相信随机 X 线程,而应该围绕自己反复出现的任务搭建私有 harness。@MaorShlomo 制作了 从产品侧提出了同样的抱怨:所谓“最佳”模型会随任务而变,图表看不出一个提示在真实应用里的表现;而 @gippp69 新增了(33 个赞、11 条回复、524 次浏览、20 个书签)则指出,长会话、中断和缓存状态,恰恰是常见编码智能体基准漏掉的内容。可见而且越来越标准化的应对方式,是把并排评测直接做进工作流本身。这是一个非常值得直接构建的方向。
前沿智能体训练起点仍然是环境可靠性,而不是建模新意
严重程度:中。@edwardjhu 分享了(50 个赞、3 条回复、2,196 次浏览、27 个书签)罕见公开了为什么知识工作 RL 很难:Mercor 的 训练指南 说,前三步全都是降风险,只有在环境、harness 和 token 记账都稳定后,才会投入真正的算力。帖子还说,构建真实的专业服务环境成本很高,训练长时程 rollout 也很贵,这有助于解释为什么几乎没有可比的公开研究。构建者的应对方式,是先发布配方、轨迹和更小规模的消融实验,再去做“英雄跑”。这个方向值得做,但比面向消费者的产品更偏基础设施。
物理 AI 演示即使成功,也可能教会模型错误动作
严重程度:高。@juraucrypt 认为(37 个赞、30 条回复、216 次浏览)指出,机器人可能通过一个充满突兀加速、振荡和低效修正的糟糕演示,依然达到正确终态,因此单看任务完成并不足以构成训练信号。@Jaxon0x 关联到 则把这个问题放进围绕 Axis Franka Dataset 展开的更大基础设施竞赛中:只有当数据经得起清洗、回放和评测,规模才有意义。相应的应对策略,是把回放和动作质量指标视为一等检查项,而不是事后补充。这是一个值得直接构建的方向。
更强的多模态感知带来了新的权限与治理难题
严重程度:中。最清楚的例子来自 Meta 发布 Muse 后的一条回复:一位评论者说,实时转录和 20 人说话人分离是能力,但产品问题在于,谁能查询这条数据流、谁不能。OpenAI 的 Astra 发布也从另一个角度体现了同样的约束:@testingcatalog 报道(271 个赞、12 条回复、15,981 次浏览、27 个书签)称,Astra 很快会上线,但即便基准结果很强,其网络安全能力仍会受到限制。人们的应对方式,是把控制上移到账户审核、API 和部署策略,而不是只信任模型权重本身。这个方向值得投入,尤其是在智能体能够持续聆听、观察或行动的场景里。
3. 人们希望有什么
原生嵌入工作流的模型评测
最明确的需求,是一种能在用户自己的任务、自己的环境和自己的会话条件下运行的模型测试。@AlexFinn 明确推荐 主张用自定义 harness 取代公共基准,而 @MaorShlomo 发布了 则给出了首个产品内答案:让同一个提示在两个模型上并行分支运行。这不是理想化愿景,而是现实需求;人们现在就想要,因为模型质量过于依赖具体任务,通用图表已经不够。机会:直接。
面向持续聆听或持续观察型智能体的治理层
Muse 和 Astra 两条线程,都暴露了同一个缺失层:不是“模型能不能做到”,而是“谁能调用、基于什么数据、遵循什么政策”。一条回复 Meta 的 Muse 发布时说,真正的产品问题是谁可以查询实时转录流;而 Astra 的争论则集中在,“有限”发布对工具和升级路径究竟意味着什么。今天,这其中一部分可以通过 API 访问控制和账户审核来解决,但公开证据表明,治理工具仍落后于原始能力。机会:竞争激烈。
可安全回放的物理 AI 数据管线
物理 AI 相关发帖者实际上想要的是这样一套系统:能够收集演示、清洗数据、忠实回放,并证明清洗后的轨迹仍然保留了任务本身。@juraucrypt 详细说明了 指出,降低加速度伪影和 jerk 不能替代回放验证;而 Axis 数据集的讨论则说明,规模正在扩大,但这一信任缺口还没有被补上。这是一个实际需求,背后有明确的研究和基础设施买家。机会:直接。
能把证据一直附着在页面上的研究助手
Open Paper 之所以突出,是因为它描述了一个非常具体的愿望:研究者希望有一个助手始终贴着 PDF,回答时给出精确引用,并让笔记、高亮和跨论文对比不断累积,而不是消失在聊天记录里。@ihteshamali 重点提到 介绍了 Open Paper 中一个真实的开源答案,这意味着这一需求已经被部分满足,而不再只是设想。因此,这个方向比全新蓝海更具竞争性,但仍然紧迫,因为这种痛点每天都会出现,而且一目了然。机会:竞争激烈。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Muse Voice Transcribe | 音频感知 / ASR | (+) | 实时转录、20 多人说话人分离、自适应延迟,并通过 Meta API 和应用交付 | 闭源模型;回复里立刻出现了访问控制问题 |
| Atlas | 世界模型 / 3D 生成 | (+) | 将摄像机几何作为输入、支持稀疏视角重建、可生成长时可控视频、与机器人相关 | 公开材料仍以发布页为主;失败模式和生产访问细节偏少 |
| Breeze-TTS-2 | TTS / 语音模型 | (+) | 开源代码、公共排行榜表现强、支持实时语音设计与克隆、GPU 占用不高 | 权重和衍生使用条款仅限研究/非商业用途 |
| Gemini 智能体式视频理解 | 多模态 API | (+) | token 最多降低 88%、成本降低 66%,可动态调用转录文本、音频和视频帧 | 优势在更长视频上最明显;仍需要具备工具意识的提示方式 |
| Base44 Model Comparison | 应用构建器 / 评测 | (+/-) | 在同一提示和应用状态下做并排分支,更快比较真实任务表现 | 绑定单一构建器,而不是通用标准 |
| SkyRL + APEX-Agents | RL 训练 / 基准 | (+) | 公开配方、长时程知识工作任务、发布了轨迹和权重 | 昂贵环境、精细 token 记账和基础设施工作仍是瓶颈 |
| SafeMind on Nemotron | 网络安全智能体栈 | (+/-) | 攻防闭环、专用网络安全数据、Falcon 原生部署、宣称成本表现强 | 偏企业场景,且依赖专有遥测和 harness |
| Axis Franka Dataset | 机器人数据集 | (+) | 公共数据集、下载势头强、任务路线图庞大、适合 VLA 和世界模型研究 | 数据集规模本身并不能证明回放质量或现实泛化能力 |
| Open Paper | 研究助手 | (+) | 基于引用的回答、项目级综合、结构化提取、Zotero 同步 | 自托管负担比托管体验更重 |
| SYLVA | 浏览器图形 / 世界生成 | (+) | MIT 许可、无需外部素材、实时编辑器,公开仓库可见 Three.js/WebGL2 技术栈 | 仍属早期阶段,优化工作占比很高 |
纵观整张表,用户满意度最高的,往往是那些把一个狭窄工作流具体解决掉的工具:语音转录、TTS、视频分析、PDF 阅读,或某种特定评测闭环。情绪变得复杂,则通常是因为工具在解决第一个问题时,把第二个问题也暴露出来了,比如环境音频治理、RL 训练的基础设施成本,或对比功能带来的构建器锁定。最大的迁移趋势,是从阅读静态基准转向直接测试工作流:私有 harness、并排分支、公开轨迹,以及用户真正能检查的公共数据集。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Open Paper | @ihteshamali 提到的 Khoj | 面向 PDF、笔记、项目和提取表格的、基于引用的研究工作区 | 研究者在论文、笔记和外部聊天机器人之间来回切换时容易丢失上下文 | GitHub README 列出了 Next.js 客户端、FastAPI 服务端、Celery 任务、PDF 解析和 Zotero 同步 | 已发布 | 帖子, 仓库, 网站 |
| SYLVA | @TokenGremlin | 直接在浏览器中运行的全程序化电影感森林 | 无需闭源素材或下载场景包的开放式世界构建与图形实验 | Three.js、WebGL2、GLSL、Vite、GitHub Pages 演示 | Alpha | 帖子, 仓库, 演示 |
| Model Comparison | @MaorShlomo / Base44 | 让同一个构建器提示在两个模型上并行分支运行,并允许用户保留一个或两个结果 | 避免根据公共图表而不是实际应用表现来选模型 | Base44 builder、多模型分支执行 | 已发布 | 帖子 |
| ApexAgents-SkyRL-Recipe | @edwardjhu / Mercor Research | 面向一个 397B 知识工作智能体的公开 RL 配方、权重、轨迹和方法 | 长时程专业工作智能体缺少开放、可复现的训练配方 | Qwen3.5-397B-A17B、SkyRL、DPPO、Harbor、APEX-Agents | 已发布 | 帖子, 博客, GitHub |
| Muse Voice Transcribe | @AIatMeta / Meta Superintelligence Labs | 用于 ASR、说话人分离和端点检测的实时音频感知模型 | 真实对话中的低延迟多语言转录和说话人分离 | Muse Spark 家族多模态 LLM、Meta Model API、Meta AI for Mac | 已发布 | 帖子, 公告 |
| Breeze-TTS-2 | @ModelScope2022 / BreezeBlue | 实时语音克隆、语音设计和指令跟随式 TTS | 对更快、更可控的开放权重语音生成的需求 | Apache 许可证代码、ModelScope 分发、12 GB GPU 目标 | 已发布 | 帖子, 模型页面 |
| Atlas | @drfeifei / World Labs | 用于图像、视频和 3D 生成的摄像机可控多模态世界模型 | 面向创意工具和机器人的稀疏视角重建与可控世界模拟 | 具备共享空间上下文的多模态自回归扩散 Transformer | Alpha | 帖子, World Labs 页面 |
最有意思的构建者模式,并不是“再做一个智能体”,而是围绕智能体的基础设施:评测 harness、基于证据的研究工作台、模型比较界面,以及公开 RL 训练配方。Open Paper 很能说明为什么这种模式重要:它的价值不在于能围绕 PDF 聊天,而在于让引用始终绑定到具体段落,支持项目级综合,并提供一套面向有依据科学问答的评测集。
SYLVA 突出在另一个维度。它的 README 明确表示,这片森林完全不包含任何下载来的美术素材;地形、树皮、植被、水面、天空和天气,都是在浏览器里通过 WebGL2 和 GLSL 实时生成的。这正是当下 AI Twitter 上一种清晰可见的独立构建者模式:发布代码,展示在线演示,让仓库本身证明说法成立。
Mercor 的 SkyRL 发布则处在成熟度光谱的另一端,但遵循了同样的建立信任逻辑。团队没有只发一张基准截图,而是公开了配方、权重、轨迹,以及昂贵大跑之前的降风险步骤。在这份数据集里,这种构建者式披露比泛泛的“新 SOTA”口号更受尊重。
6. 新内容与重点内容
摄像机几何成了一项一等产品主张
Atlas 的发布之所以值得关注,是因为它卖的不是“感觉更真实”的世界模型,而是把精确摄像机几何、稀疏视角重建和共享空间上下文当作核心抽象来卖。官方 World Labs 页面 提到可输出 1 分钟 1440p 视频,以及最少仅凭 1 张图像就能进行新视角合成。这让 Atlas 比一般图像模型发布更贴近真实的 VFX 和机器人工作流。支持证据来自 @drfeifei 和 World Labs 自己的发布页。
一款前沿网络安全模型在发布时公开谈论了明确的上线边界
OpenAI 围绕 Astra 的讨论之所以值得关注,是因为公开讨论不再把更强的攻击能力简单当成胜利。@testingcatalog 的推文以及链接的 Path to Astra 都把重点放在限制、阈值类别和后续私有评测上,而不只是 headline 分数。这说明公开 AI 话语正在发生一个重要变化:能力主张如今会和明确的上线约束一起出现。
面向知识工作的开放 RL 训练,复现性有了实质提升
Mercor 的 SkyRL 指南之所以值得关注,是因为它发布的不只是一个结论。结合 @edwardjhu 的推文、博客文章 和公开代码仓库,这项工作公开了一个 397B 知识工作智能体的训练步骤、环境选择、评测轨迹和模型权重。在充斥基准争论的信息流里,这样的复现程度格外醒目。
7. 机会在哪里
**+++] 以工作流为基础的评估与路由** — 证据涵盖第 1、2 和 4 节:[@AlexFinn 想要私有任务集,@MaorShlomo 把并排比较做进了 Base44,@gippp69 则强调了会考虑长会话和缓存状态的交互式路由基准。这个方向很强,因为痛点已经说得很明白,替代性做法反复出现,而现有产品仍然零散。
**++] 以引用为基础的知识工作助手** — [Open Paper 说明,市场对“始终贴着源文档”的助手确实有真实需求:它要能展示引用,并支持跨论文库的信息提取。这个机会是中等而不是最大,因为已经有可信产品存在,但需求可重复,工作流又是日常高频。
**++] 机器人数据清洗与回放基础设施** — [@juraucrypt 和 @Jaxon0x 都指向同一个缺口:只有当演示数据能够被清洗、回放并被信任,扩大物理 AI 数据规模才有意义。这个方向很强,因为它正处在更大机器人热潮的底层,却仍缺少简单、标准化的答案。
[+] 环境式多模态智能体的治理层 —— Meta 的 Muse 线程和 OpenAI 的 Astra 发布都暴露了同一个缺失层:对于持续聆听、持续观察或持续行动的模型,产品层面需要控制谁能查询、触发或升级。需求还在形成,但能力趋势已经先到了。
8. 要点
- 今天最强的发布动能来自专用多模态系统。 Meta 发布了实时语音感知,World Labs 推进了摄像机可控 3D 世界建模,ModelScope 推动了开放权重 TTS,Google 则把视频理解变成了一个会用工具的工作流,而不是静态帧采样器。(来源)
- 市场已经不再相信一次性基准图表能替真实工作选模型。 在最强的编码智能体帖子中,私有 harness、并排分支和会话感知路由,都比 headline 分数更有说服力。(来源)
- 网络安全能力如今是和明确的上线约束一起被讨论的。 无论是 Astra 的 Critical 阈值框架,还是 SafeMind 的专用红蓝闭环,都把控制层当作产品的一部分,而不是上线后的补救。(来源)
- 物理 AI 在看起来像硬件问题之前,仍然更像数据质量与回放问题。 最强的机器人相关推文聚焦的都是数据集规模、轨迹清洗,以及演示数据能否在评测后继续作为可用训练数据。(来源)
- 开放构建者只要拿出代码和轨迹,而不是口号,仍然更容易赢得可信度。 Open Paper、SYLVA 和 Mercor 的 SkyRL 配方,都因公开仓库、演示或可直接检查的评测材料而获得关注。(来源)