Twitter AI - 2026-09-05
1. 人们在讨论什么
1.1 基准测试之争,最终演变成“到底什么才能算证据”的争论(🡕)
AI Twitter 上当天最热的话题,不只是 GPT-6 Astra 和 Claude Fable 5.1 在各类排行榜上的名次变化,而是基准测试运营方、研究者和用户几乎用了一整天,重新协商“可信评测”到底应该是什么样。六条高信号内容共同指向同一转向:更多留出测试、更多面向工作流的专项基准,以及越来越多人怀疑任何公开榜单都很难长期保持可信。
@ArtificialAnlys 宣布(1,170 个赞,116 条回复,263,626 次浏览,207 个书签)称,Intelligence Index v4.2 新增了面向多周知识工作项目的 AA-Briefcase,以及面向 4,592 页文档推理的 GDP.pdf;同时将留出测试权重翻倍至 40%,并因 GPQA Diamond 已被刷透而将其移除。回复和首发帖同样重要:帖子补充称,Claude Fable 5.1 和 Opus 5 在 AA-Briefcase 上领先,GPT-6 Astra 在 GDP.pdf 上以 33.2% 领先,而 Astra 仍是前沿附近 token 效率最高的模型。

@cHHillee 认为(177 个赞,10 条回复,13,133 次浏览,17 个书签)称,社区过于关注各家实验室如何“benchmaxxing”,以至于忘了基准测试本身也可能为了吸引榜单关注而自我优化。最有力的回复并未全盘否定 Artificial Analysis 的这次更新,而是收紧了信任边界:有人直言,自己真正信任的只有“单任务成本”那张图。
@arena 报道(85 个赞,6 条回复,6,294 次浏览,11 个书签)称,GPT-6 Astra (Max) 以 1,797 分升至 Code Arena: WebDev 第一,领先 Claude Fable 5.1 (Max) 35 分,同时定价与其持平,都是 $40/Mtoken。引用转发进一步强化了这个观点:这次胜出更像是工作流层面的结果,而非基准测试技巧——在该类别其余投票尚未完成前,Astra 已经在 Data & Analytics、Consumer Product 和 Content Creation Tools 中领先。

@mercor 报道(78 个赞,1 条回复,3,672 次浏览,12 个书签)称,GPT-6 Astra 在 APEX-Accounting 的 Pass@1 和平均分上分别以 13.1% 和 60.0% 领先,超过 Fable 5.1 和 GPT-5.6 Sol。Mercor 和 Ramp 的公开 APEX-Accounting 页面 以及 排行榜 将该基准描述为真实的月末结账工作,涉及分类账、PDF、电子表格,以及 2,186 条由专家撰写的评分标准。这使它成为当天时间线上少数明确试图映射企业会计工作、而非抽象推理的基准测试主张之一。

讨论洞察: 回复和引用转发持续奖励那些公开工作流、成本或评分细节的基准测试,同时惩罚看起来像黑箱记分牌的基准测试。Docker 的可复现性讨论串和 Victor Taelin 的工程讨论串,也从不同方向强化了这种情绪。
与前一日比较: 2026-09-04,关于 Astra 的主要讨论集中在发布、token 效率,以及该模型是否变得更难监控。到了 2026-09-05,讨论重心又向外移了一层,转而关注:哪些基准测试能经受住前沿模型的适应,哪些公开榜单依然值得信任。
1.2 前沿模型的进步显而易见,但人们不断追问:模型到底理解了真实问题,还是只完成了表层任务(🡕)
第二条主线把真正令人惊艳的“wow moment”,和“输出质量不等于深层问题建模”的尖锐提醒放在了一起。四条强信号内容支撑了这种分裂。人们愿意为看得见的成果喝彩,但也不断用工程判断去检验这些成果。
@VictorTaelin 描述(471 个赞,42 条回复,27,659 次浏览,129 个书签)介绍了一项通宵实验:Claude Fable 5.1 和 GPT-6 Astra 都在 Bend2 中找到了正确的内存泄漏症状,但随后花了数小时去修分配器,却没有质疑其背后的调度器假设。Taelin 将 Fable 指向调度器的不对称性后,模型只做了一个很小的 lane rotation 修复,就把 2,000 次启动后的驻留内存从 555MB 降到 23MB,并把预计 OOM 从约 7,000 次启动推后到约 7,500 万次。他最有价值的一条回复把评测问题说得很明白:哪怕高质量解法只有在人类重新定义问题后才出现,基准测试仍可能把两款模型都算作“已解决”。
@scaling01 分享(385 个赞,6 条回复,23,718 次浏览,56 个书签)展示了四张 SVG 对比图,并称在这项任务上,GPT-6 Astra 让 Claude Fable 5.1 “看起来像去年的模型”。这条帖子理论阐释不多,但直接证据很强:每张图都展示了 Astra 生成的连贯场景,包括水面反射、景深、干净的几何结构和细微视觉细节,回复区的人也立刻点出了这些特点。


@cheatyyyy 作出回应(283 个赞,13 条回复,18,698 次浏览,33 个书签)则围绕另一张 GPT-6 Astra 生成的控制器 SVG 发问:一个纯文本系统怎么会“画出完美、栩栩如生的 SVG”?回复呈现出鲜明分裂:有人将其视为毋庸置疑的能力跃迁,也有人认为,复现 SVG 仍远比处理真实工程工作中的开放式歧义容易。
讨论洞察: 最有力的反驳并不是否认可见的进步,而是追问这些胜利能否迁移。Taelin 的讨论串给出了最具体的批评版本:模型可以诊断、测量、迭代,但仍可能错过那个让解法变得简单的问题框架。
与前一日比较: 2026-09-04,最响亮的能力宣称大多来自基准图表和与厂商立场一致的解读。到了 2026-09-05,讨论转向可直接检视的产出物和案例研究,然后又立刻拿真实工程标准去检验它们。
1.3 具身 AI 被框定为数据工程问题:来源、浏览器运行时与可移植性(🡕)
具身 AI 的讨论依然很强,但变得更具体了。五条帖子都在强调,难点已经不再是说“机器人数据很重要”,而是如何搭建一套跨浏览器、模拟器、策略栈和后续硬件都能持续运转的数据采集与验证系统。这是当天最清晰的跨多帖收敛之一。
@LisaFlorentina8 比较(8 个赞,9 条回复,327 次浏览)回顾了近期的机器人训练数据管线,并称 Axis Robotics 之所以突出,是因为它把采集范围、共识/来源追踪以及纠错方法,当作产品的一等组成部分。她的信息图把差异讲得很清楚:Axis 不只是从私有实验室或机器人机群中采数据,还试图通过浏览器遥操作和人工把关的纠错机制,扩大贡献者基础。

@Phuc50103413 认为(62 个赞,75 条回复,114 次浏览)称,对 Axis Robotics 来说,浏览器不只是前端,而是机器人技术栈本身的一部分。他引用 Axis Weekly 的说法称,DAgger Round 2 在三个随机种子下将配对评测成绩从 68 提升到 78.3(满分 160);随后又指出更难的问题:有些策略从 Python 迁移到基于浏览器的 WASM 后仍会掉性能。这意味着,只有在运行时具备足够可移植性、能让学到的行为在迁移后保留下来时,众包采集才真正有意义。
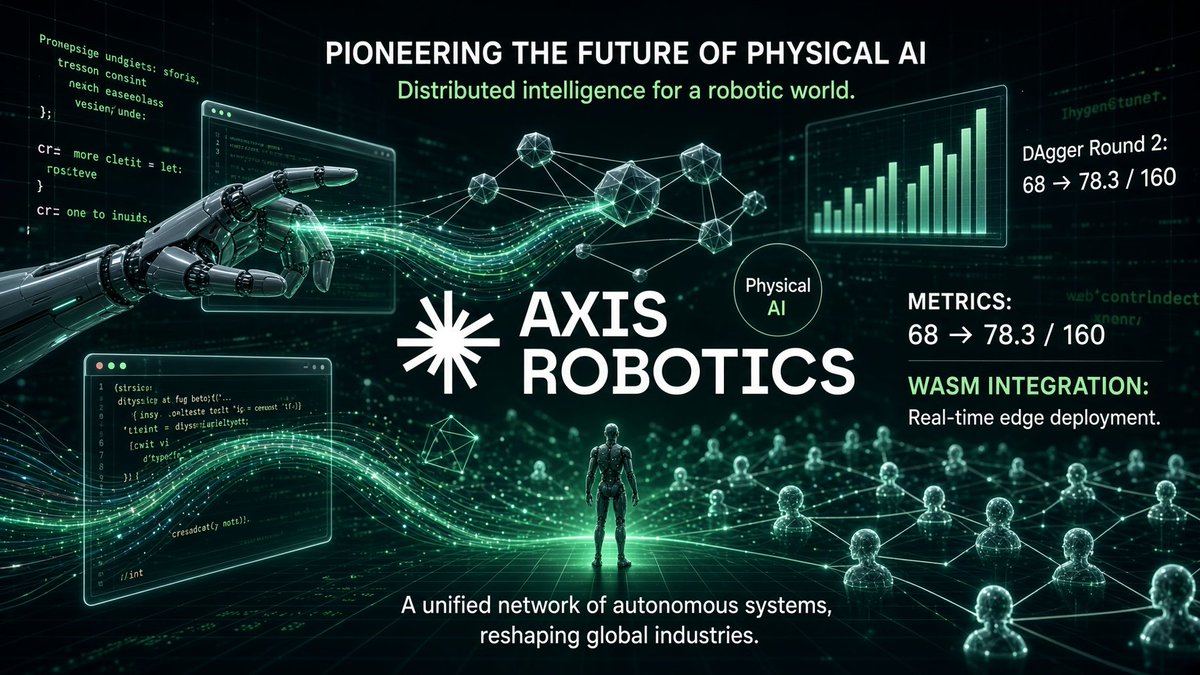
@tagsincos 认为(24 个赞,26 条回复,161 次浏览)称,只有当真正的护城河是生成器网络,而不是被冻结的数据集时,开源数据集、训练代码和基准测试才讲得通。@kengdaica 扩展了(19 个赞,17 条回复,146 次浏览)则进一步推进这一逻辑:真正的质量门槛是互操作性——在一个技术栈中采集到的经验,迁移到 DreamZero、LIBERO Pro、Isaac Sim 以及后续硬件后,仍然要有用。公开的 AXIS 论文 也把这一框架具体化,介绍了基于浏览器的 MuJoCo-WASM 遥操作、207 项任务、50K+ 条轨迹,以及受控扩展快照:随着数据集增大,LIBERO-Plus 成功率从 84.7% 提升到 88.8%。
讨论洞察: 反复出现的循环是“策略失败 -> 人工纠正 -> 下一版策略进步”,但新变化在于作者把注意力放在哪里。他们关心的已不是原始下载量,而是来源追踪、运行时一致性,以及同一批数据能否在其他工具链里继续有效。
与前一日比较: 2026-09-04,具身 AI 讨论强调的是更大的数据集和更强的基准测试。到 2026-09-05,讨论进一步钻入了众包数据究竟如何采集、验证、迁移和复用。
1.4 构建者持续在模型周围交付“运行层”:可复现性、性能、研究工作流与经济信任(🡕)
另一个强主题是,模型本身正越来越被当作更大运行层里的一个组件。七条内容共同支撑了这一判断。构建者真正投入的具体精力,落在公开仓库、运行时封装、验证界面和信任基础设施上,而不只是宣称某个模型比另一个更聪明。
@gpusteve 分享(67 个赞,8 条回复,2,308 次浏览,70 个书签)介绍了 Wafer 的 AI Performance Engineering 仓库,并表示团队接下来会逐项带大家过一遍相关资源。公开的 README 也证实,该仓库是一套结构化课程,覆盖 GPU 基础、内核优化、推理引擎、分布式推理和当前硬件,因此它与其说是炒作帖,不如说是实打实的工具和学习信号。
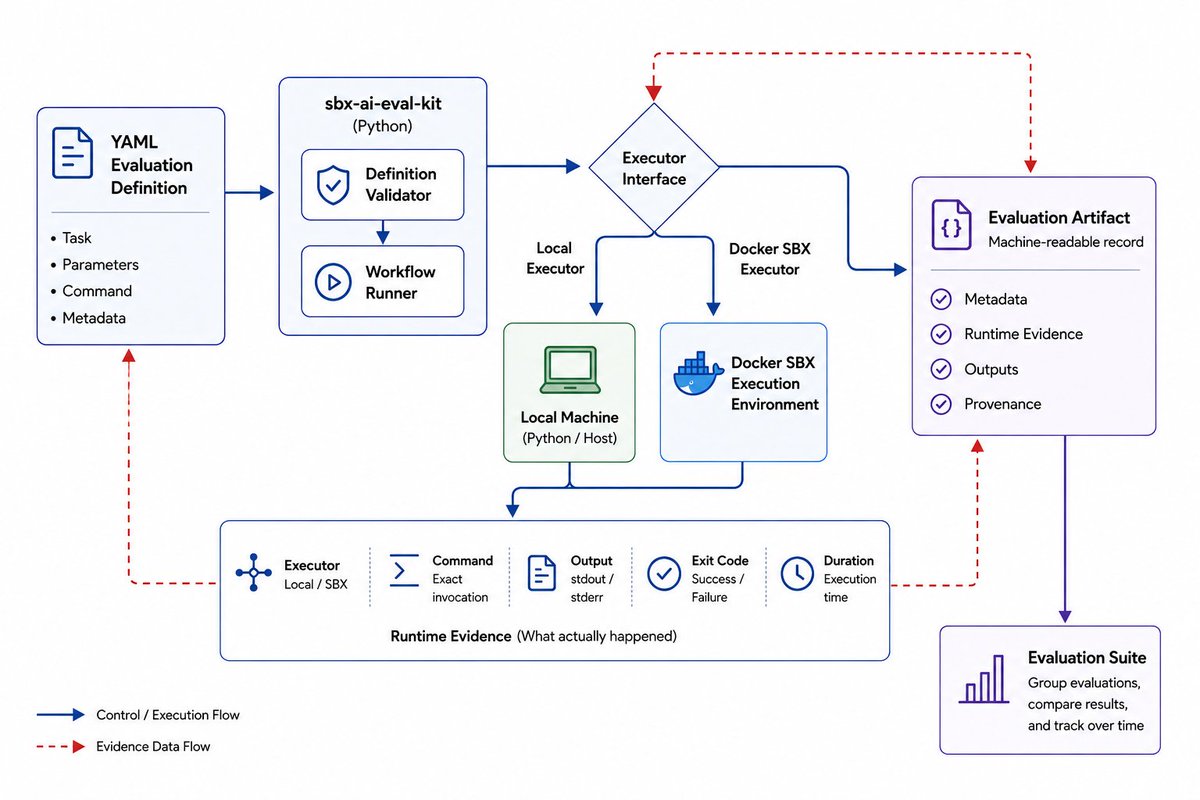
@Docker 强调(12 个赞,1 条回复,3,191 次浏览,2 个书签)则指出了同一问题的另一面:即便评测定义本身很好,如果没人能在同样的环境里重跑,仍然很难信任。Docker 的公开 SBX 工作流说明 描述了 YAML 定义的评测、隔离沙箱执行以及结构化运行时证据,让团队比较的是“实际跑了什么”,而不是“原本打算跑什么”。
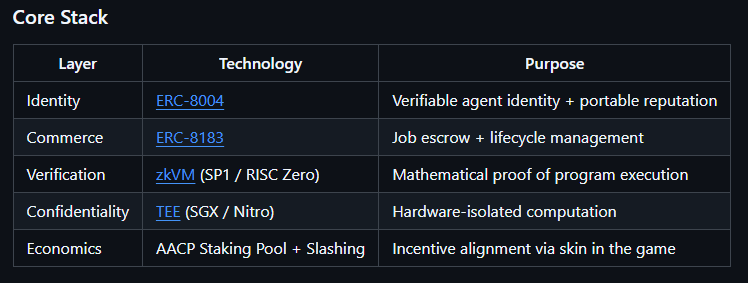
@Etheliaeth 认为(36 个赞,31 条回复,306 次浏览)称,在智能体商业里,稀缺资产可能不是支付能力,而是交易历史。附带表格把他认为关键的技术栈列得非常具体:ERC-8004 身份、ERC-8183 任务托管、zkVM 或 RISC Zero 验证、TEE 机密性,以及围绕 AACP 的质押/惩罚经济机制。
@nokaramo 概述(42 个赞,35 条回复,418 次浏览)描述了他想看到的完整智能体对智能体任务流程:发布、发现、竞价、托管、交付、评估、结算和信誉。@Loreen2074591 推动(27 个赞,17 条回复,301 次浏览)则把这个想法再往前推了一步,称报价流可能比模型基准测试更有用,因为它会在验证后揭示研究、代码审查、清理等数字劳动的真实价格。
@DanKornas 分享(1 个赞,3 条回复,520 次浏览)介绍了 OpenSwarm——一个开源编排器,可将 Linear 或本地任务接入 Worker/Reviewer 流程、可插拔通知和按仓库划分的记忆。他还单独 分享(3 个赞,1 条回复,488 次浏览,1 个书签)介绍了 Polaris——一个面向研究实验室的 Web 应用,依托持久化、人工把关的 “Voyage” 运行时,将工作从文献调研一路带到论文评审。这两个案例里,真正有意思的都不是底层模型,而是让模型可操作、可落地的工作流封装。
讨论洞察: 构建者的共同本能,是把“状态”显式化。无论这种状态是运行时产物、仓库记忆、交易历史,还是有人类把关的研究工作流,产品边界都在不断从模型本身向外移动,转向模型周围的系统。
与前一日比较: 2026-09-04,构建者的精力主要集中在控制平面和自修复循环。到了 2026-09-05,这股能量又扩展到公开性能工程仓库、可复现评测栈、研究工作流系统,以及智能体市场的信任基础设施。
2. 什么让人感到沮丧
基准测试赢了,却很难让人信任、重跑,或映射到真实工作
严重程度:高。@ArtificialAnlys 不得不重新设计(1,170 个赞,116 条回复,263,626 次浏览,207 个书签)围绕留出测试、已刷透的基准和评分修正重新设计了指数,而 @cHHillee 立即警告(177 个赞,10 条回复,13,133 次浏览,17 个书签)则指出,基准测试本身也可能为了榜单关注而优化。@VictorTaelin 展示(471 个赞,42 条回复,27,659 次浏览,129 个书签)给出了实际症状:即便模型给出的修复方案臃肿且更差,基准测试仍可能判定任务已解决。Docker 的公开 SBX 工作流说明 又从另一个角度补上了运营层面的痛点:即便评测设计良好,只要执行环境漂移,比较就会变得困难。人们当前的应对方式,是偏向留出测试、面向工作流的专项基准,以及可复现的运行时产物。这是非常值得直接建设的方向。
具身 AI 的数据闭环在浏览器、模拟器和下游技术栈之间丢失保真度
严重程度:高。@Phuc50103413 明确指出了浏览器运行时问题(62 个赞,75 条回复,114 次浏览)指出,即便 DAgger Round 2 改善了配对评测,一些策略从 Python 迁移到基于浏览器的 WASM 后仍会损失性能。@LisaFlorentina8 将其界定为(8 个赞,9 条回复,327 次浏览)把更广泛的问题归结为采集范围、来源追踪和方法论;@kengdaica 认为(19 个赞,17 条回复,146 次浏览)则指出,如果数据只能在采集它的那个技术栈里发挥作用,其价值就会大打折扣。公开的 AXIS 论文 进一步说明,这不是表面问题:该平台明确在尝试把基于浏览器的遥操作、增强和基准复用,纳入一个可成长的数据引擎。这是非常值得直接建设的方向。
智能体市场仍无法证明该信任谁、工作值多少钱,以及结算该怎么做
严重程度:高。@Etheliaeth 认为(36 个赞,31 条回复,306 次浏览)称,缺失的关键资产是可信交易历史,而不只是钱包;@nokaramo 阐明(42 个赞,35 条回复,418 次浏览)列出了仍然缺失的整套基础设施:发现、竞价、托管、验证、结算和信誉。@Loreen2074591 补充说(27 个赞,17 条回复,301 次浏览)则称,报价流可能比模型基准测试更有用,因为验证后的成交价格能揭示研究、代码审查或清理工作的真实成本。当前的应对方式仍主要停留在概念架构,而非经过验证的市场行为。这是非常值得直接建设的方向。
有用的本地 AI 仍伴随着令人不适的“速度 vs 上下文”权衡
严重程度:中。@DogukanUrker 记录了(28 个赞,2 条回复,1,118 次浏览,22 个书签)介绍了在单张 RTX 3060 上运行 Qwen3.8-27B 的两套折中方案:一套是 158K 上下文、22 tok/s,另一套是 82K 上下文、38 tok/s。他的帖子还提到,在 2-bit 量化下调高推理设置,模型可能会一路失控而不终止——这是真正的可用性故障,而不只是基准测试里的怪现象。人们目前通过为不同工作负载维护多套调优配置来应对,但挫败感很明显:即便开源模型已能在本地可用,上下文长度、解码速度和稳定性之间仍要彼此牺牲。这值得投入建设。
3. 人们希望存在什么
在模型和基准作者都开始适应之后,依然有意义的评测
人们想要的不是又一次榜单刷新,而是一套评测机制:即使前沿实验室开始朝着它训练,即使基准运营方开始围绕这种压力重构,它依然能提供有效信息。@ArtificialAnlys 通过留出测试和更偏工作流的任务朝这个方向迈了一步,@cHHillee 认为即便如此也必须保持警惕,而 Docker 的公开 SBX 工作流说明 则把可复现执行纳入同一个答案。这是一个有即时需求的现实问题。机会:直接。
能广泛采集、保留来源,并在跨技术栈迁移后仍能存活的机器人数据系统
具身 AI 相关讨论实际上要的不是又一个数据集 dump,而是一个数据引擎。@LisaFlorentina8 想要更广泛的采集和更完整的来源追踪,@Phuc50103413 想要浏览器与研究运行时之间的等价性,@kengdaica 想要经验迁移到不同模拟器和策略栈后仍能有效。公开的 AXIS 论文 展示了这个系统的一部分,但时间线上的愿望,是一个更完整的运行层。对构建者来说,这既现实又紧迫。机会:直接。
具备托管、验证阶梯、报价历史和可复用信任的智能体市场
围绕 TermiX 的社区兴趣,本质上是在请求市场基础设施。@nokaramo 想要发现、竞价、托管、交付和结算;@Etheliaeth 想要能沉淀为可信经济记忆的交易历史;@Loreen2074591 想要一个能揭示经验证数字劳动真实价格的报价流。这个方向很实际,但仍偏推测,因为所期待的网络效应尚未被证明。机会:竞争性。
更好的低成本基础设施,用于在本地或开放控制下运行严肃模型
本地 AI 和基础设施相关帖子,实际上是在要一套技术栈:让开源或自托管模型易于比较、运行便宜,并能在不同工作负载下保持稳定。@DogukanUrker 展示了在单张 RTX 3060 上平衡上下文与吞吐仍需多少手动调优,而公开的 Wafer AI Performance Engineering README 之所以存在,也正因为人们仍需要一条结构化路径,去理解推理机制、内核、调度和分布式服务。这是一个既有现实需求、也有构建者需求的问题,但赛道正在变得拥挤。机会:竞争性。
保持本地数据、语言和决策权完整的主权型垂直 AI
LingoAI 的讨论指向了与编程和基准测试不同的另一种未满足需求:面向公共部门和医疗场景的 AI 系统,不必被迫在能力和数据依赖之间二选一。@LingoAITech 把高血压护理、本地语言数据集,以及“AI 负责检测和建议;授权专业人士负责决策”整合进同一架构;LingoAI 的公开 Jokkolabs Banjul 合作帖子 则通过 Mandinka、Wolof 和 Fula 数据集以及私有部署,描述了相同方向。这在某些领域和地区是现实需求,但相较于前述评测和基础设施问题,更偏愿景。机会:愿景型。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| GPT-6 Astra | 前沿模型 | (+/-) | 在 Code Arena: WebDev 中领先,在 APEX-Accounting Pass@1 中排名第一,并在 Artificial Analysis v4.2 中展现出很强的 token 效率 | 用户仍质疑基准测试的可信度,而 Victor Taelin 的案例研究认为,它错过了导向最佳修复方案的问题框架 |
| Claude Fable 5.1 | 前沿模型 | (+/-) | 在 Artificial Analysis 总榜和 AA-Briefcase 中领先,在对提示敏感的创意任务上仍具竞争力 | 在一些工作流专项对决中输给 Astra,也未能通过 Taelin 的通宵 bug 修复框架测试 |
| Qwen3.8-27B GSQ-RCO IQ2_XS | 本地开源模型 | (+) | 可在单张 RTX 3060 上运行,提供 158K 上下文或更快的 82K 解码,为构建者提供一条可行的本地路径 | 用户仍需在上下文和速度之间二选一,而且 2-bit 量化下更高的推理设置可能失控打转 |
| LLM-as-a-Verifier | 验证框架 | (+) | 允许同一开源模型同时生成并评分候选轨迹,在 Terminal-Bench V2、SWE-Bench Verified、RoboRewardBench 和 MedAgentBench 上取得强结果 | 需要多次候选运行,并额外投入验证预算,才能释放这些收益 |
| Docker Sandboxes / SBX AI Evaluation Kit | 评测基础设施 | (+) | 隔离依赖、将评测定义与执行分离,并记录运行时证据以支持重跑 | 增加了团队必须维护的工作流与环境配置开销 |
| AXIS 浏览器遥操作 + 数据集管线 | 机器人数据引擎 | (+/-) | 通过浏览器控制、来源追踪、任务生成和可增长快照,扩大机器人数据采集 | 浏览器/WASM 一致性和跨技术栈可移植性看起来仍是开放技术风险 |
| Wafer AI Performance Engineering 仓库 | 工程资源 | (+) | 为实践者提供从 GPU 基础到服务、分布式推理和当前硬件的结构化学习路径 | 它是参考和课程,不是开箱即用的服务系统 |
| OpenSwarm | 智能体编排器 | (+) | 将 Linear 或本地任务接入 Worker/Reviewer 流程,支持多家提供商、通知和仓库记忆 | 早期开源编排仍要求配置 provider 身份验证、Node 工具链和运行环境 |
| Polaris | 研究工作流系统 | (+) | 将文献、想法、实验、写作和评审统一进一个持久化、人工把关的流程 | 更适合愿意采用完整工作流系统的实验室,而不太适合轻量级个人使用 |
| AACP / TermiX primitives | 智能体商业技术栈 | (+/-) | 身份、托管、验证、结算和报价历史,为市场提供了更明确的信任模型 | 核心问题——交易历史是否能在单一市场之外转化为可复用信任——仍未被证明 |
| Holon Agent System | 领域 AI 架构 | (+/-) | 围绕隐私、本地数据所有权和人工参与的临床决策,整合生物特征、记录和生活方式上下文 | 目前证据仍主要停留在架构和合作阶段,而非大规模公开部署 |
工具层面的图景,远不是“哪个模型最好”,而更像是“每类工作最合适的运行层是什么”。@ArtificialAnlys 展示(1,170 个赞,116 条回复,263,626 次浏览,207 个书签)称,Astra 在前沿附近拥有异常高的 token 效率;而 @DogukanUrker 展示(28 个赞,2 条回复,1,118 次浏览,22 个书签)则表明,严肃使用开源模型仍高度依赖手工配置与权衡。实际上的分化在于:一部分人通过前沿 API 购买能力,另一部分人则试图自己掌控成本、上下文长度或可复现性。
这些变通办法都很具体。Docker 的公开 SBX 帖子 以执行隔离和运行时证据为中心;公开的 Wafer 仓库 则把性能学习从单请求推理组织到分布式系统;OpenSwarm 和 Polaris 都把编排、记忆和评审当作产品界面。贯穿其中的迁移趋势是:模型选择依然重要,但更持久的差异化越来越多地转移到了模型周围的 harness 上。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| AXIS 数据引擎 / Axis Hub | Axis Robotics | 基于浏览器的机器人遥操作、任务生成、轨迹处理和可增长的操作数据集 | 具身 AI 团队需要比封闭实验室采集更丰富、可复用的机器人数据 | 浏览器 MuJoCo-WASM 遥操作、轨迹过滤、IsaacSim 增强、版本化数据集快照 | Beta | AXIS 论文,LisaFlorentina8 的推文,Phuc50103413 的推文 |
| AI Performance Engineering 仓库 | Wafer | 面向 GPU 性能工程和生产推理的公开课程与参考资料集 | 团队需要先理解吞吐、延迟、内核、KV 缓存和分布式推理,才能高效运行模型系统 | 涵盖 CUDA、内核、推理引擎、服务基准和硬件文档的 GitHub 资源列表 | Shipped | 仓库,推文 |
| OpenSwarm | Intrect | 带有 Worker/Reviewer 流程的自主代码工作者编排器 | 开发者不想手工搭好多智能体任务路由、评审、记忆和通知 | Node CLI、Codex/GPT、OpenRouter、Ollama/LM Studio、Claude Code、LanceDB | Beta | 仓库,推文 |
| Polaris | ZJU REAL Lab | 从文献调研到论文评审的端到端 AI 研究 Web 应用 | 研究实验室在文献、想法评审、实验、写作和验证之间切换多种工具时会损失大量时间 | Research Wiki、GPU/SSH 实验运行器、LaTeX 写作器、引文检查、持久化 Voyage 运行时 | Beta | 仓库,推文 |
| LLM-as-a-Verifier | Stanford / Berkeley / NVIDIA 研究人员 | 面向智能体任务的同模型轨迹排序与验证框架 | 开源模型需要一种比“直接调用更强闭源模型”更便宜的验证闭环 | Best-of-N 候选生成、持续验证评分、概率式锦标赛选择、RL 奖励 | Alpha | 项目,论文,推文 |
| TermiX / AACP commerce layer | @termix_ai | 智能体对智能体的任务发现、托管、验证、结算和信誉框架 | 有能力的智能体仍需要信任、定价和经济协同基础设施 | 智能体身份、竞价、托管、验证阶梯、结算、信誉、报价历史 | Beta | nokaramo 的推文,Etheliaeth 的推文,Loreen2074591 的推文 |
| 面向冈比亚医疗的 Holon Agent System | LingoAI | 将生物特征、病历和生活方式上下文与本地化语言模型结合的主权健康数据架构 | 资源受限的医疗部署需要隐私、本地控制和明确的人类决策权 | Holon 个人本体、可穿戴设备/血压监测仪、本地语言数据集、私有/微调模型 | RFC | 合作帖子,推文 |
反复出现的构建模式是:团队正在把“能力周围那一层”产品化,而不只是产品化能力本身。AXIS 把数据采集、来源追踪和任务覆盖做成产品;OpenSwarm 把路由、评审和记忆做成产品;Polaris 把持久化工作流和人工把关做成产品;TermiX 则把信任、结算和市场发现做成产品。
另一个值得注意的模式是,多个构建者都在明确尝试把评测本身变成产物的一部分。LLM-as-a-Verifier 把自验证做成可复用方法,而 AXIS 和 Polaris 都把进展与结构化检查点和公开标准绑定。与前几天相比,这些构建更不像 demo,更像是把 AI 工作转化为可审计系统的尝试。
6. 新进展与值得关注的内容
开源自验证正成为“用更强模型”之外的严肃替代方案
@jiqizhixin 披露了(7 个赞,541 次浏览,8 个书签)介绍了 Stanford 的 LLM-as-a-Verifier 结果:DeepSeek V4 Flash 先生成五条候选轨迹,再用同一模型充当验证器进行排序。公开的 项目文档 之所以让它值得关注,是因为该方法在 Terminal-Bench V2、SWE-Bench Verified、RoboRewardBench 和 MedAgentBench 上拿到了 state-of-the-art 结果,却不需要更强的闭源模型来当裁判。

在消费级硬件上做严肃本地推理,正变得更具体
@DogukanUrker 分享(28 个赞,2 条回复,1,118 次浏览,22 个书签)介绍了一套在单张 RTX 3060 上运行 Qwen3.8-27B 的基准配置,包括一套 158K 上下文版本和一套更快、由 MTP 辅助的 82K 版本。它之所以值得关注,是因为截图把权衡说得很明白,而不是含糊其辞:构建者可以在更多上下文和更高速度之间二选一,但这种权衡仍需手工完成。

主权型 AI 医疗从抽象原则走向了具名部署模式
@LingoAITech 认为(416 个赞,27 条回复,152,801 次浏览,8 个书签)称,在资源受限环境中,医疗 AI 需要数据主权、本地化语言模型,以及“AI 负责检测和建议;授权专业人士负责决策”。LingoAI 的公开 Jokkolabs Banjul 合作帖子 之所以值得关注,是因为它把这套表述落实成了围绕 Mandinka、Wolof 和 Fula 数据集、能力建设以及在冈比亚私有部署的具体计划。
真实会计工作进入了公开基准测试视野
@mercor 将(78 个赞,1 条回复,3,672 次浏览,12 个书签)把 APEX-Accounting 推到了时间线前台。这一基准围绕分类账、PDF、电子表格,以及评分标准密集的月末结账任务构建。它之所以值得关注,是因为它让公开 AI 讨论更接近买方真正愿意付费的工作,也更远离泛泛的学术记分牌。
7. 机会在哪里
**+++] 可复现、难以被刷分的评测系统** —— 当天最强烈的信号都指向这里:[@ArtificialAnlys 围绕留出测试重构了指数,@cHHillee 警告说基准测试本身也会朝自我优化方向漂移,@VictorTaelin 展示了基准测试如何错过解法质量,而 Docker 的公开 SBX 说明 则直接切中了可重跑问题。这是时间线上最清晰的多源痛点。
**+++] 物理 AI 数据引擎** —— [@LisaFlorentina8、@Phuc50103413、@tagsincos 和 @kengdaica 都从不同角度说明,瓶颈在于结构化、可移植、可验证的机器人数据。公开的 AXIS 论文 进一步表明,这已经不只是模糊的研究主题,而正在成为真实的构建类别。
**++] Agent 间信任与价格发现** —— [@Etheliaeth、@nokaramo 和 @Loreen2074591 收敛到同一个需求:托管、验证、可复用历史,以及能揭示数字劳动真实市场价格的报价。机会确实存在,但这个领域仍在证明这些信任信号能否形成可防御的网络效应。
**++] 具备成本意识的开放与本地推理工具链** —— [@DogukanUrker 表明,严肃的本地部署仍需要在上下文和速度之间做手工权衡,而公开的 Wafer 仓库 之所以存在,也正因为周边的性能问题仍然棘手。这个机会有现实意义,但竞争正在加剧。
**+] 面向医疗和公共服务的主权领域 AI** —— [@LingoAITech 和 LingoAI 的公开 Jokkolabs Banjul 帖子 指向了对本地保留语言数据、隐私和决策权的系统需求。这个信号虽不如评测和机器人相关讨论强,但它独立而且在受监管行业中可能更持久。
8. 要点
- 评测设计成了主线,而不只是模型排名。 Artificial Analysis 围绕留出任务调整了指数,用户质疑基准测试是否仍值得信任,而可复现性也上升为一项一等要求。(来源,来源,来源)
- 前沿模型的进步是真实的,但人们越来越把“可见输出质量”和“问题框架质量”分开看。 Astra 的 SVG 输出让时间线印象深刻,但 Victor Taelin 的通宵调试故事表明,决定性的失误模式仍可能是“没有质疑前提”。(来源,来源)
- 具身 AI 的讨论越来越像在谈数据基础设施,而不是机器人硬件。 最强的机器人相关帖子聚焦于浏览器遥操作、来源追踪、运行时一致性,以及训练技术栈之间的互操作性,而非机器人形态本身。(来源,来源,来源)
- 更持久的构建者动能,正在转向模型周围的 harness。 Wafer、OpenSwarm、Polaris 和 Docker 都指向同一个方向:性能、编排、验证和工作流状态,正越来越成为工程工作的主体。(来源,来源,来源)
- 智能体商业在成为规模故事之前,首先是信任问题。 最有实质内容的市场相关帖子讨论的,是托管、验证、报价历史和可复用的交易信誉,而不是 token 价格或智能体数量。(来源,来源,来源)