Twitter AI - 2026-09-06
1. 人们在讨论什么
1.1 AI 教育与上手培训已经成为独立的产品类别(🡕)
最明显的新趋势并不是又一条模型发布帖,而是一波帖子在讨论:AI 仍然需要更好的入门路径,包括面向特定领域的练习环境、经过整理的代码库地图,以及针对智能体构建者的正规培训。三条高热度内容共同支撑了这一主题,而且都具体谈到了如何把学习内容打包成产品,而不只是泛泛地说人们应该多学习。
@ChrisHayduk 发布(212 个赞,17 条回复,8,545 次浏览,171 个收藏)宣布 BioTorch 开启公开测试,并指出生物 AI 仍然缺少一条像通用 LLM 工作那样清晰易懂的学习路径。这条帖子格外具体:包含 116 个 PyTorch 练习、17 份模型指南,目标是让人们通过动手实现,而不是被动阅读,来理解 AlphaFold2、ESM2 和 RFdiffusion 等系统。链接中的 BioTorch 网站 进一步介绍称,该产品是一个练习工作区,提供原始张量练习、隔离式代码执行、进度保存和自适应复习排程。

@BharukaShraddha 分享(63 个赞,2 条回复,2,820 次浏览,81 个收藏)分享了一份面向 AI 工程师的十个代码库入门地图,按照实际工作内容组织学习路径:LLM 原理、推理、本地模型、RAG、智能体和多供应商 API。这条帖子不只是罗列名称,还建议读者选定一条路径并动手构建;其中链接的代码库,如 动手实践大语言模型、LLM 课程 和 GenAI_Agents,都提供了大量可运行材料,而非宣传文案。

@databricks 定位为(37 个赞,5 条回复,2,413 次浏览,16 个收藏)把“上下文工程师”定义为一种真正的职业技能,而不是一个松散的流行词。其链接的 认证相关文章 表示,测试版考试专门聚焦上下文工程,并配套教授智能体基础、检索和评估。这让教育主题超越了自学:AI Twitter 上的一部分人正在尝试正式界定,什么才算合格的智能体开发工作。
讨论洞察: BioTorch 帖子下最有价值的回复并不是泛泛的称赞,而是立即延伸出一套具体的蛋白质设计流程,涉及 RFdiffusion、ProteinMPNN、ColabFold 和后续筛选。这表明,受众更认可那些能直接连接生产或实验室实践的学习工具。
与前一天比较: 2026-09-05,构建者的关注点集中在性能工程代码库、可复现评估和研究工作流系统上。到了 2026-09-06,重点又向漏斗前端前移了一步,转向人们如何进入专业化 AI 领域,以及智能体构建技能应如何传授。
1.2 人们仍然高度怀疑基准测试,但相比再次批评基准,更关心如何改进评分与测试框架设计(🡒)
对基准测试的不信任依然无处不在,但更有意思的帖子开始尝试用更好的方法取代糟糕的评估习惯。四条内容共同呈现出同一种模式:实验室发布的分数单独来看被视为薄弱证据,而代码质量、测试框架设计和独立公开测试则被视为更有希望的方向。
@NateSilver538 认为(207 个赞,18 条回复,31,197 次浏览)认为,实验室发布的基准测试大多是公关材料,真正重要的只有模型在实际使用场景中的表现。回复并没有简单附和,而是让这一观点变得更复杂:有人同意自报图表不过是新闻稿,也有人认为,当没有人针对某个团队的确切工作负载进行基准测试时,不完美的代理指标仍可作为筛选工具。
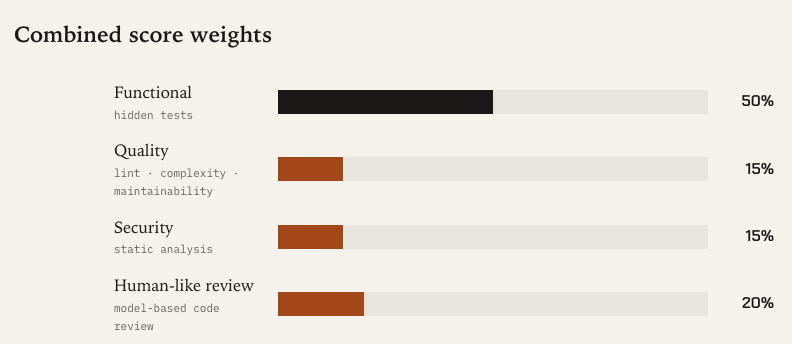
@morganlinton 提到(58 个赞,4 条回复,4,263 次浏览)在 VulcanBench-SWE v4 中给出了更具体的回应:现在有 20% 的分数来自代码质量,因为即使通过隐藏测试,团队仍可能得到难以维护的脆弱代码。引用的基准测试图片清楚展示了这一变化:评分权重分布在功能性隐藏测试、质量、安全性和类人工评审之间,而不再只看任务是否完成。
@HuggingPapers 重点介绍(10 个赞,3 条回复,931 次浏览,12 个收藏)介绍了 StarHarness,这是 ServiceNow 提出的一种方法:保持模型权重不变,转而围绕模型演进智能体脚手架。链接中的 论文摘要 表示,该框架可以包含提示词、工具接口、技能、由 MCP 驱动的提供商、子智能体和循环配置;帖子及配图声称,它在企业基准测试中带来了 20-35 分的提升,同时最多可降低 53% 的推理成本。

@DavidPawlan 表示(34 个赞,3 条回复,2,389 次浏览,15 个收藏)表示,他正在对 40 个 AI 助手进行 14 项基准测试,并将公开全部结果。这件事的重要性不在于尚未公布的数字,而在于它反映出的需求:时间线显然更希望看到独立的对比工作,而不是供应商叙事。
讨论洞察: 最有价值的分歧并不是“基准测试好”与“基准测试坏”的二选一,而是基准测试究竟应该是狭窄的代理指标、考虑维护性的评分卡,还是公开的并排测试。这比简单地追捧排行榜更健康。
与前一天比较: 2026-09-05,关于基准测试的争论集中在新排行榜发布,以及它们是否仍然可信。2026-09-06,讨论转向重新设计评分机制本身,并将测试框架,而不仅是模型,纳入评估目标。
1.3 智能体工作持续向控制平面、持久化工作流界面和自验证循环上移(🡕)
另一个强势主题是,AI Twitter 持续将模型视为更大操作系统中的一层。三条帖子从不同角度汇聚到同一个观点:状态应当持久化,工作流应当保持可检查,智能体应能根据参考内容验证自己的工作,而不只是输出结果。
@MengTo 展示(170 个赞,10 条回复,9,727 次浏览,152 个收藏)展示了 Astra 仅凭提示词生成详细的 three.js 界面和产品风格的 3D 场景。真正让这条帖子具有分析价值的是回复:多人表示,比较循环才是真正的突破;MengTo 还回复称,智能体可以持续将结果与参考内容对比,甚至为性能较弱的浏览器移除高成本特效。重点不只是“看看这个漂亮的 UI”,而是“验证循环正在成为提示词界面的一部分”。
@github 将其定义为(24 个赞,4 条回复,6,985 次浏览)介绍了将画布作为持久化界面,用于跟踪执行过什么、发生了什么变化,以及哪些内容仍待审核。链接中的 GitHub 博文 说得比推文更明确:聊天适合表达意图,却不适合承载持久化执行;明确的工作流状态、保存的草稿和人工审批节点,才是让智能体工作可治理的模式。
@DanKornas 分享(11 个赞,6 条回复,781 次浏览)介绍了 MATE,这是一个基于 Google ADK 或 LangGraph 构建的开源智能体控制层。链接中的 仓库 证实了推文中的运营定位:支持实时配置、存储在数据库中的版本化智能体定义、按智能体划分的 RBAC、令牌分析、MCP 兼容,以及无需再次部署即可进行回归评估。

讨论洞察: GitHub 的画布帖子和 MATE 帖子下的回复都强调了同一层细节:只有当每次状态变化都能追溯到产生它的运行或制品时,持久化界面才真正有用。仅有可见性还不够,缺失的关键放大器是来源追踪。
与前一天比较: 2026-09-05,构建者在发布可复现性层、研究工作流封装和信任护栏。2026-09-06,同一种倾向表现为更明确的工作流状态、更实时的智能体控制,以及对自检循环的更大重视。
1.4 糟糕的软件和物理 AI 对数据的饥渴,带来了现实检验(🡒)
最激烈的能力讨论,反复被两个顽固约束拉回现实:在普通客户流程中仍然故障频发的遗留软件,以及仍然缺乏足够累积型数据的物理 AI 系统。这是两个完全不同的领域,但情绪相同:模型进步并不能消除系统工程工作。
@GergelyOrosz 写道(198 个赞,17 条回复,17,736 次浏览)认为,当一个普通的 2026 年移动订阅流程仍因后端无法处理常见情况而需要长时间打电话时,AI 末日论就显得不那么有说服力。他后续的帖子进一步明确指出:AI 也许能帮助团队更快修复软件,但它不会凭空诊断并修复机构本身的混乱。
@BarabiloT 认为(34 个赞,33 条回复,223 次浏览)认为,物理 AI 真正的瓶颈是数据,而不是模型或硬件。配图通过对比碎片化的机器人数据集、脆弱的演示,以及由生成世界、人工行为采集、优化和失败驱动再训练组成的“Axis”循环,完成了大部分解释工作。

讨论洞察: Gergely 的回复很快转向了对更好支持工具的产品需求,而 BarabiloT 帖子的回复则不断用不同措辞重复同一观点:每次失败都应转化为更好的数据采集目标。两条讨论都不在抽象智能,而在混乱系统周围的反馈循环。
与前一天比较: 2026-09-05,关于物理 AI 的讨论集中在来源追踪、可移植性和浏览器运行时。2026-09-06,表述变得更加直接,形成了一个更鲜明的产品判断:通用机器人仍需要更好的数据引擎,就像主流软件仍需要有人理顺失效的工作流一样。
2. 人们感到沮丧的地方
基准测试只告诉你模型赢了,却不告诉你这项工作是否值得信任
严重程度:高。@NateSilver538 认为(207 个赞,18 条回复,31,197 次浏览)认为实验室基准测试大多是公关材料;而 @morganlinton 提到(58 个赞,4 条回复,4,263 次浏览)指出了更实际的失败模式:模型可以通过隐藏测试,却仍给团队留下可维护性债务。@HuggingPapers 补充说(10 个赞,3 条回复,931 次浏览,12 个收藏)则提出了另一种工程层面的抱怨:围绕固定模型改变测试框架,就能让企业得分提升 20-35 分,这意味着许多基准结果测量的部分是环境适配度,而非模型的原始质量。人们正在通过要求代码质量评分、考虑测试框架的评估,以及独立公开对比来应对这一问题,例如 @DavidPawlan 规划(34 个赞,3 条回复,2,389 次浏览,15 个收藏)所做的 40 个助手测试。这一方向非常值得构建。
智能体工作流消失在聊天记录中,或每次调整都必须重新部署
严重程度:高。@github 表示(24 个赞,4 条回复,6,985 次浏览)认为需要画布,因为单靠聊天会掩盖执行过什么、发生了什么变化,以及哪些内容需要审核。@DanKornas 描述(11 个赞,6 条回复,781 次浏览)则从构建者角度表达了同样的痛点:提示词、模型、访问规则和层级结构的变化,仍然经常意味着修改代码并重新部署。两条讨论下的回复又提出了更棘手的问题:即便有了仪表盘,团队仍需要将每次状态变化追溯到产生它的运行或制品。这个方向非常值得构建。
无论叠加多少 AI 乐观情绪,软件在结构上仍然失灵
严重程度:高。@GergelyOrosz 使用(198 个赞,17 条回复,17,736 次浏览)用一个普通的移动订阅流程说明:即使到了 2026 年,糟糕的软件质量仍然是客户问题。最能说明问题的回复并非哲学讨论,而是一个直接的产品需求:“面向移动订阅企业的移动优先版 Intercom”。与此同时,@IntCyberDigest 转发并放大(57 个赞,7 条回复,4,207 次浏览,14 个收藏)转述了 Bjarne Stroustrup 的批评:AI 生成的代码会变得臃肿、容易出错且难以验证;回复则强调,审查者不足才是瓶颈。人们并不是在拒绝 AI 帮助,而是在指出,仍然需要有人理解、验证并修复系统。这一方向非常值得构建。
物理 AI 仍然缺乏足够的累积型数据,无法摆脱脆弱演示
严重程度:中。@BarabiloT 表示(34 个赞,33 条回复,223 次浏览)认为,限制因素是机器人数据,而不是模型数量或硬件新闻。他的配图和回复都指向同一种应对策略:生成更多世界,采集更多人类行为轨迹,并将每一次策略失败都转化为下一批有针对性的数据。令人沮丧的是,这仍然是基础设施工作,而不是像互联网规模文本那样已经解决的数据输入流。这一方向值得构建,但今天的证据更像是在指向一个正在形成的基础设施需求,而非眼下的商品化市场。
3. 人们希望存在什么
更好的专业化 AI 领域和智能体工程入门路径
人们想要的不是更多泛泛的激励,而是一条进入困难子领域的路径,其中已经明确列出工具、练习和复习循环。@ChrisHayduk 呼吁(212 个赞,17 条回复,8,545 次浏览,171 个收藏)希望有一条更清晰的生物 AI 入门路径,而 BioTorch 正是围绕这一问题构建的;@BharukaShraddha 归类(63 个赞,2 条回复,2,820 次浏览,81 个收藏)则按结果组织了 AI 学习代码库,例如 RAG、本地推理、多供应商 API 和智能体工作流。@databricks 采取了(37 个赞,5 条回复,2,413 次浏览,16 个收藏)又将同样的需求转化为企业语境,把上下文工程变成一种可认证的技能。机会:直接。
反映团队实际使用助手方式的独立评估
最强烈的未满足需求,是一种无需相信供应商说法、读者也能信任的评估方式。@NateSilver538 拒绝(207 个赞,18 条回复,31,197 次浏览)将实验室基准测试视为公关材料;@morganlinton 推动(58 个赞,4 条回复,4,263 次浏览)希望评分纳入代码质量;@DavidPawlan 明确承诺(34 个赞,3 条回复,2,389 次浏览,15 个收藏)则计划对 40 个助手和 14 项基准测试进行公开测试。人们似乎既不想完全取消基准测试,也不想要没完没了的图表,而是希望看到与真实工作流、可维护性和环境适配度相关的公开比较。机会:直接。
具备来源追踪、审批和持久化状态的智能体控制平面
多条帖子从不同成熟度层面围绕同一需求展开。@github 认为(24 个赞,4 条回复,6,985 次浏览)希望有画布,因为智能体工作需要一个持久化的共享界面;@DanKornas 认为(11 个赞,6 条回复,781 次浏览)则认为提示词和访问权限的变化不应要求重新部署。两条帖子的回复都揭示了剩余缺口:人们希望有明确的审批节点,并能从每一次变化清晰追溯到触发该变化的运行。这是一个实际需求,而非理想化愿景,但竞争已经开始加剧。机会:竞争激烈。
能解决混乱现实流程的服务软件,而不只是生成更好的输出
@GergelyOrosz 投诉(198 个赞,17 条回复,17,736 次浏览)中隐藏的需求很直接:请修好那些让普通客户任务变得痛苦不堪的系统。一条回复直接要求为移动订阅企业提供更好的支持产品。与智能体控制需求不同,这并不是一个新的 AI 原生类别,但如果将 AI 辅助的修复、诊断和工作流清理与特定高摩擦行业绑定,仍可能成为有力的切入点。机会:直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| GPT-6 Astra | LLM | (+/-) | 在视觉和浏览器生成方面广受认可;能够驱动比较与验证循环,支持迭代式 UI 工作 | 原始基准测试的胜出表现一再被认为不足以证明真实世界质量 |
| StarHarness | 智能体测试框架方法 | (+) | 无需改变模型权重,就能让企业基准得分提升 20-35 分,并将推理成本最多降低 53% | 需要针对具体环境演进测试框架,而不是简单替换模型 |
| VulcanBench-SWE v4 | SWE 评估系统 | (+) | 在基准评分中加入代码质量、安全性和类人工评审 | 仍然是基准测试,因此只有在团队信任其权重和评审机制的情况下才有帮助 |
| GitHub Canvases | 工作流界面 | (+) | 让工作流状态、决策和审批节点持久化,而不是埋没在聊天中 | 相关博客称,优秀的画布需要前期设计投入和令牌消耗 |
| MATE | 智能体控制平面 | (+/-) | 支持实时配置、按智能体划分的 RBAC、令牌分析、MCP 兼容,以及无需重新部署即可进行回归评估 | 回复指出,来源追踪和工作器状态同步仍是未解决的运营风险 |
| BioTorch | 学习平台 | (+) | 将生物 AI 概念转化为原始 PyTorch 练习,并提供隔离执行、进度跟踪和自适应复习 | 专注于基础构件和练习,而非完整的端到端模型复现 |
| RFdiffusion -> ProteinMPNN -> ColabFold | 生物 AI 工作流 | (+) | 提供从骨架生成到序列设计和结构验证的具体路径 | 后续仍依赖自定义筛选、QC 脚本和大量人工判断 |
| Hands-On LLM / LLM Course / GenAI_Agents | 学习资源 | (+) | 为构建者提供进入 LLM 原理、部署、RAG、工具调用和多智能体工作流的可运行路径 | 相关建议是选择一个狭窄方向并动手构建,这意味着资源过载仍然是风险 |
| vLLM / llama.cpp / LiteLLM | 推理与可移植性层 | (+) | 反复被提及为可扩展服务、本地推理和多供应商抽象的技术栈 | 被视为重要基础构件,但单独来看并不是完整的工作流解决方案 |
总体而言,人们对脚手架和工作流基础设施的满意度最高,而不是对纯粹的模型品牌最满意。共同的应对方式是在模型周围增加结构:比较循环、持久化画布、测试框架调优、明确的评估机制或更丰富的控制平面。最接近迁移趋势的并非特定供应商,而是一种方法论变化:人们正在从仅依赖聊天和原始基准截图,转向持久化工作流状态、考虑代码质量的评分,以及面向特定技术栈的学习路径。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| BioTorch | Chris Hayduk | 面向生物 AI 的练习工作区,通过实现来教授模型组件 | 生物 AI 缺少从兴趣到实际贡献的清晰路径 | PyTorch、隔离式代码运行器、自适应复习、进度历史 | Beta | 帖子 · 网站 |
| MATE | Dan Kornas | 面向生产环境 AI 智能体的控制层和仪表盘 | 提示词、模型、访问权限变更和评估不应要求修改代码并重新部署 | Python、Google ADK、LangGraph、LiteLLM、MCP、RBAC、评估 | 已发布 | 帖子 · 仓库 |
| GitHub Canvases | GitHub | 面向智能体任务的持久化共享工作流界面 | 仅依赖聊天的智能体工作会隐藏计划、状态、审批和审核节点 | GitHub Copilot 应用画布、工作流状态、持久化草稿、审批门 | 已发布 | 帖子 · 博客 |
| VulcanBench-SWE v4 | VulcanBench | 不只评估任务完成度的 SWE 基准测试 | 仅通过隐藏测试无法反映可维护性和安全质量 | 隐藏测试、代码质量评分、静态安全检查、类人工评审 | 已发布 | 引文 · 源帖子 |
| StarHarness | HuggingPapers | 在企业环境中围绕固定模型演进测试框架的方法 | 工具丰富的智能体任务中,模型与环境不匹配 | 提示词和任务设计、工具接口、技能、MCP 提供商、子智能体、循环配置 | RFC | 帖子 · 论文 |
BioTorch 是当下“教育到构建者”链路最清晰的例子。该产品有意保持狭窄:它不承诺实现完整的生物 AI 自动化,而是将这一领域拆解为可检查的张量操作、代码练习和模型指南,再与复习机制及练习历史连接起来。回复进一步明确了相邻工作流,提到了 RFdiffusion、ProteinMPNN、ColabFold 和自定义 QC,这正是人们预计下一步要学习的序列设计技术栈。
MATE 和 GitHub Canvases 从不同方向展示了同一种构建模式。两者都假设模型已经存在,真正尚未解决的是运营问题:对变更进行版本管理、展示工作流状态、分配权限、保留审核节点,并让上下文在长期任务中保持持久化。这一模式分别以开源和平台原生的形式独立出现,因此格外值得注意。
VulcanBench-SWE v4 和 StarHarness 又将这种“围绕模型构建”的倾向延伸到评估领域。前者通过纳入代码质量和类人工评审,改变了分数的含义;后者则在不改变模型权重的情况下调整外围测试框架,以减少模型与环境之间的不匹配。当天反复出现的触发点非常清晰:人们正在构建运行层,而不只是庆祝模型层。
6. 新鲜且值得关注的内容
上下文工程被视为一种有明确名称的职业
@databricks 使用(37 个赞,5 条回复,2,413 次浏览,16 个收藏)使用“上下文工程师”这一说法时,已经超越了营销文案。其链接的认证帖子称,该考试专门考察如何为生产级智能体整理记忆、检索和工具参数。这是市场开始将上下文处理视为正式技能,而不是模糊提示词习惯的最明确信号之一。
独立助手测试从抱怨变成了公开工作计划
@DavidPawlan 表示(34 个赞,3 条回复,2,389 次浏览,15 个收藏)表示,他已经在对 40 个助手进行 14 项基准测试,并将公开全部结果。这一点之所以重要,是因为它直接回应了当天的主要抱怨之一:如果读者不信任实验室评分卡,那么最明显的替代方案就是在实验室之外开展公开对比项目。
验证瓶颈被定义为人才资本问题
@IntCyberDigest 转发并放大(57 个赞,7 条回复,4,207 次浏览,14 个收藏)转述了 Bjarne Stroustrup 的观点:AI 生成的代码越来越难以验证,而资深评审者也厌倦了依赖提示词、不断漂移的输出。无论读者是否认同完整的批评,回复都反复回到同一个高价值观点:代码生成的价值,取决于其背后的审查能力。
7. 机会在哪里
[+++] Maintenance-aware evaluation and independent assistant testing — Evidence came from @NateSilver538 拒绝(207 个赞,18 条回复,31,197 次浏览)批评实验室的公关式评分卡;@morganlinton 推动(58 个赞,4 条回复,4,263 次浏览)讨论考虑代码质量的评分;@HuggingPapers 重点介绍(10 个赞,3 条回复,931 次浏览,12 个收藏)讨论测试框架演进;@DavidPawlan 规划(34 个赞,3 条回复,2,389 次浏览,15 个收藏)则聚焦公开测试。最强的机会并不是“更多基准测试”,而是能够捕捉可维护性、测试框架适配度和公开并排表现的评分机制。
[++] Agent control planes with provenance and durable review surfaces — @github 展示(24 个赞,4 条回复,6,985 次浏览)体现了人们对持久化工作流状态的需求;@DanKornas 展示(11 个赞,6 条回复,781 次浏览)则体现了对实时、无需重新部署的控制能力的需求。回复层面的细节让这一机会更明确:没有来源追踪的可见性,仍然会让团队不得不自行考古。
[++] Specialized AI training products that connect theory to runnable workflows — @ChrisHayduk 构建(212 个赞,17 条回复,8,545 次浏览,171 个收藏)介绍了生物 AI 练习界面;@BharukaShraddha 映射(63 个赞,2 条回复,2,820 次浏览,81 个收藏)列出了新手应使用的代码库栈;@databricks 形式化(37 个赞,5 条回复,2,413 次浏览,16 个收藏)则将上下文工程定义为一种资质。人们希望获得生物 AI、上下文工程、RAG、推理和智能体编排方面的引导式练习,而不只是“学习 AI”这种宽泛的信息。
[+] Physical-AI data engines and failure-driven collection loops — @BarabiloT 认为(34 个赞,33 条回复,223 次浏览)及相关 Axis 帖子认为,真正的壁垒在于将策略失败转化为下一轮更好的数据。今天的证据不如软件智能体讨论充分,但这一需求具体且持续存在。
[+] AI-assisted repair for mundane but costly enterprise workflows — @GergelyOrosz 展示(198 个赞,17 条回复,17,736 次浏览)指出,普通支持和运营商流程仍然糟糕到足以直接造成客户痛点。相比通用代码助手,这一机会更为狭窄,但需求信号异常具体。
8. 结论
- AI 教育是当天最强的产品方向之一。 BioTorch 的测试版发布、面向 AI 工程师的十个代码库地图,以及 Databricks 的上下文工程认证都表明,构建者希望获得进入专业化 AI 工作的引导路径,而不只是更广泛的认知。(来源)
- 关于基准测试的争论正变得更加偏向运营层面。 最有影响力的帖子不再只是嘲讽排行榜,而是在要求加入代码质量权重、考虑测试框架的评估,以及独立的公开比较。(来源)
- 智能体周围的运行层正在不断变厚。 比较循环、画布和控制平面都指向同一变化:有价值的工作越来越集中在工作流状态、审批、来源追踪和自检,而不只是文本生成。(来源)
- 现实检验仍然来自普通软件和机器人数据,而不是模型演示。 Gergely Orosz 的运营商客服案例和 Axis 数据引擎讨论都表明,混乱的系统工作仍然是瓶颈。(来源)
- 验证能力仍是 AI 编程普及的核心约束。 Stroustrup 帖子和 VulcanBench 的评分变化都指向同一点:如果团队无法高效信任或审查输出,模型能力的提升就无法顺畅转化为生产价值。(来源)