Twitter AI - 2026-09-07
1. 人们在讨论什么
1.1 AI 工作被打包成课程、可复用技能和工作流操作系统(🡕)
2026-09-07 最明显的讨论集群,并不是某个单一模型的发布,而是一波试图让智能体工作变得可教、可复现的帖子。@JayAlammar 发布(172 个赞,25 次转发,9 条回复,5,603 次浏览,148 次收藏)发布了《AI 智能体图解指南》,并表示他与 Maarten Grootendorst 花了 18 个月时间,让记忆、工具、规划、评估、多智能体系统和代码智能体这些概念变得清晰易懂。@AiwithDharmik 放大了(24 个赞,11 次转发,7 条回复,578 次浏览,7 次收藏)提到了 Anthropic Academy 的免费 18 门课程目录,而公开的 Claude 101 页面 也证实,这套课程如今已覆盖项目、技能、工具连接、企业搜索、研究和基于角色的使用场景。@Mohiniuni 补充道(33 个赞,2 次转发,1 条回复,491 次浏览,9 次收藏)则从实践者角度给出了同样的思路,列出 继续 和 Cline 等具体代码仓库,并告诉新手不要囤工具,而要“选一个,做点东西,把它弄坏,再修好”。
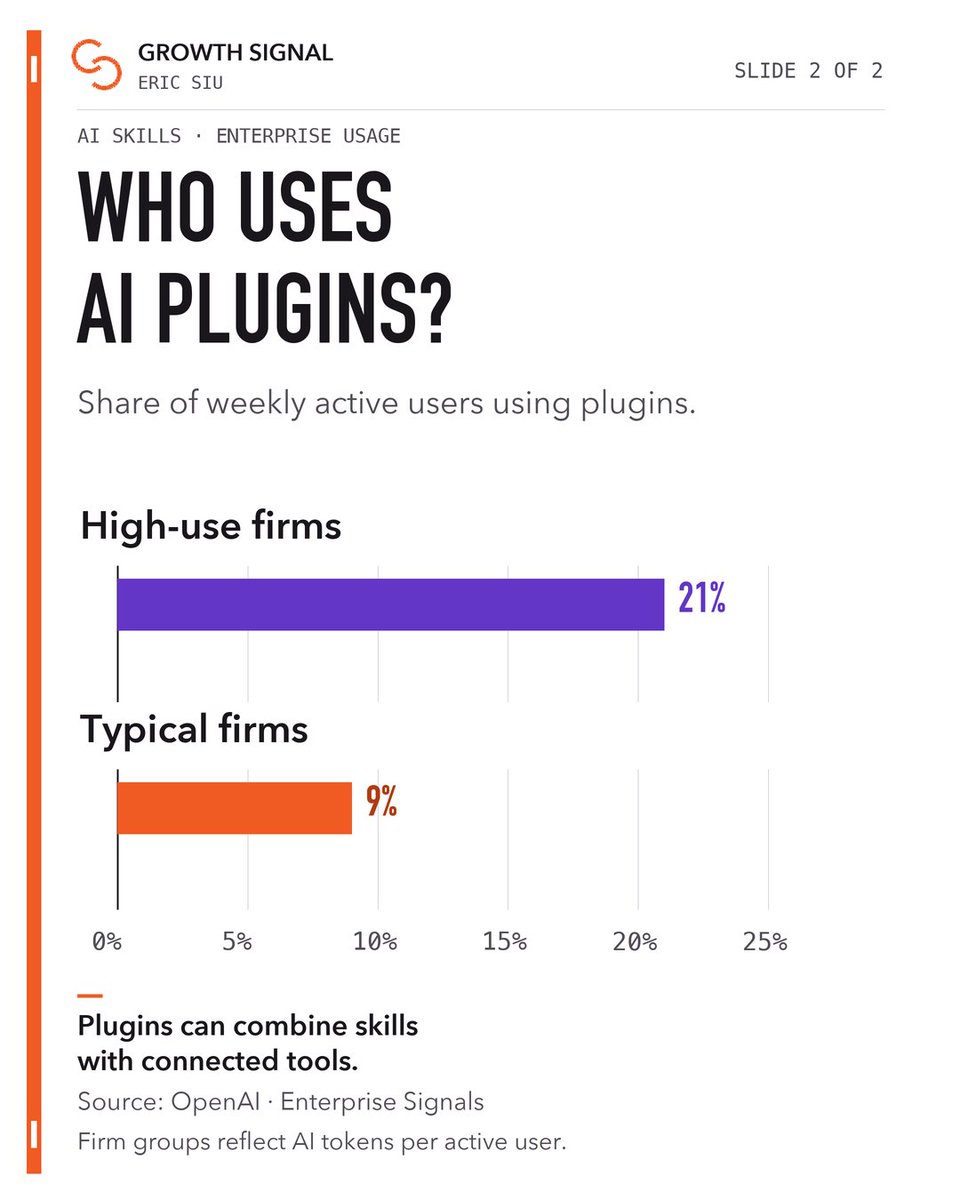
更明显的转变,是讨论从学习材料转向可复用的操作逻辑。@ericosiu 认为(2 条回复,292 次浏览)表示,如果一个团队每周都要向 AI 解释同一项任务,那这项任务就应该被沉淀为一种技能,明确输入、步骤、输出和检查项。他附上的 OpenAI Enterprise Signals 图表,让这件事听起来不再只是建议,而更像是一道采用鸿沟:高使用率企业的每周技能使用率为 19%,普通企业为 3%;每周插件使用率则分别为 21% 和 9%。@OreateAI 制作了(4 个赞,3 条回复,42 次浏览)则用更结构化的方式表达了同一点:智能体需要的不是“更好的提示词”,而是一个由上下文、约束、顺序、评估和责任归属构成的操作系统。


讨论洞察: 这一讨论集群里,最有启发性的回复并不是泛泛的祝贺。在 Jay Alammar 的发布帖下,读者马上讨论起智能体需要共享的词汇体系和否决点;在 Anthropic 课程讨论串下,人们则追问具体的学习顺序和项目深度。显然,大家真正想要的是能够脱离某位专家或某次对话、持续留存下来的操作知识。
与前一天比较: 2026-09-06,AI 教育主要表现为入门界面和垂直领域学习产品。到了 2026-09-07,讨论又深入了一层:如何把学习内容转化为可复用的每周技能、明确的工作流检查项,以及面向智能体的持久操作系统。
1.2 基准测试讨论变得更现实:只有当任务看起来像真实工作时,分数提升才有意义(🡕)
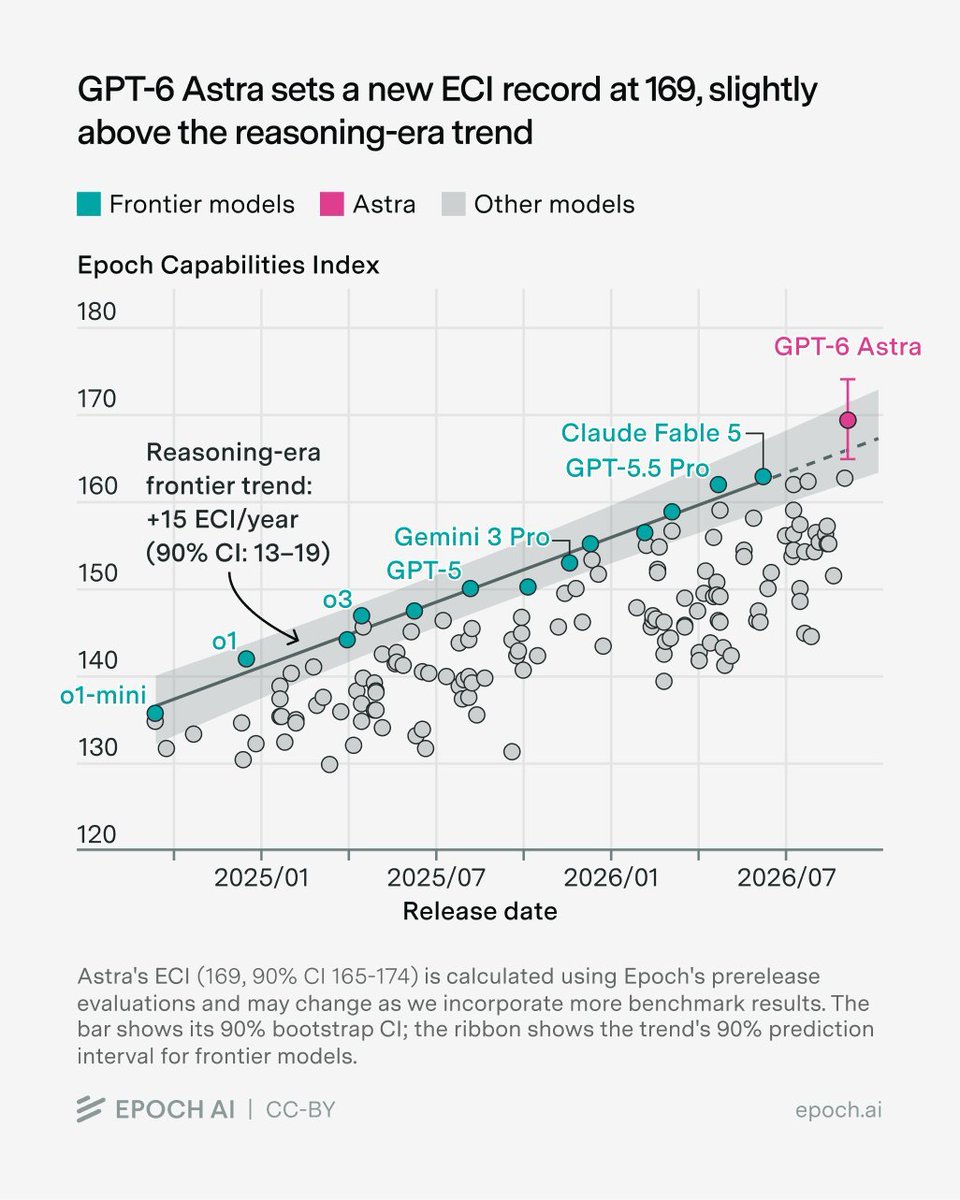
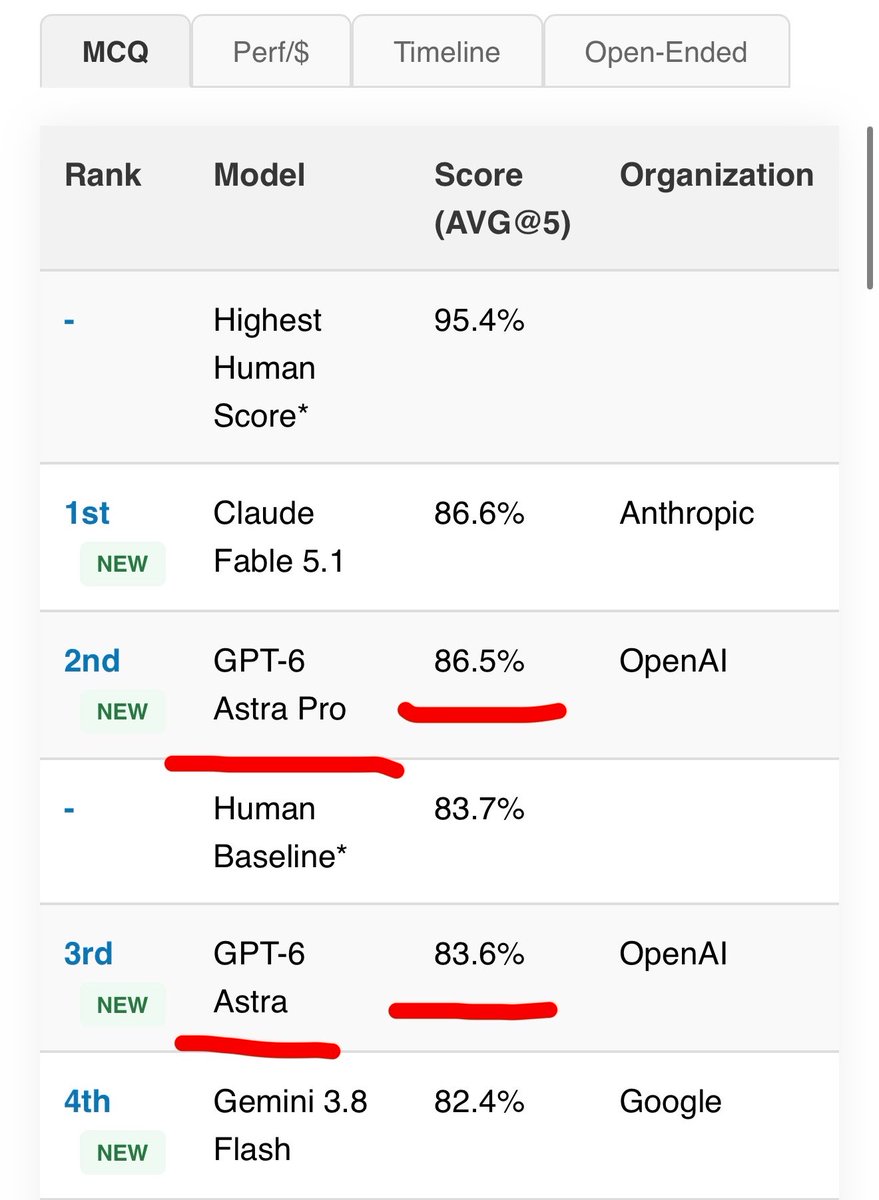
第二大主题并不是反基准测试的虚无主义,而是选择性地相信。人们仍会庆祝显著的模型进步,但前提是基准测试难以被“刷分”,或者任务看起来更像真实的客户项目或工程工作流。@IntCyberDigest 提出异议(192 个赞,27 次转发,28 条回复,24,940 次浏览,65 次收藏)针对 Jensen Huang 所说的“AGI 已经到来”发表评论,引用 Epoch 的公开认知表现趋势,认为 Astra 只是略高于既有曲线。附图进一步强化了这一判断:Astra 的 ECI 为 169,并没有呈现出明显的断层式跃升。与此同时,@ChrisGPT 称赞(120 个赞,2 次转发,9 条回复,8,580 次浏览,12 次收藏)提到 GPT-6 终于在 SimpleBench 风格的词语逻辑任务上超过了人类基线;配图截图显示,在所展示的切片中,Claude Fable 5.1 得分 86.6%,GPT-6 Astra Pro 得分 86.5%,人类基线为 83.7%。
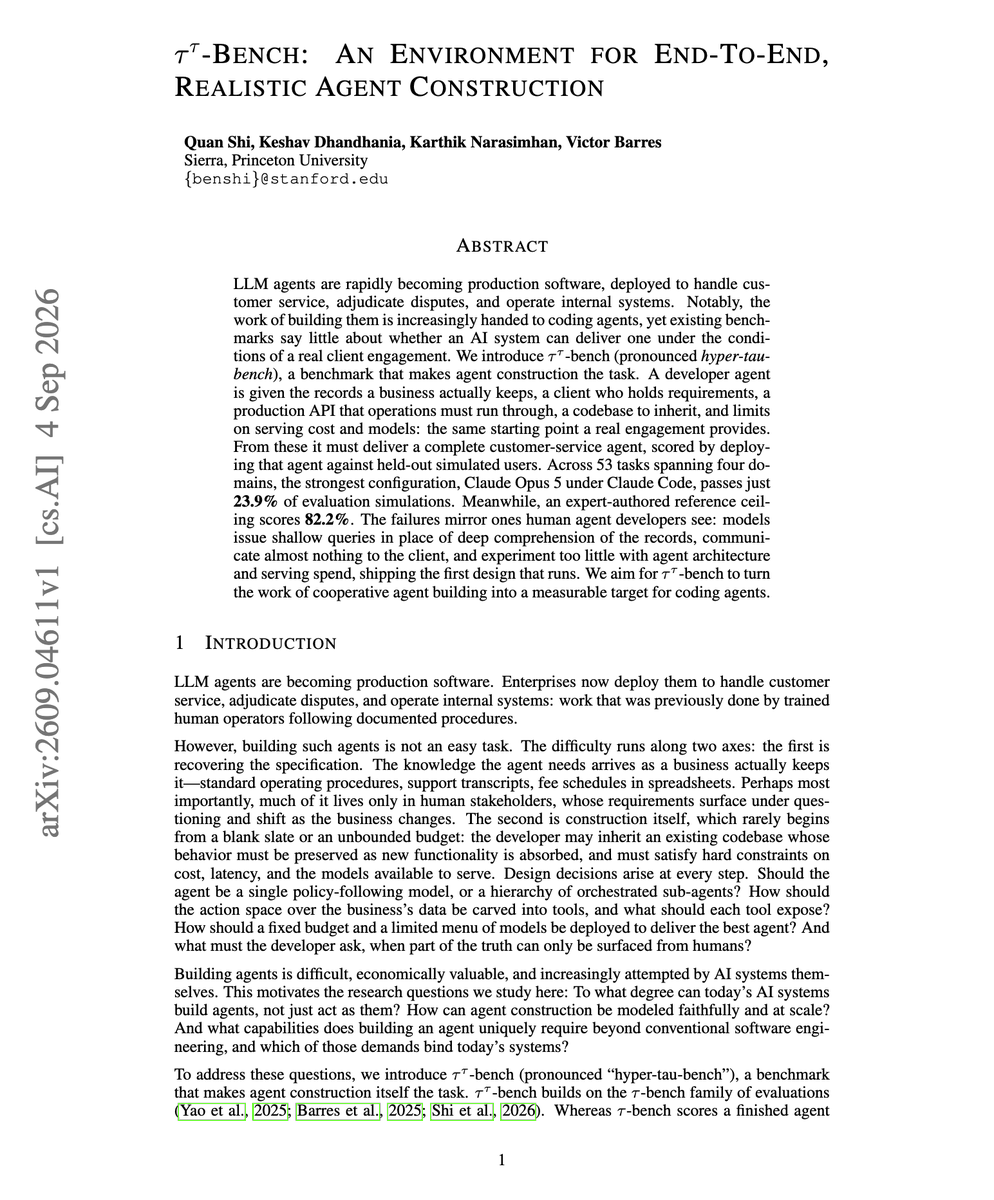
不过,真正最有分析价值的,是那些让评估变得更复杂的帖子。@dair_ai 分享了(16 个赞,1 次转发,8 条回复,2,114 次浏览,20 次收藏)介绍了 τ³-Bench:代码智能体必须阅读杂乱的业务记录、与客户沟通、处理生产约束,并交付一个可运行的客服智能体。相关的 dair.ai 摘要 和论文页面都支持帖子中的关键数字:覆盖 4 个领域的 53 项任务,最佳模型通过率为 23.9%,专家参考得分为 82.2%。@SKatalystAI 运行了(13 个赞,1 次转发,11 条回复,495 次浏览,2 次收藏)则提出了一个更接地气的公开对比:在一个混乱的代码仓库里埋入 9 个真实缺陷和 1 个误报陷阱。Fable 5.1 修复了 9/9 个真实缺陷,保住了那个需要克制不改的案例,并改动了 30 个文件;Astra 修复了 8/9 个缺陷,破坏了该克制案例,并改动了 68 个文件。

这种现实主义也延伸到了对智能体行为本身的讨论。@thdxr 总结道(73 个赞,4 次转发,14 条回复,3,333 次浏览,3 次收藏)用一句话概括:很多让智能体更好用的特性,反而会让它在基准测试里表现更差。他在回复中把问题说得更具体:读者批评了可验证奖励的术语体系、单智能体的简略作风,以及基准测试压力如何惩罚澄清性提问或更清晰的多步骤工作流。@dair_ai 补充道(24 个赞,5 次转发,7 条回复,2,812 次浏览,19 次收藏)则从方法论角度提出了另一条路径:一篇自我建模论文提出可验证的问题,询问修改提示词是否会改变模型答案,同时明确提醒,不应把更高的自我建模分数误认为内省能力。
讨论洞察: 这些帖子共同表达的诉求不是“不要基准测试”,而是“要能暴露判断力的基准测试”。当测试涉及克制、客户沟通、隐藏缺陷或可部署产物时,读者更愿意相信分数;单靠一条平滑曲线或厂商口号,很难获得同样的信任。
与前一天比较: 2026-09-06,评估讨论主要集中在评分权重和测试框架设计上。到了 2026-09-07,争论更贴近真实工程工作:基准测试是否包含杂乱上下文,智能体是否会提出好问题,以及它是否知道哪些地方不该改。
1.3 模型选择变得明确按任务区分,小模型和本地模型也更有可信度(🡕)
另一个明显趋势是,人们不再假设存在一个能处理所有任务的“最佳模型”。@shannholmberg 发布了(61 个赞,1 次转发,25 条回复,6,031 次浏览,66 次收藏)为营销工作详细设计了一套模型组合,给 Codex/GPT-5、GPT-6 Astra、Claude Fable、Claude Opus/Sonnet、Grok、Kimi K3、GPT Image 2 和 Seedance 2.5 分配不同职责。关键不在品牌忠诚,而在路由逻辑:Astra 负责浏览器工作流和编排,Fable 负责前端与架构,Grok 负责获取最新的 X 语境,Kimi 负责长篇研究综合。回复进一步表明,实践者正逐渐把“模型—任务匹配”视为一种常规操作模式。
小型开放模型也从这一转变中受益。@ArtificialAnlys 强调了(47 个赞,2 次转发,9 条回复,4,805 次浏览,8 次收藏)提到了 OpenBMB 的 MiniCPM5-2B:在更新后的 Intelligence Index 中,它是参数规模低于 4B 的开放模型里排名最高的一款。附图显示,它在该指数上得分 15,仅比 Ling 3.0 Tiny 低 1 分,而后者体量大约只有它的三分之一。回复串又补充了更贴近部署的细节:831 的 GDPval-AA v2 Elo,以及每项任务仅约 19k 个输出 token,这两点都对边缘端部署很有吸引力。@OpenMed_AI 翻译了(18 个赞,1 次转发,1,167 次浏览,9 次收藏)则把这种能力直接带入医疗场景:从临床记录中提取药物信息、核对来源,并在操作者自有硬件上借助工具完成计算。

本地模型这一主题也出现在模型改造和产品打包中。@TeksEdge 描述道(20 个赞,1 次转发,1,511 次浏览,20 次收藏)介绍了一个 Qwen3.8-27B “uncensored” 版本:据称,拒答行为从 98 个留出提示词中的 98 次拒答降至 12 次,而基准测试均值几乎没有变化,MTP 也在 GGUF 量化后得以保留。@pdp 展示了(2 个赞,3 条回复,129 次浏览,1 次收藏)则以产品形式体现了同样的本地主义倾向:CBK Studio 是一个桌面打包的开源编排界面,用于在本地运行自有模型。
讨论洞察: 这里最重要的回复都很务实。在模型组合讨论串下,人们称赞 Grok 获取最新语境的能力,也默认接受了“一种模型包打天下”的时代已经结束。在 MiniCPM 的讨论里,token 效率几乎和原始分数同等重要,因为人们已经开始考虑边缘端预算,而不只是排行榜名次。
与前一天比较: 2026-09-06,讨论仍主要聚焦于控制平面、测试框架和工作流界面,而不是模型本身。到了 2026-09-07,模型层重新成为焦点,但讨论的已是路由与部署问题,而不是谁通吃全场。
1.4 壁垒体现在分发、基准目录、运行速度和打包产品上(🡕)
最后一个主题是,构建者不断讨论模型质量之外的周边优势。@mal_shaik 逆向工程了(13 个赞,2 次转发,4 条回复,1,260 次浏览,25 次收藏)分析了 Vercel 在 AI 搜索中的可见度,并认为真正的壁垒不是品牌被提及的次数,而是可被链接引用的文档。附图显示,Vercel 的引用份额为 46.5%,Cloudflare 为 29.4%,Netlify 为 20.6%;相关的 对比中心、Next.js Learn 和 AI SDK 文档 也让这一机制更清楚:逐项功能对比页面、长篇教程,以及针对具体模型的实现指南,恰好回答了 AI 搜索系统最可能引用的那些问题。

基础设施构建者则从不同方向做着同样的事。@gonzalo_io 推出了(35 个赞,4 次转发,8 条回复,1,499 次浏览,25 次收藏)介绍了 Voice AI Benchmarks,这是一个开放目录,收录语音、语言、轮次衔接和完整语音智能体的基准测试。@xieenze_jr 声称(94 个赞,13 次转发,10 条回复,17,755 次浏览,87 次收藏)表示,Sol-H3 可以在 8× B300 上用 1.653 秒生成 5 秒、1344×768 的立体视频;公开的 Sol-H3 基准页面 和 Reactor 沙盒 也支持其“快于播放速度”的核心说法。在下游,产品构建者正把这些基础设施封装成更简单的界面:@MaxHirsch13 主推(9 个赞,1 次转发,2 条回复,440 次浏览)推出了一个集锻炼、食谱和记录于一体的“智能体教练”,而 @pdp 主推 则主打一个本地智能体 IDE,而不是又一个云端聊天封装。
讨论洞察: 在 Vercel 分析下,最犀利的一条回复指出,引用份额更多取决于文档深度,而不是品牌体量。这句话很好地概括了更广泛的情绪:AI Twitter 反复把对比内容、基准目录、运行时工程和产品打包,当作本身就具战略意义的杠杆。
与前一天比较: 2026-09-06,构建者的精力主要集中在工作流可见性和基准测试重构上。到了 2026-09-07,讨论扩展到了分发系统、运行速度和产品打包,说明围绕壁垒的讨论正超越模型本身的原始能力。
2. 人们感到沮丧的地方
仍然跳过协作环节的基准测试和 AGI 叙事
严重程度:高。@IntCyberDigest 使用了(192 个赞,27 次转发,28 条回复,24,940 次浏览,65 次收藏)引用 Epoch 的趋势线,认为“AGI 已经到来”是一种叙事跃迁,而不是干净利落的基准测试结论。@dair_ai 做出了(16 个赞,1 次转发,8 条回复,2,114 次浏览,20 次收藏)借助 τ³-Bench 明确指出了更棘手的问题:当前的代码智能体仍然只是浅层阅读业务记录、很少向客户提问,并交付第一个能跑起来的设计。@SKatalystAI 展示了(13 个赞,1 次转发,11 条回复,495 次浏览,2 次收藏)则以更小的尺度呈现了同样的缺口:Astra 改动的文件数量超过 Fable 的两倍,却仍然漏掉了一个预埋缺陷和一个需要克制不改的案例。@thdxr 补充道(73 个赞,4 次转发,14 条回复,3,333 次浏览,3 次收藏)则指出,一些用户实际喜欢的智能体行为,反而可能拉低基准测试分数。人们不满的不是评估本身,而是那些把判断、澄清和克制统统压平的评估。这是一个值得直接去做的方向。
重复性工作仍然停留在人脑里,而不是沉淀为可复用技能
严重程度:高。@ericosiu 明确说明了 点出了真实的运营痛点:如果每周一都得重新解释一项任务,那这套工作流就还没有被真正沉淀下来。@OreateAI 将其定义为 把同一问题表述为缺少上下文、约束、顺序、评估和责任归属;@JayAlammar 间接回答了 则试图让整个智能体技术栈本身变得清晰可懂。即便是 @AiwithDharmik 和 @Mohiniuni 发布的课程与代码仓库清单,看起来也像是在应对同一个问题:隐性知识太多,而可持久复用的打包太少。这是一个值得直接去做的方向。
“一种模型包打天下”的工作流,对自有数据或成本敏感型场景仍然太粗糙
严重程度:中。@shannholmberg 把模型选择视为针对不同专业任务的路由,而不是对某个赢家的效忠;这通常说明没有任何单一工具能干净利落地满足全部需求。@ArtificialAnlys 和 @OpenMed_AI 指出了应对办法:使用可在自有硬件上运行的小型开放模型,并用工具、来源核验和领域逻辑把它们包起来。@TeksEdge 更进一步,展示出人们已经在手动调整拒答行为和本地量化配置,以得到自己想要的表现。更底层的挫败感在于,对很多应用型工作流来说,前沿模型依然太贵、太泛化,或者太不透明。这是一个值得投入的方向。
面向终端用户的产品里,AI 工作流仍然割裂,或绕了奇怪的弯路
严重程度:中。@nitzukai 作出了回应(138 个赞,13 次转发,60 条回复,11,272 次浏览,45 次收藏)针对 Astra in Blender 的演示,提出了一个不太客气但很有用的问题:用户为什么还要等 AI 像人一样去操作 Blender,而不是直接拿到自己想要的素材或最终输出?回复进一步把问题说得更尖锐,焦点落在 token 开销、本地渲染延迟和可疑的经济逻辑上。在消费端,@MaxHirsch13 抱怨健身、食谱和记录还得分散在不同应用里;@pdp 则把 CBK Studio 明确定位为一个无需额外设置的本地打包产品。人们仍然会奖励那些把过多步骤压缩进同一界面的产品,因为碎片化问题依然没有解决。这是一个值得投入的方向,但现有证据更像是在寻找早期产品方向,而不是一个已经成熟的品类。
3. 人们希望存在什么
更好的技能系统和引导式智能体课程
人们似乎想要的,不是更多泛泛而谈的 AI 激励,而是把优秀的工作方式编码下来,让下一个人或下一个智能体能够复用。@JayAlammar 希望这些概念变得清晰易懂,@AiwithDharmik 指向不断扩大的官方课程目录,@Mohiniuni 给出了基于代码仓库的学习路径,而 @ericosiu 则把运营层面的需求压缩成一句话:重复性工作应该变成一种技能。缺失的一层,是一种持久的打包方式,能把指令、检查项、示例和工具绑定封装成团队真正会复用的东西。机会:直接。
面向已部署系统、而不只是孤立输出的公开评估
当天最强烈的未满足需求,是值得信任的评估。@IntCyberDigest 反对夸大的 AGI 叙事,@ChrisGPT 表明只要基准测试反映顽固的真实行为,人们仍然会重视它;@dair_ai 把任务放进真实客户项目里,@SKatalystAI 则把“克制”纳入了混乱代码仓库的评估。人们似乎想要的是一种能捕捉部署质量、判断力和沟通能力,同时又不重新沦为易于刷分的排行榜表演的评估方式。机会:直接。
基于自有数据运行、且小模型性能可信的本地智能体
@ArtificialAnlys、@OpenMed_AI、@TeksEdge 和 @pdp 共同指向一种明确诉求:有用的智能体应能运行在操作者可控的硬件上,能调用工具,能按领域行为调优,并且不必把敏感工作流送进别人的云端。人们想要的不只是抽象意义上的“本地 LLM”,而是小型、可配置、随时能进入工作流的系统。机会:直接。
把多步骤工作流收拢到一个界面的更简单产品
无论是那条愤怒的反弹帖子,还是更具建设性的产品帖子,都在表达同一个愿望:不要再让用户自己拼接六七个步骤。@nitzukai 希望媒体 AI 直接交付素材,而不是重演 Blender 里的人工劳动;@MaxHirsch13 则明确要求在一个聊天界面里完成锻炼、食谱、记录和指导。@pdp 也对本地智能体编排采取了同样的做法,把整套技术栈打包成桌面应用。尚未被满足的需求,是更少的缝隙、更少的配置,以及对用户任务端到端结果更完整的承接。机会:有竞争力。
更好的 AI 搜索与基准测试发现基础设施
Vercel 和 VoiceBenchmarks 的帖子揭示了另一个不那么光鲜、却越来越重要的缺口。@mal_shaik 展示了工具如何通过拥有可被引用的对比页面、教程和 SDK 文档,赢得 AI 搜索份额;@gonzalo_io 则建立了一个公开目录,因为语音评估仍然散落在太多界面上。缺失的产品层并不是另一个模型,而是帮助构建者比较、选择并集成正确工具的发现基础设施。机会:有竞争力。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Fable 5.1 | 前沿模型 | (+) | 公众普遍认为它擅长处理模糊问题定义、前端工作、架构和工程克制;在混乱代码仓库对比中居首,并在所示的 SimpleBench 切片中以微弱优势领先 | 仍可能强加自己的“品味”;其胜出来自范围有限的公开对比,而非全面的正面对决 |
| GPT-6 Astra / Astra Pro | 前沿模型 | (+/-) | 在公开展示的 SimpleBench 切片中终于越过了人类基线;广泛用于浏览器工作流、编排和视觉任务 | AGI 相关说法受到强烈质疑;混乱代码仓库测试显示,它比 Fable 行为更广,但克制性更弱 |
| 可复用技能 + 插件 | 工作流方法 | (+) | 把重复性工作转化为明确的输入、步骤、输出、检查和工具绑定;公开图表显示,高使用率企业的使用明显更高 | 普通企业的采用率看起来仍偏低,正确打包工作流仍需要人工完成 |
| τ³-Bench | 代码智能体评估 | (+) | 在 53 项真实客户风格任务中对已部署系统打分,涵盖业务记录、沟通和服务约束 | 当前最佳模型仍只有 23.9%,而专家参考得分为 82.2%;这个基准更多是在暴露差距,而不是提供解法 |
| Continue / Cline | 开源代码智能体 | (+) | 反复作为 AI 编码学习和工作流的具体入口出现;两者都有庞大的公开社区和可运行工具 | 相关建议是缩小选择范围,说明工具过载和浅尝辄止仍很常见 |
| MiniCPM5-2B | 小型开放模型 | (+) | 在 4B 以下规模中展现出较强的智能与智能体能力信号,支持工具调用、token 效率高,并明显适合部署在自有硬件上 | 仍需要领域封装和验证;小模型的高分并不能抹平前沿模型的权衡 |
| Qwen3.8-27B Heretic 变体 | 开放模型调优方法 | (+/-) | 表明可以改变拒答行为,同时不明显压垮通用基准测试均值;经过 GGUF 量化后仍保留 MTP | 公开信息尚未对其在安全、编程、数学、多语言和视觉方面的权衡做全面审计 |
| Sol-H3 / Fast H3 | 视频推理技术栈 | (+) | 公开展示了快于播放速度的立体视频生成,并在首日提供沙盒/API | 需要相当可观的硬件;回复层面仍有人质疑其质量和参考视频支持 |
| Voice AI Benchmarks | 基准测试目录 | (+) | 集中整理了 TTS、STT、LLM、轮次衔接和完整语音智能体的分散评估界面 | 它只是索引层,不是基准测试运行器本身,因此质量取决于维护和覆盖范围 |
| Vercel 对比中心 + Next.js Learn + AI SDK | 分发方法 | (+) | 展示了对比页面、教程和 SDK 文档如何抓住 AI 搜索引用并影响工具发现 | 同一分析也显示,Vercel 仍会输掉许多对价格敏感的查询;这一壁垒依赖持续提供极其具体的内容 |
纵观整张表,最强烈的正面情绪并不是指向某个单一厂商,而是指向那些在模型外增加结构的方法:更现实的评估、可复用技能、按任务进行模型路由、本地部署选项,以及更好的发现界面。反复出现的应对模式,是把模型视为更大操作栈中的一层,而不是整个产品本身。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Anthropic Academy / Claude 101 | Anthropic | 面向 Claude、项目、技能、工具和企业使用场景的免费证书课程目录 | 智能体采用速度正在超过共享理解和正式入门培训的建设速度 | Web 课程、证书、项目演练、技能、企业搜索模块 | 已发布 | signal 文章 · 课程 |
| Voice AI Benchmarks | Gonzalo Io | 面向语音模型、LLM、轮次衔接和完整语音智能体的开放基准测试目录 | 语音评估分散在过多来源和格式中 | 可搜索 Web 目录、开放贡献、基准测试分类体系 | 已上线 | 文章 · 网站 |
| Sol-H3 / Fast H3 | xieenze_jr with MiniMax AI / Reactor | 面向 MiniMax H3 视频生成的快于播放速度的推理技术栈和公开沙盒 | 高质量视频生成对交互式使用来说仍然太慢 | 稀疏注意力、融合内核、批量 VAE 解码、多 B300 扩展、API/沙盒访问 | 已发布 | 文章 · 基准页面 · 沙盒 |
| Maxed AI | Max Hirsch / MAXED INC | 集锻炼计划、卡路里追踪、食谱和记录于一体的聊天界面 | 健康工作流分散在太多独立应用和输入中 | iOS 应用、聊天界面、锻炼生成、语音记录、营养规划 | 已发布 | 文章 · App Store |
| CBK Studio | pdp / CBK | 面向 AI 智能体和工具的桌面打包式本地编排环境 | 运行安全的本地智能体工作流仍然需要过多设置和胶水代码 | 桌面应用、本地模型、图形化工作流界面、工具节点、技能获取 | 已发布 | 文章 |
这张表显示了当天构建者活动的广度。有些团队在补学习供给,有些在建设基准测试基础设施,有些在降低运行时延迟,还有些在把完整的用户工作流打包进一个界面。最有意思的共同点是,这些项目几乎都不是“又一个模型”,而是围绕学习、评估、速度或端到端产品流程搭建的封装层。
一体化产品和本地产品的例子尤其具体。Maxed 的公开 App Store 页面写明,该应用可以预测重量和次数、支持语音记录,并根据提示生成锻炼计划;帖子的截图也把这种打包逻辑展示得很直观:食谱生成、宏量营养素拆解和一键记录都在同一个产品里。CBK Studio 则把同样的打包思路向上推进一层,把本地编排做成桌面界面,用可检查的节点取代一堆手动设置步骤。


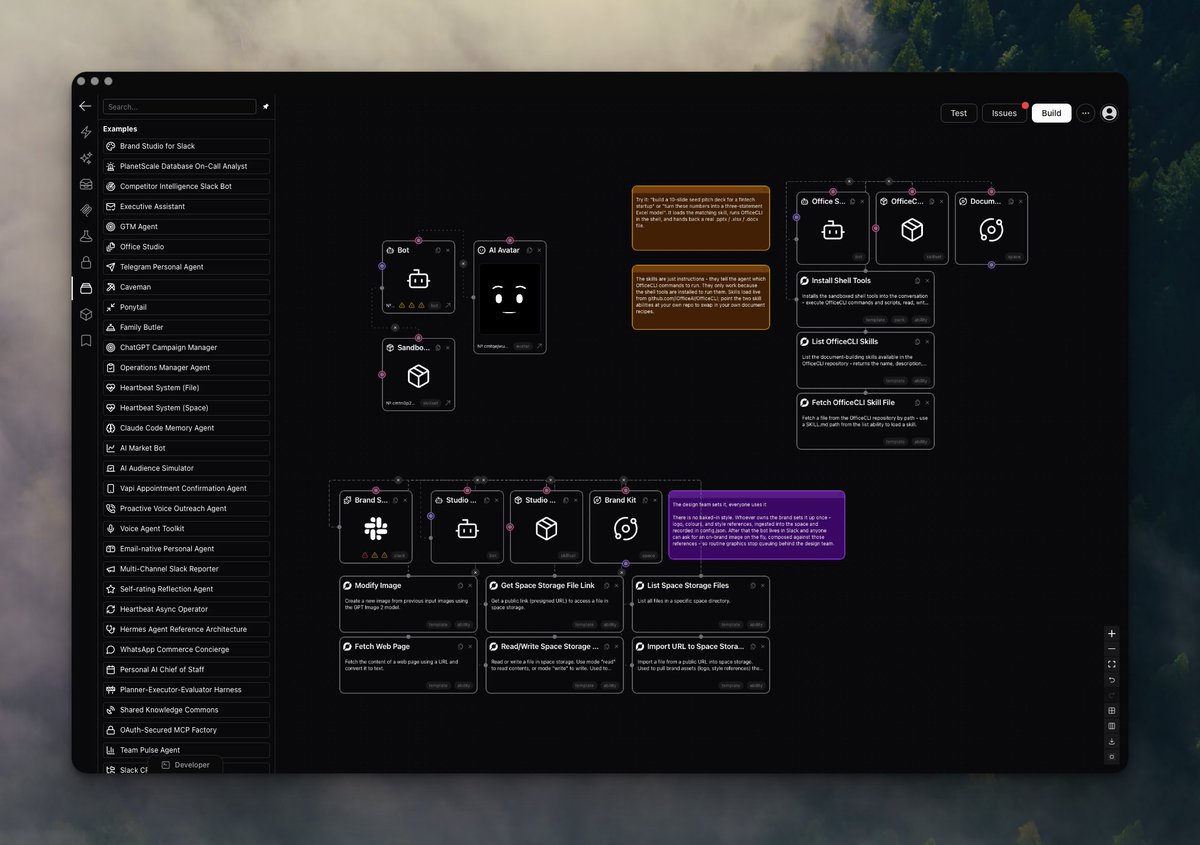
还有一个无法整齐纳入表格、但同样重要的旁证:教育本身也在被产品化。Jay Alammar 的新书发布和 Mohiniuni 的代码仓库地图都表明,学习材料正成为构建者技术栈的一部分,而不只是围绕产品的营销内容。
6. 新动态与值得关注的内容
可复用技能终于被量化,而不只是被反复倡导
@ericosiu 不只是认为(2 条回复,292 次浏览)表示,团队应该把重复性任务沉淀为技能。他附上了公开的企业使用图表,显示高使用率企业与普通企业在技能和插件使用上都存在显著采用鸿沟。这一点很重要,因为它把“工作流打包”从模糊的最佳实践,变成了可衡量的行为差距。
τ³-Bench 让代码智能体评估更接近真实客户工作
@dair_ai 强调(16 个赞,1 次转发,8 条回复,2,114 次浏览,20 次收藏)介绍了一项基准测试:智能体必须阅读业务记录、与客户沟通、在服务约束内工作,并交付一个已部署系统。比起 23.9% 对 82.2% 的分数差距,更重要的是框架转变:这个基准衡量的是工作是否真正完成,而不是某个补丁是否通过。
MiniCPM5-2B 让边缘端模型叙事显得更务实
@ArtificialAnlys 展示(47 个赞,2 次转发,9 条回复,4,805 次浏览,8 次收藏)提到 MiniCPM5-2B 以其体量取得了异常出色的表现,而 @OpenMed_AI 翻译(18 个赞,1 次转发,1,167 次浏览,9 次收藏)则把这种能力带进了自有硬件上的垂直工作流。这组搭配之所以值得注意,在于它把基准测试可信度和具体部署场景,在同一天的讨论中连接了起来。
Sol-H3 把视频生成推入“交互式系统”的讨论
@xieenze_jr 声称(94 个赞,13 次转发,10 条回复,17,755 次浏览,87 次收藏)展示了 5 秒立体视频快于播放速度的生成能力,而公开来源对核心数字的支持也足够接近,因而可以把它看作不止是时间线上的炒作。跨过这个门槛很重要,因为产品问题从批量生成转向了:连续、可操控的视频系统是否正在变得现实。
7. 机会在哪里
[+++] Real-world evaluation for agents that touch messy code and messy stakeholders — Evidence came from @IntCyberDigest 拒绝 反对夸大的 AGI 说法,@ChrisGPT 称赞 之所以看重某项基准测试,是因为它对应了长期存在的失败模式,@dair_ai 评分 把任务推进到已部署的客户式系统,@SKatalystAI 测试 强调混乱代码仓库中的克制能力,而 @thdxr 警告 则讨论了被基准测试优化过的用户体验。机会不在于增加更多记分板,而在于评估判断力、沟通能力和部署质量。
[+++] Reusable skills, workflow operating systems, and guided agent curricula — @JayAlammar 封装为 梳理了概念栈,@AiwithDharmik 揭示了 提供了正式课程,@Mohiniuni 分享 给出了具体代码仓库路径,@ericosiu 量化了 展示了采用鸿沟,@OreateAI 命名为 则提出了五层工作流。这看起来是一项持久需求,因为它把教育、运营和工具连接到了同一个缺失层。
[++] Owned-data local agent stacks built around credible small models — @ArtificialAnlys 展示 表明,4B 以下开放模型正变得更值得认真对待,@OpenMed_AI 梳理了 把这种进步带进了临床工作流,@TeksEdge 展示了 显示出人们对行为调优和量化本地部署的兴趣,@pdp 封装为 则把本地编排做成了桌面工具。当隐私、所有权或延迟比绝对前沿能力更重要时,这一机会最突出。
[++] AI-search distribution tooling and citeable documentation systems — @mal_shaik 认为 表明,Vercel 的领先来自它拥有 AI 系统最想引用的那些页面:对比、教程、模板和 SDK 文档。这说明,帮助企业生成、测试并维护适合 AI 搜索的文档,正形成一个不断扩大的市场;不应再把引用仅仅视为 SEO 的副作用。
[+] Packaged vertical agents and benchmark directories that remove category sprawl — @gonzalo_io 构建了 建立了一个基准测试目录,因为语音构建者仍然面对过多分散的参考资料;@MaxHirsch13 定位为 把 Maxed 做成一个覆盖多项健康任务的统一界面;@nitzukai 抱怨 则指出,AI 媒体工作流仍然迫使用户经历太多模仿人工操作的中间步骤。这个品类比前述方向更早期、也更嘈杂,但减少衔接环节的需求已经非常明确。
8. 要点
- AI 工作正在被打包成可复用的操作知识,而不仅是更好的提示词。 Jay Alammar 的新书发布、Anthropic 的课程目录、Eric Siu 的技能采用率图表,以及 Oreate 的工作流栈,都指向同一个转变:团队想要的是可教的系统和可复用技能。(来源)
- 基准测试讨论正在更严格地审视什么才算证据。 GPT-6 在 SimpleBench 上的进展引发了关注,但更强的信号来自 τ³-Bench、SKatalyst 的混乱代码仓库测试,以及人们对缺乏真实任务框架支撑的 AGI 叙事的质疑。(来源)
- 任务—模型路由正在取代“一种模型包打天下”的思维。 shannholmberg 的模型组合、MiniCPM5-2B 的讨论、OpenMed 的使用场景,以及 Qwen 改造讨论,都把模型选择视为部署设计决策,而不是普适排名。(来源)
- 壁垒越来越多地存在于周边系统:文档、基准测试和运行时工程。 Vercel 的引用份额分析、Voice AI Benchmarks 和 Sol-H3 都表明,构建者竞争的焦点正从单纯的模型品牌转向可发现性和基础设施。(来源)
- 终端用户产品的打包仍然重要,因为许多 AI 工作流依旧过于割裂或过于迂回。 Maxed 的一体化教练和 CBK Studio 的本地桌面编排,都是在尝试消除那些用户已经明显厌倦自己管理的衔接环节。(来源)