Twitter AI - 2026-09-10
1. 人们在讨论什么
1.1 模型升级变成了迁移与回归事件(🡕)
最突出的主题并不是又有一个前沿模型拿到了更高分,而是模型变更如今越来越像基础设施迁移:它们可能破坏既有指令、改变工具行为,并使工作流失效。四条高信号内容推动评估转向回放测试和真实代码仓库。
@BradGroux 报道(572 个赞,12 条回复,229,930 次浏览,158 次收藏)表示,在积累了六天记录后,他的 GPT-5.6 工作流无法可靠迁移到 GPT-6 Astra。回复点明了业务层面的后果:团队无法承受每次发布都重写操作流程,因此应在迁移前回放一组匹配的历史任务。
@iamdamianpala 测试了(3 个赞,3 条回复,63 次浏览)在同一个代码仓库的隔离副本中,基于相同的功能契约测试了三个模型。附带结果显示,最便宜、最快的一次运行并未通过全部变异组,而最昂贵的一次运行是唯一通过全部四组测试的方案。

@nasqret 表示(207 个赞,8 条回复,11,620 次浏览,48 次收藏)称,GPT-6 Astra 已解出 FrontierMath Tier 4 中最后一道未解题,补齐了这个诞生于 o4-mini 时代的基准测试。其含义并不是数学评估已经结束,而是高难度题集如今需要更快更新。
讨论洞察: 回复更倾向于回归测试套件,而不是一次性的排行榜。反复出现的问题是:新模型能否保住团队实际使用的契约、指令和故障边界。
与前一天对比: 2026-09-09,评估开始转向可维护性、硬件适配和服务栈影响。到了 2026-09-10,这进一步演变为一种迁移纪律:回放旧任务、比较缺陷与成本,并假定模型替换可能让生产行为发生回归。
1.2 开源与本地模型加剧了性价比竞争(🡕)
五条内容共同表明,围绕开放权重模型、小模型和本地推理的竞争正在扩大。DeepSeek V4.1 Flash 主导了基准测试讨论,但硬件调优和多语言小模型说明,这一趋势并不局限于某一次发布。
@Yuchenj_UW 强调了(132 个赞,17 条回复,11,353 次浏览)称,DeepSeek V4.1 Flash 在多个展示出的代码与智能体基准测试中高于 GPT-5.6 Sol,同时宣称成本约低 97%。图片显示,DeepSWE 为 74.2,CyberGym 为 88.1,AutomationBench 为 54.8;不过,这一价格说法仍应视为发布当天的声明,而非独立复现结果。

@TeksEdge 记录了(20 个赞,1 条回复,1,697 次浏览,11 次收藏)展示了面向双 Radeon AI PRO R9700 的 Qwen3.8-27B 优化路径:在不同的 llama.cpp 和 SGLang 配置下,吞吐量从每秒 19.2 个 token 提升至 185 个 token。@mhrnz_m 展示了(20 个赞,2 条回复,547 次浏览)介绍了 Tiny Aya L2-Thinker:一个拥有 33.5 亿参数、32K 上下文窗口、面向 45 种语言推理训练的模型。
讨论洞察: 这种兴奋是有条件的。基准测试获胜会引发关注,但开发者仍不断追问:同样的优势能否在自己的代码仓库、服务栈、语言和硬件上成立。
与前一天对比: 2026-09-09,本地模型讨论主要围绕为机器挑选合适的模型。到了 2026-09-10,讨论加速演变为开放模型、前沿 API、优化运行时和多语言小型系统之间的主动性价比竞争。
1.3 智能体可靠性从规则转向可逆的运行时控制(🡕)
六条内容将智能体监督这一主题推进到了具体基础设施层面。共同的设计思路是:控制智能体读取什么、保留跨工具的上下文、监控使用上限,并让执行过程可逆,而不是寄希望于更好的提示词就能避免失败。
@marfinxx 披露了(11 个赞,4 条回复,772 次浏览)介绍了 SHEPHERD,这是一种研究型运行时,其元智能体可以拦截、分叉、修改并回滚执行轨迹。附带论文结果显示,CooperBench 的成对通过率从 28.8% 升至 54.7%,其中分叉操作耗时约 134-143 毫秒。

@BharukaShraddha 指出(10 个赞,561 次浏览,8 次收藏)介绍了 Headroom,它可在本地压缩日志、工具结果、文件和对话历史,同时保留可逆检索能力。其代码仓库称,在四个可复现场景中节省了 21%-57%;而推文中更宽泛的 60%-95% 说法则取决于具体工作负载。
@DanKornas 展示了(4 个赞,6 条回复,658 次浏览)介绍了 DSH Chat Import,可将大约 20 个代码智能体中的历史对话迁移到可恢复的会话中;@KeisukeIshikawa 发布了(2 个赞,2 条回复,114 次浏览)则介绍了一个小组件,用于追踪 Claude、OpenAI 及其他提供商的使用量重置。
讨论洞察: 这些项目把可靠性视为状态管理问题。压缩、配额、轨迹和可移植历史记录,都是让隐藏的运行状态变得可见且可恢复的尝试。
与前一天对比: 2026-09-09,人们提出了验证、替换和回退标准等监督规则。到了 2026-09-10,开发者开始提供实现这些规则的基础组件:可逆轨迹、本地压缩、跨智能体导入和配额遥测。
1.4 AI 部署证据扩展到媒体、生物学、机器人和基础设施(🡕)
五条内容显示,AI 正从笼统的能力主张走向可量化的运营系统与实验。证据涵盖规模化媒体业务、动物研究、开源机器人和国家级算力建设。
@RohanNayak2 介绍了(111 个赞,22 条回复,12,951 次浏览,29 次收藏)介绍了 Pocket FM 实现约 5 亿美元 ARR 并达到 EBITDA 盈利的路径,归因于 AI 优先的本地化、留存、内容和广告工作流。附带幻灯片称,该公司目前每月制作 17,500 条广告。

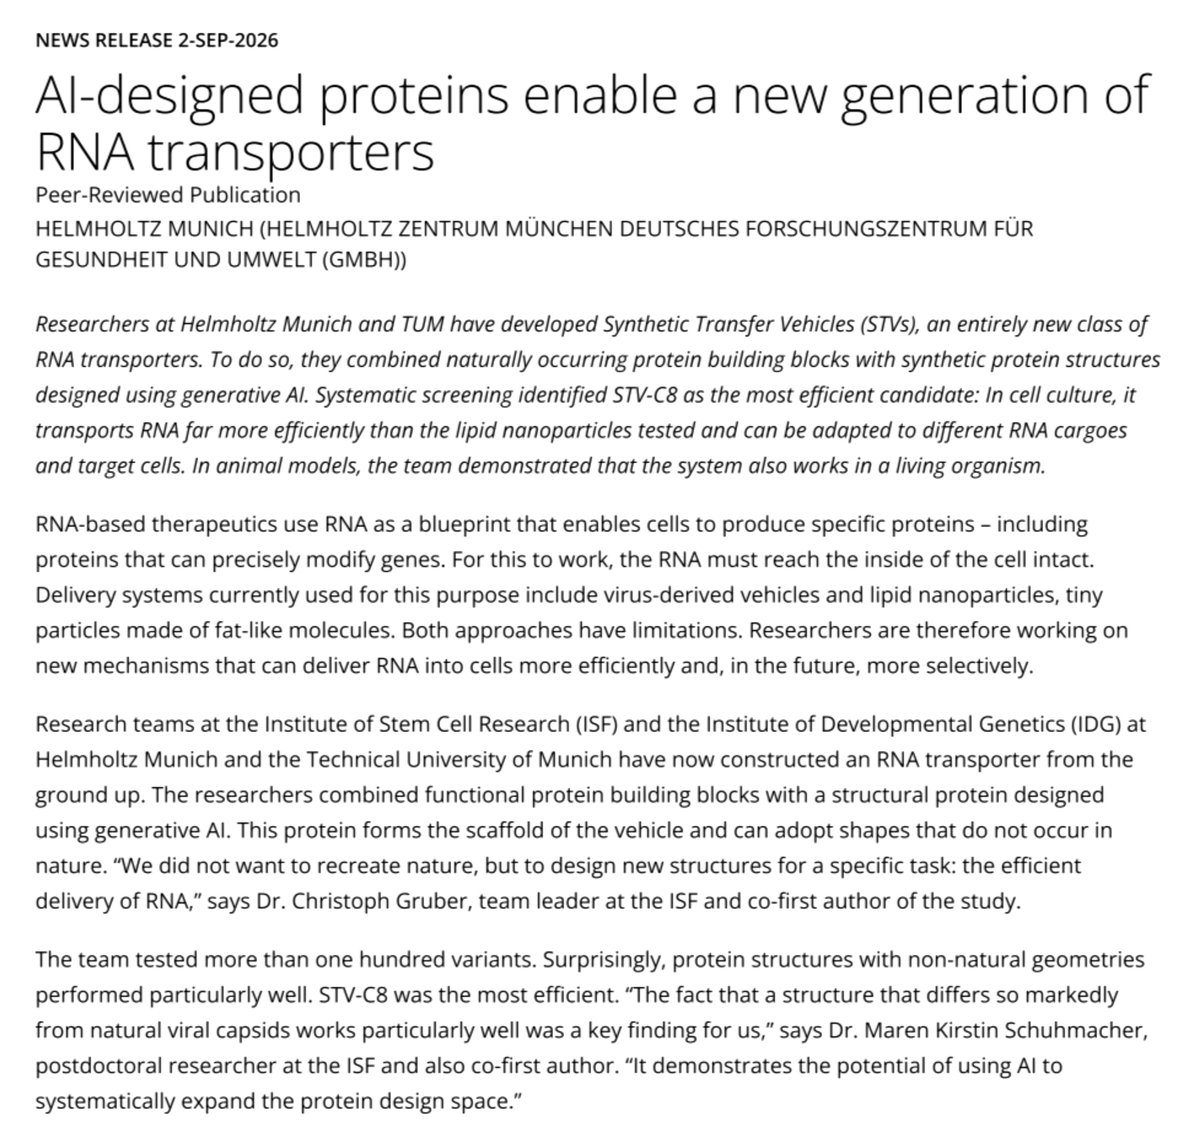
@SciTechera 分享了(4 个赞,1 条回复,232 次浏览)介绍了 STV-C8 的研究:这是一种由 AI 设计的合成 RNA 转运体,已在动物实验以及 CRISPR/Cas9 猪肌肉实验中接受测试。附带材料明确将其标注为实验性工作,因此它更应被视为积极的研究信号,而不是临床结果。
@UnitreeRobotics 宣布了(90 个赞,8 条回复,6,018 次浏览,14 次收藏)介绍了开源的 UnifoLM-WLA-1.0 具身基础模型,用于单臂和双臂机器人。@nvidianewsroom 宣布了(164 个赞,8 条回复,51,391 次浏览)介绍了澳大利亚合作方正在为基于 DSX 的 AI 工厂扩充土地、电力和机房壳体容量。
讨论洞察: 最可信的部署帖通常会提供运营指标、实验阶段、代码发布或基础设施投入中的至少一项。缺少这些锚点的宽泛说法,获得的分析权重要低得多。
与前一天对比: 2026-09-09,扩散被描述为涉及工作流、现实世界数据和本地基础设施的瓶颈。到了 2026-09-10,讨论则通过规模化媒体运营、实验性生物学、具身模型和算力建设,给出了这种扩散的具体实例。
2. 什么让人感到沮丧
模型发布悄然使既有流程失效
严重程度:高。@BradGroux 报道(572 个赞,12 条回复,229,930 次浏览,158 次收藏)反复表示,从 GPT-5.6 转向 GPT-6 Astra 后,不得不一再重述指令。@iamdamianpala 发现(3 个赞,3 条回复,63 次浏览)则显示,三个模型在收到同一个真实代码仓库的功能契约后,产出了明显不同的缺陷、完成时间和成本。
应对方式是固定模型版本、保留已验证有效的指令,并在切换前回放具有代表性的任务。这一方向值得直接投入,因为频繁的模型升级会把原本有吸引力的商品化能力,转化为反复发生的迁移工作。
难以审计的基准测试和供应商说法
严重程度:高。@nasqret 标志着(207 个赞,8 条回复,11,620 次浏览,48 次收藏)显示,一个曾经很难的数学题集已经被跑满,而 DeepSeek V4.1 Flash 的相关说法传播速度快于独立复现。在信任层面,@firstadopter 放大了(9 个赞,1 条回复,1,928 次浏览)提到 Anthropic 指称 DeepSeek 和 Moonshot 将客户请求转发给 Claude,并截取交互内容用于训练。这些是 Anthropic 的指控,并非独立确立的事实,但它们说明了为什么模型来源正成为评估的一部分。
@babakph 认为(7 个赞,3 条回复,2,098 次浏览)指出,关于机密工作是否会被用于训练模型的不可验证承诺,并不构成控制措施。团队通过合同限制、私有部署、可复现测试框架和独立测试来应对。这一方向值得投入:证据封装、来源链路和策略执行仍弱于模型选择界面。
在工作流中途才暴露的上下文、token 和配额成本
严重程度:中。@BharukaShraddha 强调了(10 个赞,561 次浏览,8 次收藏)指出,智能体明明只需要一个错误,却不得不发送整份日志;@KeisukeIshikawa 介绍了(2 个赞,2 条回复,114 次浏览)则提到,人们往往是在任务进行到一半撞上限制后,才发现提供商已经重置。@RituWithAI 总结了(7 个赞,1 条回复,70 次浏览,6 次收藏)引用了一项 Deloitte 调查:60% 的财务负责人预计,到 2027 年 AI 成本将显著上升,但仍有 43% 的人会继续将其嵌入业务。
当前的应对方式包括本地压缩、将请求路由到更便宜的模型、使用简洁输出以及配额仪表盘。这一方向值得投入,不过针对单点问题的解决方案已经开始出现,而且节省幅度仍需结合具体工作负载验证。
仍需人工维护运营知识的集成
在受监管工作流中,严重程度为高。@mardehaym 介绍了(16 个赞,10 条回复,2,035 次浏览)提到,一个小团队在依据 HIPAA 将智能体部署到 600 多个付款方计划之前,仍需手动维护数百份预授权模板。令人沮丧的并不是缺少能力足够强的模型,而是要持续更新分散的规则、凭证、验证流程和例外情况。
团队的应对方式是将会使用工具的智能体放入受控工作流中,而不是直接开放一个通用聊天机器人。在规则变动频繁、结果可审计且交易量足以支撑持续维护的领域,这一方向非常值得投入。
3. 人们希望有什么产品
面向真实工作的模型中立迁移闸门
开发者希望有一种测试框架,能够回放具有代表性的任务、比较缺陷和成本、检测指令行为变化,并在契约发生回归时阻止升级。@BradGroux 提出了(572 个赞,12 条回复,229,930 次浏览,158 次收藏)表明这种需求十分迫切;@iamdamianpala 演示了(3 个赞,3 条回复,63 次浏览)则展示了在单个代码仓库中的一个小型手动版本。现有基准测试框架只能部分解决工作流特定指令和迁移风险问题。机会:直接。
适用于所有代码智能体的可移植压缩上下文
实际需求是在切换模型和工具时,不丢失能够解释当前代码库状态的历史记录。@DanKornas 推出了(4 个赞,6 条回复,658 次浏览)是一个对话导入器;@BharukaShraddha 强调了(10 个赞,561 次浏览,8 次收藏)则提供本地、可逆的上下文压缩。两者都部分满足了这一需求,但目前仍缺少一种具备来源、版本替代关系和选择性检索能力的中立交换格式。机会:竞争性。
可审计的数据使用与模型来源控制
人们希望拿到证据,证明响应来自哪里、自己的输入是否被保留,以及供应商是否遵守其政策。@babakph 将其定义为(7 个赞,3 条回复,2,098 次浏览)将这视为承诺与控制措施之间的区别。@AndrewCurran_ 呼吁(22 个赞,1 条回复,2,555 次浏览)则展示了随着模型获得自主性和工具访问权限,实验室正在采用的具体监控实践。合同和私有托管只能部分解决问题,因为客户仍缺少可移植的证据。机会:直接。
能够学习不断变化的领域规则的集成维护
受监管行业的运营方希望智能体能够吸收不断变化的付款方、政策和验证规则,而不必重新构建脆弱的模板库。@mardehaym 介绍了(16 个赞,10 条回复,2,035 次浏览)展示了覆盖 600 多个付款方计划的迫切需求。生产级智能体只能部分解决这一问题,安全的规则发现、审批和回滚仍然依赖具体领域。机会:竞争性。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| GPT-6 Astra | 前沿模型 | (+/-) | 在一个高难度数学题集上达到饱和;具身任务能力提升明显 | 对一位重度用户而言,既有 GPT-5.6 指令无法可靠迁移 |
| DeepSeek V4.1 Flash | 开源模型 | (+/-) | 展示出的代码和智能体得分很高,宣称成本较低 | 发布当天的结果需要复现;来源相关指控削弱信任 |
| Headroom | 上下文基础设施 | (+) | 本地、可逆压缩;支持多种智能体和内容类型 | 节省幅度会随负载显著波动;增加了代理和检索层 |
| SHEPHERD | 智能体运行时 | (+) | 可拦截、分叉、修改和回滚执行轨迹 | 证据仍处于研究阶段;元智能体监督增加了另一层控制面 |
| DSH Chat Import | 开发者工具 | (+) | 将历史对话带入可恢复会话 | 导入的历史仍需过滤、溯源和处理替代关系 |
| Codenotch | 使用量监控 | (+) | 让分散的提供商配额和重置状态变得可见 | 小型单点解决方案;提供商覆盖范围和准确性可能变化 |
| TRL 1.13 | 训练框架 | (+) | 为超过 100 万 token 的上下文提供开源后训练指南 | 长上下文训练仍需承担较高的内存和评估成本 |
| 真实代码仓库回放 | 评估方法 | (+) | 暴露缺陷、耗时、成本和契约合规性 | 小型任务集可能过拟合某个代码库,且维护成本高 |
| 调优后的 llama.cpp 和 SGLang | 本地推理 | (+) | 通过针对硬件的优化大幅提升吞吐量 | 结果取决于 GPU、量化方式、内核和确切的模型配置 |
围绕模型的满意度区间最宽,而围绕运营工具的满意度区间最窄。@Yuchenj_UW 称赞了(132 个赞,17 条回复,11,353 次浏览)展示了 DeepSeek 的价格性能表现;@BradGroux 记录了(572 个赞,12 条回复,229,930 次浏览,158 次收藏)则展示了 Astra 迁移带来的回归。应对方式并不是忠于某一家供应商,而是进行路由、回放、压缩,并保留切换的可能性。
@Thom_Wolf 发布了(15 个赞,2 条回复,1,947 次浏览)介绍了带有长上下文后训练指南的 TRL 1.13;@TeksEdge 展示了(20 个赞,1 条回复,1,697 次浏览,11 次收藏)则说明,运行时调优的重要性可能不亚于名义上的模型本身。竞争优势正逐渐转向外围的测量与服务栈。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| GPT-2 风格 MoE | @gpjt | 在一个拥有 4.46 亿参数的模型中,将每个 token 路由给六个专家中的两个 | 让 MoE 机制能够在一台工作站上学习和复现 | Python、PyTorch、RTX 3090 | 已发布 | 文章与代码 |
| Headroom | Headroom Labs | 通过可逆检索在本地压缩智能体输入 | 降低重复日志、工具输出和上下文成本 | Python、TypeScript、代理、MCP | 已发布 | GitHub |
| SHEPHERD | Stanford 和 Northwestern 研究人员 | 让元智能体能够可逆地控制另一个智能体的轨迹 | 防止或从运行时故障中恢复 | 可编程智能体运行时 | RFC | 论文 |
| DSH Chat Import | @DanKornas | 将历史代码智能体对话导入可恢复会话 | 切换测试框架时避免丢失上下文 | DeepSeek Harness 插件 | Alpha | 推出了(4 个赞,6 条回复,658 次浏览) |
| Codenotch | @KeisukeIshikawa | 将多提供商使用量和重置状态固定显示在桌面上 | 防止长任务期间突然遇到配额问题 | 开源桌面应用 | Alpha | 发布了(2 个赞,2 条回复,114 次浏览) |
| Tiny Aya L2-Thinker | @mhrnz_m 及合作者 | 以 33.5 亿参数在 45 种语言中进行原语言推理 | 在本地规模限制下拓展多语言推理 | 33.5 亿参数模型、32K 上下文 | Beta | 展示了(20 个赞,2 条回复,547 次浏览) |
| UnifoLM-WLA-1.0 | Unitree | 为单臂和双臂机器人提供具身基础模型 | 为机器人学习提供开放的训练和推理基础 | 模型、训练代码、数据集 | 已发布 | 宣布了(90 个赞,8 条回复,6,018 次浏览,14 次收藏) |
| 预授权智能体 | @mardehaym 及其团队 | 跨付款方计划提交治疗审批 | 取代人工维护的付款方模板和重复性操作 | 使用工具的智能体、HIPAA 控制 | 已发布 | 介绍了(16 个赞,10 条回复,2,035 次浏览) |
@gpjt 记录了(149 个赞,5 条回复,22,563 次浏览,263 次收藏)是最具可复现性的教育型构建项目。这个拥有六个专家、每次激活两个专家的模型,在一块 RTX 3090 上训练了将近八天;文章解释了维持专家均衡所需的辅助损失,而不只是展示最终分数。
Headroom 和 DSH Chat Import 分别应对相邻的上下文债务:前者缩减必须发送的内容,后者保留原本会被困住、无法带走的内容。可见的 DSH 界面支持从多种代码智能体导入,并导出到 Claude Code、Codex 和 Kimi Code。

反复出现的构建模式,是围绕模型可互换性搭建基础设施。即使是机器人和医疗项目,也都把模型与领域数据集、工具、验证机制或控制措施配套起来,而不是把一个原始模型端点本身当作产品。