Twitter AI - 2026-09-12
1. 人们在讨论什么
1.1 控制层与独立评估取代了对前沿模型的单纯炒作(🡕)
最响亮的非开发者讨论,并不是某个新模型发布,而是谁在控制先进模型、谁有权审查它们,以及“AI 会拯救我们”和“AI 会毁灭我们”这两种叙事,是否都在把注意力从同一个现实操作缺口上移开:当下的治理。
@MabreyTed 称 (162 个赞、23 条回复、11,179 次浏览、54 个书签)指出,前沿叙事掩盖了一个更紧迫的问题:企业的投入产出已经倒挂,知识资产正不断流向模型提供方,而真正的实用价值取决于精确控制,而不是假想中的全能。他还认为,一旦团队加入自己的数据和决策轨迹,开放模型或非前沿小模型在许多用例上的性价比其实已经与前沿模型持平。
@DarioAmodei 宣布 (100 个赞、25 条回复、3,847 次浏览、30 个书签)提到他那篇《我们必须放缓前沿发展》的文章,并表示 Anthropic 将向第三方评估者提供员工级访问权限,使其能够核验安全措施、上报事件,并在训练期间评估对齐情况。紧随其后的回复很快把讨论扩展开来:人们开始追问中国实验室是否也会放慢脚步,以及 Anthropic 何时会推出开放权重版 Claude,于是一条安全主题帖子迅速变成了围绕地缘政治和市场结构的争论。
讨论洞察: 两条推文下的回复最终都收敛到同一个具体问题:一个最低可行的控制层到底该是什么样?Mabrey 的帖子下有人直接这么问,而 Dario 那边的回复则分成两派:一派要求强力监督,另一派则怀疑,如果没有中国方面的协调或开放权重,任何“放缓”都不可能维持。
与前一天对比: 相比 2026-09-11 当天治理更多体现为企业身份、流程和遗留系统债务,到了 2026-09-12,同样的担忧已经转化为一场围绕发展节奏、监督以及谁有权审查前沿系统的公开争论。
1.2 更小和本地化的模型被当作能干活的员工,而不是省钱备胎(🡒)
这一天关于小模型的帖子异常具体。它们没有泛泛地说端侧模型正在“追赶”,而是展示了本地或紧凑型系统如何调查事故、判断何时该呈现界面,以及接手重复性的业务运营。
@_avichawla 展示了 (33 个赞、4 条回复、3,032 次浏览、36 个书签)展示了 MiniCPM5-2B 在完全本地运行的情况下,完成一次多步骤营收下滑排查:模型先检查订单、流量、支付、退款和部署日志,再撰写事件报告。值得注意的不只是一个 2B 模型能在设备上聊天,而是 OpenBMB 已把它调优到可用于编码、工具调用,以及跨 SGLang、vLLM、llama.cpp、Ollama 和移动端运行时执行多步骤、有状态任务。
@TeksEdge 重点介绍了 (22 个赞、2 条回复、1,391 次浏览、14 个书签)介绍了 Saanora Labs 的 Mark 1x-9B。这是一个经过后训练的 Qwen3.5-9B 衍生模型,能够判断答案更适合以图表、仿真、概念图还是 JSON 载荷呈现,而不是一律输出普通文字。随附的基准图表之所以重要,在于它把“界面能力”这一主张,与 IFEval、MMLU-Pro、GPQA Diamond 和 AIME 风格测试中的小模型竞争成绩对应了起来。

@pbteja1998 介绍了 (24 个赞、2,511 次浏览、22 个书签)展示了在把三天的业务与财务上下文导入 Squad 后,如何在其中创建一个“财务运营负责人”。附带的工作区截图解释了这条帖子为何引发共鸣:这款产品已经具备任务队列、内置搜索、Composio、云端计算机和长期记忆,因此它卖的并不只是“和助手聊天”,而是“把一块业务交给一位队友”(网站)。

@AlexFinn 称 (72 个赞、19 条回复、6,737 次浏览、51 个书签)认为,即便是一台便宜的 Mac Mini,也足以通过 LM Studio 开始用本地模型替代一些较小的工作流。他在回复里把限制说得比主帖更清楚:他使用的是专用设备,而小型硬件主要替代的是更窄的工作流,并不能取代每一次云端调用。
讨论洞察: 本地模型相关回复已经不再停留于“能不能跑”,而是转向模型与内存的匹配、专用设备的持续在线能力,以及模型能否保留足够状态来调用工具而不引发频繁的内存抖动。
与前一天对比: 相比 2026-09-11 侧重用多模型执行框架降低前沿编码代理成本,2026-09-12 把成本讨论进一步推向边缘端:更小的模型、开放权重,以及要么留在本机、要么复用团队已付费订阅的代理队友。
1.3 代理研究讨论聚焦训练循环与可复用环境,而不是更大的基座模型(🡒)
这一天最密集的开发者讨论,集中在一组论文上。它们共同主张:长时程代理的提升,如今更多来自更好的训练信号、隐藏评估和可复用环境层,而不是简单地把更大的模型接到同一套循环上。
@omarsar0 总结了 (44 个赞、13 条回复、4,029 次浏览、43 个书签)介绍了《Thinking with Looped Flows》。这是一篇循环式推理论文,通过局部去噪目标训练早期循环步骤,让后续推理能建立在这些步骤之上。附图和 arXiv 摘要把这一主张具体化了:增加推理时计算,可以在不增加参数的情况下换来更强的高难度推理能力;作者报告 ARC-AGI-1 得分为 58.8%,ARC-AGI-2 得分为 12.2%(论文)。

@marfinxx 提炼了 (27 个赞、6 条回复、1,228 次浏览、26 个书签)把 Meta 的 AIRA2 描述为研究代理的三件套修复方案:异步多 GPU 工作者、隐藏且一致的评估,以及能够调试实时代码的有状态 ReAct 循环。论文预览和图表显示,在 24 小时设置下,MLE-bench-30 的平均百分位排名为 81.5%,72 小时下为 83.1%;同时,随着时间推移,1-GPU 与 8-GPU 进化搜索之间的差距还在继续拉大(论文)。

@gurtej__gill_ 重点推荐了 (9 个赞、172 次浏览、8 个书签)介绍了 Microsoft 的 Orchard 框架,其中 Orchard Env 是一层 Kubernetes 原生、与执行框架无关的沙箱层,可被不同代理方案共享。引用摘要称,配合价值模型重排序后,Orchard-SWE 在 SWE-bench Verified 上达到 73.0%;Orchard-GUI 在三个网页基准上的平均成绩为 68.4%;Orchard-Claw 的 pass@3 为 59.6%,换上更强的执行框架后升至 73.9%(论文)。
@HuggingPapers 指出了 (9 个赞、5 条回复、582 次浏览、10 个书签)介绍了 WMRL:它在强化学习中用世界模型替代真实环境执行,并声称训练计算量可降低 3.1 倍到 3.4 倍,同时仍能提升留出集得分。讨论中最值得注意的是它附带的保留意见:回复立刻追问,世界模型会不会只是学会了模拟器的盲点,而不是真正掌握了底层任务(项目页面)。
讨论洞察: 这些讨论明显带有强烈的自我批判色彩。回复不断追问:这些收益是否是在计算量匹配条件下取得的,评估器本身是否可能被利用,以及学到的世界模型或基准划分是否在制造虚假的进展。
与前一天对比: 2026-09-11 已经强调过轨迹审查和对基准的怀疑,但到 2026-09-12,讨论已经从批判推进到了机制层面:隐藏评估容器、Kubernetes 原生环境层、循环去噪目标,以及基于世界模型的强化学习。
1.4 基础设施与实体 AI 讨论共同收敛到瓶颈、溯源与运行时一致性(🡕)
其余高信号帖子读起来更像是系统故障地图,而不是产品发布:GPU 显存上限、推理性能剖析、运行集群所需的技能栈,以及一个在 Python 中表现出色的机器人策略,与一个能在浏览器运行时里活下来的策略之间的差距。
@suraj_sharma14 梳理了 (72 个赞、5 条回复、2,093 次浏览、86 个书签)介绍了一份 12 阶段的“AI 基础设施工程师”路线图:从 Linux 和网络起步,经过 Kubernetes、vLLM、KV 缓存管理、KEDA 和 FSDP,最后落到公开的延迟与成本基准。回复进一步点明了重点:有人说,长上下文编码代理往往不是先死在原始 FLOPs 上,而是先死在 KV 缓存驻留和并发问题上。
@Siddhant_K_code 发布了 (103 个赞、6 条回复、2,058 次浏览、63 个书签)介绍了一篇 Springer 论文和开源 LLMTraceFX 性能分析器。它会把推理证据收集进统一的规范模式,用确定性工作负载核验输出,并且只有在实测证据满足策略条件时才建议修改配置(仓库、论文)。
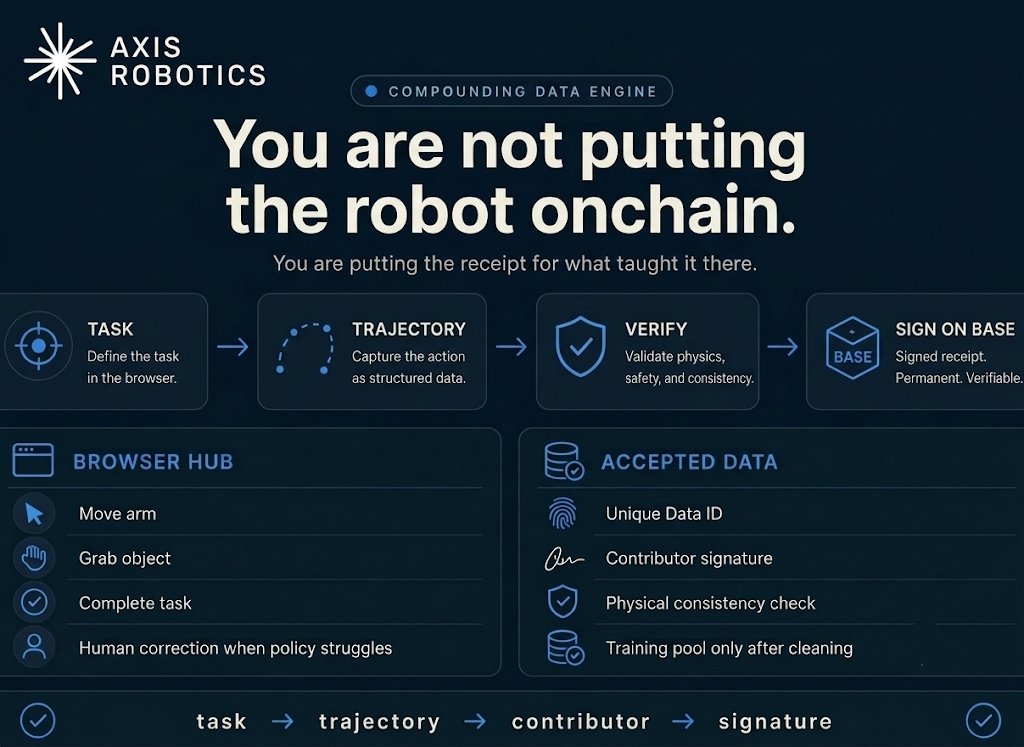
@AzadWeb3 详细讲解了 (39 个赞、36 条回复、262 次浏览)介绍了 Axis Robotics 的数据管线:一个浏览器任务先变成轨迹,轨迹经过重放和验证,只有被验收的数据回执才会在 Base 上签名。这张图之所以有用,在于它把一个模糊的实体 AI 数据工程叙事,拆成了明确的溯源链:任务 → 轨迹 → 验证 → 贡献者签名,而原始机器人数据本身仍保留在链下。
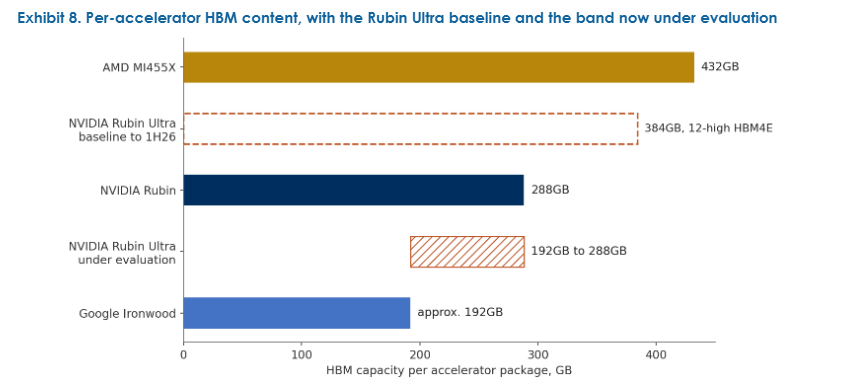
@0x_kairox 补充说 (21 个赞、24 条回复、91 次浏览)指出,当策略从 Python 评估迁移到浏览器和 WASM 运行时时,Axis 仍会损失性能,这意味着环境一致性和数据集规模同样重要。@StockSavvyShay 称 (113 个赞、8 条回复、17,184 次浏览、18 个书签)则认为,NVIDIA 修订后的 Rubin Ultra 内存规格,更能说明 HBM 供应上限,而不是 AI 需求在下滑。
讨论洞察: 基础设施和机器人领域的回复,从不同方向得出了同一个教训。Suraj 的讨论串指出,如果基准测试不纳入并发和缓存压力,就会错过真正的瓶颈;而 Axis 的讨论则表明,如果部署运行时与采集或评估环境不一致,再好的轨迹也不够。
与前一天对比: 相比 2026-09-11 在语音、表格预测、欺诈检测和预训练效率上的应用模型成果,2026-09-12 更集中在它们底下的系统层:显存上限、测量工具和数据溯源。
2. 人们在为什么事情感到沮丧
控制讨论跑在了具体监督机制前面
严重程度:高。@MabreyTed 称 (162 个赞、23 条回复、11,179 次浏览、54 个书签)指出,企业的投入产出已经倒挂,却仍缺乏对模型行为的可用控制;与此同时,@DarioAmodei 提出了 (100 个赞、25 条回复、3,847 次浏览、30 个书签)则提出让第三方评估者获得员工级访问权限。回复里最明显的挫败感在于:所有人都同意安全很重要,但对实际机制仍意见分裂——到底该靠嵌入式评估者、开放权重、中国协调,还是别的方案。
当天的应对方式仍然主要停留在争论,而不是操作层面。人们能说出治理原则,但讨论始终绕回到缺少具体控制界面、事件处理流程和共享监督规范这一点上。这值得去做,因为无论是公共评论者还是开发者,要求的都是可审查的机制,而不是更多修辞姿态。
只有在真实负载下才暴露出来的基础设施瓶颈
严重程度:高。@suraj_sharma14 梳理了 (72 个赞、5 条回复、2,093 次浏览、86 个书签)展示了一套部署栈,在其中 TTFT、ITL、自动扩缩容、令牌预算和租户隔离与模型选择同样重要;@Siddhant_K_code 发布了 (103 个赞、6 条回复、2,058 次浏览、63 个书签)则专门使用 LLMTraceFX 通过证据暴露推理瓶颈。Suraj 讨论串里有一条回复说,长上下文编码代理往往不是先输在原始 FLOPs 上,而是先输在 KV 缓存驻留和并发问题上;而 @StockSavvyShay 展示了 (113 个赞、8 条回复、17,184 次浏览、18 个书签)则指出,HBM 供应上限已经在扭曲加速器规划。
眼下可见的应对办法是近乎执拗的测量:公开拆解、性能分析器输出、TTFT 报告,以及按 token 计的成本仪表盘。这值得去做,因为团队仍在自己拼装整套观测工具,只为了弄清一次优化之后到底变了什么。
长时程代理研究仍在为评估噪声和脆弱环境烧算力
严重程度:高。@omarsar0 报道了 (44 个赞、13 条回复、4,029 次浏览、43 个书签)关注 Looped Flows,因为当梯度几乎传不到早期步骤时,循环推理就很难训练。@marfinxx 报道了 (27 个赞、6 条回复、1,228 次浏览、26 个书签)关注 AIRA2,因为自报式评估和单 GPU 搜索会随着时间推移触顶;@gurtej__gill_ 报道了 (9 个赞、172 次浏览、8 个书签)关注 Orchard,因为定制沙箱很难在不同执行框架之间迁移;@HuggingPapers 报道了 (9 个赞、5 条回复、582 次浏览、10 个书签)关注 WMRL,因为真实环境中的强化学习太贵。
值得注意的是,回复并不只是庆祝这些进展。它们不断追问:算力究竟是真的省下来了,还是只是被转移了;评估器是否仍可能被利用;模拟器或世界模型是否在教会系统错误的东西。这值得去做,因为同样的隐性成本正反复出现在推理、研究、SWE 和网页代理论文里。
实体 AI 仍有溯源缺口和运行时缺口
严重程度:中高。@AzadWeb3 介绍了 (39 个赞、36 条回复、262 次浏览)讨论的是 Axis 如何验证并签署已验收的轨迹,而不是盲目为原始交互数据付费;@0x_kairox 警告称 (21 个赞、24 条回复、91 次浏览)则指出,就算 Python 侧的 Dagger 分数更高,也不意味着策略迁移到浏览器和 WASM 运行时后还能活下来。
这里的挫败感非常具体,而不抽象。人们并不是泛泛地说机器人需要更多数据,而是在说:它需要的是可归属、可核验、还能迁移到与采集栈行为一致的部署环境中的数据。这值得去做,因为数据管线线程和运行时差距线程其实都指向同一个缺失层。
3. 人们希望出现什么
一个能被审查的控制层,而不只是安全承诺
推文和回复不断绕回“可审查性”。@MabreyTed 表示 (162 个赞、23 条回复、11,179 次浏览、54 个书签)指出,实用价值受制于控制能力;@DarioAmodei 提出了 (100 个赞、25 条回复、3,847 次浏览、30 个书签)则要求给评估者更深的外部访问权限。这个需求既现实又紧迫:人们想看到的是可指认的权限、日志、事件报告,以及按模型划分的治理机制。Anthropic 关于评估者访问权限的提案只部分回应了这一点,但今天的讨论表明,市场仍缺一个可信、共享的控制层。机会:直接。
能在普通硬件上完成真实工作的本地或私有代理
@AlexFinn 将其定义为 (72 个赞、19 条回复、6,737 次浏览、51 个书签)把本地模型视为自主性与隐私的抓手;@_avichawla 展示了 (33 个赞、4 条回复、3,032 次浏览、36 个书签)展示了 MiniCPM5-2B 在本地完成完整调查;@TeksEdge 展示了 (22 个赞、2 条回复、1,391 次浏览、14 个书签)则展示了一个 9B 模型会判断何时该输出可直接用于界面的 JSON,而不是普通文本。这个需求同时包含现实层面和情绪层面:人们既想降低持续成本、增强数据控制,也想真正拥有工作流,而不是向前沿实验室租用它。LM Studio、llama.cpp、MiniCPM 和开放权重的 Qwen 衍生模型覆盖了其中一部分,但回复仍暴露出硬件匹配、持续在线和本地工具桥接方面的缺口。机会:竞争激烈。
与执行框架无关的环境,以及更便宜的代理训练循环
AIRA2、Orchard 和 WMRL 都指向同一个未被满足的需求:长时程代理训练太贵、太容易被误评,而且与定制沙箱绑定得太深。@marfinxx 强调了 (27 个赞、6 条回复、1,228 次浏览、26 个书签)关注隐藏评估和异步工作者;@gurtej__gill_ 强调了 (9 个赞、172 次浏览、8 个书签)关注可复用环境层;@HuggingPapers 强调了 (9 个赞、5 条回复、582 次浏览、10 个书签)则关注更便宜的世界模型奖励循环。这些论文给出的是部分答案,但回复清楚表明,计算量匹配、模拟器保真度和奖励劫持仍是未解问题。机会:直接。
具备来源证明与仿真到现实一致性的实体 AI 数据基础设施
与 Axis 相关的讨论串不断用不同措辞重复同一个愿望:只有当每条轨迹都能被验证、归属,并迁移到一个行为与训练环境一致的运行时里,让更多人参与机器人数据采集才有意义。@AzadWeb3 介绍了 (39 个赞、36 条回复、262 次浏览)体现了这一需求的溯源侧,@0x_kairox 介绍了 (21 个赞、24 条回复、91 次浏览)则体现了运行时侧。当前工作流已经能签署被验收的贡献并过滤坏数据,但浏览器和 WASM 的警告说明,光有溯源还不够。机会:直接。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| LM Studio + 本地开放模型技术栈 | 本地运行时 | (+) | 在消费级硬件上快速搭建私有工作流;无需强制上云 | 小型硬件只能替代部分工作流;持续在线能力和 RAM 匹配仍然重要 |
| MiniCPM5-2B | 小型 LLM | (+) | 支持跨多种运行时和移动端目标的本地编码与工具调用 | 今天的证据主要来自一条很强的演示帖,而非广泛的一线使用报告 |
| Mark 1x-9B | 小型 LLM / UI 模型 | (+) | 能在普通文本与结构化 UI 工件之间做选择;小模型基准成绩具备竞争力 | 仍依赖渲染器和外围工具;在部分测试上落后于领先模型 |
| Squad | 代理工作区 | (+) | 内置工具、记忆、云端计算机,并可复用现有 AI 订阅 | 初始上下文迁移需要时间;配置质量决定实际价值 |
| LLMTraceFX | 推理可观测性 | (+) | 统一测量模式、确定性验证、基于策略的调优 | 仍属早期工具;需要严格的基准测试流程 |
| Thinking with Looped Flows | 推理方法 | (+/-) | 改进循环训练,并允许在不增加参数的情况下做计算深度权衡 | 额外循环会增加推理成本;回复质疑其比较是否做到了计算量匹配 |
| AIRA2 | 研究代理架构 | (+) | 异步多 GPU 搜索、隐藏评估和有状态 ReAct 循环 | 需要大量编排和算力;收益可能仍依赖基准设计 |
| Orchard Env / Orchard-SWE | 代理环境框架 | (+) | 与执行框架无关的 Kubernetes 环境、可复用轨迹,以及强劲的开源代理成绩 | 基础设施负担重;对多数团队来说仍停留在论文阶段 |
| WMRL | 强化学习训练方法 | (+/-) | 相比真实环境中的 GRPO,训练计算量减少 3.1 倍到 3.4 倍,同时提升留出集得分 | 世界模型可能继承模拟器或评分器的盲点 |
| Axis Robotics Hub | 机器人数据平台 | (+/-) | 基于浏览器的任务采集、人工纠正、溯源与验证流程 | 仿真到现实以及浏览器运行时的差距仍未解决 |
| Trust3R | 3D 重建模型 | (+) | 单次前向传播即可给出经校准的逐像素不确定性;风险-覆盖信号更强 | 有一定额外开销;在困难的分布外场景下,不确定性质量仍是悬而未决的问题 |
| ANVIL III / Feather-1.7B | 预训练技术栈 | (+) | 以具体的速跑图表支撑效率与小模型数学能力主张 | 证据主要来自项目方自发布内容,且优化器仍有部分细节未公开 |
满意度分化最大的是代理基础设施,而不是原始基座模型。本地运行时和小模型相关帖子整体偏乐观,因为它们降低了对前沿 API 的依赖,但仍离不开仔细的硬件匹配、专用设备和工具桥接。代理训练相关帖子则一边对新方法持积极态度,一边公开质疑评估泄漏、模拟器偏差,以及省下的算力究竟是真的省了,还是只是换了个地方消耗。
迁移趋势同时朝两个方向发生。开发者一方面正从“只用前沿模型”的工作流,转向本地化或复用现有订阅的技术栈;另一方面也在从单体代理循环,转向显式拆分的环境、评估器、记忆和溯源层。硬件约束同样始终可见:HBM 容量和 GPU 合同结构不断以一阶产品变量的身份出现,而不再只是后台采购细节。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| LLMTraceFX | @Siddhant_K_code | 以证据为先的推理性能分析与验证工具包 | 在团队盲目优化前,让 GPU 和推理瓶颈可见 | Python、规范化实验记录、确定性工作负载验证 | 已发布 | 文章、仓库、论文 |
| MiniCPM5-2B | OpenBMB,由 @_avichawla 分享 | 针对编码、工具调用和多步骤调查调优的 2B 本地模型 | 让资源受限硬件也能跑出有用的代理工作流 | 2B 稠密模型、SGLang、vLLM、llama.cpp、Ollama、移动端运行时 | 已发布 | 文章 |
| Mark 1x-9B | Saanora Labs,由 @TeksEdge 分享 | 基于 Qwen 的 9B 模型,可输出结构化 UI 工件,而不只是文本 | 缩小模型输出与可用界面之间的落差 | Qwen3.5-9B、开放权重、结构化 JSON 与 UI 生成、llama.cpp GGUF | Beta | 文章 |
| Squad AI teammates | Squad,由 @pbteja1998 分享 | 具备任务队列、记忆、连接器和云端执行能力的代理工作区 | 无需定制编排即可接手重复性运营工作 | 现有 ChatGPT 和 Claude 套餐、内置搜索、Composio、云端计算机、记忆 | 已发布 | 文章、网站 |
| AIRA2 | Meta FAIR,由 @marfinxx 分享 | 使用异步工作者、隐藏评估和 ReAct 循环的研究代理 | 防止长时程研究代理卡死在评估噪声和单 GPU 搜索上 | 多 GPU 工作者、Hidden Consistent Evaluation、ReAct 代理 | Alpha | 文章、论文 |
| Orchard | Microsoft Research,由 @gurtej__gill_ 分享 | 与执行框架无关的环境层与跨领域代理方案 | 在不同任务间复用轨迹、沙箱和评估协议 | Orchard Env、Kubernetes、Qwen3.5-35B-A3B、价值模型重排序 | Alpha | 文章、论文 |
| WMRL | Amazon 和 UIUC,由 @HuggingPapers 分享 | 用世界模型加偏差与噪声修正替代真实执行 RL 环境 | 降低研究代理训练成本 | 世界模型 RL、在线去偏、逆方差去噪 | Alpha | 文章、项目 |
| Axis Robotics Hub | Axis Robotics,由 @AzadWeb3 分享 | 基于浏览器的机器人任务采集,并提供轨迹验证和溯源回执 | 扩大机器人数据采集,同时让贡献链路可审计 | 浏览器 Hub、仿真重放、数据清洗、Base 签名 | Beta | 文章 |
| Trust3R | phai-lab 和 Texas A&M,由 @rsasaki0109 分享 | 具备经校准逐像素不确定性的 3D 重建 | 为下游系统提供可信的不确定性信号,而不是启发式置信度 | 冻结的 MASt3R 主干、证据头、门控残差头 | Beta | 文章、仓库 |
| Feather-1.7B + ANVIL III | @DevenPzak / Hyperstition | 小模型预训练技术栈与新型优化器 | 在保持小模型数学性能竞争力的同时降低训练成本 | ANVIL III 优化器、1.7B 基础模型、200B-token 预训练 | Alpha | 文章 |
LLMTraceFX 是开发者通过“测量”而不是“更大模型”来回应瓶颈的最清晰例子之一。论文、代码仓库和推文都围绕同一套工作流展开:先测量发生了什么,再用确定性工作负载核验输出,只有在证据支持时才优化。
小模型这一簇则遵循了另一种同样一致的模式。MiniCPM5-2B、Mark 1x-9B 和 Squad 都在试图把有用工作压缩进更便宜或更可控的封装里,再把省下来的预算投入记忆、工具或界面生成,而不是砸在尽可能大的基座模型上。
AIRA2、Orchard 和 WMRL 体现了当天最反复出现的构建模式:把代理中原本隐藏的部分外置成可复用基础设施。搜索循环、评估协议、世界模型和环境服务都被做成明确的产品或研究工件,因为开发者认为,下一轮增益会更多来自周边系统,而不只是模型本身。
Axis Robotics 和 Trust3R 是当天最强的应用 AI 例子,因为二者都把可靠性视为产品的一部分。Axis 在轨迹数据成为训练材料之前加入验证与溯源;Trust3R 则加入经校准的不确定性,让下游几何系统知道哪些地方不该信任重建结果。

6. 新的和值得注意的
AI 辅助数学触及了几何学最古老的开放问题之一
@QuantaMagazine 报道称 (57 个赞、1 条回复、6,733 次浏览、25 个书签)指出,一个大语言模型找到了数学家自 1947 年以来一直在寻找的对象。Quanta 的 Transformation 更新称,这个结果是六维球面 S6 上的一种复结构,这是一个与 Heinz Hopf 相关的长期问题,因此这比那种泛泛总结定理的帖子更能说明 AI 在数学中的实质性进展(更新)。
算力风险开始更像一个市场,而不只是采购头痛问题
@jessiedong_ 询问了 (15 个赞、1 条回复、445 次浏览、6 个书签)提出了一个问题:到底谁会去交易与 GPU 租赁价格指数挂钩、以现金结算的 H100 和 B200 期货?附图之所以值得注意,在于它区分了金融期货市场与实体 GPU 容量合约,并暗示最早的真实对冲需求,可能来自新型云服务商、出租方和转售商,而不是资金吃紧的 AI 初创公司。

小模型训练效率仍在不断给出具体、但主要仍由项目方自发发布的主张
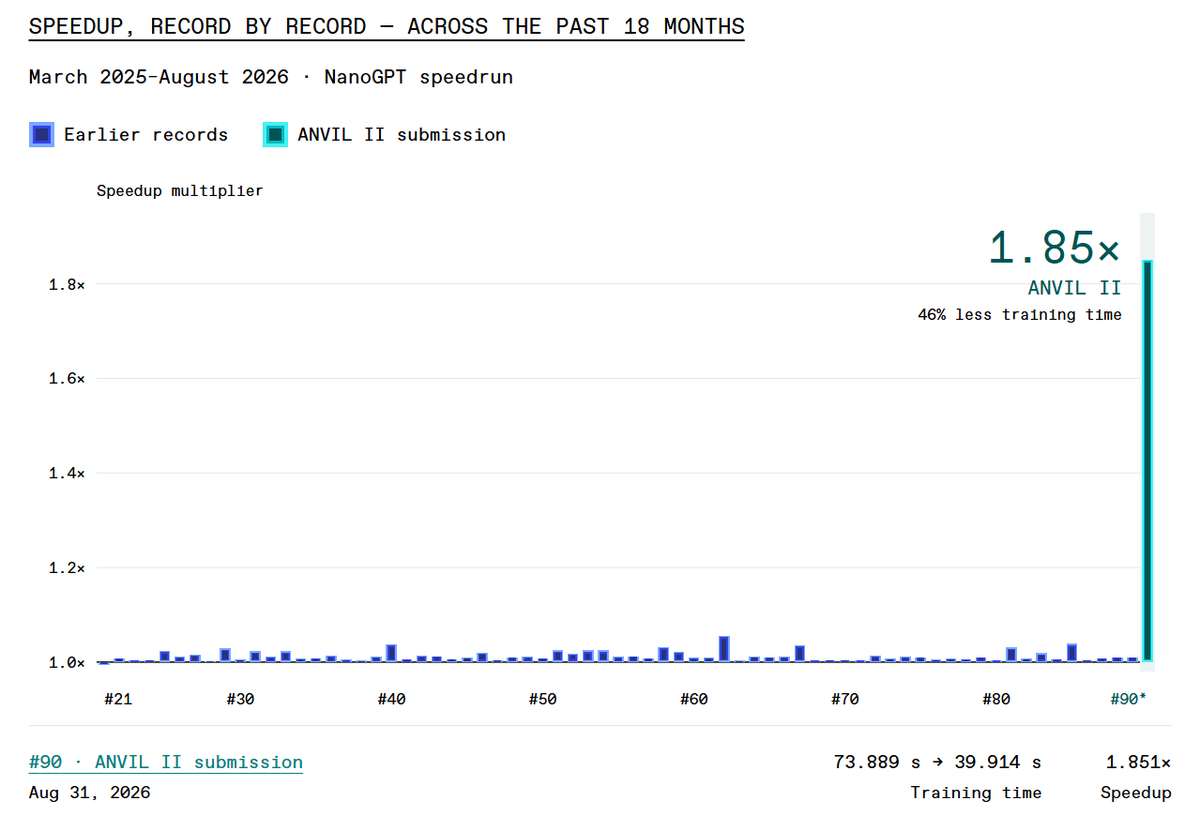
@DevenPzak 报道称 (42 个赞、2 条回复、4,866 次浏览、36 个书签)展示了新的 ANVIL III 优化器、Feather-1.7B 基础模型,以及 NanoGPT 速跑成绩从 73.889 秒降到 39.914 秒。速跑图表是这条讨论里最具体的部分;而推文中“相比 Qwen3-1.7B 计算量低 180 倍”的说法,也让它成为当天较清楚地说明优化器和训练循环工作仍能推动小模型前沿的案例之一。
7. 机会在哪里
[+++] Deployed-AI control and evaluation layer — Evidence from @MabreyTed、@DarioAmodei、LLMTraceFX 和 AIRA2 都指向同一个缺失的产品层:可测量的控制、可信的评估者、事件报告,以及按工作负载定制的验证。这个信号很强,因为它同时出现在公共治理争论、企业成本焦虑和开发者工具中。
[++] 具备结构化输出的本地与私有代理技术栈 —— MiniCPM5-2B、Mark 1x-9B、LM Studio 工作流和 Squad 都表明,市场对更小但仍能行动、保持上下文并生成可用工件的系统有明确需求。机会中等,因为需求显而易见,但剩下的缺口在于产品封装、硬件匹配、内存行为和工具桥接。
[++] 面向可复用环境与更廉价搜索的代理训练基础设施 —— AIRA2、Orchard 和 WMRL 分别击中了不同的隐藏瓶颈:搜索并行性、与执行框架无关的沙箱,以及真实环境强化学习的成本。现有证据表明,环境服务、重放与评估工具,以及高算效后训练基础设施,存在真实市场,而不只是单一用途的基准封装。
[++] Physical-AI provenance and runtime validation — Axis-related threads and @0x_kairox表明,机器人开发者需要的不只是原始轨迹,他们还需要可验证的来源链路、一致的环境,以及从仿真到部署的清晰交接。这个信号强度中等,因为使用场景比通用 AI 更窄,但需求具体且反复出现。
[+] GPU 容量风险管理 —— HBM 容量讨论串和算力期货图都表明,硬件稀缺和合约设计本身正在变成产品问题。这仍是一个新兴领域,还谈不上成熟,但如果 GPU 租赁市场继续碎片化,它的重要性可能会上升。
8. 结论
- 控制取代“必然性”成为当天最核心的争论。 MabreyTed 和 Dario 都把问题框定为当下的治理与可审查性,而不是抽象炒作。(来源)
- 有用的小模型如今被展示成“员工”,而不是玩具。 MiniCPM5-2B 在本地调查了一起营收事故,Mark 1x-9B 则被包装成一个能生成 UI 的模型,而不是更便宜的聊天接口。(来源)
- 代理研究正越来越多地围绕训练基础设施和评估设计展开。 Looped Flows、AIRA2、Orchard 和 WMRL 都声称,其收益来自更好的循环、环境或奖励信号,而不只是更大的基座模型。(来源)
- 基础设施瓶颈正从 KV 缓存一路上浮到 HBM 供应。 Suraj 的路线图、LLMTraceFX 和 StockSavvyShay 的内存图都把测量与容量视为一阶约束。(来源)
- 实体 AI 的构建,既是数据溯源与运行时一致性问题,也是模型问题。 与 Axis 相关的讨论强调,在轨迹数据变得有价值之前,必须先解决验证、贡献者来源链路和环境一致性。(来源)