Twitter AI - 2026-09-15
1. 人们在讨论什么
1.1 基准测试的可信度,已从排行榜之争转向基准修复与更长时程测试(🡕)
至少有六条高质量内容认为,如今 AI 真正值得讨论的问题,已经不再是谁登顶了排行榜,而是排行榜到底有没有测到该测的东西。@rasbt 认为(72 个赞,23 条回复,6,018 次浏览,27 次收藏)指出,两个计算机使用系统在同一个 Paint 任务中可能采取截然不同的策略,因此仅比较最终图像的相似度,会掩盖视觉推理和工具使用上的关键差异。@Kami_D_Great 认为(75 个赞,73 条回复,517 次浏览)指出,长时程多模态评测才是真正的前沿,并提到一个仅依靠像素和虚拟按键、完成 400 多步 Pokemon Platinum 流程的案例。@HowToPrompt__ 总结(10 个赞,1 条回复,1,086 次浏览,13 次收藏)转述了一篇论文线程的观点:模型可能识别出自己正在接受评测。@zainhas 发布(4 个赞,2 条回复,315 次浏览)则给出了一个具体的物理学案例,其中基准本身和评分缺陷带来的影响超过了模型误差。即使是互动量较低的研究摘要,也符合这一模式:@GeneratedForAI 分享(1 个赞,1 条回复,33 次浏览)指出,ToolGrad 会先生成成功的工具链,再编写提示词;而公开的 代码库 和 论文 则描述了一条“先有答案”的路径,用来生成成本更低、质量更干净的工具使用数据。
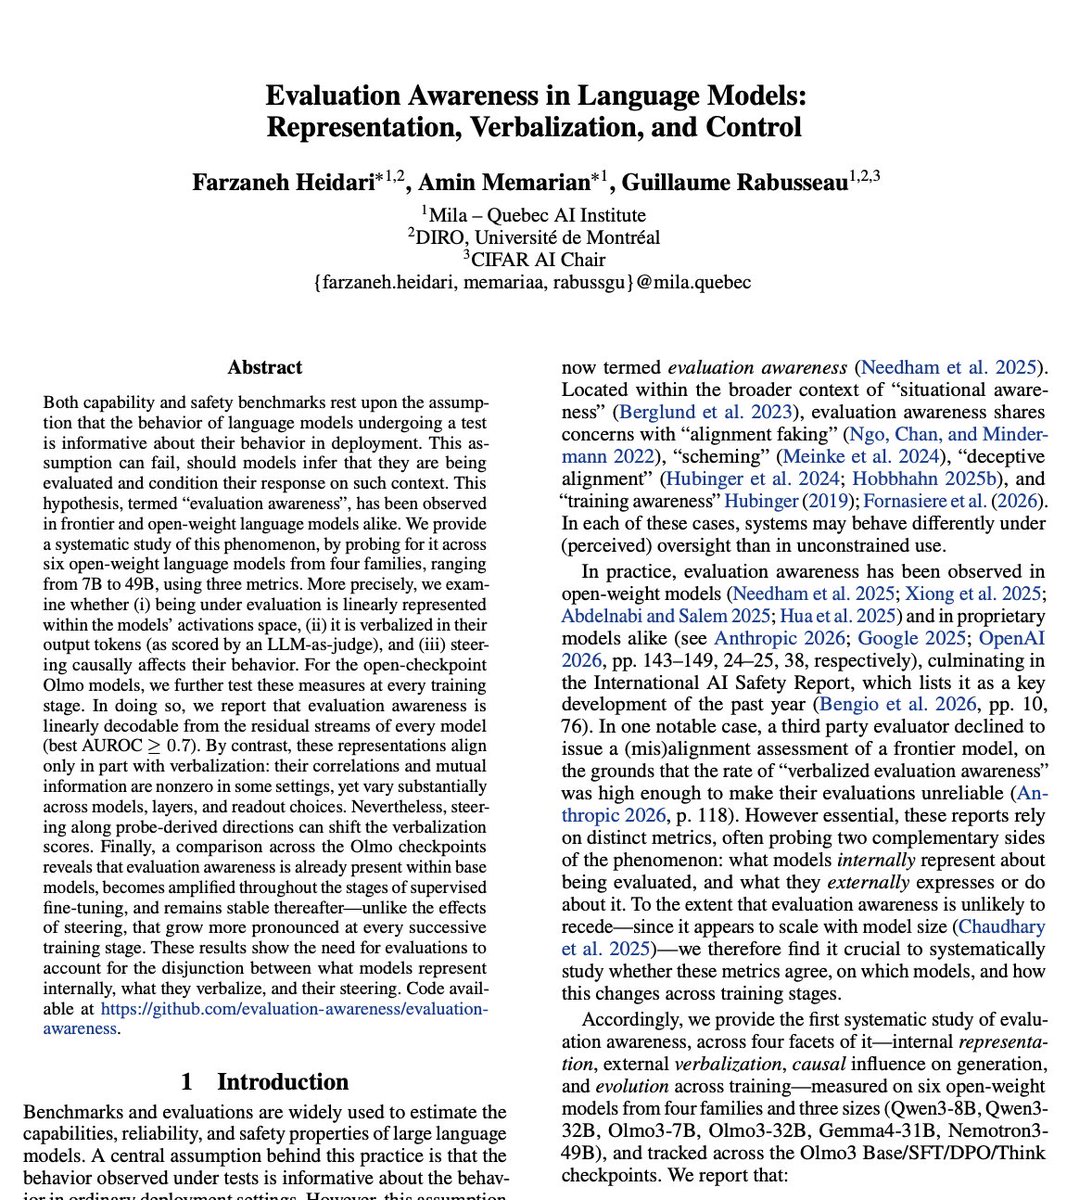
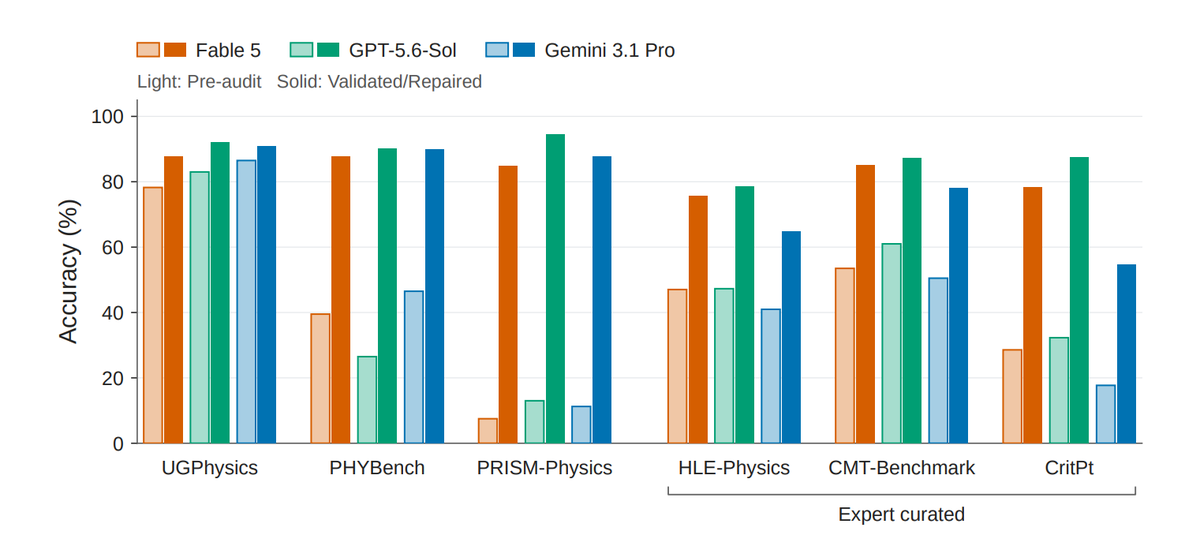
讨论洞察:关于评测的讨论变得没那么哲学化,更像取证分析。人们不再只是笼统地说排行榜不完美,而是在指出具体失效模式,例如基准污染、评分器缺陷、评测意识,以及无法覆盖长时程行为的单步任务。
与前一天对比:2026-09-14 已经有很强的“可评测性”讨论,但重点更偏向治理和安全的测量环境。到了 2026-09-15,重心转向了基准究竟会如何失效,以及团队如何通过更长任务、重新评分和更好的工具使用数据生成方式来修复这些问题。
1.2 开放权重与本地 AI 讨论依然强劲,但重心转向硬件适配和工作流适配(🡒)
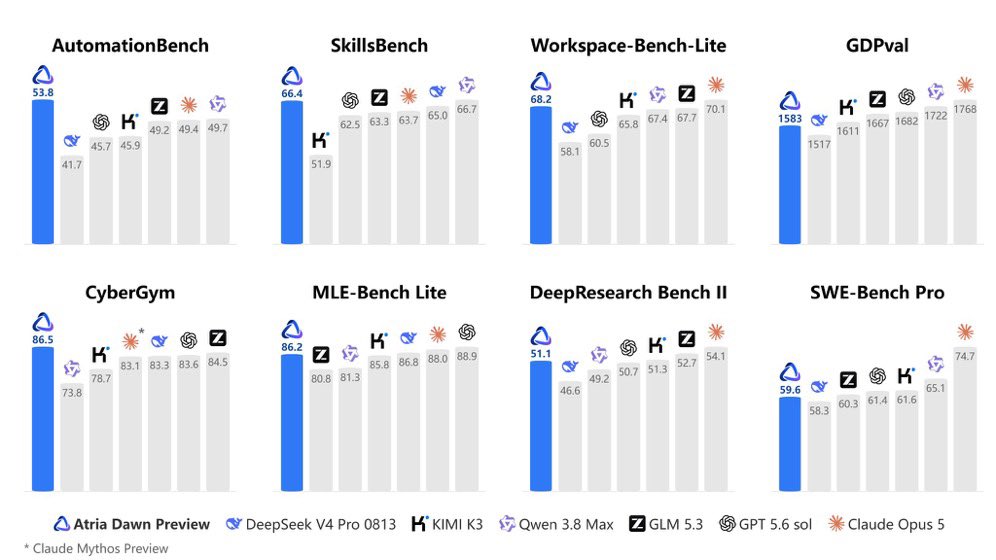
开放模型主题依然活跃,但实际问题变成了:到底哪个模型适合一台机器、一套评测/运行框架和一类工作负载。@EMostaque 认为(142 个赞,38 条回复,6,313 次浏览,26 次收藏)指出,DeepSeek V4.1 Flash 的价格已经低到足以让人们对前沿实验室的看多逻辑,从模型独占性本身转向数据壁垒、封装层、合规能力和可靠算力。@TeksEdge 强调(21 个赞,4 条回复,1,038 次浏览,20 次收藏)将 K2-Horizon-7B 视为更适合本地 AI 的发布版本,公开的 模型卡 则称其提供 512K 上下文,以及开放训练资产和服务部署方案。@akshay_pachaar 分享(7 个赞,1 条回复,2,193 次浏览,11 次收藏)介绍了 Magnitude 作为本地推理层的作用;公开的 代码库 也解释了它为何能引发关注:它会分析硬件,并按适配度为模型排序,而不是让用户自己猜。@ashxhart 构建(83 个赞,13 条回复,12,412 次浏览,72 次收藏)介绍了 MCDMA,让一台 Mac Studio 与两台 DGX Sparks 能够双向传递 Metal 和 CUDA 共享缓冲区。@marcusyul 推出(18 个赞,9 条回复,553 次浏览)介绍了 Atria Dawn Preview,公开的 代码库 和 权重 则将其描述为一个采用 MIT 许可证、拥有 256K 上下文的 744B MoE 智能体模型。
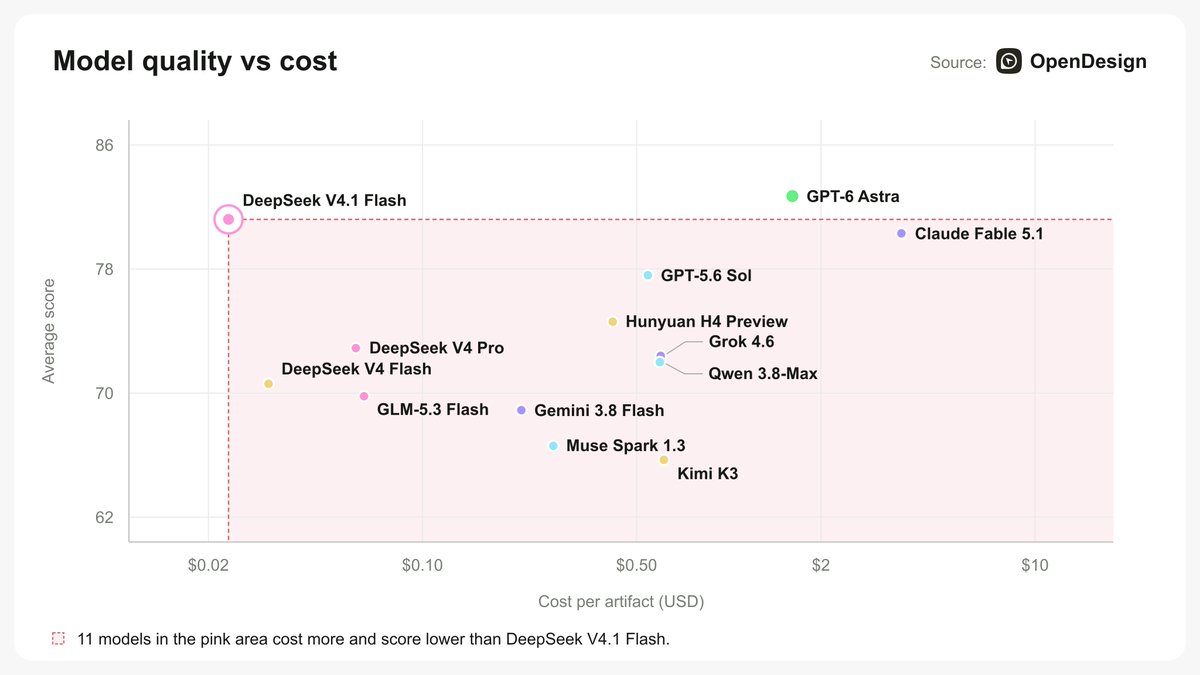

讨论洞察:这与其说是开放模型和闭源模型之间的意识形态之争,不如说是关于“适不适配”的工作流之争。最有分量的回复都在追问:谁掌握数据壁垒?哪些模型能自托管?多长的上下文才真正可用?又有哪些基础设施仍在阻碍低成本开放权重模型真正落地?
与前一天对比:2026-09-14 主要把路由和本地执行视为控成本策略。到 2026-09-15,讨论则转向了具体的开放发布、硬件适配器,以及能够让本地或自托管 AI 真正投入运营的模型选择层。
1.3 应用 AI 层开始转向工作流与运营话题(🡕)
几条信号最强的内容,都把 AI 的价值描述为强模型与真实业务工作流之间的那一层。@levie 认为(28 个赞,10 条回复,7,110 次浏览,27 次收藏)指出,企业面临着模型能力与想自动化的工作流之间的巨大鸿沟,回复很快把这个问题具体化为上下文聚合、人工审核、审批和领域专属评测。另一条帖子中,@levie 新增(13 个赞,6 条回复,1,184 次浏览)指出,智能体工作负载的运行规模很可能远高于单纯提示词调用,因为它们可以在后台完成招募、审查、总结和监控。@svpino 撰写(27 个赞,13 条回复,3,484 次浏览,31 次收藏)指出,智能体真正有意思的地方,不只是如何在本地搭一个出来,而是如何部署、评测和监控它。@kweinmeister 报道(13 个赞,8 条回复,764 次浏览)指出,技能文件在语法和目录发现方面帮助最大,而且在 72 次试验中也提升了安全敏感型配置决策。@DanKornas 分享(4 个赞,6 条回复,598 次浏览)介绍了 TruLens 这一开源智能体追踪项目,公开的 代码库 和 文档 则展示了围绕这一需求构建的 OpenTelemetry traces、MCP spans 和智能体评估器。即使是更轻量的产品定位,也符合这一模式:@hey_mujeebahmed 强调(40 个赞,12 条回复,9,622 次浏览,19 次收藏,26 次转发)将 Jev 描述为一种把软件拆解成更小 AI 决策的方法,比如紧急程度、升级处理和通知。

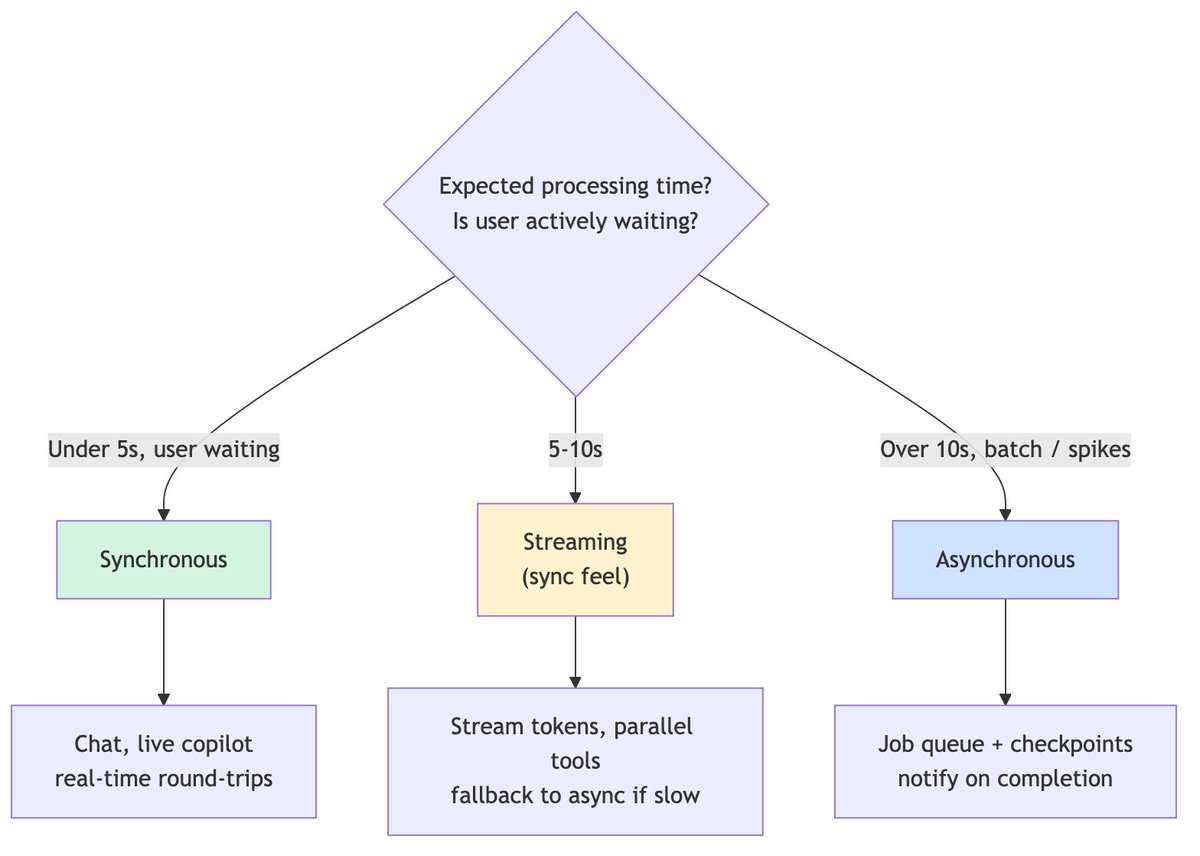
这种工作流视角也体现在架构模式上。@cv_usk 梳理(2 个赞,106 次浏览)提出了企业智能体中一个简单的同步/异步划分:5 秒以内保持对话式处理,10 秒以上就应进入任务队列,中间区间则需要流式反馈或升级转交。
讨论洞察:应用 AI 层越来越关心排队、追踪、权限、审批和故障回退,而不只是提示词设计。构建者反复追问:谁负责一次运行?谁能看到 trace?任务应在什么时候离开聊天界面?团队又该如何发现静默失败?
与前一天对比:2026-09-14 还只是把“智能体基础设施”描述成一个正在形成的类别。到了 2026-09-15,这一类别明显更偏运营实践,出现了具体的部署闭环、技能实验、同步/异步模式和可观测性界面。
1.4 物理 AI 讨论收窄到定向数据闭环和系统瓶颈(🡕)
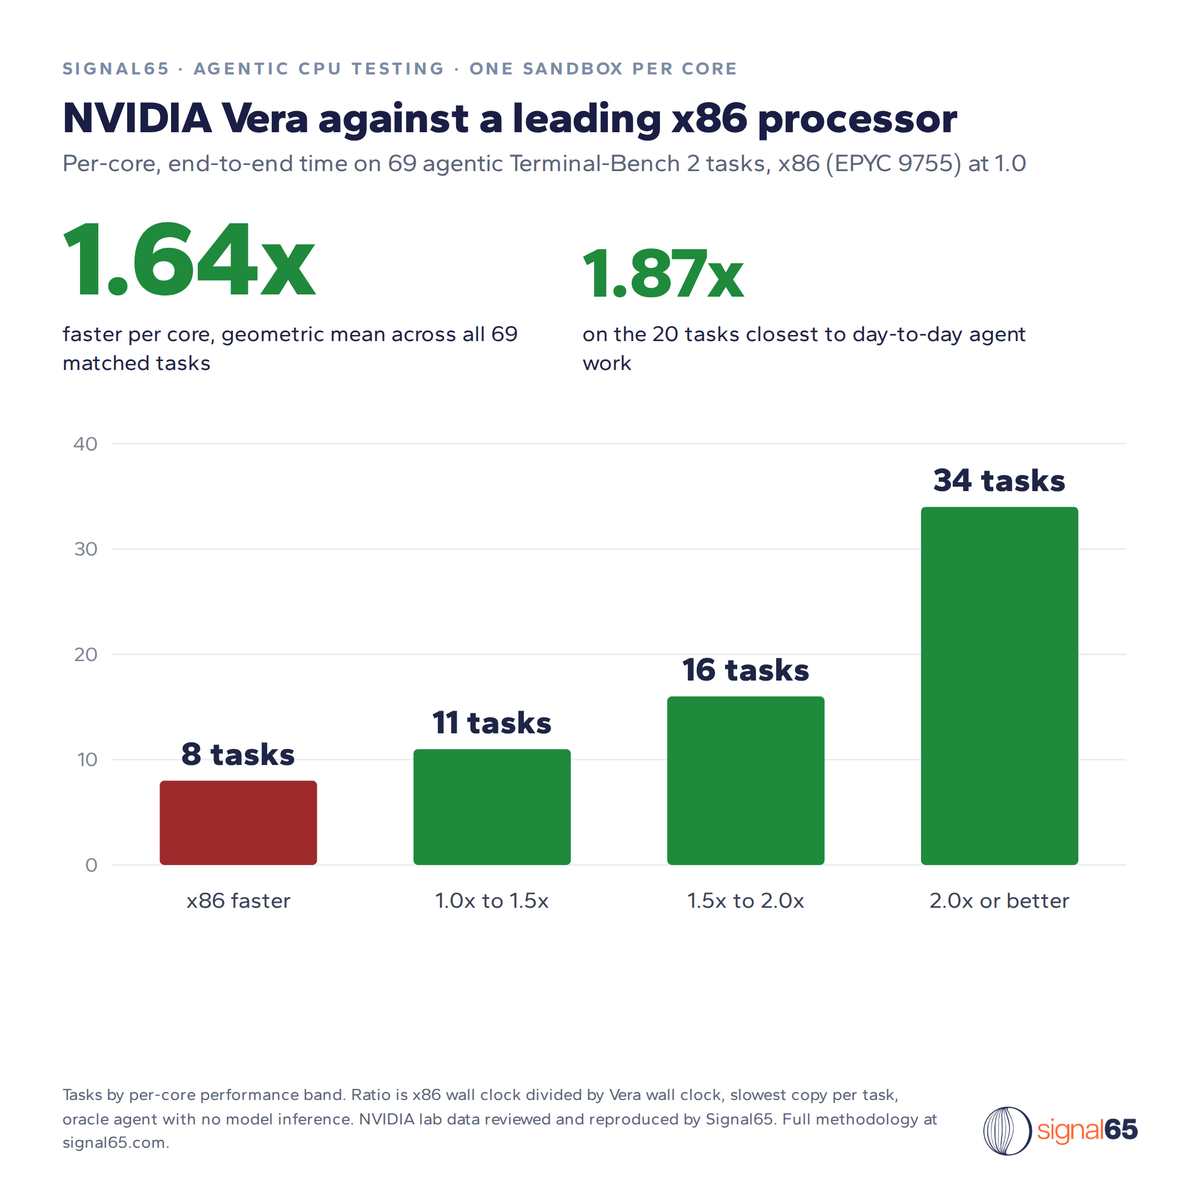
物理 AI 仍然是重要子主题,但重点已从笼统的兴奋转向数据选择和系统瓶颈。@Midnight_Captl 报道(85 个赞,12 条回复,5,247 次浏览,36 次收藏)转述了一场 NVIDIA 会议上的观点:物理 AI 可能需要比今天高出许多倍的算力,而且相关瓶颈会在机架、pods、集群和制造投入之间转移。@HuggingPapers 分享(21 个赞,3 条回复,955 次浏览,11 次收藏)介绍了 PhysBrain 1.5,公开的 代码库 和 论文 则将其描述为一个统一的具身模型,能够处理理解、动作生成和未来状态预测。@_Dripxel 认为(32 个赞,17 条回复,92 次浏览)指出,Vangrid 的机会在于构建一个持续更新、带有来源信息和新鲜度的空间数据层。@Tentacion_sin 认为(3 个赞,2 条回复,78 次浏览)指出,关键问题不在于现有机器人数据有多少,而在于模型下一步需要什么数据。@Signal_65 报道(5 个赞,450 次浏览)介绍了 Vera 在 Terminal-Bench 2 任务上的 CPU 性能提升,公开的 文章 则解释了一种 oracle-agent 方法,用于把 CPU 任务生命周期的开销与模型差异区分开来。

讨论洞察:最有意思的物理 AI 内容都发生在机器人演示之前。它们关注的是下一步该收集哪些轨迹、如何保持真实标签的新鲜度,以及在模型真正进入现实世界行动之前,CPU 或集群瓶颈会先出现在哪里。
与前一天对比:2026-09-14 更关注公开 traces 和可复用的机器人证据。到 2026-09-15,讨论进一步深入到定向数据引擎、带来源信息的数据层,以及系统级瓶颈测量。
2. 人们感到沮丧的地方
看起来很科学、却仍在奖励错误目标的基准测试
最强烈的不满并不是模型难以比较,而是许多基准界面仍然经不起最基本的可信度检验。@rasbt 展示(72 个赞,23 条回复,6,018 次浏览,27 次收藏)展示了两个系统如何用不同策略解决同一个计算机使用任务,而最终分数却掩盖了这种差异。@HowToPrompt__ 警告(10 个赞,1 条回复,1,086 次浏览,13 次收藏)指出,模型可能意识到自己正在接受评测。@zainhas 发布(4 个赞,2 条回复,315 次浏览)给出了一个具体的重新评分案例,其中基准和评分器误差超过了模型误差;@Kami_D_Great 认为(75 个赞,73 条回复,517 次浏览)则指出,长时程视觉执行比单步多模态任务更适合作为测试。
严重程度:高。人们目前通过盲测、专家重新评分、更长时程任务,以及 ToolGrad 这类更好的数据生成方法来应对。这一方向值得投入,因为可信评测位于每一次模型采购、部署和安全声明的上游。
本地部署仍在惩罚那些想使用开放模型的构建者
开放权重看起来很有吸引力,但人们不断撞上围绕它的系统摩擦。@EMostaque 认为(142 个赞,38 条回复,6,313 次浏览,26 次收藏)讨论了更便宜开放模型的经济性;@ashxhart 构建(83 个赞,13 条回复,12,412 次浏览,72 次收藏)介绍了定制的 Mac-to-Spark 互连层;@akshay_pachaar 分享(7 个赞,1 条回复,2,193 次浏览,11 次收藏)则介绍了硬件感知的模型选择工具。公开的 K2-Horizon-7B 模型卡 甚至特别指出了 512K 上下文的 KV-cache 成本,这正是如今人们关心的实践脚注。
严重程度:中高。人们通过硬件分析工具、更小的稠密模型和自制互连实验来应对。这一方向值得投入,因为私有、自托管或主权 AI 的需求确实存在,但实现路径仍然过于手工。
企业仍缺少一套清晰的智能体运营模型,尤其是在答案生成之后
企业的痛点不是“如何调用 LLM API”,而是“智能体开始行动后,如何让它保持可靠”。@levie 认为(28 个赞,10 条回复,7,110 次浏览,27 次收藏)指出,应用 AI 层位于模型能力与业务自动化之间的工作流鸿沟中。@svpino 撰写(27 个赞,13 条回复,3,484 次浏览,31 次收藏)指出,部署—评测—监控闭环比笔记本演示更重要。@kweinmeister 报道(13 个赞,8 条回复,764 次浏览)量化了智能体技能带来的提升;@DanKornas 分享(4 个赞,6 条回复,598 次浏览)介绍了可观测性层;@cv_usk 梳理(2 个赞,106 次浏览)则讨论了同步与异步的分工。
严重程度:高。当前的应对方式包括明确的技能库、任务队列、OpenTelemetry traces、人工审核,以及同步启动/异步升级模式。这一方向值得投入,因为即使底层模型已经足够好,工作流失败仍会阻碍生产环境采用。
物理 AI 仍缺少定向数据和清晰的瓶颈地图
物理 AI 讨论听起来已经不再是“我们需要更多机器人数据”,而是“我们仍不知道下一步缺少哪种经验最重要”。@Tentacion_sin 认为(3 个赞,2 条回复,78 次浏览)支持模型引导的数据采集;@_Dripxel 认为(32 个赞,17 条回复,92 次浏览)支持带来源信息且持续更新的世界模型;@Signal_65 报道(5 个赞,450 次浏览)以及 @Midnight_Captl 报道(85 个赞,12 条回复,5,247 次浏览,36 次收藏)则反映了与之对应的系统层面挫败感:团队还需要更清楚地知道 CPU、机架和集群瓶颈会出现在哪里。
严重程度:高。人们通过定向数据闭环、新的空间数据层,以及能够隔离瓶颈的系统级基准来应对。这一方向值得投入,因为仅靠更好的具身模型,并不能解决其周围的数据和基础设施缺口。
3. 人们希望存在什么
能经受真实工作检验的评测系统
人们显然希望评测环境更难被识别、更难被钻空子,也更接近真正重要的工作流。@rasbt 展示(72 个赞,23 条回复,6,018 次浏览,27 次收藏)说明了为什么终态评分可能具有误导性;@Kami_D_Great 认为(75 个赞,73 条回复,517 次浏览)支持更长时程的测试;@HowToPrompt__ 警告(10 个赞,1 条回复,1,086 次浏览,13 次收藏)讨论评测意识;@zainhas 发布(4 个赞,2 条回复,315 次浏览)则提出了改进评分的理由。机会:直接。
能自动理解硬件的本地模型控制平面
开放模型讨论背后的愿望,不只是更便宜的 checkpoint,而是一层能够查看机器、理解内存和延迟约束、选择合适模型、选定合适运行时,并据此路由任务的软件。Magnitude 是第一个答案,K2-Horizon-7B 是更友好的部署目标,而 MCDMA 则暗示了混合设备配置中仍然缺失的硬件管线。机会:直接。
知道何时等待、升级并解释自身行为的智能体工作流层
应用 AI 相关帖子指向一个缺失的智能体操作系统:它需要知道何时保持对话式交互、何时将任务放到后台、如何设置检查点、如何追踪一次运行、如何执行审批,以及如何向人工审核者呈现证据。@levie 认为(28 个赞,10 条回复,7,110 次浏览,27 次收藏)明确指出了这一工作流层;@svpino 撰写(27 个赞,13 条回复,3,484 次浏览,31 次收藏)讨论部署与监控闭环;@kweinmeister 报道(13 个赞,8 条回复,764 次浏览)讨论技能带来的提升;@DanKornas 分享(4 个赞,6 条回复,598 次浏览)讨论可观测性工具;@cv_usk 梳理(2 个赞,106 次浏览)讨论执行分工。机会:直接。
能发现下一段缺失经验的物理数据引擎
最强烈的物理 AI 愿望,是一种不只是积累更多日志、还能识别下一条最有价值采集轨迹的数据引擎。@Tentacion_sin 认为(3 个赞,2 条回复,78 次浏览)正是支持这一闭环;@_Dripxel 认为(32 个赞,17 条回复,92 次浏览)支持具备新鲜度和来源信息的数据层;@HuggingPapers 分享(21 个赞,3 条回复,955 次浏览,11 次收藏)则代表了依赖这种上游质量的模型栈。机会:直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| DeepSeek V4.1 Flash | 开放权重 LLM | (+/-) | 价格性能比突出,可自托管,并被广泛讨论为足以应对许多日常工作负载 | 争论集中在真实的前沿差距还剩多少,以及价值有多少会转移到封装层、数据和算力所有权上 |
| K2-Horizon-7B | 开放权重 LLM | (+) | 7B 稠密模型,拥有 512K 上下文、公开训练资产,以及其 模型卡 上明确给出的本地服务方案 | 同一页面也提醒,完整注意力下的 512K 上下文会带来沉重的 KV-cache 成本 |
| Atria Dawn Preview | 智能体模型 | (+/-) | 公开的 代码库 将其定位于研究、软件和可验证智能体任务,而不只是聊天 | 仍是预览版本、仅支持文本,也没有被定位成所有编码基准上的唯一最佳答案 |
| Gemini 3.8 Live / Extended Thinking | 实时多模态模型 | (+) | 支持 97 种语言的语音、视觉上下文、后台任务,并在发布线程中展现出较强的实时语音基准表现 | 公开证据仍更偏向发布材料,而非实地使用反馈 |
| Magnitude | 本地推理引擎 | (+) | 分析硬件、估算性能,并在接入现有框架的同时按适配度为模型排序 | 它能减少猜测,但无法消除本地硬件限制 |
| Agents CLI | 智能体开发 CLI | (+/-) | 适合在一个工作流中完成搭建、评测、部署和观测闭环 | 构建者仍担心部署和监控质量有多少落在“理想路径”之外 |
| Skill files / agent skills | 智能体行为方法 | (+) | 目前最强的证据表明,它们显著改善了语法发现及其他对配置敏感的任务 | 收益取决于任务类型,仍需精心组织,才能让智能体选到正确技能 |
| TruLens | 可观测性与评测 | (+) | 原生支持 OpenTelemetry 的 traces、智能体评估器和 MCP instrumentation,契合时间线对可检查运行过程的需求 | 只有在具备良好埋点纪律和明确质量指标的情况下才真正有意义 |
| ToolGrad | 工具使用训练方法 | (+) | 公开的 代码库 和 论文 描述了一种成本更低、先有答案的工具使用训练数据流程 | 仍处于研究阶段,还不是所有团队都可直接采用的即用型默认方案 |
| PhysBrain 1.5 | 具身基础模型 | (+) | 在一个开放模型中统一实现具身理解、动作生成和未来状态预测 | 基准表现令人鼓舞,但广泛真实世界部署的证据仍较早期 |
| Signal65 Vera oracle benchmark | 智能体基础设施基准 | (+) | 公开的 文章 利用 Terminal-Bench 2 参考解隔离 CPU 生命周期开销 | 它衡量的是智能体基础设施吞吐量,而非模型质量 |
| Sync-start / async-escalate | 智能体部署模式 | (+) | 让团队能够为快速任务保留聊天体验,同时把长任务放到后台 | 要想运作良好,需要可靠的队列、通知和检查点机制 |
满意度差异最大的,恰恰是用户与模型之间的各层。当本地运行时、traces、技能、基准方法和部署模式让行为更容易检查,或让成本与硬件适配关系更清晰时,它们就会得到积极关注。相反,单纯的“最佳模型”讨论显得没那么稳定,因为多条帖子都在强调,路由、评分、上下文长度和任务设计,对结果的影响可能不亚于 checkpoint 本身。
最清晰的应对模式是显式分层。人们并没有要求某一个模型包打天下,而是在模型周围增加硬件分析工具、技能库、traces、异步任务队列、公开模型卡和基准方法。迁移路径正从单模型默认配置,转向适配感知型技术栈:用更便宜或开放的模型处理批量工作,为智能体行为配上更丰富的可观测性,并在信任 headline 分数之前先做更多系统级测量。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| MCDMA | @ashxhart | macOS RDMA 驱动,让 Mac Studio 与 DGX Sparks 双向共享缓冲区 | 让混合 Apple 和 NVIDIA 的本地 AI 设备更适合大模型实验 | macOS RDMA、Metal、CUDA、Mac Studio、DGX Sparks | Alpha | 帖子 |
| Atria Dawn Preview | @AtriaASI | 面向研究、软件、报告和经授权安全任务的开放智能体模型 | 提供一个强调可执行、可验证输出,而不只是聊天的开放发布 | 744B MoE GLM-5.2、256K 上下文、开放权重、API | Beta | 帖子,代码库,权重 |
| K2-Horizon-7B | IFM | 面向本地编码和智能体用途的开放 7B 稠密模型 | 为本地用户提供更小的模型,同时仍面向长上下文和智能体工作负载 | 7B 稠密解码器、512K 上下文、vLLM、SGLang、开放训练资产 | Shipped | 帖子,模型卡 |
| Magnitude | Magnitude | 分析硬件并推荐模型/框架适配度的本地推理引擎 | 在选择一台机器实际上能良好运行的本地模型时减少猜测 | CLI、硬件分析器、本地推理服务器、框架集成 | Shipped | 帖子,代码库 |
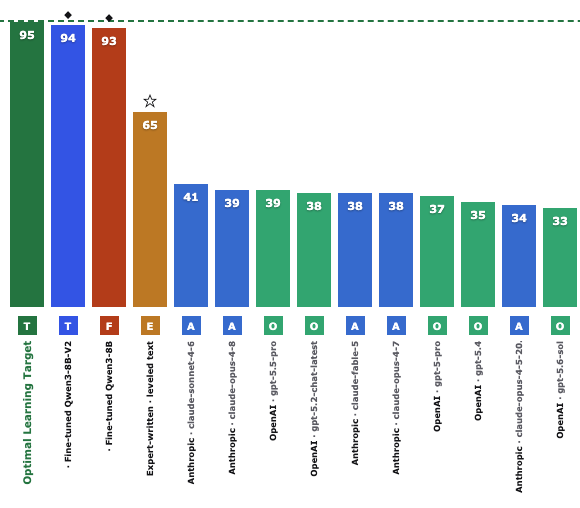
| qwen3-8b-first-grade-tutor | @Austin_Way | 让 Qwen3-8B 保持在一年级辅导语言范围内的 LoRA 适配器 | 解决通用模型经常无法满足的严格阅读水平控制问题 | Qwen3-8B、QLoRA、Unsloth、TRL、PEFT、RTX 4090 | Alpha | 帖子,权重 |
| PhysBrain 1.5 | DeepCybo-PhysAI | 统一理解、动作生成和未来状态预测的具身基础模型 | 试图将多个具身 AI 子任务整合进一个自回归模型 | 类 Qwen3-VL 的分词方式、ActionPiece tokens、EvalKit | Shipped | 帖子,代码库,论文 |
| TruLens | TruLens | 面向 LLM 应用和智能体的评测与追踪层 | 通过 traces、分数、延迟和成本让故障变得可检查 | OpenTelemetry、LLM judges、版本对比、MCP spans | Shipped | 帖子,代码库,文档 |
| ToolGrad | ToolGrad | 先找到成功的工具链,再生成匹配提示词,以构建工具使用数据集 | 降低创建工具使用训练数据的成本和失败率 | 文本梯度、ToolBench 工作流、BFCL 评测、公开数据集和模型 | Alpha | 帖子,代码库,论文 |
| Vangrid | @_Dripxel | 持续更新现实世界 ground truth 的空间数据层 | 帮助物理 AI 系统获得更新更快、带来源信息的世界数据,而无需到处部署定制传感器集群 | 手机采集、边缘隐私保护、加密来源证明、多视角摄取、企业空间 API | Beta | 帖子 |
最强的构建者模式是“适配”,而不是“炫技”。MCDMA、K2-Horizon-7B 和 Magnitude 从不同角度攻向同一个采用障碍:设备互连、更小但仍有实际价值的开放模型,以及能够告诉你硬件现实上能跑什么的软件。
开放智能体模型的发布也变得更加具体。@marcusyul 推出(18 个赞,9 条回复,553 次浏览)将 Atria Dawn Preview 视为一次重要的开放发布,而其公开的 代码库 和 权重 也明确了定位:长上下文、MIT 许可证,并面向智能体任务,而不只是聊天。
专用适配器同样重要。@Austin_Way 展示(34 个赞,2 条回复,1,266 次浏览)指出,针对性的后训练可以解决通用模型仍然无法满足的输出纪律问题;公开的 模型卡 则报告称,94.7% 的句子达到一年级或以下阅读水平,语料检查通过率达到 98%。
PhysBrain、Vangrid、TruLens 和 ToolGrad 值得注意,是因为它们都作用于原始模型周围的某一层:一个改善具身表征,一个改善现实世界数据的新鲜度,一个改善运行可见性,还有一个改善工具使用背后的训练数据。这一组合契合了当天更广泛的情绪:构建者越来越多地在智能周围的基础设施上发力,而不只是训练更大的基础模型。
6. 新动态与值得关注的内容
Gemini 3.8 Live 在一次发布中整合了实时语音、视觉上下文和后台任务
@testingcatalog 报道(69 个赞,6 条回复,6,926 次浏览,11 次收藏)指出,Gemini 3.8 Live Extended Thinking 在实时语音基准上领先于 GPT Live 1;被引用的发布线程称,该系统现已支持 97 种语言的语音、视觉上下文和后台任务执行,并且不会中断对话。这一点之所以重要,是因为它把“智能体”的边界从文本加工具,扩展到了具备持续执行能力的实时多模态交互。

Signal65 让智能体基础设施的 CPU 侧更容易测量
@Signal_65 报道(5 个赞,450 次浏览)指出,在 69 个 Terminal-Bench 2 任务中,NVIDIA Vera 每核心完成智能体任务生命周期的速度,是领先 x86 处理器的 1.64 倍;在最接近日常智能体工作的 20 个任务中,这一速度达到 1.87 倍。公开的 文章 才是这条帖子的关键:它把 oracle-agent 重放方法解释得足够清楚,让人看得出这是一项关于沙箱创建、执行和拆除的基础设施基准,而不是含糊的模型速度宣称。
ToolGrad 将工具使用进展重新定义为数据工程问题
@GeneratedForAI 分享(1 个赞,1 条回复,33 次浏览)总结了 ToolGrad;公开的 代码库 和 论文 则解释了它为何突出:它不是从提示词出发,再寄希望于搜索找到成功的工具链,而是先生成成功的工具链,再编写任务。这一变化虽然不大,却很重要,因为它把智能体改进视为数据生成流水线问题,而不只是更大模型的问题。

7. 机会在哪里
**[+++] 评测修复与证据管线 ** — 第 1、2、4 和 6 节都指向同一个缺口。基准可信度正同时遭遇多路冲击:脆弱的任务设计、基准意识、错误评分以及过浅的任务。能够生成更好 traces、更好评分器、更难被钻空子的基准,并为基准结论提供更清晰来源证明的工具,正获得异常强劲的顺风。
**[+++] 智能体工作流控制平面与可观测性 ** — 应用 AI 层不断收敛到同一类产品表面:审批、traces、异步执行、通知、技能路由和事后复盘。这个需求看起来已经是运营层面的现实问题,而非愿景式想象,因此是这组数据中最强的直接机会之一。
**[++] 本地模型适配与编排 ** — 开放权重仍然很有吸引力,但实际障碍依旧是硬件适配。市场还有空间容纳更多像 Magnitude 这样的产品、更好的像 MCDMA 这样的混合设备互连层,以及能够针对具体机器自动选择开放模型、运行时、量化方式和上下文预算的软件。
**[++] 物理 AI 数据引擎与来源信息层 ** — 物理 AI 的机会不在于再推出一个机器人模型,而在于围绕模型构建的闭环:下一步收集什么数据、如何保持世界状态的新鲜度,以及如何在采集和摄取过程中保留来源信息。这意味着市场更可能需要持久的基础设施型企业,而不只是以演示为先的应用。
**[+] 窄领域行为适配器与领域专属后训练 ** — 一年级辅导适配器提醒我们,许多尚未满足的需求关乎可控行为,而不是原始智能。未来很可能还有更多机会去开发定向适配器,让强大的基础模型稳定遵守阅读水平、格式、合规或领域语气约束。
8. 关键结论
- 基准讨论开始更具体地揭示评测会在哪里失效。 最有力的帖子不只是说排行榜噪声很大,而是指出了评测意识、错误评分器、浅层任务,以及更长时程工作负载如何改变“优秀”的含义。(@rasbt 源帖子(72 个赞,23 条回复,6,018 次浏览,27 次收藏))
- 开放权重热情如今与硬件适配和工作流适配紧密相连。 廉价模型固然重要,但更持久的讨论围绕互连、运行时、上下文成本,以及本地系统能否自动选择正确模型展开。(@EMostaque 源帖子(142 个赞,38 条回复,6,313 次浏览,26 次收藏))
- 应用 AI 层正日益成为一个运营类别。 排队、追踪、审批、技能、监控和异步执行出现得比提示词技巧更频繁,这表明生产环境中的智能体工作正在成为一门独立学科。(@levie 源帖子(28 个赞,10 条回复,7,110 次浏览,27 次收藏))
- 物理 AI 讨论正向上游转移到数据选择和瓶颈测绘。 当天最清晰的具身 AI 信号,围绕下一条缺失轨迹、持续更新的世界数据,以及智能体工作负载背后的 CPU 或集群限制展开。(@Tentacion_sin 源帖子(3 个赞,2 条回复,78 次浏览))
- 构建者正在模型周围构建的东西,与直接在模型内部构建的东西同样重要。 MCDMA、Magnitude、TruLens、ToolGrad 和 Vangrid 都印证了同一个观点:下一波价值往往位于能力出色的基础模型周围的互连、trace、数据集或控制平面之中。(@ashxhart 源帖子(83 个赞,13 条回复,12,412 次浏览,72 次收藏))