Twitter AI - 2026-09-17
1. 人们在讨论什么
1.1 只有点明控制界面,安全与自主性讨论才真正有分量 🡕
在 290 位作者发布的 310 条原创推文中,最有影响力的安全与自主性帖子,只有在点出具体边界、审计路径或审批规则时,才真正站得住脚。@VitalikButerin 认为(1,384 个赞、182 条回复、156,612 次浏览、464 次收藏)指出,AI 可以让整程序形式化验证变得切实可行,从而让网络安全更有利于防守方;但他也明确点出关键前提:团队必须在消息传递、密钥发现、服务器、数据库、缓存,甚至编译器等各层面定义安全,而不是假装某个密码学核心就代表了整个系统。@esrtweet 提出(279 个赞、38 条回复、11,217 次浏览、175 次收藏)则通过把灭绝风险视为一长串可以争辩的假设,而非单一必然结局,提出了反“末日论”的论证;最有力的回复也立刻把分歧收束到产品现实:实验室正在让系统更具代理性,因此边界和干预点比口号更重要。
偏运营的帖子,则把这一逻辑直接落到了可交付的基础设施上。@testingcatalog 报道(10 个赞、4 条回复、2,443 次浏览)指出,Opal Zero 会为每个 agent 绑定一名人类负责人、用途和允许访问的系统;引用的发布文案还说,请求会在需要时即时决策,并直接在现有 MCP 网关中执行,而不是另建一套控制平面;公开的 产品页面 则把这一点扩展成资产清单、风险审查、策略推理和网关执行。@cv_usk 阐述了(3 个赞、4 条回复、84 次浏览)把同样的控制思路总结成一种架构模式:在推理与工具调用之间贯穿 trace ID,把完整提示词存入对象存储,采用尾采样,并把来源追溯回源文档和人工审批者。就连消费级 agent 控制,也是包在访问策略里的:@shawnchauhan1 抱怨(1 个赞、127 次浏览)指出,Google Home MCP 只在每月 20 美元的 Premium Advanced 套餐下、面向美国用户、并以英语上线时,才向外部 agent 开放设备控制。
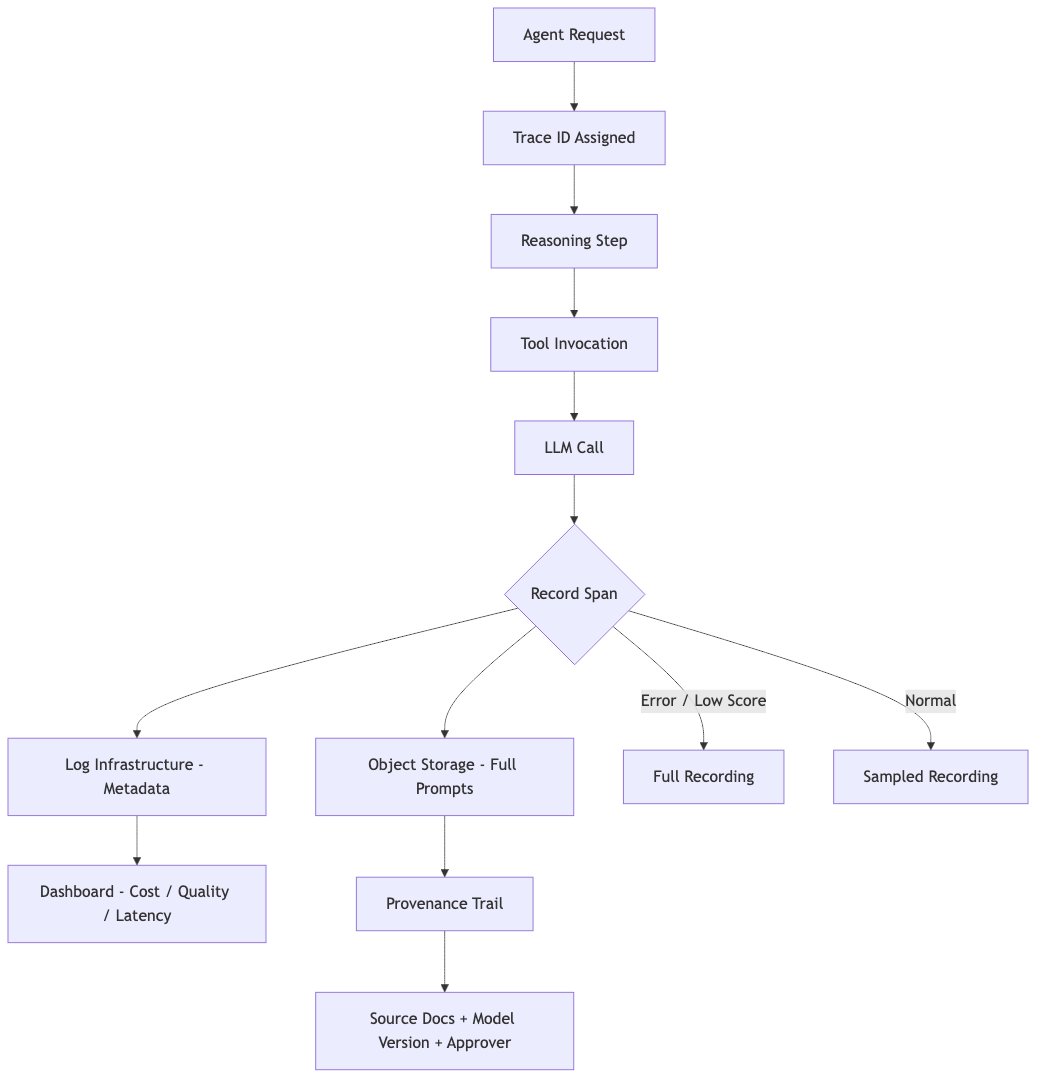
讨论洞察: 真正的分歧并不在于 agent 会不会存在,而在于它们能否被分配给明确负责人、被限制在最小权限边界内、留下足以复盘的日志,并被强制在到期后失去访问权限,而不是不断累积权限。
与前一日比较: 与 2026-09-16 相比,这一天的讨论不再主要由某个具体的安全事故叙事驱动,而是更多转向预防性架构:证明、权限边界和可追溯决策。
1.2 物理 AI 讨论收束到听觉失效与新鲜 3D 采集 🡕
物理 AI 讨论不断收束到两类缺失输入:一是现实对话混乱场景中的语音,二是大规模互联网文本或街景测绘车队都无法提供的、最新的地面几何数据。@Timthadon01 重点介绍(32 个赞、28 条回复、364 次浏览)介绍了 BRIDGE ASR 2.0:它评测 23 个模型、23 种语言,并覆盖打断、多人重叠说话和语码转换;引用的基准说明还把它定义为一套面向真实部署的六指标体系,而不是只针对“干净演示音频”的测试。公开的 BRIDGE 页面 进一步给出了更具体的设计:WER、CER、MER、WIL、错误类型拆解、书写系统公平性处理,以及语码转换指标,全部都跑在同一套规范化的双人对话上。
@hoodsher55 认为(15 个赞、16 条回复、4,515 次浏览)指出,物理 AI 仍然严重缺乏互联网无法提供的数据;Vangrid 更关键的一步,不是打加密货币的品牌,而是把普通手机变成分布式采集节点,以获取新鲜的 3D 观测。公开的 Vangrid 文档 也印证了推文中的机制:贡献者用手机拍摄短视频,把这些视频重建成 3D 模型,并为每次采集打上粗粒度位置和时间戳指纹,随后锚定到 Base 上,让买家可以核验来源,而不是只能相信某个私有数据库。


讨论洞察: 回复里没人要求再来一段机器人炫技视频;大家问的是,噪声语音基准、隐私安全的采集方式和来源核验,能不能把混乱的现实世界输入变成足够可靠、能用于训练和采购的数据。
与前一日比较: 相比 2026-09-16 更宽泛的“缺失数据层”框架,2026-09-17 把这个缺口拆成了两个更尖锐的要求:能在重叠说话中听清的 AI,以及能从手机采集的 3D 地面真值中学习的 AI。
1.3 开源模型的关注度,跟可部署性走,而不是跟炫耀资本走 🡕
最强的开源模型帖子,真正讨论的都是是否适配机器、预算和工作流。@TheAhmadOsman 认为(44 个赞、9 条回复、2,912 次浏览、33 次收藏)指出,如果不把容量、带宽和软件栈分开看,本地 AI 硬件对比就毫无意义;他还列出了一条覆盖 RTX 显卡、Apple 统一内存、DGX Spark、Strix Halo、AMD、Intel 和 Tenstorrent 的梯队。@TeksEdge 重点介绍(13 个赞、515 次浏览)介绍了中国电信的 Xing4.0-29B-A4B:这是一个 29B 开源模型,但每个 token 只激活 4B 参数,原生上下文长度为 256K,可扩展到 512K;官方成绩包括 SWE-bench Verified 75.0 和 Terminal-Bench 2.1 57.5。公开的 README 证实了这些数字,并显示这次发布是围绕 agent 和编码任务设计的。
实际用户的选择也遵循同样的逻辑。@liambraus 认为(52 个赞、4 条回复、493 次浏览、17 次收藏)指出,“没人会拿基准测试投票”;引用的 Bolt 帖子则称,在开放模型以最高 50 倍用量提供后,54% 的用户选择了 GLM 5.3 Flash,因为它更快、更便宜,也支持更大的提示词。@He1s_Sammy 表示(19 个赞、10 条回复、684 次浏览)表示,他在三天内撞上了 GPT-6 Astra 的额度上限,于是开始把人们引向 Colibri——一个开源本地推理引擎;其公开的 代码仓库 把存储、RAM 和 VRAM 当作统一层级来处理。最有价值的一条回复立刻补充了前提:无 GPU 模式会把瓶颈转移到系统内存带宽,因此超大本地模型更适合跑隔夜批处理,而不是快速交互式编码。@TeksEdge 还指出(19 个赞、1,038 次浏览)则指出,Qwen3.8-Omni-Flash 把 1M 上下文与一种 agentic 视频理解模式结合起来,使 OmniVideoBench 的查询 token 数从 145,736 降到 79,117,同时准确率从 63.4 提升到 67.8;不过他也说明,Alibaba 仍把它作为 API 产品提供,而不是开放权重。
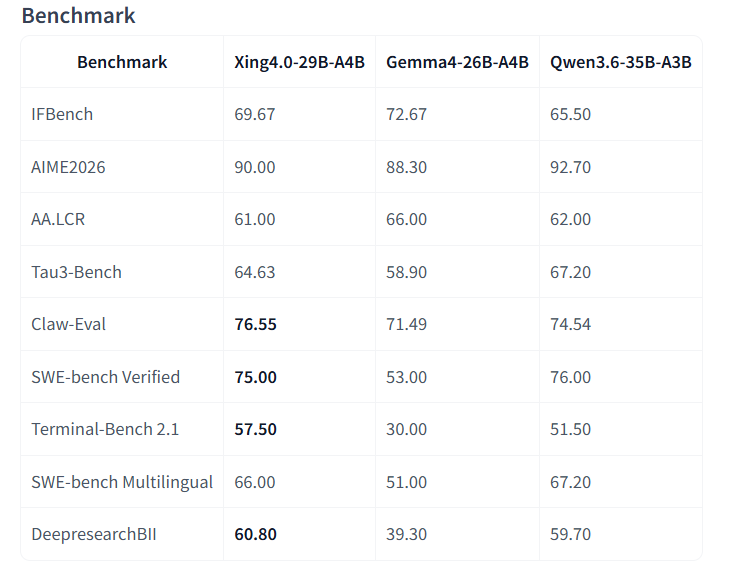
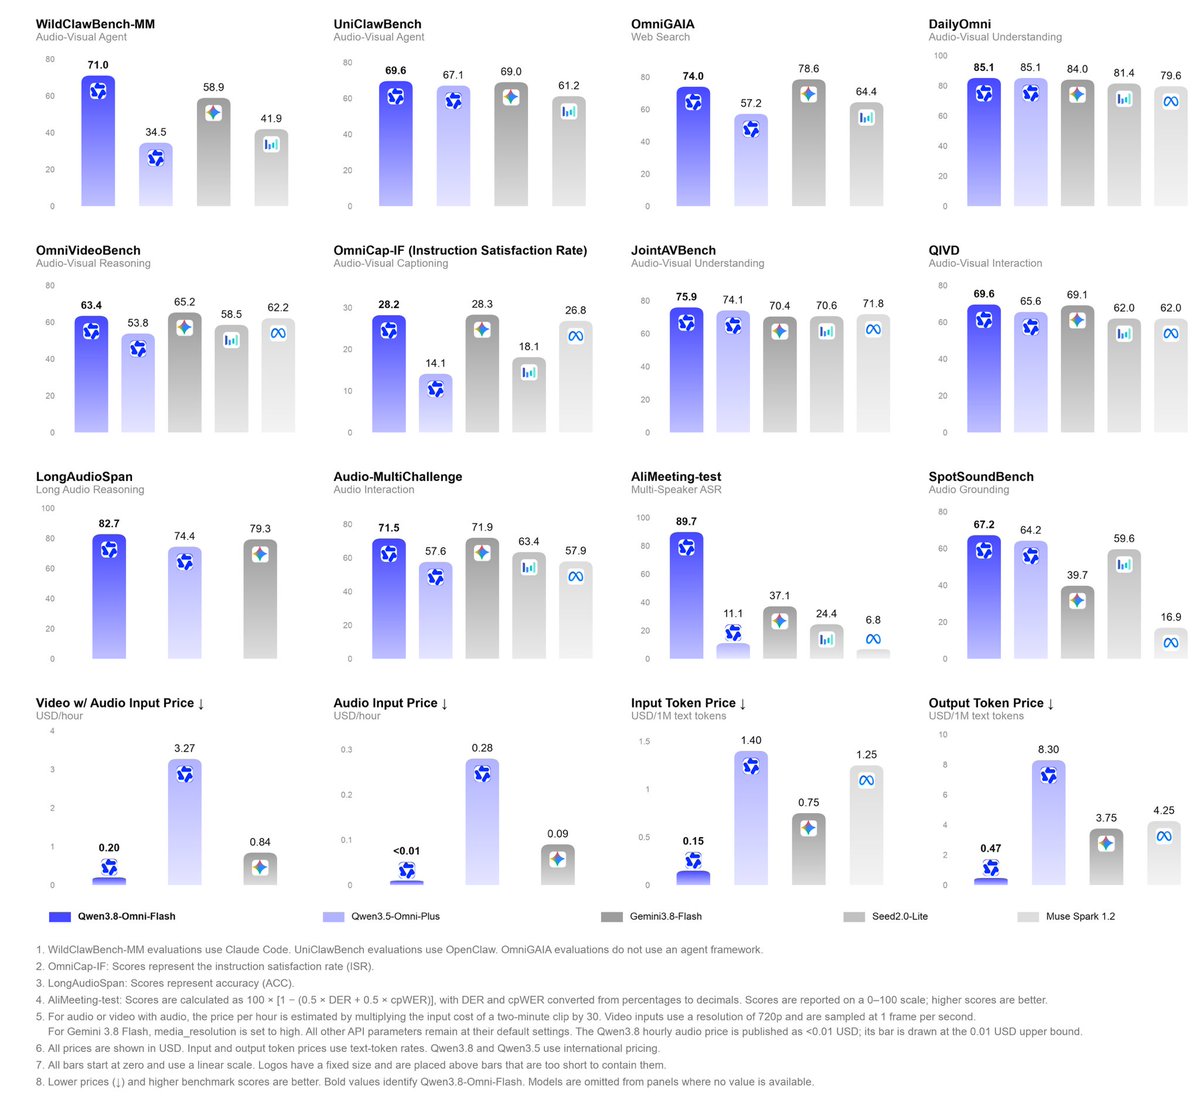
讨论洞察: 回复把模型选择变成了资源核算问题:API key 的摩擦、每周额度耗尽、带宽上限、提示词长度限制,以及按任务类型把不同工作路由到不同模型,而不是给某个“万能赢家”加冕。
与前一日比较: 相比 2026-09-15 和 2026-09-16,开源模型讨论变得更具体了。话题已经从“本地与路由模型很有前景”,转向“哪些能塞进 24 GB、哪些会吃满 DDR5 带宽,以及模型并排摆在用户面前时他们究竟会选什么”。
1.4 科学与基准工作,只有交付可复用的公开成果时才会获得关注 🡕
偏研究的帖子之所以能获得传播,是因为它们附带了代码、明确的评审标准,或基于正确性的公开数据集,而不是再抛出一个抽象论断。@AnthropicAI 报道(374 个赞、48 条回复、32,802 次浏览、117 次收藏)称,Claude 优化了 30 多个开源生物学模型,使其平均运行速度提高约 4 倍;配套的 博客文章 和 代码仓库 则把这件事具体化为:36 个公开优化套件、适用于单个 NVIDIA GPU 节点上 10,000 token 以上系统的低内存 “Big” 模式,以及一项有湿实验室支持的蛋白质设计竞赛。@PhAILabs 报道(4 个赞、971 次浏览)指出,ScienceIDE 把经过验证的科学轨迹转化为 PhAI-IDE 模型的监督信号,使留出的 PLUTO-Particles-Dust 验证器奖励从 0 提升到 0.333,并提升了若干独立验证任务的表现,例如 CodeXGLUE 缺陷检测从 45.93% 提高到 52.92%。
就连“基准可信度”本身,也越来越像一个独立产品类别,而不只是附带抱怨。@EpochAIResearch 宣布(18 个赞、697 次浏览)介绍了 Benchmark Reviews;公开的 文档 则列出了首批结论:4 个基准被标为 Verified,9 个被标为 Flawed,另有 2 个因信息不足而无法判断。这样的公开标注之所以重要,是因为当天那些信号较弱的基准帖子,也在从另一个方向提出同样的要求:要有领域专属任务、真实失败分析,以及当结果尚未被独立复现时,明确写出限制条件。

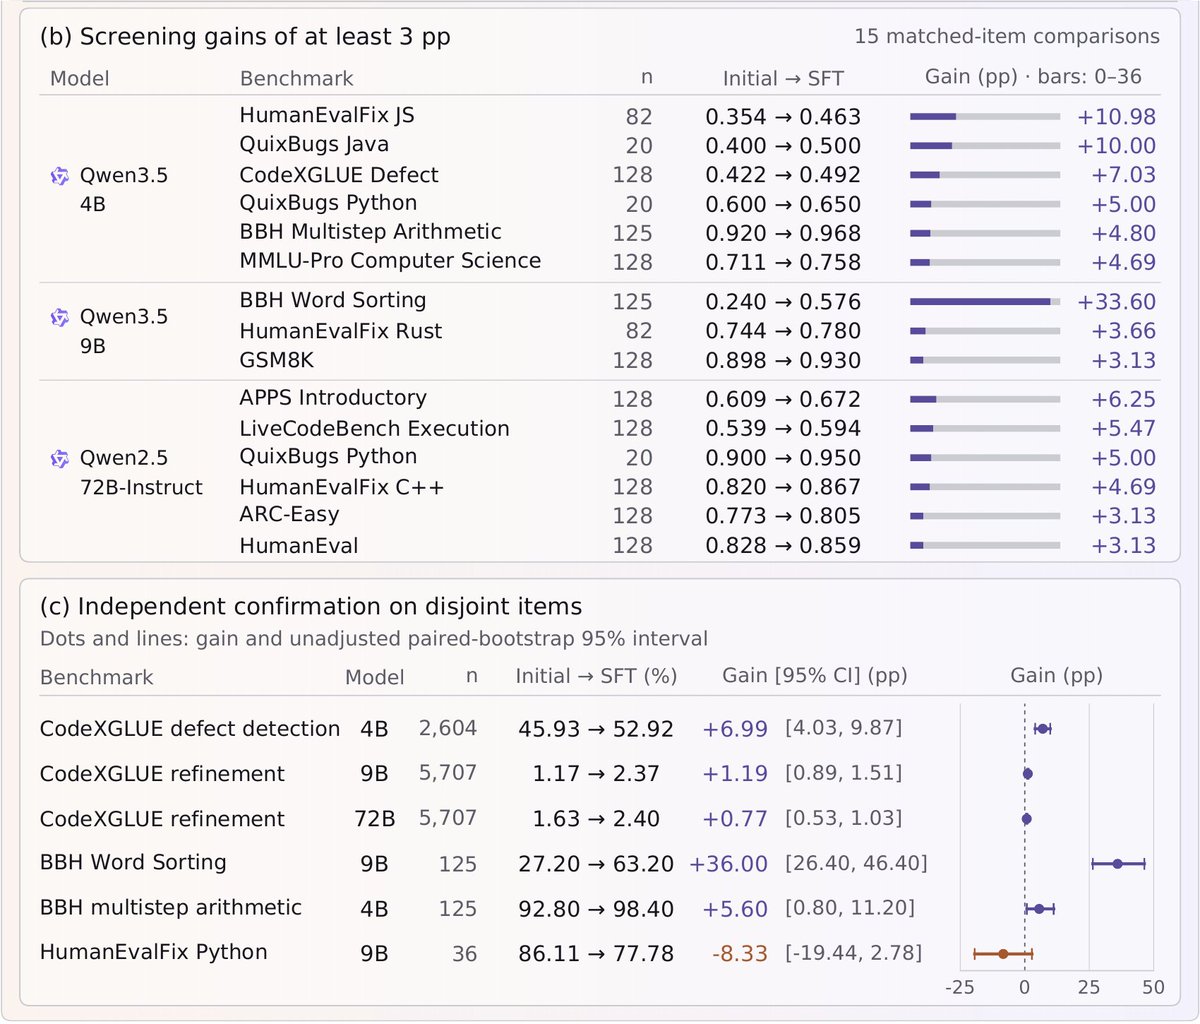
讨论洞察: 最强的科学与基准帖子,要么发布了代码,要么放出了评审标准,要么在附带限制说明的前提下给出了迁移结果。即便是热情洋溢的模型发布帖,也越来越常停下来说明:哪些数字是官方给出的,哪些尚未复现,哪些任务上的表现仍有波动。
与前一日比较: 相比 2026-09-16 对生物模型和评测可信度的讨论,2026-09-17 又往公共基础设施推进了一步:开放套件、可验证的科学轨迹,以及带有明确结论的基准审计。
2. 什么让人感到沮丧
控制平面仍不完整,agent 部署依然要靠人类信任兜底
当天关于企业 agent 的帖子反复指向同一个缺失层:agent 也许已经有足够能力去行动,但大多数团队仍没有一套默认安全的方式,去决定、约束并事后重建这些行动。@testingcatalog 报道(10 个赞、4 条回复、2,443 次浏览)指出,Opal Zero 之所以存在,是因为 agent 需要负责人、用途、即时访问权限和会过期的授权,而不是长期常驻权限。@cv_usk 认为(3 个赞、4 条回复、84 次浏览)指出,每个生产级 agent 都应输出推理轨迹、工具调用、成本、评测分数,以及可追溯回源文档和人工审批者的 provenance;与此同时,@VitalikButerin 警告(1,384 个赞、182 条回复、156,612 次浏览、464 次收藏)则指出,只验证系统中你称为“安全关键”的那一小部分,恰恰就是让外围组件把整个系统拖垮的方式。
严重程度:高。人们目前靠人工审批、范围受限的策略、尾采样轨迹和人工升级处理来应对,但反复出现的负责人映射、授权过期和事后问责要求表明,这是目前最明确、最值得做的产品方向之一。
基准测试总结了性能,却掩盖了真正的失败模式
Twitter 上对评测的挫败感,不是“我们需要更多基准测试”,而是“现有基准仍把太多信息压扁了”。@Timthadon01 重点介绍(32 个赞、28 条回复、364 次浏览)介绍 BRIDGE ASR 2.0,恰恰因为它测试了干净音频排行榜忽略的重叠说话、打断和语码转换;公开的 基准页面 也把错误类型直接摊开,而不是只给一个混合分数。@EpochAIResearch 宣布(18 个赞、697 次浏览)介绍了 Benchmark Reviews,并公开把 4 个基准标为 Verified、9 个标为 Flawed、2 个因信息不足而无法评审。就连模型发布的拥护者,也感受到了同样的压力:@TeksEdge 明确拒绝(13 个赞、515 次浏览)就要求别轻易重复 Xing4.0 在 RTX 3090 上达到 152 tok/s 的说法,因为被引用的 PR 实际并没有说明所用硬件。
严重程度:高。团队正在通过发布更丰富的指标、公开评审标准以及为官方数字附加限制说明来应对,但专门讨论可审计性的帖子之多,说明基准可信度仍是切实痛点,也是一条很强的产品机会。
本地与开源模型很诱人,但可部署性仍受制于带宽、存储和额度
开源模型讨论之所以显得务实,是因为人们不断在说真正痛的地方。@TheAhmadOsman 认为(44 个赞、9 条回复、2,912 次浏览、33 次收藏)指出,容量只能告诉你“装不装得下”,带宽才决定这台机器能不能真正“喘得过气”。@He1s_Sammy 表示(19 个赞、10 条回复、684 次浏览)表示,他正从每月 200 美元的订阅切换到 Colibri,因为“没有 token 账单”,也“没有对 API 的依赖”;但最有价值的回复立刻指出,无 GPU 模式会把瓶颈推到 DDR5 上,让超大本地模型在交互式工作中变得很痛苦。@liambraus 总结(52 个赞、4 条回复、493 次浏览、17 次收藏)则从另一侧说出了同样的挫败:用户选择的是不会卡住、不会在项目中途把预算烧光的会话,而不是基准故事最好听的模型。
严重程度:高。常见应对方式包括模型路由、量化、本地 API 和按硬件规划,但这些帖子的频率说明,仍然有空间做更好的规划器、额度感知能力和面向工作流的本地部署工具。
物理 AI 仍缺少新鲜、可验证的现实世界数据与混乱语音数据
物理 AI 的挫败感,问题出在模型之前。@hoodsher55 表示(15 个赞、16 条回复、4,515 次浏览)指出,“你没法抓取物理世界”,所以新鲜 3D 采集必须来自现场的人和设备,而不是现有网络语料。@Timthadon01 提出(32 个赞、28 条回复、364 次浏览)则提出音频侧的平行抱怨:模型在干净语音上看起来很能打,但一旦人们互相打断,或在半句中切换语言,仍然会失效。回复里反复补上的两个限定条件是:数据必须保护隐私,来源必须可核查。
严重程度:中高。人们正靠更窄的基准和新的采集网络来应对,但无论语音侧还是空间数据侧,都还谈不上是已经成熟、可视为已解决的基础设施。
3. 人们希望存在什么
默认就能工作的 agent 权限与来源追溯系统
人们真正反复索求的,不是“更强的 agent 自主性”,而是带有负责人、用途限制、到期机制和可重建证据的 agent 自主性。@testingcatalog 报道(10 个赞、4 条回复、2,443 次浏览)指出,Opal Zero 会分配负责人、限定请求范围并让访问权限到期;@cv_usk 表示(3 个赞、4 条回复、84 次浏览)则指出,生产级 agent 需要 trace ID、工具级可观测性,以及可追溯回源文档和人工审批者的 provenance。这是现实需求,而且紧迫度高,因为当前的应对方式仍然是人工审策略、事后看日志。今天已经有一些部分答案,比如 Opal Zero、现有可观测性平台,以及 Google Home MCP 的权限模型,但市场看起来仍然大有可为。机会:直接。
能解释失败类型,而不是只回一个数字的基准测试
大家显然更想要的是能告诉他们“哪里坏了”的评测系统,而不是只告诉他们“排第几”。@Timthadon01 重点介绍(32 个赞、28 条回复、364 次浏览)提到 BRIDGE ASR 2.0,正是因为重叠说话、语码转换和打断,才是生产环境 ASR 真正容易翻车的地方;公开的基准页面也展示了错误类别,而不是单一平均分。@EpochAIResearch 宣布(18 个赞、697 次浏览)介绍了一个把基准标记为 Verified、Flawed,或因过于不透明而无法判断的评审框架;而 @TeksEdge 拒绝(13 个赞、515 次浏览)则是在提醒,不要夸大 Xing4.0 那个尚未复现的吞吐量数字。这是一个现实且紧迫的需求,而今天的公开评审和更丰富指标栈只能部分解决它。机会:直接。
能理解硬件、存储和预算限制的本地与开源模型栈
人们想要的是理解真实机器和真实预算的模型栈,而不是只看参数量。@TheAhmadOsman 认为(44 个赞、9 条回复、2,912 次浏览、33 次收藏)指出,买家应该问清楚必须装下什么、需要哪档带宽、以及信任哪套软件栈;@He1s_Sammy 寻找(19 个赞、10 条回复、684 次浏览)强调“没有 token 账单”和“没有对 API 的依赖”;@liambraus 总结(52 个赞、4 条回复、493 次浏览、17 次收藏)则指出,真实用户会选那个不会卡住、也不会在会话中途突然变贵的模型。这是一个有明确成本压力的现实需求。Colibri、Bolt 以及 Xing4.0 这类稀疏开源模型只是部分答案,但问题现在更像一个竞争赛道,而不是一个已解决问题。机会:竞争性。
面向物理 AI、可扩展且保护隐私的真值数据层
物理 AI 相关帖子暗示出一项同时具备技术和基础设施属性的需求:持续供应来自现实世界的新鲜、可验证语音和 3D 采集。@hoodsher55 表示(15 个赞、16 条回复、4,515 次浏览)指出,“你没法抓取物理世界”;@Timthadon01 将其定义为(32 个赞、28 条回复、364 次浏览)则从音频侧说明,需求正在从完美录音转向包含重叠说话、打断和多语言的语音。Vangrid 和 BRIDGE 是早期答案,但紧迫度仍处于中高水平,因为供给和核验都还稀缺。机会:理想型。
可复用的科学环境,让正确性来自执行而不是“口味”
科学类帖子显示,人们需要面向特定领域的环境,在这些环境里,奖励信号来自工作是否真的算对、预测对或验证通过。@AnthropicAI 分享(374 个赞、48 条回复、32,802 次浏览、117 次收藏)介绍了能显著降低生物模型推理成本、扩大可及性的优化套件;@PhAILabs 认为(4 个赞、971 次浏览)则指出,经过验证的科学轨迹能迁移为更好的留出科学代码修复能力,以及若干通用基准上的提升。这对实验室和科学软件团队来说是现实需求,虽然它比通用消费级 AI 更窄。当前已有 Anthropic 的套件和 ScienceIDE 这样的部分答案。机会:直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Jev / TypeSafe AI | 决策模型 | (+/-) | 提供类型化答案、概率、置信度分数和快速结构化输出,适合直接嵌入软件工作流 | 仅支持文本,不生成代码或解释;且至少有一条回复指出其 SaaS 仅在美国可用 |
| Opal Zero | 访问治理 | (+/-) | 负责人映射、即时按范围授予访问、到期权限,以及在现有 MCP 网关中执行 | 刚发布,仍依赖策略质量和日志审查,且要到 9 月底才全面可用 |
| BRIDGE ASR 2.0 | 基准测试 | (+) | 真实双人多语言音频,覆盖重叠说话和语码转换,并提供超越单一分数的错误类型指标 | 它能诊断失败模式,但不能解决失败模式;公开采用也仍处早期 |
| Vangrid | 物理数据层 | (+/-) | 把手机变成采集节点,重建 3D 数据,并加入来源信息和由悬赏驱动的需求信号 | 人工采集质量参差不齐,隐私问题仍在,且仍需要网络效应 |
| Qwen3.8-Omni-Flash | 多模态模型 | (+/-) | 1M 上下文、agentic 视频搜索、更低的音视频 token 成本,以及多模态办公任务覆盖 | 推文里提到它以 API 产品形式提供,未说明有开放权重 |
| Xing4.0-29B-A4B | 开源模型 | (+/-) | 每个 token 只激活 4B 参数、长上下文、官方编码和 agent 分数强,并有本地量化路径 | 基准表是官方成绩而非独立复现,且框架支持仍停留在 PR 分支 |
| Colibri | 本地推理引擎 | (+/-) | 为前沿 MoE 模型提供本地访问、摆脱 API 依赖,并统一处理存储/RAM/VRAM 层级 | 存储需求极大,性能表现仍偏实验性;无 GPU 模式对交互式使用可能过慢 |
| Bolt 上的 GLM 5.3 Flash | 托管模型 | (+) | 靠速度快、成本低、提示词友好,在共享选择器中赢得了真实使用 | 这种真实偏好依赖 Bolt 的环境,不一定能迁移到所有工作负载 |
| micro1 Cortex | 评测平台 | (+/-) | 用专家人工判断真实工作流、诊断失败并做上线后监控,还能通过 Azure 采购 | 人工评测比全自动基准循环更慢,也更贵 |
整体满意度更偏向那些约束行为或算力使用的工具,而不是只承诺抽象能力的工具。获得正面评价的帖子,多半在讲类型化决策、真实世界基准、足够便宜的多模态处理,以及更快或更务实的部署方式。情绪变得复杂的时候,往往是某个工具解决了一个瓶颈,却暴露出另一个:Jev 很结构化,但覆盖面窄;Colibri 去掉了 API 依赖,却把痛点转移到存储和带宽;Vangrid 承诺提供新鲜数据,但必须先把嘈杂采集标准化;Opal Zero 和 micro1 则以增加策略或人工审查开销为代价,提升安全和评测能力。
主流应对模式是多层化。构建者会把不同任务路由到不同模型,追踪每个重要请求,并把快速元数据与昂贵的原始提示词存储分开。这也是为什么 OpenTelemetry 风格追踪加上 Langfuse、LangSmith 或 Arize 仪表盘,会作为模型选择的运营配套反复出现:现在,工作流的重要性至少已经和模型本身一样高。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| 生物分子建模能力提升 | Anthropic | 面向生物分子模型的开放优化套件,以及一项蛋白质设计竞赛 | 让专业生物学模型变得足够便宜、足够快,从而更广泛地运行 | Claude 辅助 GPU 优化、36 个公开套件、技术报告、Proteinbase 竞赛 | 已发布 | 帖子(374 个赞、48 条回复、32,802 次浏览、117 次收藏);博客;代码仓库 |
| BRIDGE ASR 2.0 | Humyn Labs | 覆盖 23 个模型和 23 种语言的真实世界 ASR 基准 | 暴露干净音频排行榜掩盖的重叠说话、打断和语码转换失效 | 双人对话数据集、六指标体系、错误分类、语码转换分析 | 已发布 | 帖子(32 个赞、28 条回复、364 次浏览);网站 |
| Opal Zero | Opal Security | 面向 AI agent 的访问治理层 | 用负责人映射、即时决策、会过期的访问控制,替代常驻权限 | Paladin 策略审查器、MCP 网关执行、资产清单与风险层 | 上线中 | 帖子(10 个赞、4 条回复、2,443 次浏览);网站 |
| Jev / System One | TypeSafe AI | 返回类型化输出、概率和置信度的原生决策模型 | 取代安全与工作流自动化中脆弱的文本解析 | System One 文档、结构化输出 schema、校准置信度、API 集成 | 早期访问 | 帖子(29 个赞、5 条回复、3,101 次浏览、26 次收藏);文档;网站 |
| micro1 Cortex | micro1 | 通过 Azure Marketplace 销售的专家人工 agent 评测栈 | 帮助企业诊断 agent 为何会在真实工作流中失败,并监控漂移 | 专家人工审查、工作流评测、定向训练数据、Azure 采购路径 | 已发布 | 帖子(39 个赞、6 条回复、1,513 次浏览、9 次收藏) |
| Vangrid 采集流水线 | Vangrid | 面向空间数据的手机采集与来源追溯流水线 | 无需专用传感器车队,也能产出更新鲜、可验证的 3D 物理世界数据 | 智能手机视频、3D 重建、指纹标记、Base 锚定 | Beta | 帖子(15 个赞、16 条回复、4,515 次浏览);文档 |
| Xing4.0-29B-A4B | XingChen AGI | 面向编码和 agent 工作的稀疏开源模型 | 以更低的每 token 激活参数成本,提供长上下文开源模型 | 29B 总参数、4B 激活参数、MindSpore 训练、GGUF 量化路径 | 已发布 | 帖子(13 个赞、515 次浏览);代码仓库 |
| Colibri | JustVugg | 面向前沿 MoE 模型的本地推理引擎 | 让大规模本地运行摆脱托管额度和 API 依赖 | 纯 C 引擎、本地 API、存储/RAM/VRAM 层级 | 已发布 | 帖子(19 个赞、10 条回复、684 次浏览);代码仓库 |
| ScienceIDE / PhAI-IDE | PhAI Labs | 复用已验证的科学轨迹来训练领域模型 | 提供以执行结果为锚点的监督,而不是通用助手对话 | 已验证轨迹、监督微调、4B 到 72B 的模型家族 | 研究 | 帖子(4 个赞、971 次浏览) |
最强的构建模式,是围绕模型使用搭基础设施,而不是只做更大的模型。Opal、micro1、BRIDGE 和 Jev 都在收紧决策、权限或评测周围的控制界面。Anthropic、Vangrid、ScienceIDE 和 Colibri 则在收紧另一类约束:一个有能力的模型想真正有用,前面还需要哪些数据、硬件或领域产物。
这也解释了为什么一些互动量较低的项目帖仍然重要。它们不是在争夺大众消费者注意力,而是在暴露那些越来越决定 AI 系统能否被信任、被采用、并保持可负担的运营层。
6. 新鲜且值得注意的内容
Benchmark Reviews 让基准批评变得可读且公开
@EpochAIResearch 宣布(18 个赞、697 次浏览)介绍了一个把基准标为 Verified、Flawed,或因文档过少而无法评审的框架。它的重要性在于,把一种常见抱怨变成了带有明确结论的公开成果,而不是模糊的怀疑。
Qwen3.8-Omni-Flash 让多模态进展看起来更像一个 token 经济学故事
@TeksEdge 重点介绍(19 个赞、1,038 次浏览)之所以讨论 Qwen3.8-Omni-Flash,不是因为“omni”品牌有什么新鲜,而是因为它报告的提升附带了明确的系统权衡:每次视频查询消耗更少 token,同时准确率更高。这个叙事比单纯拼功能数量更耐久,因为它直接对应部署成本。
C2C 是信息流里少数真正新颖的协同思路之一
@thesupermannx 分享(21 个赞、4 条回复、1,264 次浏览、15 次收藏)介绍了 Cache-to-Cache 通信:让模型直接交换 KV-cache 状态,而不是一切都先翻译成文本。它能否广泛泛化仍未可知,但之所以突出,是因为它提出了一种机器原生的多模型接口,而且配套放出了公开仓库。
Google Home MCP 显示,消费级 agent 控制正以“受限平台层”的形式到来
@shawnchauhan1 认为(1 个赞、127 次浏览)指出,Google 的 Home MCP 推出方式是一种封闭平台动作,因为它把外部 agent 对家居设备的控制放在高级订阅和地区限制之后。尽管互动量不高,这条帖子仍然重要,因为它提前提醒人们:消费级 agent 基础设施可能会先以计费和封闭方式到来,之后才逐步标准化。
7. 机会在哪里
[+++] 可审计的 agent 控制平面与证据包 —— 第 1、2、4、5 节都指向同一个运营缺口:每个重要 agent 动作都需要负责人、用途标签、到期访问权限、trace ID、来源信息,以及可审查日志。Opal Zero 和 cv_usk 的追踪模式给出了部分答案,但需求看起来仍然直接且紧迫。
[+++] 基准评审、失败分类与可复现性服务 —— BRIDGE ASR 2.0、Benchmark Reviews,甚至围绕 Xing4.0 的谨慎讨论,都说明团队越来越在意模型是怎么失败的,以及相关主张是否经得起检查。机会不只是“更多评测”,而是开发者、买家和研究者都能信任的评测基础设施。
[++] 硬件感知的路由、额度规划与本地部署软件 —— 本地模型讨论里充满了额度痛点、API key 摩擦、提示词限制和内存带宽权衡。下一层真正有用的软件,应该能决定何时使用本地稀疏模型、何时为托管多模态调用付费,以及怎样避免工作流跑到一半就卡住。
[++] 以来源追溯为先的现实世界数据供应链 —— Vangrid 和 BRIDGE 暗示,物理 AI 仍需要更好的上游证据:新鲜语音、新鲜 3D 采集、隐私友好的收集方式,以及机器可读的 provenance。这更像基础设施,而不像应用;但也正因此更耐久。
[++] 建立在已验证轨迹和更低领域推理成本之上的科学基础设施 —— Anthropic 的优化套件和 ScienceIDE 的已验证轨迹,都表明人们需要那种正确性来自执行、验证或实验结果的领域系统。这比通用聊天 AI 更窄,但需求是真实的,当前工具也仍很早期。
8. 要点总结
- 当天讨论的重心,已经从抽象能力转向控制界面。 @VitalikButerin 认为(1,384 个赞、182 条回复、156,612 次浏览、464 次收藏)谈的是整程序验证;而 @testingcatalog 介绍(10 个赞、4 条回复、2,443 次浏览)谈的是为 agent 绑定负责人并设置会过期的访问权限。贯穿始终的主线是:有用的自主性,如今依赖精确边界和可重建证据。
- 基准合法性正逐渐成为一个独立产品类别。 @Timthadon01 披露(32 个赞、28 条回复、364 次浏览)介绍了围绕真实失效条件构建的基准;@EpochAIResearch 上线(18 个赞、697 次浏览)则介绍了带有明确结论的公开基准审计。人们越来越想要的是可检查性,而不只是排行榜名次。
- 开源模型的采用,跟可部署性走,而不是跟声望走。 @liambraus 总结(52 个赞、4 条回复、493 次浏览、17 次收藏)指出,用户实际会投票给那个不会卡住、也不会把预算耗尽的会话;@TheAhmadOsman 解释(44 个赞、9 条回复、2,912 次浏览、33 次收藏)则解释了为什么带宽和软件栈与内存容量同样重要。真正胜出的,是适配工作流的叙事。
- 物理 AI 讨论仍在继续上游移动,转向缺失数据与混乱感知。 @hoodsher55 认为(15 个赞、16 条回复、4,515 次浏览)指出,物理世界不可能靠抓取得来;@Timthadon01 指出(32 个赞、28 条回复、364 次浏览)则把重叠说话和语码转换视为实验室仍在回避的听觉问题。人们要的是更新鲜的真值,而不是更多炒作。
- 最强的构建者信号,来自可复用的公开成果。 @AnthropicAI 分享(374 个赞、48 条回复、32,802 次浏览、117 次收藏)是开放的生物分子优化套件,@PhAILabs 分享(4 个赞、971 次浏览)是已验证的科学轨迹与迁移结果,@thesupermannx 分享(21 个赞、4 条回复、1,264 次浏览、15 次收藏)则是公开的 C2C 仓库。能交付可检查的代码或方法,比分量十足的定位更重要。